Any-to-Any: 네이티브 멀티모달 에이전트 구축하기
📺 원본 영상: Any-to-Any: Building Native Multimodal Agents - Patrick Löber, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-21 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것이다. 화면에 표시된 코드, 슬라이드, 다이어그램 등 시각 자료는 포함되지 않을 수 있으며, 원본 영상과 함께 참조하기를 권장한다.
개요
이 강연은 Google DeepMind의 기술 스태프(Technical Staff Member)인 Patrick Löber가 Gemini API와 Google AI Studio를 활용하여 네이티브 멀티모달 에이전트를 구축하는 방법을 소개한다. 강연의 핵심 아이디어는 텍스트 처리라는 단일 통로를 넘어, 이미지·오디오·비디오를 입력으로 받아 텍스트·이미지·음성을 자율적으로 생성하는 “Any-to-Any” 에이전트를 실제로 구현하는 데 있다. 강연자는 멀티모달 이해, 네이티브 이미지 생성, 네이티브 음성 생성, 실시간 Live API라는 네 가지 축을 중심으로 설명하며, 이 모든 요소를 엮어 Notebook LM 클론을 직접 만드는 것을 최종 목표로 제시한다.
1. “Any-to-Any” 비전: Gemini API가 가능하게 하는 것들
Patrick Löber는 “Any-to-Any”라는 개념으로 강연을 시작한다. 이 개념의 핵심은 Gemini API가 단일 방향의 정보 처리를 넘어 다양한 입력과 출력 형태를 유연하게 조합할 수 있다는 데 있다. 입력(Input) 측면에서 Gemini는 텍스트와 코드를 기본으로, 이미지, 오디오, 비디오뿐만 아니라 URL 직접 전달과 Google Search까지도 처리할 수 있다. 출력(Output) 측면에서는 텍스트 생성을 기반으로, 이미지 생성, 음성(Speech) 생성, 비디오 생성, 함수 호출(Function Call), 코드 생성까지 지원한다. 이러한 입출력 조합의 자유도가 기존의 단일 모달 파이프라인으로는 상상하기 어려웠던 복합적인 에이전트 애플리케이션을 가능하게 한다.
💡 [영상 참조] 강연자는 [01:00] 시점에서 Gemini API의 모든 입출력 조합을 보여주는 슬라이드를 화면에 표시하며 설명한다. 상세 내용은 원본 영상을 확인하라.
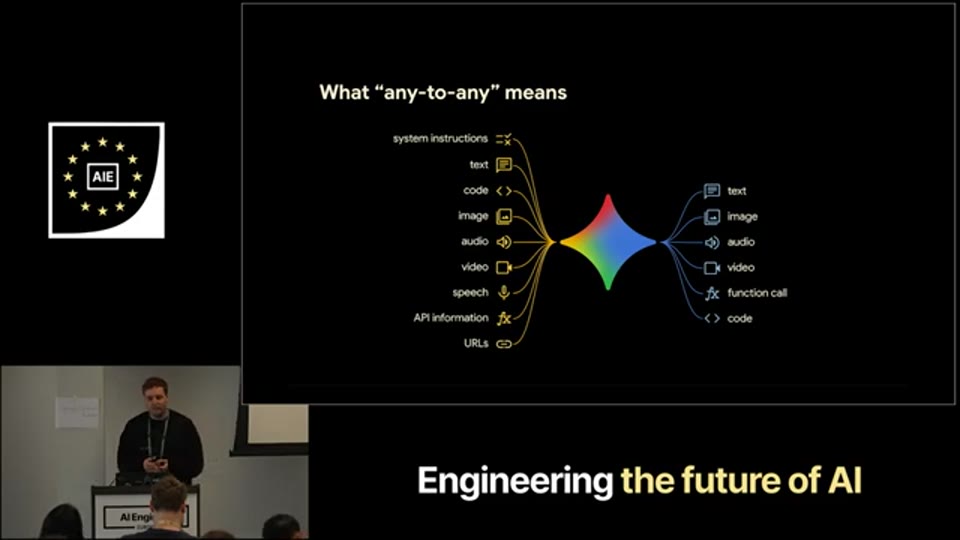
01:05 - Gemini API의 전체 입출력 조합을 보여주는 Any-to-Any 슬라이드
2. 현재의 모델 아키텍처: 비전과 현실 사이의 간극
그러나 강연자는 곧바로 솔직한 수정을 가한다. “Any-to-Any” 슬라이드가 약간 오해를 불러일으킬 수 있다고 말하면서, 실제로는 아직 하나의 통합된 멀티모달 모델이 존재하지 않는다고 설명한다. “Any-to-Any”는 Google DeepMind가 Gemini를 통해 그리는 장기적 비전이며, 현재의 아키텍처는 그 중간 단계에 해당한다.
현재의 구조는 크게 두 레이어로 나뉜다. 중심에는 메인 Gemini 모델 시리즈(강연 시점 기준 Gemini 3)가 위치하며, 이 모델은 텍스트·이미지·오디오·비디오 등 다양한 입력을 처리할 수 있지만 출력은 텍스트에 한정된다. 이미지 생성, 음성 생성 등 다른 모달리티의 출력은 메인 Gemini 모델을 기반으로 훈련된 별도의 전문화된 네이티브 생성 모델들이 담당한다. 강연자는 이 구조가 보기에는 복잡할 수 있지만 현재 기술의 정직한 반영이라고 표현했으며, Gemini 소형 모델들의 경우 텍스트, 이미지, 비디오 입력은 물론 오디오 입력도 지원하기 때문에 로컬에서도 멀티모달 에이전트를 구축할 수 있다는 점을 언급했다.
💡 [영상 참조] 강연자는 [01:57] 시점에서 현재 Gemini 모델 아키텍처를 나타내는 다이어그램을 화면에 표시한다. 상세 내용은 원본 영상을 확인하라.
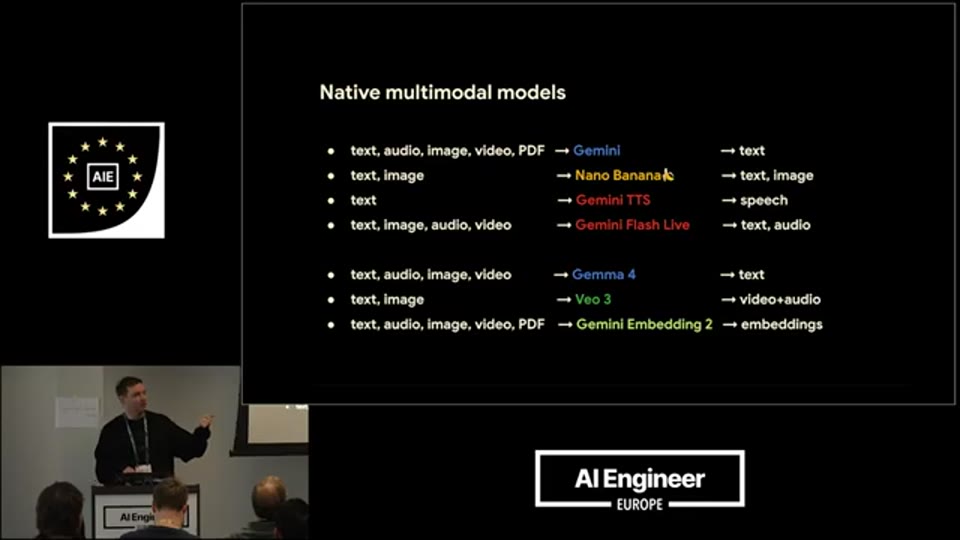
02:02 - 현재 Gemini 모델 아키텍처 다이어그램
3. 데모 프로젝트: 에이전트로서의 Notebook LM 클론
강연의 실용적인 목표는 Notebook LM 클론을 직접 구현해보는 것이다. Notebook LM은 Google이 제공하는 서비스로, 여러 소스를 입력받아 팟캐스트 스타일의 오디오 오버뷰나 인포그래픽 같은 멀티미디어 콘텐츠를 생성해준다. 강연자가 이 클론을 목표로 삼은 이유는 Gemini API의 멀티모달 기능을 활용하면 이 수준의 기능을 개발자가 직접 구축할 수 있음을 보여주기 위함이다.
이 클론 앱의 핵심적인 차별점은 “워크플로(Workflow)“가 아닌 “에이전트(Agent)“로 설계한다는 점이다. 하드코딩된 파이프라인에서는 어떤 콘텐츠를 생성할지 사전에 고정되어 있다. 반면, 에이전트 방식에서는 추론 모델이 어떤 콘텐츠를 생성할지 스스로 결정한다. 강연자가 설계한 에이전틱 아키텍처는 두 개의 페이즈로 구성된다. Phase 1은 멀티모달 이해로, 다양한 소스(PDF, 이미지, 비디오, 음성 메모 등)를 입력받아 종합 요약을 생성한다. Phase 2는 에이전틱 루프로, Gemini가 추론 모델(Brain) 역할을 하며 함수 호출을 통해 이미지나 음성 같은 에셋을 필요에 따라 생성하고, 충분한 에셋이 만들어졌다고 판단할 때까지 루프를 반복하여 최종적으로 텍스트, 음성, 인포그래픽 세 가지 형태의 출력을 만들어낸다.
강연자는 예제 시나리오로 “Attention is All You Need” 논문을 활용한 학습 자료 생성을 선택했다. PDF 논문, 관련 이미지, 강의 비디오, 음성 메모 등을 한꺼번에 입력으로 제공하고, 이를 바탕으로 교육 자료를 자동 생성하는 흐름이다.
💡 [영상 참조] 강연자는 [03:48] 시점에서 전체 에이전틱 아키텍처 다이어그램을 화면에 표시하며 설명한다. 상세 내용은 원본 영상을 확인하라.
4. Phase 1: 멀티모달 이해 구현
4.1 Google GenAI SDK 설정과 파일 업로드
강연자에 따르면, 멀티모달 이해를 구현하는 코드는 놀랍도록 단순하다. 기본 설정 흐름은 세 단계로 요약된다. 우선 Google AI Studio에서 무료로 API 키를 발급받는다. 그다음 Google GenAI SDK를 설치하는데, Python, JavaScript 등 다양한 언어를 지원한다. 파일 업로드 방식은 두 가지인데, 큰 파일은 File API를 통해 먼저 업로드하고, 상대적으로 작은 파일은 인라인 데이터(Inline Data)로 API 호출 시 직접 전달한다. 이렇게 업로드된 PDF, 비디오, MP3 파일들을 동일한 contents 리스트 안에 담아 client.models.generate_content()를 한 번만 호출하면, 모델이 여러 소스 간의 연결 고리를 파악하여 종합적인 분석 결과를 반환한다. 강연자는 이 일관된 인터페이스가 Gemini API 설계의 핵심 철학이라고 강조했다.
💡 [영상 참조] 강연자는 [04:55] 시점에서 실제 Google GenAI SDK 코드를 화면에 표시하며 설명한다. 상세 내용은 원본 영상을 확인하라.
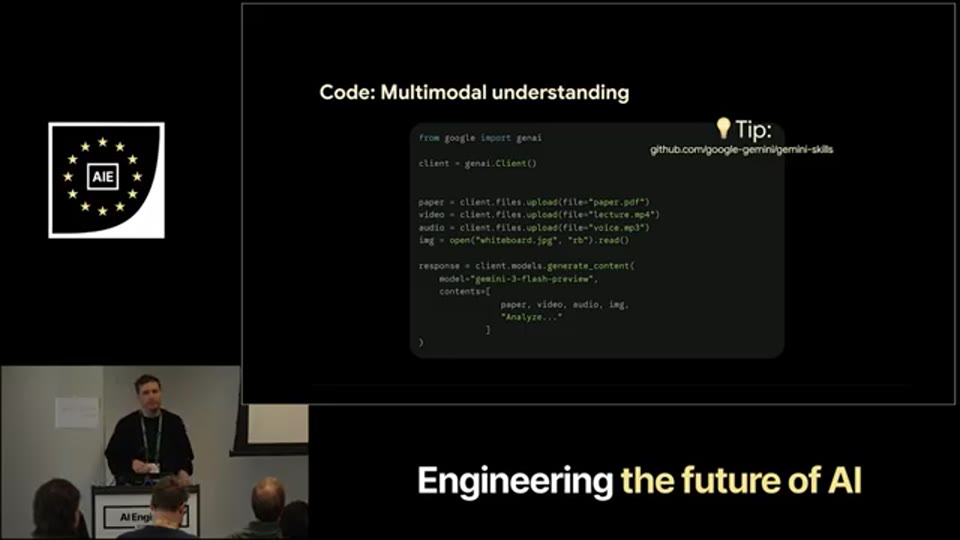
04:58 - 멀티모달 이해를 위한 Google GenAI SDK 코드 예제
4.2 오디오/비디오 처리의 실용적 수치들
강연자는 실제 개발에서 중요한 몇 가지 수치를 공유했다. 오디오의 경우 1분이 약 1,920 토큰으로 환산되며, Gemini의 컨텍스트 창이 100만 토큰임을 감안하면 단일 API 호출로 약 8시간 이상의 오디오 콘텐츠를 처리할 수 있다는 계산이 나온다. 비디오는 대략 1시간이 한계이지만, 특정 타임스탬프 범위만 분석하도록 프롬프트에 지시함으로써 더 유연하게 활용할 수 있다. 또한 YouTube URL을 직접 API에 전달하는 것도 가능하다고 강연자는 언급했다.
비용 절감 측면에서는 컨텍스트 캐싱(Context Caching)을 적극 활용할 것을 권장했다. 이 기능은 API에 내장되어 있으며, 동일한 긴 파일을 반복적으로 불러와 여러 쿼리를 수행하는 패턴에서 토큰 비용을 최대 90%까지 절감해준다. 하나의 긴 강의 비디오를 기반으로 다양한 질문을 반복하는 에이전트 애플리케이션에서 특히 의미 있는 절감 효과다. 강연자는 텍스트 전사(Transcription) 또한 Gemini Flash 모델로 충분히 수행 가능하다고 언급했는데, 프롬프트에 “이 파일의 트랜스크립트를 생성해라”라고 지시하는 것만으로 고품질 전사가 이루어진다고 설명했다.
5. Phase 2: 네이티브 멀티모달 생성
5.1 네이티브 이미지 생성과 “세계를 이해하는” 모델
이미지 생성에는 Gemini 3.5 Flash Image Preview 모델이 사용된다. 강연자는 이 모델의 API 호출 구조가 client.models.generate_content()로 멀티모달 이해와 동일하다는 점을 재차 강조했다. 특정 모달리티를 추가할 때마다 새로운 인터페이스를 배울 필요가 없다는 것이 핵심 설계 이점이다.
강연자는 이 모델을 “NanoBanana2”라는 이름으로도 언급했는데(강연자가 해당 모델에 부여한 비공식 명칭으로 보인다), 이 모델이 인포그래픽 생성에 특히 강점을 보인다고 설명했다. 단순히 프롬프트에 “인포그래픽을 만들어라”라고 입력하는 것만으로도 적절한 시각적 구성이 갖춰진 인포그래픽이 생성된다. 그런데 이보다 더 중요한 것은 “네이티브(Native)” 생성이 왜 의미 있는지에 대한 설명이다. 이 이미지 생성 모델은 메인 Gemini 모델과 동일한 방대한 훈련을 공유하기 때문에, 단순한 미적 이미지 합성을 넘어 세계에 대한 지식을 바탕으로 한 의미 있는 생성이 가능하다.
강연자가 제시한 사례 하나는 지도 위에 화살표를 그려 “여기 보이는 것을 그림으로 그려달라”고 요청하면, 모델이 세계 지식을 활용하여 금문교(Golden Gate Bridge)를 정확하게 생성하는 것이다. 또 다른 교육적 사례로는 수학 숙제를 모델에게 직접 교정받으면서 수정 내용이 포함된 이미지를 생성하는 활용이 소개되었다. 모델이 수학적 개념을 이해하고 교정 내용을 이미지 위에 렌더링할 수 있기 때문에 가능한 기능이다.
💡 [영상 참조] 강연자는 [08:40] 및 [11:52] 시점에서 이미지 생성 코드 예제와 실제 활용 사례 이미지를 화면에 표시한다. 상세 내용은 원본 영상을 확인하라.
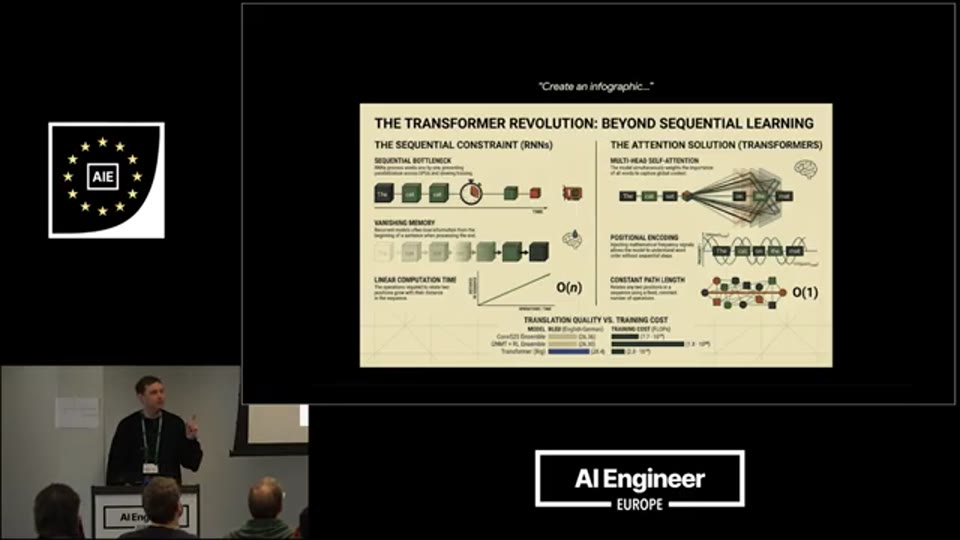
08:49 - Gemini 이미지 생성 모델(Gemini 3.5 Flash Image Preview) 코드 예제 및 생성된 인포그래픽 결과
5.2 네이티브 음성 생성: 다국어, 다화자, 억양 제어
음성 생성에는 현재 Gemini 2.5 기반의 TTS(Text-to-Speech) 모델이 사용된다. 이 모델의 가장 두드러진 특징은 단일 화자 음성 합성을 넘어, 두 명의 화자가 번갈아 이야기하는 팟캐스트 스타일의 오디오 파일을 생성할 수 있다는 점이다. 이는 Notebook LM의 Audio Overview 기능과 직접 대응하는 능력으로, 강연자는 실제 생성된 오디오를 데모로 재생하여 청중에게 직접 들려줬다.
이 모델은 또한 다국어 지원과 억양(Accent) 제어 기능을 갖추고 있어, 프롬프트에 특정 억양을 지정하는 것만으로 다양한 지역적 뉘앙스를 재현할 수 있다. 강연자는 영국식 억양과 독일 바이에른 방언 억양을 포함한 예시를 직접 데모로 선보이며, 언어·억양·톤을 이해하는 모델의 능력을 보여줬다. 물론 세상의 모든 억양을 지원하지는 않지만, 주요 지역 언어와 억양에 대한 지원이 이루어지고 있다고 강연자는 설명했다.
💡 [영상 참조] 강연자는 [09:22] 시점에서 생성된 팟캐스트 스타일 오디오 데모를, [12:43] 시점에서 다국어 억양 데모를 재생한다. 원본 영상에서 직접 청취할 수 있다.
5.3 함수 호출(Function Calling)로 에이전틱 루프 구성하기
이 섹션이 강연의 핵심 엔지니어링 부분이다. Gemini를 추론 엔진으로 삼고 이미지 생성과 음성 생성을 도구(Tool)로 연결하여 에이전틱 루프를 구성하는 구체적인 방법이 소개된다.
구성은 크게 세 단계로 이루어진다. 먼저 **함수 선언(Function Declaration)**을 작성하는데, 각 함수에는 이름과 함께 설명(Description)을 부여한다. 이 설명이 Gemini가 어떤 상황에서 이 함수를 호출해야 하는지 이해하는 핵심 근거가 되므로, 명확하고 구체적으로 작성하는 것이 중요하다. 파라미터는 최소화하여 이미지 생성 함수의 경우 이미지의 상세 묘사를 담은 문자열 하나로 구성했다. 그 다음 client.models.generate_content() 호출 시 tools 파라미터에 이 함수 선언 목록을 설정한다. 마지막으로 에이전트 프롬프트를 통해 Gemini에게 역할과 목적을 명확히 부여한다.
강연자가 제시한 에이전트 프롬프트의 핵심 지시사항은 다음 두 가지다:
- “어떤 개념이 시각적 다이어그램이 필요할 만큼 복잡한지 판단하고, 그런 경우
generate_image를 호출하라.” - “어떤 섹션이 오디오 요약으로부터 이익을 얻을 수 있는지 판단하고, 그런 경우
generate_speech를 호출하라.”
이 구조 하에서 Gemini는 Phase 1에서 생성된 종합 요약을 바탕으로 어떤 보완 자료가 필요한지 스스로 추론하고 해당 함수를 호출한다. 그리고 생성된 에셋이 충분한지 다시 평가하며 루프를 반복한다. 강연자는 이것이 에이전틱 멀티모달 생성을 구축하기 위해 필요한 거의 전부라고 설명했다.
💡 [영상 참조] 강연자는 [10:00] 시점에서 함수 선언 코드와 에이전트 프롬프트 예제를 화면에 표시한다. 상세 내용은 원본 영상을 확인하라.
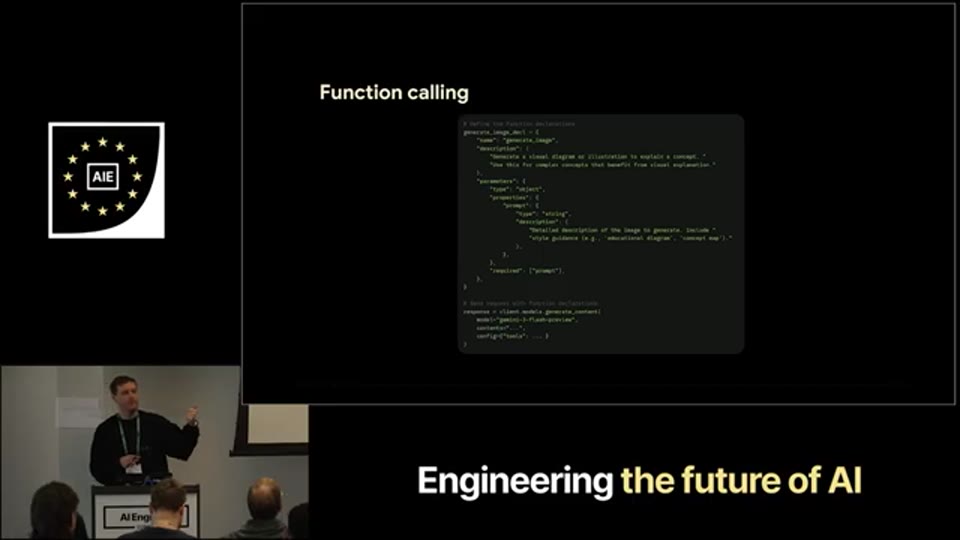
10:08 - 함수 호출(Function Calling) 설정 코드 - generate_image, generate_speech 함수 선언 및 에이전트 프롬프트
6. Live API: 오디오-투-오디오 실시간 상호작용
강연의 마지막 주요 섹션은 Live API다. 강연자는 Gemini 3.1 Flash Live라는 모델을 소개하는데, 이 모델이 기존 실시간 음성 인터페이스와 근본적으로 다른 이유는 “오디오-투-오디오(Audio-to-Audio)” 단일 아키텍처를 채택하고 있기 때문이다. 기존의 실시간 음성 처리는 음성 인식(ASR) → 대형 언어 모델(LLM) → 음성 합성(TTS)이라는 세 단계가 순차적으로 연결된 캐스케이드(Cascade) 파이프라인으로 구성된다. 이 방식에서는 각 단계를 거치면서 억양, 감정, 빠르기 같은 언어적 뉘앙스가 손실되고 지연(Latency)도 누적된다. 반면 오디오-투-오디오 모델은 단일 아키텍처 안에서 오디오가 입력되고 오디오로 출력되기 때문에, 이러한 정보 손실과 지연 문제를 구조적으로 해결한다.
14:03 - Live API 아키텍처 설명 - Gemini 3.1 Flash Live 오디오-투-오디오 단일 아키텍처와 기존 캐스케이드 파이프라인 비교
강연자는 동료 Thor가 Live API를 시연하는 영상을 재생하며, 사용자가 자연스럽게 말을 시작하는 순간부터 대화가 이루어지고, 카메라를 활성화하면 모델이 실시간 비디오 피드를 인식하여 화면 속 사람의 외모를 정확하게 묘사하는 장면을 보여줬다. 이 기능은 실시간성과 시각 이해가 동시에 요구되는 응용, 예컨대 시각 보조 에이전트나 실시간 교육 튜터 등에서 특히 강력한 잠재력을 가진다. 직접 체험하려면 Google AI Studio의 Live 데모 환경을 이용할 수 있다.
💡 [영상 참조] 강연자는 [14:36] 시점에서 동료가 Live API를 사용하는 데모 영상을 재생한다. 상세 내용은 원본 영상을 확인하라.
7. 추가 기능 및 로컬 활용 가능성
강연 말미에 강연자는 몇 가지 추가적인 관련 기능을 간략히 언급했다. 첫 번째는 멀티모달 임베딩 모델(Multimodal Embedding Model)로, 텍스트·이미지·비디오·오디오 등 서로 다른 모달리티를 하나의 통합된 벡터 공간(Unified Vector Space)에 매핑할 수 있다. 이는 단순한 텍스트 유사도 검색을 넘어, “이 이미지와 가장 유사한 오디오 클립은?”과 같은 크로스-모달 검색(Cross-modal Search)을 가능하게 한다. 두 번째는 Gemma 4로, 로컬 환경에서 실행 가능한 멀티모달 이해 모델이다. 이미지·비디오 입력과 네이티브 오디오 처리를 온디바이스(On-device)로 수행할 수 있어, 클라우드 API에 의존하지 않는 프라이버시 중심의 멀티모달 에이전트를 구축하고자 하는 개발자에게 중요한 선택지가 된다.
강연자는 또한 “Gemini API Skill”이라는 도구 개념도 잠시 언급했다. 에이전트에 이 스킬을 연결해두면 Gemini 관련 코드를 에이전트가 자동으로 생성해주므로, 개발자가 SDK 문서를 매번 참조하지 않아도 Gemini 모델과 상호작용하는 코드를 즉시 작성할 수 있다.
마무리: 일관성이라는 설계 철학과 에이전틱 멀티모달의 현재
Patrick Löber의 강연은 Gemini API가 현재 어디까지 와 있는지를 보여주는 기술적 스냅샷이다. 단일 통합 모델이라는 이상적 비전과 실제로는 여러 전문화된 모델이 협력하는 현재 아키텍처 사이의 간극을 솔직하게 인정하면서도, 그 현재 상태에서도 충분히 강력한 에이전틱 애플리케이션을 구축할 수 있음을 구체적인 코드와 데모로 증명한 강연이다.
강연 전반에 걸쳐 반복되는 핵심 메시지는 일관성이다. 멀티모달 이해든 이미지 생성이든 음성 합성이든, 모두 client.models.generate_content()라는 동일한 인터페이스로 호출된다. 이 설계 철학 덕분에 개발자는 새로운 모달리티를 추가할 때 새로운 패러다임을 처음부터 학습할 필요가 없다. 함수 호출을 통한 에이전틱 루프, 컨텍스트 캐싱을 통한 비용 절감, 그리고 오디오-투-오디오 모델이 가져다주는 자연스러운 실시간 상호작용까지, 강연자가 소개한 이 기술 스택은 멀티모달 AI 에이전트 개발의 현실적이고 즉시 적용 가능한 출발점을 제시한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Any-to-Any: Building Native Multimodal Agents - Patrick Löber, Google DeepMind |
| 채널 | AI Engineer |
| 강연자 | Patrick Löber (Google DeepMind, Technical Staff Member, Gemini API & AI Studio 담당) |
| 리포트 작성 | 2026-05-21 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었다. 정확한 내용은 원본 영상을 참조하라.
Related Reports
- Building Conversational Agents — Thor Schaeff and Philipp Schmid, Google DeepMind
- Build & deploy AI-powered apps — Paige Bailey, Google DeepMind
- Why (Senior) Engineers Struggle to Build AI Agents — Philipp Schmid, Google DeepMind
- “진짜 공부는 따로 있습니다” 구글 시니어 디렉터가 밝히는 AI 학습의 원리
- From Transcription to Live Music - Gemini’s Audio Stack — Thor Schaeff, Google DeepMind