Autonomous Agents for Scientific Tasks - Sina Shahandeh, Radicait
📺 원본 영상: Autonomous Agents for Scientific Tasks - Sina Shahandeh, Radicait
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-19
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
Sina Shahandeh는 이 강연에서 과학 연구 작업에 자율 에이전트를 적용할 때 가장 큰 병목이 단순한 코드 구현이 아니라 “좋은 가설을 계속 만들어내는 능력”에 있다고 설명한다. 그는 Radicait에서 수행하는 CT-to-PET 의료 영상 변환 문제를 사례로 들며, 현재의 코딩 에이전트가 실험 실행과 코드 수정에는 강하지만 장기적이고 개방적인 연구 문제에서는 일정 수준에서 성능이 포화되는 경향이 있다고 분석한다.
강연의 핵심은 과학적 발견 과정을 코드 최적화 루프로만 보지 않고, 관찰, 질문, 가설, 실험, 학습이 반복되는 구조로 바라봐야 한다는 점이다. 특히 그는 복잡한 연구 문제를 계층적으로 분해하고, 각 구성 요소마다 명시적으로 가설을 생성하도록 유도하면 에이전트가 더 급진적이고 유의미한 개선안을 탐색할 수 있다고 주장한다.
자율 연구 에이전트의 한계는 구현이 아니라 아이디어에 있다
강연자는 먼저 Andrej Karpathy의 Auto Research류 접근을 언급하며, 머신러닝 모델과 코딩 에이전트를 결합해 특정 metric을 최적화하고 error를 줄이는 방향으로 코드를 개선하는 방식이 많은 코딩 작업에서 잘 작동한다고 설명한다. 이런 문제에서는 에이전트가 코드를 고치고, 실험을 반복하고, 결과를 비교하면서 일종의 hill climbing(언덕 오르기식 최적화)을 수행할 수 있다. 목표가 비교적 명확하고 평가 지표가 안정적이라면, 에이전트는 구현과 반복 실험을 통해 성능을 꽤 빠르게 끌어올릴 수 있다.
그러나 과학적 연구 문제는 일반적인 코딩 과제보다 훨씬 더 개방적이고 장기적인 성격을 갖는다. 강연자에 따르면, 이런 환경에서 AI 에이전트는 일정 수준까지는 빠르게 개선하다가 이후에는 더 이상 나아가지 못하고 포화되는 경우가 많다. 그 이유는 에이전트가 코드 구현이나 대량 실험 실행에는 능숙하지만, “다음에 무엇을 시도해야 하는가”를 결정하는 연구적 감각, 즉 research taste가 부족하기 때문이다.
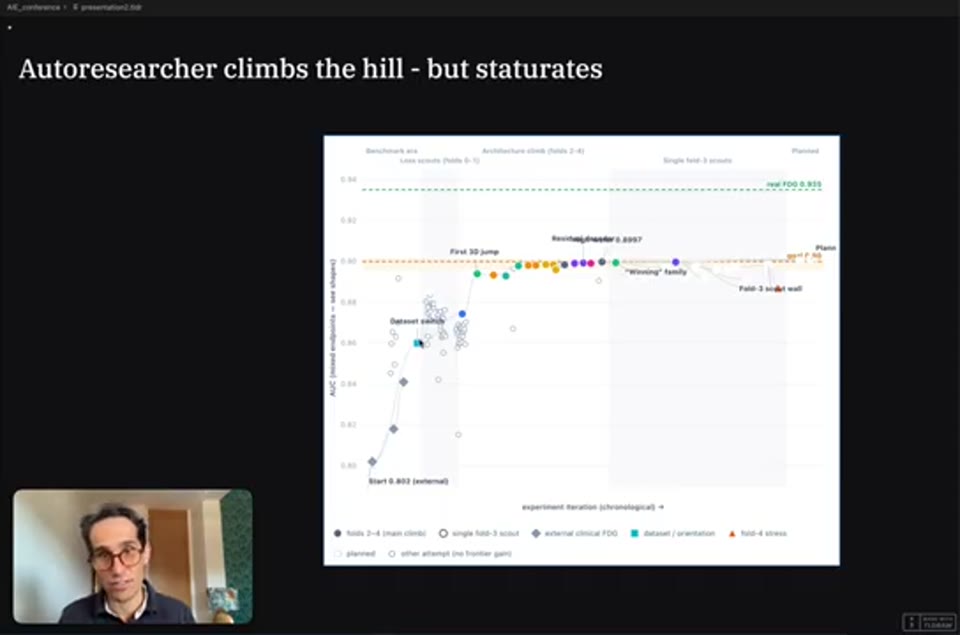
05:21 - Codex 실행에서 나온 모델 개선 iteration과 성능 포화 지점을 보여주는 화면
좋은 인간 연구자는 실패한 실험에서도 단서를 읽고, 문제를 다른 관점에서 재구성하며, 기존 가정 자체를 바꾸는 새로운 가설을 제안한다. 반면 현재의 코딩 에이전트는 주어진 코드베이스 안에서 하이퍼파라미터를 조정하거나 익숙한 패턴을 적용하는 데 머무르기 쉽다. 이 차이가 장기 연구에서 인간 연구자와 자율 에이전트 사이의 성능 격차를 만든다는 것이 강연의 출발점이다.
과학적 방법을 에이전트 루프로 번역하기
강연자는 과학적 작업을 관찰, 질문, 가설, 실험, 학습의 반복 구조로 설명한다. 어떤 현상을 관찰한 뒤 질문을 만들고, 그 질문에 대한 좋은 가설을 세운 다음, 실험을 통해 검증하고, 다시 그 결과로부터 학습하는 과정이 과학적 방법의 기본 골격이다. 이 관점에서 보면 자율 에이전트의 연구 능력은 단순히 코드를 잘 생성하는 능력이 아니라, 이 루프 전체를 얼마나 잘 수행하는가에 달려 있다.
그는 이 중 학습과 구현은 어느 정도 해결 가능한 영역으로 본다. 예를 들어 에이전트가 과거 실수와 실험 결과를 잘 기억하도록 memory를 구성하고, 반복 활동의 패턴을 정리하면 같은 오류를 줄이거나 실험 로그를 더 체계적으로 활용할 수 있다. 물론 이것도 쉽지는 않지만, 강연자는 상대적으로 더 어려운 문제는 “좋은 가설을 만드는 것”이라고 강조한다.
가설 생성은 단순한 다음 단계 추천이 아니다. 좋은 가설은 문제 구조를 다르게 바라보게 하고, 기존 탐색 공간 밖의 선택지를 열어준다. 따라서 자율 에이전트를 과학 연구에 투입하려면, 모델에게 단순히 “성능을 개선하라”고 요청하는 대신 문제를 구조화하고, 각 부분에서 가능한 변화의 방향을 명시적으로 탐색하게 만드는 장치가 필요하다.
Radicait의 사례 - CT에서 PET을 생성하는 in silico PET
강연자는 Radicait에서 다루는 문제로 in silico PET을 소개한다. 이는 CT scan을 입력으로 받아 PET scan에 해당하는 영상을 생성하려는 접근이다. 환자의 폐에 결절이 있을 때, 이 결절이 암인지 여부를 판단하기 위해 PET scan을 수행할 수 있지만, PET scan은 방사성 추적자 사용, 촬영 시간, 비용 측면에서 부담이 큰 절차다. 따라서 CT 영상으로부터 PET 영상의 정보를 추정할 수 있다면 의료 영상 분석에서 매우 큰 의미를 가질 수 있다.
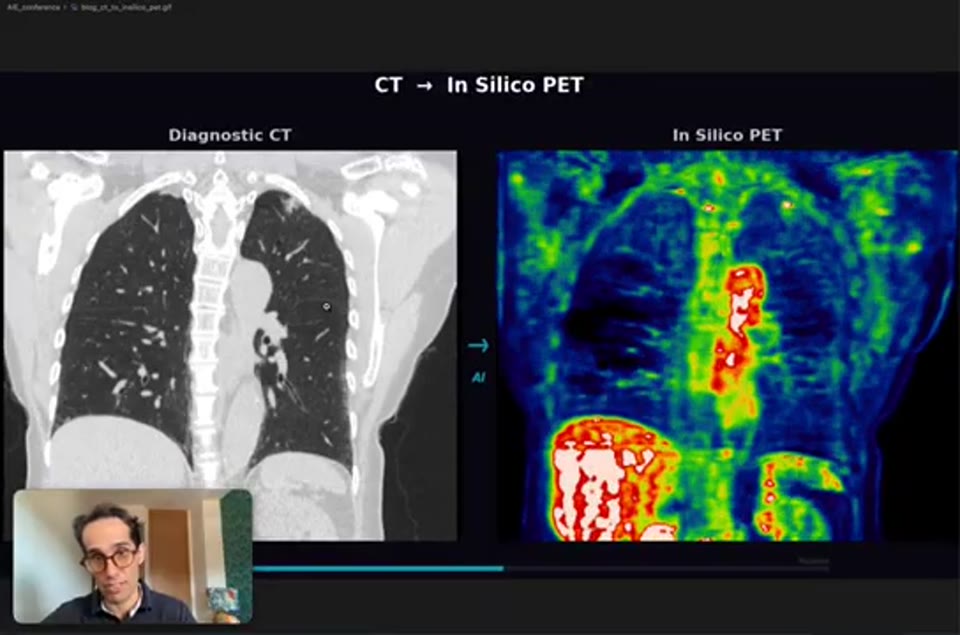
03:30 - CT scan에서 PET scan을 생성하는 in silico PET 문제와 의료 영상 변환 사례를 설명하는 화면
이 문제는 본질적으로 machine learning 기반 image-to-image translation이다. CT는 신체 구조를 보여주는 반면, PET은 조직의 대사 활동을 반영한다. 특정 조직은 radioactive tracer(방사성 추적자)를 더 많이 흡수하고 PET 영상에서 밝게 나타나며, 종양 조직도 대체로 이러한 특성을 보인다. 모델은 CT 영상의 구조적 정보를 학습한 뒤, 해당 조직이 PET에서 어떻게 보일지를 추론해야 한다.
하지만 이 문제는 단일 모델 아키텍처를 선택하고 학습시키면 끝나는 작업이 아니다. 좋은 데이터셋 확보, 전처리, metric 설계, synthetic PET과 real PET 사이의 fidelity 평가, 모델 구조 선택, training loss 구성, 주변 스크립트 정비까지 많은 요소가 얽혀 있다. 강연자는 이런 복합적인 과학 문제를 장기 연구 프로젝트 전체로 바라보면, 결국 수많은 하위 목표와 반복 루프의 집합으로 분해해야 한다고 설명한다.
2.5D 접근의 한계와 3D convolution이라는 가설
강연자가 든 구체적 사례는 CT slice를 모델에 입력하는 방식이다. 초기 모델은 여러 CT slice를 channel처럼 쌓아 2D convolution 기반으로 처리하는 2.5D generator 구조였던 것으로 설명된다. 이는 의료 영상에서 흔히 사용되는 절충적 접근이다. 완전한 3D volume을 다루는 것보다 계산 부담이 낮으면서도, 단일 2D slice보다 주변 단면 정보를 더 활용할 수 있기 때문이다.
그러나 이 접근에는 명확한 한계가 있다. CT와 PET 데이터는 본질적으로 3차원 신체 구조를 담고 있으며, 병변과 주변 조직의 관계도 slice 단위로만 이해하기 어렵다. 만약 모델이 각 slice를 2D convolution 중심으로 처리한다면, 공간적 연속성과 입체적 맥락을 충분히 포착하지 못할 가능성이 있다. 강연자는 일반적인 에이전트에게 단순히 성능 개선을 맡기면 hyperparameter 조정이나 익숙한 모델 수정에 머무르기 쉽고, 문제를 3D convolution 기반으로 재구성하는 수준의 급진적 아이디어는 잘 나오지 않는다고 설명한다.
이 지점에서 “가설 생성”의 중요성이 드러난다. 인간 연구자는 실험이 포화되는 순간, 입력 표현 자체가 잘못된 것은 아닌지, 2.5D 구조가 문제를 지나치게 단순화한 것은 아닌지 질문할 수 있다. 반면 에이전트는 그런 질문을 유도받지 않으면 기존 코드의 지역적 수정에 갇힐 가능성이 높다. 따라서 강연자는 에이전트가 이런 구조적 변화를 떠올리도록 문제를 명시적으로 분해하고, 각 구성 요소에서 대안 가설을 생성하게 해야 한다고 주장한다.
계층적 문제 분해가 가설 공간을 넓힌다
강연자가 제안하는 핵심 기법은 문제를 subcomponent로 명시적으로 분해하는 것이다. 이는 Chain-of-Thought(사고의 연쇄)가 모델에게 단계적 추론을 유도하는 것과 유사하지만, 단순히 “step by step으로 생각하라”고 말하는 것보다 더 구조적이다. 여기서는 전체 연구 문제를 데이터, 모델 아키텍처, 학습 방법, training loss, metric, operational script, data preparation 같은 구성 요소로 나누고, 이들 사이의 관계를 문서화한다.
강연자는 코딩 에이전트가 코드베이스를 읽고 이런 계층 문서를 생성하도록 할 수 있다고 설명한다. 예를 들어 최상위 문서에는 problem statement와 level 1 구조가 있고, 그 아래 level 2, level 3 문서가 이어지며, 최종적으로 실제 코드와 연결된다. 이 구조는 Obsidian 같은 도구에서 그래프 형태로 볼 수 있으며, 모델이 문제의 전체 구조와 세부 요소를 동시에 이해하도록 돕는다.
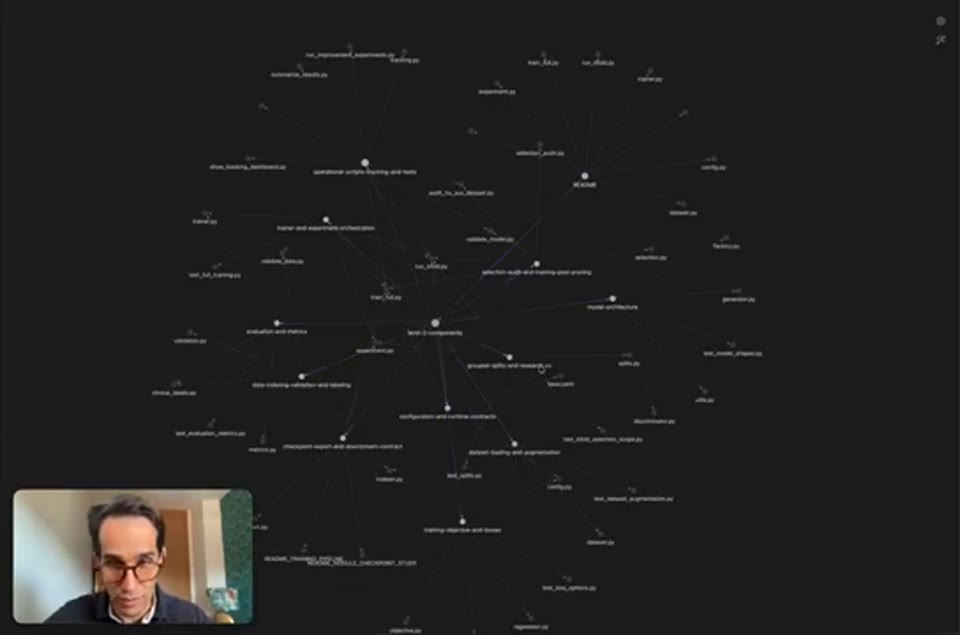
08:38 - Obsidian 그래프를 통해 연구 문제의 계층적 문서 구조를 설명하는 화면
중요한 점은 이 계층 문서가 단순한 documentation이 아니라 가설 생성의 scaffold로 작동한다는 것이다. 에이전트는 더 이상 “코드베이스 전체를 개선하라”는 막연한 지시를 받지 않는다. 대신 “이 계층 구조를 기준으로 각 구성 요소에서 어떤 변화가 문제를 개선할 수 있는지 제안하라”는 작업을 수행한다. 그러면 탐색 공간이 더 체계적으로 열리고, 모델은 데이터 준비, metric 설계, architecture 변경, loss function 조정 등 다양한 방향의 아이디어를 동시에 생성할 수 있다.
단순 최적화 루프에서 협업적 연구 루프로
강연자는 계층적 분해를 통해 100개 이상의 solution idea를 만들 수 있다고 설명한다. 여기서 중요한 것은 아이디어의 개수 자체가 아니라, 그 아이디어들이 문제의 여러 구성 요소를 체계적으로 훑으면서 생성된다는 점이다. 기존 방식이 주어진 코드 주변에서 작은 변경을 반복하는 hill climbing에 가까웠다면, 계층 기반 방식은 문제 공간 전체를 더 넓게 탐색하는 연구 루프에 가깝다.
이 접근은 에이전트가 기존 모델 구조를 조금 고치는 데서 멈추지 않고, 2.5D generator를 3D structure로 바꾸는 것처럼 더 큰 설계 변경을 제안하도록 만든다. 강연자에 따르면, 이런 아이디어는 단순한 코드 최적화 프롬프트만으로는 나오지 않거나 쉽게 놓칠 수 있다. 문제를 구성 요소별로 나누고 각 요소마다 개선 가능성을 묻게 하면, 모델은 인간 연구자가 하듯 “무엇이 중요한가”와 “어디를 바꾸면 큰 차이가 나는가”를 더 잘 탐색하게 된다.
또한 이 과정은 단일 에이전트의 독백으로 끝날 필요가 없다. 생성된 plan은 다른 agent나 다른 model이 검토할 수 있고, sequential 또는 collaborative 방식으로 개선될 수 있다. 이때 연구 루프는 code base, metric goal, hypothesis, implementation, outcome review가 반복되는 형태가 되며, 각 반복마다 더 나은 가설을 만들고 검증하는 방향으로 발전한다.
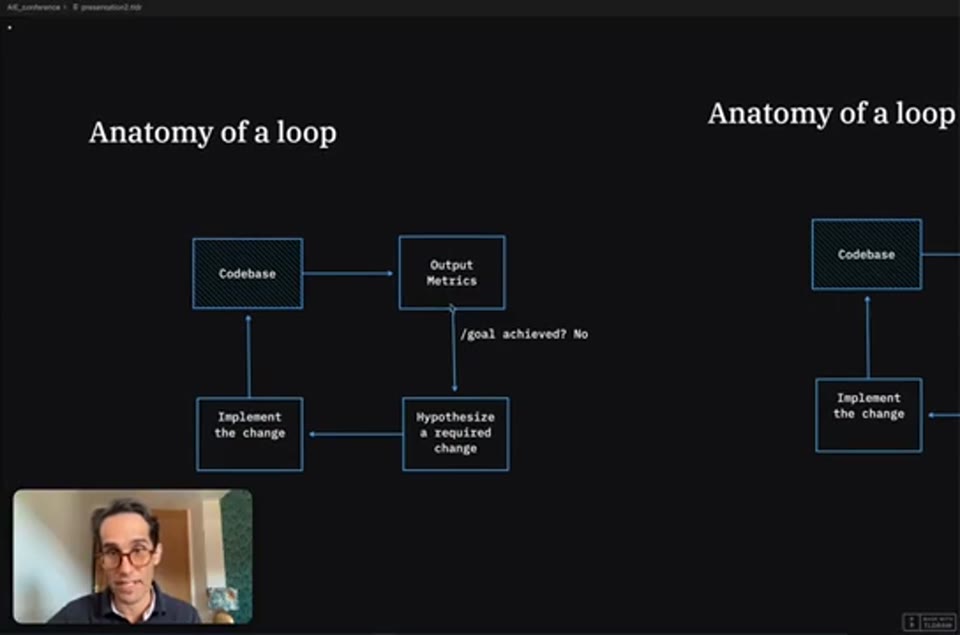
11:49 - code base, metric goal, hypothesis, implementation으로 이어지는 자율 연구 루프를 설명하는 화면
의료 영상 등록 문제와 multimodal critique
강연의 두 번째 사례는 data preparation 과정에서 등장하는 image registration(영상 정합) 문제다. CT scan과 PET scan은 서로 다른 시점에 촬영되기 때문에 처음부터 정확히 맞물려 있지 않을 수 있다. CT는 회색 구조 영상으로, PET은 대사 활동을 색상으로 보여주는 영상으로 설명되며, 두 영상을 정확히 겹쳐야 학습 데이터로 활용할 수 있다.
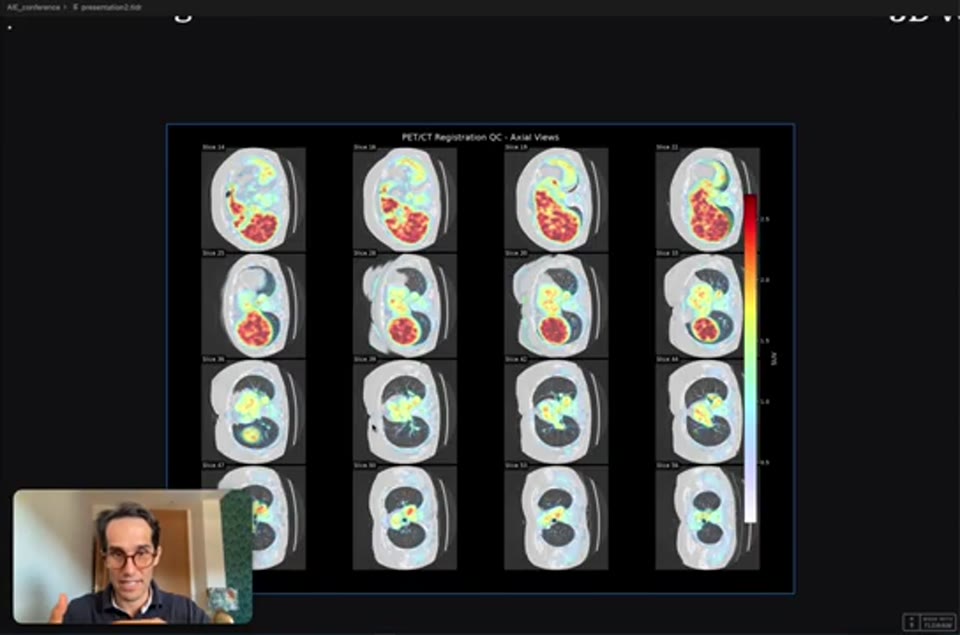
12:49 - CT와 PET scan이 겹쳐진 image registration 예시를 설명하는 화면
이 정합 과정은 단순한 좌표 변환 문제가 아니다. 환자가 호흡하는 방식, 촬영 시점의 차이, 자세 변화, 스캐너 차이 때문에 같은 신체라도 영상의 형태와 위치가 달라질 수 있다. 따라서 registration은 그 자체로 하나의 최적화 루프이며, 좋은 metric을 설계하는 것도 어렵고 실패 원인을 자동으로 파악하는 것도 쉽지 않다. 어떤 경우에는 정량 지표보다 사람이 이미지를 직접 보고 “이 정합이 말이 되는가”를 판단하는 질적 평가가 더 중요할 수 있다.
강연자는 이 지점에서 multimodal model을 loop 안으로 호출하는 방식을 제안한다. 예를 들어 생성된 registration 결과 이미지를 더 강한 시각 이해 능력을 가진 모델에 보여주고, scan이 올바르게 align되었는지, lung mask가 제대로 적용되었는지, crop이나 truncation 문제가 있는지 평가하게 할 수 있다. 이는 에이전트가 수치 metric만 보고 판단하는 한계를 보완하며, 인간 연구자의 visual quality control에 가까운 검토 절차를 자동화하려는 시도다.
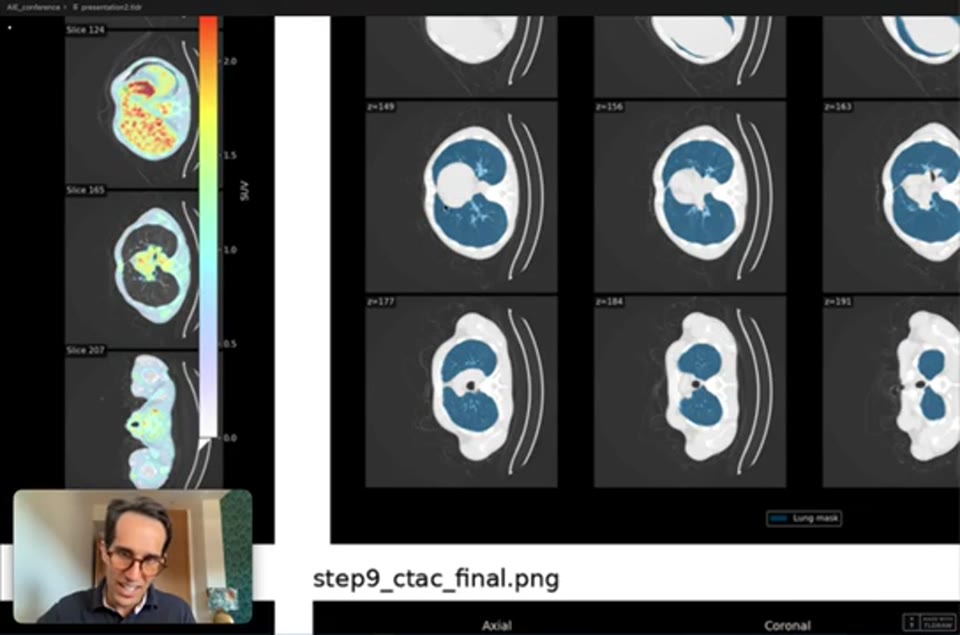
14:34 - lung mask와 quality control metric을 보며 multimodal review 필요성을 설명하는 화면
에이전트에게 추가 skill을 장착한다는 의미
강연자는 에이전트 루프 안에 추가 skill과 adversarial 또는 collaborative review 과정을 넣는 것이 중요하다고 말한다. 여기서 skill은 단순한 프롬프트 조각이 아니라, 특정 작업을 더 잘 수행하는 외부 모델이나 절차를 의미한다. 예를 들어 이미지 품질 검토에는 Gemini 같은 multimodal model을 호출하고, 더 깊은 추론이나 가설 비판에는 GPT-5 Pro 같은 reasoning model을 호출하는 방식이 가능하다고 설명한다.
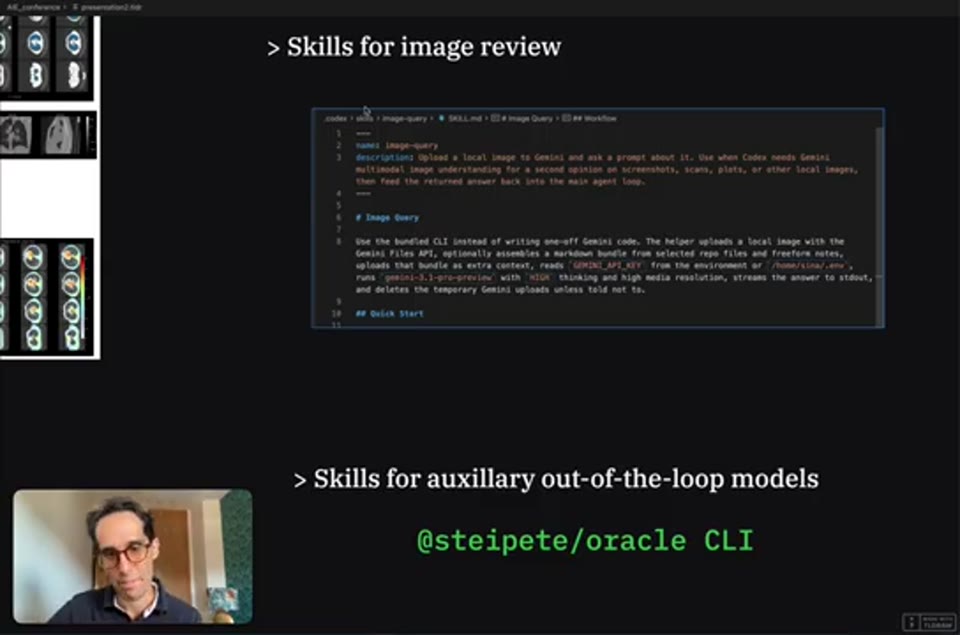
15:51 - 외부 모델과 skill을 호출해 hypothesis generation과 critique를 강화하는 루프를 설명하는 화면
그는 Peter Steinberger의 Oracle CLI를 언급하며, 코드와 데이터를 패키징해 GPT-5 Pro API로 보내고 결과를 다시 루프에 반영하는 접근을 소개한다. 이 부분은 STT상 일부 표현이 불명확하지만, 문맥상 핵심은 “한 모델이 모든 것을 처리하게 하는 대신, 특정 단계마다 더 적합한 모델이나 도구를 불러와 연구 루프를 보강한다”는 데 있다. 구현 담당 에이전트, 이미지 검토 모델, 고성능 추론 모델이 각각의 역할을 맡으면, 루프 전체의 품질이 올라갈 수 있다.
이 구조는 특히 “이번 구현이 정말 효과적이었는가”를 묻는 critique 단계에서 중요하다. 에이전트가 어떤 변경을 구현한 뒤 결과를 보고, 그 결과가 의미 있는 개선인지 판단하고, 다음에는 무엇을 해야 할지 다시 묻는 과정이 반복되어야 한다. 강연자는 이 루프가 잘 설계될수록 가설 생성의 속도와 질이 모두 좋아진다고 본다.
아직 남은 병목 - 관찰 능력과 과학 이미지 이해
강연자는 자율 과학자의 구현 능력은 상당 부분 해결되고 있다고 보지만, 완전한 “data center 안의 과학자”를 만들기 위해서는 관찰 능력이 여전히 큰 병목이라고 지적한다. 특히 의료 영상처럼 전문성이 필요한 scientific image에서는 작은 결절이나 미세한 조직 변화를 인식하는 능력이 중요하다. 현재의 multimodal model은 일반 이미지 이해에는 강해지고 있지만, 이런 특수한 과학 이미지에 대해 훈련된 데이터와 전문적 기준이 부족하다.
예를 들어 폐 결절의 존재 여부나 아주 작은 변화는 일반적인 시각 모델이 쉽게 놓칠 수 있다. 이는 단순한 해상도 문제가 아니라, 어떤 패턴이 의학적으로 의미 있는지 아는 domain-specific observation의 문제다. 인간 과학자나 임상의는 수년간의 훈련을 통해 이런 신호를 읽지만, 현재 모델은 그 수준의 관찰 능력을 안정적으로 갖추지 못했다는 것이 강연자의 진단이다.
따라서 앞으로의 발전 방향은 두 갈래로 나뉜다. 하나는 모델을 과학 이미지와 전문 데이터에 맞게 fine-tuning하거나 조정해 관찰 능력을 높이는 것이고, 다른 하나는 가설 생성 자체를 더 강하게 만드는 것이다. 강연자는 후자에 대해서는 계층적 문제 분해와 test-time compute 확장이 당장 활용 가능한 실용적 기법이라고 본다.
계층 구조는 test-time compute를 과학적으로 쓰는 방법이다
강연자는 Chain-of-Thought가 기존 base model 위에서 더 나은 reasoning을 가능하게 했던 것처럼, 계층적 문제 분해도 현재 모델 위에서 과학적 추론을 강화하는 “트릭”으로 볼 수 있다고 설명한다. 모델이 문제를 자연스럽게 잘 분해하고 compartmentalize할 수 있다면 이런 명시적 장치가 덜 필요해질 수 있지만, 현재 모델에서는 여전히 효과적인 보조 구조가 된다. 특히 장기 연구 문제에서는 단순히 더 많은 토큰을 생성하는 것보다, 어디에 대해 더 많이 생각하게 할 것인지가 중요하다.
계층 구조는 test-time compute를 무작정 늘리는 방식이 아니라, 문제의 각 구성 요소에 reasoning budget을 배분하는 방식이다. 데이터 전처리, architecture, loss, metric, evaluation, operational tooling 등 각각의 층위에서 “무엇을 바꿀 수 있는가”를 묻기 때문에, 생성되는 토큰이 더 구조화된 탐색으로 이어진다. 이는 무작위 아이디어 생산보다 훨씬 연구자다운 탐색 방식에 가깝다.
강연자의 메시지는 결국 자율 에이전트를 과학 연구에 쓰려면 implementation agent로만 보아서는 안 된다는 것이다. 에이전트는 좋은 관찰을 하고, 문제를 나누고, 가설을 만들고, 실험 결과를 비판하고, 다시 다음 가설을 세우는 loop 안에서 작동해야 한다. 현재 모델만으로도 이 모든 것이 완전히 해결된 것은 아니지만, 명시적 계층 분해와 외부 skill 호출을 결합하면 과학 작업에서 더 강한 자율성을 끌어낼 수 있다.
마무리 / 핵심 정리
이 강연의 핵심은 자율 에이전트의 미래가 더 빠른 코드 작성에만 있지 않다는 점이다. 과학 연구에서 정말 어려운 부분은 코드를 실행하는 것이 아니라, 무엇을 시도해야 하는지, 어떤 관찰이 중요한지, 왜 현재 접근이 막혔는지를 판단하는 일이다. Sina Shahandeh는 이 문제를 해결하기 위해 연구 문제를 계층적으로 문서화하고, 각 구성 요소에 대해 명시적으로 가설을 생성하게 하는 방식을 제안한다.
Radicait의 CT-to-PET 사례는 이 주장을 잘 보여준다. 단순한 최적화 루프는 2.5D 모델의 주변을 맴돌 수 있지만, 계층적 사고를 유도하면 3D convolution 같은 더 근본적인 구조 변경을 떠올릴 가능성이 커진다. 또한 image registration처럼 정량 지표만으로 판단하기 어려운 단계에서는 multimodal model과 reasoning model을 루프 안에 넣어 collaborative 또는 adversarial critique를 수행할 수 있다.
결국 자율 과학 에이전트의 발전 방향은 구현 자동화에서 연구 판단 자동화로 이동하고 있다. 현재의 병목은 관찰 능력과 가설의 질이지만, 계층적 분해, test-time compute의 구조적 활용, 전문 skill의 조합은 그 간극을 줄이는 실용적인 방법이 될 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Autonomous Agents for Scientific Tasks - Sina Shahandeh, Radicait |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-19 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.