Back to Basics: Move Semantics
📺 원본 영상: Back to Basics: Move Semantics - Ben Saks - CppCon 2025 🎙️ 채널: CppCon 📅 정리 일자: 2026-03-25 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 코드, 슬라이드, 메모리 다이어그램 등의 시각 자료는 포함되지 않을 수 있습니다.
개요
Ben Saks는 Saxon Associates에서 C/C++ 교육을 담당하는 전문가로, 이 강연에서는 C++의 핵심 기능인 Move Semantics(이동 의미론)을 처음부터 차근차근 설명한다. 단순한 API 사용법을 넘어서, Move Semantics가 왜 필요한지, lvalue(좌값)와 rvalue(우값)이라는 근본 개념이 어떻게 Move의 토대가 되는지, 그리고 std::move를 언제 사용하고 언제 사용하지 말아야 하는지를 명확하게 짚어 준다. 특히 C++17에서 일부 복사 연산이 아예 제거(elision)되는 현대적 맥락까지 다루기 때문에, 기존에 Move Semantics를 단편적으로 이해하고 있던 개발자라면 빠진 퍼즐 조각들을 채울 수 있는 강연이다.
왜 Move Semantics가 필요한가 - 값비싼 복사의 문제
C++에서 복사(copy)는 매우 흔한 연산이다. 정수나 포인터 같은 단순 스칼라 타입이라면 복사 비용이 거의 없지만, 동적으로 할당된 메모리를 내부에 보유한 컨테이너나 문자열 같은 클래스 타입은 사정이 다르다. 이런 타입의 복사는 단순히 데이터 멤버 값을 읽어 오는 것이 아니라, 내부 자원을 통째로 복제하는 심층 복사(deep copy)를 수행해야 하기 때문에 상당한 비용이 따른다.
강연자는 이 문제를 C++03 시절의 swap 함수 템플릿을 예시로 든다.
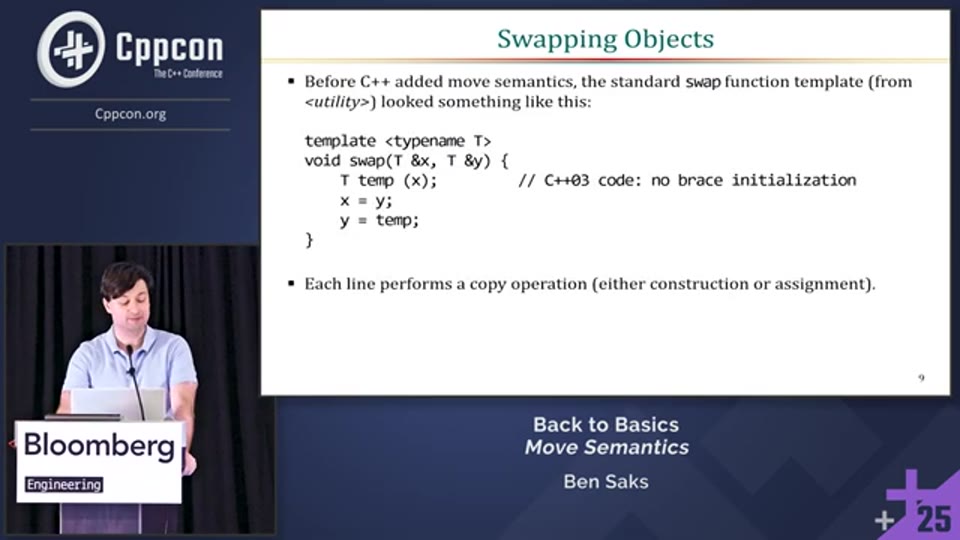
03:36 - C++03 방식의 swap 함수 템플릿 코드 - 세 번의 복사 연산이 발생하는 비효율 시연
이 함수는 내부적으로 임시 객체 temp를 만들어 X의 값을 저장하고, Y를 X로 덮어 쓴 뒤, Y에 temp를 다시 쓰는 세 단계로 구성된다. 정수처럼 단순한 타입이라면 괜찮지만, 내부에 동적 배열을 보유한 문자열 클래스에 이 함수를 적용하면 세 번의 심층 복사가 연속으로 발생한다. 강연자가 원하는 작업은 논리적으로 “X의 값을 Y로, Y의 값을 X로 옮기는 것”인데, 그 과정에서 굳이 메모리 내용 전체를 세 번이나 복제해야 하는 것이다. Move Semantics는 바로 이 낭비를 해결하기 위해 탄생했다.
MyString 클래스 - 심층 복사의 필요성과 한계
강연자는 설명을 위해 동적 배열을 사용하는 간단한 MyString 클래스를 직접 정의한다. 이 클래스는 문자열의 길이를 저장하는 stored_length와 실제 문자들을 보관하는 동적 할당 문자 배열 포인터 actual_str로 구성된다.
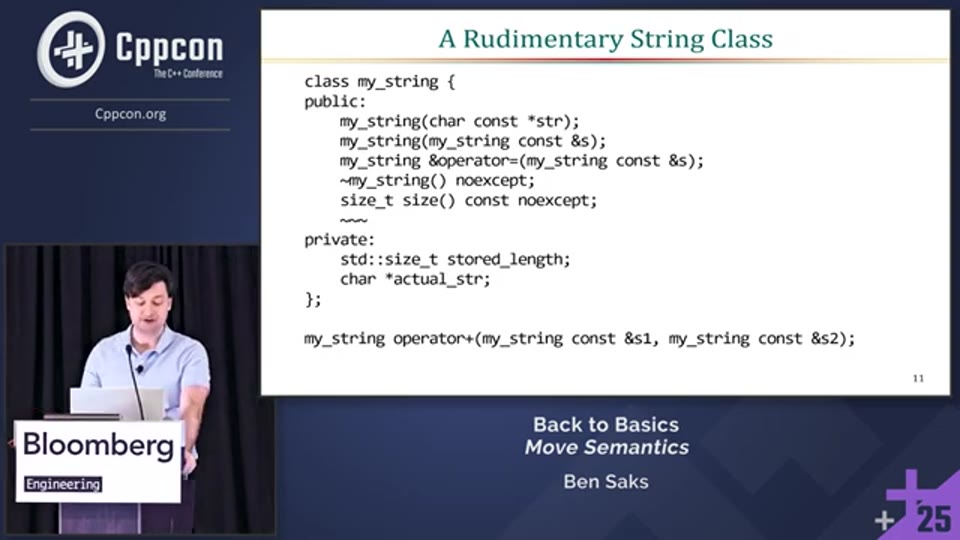
05:03 - MyString 클래스 전체 구조 - stored_length 및 actual_str 동적 배열 포인터 멤버 정의
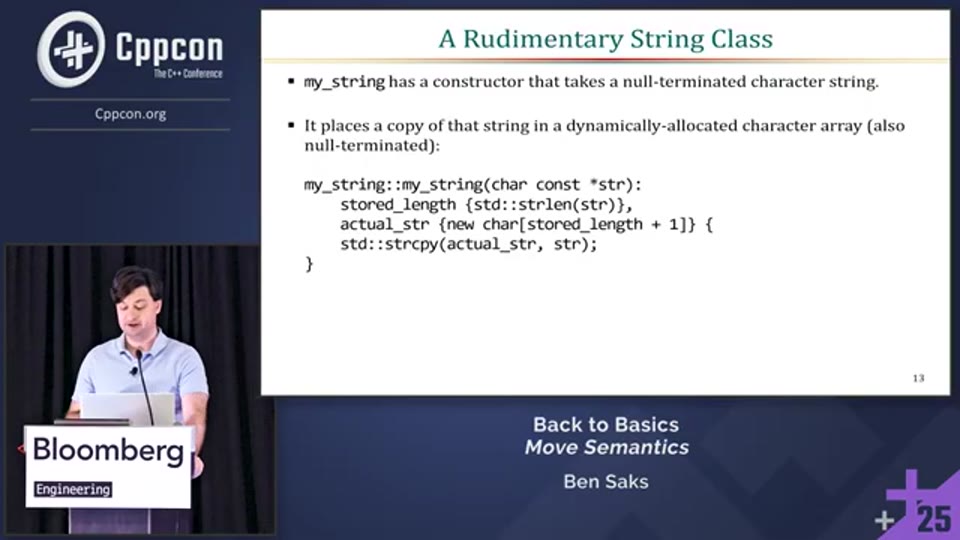
06:54 - S1 = ‘hello’ 생성 시 메모리 구조 다이어그램 - 객체와 동적 배열의 관계 시각화
이 클래스에서 복사 생성자(copy constructor)가 반드시 심층 복사를 수행해야 하는 이유는 소멸자(destructor)에 있다. 만약 두 MyString 객체가 동일한 배열을 가리키는 포인터를 공유하게 되면, 각 객체의 소멸자가 실행될 때 같은 메모리가 두 번 해제(double delete)되어 미정의 동작(undefined behavior)이 발생한다. 따라서 복사 시에는 반드시 새로운 배열을 할당하고 내용을 복제해야 한다. 복사 배정 연산자(copy assignment operator) 역시 마찬가지인데, 배정은 이미 존재하는 객체를 덮어 쓰는 행위이므로 기존에 보유하던 배열을 먼저 해제한 뒤 새 배열을 할당하고 내용을 복제해야 한다.
강연자에 따르면, 이처럼 복사 연산만 구현된 MyString의 경우 operator+ 연산에서 비효율이 드러난다. S3 = S1 + S2를 계산할 때 컴파일러는 우선 임시 MyString 객체에 S1과 S2를 연결한 결과를 담고, 이 임시 객체에서 S3으로 다시 한 번 심층 복사를 수행한다. 그리고 곧바로 임시 객체를 소멸시킨다. 결국 우리는 완성된 문자열을 S3에 넣기 위해 정성껏 복사를 수행했음에도, 원본인 임시 객체는 즉시 버려진다. 이 과정이 Move Semantics가 해결하고자 하는 핵심 비효율이다.
lvalue와 rvalue - Move의 이론적 토대
Move Semantics를 구현하고 올바르게 사용하기 위해서는 lvalue(좌값)와 rvalue(우값)의 개념을 정확히 이해해야 한다. 강연자는 이 용어가 C++ 이전에 C에서, 더 정확히는 Kernighan & Ritchie의 C 교과서에서 비롯되었음을 설명한다. 원래 lvalue란 배정식 E1 = E2의 왼쪽에 올 수 있는 표현식, 즉 쓰기 가능한 메모리 위치를 가진 표현식을 뜻했다.
예를 들어 int n; n = 1;에서 n은 lvalue이고 1은 rvalue다. n은 메모리에 특정 주소가 할당되어 있고 새 값을 저장할 수 있지만, 정수 리터럴 1은 메모리에 고정된 집이 없으며 어딘가에 새 값을 배정받는 것이 의미 없다. 더 복잡한 표현식도 마찬가지인데, x[i+1]처럼 첨자 연산자(subscript operator)가 반환하는 것은 lvalue지만, abs(p->value)처럼 단순히 값을 반환하는 함수 호출은 rvalue다.
그러나 이 정의는 시간이 지나면서 한계를 드러냈다. const int max = 100;처럼 const로 선언된 객체는 메모리에 고정된 주소를 갖고 있어 &max로 주소를 취할 수 있다. 하지만 배정의 왼쪽에는 올 수 없다. 강연자는 이를 “수정 불가능한 lvalue(non-modifiable lvalue)“라고 부른다. 반면 열거형 상수 blue는 주소가 없기 때문에 진정한 rvalue다. 결국 현대 C++에서 lvalue는 “주소를 취할 수 있는 표현식”, rvalue는 “주소를 취할 수 없는 표현식”으로 이해하는 것이 더 정확하다.
한편 rvalue도 클래스 타입일 수 있다. S1 + S2처럼 값을 반환하는 함수 호출이나 함수 스타일의 타입 변환 표현식은 클래스 타입의 rvalue를 만들어 낸다. 이러한 클래스 타입 rvalue에 멤버 함수를 호출하면, 컴파일러는 내부적으로 임시 객체를 메모리에 실체화(materialize)하는 “임시 실체화 변환(temporary materialization conversion)“을 수행한다. 이 임시 객체는 잠깐 동안 주소를 가지지만, 해당 표현식의 수명이 끝나는 즉시 소멸된다.
lvalue 참조와 rvalue 참조
C++에서 포인터와 참조(reference)는 lvalue를 가리키거나 바인딩하는 것이 기본이다. T*나 T&는 모두 lvalue인 T 타입 객체에만 바인딩된다. 이 규칙에 한 가지 예외가 있는데, const T&(const lvalue 참조)는 T 타입이 아니거나 rvalue인 표현식에도 바인딩될 수 있다. 이 경우 컴파일러는 변환된 값을 담는 임시 객체를 만들어 참조를 그 임시 객체에 바인딩하며, 해당 참조의 수명이 다할 때 임시 객체도 함께 소멸된다.
Move Semantics의 핵심 도구는 C++11이 도입한 **rvalue 참조(rvalue reference)**다. 단일 앰퍼샌드(&) 대신 이중 앰퍼샌드(&&)로 선언하며, rvalue에만 바인딩된다는 점이 lvalue 참조와의 결정적 차이다. rvalue 참조를 const로 만들 수는 있지만, 이는 거의 쓸모가 없다. Move 연산의 본질이 원본 객체를 수정하는 것이기 때문이다.
// 재구성된 코드 예시 - 원본 코드는 영상에서 확인 필요
int&& ri = 10;  // rvalue 참조: 임시 객체가 실체화되어 ri에 바인딩
// int& lri = 10;  // 컴파일 오류: lvalue 참조는 rvalue에 바인딩 불가
💡 [영상 참조] 강연자는
[30:11]시점에서 rvalue 참조 선언 코드를 슬라이드로 보여 줍니다. 📺 원본 영상에서 확인하세요.
Move Constructor와 Move Assignment Operator 구현
MyString 클래스에 Move Semantics를 부여하는 방법은 rvalue 참조를 매개변수로 받는 생성자와 배정 연산자를 추가하는 것이다.
Move 생성자(move constructor)는 rvalue 참조 MyString&&를 인자로 받는다. 복사 생성자처럼 새 배열을 할당하고 내용을 복제하는 대신, 원본 객체(이하 s)가 보유하던 포인터를 그대로 새 객체로 가져온다. 여기서 결정적으로 중요한 단계가 하나 있는데, s의 내부 포인터를 즉시 nullptr로 설정해야 한다는 것이다. s의 소멸자는 여전히 나중에 실행될 것이며, 소멸자가 s의 내부 포인터를 delete하려 할 때 nullptr를 삭제하는 것은 아무런 효과가 없으므로 안전하다.
강연자의 설명에 따르면, 복사 생성자는 const T&(const lvalue 참조)를 받고, Move 생성자는 T&&(non-const rvalue 참조)를 받는다는 것이 패턴의 핵심이다. non-const인 이유는, rvalue임을 인식한다는 것이 곧 “이 객체는 곧 소멸될 것이므로 파괴해도 괜찮다”는 허가를 의미하기 때문이다. Move 연산은 때로 “파괴적 복사(destructive copying)“라고 불리기도 하는데, 값을 새 위치로 옮기는 과정에서 원본의 내부 상태를 훼손하기 때문이다.
Move 배정 연산자(move assignment operator) 역시 같은 원칙으로 구현된다. 차이점은 배정 대상 객체가 이미 존재하므로, 자기 배정(self-assignment) 여부를 먼저 확인하고 기존에 보유하던 배열을 해제한 뒤 원본의 포인터를 가져와야 한다는 것이다. 반환 값은 lvalue 참조 T&인데, 배정의 대상 객체는 항상 lvalue이기 때문이다.
// Move 생성자 - 재구성된 코드 예시
MyString(MyString&& s)
    : stored_length(s.stored_length), actual_str(s.actual_str)
{
    s.actual_str = nullptr;  // 원본 포인터 무효화
}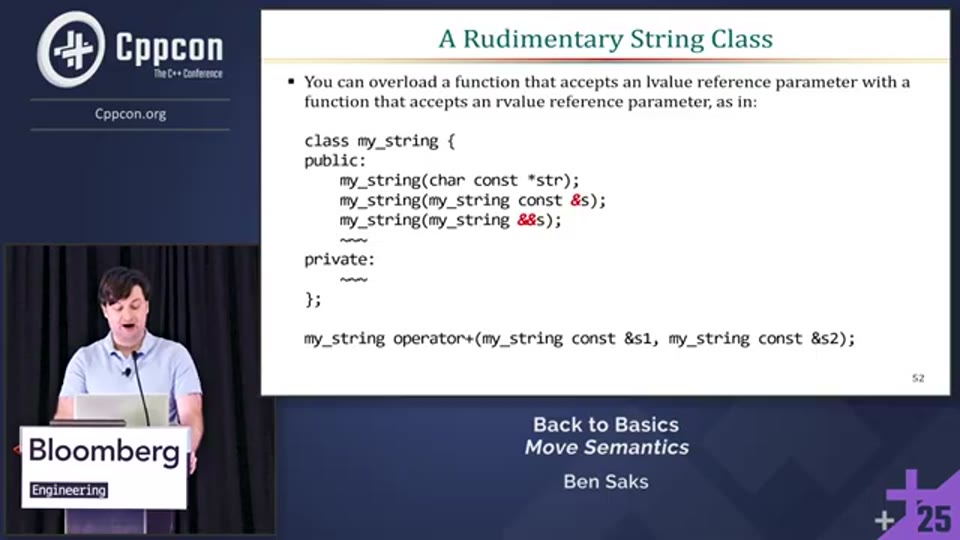
32:14 - MyString의 Move 생성자 구현 코드 - actual_str 포인터 이전 및 nullptr 설정
// Move 배정 연산자 - 재구성된 코드 예시
MyString& operator=(MyString&& s) {
    if (this != &s) {
        delete[] actual_str;          // 기존 배열 해제
        stored_length = s.stored_length;
        actual_str = s.actual_str;
        s.actual_str = nullptr;       // 원본 포인터 무효화
    }
    return *this;
}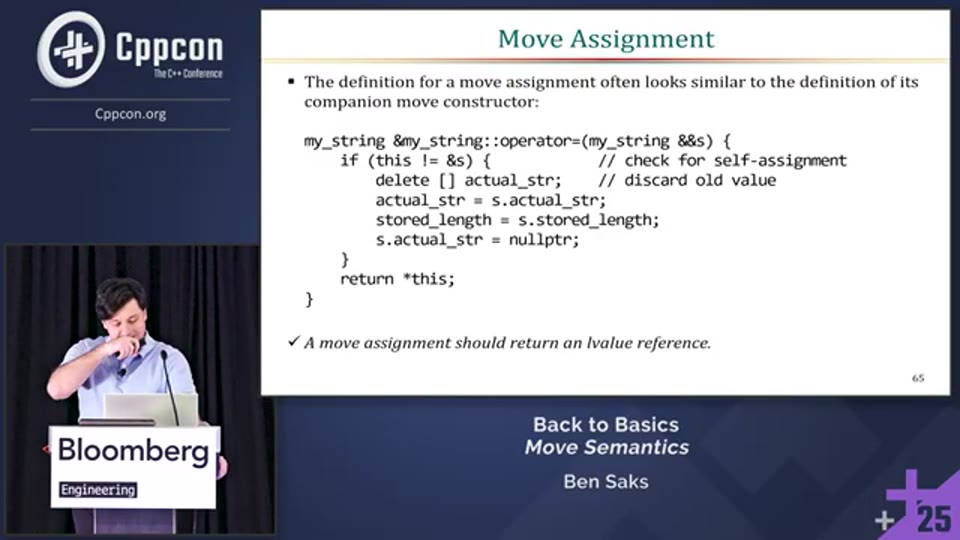
42:32 - MyString의 Move 배정 연산자 구현 코드 - 자기 배정 검사, 기존 배열 해제, 포인터 이전
이처럼 복사 연산과 Move 연산을 모두 구현하면, 컴파일러는 오버로드 해소(overload resolution)를 통해 원본 객체가 lvalue일 때는 복사 연산을, rvalue(임시 객체)일 때는 Move 연산을 자동으로 선택한다. 강연자는 Move 생성자와 Move 배정 연산자를 거의 항상 함께 선언해야 한다고 강조한다. 하나만 필요한 경우는 극히 드물다.
std::move - lvalue를 rvalue로 바꾸는 힌트
Move 생성자와 Move 배정 연산자를 구현했다고 해서 모든 상황에서 Move가 자동으로 선택되는 것은 아니다. C++에는 중요한 규칙이 하나 있는데, “이름이 있으면 lvalue다”는 것이다. 변수는 이름이 있기 때문에, 설령 프로그래머가 그 변수에서 Move하고 싶어도 컴파일러는 이를 lvalue로 보고 복사 연산을 선택한다.
앞서 살펴본 swap 함수가 대표적인 예다. swap 함수 내부에서 x와 y는 명확한 이름을 가진 변수이므로 lvalue다. 따라서 Move 연산을 구현했더라도 컴파일러는 기본적으로 복사를 선택한다. 이때 프로그래머가 컴파일러에게 “이 lvalue에서 Move해도 안전하다”는 힌트를 주기 위한 도구가 바로 std::move다.
// std::move를 사용한 swap - 재구성된 코드 예시
template<typename T>
void swap(T& x, T& y) {
    T temp = std::move(x);
    x = std::move(y);
    y = std::move(temp);
}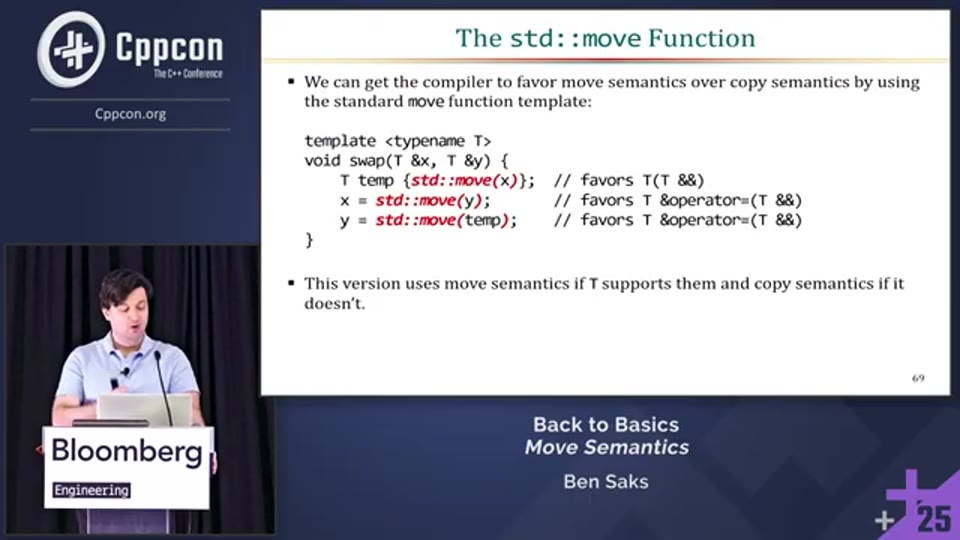
46:12 - std::move를 적용한 swap 함수 - 세 번의 Move 연산으로 복사 없이 교환
std::move(x)가 실제로 하는 일은 x를 rvalue 참조로 캐스팅해 반환하는 것이다. 함수의 반환 값은 이름이 없기 때문에 rvalue가 되고, 컴파일러는 Move 연산을 선택한다. 강연자는 이 함수의 이름이 다소 오해를 불러일으킬 수 있다고 언급한다. std::move는 실제로 무언가를 “이동”하지 않는다. 단지 이후 코드가 해당 객체에서 Move를 수행할 수 있도록 권한을 부여할 뿐이다. 만약 다시 명명할 기회가 있다면 make_movable 같은 이름이 더 정확할 것이라고 강연자는 말한다.
한 가지 중요한 함정이 있다. rvalue 참조를 매개변수로 받는 함수 내부에서 그 매개변수는 다시 lvalue로 취급된다. 이름이 있기 때문이다. 따라서 해당 함수 안에서 Move를 수행하려면 다시 한 번 std::move를 명시적으로 호출해야 한다. 그리고 그 호출은 반드시 해당 변수를 사용하는 마지막 지점이어야 한다. 이후로는 Move된 객체의 상태를 알 수 없기 때문이다.
NRVO와 Copy Elision - std::move를 쓰지 말아야 할 때
강연의 후반부는 std::move를 쓰는 것이 오히려 역효과를 낼 수 있는 상황을 다룬다. 바로 함수의 반환문(return statement)이다.
강연자에 따르면, 함수 내 지역 변수나 매개변수를 반환 표현식으로 사용하면 컴파일러는 암묵적으로 Move를 고려한다. return temp;처럼 지역 객체를 직접 반환하면, 컴파일러는 temp가 이 시점 이후로 사용되지 않음을 알고 Move 연산을 선택할 수 있다. 하지만 C++17부터는 이것보다 더 강력한 최적화가 보장된다.
**Named Return Value Optimization(NRVO, 지명 반환 값 최적화)**이 그것인데, 컴파일러가 함수 내 지역 객체를 처음부터 반환 값이 저장될 위치, 즉 호출하는 쪽(caller)의 메모리 위치에 직접 생성하는 기법이다. 이 경우 반환 시 복사도 Move도 전혀 발생하지 않는다. 값이 처음부터 올바른 위치에 있기 때문이다. C++17 이전에는 이것이 컴파일러의 선택적 최적화(optional optimization)였지만, C++17부터는 특정 상황에서 필수(mandatory)가 되었다.
강연자는 여기서 결정적인 경고를 한다. 반환 표현식에 std::move를 명시적으로 추가하면 NRVO가 적용되지 않을 수 있다. NRVO는 반환 표현식이 지역 변수의 이름 그 자체일 때만 적용된다. return std::move(temp);처럼 작성하면 반환 표현식은 더 이상 temp라는 이름이 아니라 std::move의 반환 값이 된다. 결과적으로 컴파일러는 NRVO를 포기하고 Move 생성자를 통해 별도의 위치에 값을 복사한다. 친절하게 Move를 유도하려는 코드가 오히려 더 비효율적인 경로를 강제하는 셈이다.
// NRVO가 적용되는 좋은 예 - 재구성된 코드 예시
MyString g() {
    MyString temp;
    // ... temp를 구성하는 작업
    return temp;  // ✅ NRVO 가능: 컴파일러가 copy/move를 생략할 수 있음
}

// NRVO를 방해하는 나쁜 예 - 재구성된 코드 예시
MyString g() {
    MyString temp;
    // ... temp를 구성하는 작업
    return std::move(temp);  // ❌ NRVO 불가: Move 생성자가 강제로 호출됨
}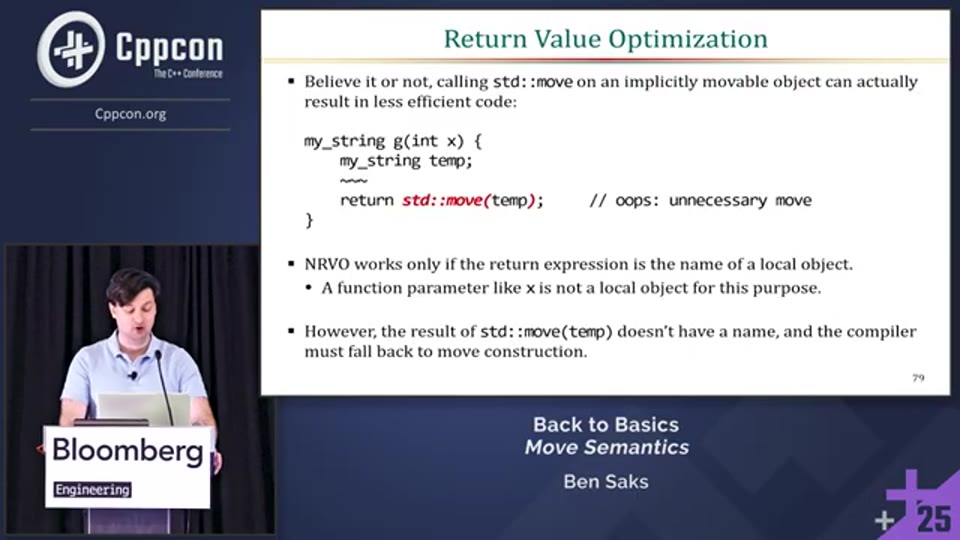
54:24 - return std::move(temp)가 NRVO를 방해하는 이유 설명 슬라이드 - G 함수 반환 예시
Q&A - Move 이후 객체의 상태
강연 후 청중 질의에서 중요한 내용이 추가로 다루어졌다. 한 청중은 Move 배정 연산자 실행 후 원본 객체(매개변수 s)의 상태에 대해 질문했다. 강연자는 이에 동의하며 명확히 설명했다.
Move 생성이나 Move 배정이 완료된 이후, Move된 원본 객체는 “유효하지만 비특정 상태(valid but unspecified state)“에 놓인다. 이는 메모리 누수나 미정의 동작이 없다는 의미에서는 안전하지만, 그 객체가 특정 값을 보유하고 있다고 가정할 수 없다는 뜻이다. 따라서 Move된 객체에 대해 출력(std::cout << s1)과 같은 작업을 수행하면 의도치 않은 동작이 발생할 수 있다. 강연자는 Move된 객체의 다음 행위는 새 값을 배정하거나 스코프를 벗어나 소멸되는 것이어야 한다고 강조했다.
또 다른 청중은 const T&로 참조를 받으면 임시 객체의 수명이 연장되는 현상을 질문했다. 강연자는 이를 확인하면서, 수명 연장은 원본 참조에 직접 바인딩된 경우에만 적용되며, 참조에서 파생된 다른 참조로 체인을 만들면 수명 연장이 보장되지 않아 해제된 메모리를 참조하는 위험한 상황이 발생할 수 있다고 경고했다. 이는 C++에서 흔히 발생하는 객체 수명(object lifetime) 관련 함정 중 하나다.
마무리 - 핵심 정리
Move Semantics는 C++의 성능 최적화에 있어 매우 강력한 도구지만, 그 힘을 올바르게 활용하려면 기초 개념을 탄탄히 이해해야 한다. 강연자가 강조한 핵심을 정리하면 다음과 같다.
Move Semantics의 기반은 lvalue와 rvalue의 구분이다. 이름이 있으면 lvalue이고, 이름 없는 임시 객체는 rvalue다. rvalue 참조(&&)는 이 rvalue에만 바인딩되며, Move 생성자와 Move 배정 연산자는 이를 매개변수 타입으로 활용해 컴파일러가 복사 대신 Move를 선택하도록 유도한다.
std::move는 lvalue를 rvalue로 취급하도록 컴파일러에게 힌트를 주는 캐스팅 도구이며, 실제 이동을 수행하지는 않는다. swap처럼 lvalue에서 명시적으로 Move가 필요한 상황에서는 반드시 사용해야 하지만, 함수 반환문에서는 NRVO를 방해할 수 있으므로 std::move를 추가하는 것이 오히려 역효과다. 컴파일러를 믿고 지역 변수의 이름을 그대로 반환하는 것이 C++17 이후에는 최선이다.
마지막으로, Move된 객체의 상태는 불특정하므로 Move 이후에는 해당 객체를 다시 사용하지 않거나 새 값을 배정해야 한다. Move Semantics를 통해 불필요한 심층 복사를 제거하면 특히 컨테이너나 문자열처럼 내부 자원을 관리하는 타입에서 눈에 띄는 성능 향상을 얻을 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Back to Basics: Move Semantics - Ben Saks - CppCon 2025 |
| 채널 | CppCon |
| 강연자 | Ben Saks (Saxon Associates) |
| 리포트 작성 | 2026-03-25 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 화면에 표시된 코드와 메모리 다이어그램은 STT 특성상 포함되지 않으므로, 정확한 코드는 원본 영상을 참조해 주세요.
Related Reports
- Lightning Talk - std::move & Spirited Away - When Nameless Objects Walk the Spirited World
- C++ Performance Tips - Cutting Down on Unnecessary Objects - Prithvi Okade & Kathleen Baker - CppCon
- Lightning Talk - But I was doing the right thing! - Andrei Zissu - CppCon 2025
- Lightning Talk - Can set_value Actually Throw? - Robert Leahy - CppCon 2025