Beyond Code Coverage: Playwright로 기능 테스팅하기
📺 원본 영상: Beyond Code Coverage: Functionality Testing with Playwright — Marlene Mhangami, Microsoft 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-17 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Microsoft와 GitHub의 Senior Developer Advocate인 Marlene Mhangami는 이 강연에서 AI 코딩 도구의 급격한 확산이 오히려 코드 품질을 위협할 수 있다는 역설적인 현실을 데이터로 제시한다. 이를 해결하기 위해 그녀는 전통적인 TDD(Test-Driven Development)의 한계를 짚고, Microsoft가 개발한 오픈소스 테스팅 프레임워크 Playwright를 활용해 코드 커버리지가 아닌 실제 기능(Functionality) 을 검증하는 새로운 개발 방법론을 소개한다.
AI가 만들어낸 코드의 홍수, 그리고 품질이라는 질문
강연은 GitHub의 성장 통계에서 시작한다. 2025년 GitHub Octoverse 리포트에 따르면, 2025년 한 해 동안 GitHub에 약 10억 건의 커밋이 푸시되었으며 이는 GitHub 역사상 가장 활발한 해였다. 그런데 2026년 현재, 이 성장세는 더욱 가팔라지고 있다. GitHub CEO Kyle Daigle이 공개한 수치에 따르면, 현재 플랫폼에는 매주 약 2억 7,500만 건의 커밋이 쌓이고 있으며, 이를 연간으로 환산하면 약 140억 건에 달한다. 이는 전년도 대비 14배에 이르는 수치다.
이 폭발적 성장의 상당 부분에는 AI 에이전트의 기여가 있다. 강연자는 Claude와 같이 커밋에 공동 서명(co-sign)하는 에이전트나, 코드 내 특정 패턴 추적을 통해 AI가 작성한 코드를 실제로 식별할 수 있다고 밝혔다. 그러나 강연자가 던지는 핵심 질문은 단순하다. “이 모든 코드의 증가가 실제로 개발자 생산성을 높이고 있는가?”
Stanford 연구가 보여주는 불편한 진실
이 질문에 답하기 위해 강연자는 Stanford University가 12만 명의 개발자를 대상으로 진행한 연구 결과를 인용한다.
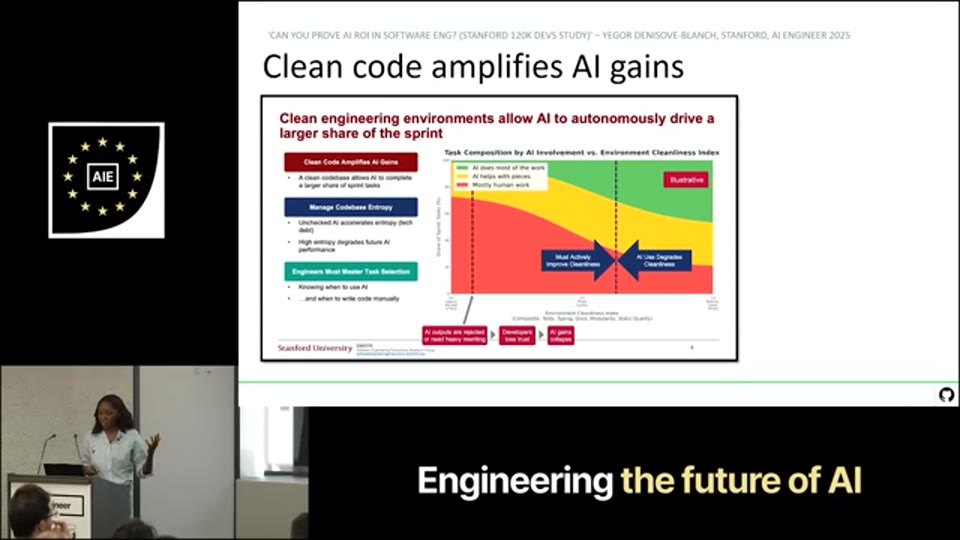
02:38 - Stanford University 12만 개발자 연구 결과 그래프 - 클린 코드베이스에서의 AI 생산성 증폭 vs 무분별한 AI 사용 시 엔트로피 증폭
이 연구의 결론은 이렇다. AI는 분명히 개발자를 더 생산적으로 만들 수 있다. 그러나 어떻게 사용하느냐가 결과를 가른다. 구체적으로, 클린 코드베이스(clean codebase)에서 AI를 활용할 경우 AI의 생산성 향상 효과가 증폭되는 반면, AI를 검증 없이 코드베이스에 투입하면 오히려 엔트로피(entropy)를 증폭시킨다는 것이다.
강연자가 소개한 사례 연구는 이 점을 더욱 생생하게 보여준다. AI를 무분별하게 도입한 한 팀은 PR(Pull Request) 수가 증가했음에도 불구하고 코드 품질이 저하되었고, 결국 리워크(rework)와 리팩터링에 더 많은 시간을 쏟아야 했다. 그 결과 실질적인 생산성 향상은 약 1%에 그쳤다. AI 코딩이 가져다주는 가치는 개발자가 좋은 테스트 커버리지, 타입 커버리지, 문서화, 모듈화와 같은 코드 위생을 유지할 때 비로소 실현된다는 것이 연구의 핵심 메시지다.
TDD의 부활, 그리고 붉은 신호등에서 시작하는 개발
클린 코드베이스를 유지하는 방법으로 강연자가 주목하는 것은 TDD(Test-Driven Development), 그중에서도 Red-Green-Refactor 사이클이다. Simon Willison과 같은 저명한 개발자들이 에이전트 코딩(agentic coding)과 함께 이 방식을 적극 활용하고 있다고 강연자는 소개한다.
Red-Green-Refactor TDD의 흐름은 이렇다. 먼저 기능 요청이 들어오는 순간, 개발자는 코드를 작성하기 전에 실패하는 테스트부터 작성한다(Red 단계). 해당 기능이 아직 없으므로 테스트는 당연히 실패한다. 다음으로 Green 단계에서는 코드 품질에 연연하지 않고 오로지 테스트를 통과시키는 데 집중한다. 과거라면 Stack Overflow에서 코드를 복사해오는 것도 이 단계에서는 허용된다. 마지막 Refactor 단계에서야 비로소 코드 품질, 모범 사례, 구조적 정합성을 따진다. 이 세 단계의 선명한 분리가 TDD를 강력하게 만드는 핵심이다.
코드 커버리지의 함정: 테스트가 많다고 안전한 게 아니다
그러나 TDD가 만능은 아니다. 2014년에도 TDD는 한 차례 “사망 선고”를 받은 바 있다. Rails를 만든 DHH(David Heinemeier Hansson)는 이 시기에 TDD의 단점을 공개적으로 비판하는 블로그 포스트를 게재했는데, 그 핵심은 단위 테스트(unit test)에 과도하게 집중한 나머지 실제 시스템을 검증하지 못한다는 것이었다.
코드 커버리지에만 집중할 때 발생하는 가장 큰 문제는 구현 세부사항(implementation detail)을 테스트하는 경향이다.
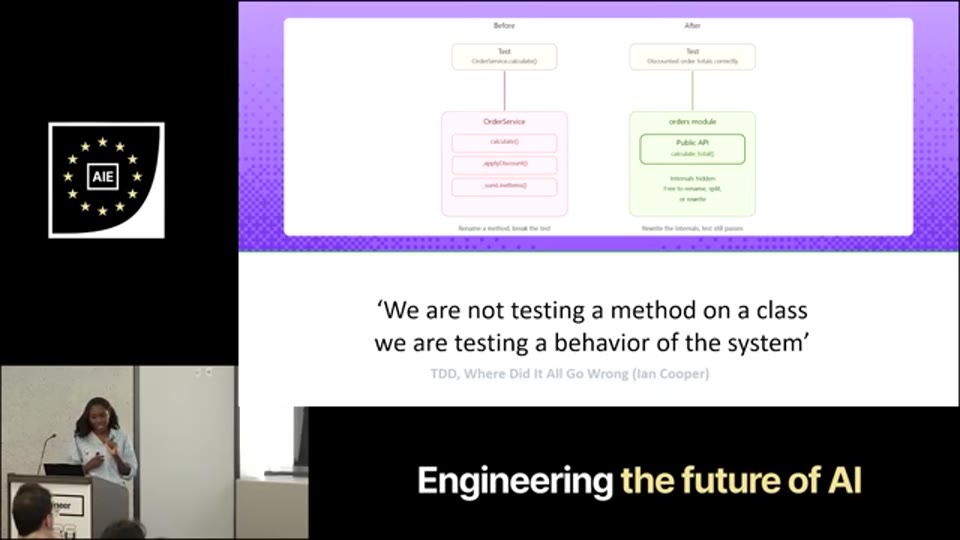
06:49 - 구현 세부사항을 테스트하는 안티패턴 코드 예시 - 할인 적용 주문 계산 코드에서 메서드명 변경 시 테스트가 깨지는 문제
예를 들어, 어떤 테스트가 calculate라는 메서드 이름에 직접 의존하고 있다면, 기능은 완벽하게 동작하더라도 메서드 이름 하나만 바꿔도 테스트 전체가 깨져버린다. 이상적인 테스트는 메서드명이나 내부 구현이 아니라, 시스템의 최종 동작 결과(behavior) 를 검증해야 한다. 즉, 최종 가격이 올바른가, 외부에 노출되는 API나 모듈이 계약(contract)을 지키는가를 테스트해야 내부 리팩터링에도 테스트가 살아남는다. 강연자는 이 주제를 더 깊이 탐구하고 싶다면 Ian Cooper의 강연 “TDD, Where Did It All Go Wrong”을 추천했다.
AI 시대에 이 문제는 더욱 심각해진다. 많은 개발자들이 AI로 테스트를 자동 생성하고 있는데, AI가 생성한 테스트는 자기 확인형(self-affirming) 이 되는 경향이 있다. 즉, 단위 테스트는 모두 초록색으로 통과하지만, 실제 시스템이 사용자가 기대하는 대로 동작하는지는 전혀 검증되지 않는 것이다.
Playwright: 행동 기반 기능 테스팅의 열쇠
강연의 본론은 바로 이 지점에서 시작한다. 강연자가 제안하는 해결책은 Microsoft가 개발한 오픈소스 테스팅 프레임워크 Playwright다.
💡 [영상 참조] 강연자는 이 시점에서 Playwright 공식 문서 화면과 예시 테스트 코드를 보여줍니다. 📺 원본 영상에서 확인하세요.
Playwright는 브라우저에서 사용자 상호작용을 시뮬레이션함으로써 End-to-End(E2E) 테스팅을 자동화한다. 현재 Python, TypeScript, C#을 비롯한 다양한 언어를 지원하며, 테스트 스크립트는 직관적이다. 예를 들어, page.goto()로 시작 페이지를 지정하고, 검색창 플레이스홀더를 찾아 “Furby”라는 단어를 입력하면 브라우저가 자동으로 검색을 실행한다. 또한 브라우저를 화면에 띄우지 않고 백그라운드에서만 실행하는 헤드리스 모드(headless mode) 도 지원한다.
Playwright가 강력한 이유는 단위 테스트와 달리 실제 사용자 관점에서 시스템의 기능이 올바르게 동작하는지를 직접 검증하기 때문이다. 메서드명이나 내부 구현이 어떻게 바뀌든, 최종적으로 사용자가 검색창에 입력하면 결과가 나오고, 필터를 클릭하면 필터링이 되는지를 검증한다. 이는 앞서 언급한 코드 커버리지의 함정을 정면으로 돌파하는 접근법이다.
AI와 Playwright의 결합: TDD를 다시 빠르게 만들다
TDD의 오랜 불만 중 하나는 속도다. 테스트를 먼저 작성하고, 실패를 확인하고, 코드를 짜고, 리팩터링하는 사이클은 빠른 출시를 원하는 팀에게 부담이었다. 그러나 AI 코딩 에이전트를 결합하면 이 방정식이 달라진다.
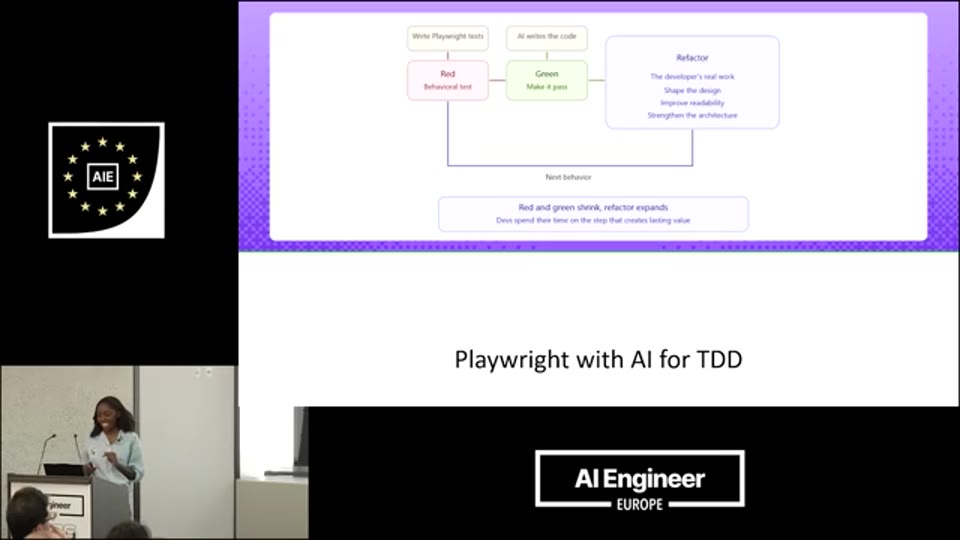
09:21 - AI와 결합된 Red-Green-Refactor TDD 사이클 다이어그램 - Red/Green 단계는 AI 에이전트가 빠르게 처리하고, Refactor 단계에 개발자가 집중하는 구조
강연자의 모델에서 AI 에이전트는 Red 단계(실패하는 Playwright 테스트 작성)와 Green 단계(테스트를 통과시키는 코드 생성)를 빠르게 처리한다. 개발자는 이 두 단계를 에이전트에게 맡기고, 자신은 가장 중요한 Refactor 단계에 가장 많은 시간을 투자한다. 에이전트가 생성한 코드를 검토하고, 품질을 높이고, 모범 사례를 적용하는 것이 개발자의 역할로 재정의되는 것이다.
코딩 에이전트와 Playwright 연결하기
현재 코딩 에이전트와 Playwright를 연결하는 방법은 크게 세 가지다.
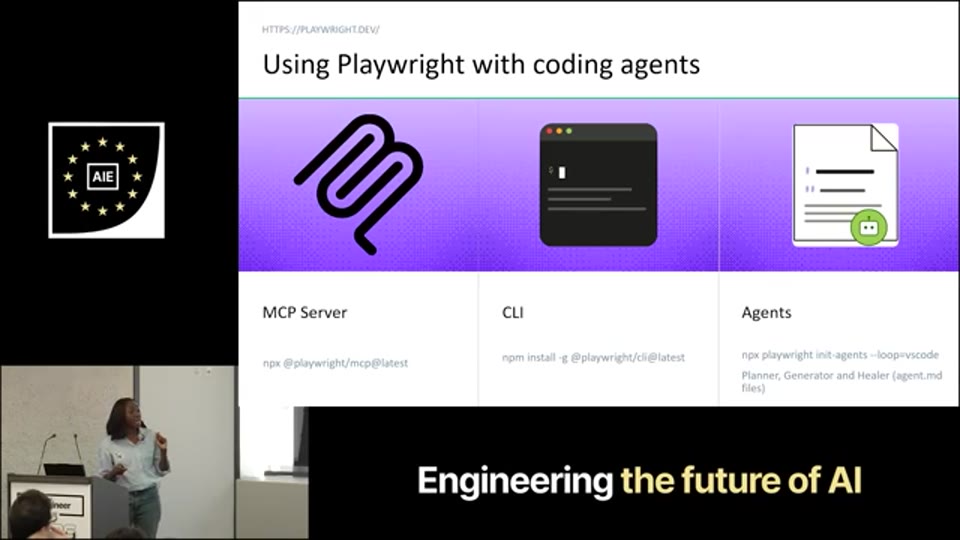
10:17 - 코딩 에이전트와 Playwright를 연결하는 세 가지 방법(MCP 서버, CLI, Playwright Agents) 소개 슬라이드
첫째는 Playwright MCP(Model Context Protocol) 서버를 활용하는 방식으로, 에이전트가 MCP를 통해 Playwright를 직접 제어한다. 둘째는 CLI 도구를 직접 사용하는 방식이다. 셋째이자 강연자가 특히 추천하는 방식은 Playwright Agents다. 특정 명령어를 실행하면 세 가지 AGENTS.md 파일이 설치된다. Planner는 어떤 테스트를 실행할지 계획하고, Generator는 실제 테스트를 생성하며, Healer는 실패한 테스트를 수정한다. 이 세 에이전트의 협업이 자동화된 TDD 사이클을 완성한다.
라이브 데모: Tailspin Toys 검색 기능 구현
강연자는 GitHub Copilot CLI를 사용한 라이브 데모를 통해 이 방법론을 직접 보여주었다. 시나리오는 가상의 장난감 회사 “Tailspin Toys”의 개발자가 검색 및 필터 기능을 추가하는 것이다. 구체적으로 단순 검색을 위한 틱(Tic) 검색 바와 복잡한 검색을 위한 Azure Search, 그리고 카테고리와 가격으로 필터링하는 사이드바를 추가하는 작업이다.
흥미로운 점은 기능 요청의 출발점이다. 강연자는 WorkIQ라는 Microsoft의 M365 통합 스킬을 활용해 Outlook에 수신된 제품 관리팀의 이메일 내용을 터미널로 직접 가져왔다. 기존 TDD에서 테스트 작성의 트리거가 새로운 메서드 추가였다면, 이 새로운 방식에서는 기능 요청(feature request) 자체가 테스트 작성의 트리거가 된다.
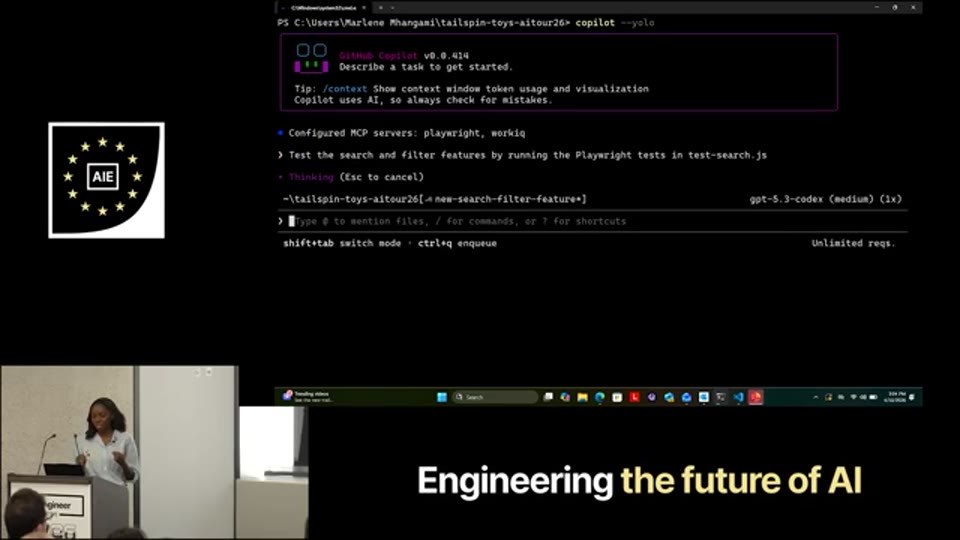
14:42 - Playwright가 브라우저를 자동 제어하며 검색창 입력(Furby, Simon), 카테고리 필터 클릭, 가격 범위 필터링을 순서대로 테스트하는 화면
데모에서 에이전트는 먼저 코드베이스를 분석하고, Playwright MCP 서버를 통해 실패하는 테스트를 작성했다. 이후 코드를 생성해 테스트를 통과시켰고, 최종적으로 강연자가 Playwright 테스트를 직접 실행했다. 브라우저가 자동으로 열리며 검색창에 “Furby”를 입력하고, “Simon”을 검색하고, 카테고리 버튼을 클릭하고, 특정 가격 범위의 장난감을 필터링하는 모든 동작이 강연자의 키보드 개입 없이 자동으로 실행되었다. 모든 기능 테스트가 통과했다. 강연자가 강조한 것처럼, 이 방식은 “에이전트가 코드를 생성했고, 그 코드가 내가 기대하는 대로 실제로 동작한다”는 사실을 눈으로 직접 확인하게 해준다.
Playwright 모범 사례
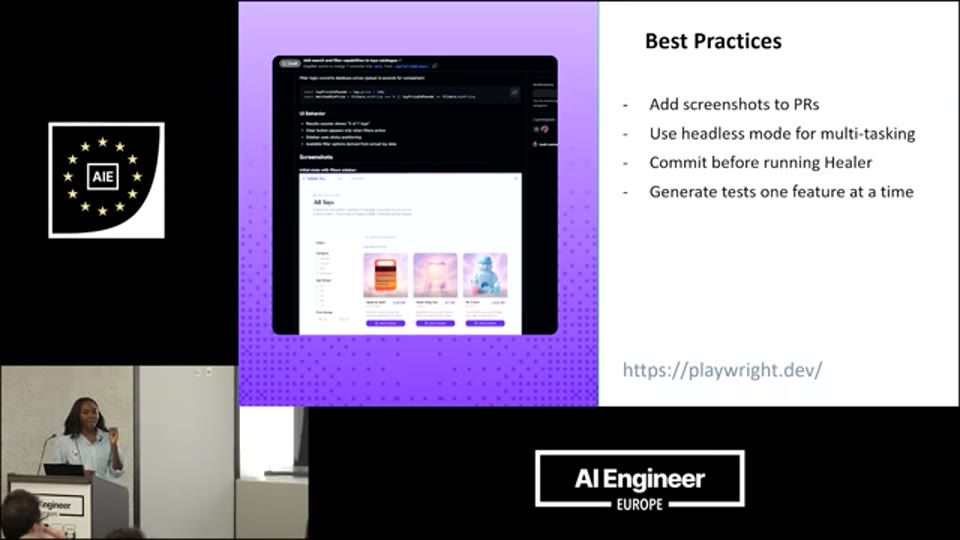
16:19 - Playwright 모범 사례 슬라이드 - 스크린샷을 PR에 첨부, 헤드리스 모드 활용, 코드 수정 전 커밋, 기능당 하나의 테스트 원칙
강연자는 마지막으로 실무에서 바로 적용할 수 있는 몇 가지 모범 사례를 공유했다.
첫째, Playwright는 기능 테스트를 실행할 때마다 스크린샷을 자동으로 캡처한다. 강연자는 이 스크린샷을 PR(Pull Request)에 첨부하는 습관을 들이라고 권장했다. 코드 변경 사항에 대한 시각적 증거가 코드 리뷰의 품질을 높이기 때문이다. 둘째, 앞서 언급한 헤드리스 모드를 활용하면 브라우저를 화면에 띄우지 않고도 CI/CD 파이프라인에서 테스트를 자동 실행할 수 있다. 셋째, 매우 중요한 실용적 조언으로, 에이전트가 코드 수정을 시작하기 전에 반드시 현재 상태를 커밋해두어야 한다. 에이전트가 맥락을 잃으면 이전에 어떤 일이 있었는지 기억하지 못하는 경우가 있기 때문이다. 넷째, 테스트는 기능 단위로 하나씩 생성하는 것이 관리 측면에서 유리하다. 하나의 기능에 하나의 테스트를 원칙으로 삼으면 추적과 디버깅이 용이해진다.
Q&A에서 상태 관리(state management)가 복잡한 애플리케이션에서 Playwright를 어떻게 쓸 수 있냐는 질문에 강연자는 앞서 소개한 Playwright Agents 방식을 추천했다. AGENTS.md 파일에 상태 관리와 관련된 특수한 지침이 내장되어 있어 복잡한 상황을 더 잘 처리할 수 있다는 것이다. 또한 Playwright는 현재 브라우저 기반 테스팅에 최적화되어 있으며, 모바일과 데스크톱 환경 간 차이도 검증할 수 있다.
마무리: 클린 코드베이스가 AI 생산성의 선결 조건이다
이 강연의 핵심 메시지를 한 문장으로 압축하면 이렇다. AI가 더 많은 코드를 빠르게 만들어주는 시대일수록, 그 코드가 실제로 올바르게 작동하는지 검증하는 일이 더 중요해진다. 코드 커버리지 숫자나 단위 테스트 통과 여부는 이 질문에 충분한 답을 주지 못한다. Playwright는 브라우저를 통해 실제 사용자의 관점에서 시스템이 의도한 대로 동작하는지를 검증함으로써, AI 에이전트가 생성한 코드의 품질을 보증하는 마지막 안전망이 될 수 있다. Red-Green-Refactor TDD 사이클에서 Red와 Green을 에이전트에게 맡기고, 개발자가 Refactor에 집중하는 이 새로운 분업 구조는 AI 시대에 코드 품질과 개발 속도를 동시에 잡는 현실적인 접근법으로 주목할 만하다.
📚 참고 자료 (강연 내용과 별개)
강연자가 언급한 자료 외에, 주제를 더 깊이 이해하는 데 도움이 될 관련 자료들을 참고용으로 소개한다.
- Ian Cooper - “TDD, Where Did It All Go Wrong”: 강연자가 직접 추천한 강연. 코드 커버리지 집착의 문제와 행동 기반 TDD의 올바른 방향을 설명한다.
- DHH의 2014년 블로그 포스트: TDD에 대한 비판적 관점을 담은 글로, TDD의 한계를 이해하는 데 중요한 역사적 문서다.
- Simon Willison의 Red-Green TDD 관련 포스트: 에이전트 코딩 맥락에서 TDD를 어떻게 적용하는지 실용적인 관점을 담고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Beyond Code Coverage: Functionality Testing with Playwright |
| 채널 | AI Engineer |
| 강연자 | Marlene Mhangami (Senior Developer Advocate, Microsoft & GitHub) |
| 리포트 작성 | 2026-05-17 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.