전사(Transcription)를 넘어서: 대화를 이해하는 Voice AI 구축하기
📺 원본 영상: Beyond Transcription: Building Voice AI That Understands Conversations — Hervé Bredin, pyannoteAI 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-06 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(Python 노트북 코드, 시각화 위젯, 벤치마크 표 등)는 음성에서 언급된 범위 내에서만 서술되었습니다.
개요
이 강연은 AI Engineer 컨퍼런스의 Voice and Vision 세션에서 발표된 것으로, pyannoteAI의 공동창업자이자 최고과학책임자(CSO)인 Hervé Bredin이 화자 분리(Speaker Diarization)의 원리와 한계, 그리고 이를 음성 인식(STT)과 결합할 때 발생하는 기술적 난제를 라이브 시연과 함께 설명한다. 단순히 “무엇이 발화되었는가”를 넘어 “누가, 언제, 어떻게 말했는가”까지 파악해야 대화를 온전히 이해할 수 있다는 것이 강연의 핵심 전제이며, pyannote 오픈소스 툴킷과 pyannoteAI 클라우드 API를 실제로 구동하면서 이 문제를 구체적으로 다룬다.
1. 왜 전사만으로는 부족한가: 대화 이해의 네 가지 차원
음성 인식 기술이 빠르게 발전하면서 OpenAI의 Whisper처럼 뛰어난 STT 모델이 오픈소스로 공개되었지만, Bredin은 이것이 대화 이해의 시작일 뿐임을 강조한다. 그는 대화를 완전히 이해하기 위해 필요한 정보를 네 가지 차원으로 계층화해서 제시한다.
첫 번째 차원은 가장 기본적인 **전사(Transcription)**다. “무엇이 말해졌는가(What was said)“에 답하는 단계로, Whisper가 이 역할을 담당한다. 그러나 발화자의 이름이나 식별자가 없으면 대화록은 대부분 해석 불가능한 텍스트 덩어리에 불과하다.
두 번째 차원은 **화자 귀속 전사(Speaker-Attributed Transcription)**로, “누가 무엇을 말했는가(Who said what)“에 답한다. 회의록 생성이나 영상 더빙처럼 발화자별로 내용을 분리해야 하는 응용에서 이 수준이 요구된다. 자동 영상 번역을 예로 들면, 각 화자에게 올바른 목소리를 배정하려면 누가 어느 구간에 발화했는지 정확히 알아야 한다. 팟캐스트 인텔리전스처럼 특정 게스트가 여러 에피소드나 여러 팟캐스트에 걸쳐 등장하는 패턴을 추적하는 것도 이 차원에 해당한다.
세 번째 차원은 정확한 타임스탬프다. “누가 언제 말했는가(Who said what and when)“가 핵심이다. Bredin은 이것이 왜 중요한지 구체적인 예시로 설명한다. 단어 수준의 정밀한 타임스탬프가 없으면, 한 화자가 다른 화자의 발화 도중에 끼어들었다는 사실(Interruption)을 감지할 수 없다. 또한 상대방 발화 중에 짧게 “응” 또는 “맞아” 하고 반응하는 역채널(Back-channel) 발화를 놓치게 된다. 이 짧은 발화 하나가 화자의 동의나 반응 상태를 나타내는 가장 중요한 정보가 될 수 있기 때문에, 이를 놓치는 것은 대화의 맥락을 잃는 것과 다름없다. 화자 간 침묵(Pause) 역시 타임스탬프가 있어야만 의미 있게 해석할 수 있다.
네 번째 차원은 **발화 방식(How)**이다. 웃음, 기침, 강세(Stress), 운율(Prosody) 등이 여기에 포함된다. Bredin은 “The dog ate the cake”라는 동일한 문장을 예로 든다. 어디에 강세를 두느냐에 따라 — “The dog ate the cake”, “The dog ate the cake”, “The dog ate the cake” — 의미가 달라진다. 이러한 저수준(Low-level) 음성 특징들이 다운스트림 LLM이나 분석 도구에 전달될 때 추가적인 컨텍스트를 제공할 수 있다는 것이 그의 주장이다.
더 나아가 Bredin은 **대화의 구조(Who is talking to whom)**까지 파악하는 것의 가치를 언급한다. 강연 중에는 강연자가 청중 전체를 향해 말하지만, 질의응답 시간에는 특정 한 명을 향해 말하는 구조로 바뀐다. 이런 상위 레벨의 대화 구조와 음향 환경(조용한 회의실인지, 시끄러운 거리인지)까지 종합할 때, 비로소 AI가 발화의 의도와 맥락을 더 정확하게 파악할 수 있다.
2. 화자 분리(Speaker Diarization)란 무엇인가
pyannote는 원래 이 네 가지 차원 전체를 다루기 위한 프로젝트가 아니라, “누가 언제 말하는가(Who speaks when)“라는 보다 좁은 문제인 **화자 분리(Speaker Diarization)**에서 시작했다. Bredin은 이 단어가 본인도 발음하기 까다롭다고 솔직히 인정하면서, 화자 분리가 커뮤니티에서 얼마나 중요하게 다루어지는지를 Hugging Face 모델 허브의 통계로 보여준다.
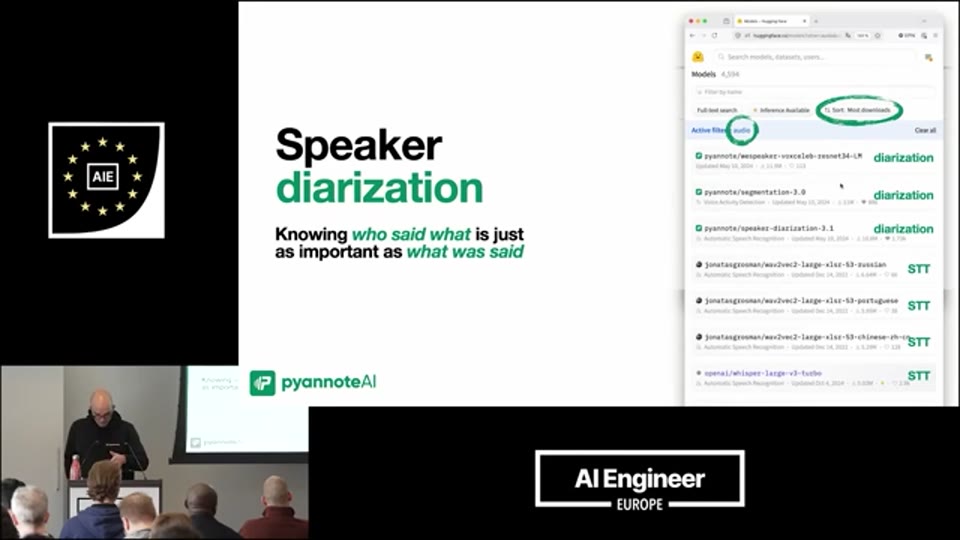
08:19 - Hugging Face 모델 허브에서 오디오 태그 모델을 다운로드 수 순으로 정렬한 화면 — 상위 7개 중 3개가 화자 분리 관련 모델임을 보여주는 표
오디오 태그가 붙은 모델들을 다운로드 수 순으로 정렬했을 때, 상위 7개 모델 중 3개가 화자 인식(Speaker Identity) 및 화자 분리 관련 모델이고 나머지가 STT 모델이라는 사실은, 화자 분리가 STT와 거의 동등한 수준의 커뮤니티 수요를 갖고 있음을 방증한다.
화자 분리 파이프라인의 단계별 구조
화자 분리는 크게 세 단계로 이루어진다. 첫 번째는 **음성 활성도 감지(Voice Activity Detection, VAD)**로, 어느 구간에 누군가 발화하고 있는지 아닌지를 이진 분류한다. 두 번째는 **세분화(Segmentation)**로, 발화 구간 내에서 화자 전환(Speaker Change Point)을 찾아내고, 두 화자가 동시에 말하는 오버랩 구간과 역채널 발화처럼 매우 짧은 발화 구간을 식별한다. Bredin은 특히 이 짧은 발화 구간이 “yes” 한 마디일지라도 화자의 상태를 드러내는 가장 중요한 정보가 될 수 있기 때문에 절대 놓쳐서는 안 된다고 강조한다.
세 번째 단계가 진정한 의미의 화자 분리로, 각 발화 구간에 화자 식별자(Speaker Identity)를 부여하는 것이다. 여기서 중요한 특성이 두 가지 있다. 첫째, 대화에 등장하는 화자의 수를 사전에 알 수 없다는 점이다. 회의 참석자 목록이 있다 해도, 두 사람이 같은 채널로 접속했거나 초대받지 않은 사람이 참여했을 수 있다. 둘째, 화자 분리 시스템의 출력은 “Hervé”, “John” 같은 실제 이름이 아니라 “화자 1”, “화자 2” 같은 익명 레이블이라는 점이다. 레이블을 서로 교환해도 — 초록색을 검정색으로, 검정색을 초록색으로 바꾸어도 — 분리 결과 자체의 정확도는 동일하게 평가된다. 이런 특성 때문에 화자 분리는 클래스 수가 고정된 일반적인 머신러닝 분류 문제와는 근본적으로 다른 어려움을 가진다.
오버랩 발화 처리, 매우 짧은 발화 구간, 화자 간 발화 시간 불균형, 다양한 음향 조건 등 여러 복합적인 이유로, 화자 분리 연구 커뮤니티가 오랫동안 이 문제를 다루어왔음에도 여전히 완전히 해결된 문제로 볼 수 없다고 Bredin은 솔직하게 말한다.
3. DER(Diarization Error Rate): 화자 분리 성능을 어떻게 측정하는가
강연의 첫 번째 라이브 시연은 화자 분리 성능 평가 지표인 **DER(Diarization Error Rate)**을 직접 계산해보는 것이다. Bredin은 사전에 준비한 Python 노트북을 Mac에서 실행하면서(Metal Performance Shaders, MPS 백엔드 사용) 두 여성이 전화 통화하는 약 30초짜리 샘플 오디오를 사용한다.
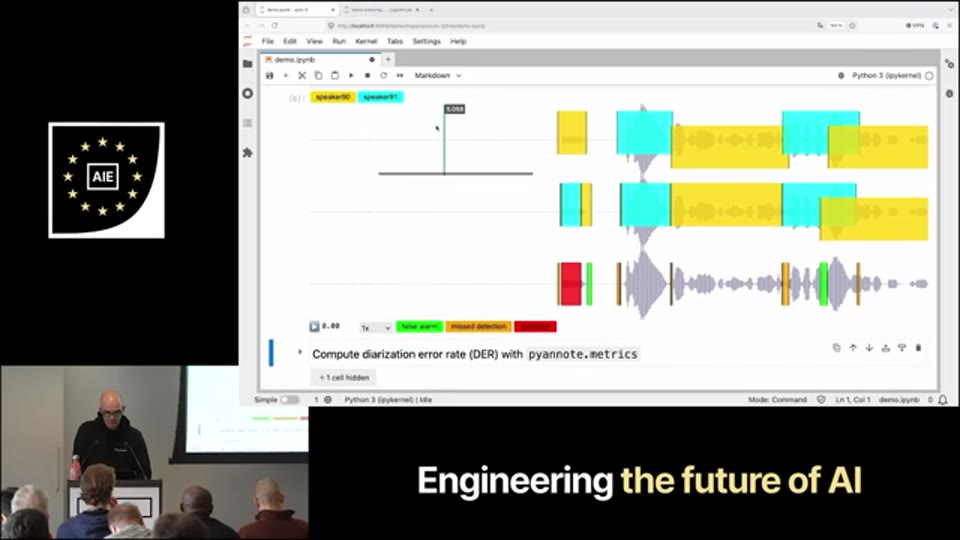
14:16 - 레퍼런스 어노테이션(정답)과 Community 1 모델 예측 결과를 타임라인으로 비교, Confusion/False Alarm/Misdetection 오류 구간이 색상으로 표시된 노트북 시각화 위젯
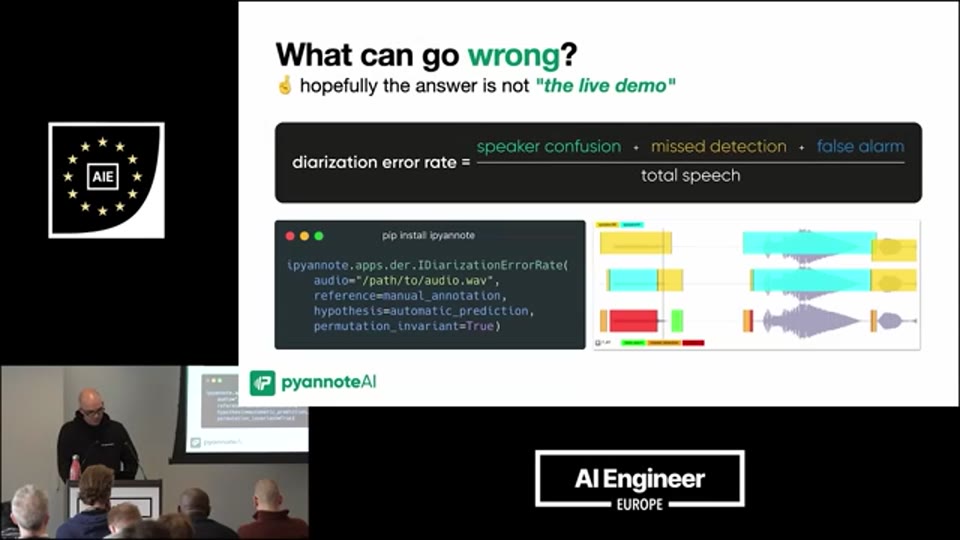
DER은 화자 분리 시스템이 만들어내는 세 가지 오류 유형의 합계를 전체 발화 시간으로 나눈 값이다.
| 오류 유형 | 설명 |
|---|---|
| Confusion | 발화는 감지했지만 잘못된 화자에게 할당함 |
| False Alarm | 실제 발화가 없는 구간에서 발화를 감지함 |
| Misdetection | 실제 발화가 있는 구간을 감지하지 못함 (오버랩 구간에서 한 명만 감지하는 경우 등) |
pyannote Community 1(오픈소스, 무료) 모델을 동일한 샘플에 적용했을 때 5% DER이 나왔고, 이어서 pyannoteAI의 클라우드 API에서 실행되는 상위 모델인 Precision 2를 적용했을 때 약 3% DER이 나왔다. Confusion 오류가 줄고 False Alarm과 Misdetection도 소폭 개선된 결과였다. 이 시연은 강연 현장에서 실시간으로 실행되었으며, Bredin은 특유의 솔직함으로 “데모는 항상 실패할 수 있다”고 언급했지만 실제로는 정상 작동했다.
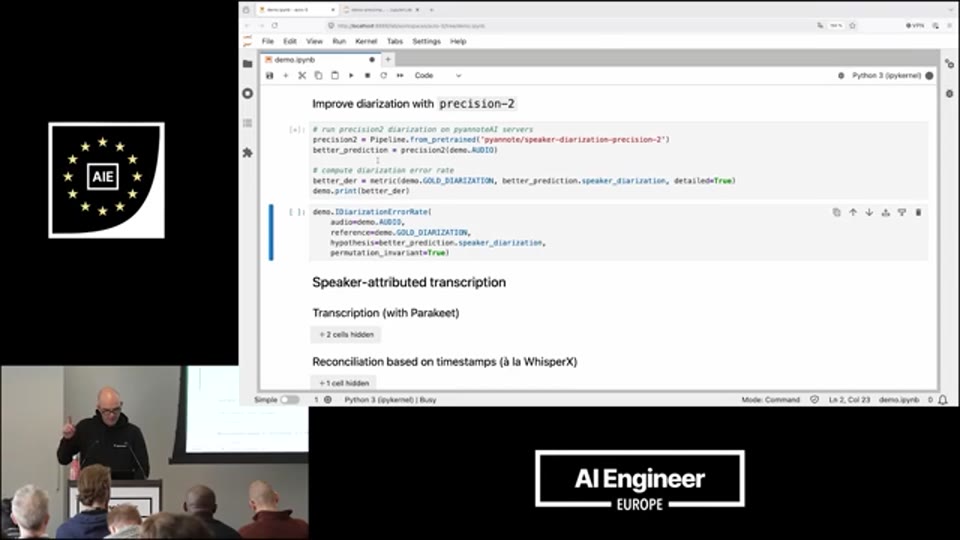
15:30 - pyannote.metrics로 계산된 5% DER 결과값 및 오류 유형별 분해 수치가 표시된 노트북 셀 출력
현재 SOTA(State-of-the-Art)의 한계
DER로 본 현재 최고 수준의 성능은 사용 환경에 따라 극명하게 갈린다. Bredin이 제시한 수치에 따르면, 전화 통화처럼 단거리 마이크 단일 화자 음성의 경우 최고 시스템이 약 2%의 DER을 달성한다. 반면 많은 사람들이 함께 있는 식당처럼 배경 소음이 심한 환경에서는 최고 시스템도 41% DER에 이른다. 같은 기술이지만 환경에 따라 2%와 41%라는 20배 이상의 성능 격차가 발생한다는 사실은, 화자 분리가 여전히 해결 중인 열린 문제임을 분명히 보여준다.
16:07 - 환경별 최고 시스템 DER 비교: 전화 통화 약 2%, 식당 환경 약 41%를 보여주는 슬라이드
4. STT와 화자 분리를 결합하면 왜 어려운가
화자 분리와 STT를 각각 충분히 잘 수행한다면, 이 둘을 결합해 화자 귀속 전사(Speaker-Attributed Transcription)를 만드는 것은 간단해 보인다. 각 단어를 발화한 화자를 찾아 붙이면 되는 것 아닌가? 그러나 Bredin은 이것이 생각보다 훨씬 까다로운 문제라고 강조하며, 그 이유를 크게 두 가지로 설명한다.
첫 번째 이유는 STT 모델의 일반화 실패다. 대부분의 STT 모델은 단일 화자 데이터로 훈련되기 때문에, 여러 화자가 겹쳐 말하거나 화자가 빠르게 교체되는 실제 대화 환경에 적용하면 성능이 급격히 저하된다. Bredin은 이를 NVIDIA의 Parakeet 모델과 AMI 데이터셋을 예시로 설명한다. AMI는 4~5명이 회의실에서 진행하는 회의를 녹음한 데이터셋으로, 각 참여자의 헤드셋 마이크와 테이블 중앙의 원거리 마이크 두 종류의 오디오가 존재한다. Open ASR 리더보드에 Parakeet이 보고하는 11.4% 단어 오류율(WER)은 헤드셋(단일 화자) 기준이다. 그러나 pyannoteAI가 동일한 Parakeet 모델을 테이블 중앙 마이크(다중 화자, 원거리) 기준으로 평가하자 WER이 26%로 치솟았다. 같은 모델, 같은 데이터셋인데 마이크 종류만 달라졌을 뿐인데도 성능이 두 배 이상 떨어진 것이다. 이는 리더보드 수치를 그대로 신뢰해서는 안 된다는 중요한 경고이기도 하다.
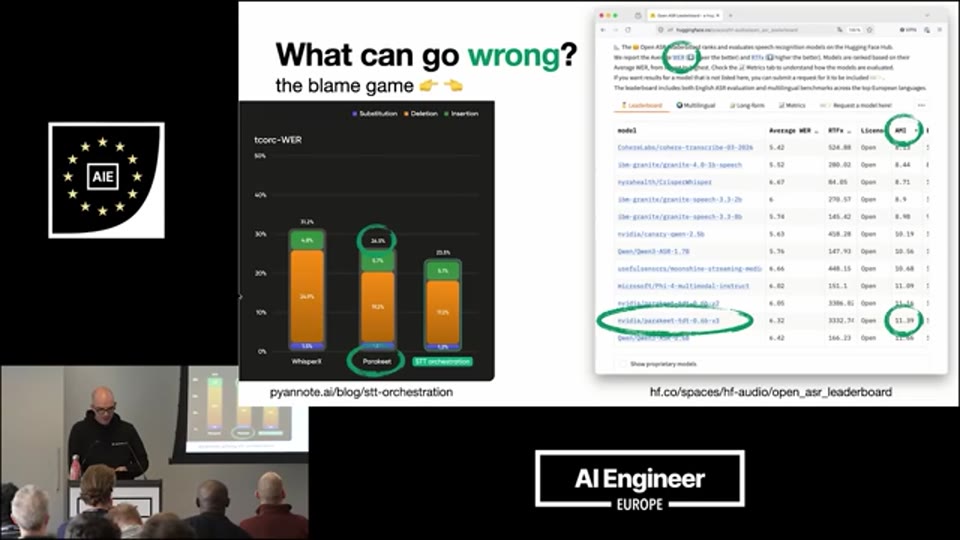
17:44 - Open ASR 리더보드의 NVIDIA Parakeet 수치(11.4% WER, 헤드셋 기준)와 pyannoteAI 자체 측정 수치(26% WER, 테이블 중앙 마이크 기준) 비교 슬라이드
두 번째 이유는 타임스탬프 불일치(Timestamp Reconciliation) 문제다. 이것이 두 번째 라이브 시연의 핵심 주제다.
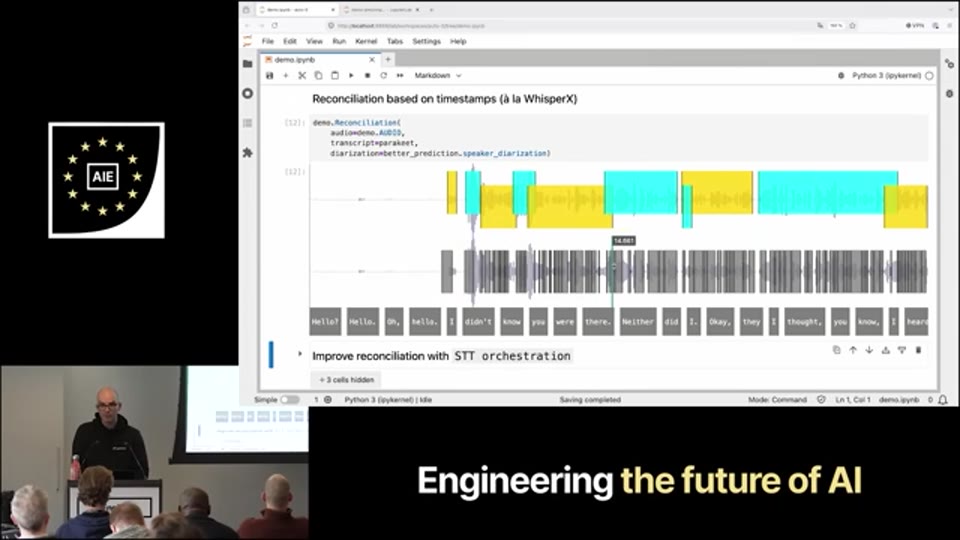
20:30 - Parakeet 전사 출력(단어별 타임스탬프 포함)과 Precision 2 화자 분리 결과를 나란히 놓고 단어-화자 매핑의 모호성을 시각화한 화면
Bredin은 동일한 전화 통화 샘플에 Parakeet(NVIDIA)으로 단어별 타임스탬프가 포함된 전사를 생성하고, Precision 2로 화자 분리 결과를 생성한 뒤, 이 둘을 단어 단위로 매핑하는 과정을 직접 보여준다. 대부분의 단어는 타임스탬프가 어느 정도 맞아 할당이 가능하지만, 문제는 경계 지점에서 발생한다. 예를 들어 “Oh”라는 단어의 타임스탬프가 화자 분리 결과에서 두 화자의 경계 지점에 정확히 걸쳐 있는 경우, 이 단어를 어느 화자에게 귀속시켜야 하는지 명확하지 않다. 또한 화자 분리가 두 화자의 동시 발화를 감지했는데 STT에는 그 구간에 단어가 하나밖에 없는 경우도 발생한다. 화자 분리가 감지한 구간을 STT가 전사하지 않거나, 반대로 STT가 전사한 구간을 화자 분리가 누락하는 경우도 있다.
이처럼 두 시스템의 결과를 단순 매핑하는 것은 경계 사례(Edge Case)에서 반복적으로 실패한다. 이것이 pyannoteAI가 독자적인 STT 오케스트레이션(STT Orchestration) 레이어를 개발한 동기다.
5. pyannoteAI의 STT 오케스트레이션: 화해(Reconciliation) 문제 해결
pyannoteAI의 클라우드 API는 화자 분리 모델(Precision 2)과 외부 STT 모델(Parakeet 등)의 출력을 입력으로 받아, 두 결과 간의 타임스탬프 불일치를 자동으로 처리하는 조화(Reconciliation) 과정을 수행한다. 이 과정의 내부 알고리즘은 현재 독점 기술(Proprietary)이지만, Bredin은 오픈소스 Community 1 모델에서 이미 공개한 한 가지 핵심 아이디어를 설명한다.
그것은 Exclusive Diarization이라는 접근 방식으로, 두 화자가 오버랩하여 발화하는 구간에서 STT 모델이 더 잘 전사할 가능성이 높은 한 화자를 선별하는 메커니즘이다. STT 모델 자체는 오버랩 발화를 잘 처리하지 못하므로, 오버랩 구간을 하나의 주요 화자 구간으로 단순화함으로써 이후의 타임스탬프 매핑 작업을 크게 용이하게 만든다.
또한 이 오케스트레이션 레이어의 설계 철학으로 중요한 점이 있다. Bredin은 이 시스템이 특정 STT 모델에 종속되지 않도록 설계되었다고 강조한다. 사용자가 내부적으로 파인튜닝한 STT 모델이 있더라도, 그 모델의 출력을 pyannoteAI의 화자 분리 결과와 결합하여 고품질의 화자 귀속 전사를 얻을 수 있다. STT 모델 자체를 수정하거나 재훈련할 필요가 없다는 것이 이 접근법의 핵심 가치다.
라이브 시연에서 이 오케스트레이션을 통해 얻은 최종 결과는 단순 매핑 방식보다 훨씬 나았다. 특히 두 화자가 실제로 동시에 발화한 오버랩 구간에서, 두 화자의 단어들이 타임스탬프 순서에 맞게 적절히 인터리빙(Interleaving)된 결과를 보여주었다.
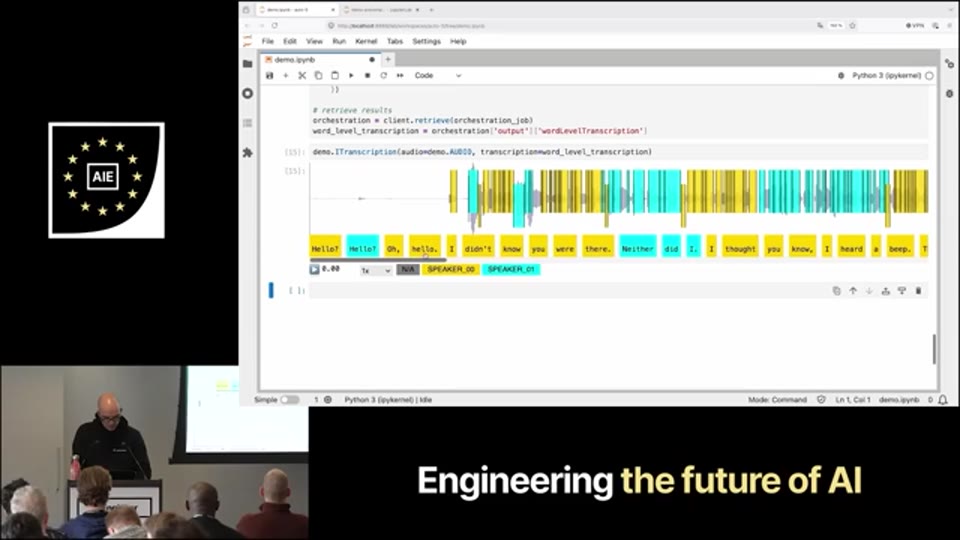
21:54 - STT 오케스트레이션 최종 결과: 오버랩 구간에서도 두 화자의 단어가 타임스탬프 순서에 따라 올바르게 인터리빙된 화자 귀속 전사 출력
6. pyannote 생태계: 오픈소스에서 클라우드 API까지
Bredin이 2년 전 학계를 떠나 창업한 pyannoteAI는 그가 수십 년간 개발해온 오픈소스 툴킷인 pyannote를 기반으로 한다. pyannote의 GitHub 스타 히스토리에서 눈에 띄는 변곡점들이 있는데, 가장 두드러진 것은 OpenAI의 Whisper가 공개된 시점이다. Whisper는 STT 분야에서 혁명적인 변화를 가져왔지만, 발화자 정보를 제공하지 않았기 때문에 사람들이 자연스럽게 화자 분리를 위해 pyannote로 눈을 돌렸고 이것이 폭발적인 채택으로 이어졌다. 강연 시점 기준으로 pyannote의 GitHub 스타는 약 10,000개에 근접해 있었다.
현재 pyannote 생태계는 크게 네 가지 구성요소로 이루어져 있다. 첫째는 pyannote.audio — 화자 분리를 위한 핵심 오픈소스 툴킷이다. 둘째는 pyannote.metrics — 화자 분리 성능을 DER 등의 지표로 평가하는 라이브러리다. 셋째는 ipyannote — “i”는 iOS나 iMac이 아니라 Interactive의 의미로, Jupyter 노트북 환경에서 발화 타임라인과 오류를 시각적으로 탐색할 수 있는 인터랙티브 위젯이다. 넷째는 pyannoteAI SDK — Community 1(오픈소스)보다 고성능인 Precision 2 같은 프리미엄 모델을 클라우드 API로 사용할 수 있는 인터페이스다. 강연에서 시연된 모든 코드와 노트북은 pyannoteAI/tutorials GitHub 레포지터리에 공개되어 있다.
마무리: “전사 이후”를 향한 여정
Bredin의 강연은 짧은 25분이었지만, 담고 있는 메시지는 명확하다. 음성 AI는 “무엇이 말해졌는가”를 넘어 “누가, 언제, 어떻게, 누구에게 말했는가”를 이해하는 방향으로 나아가야 한다. 화자 분리는 그 여정의 핵심 구성요소이며, pyannote는 이 분야에서 가장 널리 사용되는 오픈소스 툴킷으로 자리잡았다.
그러나 현실은 여전히 까다롭다. 최고 시스템도 시끄러운 환경에서 41% DER이라는 높은 오류율을 보이고, STT와 화자 분리의 결합은 타임스탬프 불일치라는 숨겨진 복잡성을 안고 있다. STT 리더보드의 수치가 단일 화자 헤드셋 마이크 기준임을 간과하고 실제 다화자 환경에 그대로 적용하면 성능이 두 배 이상 저하될 수 있다는 경고는, AI 엔지니어들이 벤치마크를 비판적으로 해석해야 한다는 중요한 실무적 교훈이기도 하다.
pyannoteAI의 STT 오케스트레이션은 이 간극을 메우려는 실용적 해법이며, 특정 STT 모델에 종속되지 않는다는 설계 원칙은 다양한 실무 환경에의 적용 가능성을 높인다. 대화 이해 AI의 완성을 향한 연구는 여전히 진행 중이며, 이 강연은 그 최전선에서 어떤 문제들이 다루어지고 있는지를 잘 보여준다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Beyond Transcription: Building Voice AI That Understands Conversations |
| 채널 | AI Engineer |
| 발표자 | Hervé Bredin (CSO & Co-founder, pyannoteAI) |
| 리포트 작성 | 2026-06-06 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.