Bounded Autonomy: LLM 에이전트 설계의 철학 — 자유 의지와 결정론 사이
📺 원본 영상: Bounded Autonomy: Between Free Will and Determinism — Angus J. McLean, Oliver 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-26 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 광고 AI 회사 Oliver의 AI 디렉터 Angus McLean이 에이전트 설계 현장 경험을 바탕으로 LLM의 본질적 한계와 그 한계를 어떻게 받아들이고 활용할 것인지를 이야기한다. “경계 지어진 자율성(Bounded Autonomy)“이라는 제목이 암시하듯, 이 강연은 AI 에이전트에게 얼마만큼의 자율성을 부여할 것인가, 그리고 제약이 오히려 창의성을 만들어낸다는 역설적 주장을 중심으로 전개된다. 단순한 기술 소개를 넘어, 빠르게 변화하는 AI 환경 속에서 개발자와 실무자가 어떤 철학과 태도로 에이전트를 설계해야 하는지를 성찰하게 만드는 내용이다.
Oliver: AI로 전환한 광고 회사
강연자 Angus McLean이 재직 중인 Oliver는 처음에는 전통적인 광고 대행사로 출발했으나, 지금은 거의 완전히 생성형 AI 중심 기업으로 전환한 스타트업이다. 46개국에 3,000명의 직원을 두고 있으며, 하루에 약 4,000개의 광고 에셋을 생성해 200개 이상의 브랜드를 위해 사용한다. Johnny Walker 캠페인이 그 대표적인 예다. 흥미로운 점은 이 에셋들이 실제 미디어 집행에 투입된다는 것인데, 개당 2만 달러에서 수백만 달러에 이르는 미디어 스펜드(media spend)가 뒤따른다. 이는 단순한 콘텐츠 생성을 넘어, 실제 성과 데이터를 축적하고 피드백 루프를 형성할 수 있다는 의미이며, 덕분에 어떤 에셋이 효과적인지를 데이터 기반으로 빠르게 검증하는 구조가 갖춰져 있다.
전통적인 광고 대행사는 계정(Accounts), 크리에이티브(Creative), 전략(Strategy)의 세 부서로 구성된다. 과거에는 계정 부서가 전체의 50%를 차지했으나, 지금 Oliver에서는 크리에이티브와 전략이 각각 20%씩을 차지하는 구조로 바뀌었다. 크리에이티브 팀은 단순한 이미지 생성을 넘어 아이디에이션(ideation), 카피라이팅(copywriting), 콘텐츠 프로덕션 전반을 에이전트로 처리하고 있다. McLean이 속한 전략 팀 역시 소비자 인사이트, 트렌드 분석, 경쟁사 분석, 퍼포먼스 최적화를 각기 다른 에이전트를 통해 수행한다. 고객 대면 서비스인 만큼 속도와 품질이 동시에 요구되며, 생성된 에셋의 품질이 낮을 경우 브랜드에 오히려 역효과를 낼 수 있다는 긴장감 속에서 운영되고 있다.
LLM은 정말 이해하는가? — 느리게 생각하기
McLean은 강연의 첫 번째 핵심 조언으로 “속도를 늦추라(Slow Down)“는 이야기를 꺼낸다. AI 업계에는 눈 깜짝할 새 새로운 도구가 나타났다 사라지는 “blink-and-you’ll-miss-it” 멘탈리티가 팽배해 있지만, 막상 놓쳤던 것들을 돌아보면 그것들이 정말 중요했는지 의문이 든다고 그는 말한다. 실제로 LLM의 핵심 구조는 적어도 1990년대 이후 본질적으로 크게 달라지지 않았다는 것이 그의 주장이다(일부 연구자는 그 기원이 더 오래되었다고 주장하기도 한다 — 강연에서 “Emma Strubell”[STT 오인식 가능성 — Emma Strubell 또는 다른 연구자로 추정, 원본 영상 확인 권장]을 언급했으나 원본 영상 확인 권장).
현재의 대규모 언어 모델들이 데이터를 진정으로 “이해”하지 못한다는 근거로 McLean은 세 가지 명확한 한계를 든다. 첫째는 **데이터 효율성(Data Efficiency)**으로, 인간은 소수의 예시만으로도 개념을 습득하는 반면 모델은 비교적 단순한 결론에 도달하기 위해 방대한 데이터셋을 필요로 한다. 둘째는 지속적 학습의 부재로, 인간처럼 망각 없이 연속적으로 학습하는 능력이 없다. 셋째는 폐쇄형 박스(Closed Box) 특성이다. McLean은 LLM을 “의미적 수학이 가능한 유연한 데이터베이스(flexible database capable of doing semantic math)“로 이해하는 것이 더 정확하다고 제안하며, 어떠한 창발(emergence)이나 실시간 학습도 기대하지 않는다는 입장을 분명히 밝힌다.
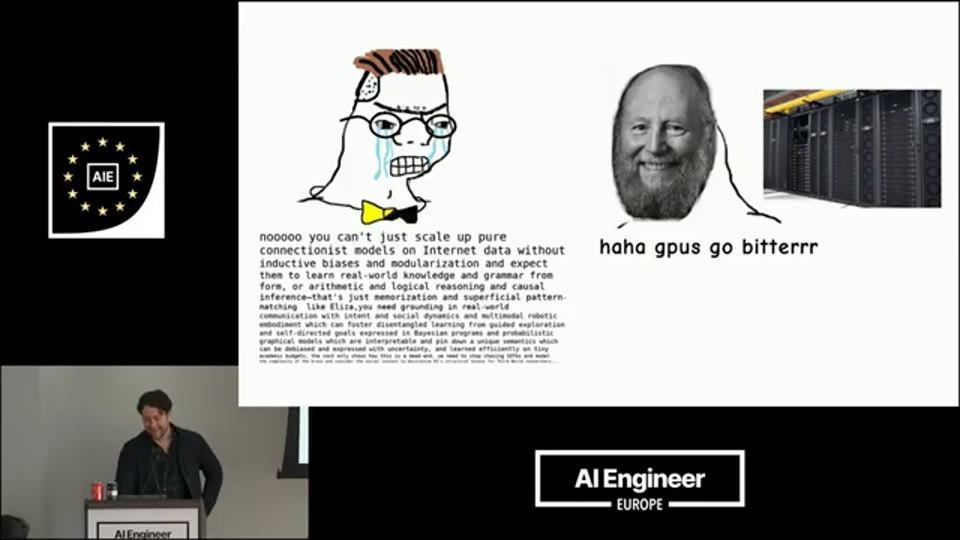
05:49 - Rich Sutton의 ‘The Bitter Lesson’ 다이어그램 — LLM의 한계와 컴퓨팅 브루트 포스 의존성을 설명하는 슬라이드
The Bitter Lesson은 Rich Sutton이 작성한 유명한 에세이로, AI 연구의 역사에서 범용적인 연산 능력을 활용한 방법론이 인간의 도메인 지식을 수작업으로 설계한 방법론을 결국 항상 압도해왔다는 교훈을 담고 있다. McLean은 이 맥락에서 현재 우리가 만들고 있는 도구들 대부분이 모델의 근본적인 제약을 직접 해결하기보다 그 위에 임시방편(band-aid)을 붙이는 방식임을 지적한다. 임시방편적 해결책의 특징은 단기적이고 피상적이며, 증상을 감추는 데 그친다는 것이다. 이는 최근의 모델 성능 향상이 구조적 돌파구보다 컴퓨팅 자원의 브루트 포스(brute force) 확장에서 비롯된 것이라는 시각과 맥을 같이 한다.
맥락(Context)의 역설 — 제약이 창의성을 만든다
에이전트의 능력이 비약적으로 발전한 주요 원인 중 하나로 McLean은 컨텍스트 윈도우(Context Window)의 확장을 꼽는다. 장기 실행 에이전트(long-running agents)일수록 더 긴 컨텍스트가 필수적인데, 에이전트가 작업 내역, 도구 출력, 목표, 계획 등을 지속적으로 추적하고 참조할 수 있어야 하기 때문이다. 컨텍스트가 충분하지 않으면 에이전트는 작업 도중 방향을 잃고, 복잡한 멀티스텝 워크플로를 처리할 수 없으며, 심한 경우 중요한 데이터를 삭제하는 사고(예: 이메일 대량 삭제 사례)로 이어질 수 있다.
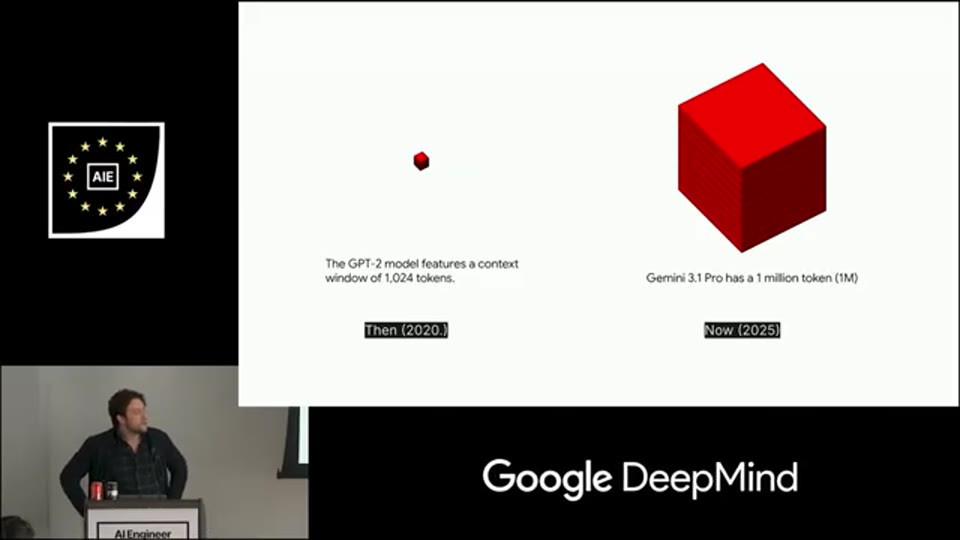
07:28 - GPT-2와 대형 최신 모델의 컨텍스트 윈도우 크기 비교 슬라이드 — 컨텍스트 확장의 역사적 흐름
⚠️ 강연에서 비교 대상 모델로 언급된 이름은 STT 오인식 가능성 있음 — 정확한 모델명은 원본 영상 참조
그러나 McLean은 역설적인 주장을 펼친다. 컨텍스트 윈도우는 아무리 커져도 절대 충분하지 않을 것이라는 점이다. 세계의 총 지식량은 약 12시간마다 두 배로 늘어나기 때문에, 우리는 항상 더 많은 컨텍스트를 원하게 될 것이다. 따라서 이제는 “얼마나 많은 컨텍스트를 넣을 것인가”가 아니라 “얼마나 많은 노이즈를 제거할 것인가”가 더 중요한 질문이 되었다고 그는 강조한다. 이는 개발자의 관점에서 컨텍스트가 가드레일(guardrail)만큼이나 모델을 제약하는 요소임을 의미하며, 일종의 소프트 제약(soft constraint)으로 작동해 모델의 행동을 간접적으로 형성하는 도구가 된다.
예를 들어, 모델에게 인터넷 접속 권한을 주는 대신 고품질 문서(documentation)를 직접 제공하면 훨씬 나은 결과를 얻을 수 있다. Oliver의 경우, 광고 경쟁사를 조사할 때 모델이 인터넷 검색에 의존하면 SEO에 최적화된 홍보성 콘텐츠를 그대로 흡수하는 문제가 발생했다. 결국 원하는 것은 브랜드 자체가 쓴 글이 아니라 소비자의 실제 반응인데, 이를 위해서는 컨텍스트의 품질을 직접 통제하는 것이 핵심이다.
이 생각은 더 나아가 “제약이 창의성을 만든다(Constraints create creativity)“는 철학으로 이어진다. 자원이 풍부해지면 절박함과 창의적 문제 해결 능력이 오히려 줄어들 수 있다. 초기 컴퓨팅 시대의 극한 제약 속에서 Spacewar!(STT에서 “space wall”로 오인식된 것으로 추정) 같은 혁신적인 프로그램이 탄생했고, Crash Bandicoot 개발팀은 PlayStation의 메모리 제약을 역이용해 획기적인 성능 개선을 이뤄냈다. McLean은 전체 컨텍스트 윈도우를 채우지 않아야 한다는 것은 누구나 알고 있지만, “얼마나 적은 컨텍스트만으로도 작업을 완료할 수 있는가”를 탐구하는 것이 더 흥미로운 질문이라고 제안한다. 구체적인 실험 방법으로는 더 오래되고 작은 버전의 모델을 사용해 보거나, 자체적인 메모리 및 컴팩션(compaction) 시스템을 직접 구축해보거나, 데이터 사전 처리 및 아카이빙에 집중하는 방법 등을 권장한다.
단순함의 힘 — 복잡성의 유혹을 거슬러라
McLean이 제시하는 두 번째 핵심 원칙은 “단순하게 유지하라(Keep It Simple)“이다. 그는 개인적인 경험을 예시로 든다. 이력서(CV) 파싱 애플리케이션을 매우 복잡하게 구축했을 때보다, 단순히 “HTML”이라는 네 글자를 프롬프트에 포함했을 때 10배 이상, 어쩌면 100배에 가까운 성능 향상이 있었다는 것이다. 막강한 도구를 갖고 있다고 해서 그것을 모두 사용할 이유는 없다는 역설이 여기에 담겨 있다.
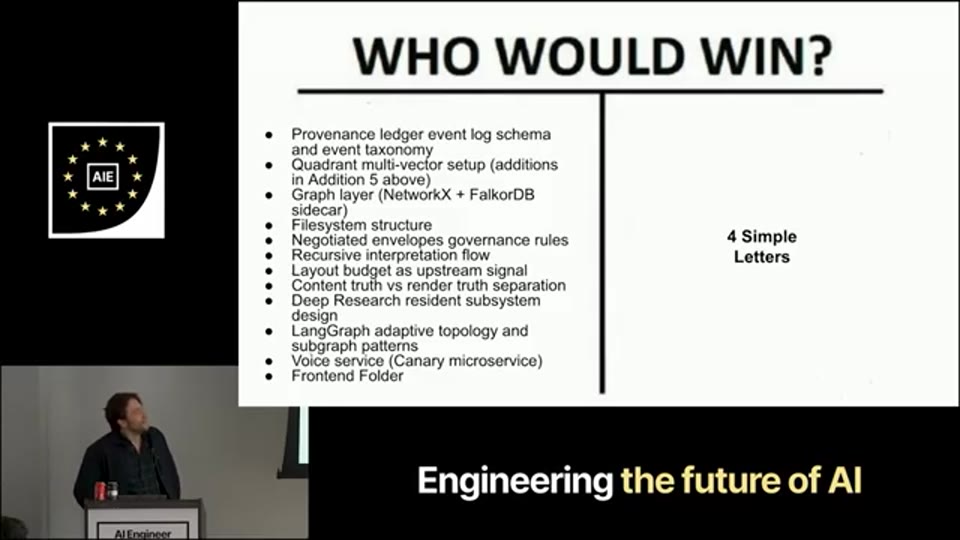
11:37 - 복잡한 CV 파싱 애플리케이션 대 단순한 HTML 프롬프트 결과 비교 화면
모델은 본질적으로 장황하고(verbose) 복잡한 해결책을 지향하는 경향이 있다고 McLean은 지적한다. 모델이 제안하는 가장 복잡한 해결책에 그대로 끌려가기보다, 불필요한 복잡성을 걷어내고 현실과의 피드백 루프를 최대한 빠르게 단축시키는 것이 핵심이다. 에이전트를 활용해 업무 속도를 높이는 것처럼, 제품을 만들 때에도 현실과의 충돌을 빠르게 경험하는 단순한 버전을 먼저 구축하는 것이 중요하다.
신경망 연구의 역사도 이를 뒷받침한다. Frank Rosenblatt가 퍼셉트론(Perceptron)의 연결 와이어를 제거하는 실험을 진행했던 것이 훗날 Dropout이라는 핵심 규제화(regularization) 기법의 기초가 되었다는 사실은, 제약과 단순화가 오히려 더 강력한 일반화 능력으로 이어질 수 있음을 역사적으로 증명한다.
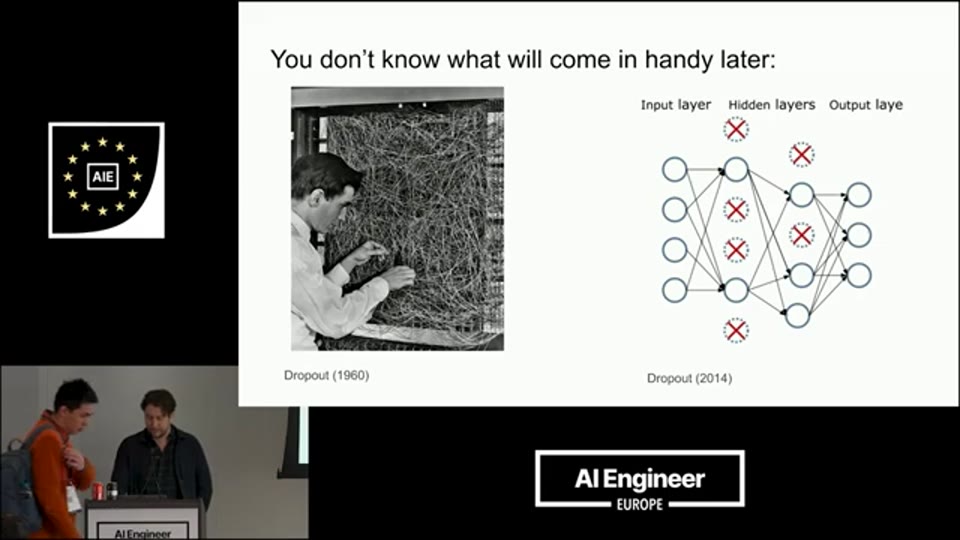
11:20 - Frank Rosenblatt가 퍼셉트론의 와이어를 제거하는 역사적 사진 — Dropout 기법의 기원
AI는 번역이다 — 표현 공간의 철학
강연에서 가장 철학적으로 흥미로운 부분은 “AI는 근본적으로 번역(Translation)이다”라는 주장이다. 이는 Transformer 아키텍처의 기반이 된 논문 “Attention Is All You Need”가 원래 영어-프랑스어 번역 문제를 위해 개발되었다는 사실에서 출발한다. McLean은 이 개념을 훨씬 더 넓게 확장한다. 텍스트를 이미지로, 이미지를 오디오로, 오디오를 비디오로 변환하는 모든 과정이 같은 원리의 연장선이며, 지식 생산 자체도 경험을 요약해 압축된 지식으로 만드는 번역 행위라는 것이다. 그가 이 강연에서 수년간의 경험을 정리해 전달하는 행위 자체도 번역의 산물이라고 그는 말한다.
이 관점에서 MCP(Model Context Protocol)나 에이전트 간 핸드오프(model handoff)와 같은 개념도 재해석된다. 구조화된 데이터와 비구조화된 데이터가 공존하는 환경에서, 에이전트는 두 세계 사이를 매개하는 번역자의 역할을 한다. 더 나아가 McLean은 데이터의 구조(structure)가 그 데이터 자체의 내재적 속성이 아니라, **관찰자의 표현 방식(representation of the observer)**에 따라 달라진다는 중요한 통찰을 제시한다. 같은 정보라도 어떤 형태로 표현하느냐에 따라 전혀 다른 의미와 활용 가능성을 갖게 된다는 것이다. 슬라이드 하나를 예로 들면, 같은 내용을 다이어그램으로 표현할 것인지, 텍스트로 쓸 것인지, 음성으로 전달할 것인지는 본질적으로 다른 선택이다.
이 원칙은 에이전트 시스템을 설계할 때 복수의 표현 구조를 병용해야 한다는 실천적 제안으로 연결된다. McLean에 따르면 이상적인 시스템은 아래와 같은 표현 방식들을 상황에 맞게 조합해야 한다.
- Markdown: 인간이 읽기 좋은 계층적 구조와 저작(authoring)
- 그래프(Graph): 관계성과 참조(reference) 구조
- 클러스터링(Clustering): 대규모 또는 비정형 텍스트 처리
- 폴더 구조(Folder): 빠른 검색이 필요한 데이터
- 타임라인(Timeline): 시간 순서가 중요한 작업
이러한 표현 구조의 선택은 단순한 기술적 결정이 아니라, 어떤 렌즈로 정보를 바라볼 것인지에 대한 철학적 결정이기도 하다. 과거에 컨텍스트 윈도우가 매우 작았던 시절에는 TF-IDF 클러스터 레이블링처럼 제한적이고 정적인 방식을 사용했지만, 지금은 컨텍스트 조립(context assembly)이 훨씬 더 동적으로 이루어진다. 문제는 이제 컨텍스트를 확보하는 것이 아니라, 노이즈를 걸러내는 것으로 완전히 역전되었다.
에이전트 설계의 두 갈래 — 구조화 대 자율성
강연 말미에 McLean은 에이전트를 직장에 통합하는 방식에 대해 짧지만 핵심적인 이야기를 남긴다. Adam Smith의 핀 공장(pin factory) 사례에서처럼, 자본주의는 자연스럽게 업무를 작고 반복 가능한 단위로 분해하는 경향이 있다. 에이전트 설계도 이와 유사한 구조를 따를 수 있으며, 실제로 Oliver에서는 단일한 자율 에이전트보다 명확한 역할로 분리된 워크플로(workflow) 방식이 훨씬 효과적인 결과를 낸 경우가 많았다고 그는 밝힌다. 자유도가 높은 에이전트 하나보다 예측 가능하고 통제 가능한 구조화된 파이프라인이 실무에서는 더 신뢰성이 높다는 것이다.
그는 또 하나의 중요한 원칙을 덧붙인다. “당신이 직접 할 수 없는 일은 자동화하지 말라(Don’t automate a job unless you can do it yourself).” 이는 단순히 기술적 가능성의 문제가 아니라, 자동화할 업무에 대한 깊은 이해와 직접적인 경험이 선행되어야 한다는 의미이다. McLean 자신이 소셜 미디어 인텔리전스(social media intelligence) 업무를 직접 수행했던 경험이 있기 때문에, LLM을 이용해 5만 개의 트윗을 클러스터링하고 이를 전략으로 구조화하는 자동화 시스템을 설계할 수 있었다고 한다. 그는 이 시스템을 특정 AI 관련 기업의 지난 1년치 데이터(강연에서 “OpenClaw”로 언급 — STT 오인식으로 추정, 원본 영상 확인 권장)에 적용해 시연했으며, 광고 기획 팀이나 전략 팀이 즉각 활용할 수 있는 형태의 인사이트를 거의 실시간으로 생성할 수 있음을 보여주었다.
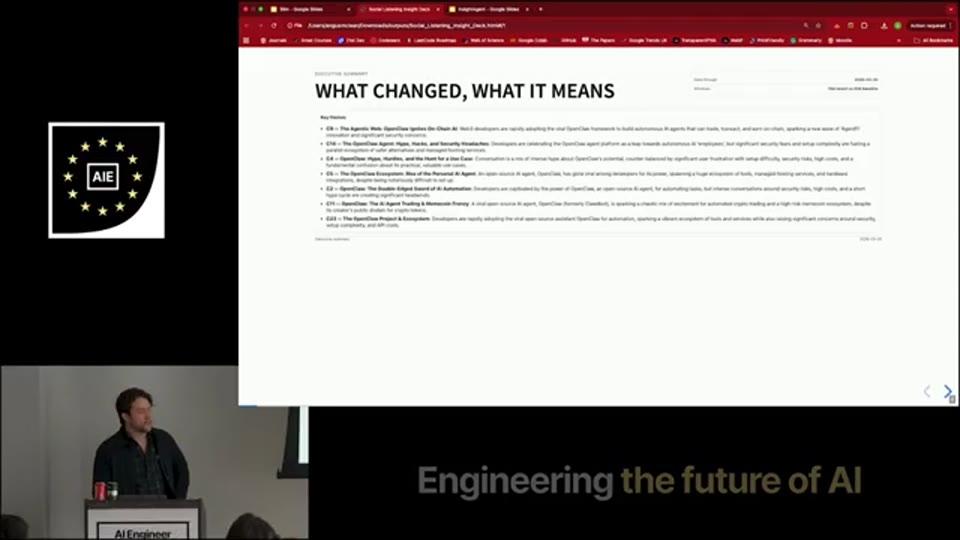
16:01 - LLM이 생성한 소셜 미디어 인사이트 리포트 — 5만 개 트윗 클러스터링 및 전략화 결과물
마무리 — 경계 지어진 자율성의 의미
이 강연의 제목 “경계 지어진 자율성(Bounded Autonomy)“은 결국 단순한 기술 용어가 아니라 하나의 설계 철학이다. LLM은 자유 의지처럼 보이는 유연성을 갖추고 있지만, 그 이면에는 훈련 데이터, 컨텍스트 윈도우, 모델 아키텍처라는 명확한 결정론적 경계가 존재한다. McLean이 강조하는 것은 그 경계를 이해하고, 제약을 두려워하는 대신 창의적으로 활용하라는 것이다. 속도를 늦추고, 단순하게 유지하며, AI를 번역 엔진으로 이해하고, 표현 방식을 다양화하고, 자신이 직접 이해하는 일만 자동화하라. 이 다섯 가지 원칙은 화려한 기술 스택 위에 놓인 철학적 나침반으로서, 빠르게 변화하는 에이전트 개발 환경에서도 흔들리지 않는 방향을 제시한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Bounded Autonomy: Between Free Will and Determinism |
| 채널 | AI Engineer |
| 강연자 | Angus J. McLean (AI Director, Oliver) |
| 리포트 작성 | 2026-05-26 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.