Build Evals That Actually Matter - Nick Ung, Lyft
📺 원본 영상: Build Evals That Actually Matter - Nick Ung, Lyft
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-20
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
이 강연은 Lyft가 고객지원 AI 에이전트를 운영하면서 배운 평가 시스템, 즉 Evals를 어떻게 설계해야 실제 제품 의사결정에 도움이 되는지를 설명한다. Nick Ung과 Akshay는 단순히 LLM 응답을 점수화하는 수준을 넘어, 출시 전 오프라인 평가, 출시 후 온라인 평가, LLM-as-a-Judge 검증, 트레이싱, 오류 분석, 그리고 지속적인 개선 루프까지 하나의 시스템으로 묶어야 한다고 강조한다.
강연의 핵심 주장은 명확하다. 평가 지표는 보기 좋은 숫자가 아니라 실제로 출시 여부를 결정하고, 회귀를 감지하며, 다음 개선 작업의 우선순위를 바꾸는 장치여야 한다. 따라서 좋은 Eval은 모델 자체보다 더 넓은 범위, 즉 사용자 시뮬레이션, 데이터셋 구성, 도메인 전문가의 라벨링, 평가자 검증, 운영 트레이스 분석, CI/CD 게이트까지 포함하는 엔지니어링 시스템에 가깝다.
Eval은 점수가 아니라 출시 게이트다
Nick은 AI 에이전트 개발 과정을 전통적인 머신러닝 모델 개발과 유사하게 바라본다. 머신러닝 모델을 프로덕션에 배포하기 전에 오프라인 평가를 수행하듯, 사용자와 직접 상호작용하는 AI 에이전트도 실제 사용자에게 노출되기 전에 충분한 검증을 거쳐야 한다는 것이다. 특히 고객지원 에이전트는 단일 응답을 생성하는 시스템이 아니라 여러 턴에 걸쳐 사용자와 대화하고, 정책을 해석하며, 도구를 호출하고, 때로는 사람 상담원에게 이관해야 하는 복합 시스템이다.
이 때문에 Lyft는 개발 단계와 프로덕션 단계를 구분하고, 두 단계 사이에 엄격한 오프라인 평가 프로세스를 둔다. 개발 단계에서는 RAG 파이프라인, 도구 정의, LangGraph 기반 에이전트 그래프, 시스템 프롬프트 등이 구성되고, 그 결과 만들어진 AI 에이전트는 곧바로 실제 사용자에게 배포되지 않는다. 먼저 실제 운영 트래픽을 대표할 수 있는 데이터셋과 사용자 LLM 시뮬레이터, 그리고 LLM-as-a-Judge와 결정론적 평가기를 통해 충분한 성능을 확인해야 한다.
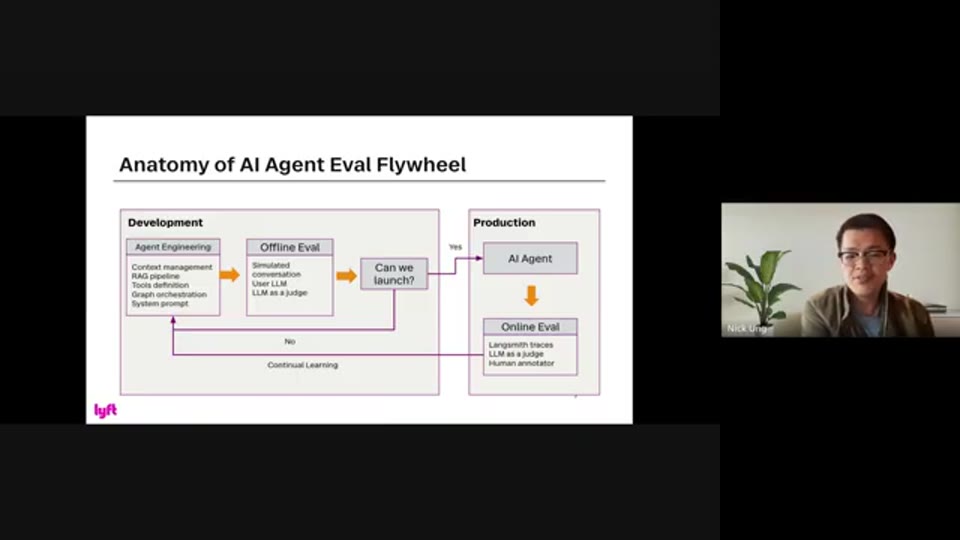
02:48 - 개발 단계에서 프로덕션 배포 전 오프라인 평가를 거치는 전체 평가 시스템 구조
강연자가 반복해서 강조한 문장은 “실제 사용자를 테스트 데이터로 쓰지 말아야 한다”는 원칙이다. 이는 AI 에이전트가 실패했을 때 단순한 모델 품질 문제가 아니라 사용자 경험, 고객 신뢰, 비용, 운영 리스크로 이어지기 때문이다. 따라서 Eval은 실험용 대시보드가 아니라 프로덕션 진입을 막거나 허용하는 launch gate로 기능해야 하며, 이 게이트가 없다면 평가 점수는 조직 안에서 실질적인 힘을 갖기 어렵다.
오프라인 평가는 실제 사용자를 닮아야 한다
Lyft의 오프라인 평가 시스템은 TauBench에서 많은 영감을 받았다. TauBench는 고객지원 AI 에이전트 평가를 위해 사용자 시뮬레이션과 도메인 정책, 멀티턴 대화 궤적을 함께 다루는 접근법으로 소개되며, Lyft는 이 아이디어를 자사 고객지원 환경에 맞게 적용했다. 여기서 중요한 점은 단순히 테스트 질문 몇 개를 LLM에게 생성시키는 것이 아니라, 실제 프로덕션에서 발생하는 사용자 의도, 사용자 상태, 도메인 정책, 사용자 페르소나를 구조화해 시뮬레이션에 반영하는 것이다.
예를 들어 Lyft의 고객지원 상황에서는 사용자가 드라이버인지 승객인지, 오랫동안 Lyft를 사용해온 고객인지, 특정 보상이나 정산 문제로 불만을 가진 사람인지에 따라 대화 양상이 달라진다. 강연자는 이를 user intent, world state, user persona로 나누어 설명한다. 이 요소들이 충분히 반영되어야 에이전트가 실제 운영 환경에서 마주칠 복잡한 요청과 감정적 반응, 불완전한 설명, 갑작스러운 이관 요청을 평가할 수 있다.
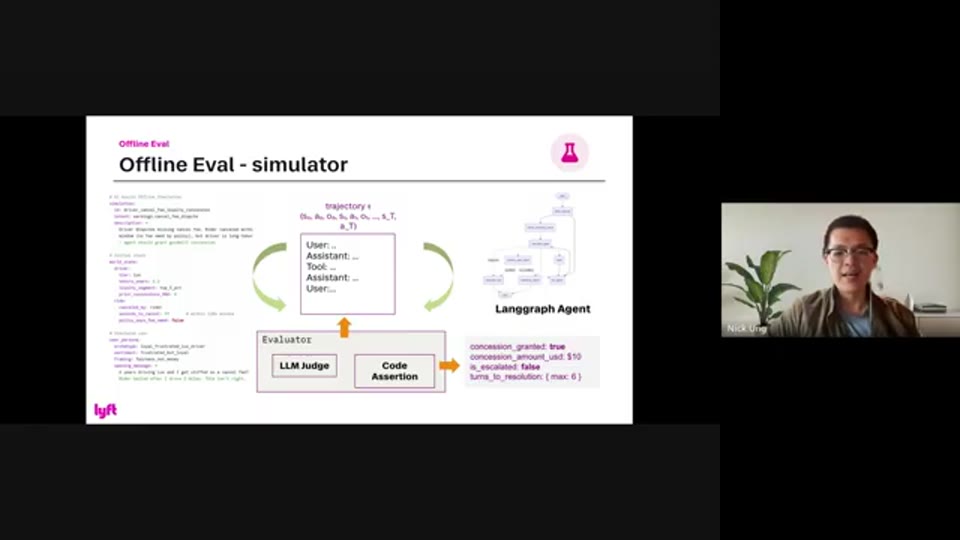
08:44 - TauBench에서 영감을 받은 오프라인 사용자 시뮬레이터와 LangGraph 에이전트 구조
초기 접근의 문제는 LLM이 너무 친절한 사용자 역할을 한다는 데 있었다. 프런티어 모델 수준의 LLM은 기본적으로 도움이 되고 정중한 어시스턴트로 훈련되어 있기 때문에, 고객지원 상황에서도 문제를 차분하고 자세하게 설명하는 사용자처럼 행동하기 쉽다. 하지만 실제 고객지원에 연락하는 사용자는 이미 답답함을 느끼고 있거나, 짧고 불완전한 문장으로 문제를 던지거나, AI를 거치지 않고 바로 사람 상담원에게 연결되길 원할 수 있다. 이 차이를 무시하면 오프라인 평가의 통과율은 높게 나오지만, 그 숫자는 프로덕션 성능을 과대평가하게 된다.
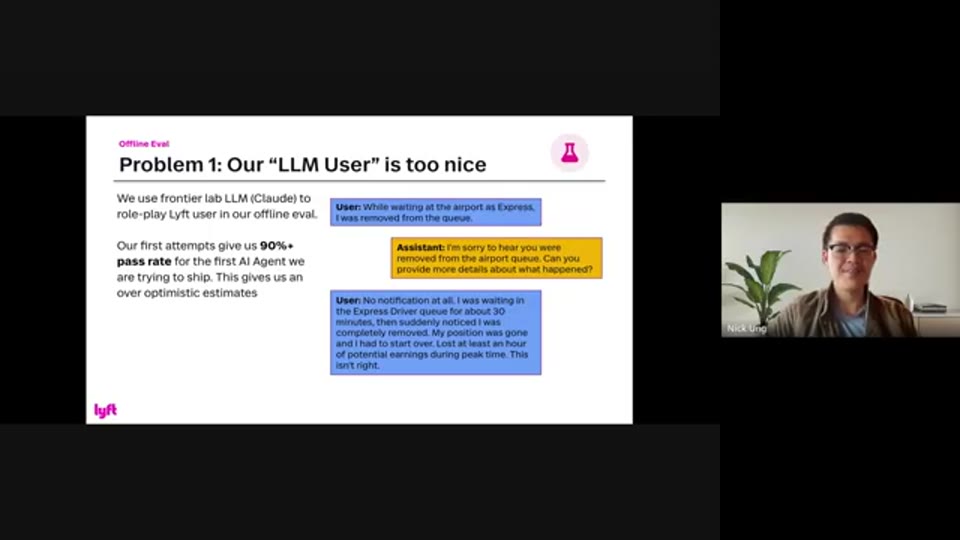
14:17 - LLM 사용자 시뮬레이션이 실제 고객보다 지나치게 정중하게 동작해 90% 이상의 과도한 통과율이 나온 문제
Lyft는 이 문제를 해결하기 위해 실제 Lyft 사용자 표현에 가까운 데이터로 사용자 LLM을 파인튜닝했다. 그 결과 평가 점수는 낮아졌지만, 강연자는 오히려 이것이 바람직한 신호라고 설명한다. 쉬운 Eval은 에이전트의 약점을 드러내지 못하고, 어려운 Eval은 프로덕션에서 발생할 실패 모드를 미리 드러낸다. 다시 말해 Eval의 목적은 높은 점수를 얻는 것이 아니라, 배포 전에 시스템이 어디서 깨지는지 발견하는 것이다.
LLM-as-a-Judge는 범용 점수표가 아니라 업무 성공 판정기여야 한다
Akshay는 많은 팀이 LLM-as-a-Judge를 도입하면서 빠지는 함정을 지적한다. 흔히 사용되는 평가지표는 응답의 helpfulness, naturalness, completeness, toxicity, bias, fairness, conciseness처럼 일반적인 품질 속성을 측정한다. 이런 지표들은 출발점으로는 유용하지만, 실제 제품 개선에는 충분하지 않다. 예를 들어 response helpfulness가 0.5로 나왔다고 해서 엔지니어가 무엇을 고쳐야 하는지 바로 알기는 어렵다.
Lyft가 도달한 결론은 평가 지표가 비즈니스 목표와 기능 요구사항에 직접 연결되어야 한다는 것이다. 고객지원 에이전트라면 “대화가 자연스러운가”보다 “이 사용자의 문제를 정책에 맞게 해결했는가”, “교육이 필요한 상황에서 적절히 안내했는가”, “사람 상담원에게 이관해야 하는 시점을 놓치지 않았는가”가 더 중요하다. 따라서 좋은 LLM Judge는 추상적인 품질 점수를 매기는 심사위원이 아니라, 특정 업무가 성공했는지 실패했는지를 판정하는 이진 분류기에 가까워야 한다.
강연에서 소개된 예시는 education rubric이다. AI 에이전트가 사용자를 교육해야 하는 상황에서 너무 오래 설명만 반복해 이관을 지연하면 실패이고, 반대로 사용자를 교육할 기회를 주지 않고 너무 빨리 이관해도 실패다. 반면 정책과 상황에 맞게 사용자를 안내하고 적절한 시점에 다음 행동을 취했다면 성공으로 본다. 이처럼 성공과 실패 기준이 구체적일수록 평가 결과는 엔지니어링 액션으로 이어지기 쉬워진다.
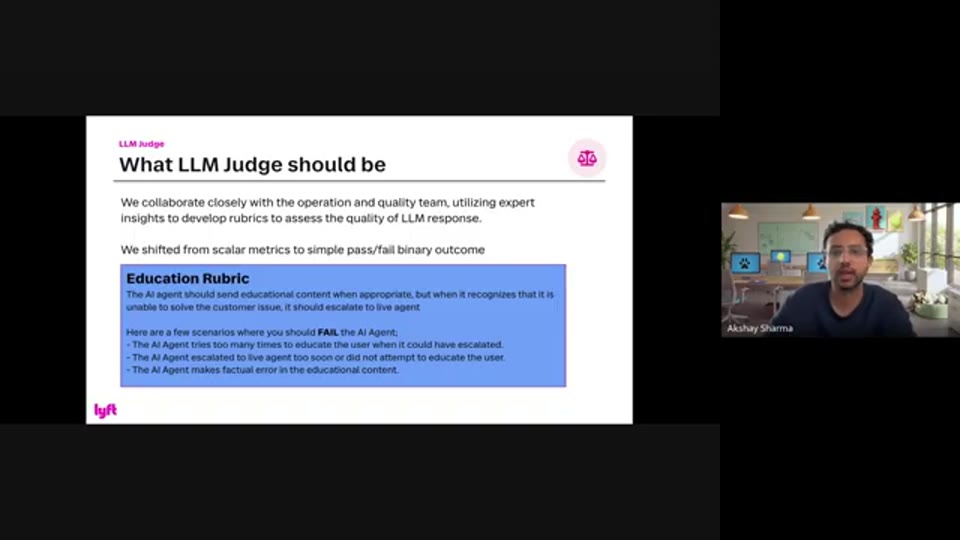
20:28 - 도메인 전문가와 함께 정의한 education rubric 예시를 통해 actionable metric을 설명하는 구간
여기서 중요한 변화는 평가 프롬프트를 “좋은 답변인지 판단하라”가 아니라 “이 업무가 성공했는지 실패했는지, 아래 기준에 따라 분류하라”로 바꾸는 것이다. 이 접근은 모호한 점수보다 캘리브레이션이 쉽고, 도메인 전문가와 데이터 사이언티스트가 함께 기준을 다듬기에도 적합하다. 결과적으로 Eval은 모델의 미묘한 문체를 평가하는 장치가 아니라, 제품이 지켜야 할 업무 규칙과 사용자 경험 기준을 검증하는 장치가 된다.
Judge도 검증 대상이다
LLM-as-a-Judge를 사용한다고 해서 그 판단을 곧바로 신뢰해서는 안 된다. Akshay는 Judge를 전통적인 머신러닝 분류기처럼 다뤄야 한다고 설명한다. 즉, 사람이 직접 라벨링한 ground truth를 만들고, Judge가 그 라벨과 얼마나 일치하는지 precision과 recall로 측정해야 한다. Judge가 잘못된 판정을 내린다면, 그 위에 세운 에이전트 평가 결과도 흔들릴 수밖에 없다.
Lyft의 접근은 약 100개 수준의 예시를 pass/fail로 수작업 라벨링한 뒤, 이를 train, dev, validation 세트로 나누는 방식이다. 여기서 train 세트는 모델 가중치를 학습시키기 위한 데이터가 아니라 Judge 프롬프트에 들어갈 few-shot 예시를 고르는 데 사용된다. dev 세트는 Judge 프롬프트와 평가 기준을 반복적으로 개선하는 데 쓰이고, test 또는 validation 세트는 dev 예시에 과적합되지 않았는지 확인하는 데 사용된다.
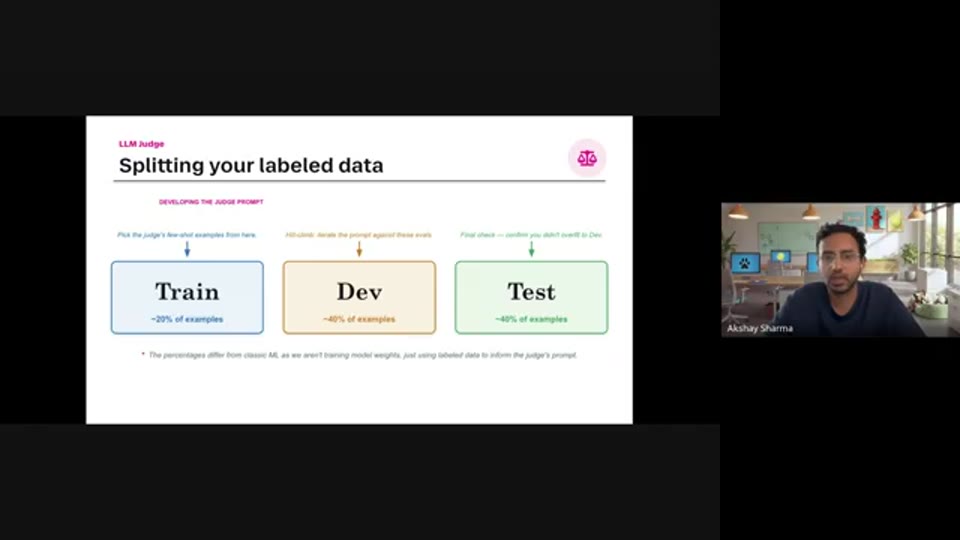
22:42 - LLM Judge를 train, dev, validation 세트로 검증하고 precision과 recall을 계산하는 방식
이 과정은 Eval을 한 번 작성하고 끝내는 문서가 아니라, 데이터와 함께 발전하는 시스템으로 만든다. 강연자는 이를 criteria drift와 validating the validators라는 관점으로 설명한다. 실제 데이터를 더 많이 보고, 더 많은 실패 사례를 라벨링하고, 더 다양한 사용자 행동을 접할수록 “좋은 응답”과 “나쁜 응답”에 대한 조직의 기준도 변한다. 따라서 평가 기준은 모델 관찰과 분리되어 존재하는 고정된 규칙이 아니라, 모델의 실제 실패를 보며 함께 진화해야 한다.
이 지점은 많은 AI 제품 팀에게 특히 중요하다. 평가자가 틀릴 수 있다는 사실을 인정하지 않으면, 팀은 잘못된 신호를 기준으로 모델을 개선하게 된다. 반대로 Judge 자체를 정기적으로 측정하고 개선하면, 에이전트 성능 지표가 실제 사용자 경험과 더 잘 연결된다.
숫자에는 신뢰구간이 필요하다
Eval 결과가 의사결정에 쓰이려면 통계적 엄밀성도 필요하다. Akshay는 많은 팀이 alignment rate나 pass rate를 단일 점 추정치로 보고하지만, 실제로는 표본 수와 변동성을 고려하지 않으면 그 차이가 의미 있는지 판단하기 어렵다고 말한다. 예를 들어 한 평가기가 84%, 다른 평가기가 88%를 기록했다고 해서 두 번째가 확실히 더 낫다고 결론 내릴 수는 없다. 표본이 50개에 불과하고 차이가 4%p라면, 그 차이는 실제 개선이 아니라 샘플링 노이즈일 수 있다.
그렇다고 모든 숫자에 과도한 통계 분석을 붙여야 한다는 뜻은 아니다. 강연자는 비용이 큰 엄밀성은 중요한 순간에 집중해야 한다고 설명한다. 출시 여부를 결정하거나, 리더십에 보고하거나, 특정 모델 변경이 실제 개선인지 판단해야 하는 경우라면 confidence interval(신뢰구간), calibration(보정), 적절한 sampling(표본 추출)이 필요하다. 반면 탐색적 분석이나 내부 디버깅 단계에서는 더 가벼운 지표로 빠르게 학습할 수도 있다.
핵심은 숫자가 결정을 바꾸는 순간, 그 숫자에 불확실성도 함께 표시해야 한다는 것이다. “88%가 84%보다 높다”는 문장은 직관적으로 설득력 있어 보이지만, “50개 샘플에서 4%p 차이가 났고 신뢰구간이 겹친다”는 문장은 전혀 다른 판단을 요구한다. Eval이 제품 출시 게이트라면, 그 게이트를 통과하거나 막는 숫자는 반드시 통계적으로 해석 가능해야 한다.
트레이싱과 어노테이션 큐가 평가 루프의 기반이다
온라인 평가에서 가장 중요한 기반은 tracing이다. 강연자는 LangSmith, Langfuse 같은 도구를 예로 들며, 에이전트 실행의 전체 그래프를 기록해야 한다고 설명한다. 어떤 노드가 실행되었는지, LLM이 어떤 컨텍스트를 보았는지, 어떤 도구가 호출되었는지, 토큰 사용량과 latency가 어땠는지까지 기록되어야 나중에 실패 원인을 분석할 수 있다. 멀티에이전트 시스템이나 agentic flow에서는 최종 응답만 봐서는 문제가 어디에서 시작되었는지 알기 어렵기 때문이다.
트레이스는 단순한 로그가 아니라, 평가 데이터셋으로 다시 들어가는 원천이다. 도메인 전문가는 raw JSON을 직접 읽는 대신 annotation queue를 통해 사례를 라벨링하고 피드백을 줄 수 있다. 이렇게 라벨링된 트레이스는 오프라인 평가 데이터셋에 추가되거나, Judge의 precision과 recall을 계산하는 ground truth로 활용된다. 즉, 온라인 운영에서 발생한 실패가 오프라인 평가를 강화하고, 강화된 오프라인 평가가 다음 배포의 품질을 높이는 구조가 만들어진다.
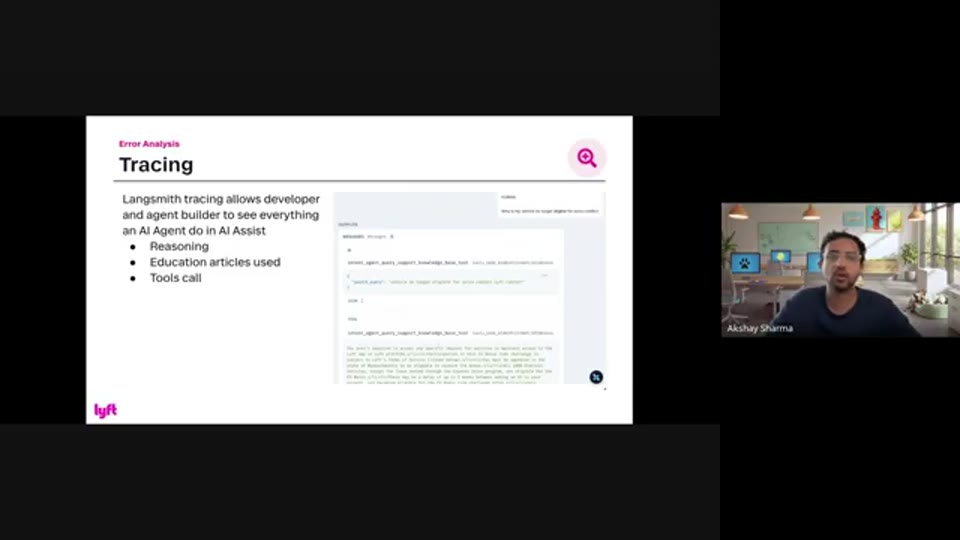
29:28 - LangSmith, Langfuse 같은 트레이싱 도구와 annotation queue를 활용해 raw trace를 라벨링하는 구조
Akshay가 제시한 error analysis loop도 같은 맥락에 있다. 먼저 raw trace를 깊이 들여다보고, 실패 모드를 특정하며, 실제 의사결정을 바꾸는 지표만 남긴다. 이후 새로운 가설을 세워 다시 평가하고, 이 과정을 정기적으로 반복한다. 이 루프는 일회성 감사가 아니라 지속 운영 프로세스이며, 주간 또는 격주 cadence로 반복될 때 Eval은 조직의 학습 시스템으로 기능한다.
개선은 모델 학습, 컨텍스트 학습, 하네스 학습으로 나뉜다
Nick은 Eval의 궁극적인 목적이 평가 인사이트를 다시 에이전트 성능 개선으로 되돌리는 것이라고 설명한다. 그는 이를 model learning, context learning, harness learning으로 나눈다. Model learning은 post-training이나 custom LLM 학습처럼 모델 가중치를 업데이트하는 방식이다. 반면 context learning과 harness learning은 모델 자체를 바꾸지 않고 에이전트가 보는 정보와 실행 환경을 개선하는 접근이다.
Context learning은 에이전트가 어떤 문서, 메모리, 사용자 상태, 도구 출력 등을 참고하는지를 개선하는 작업이다. 고객지원 에이전트가 실패하는 이유가 모델의 언어 능력 부족이 아니라 잘못된 정책 문서를 참조했거나 필요한 사용자 정보를 보지 못했기 때문이라면, 모델 파인튜닝보다 컨텍스트 관리 전략을 고치는 것이 더 효과적일 수 있다. Harness learning은 시스템 프롬프트, 도구 스키마, control flow, routing, retry 전략 등을 개선하는 영역이다. 즉, 같은 모델이라도 어떤 절차와 제약 안에서 실행되느냐에 따라 성능이 크게 달라진다.
이 구분은 실무적으로 중요하다. Eval이 실패 사례를 보여줄 때마다 곧바로 “모델을 바꿔야 한다”고 결론 내리면 비용이 커지고 원인 분석도 흐려진다. 실패가 지식 베이스 문제인지, 프롬프트 문제인지, 라우팅 문제인지, 도구 호출 문제인지, 또는 정말 모델 능력의 한계인지 분류해야 한다. Lyft의 평가 루프는 바로 이 분류를 가능하게 만들고, 각 실패 모드를 적절한 개선 경로로 연결하는 역할을 한다.
Eval Harness는 평가를 조직의 공용 인프라로 만든다
강연 후반부에서 Nick은 Lyft가 앞으로 투자하려는 영역으로 체계적인 Eval Harness를 소개한다. 현재 오프라인 시뮬레이터를 실행할 수 있는 능력은 있지만, 여러 노트북과 분석 레포지토리에 스크립트가 흩어져 있어 반복성과 표준화가 부족하다고 설명한다. 고객지원 AI 에이전트처럼 여러 에이전트와 서브에이전트가 존재하는 시스템에서는 평가를 개인별 실험 코드로 유지하기 어렵다.
Eval Harness는 평가를 config-driven 방식으로 실행하는 공통 인프라다. 강연자는 YAML 파일 기반 설정을 언급하며, 엔지니어뿐 아니라 애널리스트와 데이터 사이언티스트도 평가 스위트에 기여할 수 있어야 한다고 말한다. 이를 위해 task, dataset, persona, LLM adapter, evaluator 같은 primitive를 정의하고, 수천에서 수만 개 예시를 병렬로 처리할 수 있는 throughput도 필요하다. 평가가 커질수록 실행 속도와 기여 방식, 설정의 재사용성이 제품 개발 속도를 좌우하게 된다.
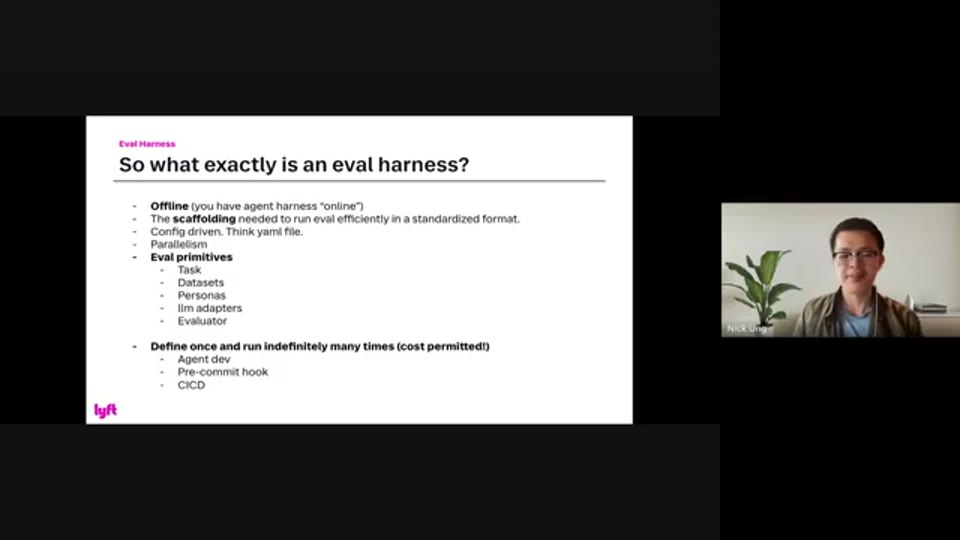
34:51 - YAML 기반 config-driven Eval Harness와 task, dataset, persona, LLM adapter, evaluator primitive
이 하네스의 장점은 한 번 정의한 평가 설정을 여러 개발 지점에서 반복 실행할 수 있다는 데 있다. 로컬에서 프롬프트를 수정할 때 즉시 이전 버전과 비교할 수 있고, pre-commit hook에서 성능 저하를 감지할 수 있으며, CI/CD에서는 regression test suite나 acceptance test suite로 활용할 수 있다. 이렇게 되면 Eval은 발표용 지표가 아니라 개발 워크플로 자체에 들어간 품질 보증 장치가 된다.
마무리 / 핵심 정리
이 강연이 전달하는 가장 중요한 메시지는 “좋은 Eval은 어려워야 하고, 구체적이어야 하며, 실제 결정을 바꿔야 한다”는 것이다. 단순히 LLM에게 여러 문장을 평가하게 하고 점수를 모으는 방식은 빠르게 시작할 수 있지만, 그 점수가 출시를 막지도 않고, 실패 원인을 알려주지도 않고, 제품 개선 방향을 바꾸지도 않는다면 실질적인 가치는 제한적이다.
Lyft의 사례는 고객지원 AI 에이전트 평가가 하나의 end-to-end 시스템이어야 함을 보여준다. 실제 사용자를 닮은 사용자 시뮬레이터, 도메인 정책에 맞춘 업무 성공 기준, 검증 가능한 LLM Judge, 트레이스 기반 오류 분석, 통계적으로 해석 가능한 지표, 그리고 반복 실행 가능한 Eval Harness가 함께 있어야 한다. 특히 사용자를 실제보다 친절하게 가정하지 않는다는 점은 실무적으로 큰 교훈이다. 프로덕션은 항상 교과서적인 입력보다 거칠고 불완전하며, Eval은 바로 그 현실을 모델보다 먼저 마주해야 한다.
결국 AI 에이전트의 품질은 모델 성능만으로 결정되지 않는다. 에이전트가 어떤 정보를 보고, 어떤 도구를 호출하며, 어떤 흐름으로 판단하고, 실패했을 때 조직이 어떻게 학습하는지가 함께 성능을 만든다. 이 강연은 Eval을 “측정”이 아니라 “운영 가능한 학습 루프”로 바라보게 만드는 실무적 프레임워크를 제시한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Build Evals That Actually Matter - Nick Ung, Lyft |
| 채널 | AI Engineer |
| 영상 길이 | 약 37분 36초 |
| 리포트 작성 | 2026-07-20 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.