Build an AI code review agent with Vercel Eve full tutorial
📺 원본 영상: Build an AI code review agent with Vercel Eve full tutorial
🎙️ 채널: How I AI
📅 정리 일자: 2026-08-06
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 영상은 AI가 작성한 Pull Request(PR)가 급증하는 상황에서, 모든 PR을 사람이 직접 리뷰해야 한다는 전제를 다시 검토한다. 강연자는 Vercel Eve를 활용해 GitHub PR을 읽고, 위험도를 점수화하며, 낮은 위험도의 PR은 승인 신호를 남기고 Slack으로 사람에게 최종 조치를 요청하는 내부 에이전트를 구축한 과정을 설명한다.
핵심은 “AI 코드 리뷰가 사람의 리뷰를 완전히 대체한다”는 주장이라기보다, 반복적이고 낮은 위험도의 리뷰를 자동화해 인간 리뷰어가 더 중요한 판단에 집중하도록 만드는 운영 설계에 있다. 특히 강연자는 Intercom의 AI 승인 PR 사례와 DiffVader 방식에서 영감을 받아, 속도와 품질뿐 아니라 감사 가능성, 정책 준수, 위험 분류 체계를 함께 고려해야 한다고 강조한다.
AI가 만든 PR이 조직의 병목이 되는 이유
강연자는 영상 초반부터 현재 엔지니어링 조직이 마주한 병목을 명확하게 제시한다. AI 코딩 도구가 보편화되면서 이제는 더 많은 사람이 더 빠르게 코드를 작성하고 GitHub에 PR을 올릴 수 있게 되었지만, 그 결과 리뷰 큐는 오히려 더 빠르게 쌓이기 시작했다. 코드 작성 속도가 빨라졌다고 해서 리뷰 역량이 같은 비율로 늘어나는 것은 아니기 때문에, 조직은 “AI로 코드를 쓰는 문제” 다음 단계인 “AI가 만든 PR을 어떻게 처리할 것인가”라는 질문에 부딪히게 된다.
강연자는 이 문제를 단순한 생산성 이슈로 보지 않는다. 리뷰가 지연되면 배포 주기가 길어지고, 작은 문서 수정이나 안전한 변경까지 사람의 주의를 점유하게 된다. 반대로 모든 PR을 무심코 통과시키면 품질과 보안 리스크가 커진다. 따라서 필요한 것은 무조건적 자동 승인도, 모든 변경에 대한 수동 검토도 아니라, 변경의 위험도를 판단하고 그 판단 근거를 남기는 중간 계층이다.
이 지점에서 강연자는 Intercom 사례를 중요한 선례로 언급한다. Intercom은 AI 도입 이후 PR 처리량이 크게 증가했고, 이에 대응하기 위해 PR을 자동 평가하고 일부를 자동 승인하는 시스템을 구축했다고 소개된다. 강연자가 주목한 부분은 단순히 승인 속도가 빨라졌다는 사실이 아니라, AI 승인 PR의 추적 가능성과 감사 가능성을 확보해 SOC 2, HIPAA 같은 컴플라이언스 환경에서도 설명 가능한 체계를 만들었다는 점이다.
Intercom 사례가 보여준 핵심 전환
강연자에 따르면 Intercom의 접근법은 “AI가 쓰는 코드는 위험하다”는 직관을 그대로 받아들이지 않는다. 오히려 AI를 잘 설계된 검토 루프 안에 넣으면, 인간이 놓칠 수 있는 반복적 검증과 정책 기반 판단을 더 일관되게 수행할 수 있다는 관점에 가깝다. 강연자는 Intercom의 AI 승인 PR이 사람 리뷰보다 약 다섯 배 빠르게 승인되었고, production 배포 이후 되돌려야 하는 revert rate도 더 낮았다고 설명한다.
물론 이 수치는 영상에서 강연자가 언급한 사례에 기반한 것이므로, 모든 조직에 그대로 적용되는 일반 법칙으로 볼 수는 없다. 다만 중요한 함의는 분명하다. AI 리뷰의 안전성은 모델 자체의 능력만으로 결정되는 것이 아니라, 어떤 변경을 낮은 위험으로 정의하는지, 어떤 변경은 사람에게 올리는지, 판단 결과를 어떻게 로깅하고 감사할 수 있게 만드는지에 따라 달라진다.
강연자는 특히 컴플라이언스 환경에서 자동 승인이 불가능하다는 반론에 대해, 정책과 감사 체계를 갖추면 접근 가능하다고 말한다. 여기서 핵심은 “AI가 승인했다”는 사실을 숨기는 것이 아니라, 어떤 정책에 따라 어떤 근거로 승인 또는 보류했는지를 기록하는 것이다. 결국 AI 코드 리뷰 에이전트는 단순한 편의 기능이 아니라, 조직의 코드 리뷰 정책을 실행 가능한 시스템으로 옮기는 도구가 된다.
Vercel Eve를 선택한 이유
강연자는 이 튜토리얼에서 Vercel Eve를 사용한 이유를 비교적 실용적으로 설명한다. Eve는 엔터프라이즈 환경에서 Slack, GitHub 같은 업무 채널과 연결되는 AI 에이전트를 빠르게 배포하기 쉬운 프레임워크로 소개된다. 강연자는 Eve 에이전트가 기본적으로 instructions, skills, code로 구성된 디렉터리 구조에 가깝기 때문에, 복잡한 프레임워크를 깊게 이해하지 않아도 자연어 지시와 TypeScript 구현을 조합해 내부 자동화 에이전트를 만들 수 있다고 본다.
Eve의 장점은 에이전트 자체의 추론 능력보다 주변 연결성을 단순화한다는 데 있다. Slack bot이나 GitHub App을 직접 구성해 본 사람이라면 OAuth, refresh token, 권한 범위, 이벤트 구독, manifest 설정 같은 작업이 실제 구현 시간보다 더 번거로울 수 있다. 강연자는 Vercel Connectors를 사용하면 이러한 연결 과정을 Vercel 계정 안에서 마법사처럼 설정할 수 있고, 그 덕분에 에이전트 구축의 초기 마찰이 크게 줄어든다고 설명한다.
또한 Eve는 Vercel Chat SDK를 기반으로 하며, Slack, Teams, WhatsApp 같은 여러 채널에서 동작하는 챗봇을 세우는 복잡성을 줄여준다고 소개된다. 강연자는 이미 내부용 Slack 에이전트를 만들 때 Eve로 옮기고 있다고 말할 정도로, 반복적인 사내 자동화 use case에 적합한 도구로 평가한다. STT상 “Vercelles Eve”처럼 들리는 부분은 문맥상 Vercel Eve로 교정해 이해하는 것이 자연스럽다.
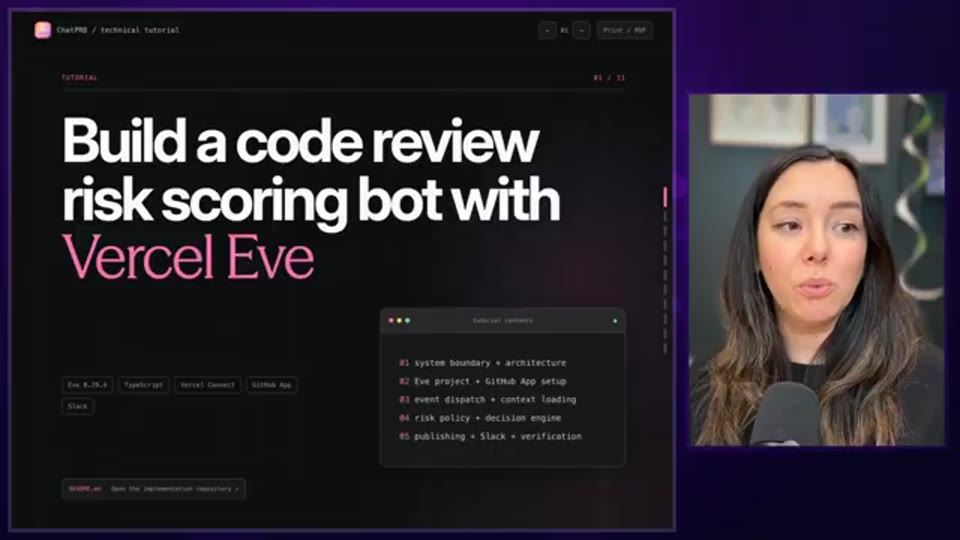
06:17 - Codex로 만든 데크를 열고 Vercel Eve 기반 PR risk scoring bot의 전체 구축 흐름을 소개하는 장면
Codex로 만든 PR 리뷰 에이전트의 출발점
흥미로운 점은 강연자가 처음부터 상세한 시스템 설계를 작성하지 않았다는 것이다. 강연자는 Codex에 내부 GitHub bot 또는 app을 만들고 싶다고 요청했으며, 모든 CI checks가 green 상태가 된 뒤 PR을 low, medium, high risk로 평가하고 low risk PR을 자동 승인하도록 만들고 싶다는 수준의 프롬프트로 시작했다고 설명한다. 이후 “Vercel Eve agent로 설계해도 된다”는 식으로 방향을 잡아주자, Codex가 초기 구현을 진행했다.
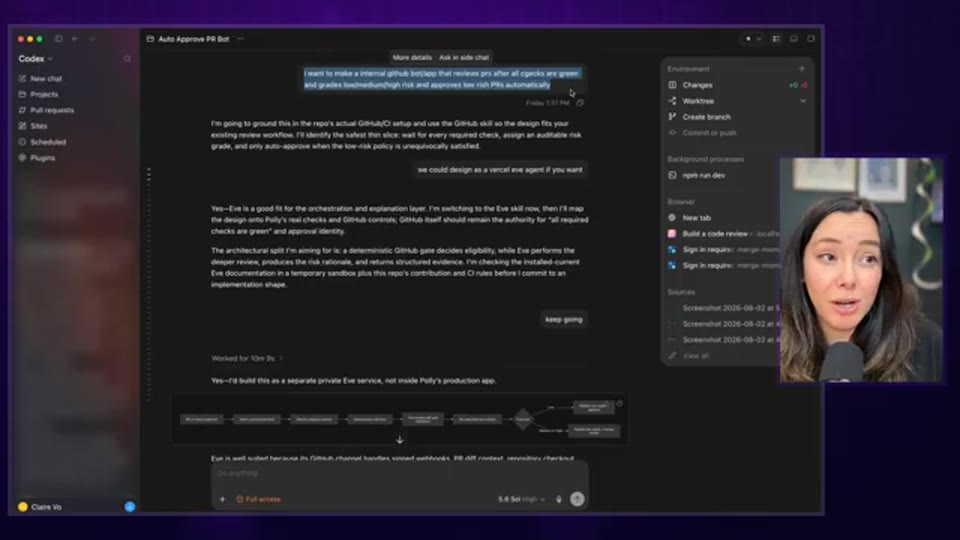
09:28 - Codex에 입력한 초기 프롬프트와 PR review bot 생성 과정을 보여주는 장면
이 대목은 AI 에이전트 개발에서 중요한 실무 감각을 보여준다. 완성된 아키텍처 문서를 사람이 먼저 쓰지 않아도, 목적과 트리거, 판단 기준, 결과 액션이 충분히 명확하면 AI 코딩 도구가 초기 골격을 만들 수 있다. 다만 강연자는 Codex가 모든 것을 완벽하게 했다는 식으로 말하지 않고, 몇 차례 방향을 조정하고 refinement를 거쳤다고 설명한다. 즉 이 작업은 “한 번의 프롬프트로 production 시스템 완성”이라기보다, AI를 빠른 구현 파트너로 두고 사람이 운영 판단을 더하는 방식에 가깝다.
설정 작업에서도 강연자는 Chrome 브라우저 사용 기능을 활용했다고 말한다. Slack bot과 GitHub App 설정처럼 브라우저에서 권한을 고르고 저장 버튼을 눌러야 하는 과정은 코드 작성보다 지루하고 실수하기 쉽다. 강연자는 Codex가 브라우저를 사용해 설정 화면을 탐색하도록 하고, 자신은 버튼 클릭이나 최종 확인을 보조하는 식으로 구성 작업을 줄였다고 설명한다.
에이전트의 기본 동작 흐름
강연자가 소개한 PR 리뷰 에이전트의 기본 흐름은 단순하지만 실무적으로 설득력 있다. 먼저 GitHub App이 PR 관련 이벤트를 감지하고, 모든 변경과 checks가 완료된 뒤 Vercel의 GitHub integration을 통해 Eve agent가 호출된다. 이후 Vercel sandbox가 뜨고 repository를 checkout한 뒤, 에이전트는 PR의 diff와 관련 파일을 읽어 변경 내용을 평가한다.
평가 과정에서 에이전트는 단순히 “좋아 보인다”거나 “문제가 있다”는 감상적 리뷰를 남기지 않는다. PR의 위험도와 품질을 판단하기 위한 skill과 tool을 실행하고, 그 결과를 근거와 함께 정리한다. low risk로 판단되면 PR에 approval 신호를 남기고, 사람이 필요하다고 판단되면 Slack으로 escalation한다. blocking requirement가 있으면 approval 대신 변경 요청 또는 보류 상태를 만들며, 이 점은 사람 리뷰어의 의사결정 흐름과 유사하다.
강연자는 이 구조가 특별히 많은 파일이나 과도한 코드로 이루어지지 않았다고 강조한다. GitHub channel, instructions, PR을 읽는 skill, PR 주변 정보를 읽는 tool, risk decision을 남기는 tool, Slack notifier 정도가 주요 구성 요소로 소개된다. 결국 핵심은 거대한 agent platform을 만드는 것이 아니라, PR 리뷰라는 좁은 업무를 위해 필요한 입력, 판단 기준, 출력 채널을 명확히 연결하는 데 있다.
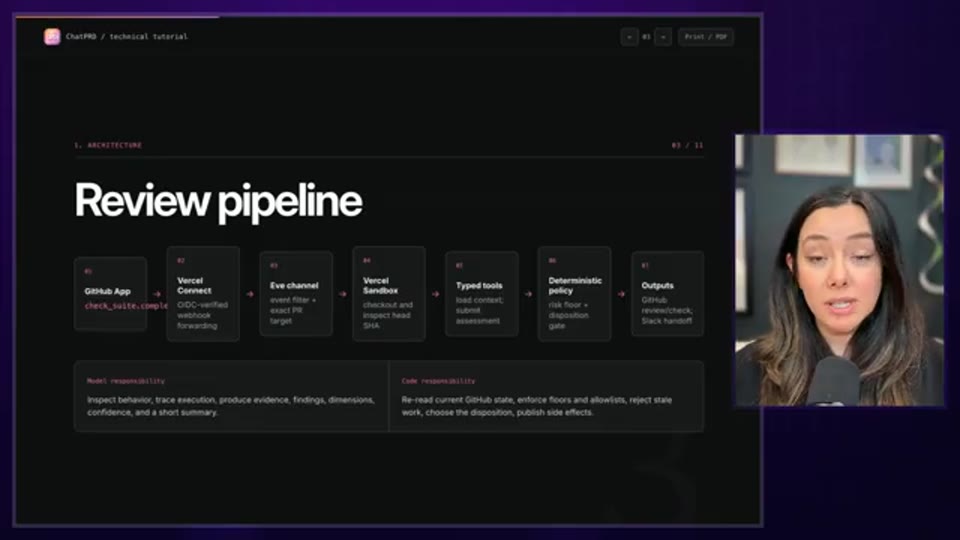
12:45 - 에이전트가 repository를 checkout하고 diff를 확인한 뒤 risk와 quality를 평가하는 기술 흐름을 설명하는 장면
위험도 평가는 무엇을 봐야 하는가
강연자가 만든 에이전트는 PR 위험도를 평가할 때 여섯 가지 축을 본다고 설명한다. 변경 면적과 blast radius, 되돌리기 쉬운지 여부, 데이터와 보안에 닿는지 여부, 운영상 변화가 있는지 여부, 그리고 테스트와 CI가 충분한지 같은 verification gap이 주요 기준이다. 이러한 기준은 코드의 줄 수만으로 위험도를 판단하지 않겠다는 의도를 담고 있다.
예를 들어 문서만 수정한 PR은 대체로 low risk에 가깝지만, 인증이나 billing, server API behavior를 바꾸는 PR은 훨씬 더 신중하게 봐야 한다. 반대로 diff가 크더라도 오래된 코드를 제거하는 작업처럼 맥락상 위험이 중간 수준에 머무를 수 있고, diff가 작더라도 권한 검증 로직을 바꾸면 high risk가 될 수 있다. 강연자는 “diff size does not set risk”라는 식의 규칙을 언급하며, 단순 변경량보다 변경 성격이 더 중요하다는 점을 분명히 한다.
점수 체계는 low, medium, high risk로 나뉜다. 영상에서는 24점 이하가 low risk, 25점에서 64점이 medium risk, 65점 이상이 high risk로 소개된다. 이 임계값은 강연자가 직접 설계했다기보다 Codex가 생성한 뒤 refinement한 것으로 보이며, 실제 조직에서 적용하려면 repository의 도메인, 장애 비용, 배포 전략, rollback 가능성에 맞게 조정해야 한다.
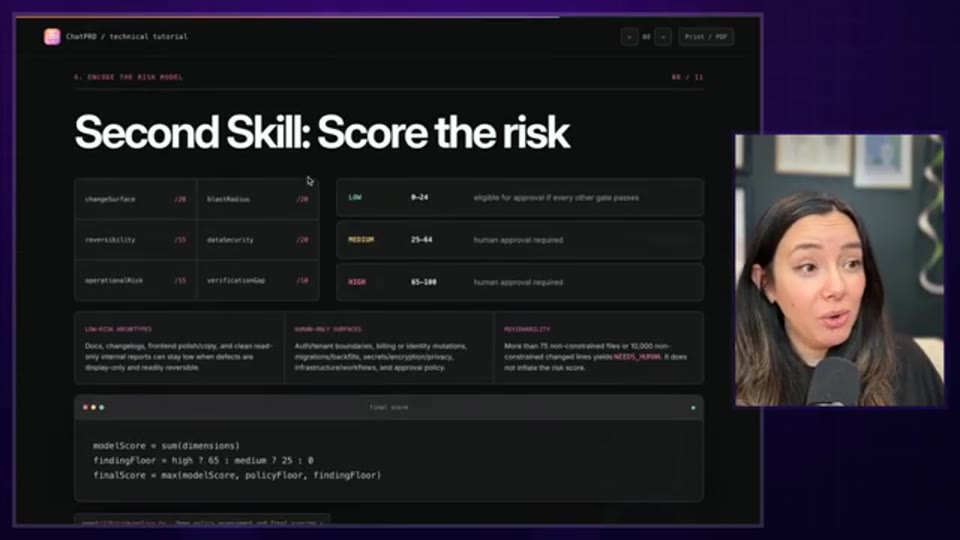
15:47 - 변경 면적, reversibility, data security, verification gap 등을 기준으로 risk score를 계산하는 화면을 설명하는 장면
자동 승인과 인간 승인 사이의 현실적 경계
강연자가 만든 bot은 low risk PR에 대해 자동 approval 신호를 남길 수 있지만, 실제 repository rule을 완전히 우회하지는 않는다. 강연자의 조직은 GitHub에서 required approval 규칙을 유지하고 있으며, bot의 회색 check mark는 “이 PR은 낮은 위험으로 평가되었으니 사람이 빠르게 승인해도 된다”는 신호로 사용된다. 즉 최종 merge 권한은 여전히 사람에게 남아 있고, bot은 리뷰 큐에서 우선순위와 신뢰 신호를 제공하는 역할을 한다.
이 설계는 꽤 현실적이다. 많은 조직에서 bot account의 approval을 required human review와 동일하게 인정하면 감사나 보안 정책상 문제가 될 수 있다. 강연자도 이를 우회하거나 hack하는 대신, Slack으로 알림을 보내 사람이 approve button과 merge button을 누르는 운영 절차를 택했다고 설명한다. 그렇게 하면 low risk PR은 사실상 두 번의 클릭으로 production에 갈 수 있지만, 정책상 필요한 사람의 최종 책임은 유지된다.
이 접근은 AI를 “완전한 대체자”로 쓰는 것이 아니라, 사람의 주의를 더 잘 배분하는 시스템으로 쓰는 방식이다. 강연자의 표현을 빌리면, AI를 우리 대신 일하게 만들면서도 필요한 순간에는 AI가 우리를 일하게 만든다. 내부 자동화에서 중요한 것은 바로 이 경계 설정이다. AI가 충분히 잘하는 판단은 맡기되, 조직적 책임과 정책적 승인이 필요한 순간에는 사람에게 명확히 넘기는 것이다.
22:04 - Vercel Eve agent, GitHub, Slack을 연결해 PR review와 human approval workflow를 구성하는 방법을 요약하는 장면
실제 PR 사례로 본 동작 방식
강연자는 세 가지 PR 사례를 통해 bot이 어떻게 판단하는지 보여준다. 첫 번째는 Devin이 작성한 docs-only update였고, 일반적으로는 사람이 거의 곧바로 승인하고 merge할 만한 변경이었다. 하지만 bot은 이 PR을 low risk로 평가하면서도 merge conflict가 있다는 이유로 자동 승인하지 않았다. 이 사례는 위험도가 낮더라도 merge 가능 상태나 blocking condition을 별도로 확인해야 함을 보여준다.
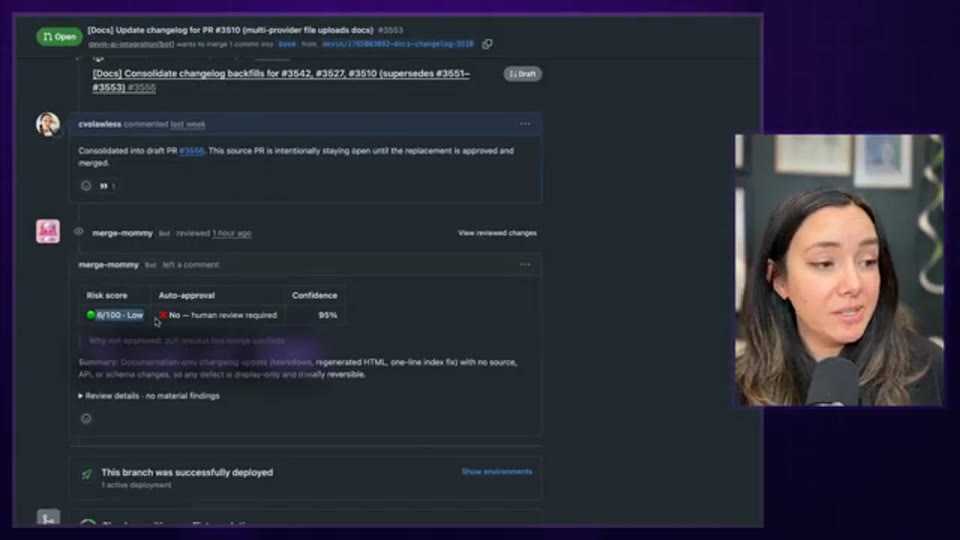
18:09 - docs-only PR이 low risk로 평가되었지만 merge conflict 때문에 자동 승인되지 않은 사례를 보여주는 장면
두 번째 사례는 이미 merge된 더 깔끔한 low risk PR이었다. bot은 이 PR에 대해 7 out of 100의 낮은 위험 점수를 부여했고, 자동 승인 신호를 남겼다. 이후 Slack channel에는 checks가 green이고 risk가 low이므로 사람이 승인하고 merge하면 된다는 알림이 전달된다. 이 흐름은 문서 수정이나 작은 안전한 변경이 리뷰 큐에 오래 묶이는 문제를 줄이는 데 특히 유용하다.
세 번째 사례는 chat V1에서 chat V2로 넘어가며 남아 있던 오래된 코드를 제거하는 deprecation PR이었다. 변경량이 크고 server API behavior에 영향을 줄 수 있으며, large change surface를 가진 것으로 평가되어 medium risk로 분류되었다. bot은 45 out of 100이라는 점수를 부여했고, 이 PR은 low risk가 아니므로 자동 승인되지 않았다. 여기서 중요한 점은 bot이 모든 PR을 빠르게 통과시키는 것이 아니라, 오히려 사람이 봐야 하는 PR을 분리해낸다는 것이다.
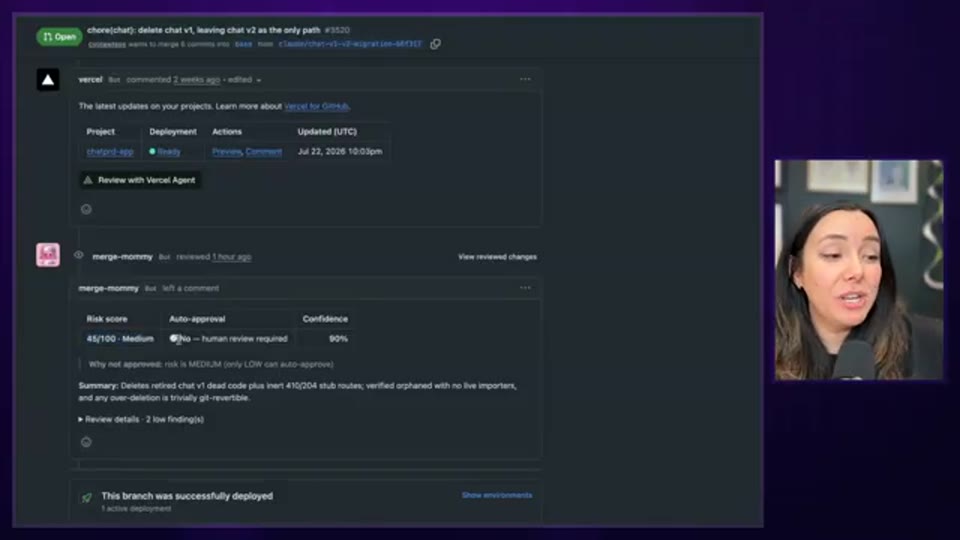
19:58 - deprecation PR이 medium risk로 분류되어 자동 승인되지 않은 사례를 보여주는 장면
내부 AI 에이전트에도 eval이 필요하다
영상 후반부에서 강연자는 직접 시연하지는 않았지만 중요한 보완 요소로 evals를 언급한다. Intercom과 같은 팀은 PR review agent의 판단 결과를 내부 eval platform에 기록하고, 엔지니어가 해당 판단이 맞았는지 확인하는 과정을 둔다고 설명한다. 이는 customer-facing AI product를 개선할 때 eval을 사용하는 것과 같은 논리다.
내부 도구라고 해서 eval이 덜 중요한 것은 아니다. 오히려 코드 리뷰, 승인, 배포처럼 시스템 안정성과 직접 연결되는 업무에서는 agent의 판단 품질을 지속적으로 측정해야 한다. 어떤 PR을 low risk로 잘못 분류했는지, 어떤 PR을 지나치게 보수적으로 medium 또는 high로 올렸는지, 판단 근거가 실제 코드 변화와 맞았는지를 기록해야 threshold와 rubric을 개선할 수 있다.
따라서 이 영상의 설계는 첫날부터 완벽한 자동 승인 시스템을 만들라는 메시지가 아니다. 처음에는 bot의 판단을 advisory signal로 사용하고, 로그와 사람의 피드백을 쌓으면서 점진적으로 자동화 범위를 넓히는 편이 더 합리적이다. 특히 인증, 결제, 데이터 마이그레이션, 권한, 개인정보 처리처럼 blast radius가 큰 영역은 별도 정책으로 항상 human review를 요구하는 것이 안전하다.
참고할 만한 기술적 확장 방향
강연 내용과 별개로, 이 유형의 PR review agent를 실제 조직에 적용한다면 몇 가지 확장 포인트를 고려할 만하다. 첫째, risk scoring rubric은 repository마다 달라야 한다. 프론트엔드 문구 변경과 database migration의 위험도가 같은 방식으로 계산될 수 없기 때문에, code owners, path pattern, service criticality, test coverage, deployment strategy를 함께 반영해야 한다.
둘째, CI 결과를 단순히 통과 여부로만 보지 않고 어떤 test suite이 실행되었는지까지 확인하는 것이 좋다. 예를 들어 unit test만 통과한 PR과 integration test, type check, lint, security scan까지 통과한 PR은 같은 green 상태라도 신뢰도가 다르다. 강연자가 말한 verification gap은 바로 이 부분을 확장할 수 있는 좋은 기준이다.
셋째, approval comment는 사람이 읽고 판단할 수 있을 만큼 구체적이어야 한다. “low risk”라는 결론만 남기는 bot은 운영상 가치가 제한적이다. 어떤 파일이 바뀌었고, 어떤 위험 축에서 낮은 점수를 받았으며, 어떤 이유로 blocking condition이 없다고 봤는지를 남겨야 나중에 감사와 디버깅이 가능하다. 이 점에서 PR review agent는 리뷰어라기보다 정책 실행기이자 evidence publisher에 가깝다.
마무리 / 핵심 정리
이 영상의 핵심 메시지는 AI 시대의 코드 리뷰 병목을 더 많은 사람의 수동 검토만으로 해결하기 어렵다는 데 있다. AI가 PR 생성량을 늘렸다면, PR triage와 risk scoring에도 AI를 투입해야 전체 개발 흐름이 균형을 찾을 수 있다. 다만 강연자는 무분별한 자동 merge를 주장하지 않고, low risk PR을 식별해 사람의 최종 승인 부담을 줄이는 현실적 운영 모델을 제안한다.
Vercel Eve는 이 모델을 구현하기 위한 실용적 선택지로 제시된다. GitHub, Slack, sandbox, instructions, skills, tools를 비교적 단순하게 연결할 수 있기 때문에, 작은 팀도 내부 PR review bot을 빠르게 실험할 수 있다. 가장 중요한 설계 원칙은 위험도 기준을 명확히 정의하고, 판단 근거를 남기며, medium 또는 high risk 변경은 반드시 사람에게 올리는 것이다.
결국 좋은 AI 코드 리뷰 에이전트는 사람을 배제하는 시스템이 아니라, 사람의 판단이 필요한 곳을 더 선명하게 드러내는 시스템이다. 문서 수정, 작은 UI 변경, 낮은 위험도의 반복 작업은 빠르게 흐르게 하고, 인증, 결제, 데이터, API behavior처럼 책임이 큰 변경은 더 확실히 사람에게 전달한다. 이 균형을 잡을 수 있다면, AI로 늘어난 PR 속도는 리뷰 품질을 희생하지 않고도 실제 배포 속도로 이어질 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Build an AI code review agent with Vercel Eve full tutorial |
| 채널 | How I AI |
| 영상 길이 | 약 24분 |
| 리포트 작성 | 2026-08-06 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.