Compression at the Edge — NVIDIA, Unsloth, HuggingFace, Ollama
📺 원본 영상: Compression at the Edge — NVIDIA, Unsloth, HuggingFace, Ollama
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-08-07
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 패널은 NVIDIA, Unsloth, Hugging Face, Ollama 관계자들이 모델 압축, 특히 양자화(Quantization)가 왜 엣지 AI와 로컬 LLM의 핵심 기술이 되었는지를 논의한 자리다. 참가자들은 압축을 단순히 모델 크기를 줄이는 기술로 보지 않고, 같은 비용으로 더 많은 지능을 제공하고, 개인 컴퓨터와 휴대폰에서도 고성능 모델을 실행하게 만드는 인프라적 전환으로 설명한다.
핵심 논점은 “작아진 모델이 왜 그만큼 멍청해지지 않는가”에 있다. 패널은 레이어별 민감도, Super Weights, FP4·NVFP4 같은 수치 형식, KV Cache 압축, Sparsity(희소성), 모델 라우팅 등 여러 기술을 통해 압축이 단순한 손실이 아니라 지능을 재배치하는 공학적 최적화에 가깝다고 설명한다.
압축은 모델을 줄이는 기술이 아니라 지능의 배치 전략이다
패널의 출발점은 각자가 정의하는 “압축”이었다. Ollama 측에서는 압축이 거대한 모델을 일반 사용자의 작은 머신에서도 실행 가능하게 만든 핵심 계기였다고 설명했다. 로컬 모델 실행이 대중화된 배경에는 단순한 UX 개선만 있었던 것이 아니라, 큰 모델을 상대적으로 작은 디스크와 메모리에 올릴 수 있게 해준 양자화가 있었다는 것이다.
Hugging Face 측 발언자는 압축을 “정보를 잃지 않고 무언가를 줄이는 것”으로 표현하면서도, 실제로는 공짜 점심이 없다고 선을 그었다. 품질 저하를 피하면 지연시간이 늘 수 있고, 크기를 더 공격적으로 줄이면 정확도나 모델의 행동 특성이 흔들릴 수 있다. 따라서 압축은 크기, 속도, 품질 사이의 균형을 조정하는 문제이며, 모델을 작게 만드는 순간에도 무엇을 보존할지 선택해야 한다.
NVIDIA 측에서는 압축을 “같은 비용으로 더 많은 지능을 얻는 것”이라고 정의했다. 과거에는 FP32로 학습하던 모델이 이제는 FP4 수준까지 논의되고 있으며, 이는 이론적으로 8배 수준의 압축 효과를 만들 수 있다. 중요한 점은 비트 수를 줄이는 것 자체가 아니라, 거의 같은 지능을 훨씬 낮은 비용으로 제공할 수 있느냐에 있다.
Unsloth 측에서는 GLM 계열의 대형 모델을 예로 들며, 1.5TB 규모의 모델을 약 250GB 수준으로 줄일 수 있다고 설명했다. 이때 모델 크기가 86% 줄었다고 해서 성능이 86% 줄어드는 것은 아니다. 강연자에 따르면, 중요한 레이어는 높은 정밀도로 남기고 덜 민감한 레이어는 1비트나 2비트까지 낮추는 방식으로 접근하면, 상당한 정확도를 회복하면서도 실질적인 크기 절감을 얻을 수 있다.
03:21 - GLM 계열 대형 모델을 1.5TB에서 약 250GB로 줄이는 동적 양자화 개념을 설명하는 구간
DeepSeek R1, QLoRA, Ollama가 만든 로컬 AI의 전환점
패널 참가자들이 말한 전환점은 각기 달랐지만, 공통적으로 “큰 모델을 내 장비에서 직접 돌릴 수 있다”는 경험이 압축 기술의 의미를 바꾸었다. Unsloth 측은 DeepSeek R1의 공개를 큰 계기로 언급했다. 이 모델은 강력한 추론 능력을 갖춘 오픈 모델이었지만, 크기가 너무 커서 로컬 실행이 쉽지 않았고, 바로 그 문제 때문에 양자화와 압축의 필요성이 더 선명해졌다는 설명이다.
Hugging Face 측에서는 QLoRA가 중요한 순간이었다고 말했다. QLoRA는 저비트 양자화와 LoRA(Low-Rank Adaptation)를 결합해, 제한된 VRAM 환경에서도 모델 파인튜닝을 가능하게 만든 접근이다. 강연자는 이를 Colab Free Tier의 T4 GPU 같은 제한적인 환경에서도 실험할 수 있게 된 사건으로 받아들였고, 이후 TRL, bitsandbytes 같은 라이브러리 생태계가 이러한 흐름을 확장했다고 설명했다.
Ollama 측 발언자는 소비자 관점에서 2023년 무렵 로컬에서 Llama 계열 모델을 실행해 본 경험을 언급했다. 당시에는 지금의 Qwen 3나 Gemma 계열 모델만큼 강력하지 않았지만, API 뒤에 있던 모델을 개인 컴퓨터에서 직접 실행한다는 경험 자체가 큰 변화였다. 이 경험은 로컬 AI를 단순한 장난감이 아니라 실제 작업을 수행할 수 있는 도구로 인식하게 만들었고, 양자화는 그 가능성을 대중화하는 기반이 되었다.
이 흐름에서 압축은 오픈 모델의 확산과 강하게 결합된다. 모델이 공개되어도 너무 크면 일반 사용자는 활용할 수 없고, 기업도 비용 때문에 광범위한 배포가 어렵다. 그러나 양자화와 압축이 모델을 개인 노트북, 워크스테이션, 나아가 휴대폰까지 가져오면, 오픈 모델의 실질적 접근성이 완전히 달라진다.
작아진 모델은 왜 그만큼 멍청해지지 않는가
패널에서 가장 기술적으로 중요한 질문은 모델을 86% 줄였을 때 왜 성능이 86% 나빠지지 않느냐는 것이었다. Unsloth 측은 무작위로 가중치를 삭제하거나 단순 반올림을 하면 모델이 86%가 아니라 거의 100% 망가질 수 있다고 설명했다. 따라서 핵심은 모델 전체를 균일하게 압축하는 것이 아니라, 언어 모델 아키텍처 내부의 민감도 차이를 이용하는 데 있다.
강연자에 따르면, 언어 모델은 수십 개의 레이어로 구성되며 각 레이어의 중요도는 동일하지 않다. 첫 번째 레이어와 마지막 레이어는 매우 민감한 반면, 중간 레이어 일부는 상대적으로 덜 중요할 수 있다. 또한 현재의 대규모 모델은 모든 가중치가 완전히 포화될 만큼 충분히 학습된 상태가 아닐 수 있으며, 일부 가중치는 0에 매우 가까워 제거하거나 낮은 정밀도로 표현해도 전체 성능에 큰 영향을 주지 않는다.
그러나 이 판단은 단순하지 않다. 레이어 하나씩 양자화해 정확도 변화를 보는 것만으로는 부족하고, 여러 레이어 조합을 함께 고려해야 하기 때문에 문제는 조합 최적화(Combinatorial Optimization)에 가까워진다. 여기에 특정 텐서 내부의 특정 값 하나가 모델 성능에 큰 영향을 주는 Super Weights 현상까지 더해지면, 압축은 단순한 변환 작업이 아니라 모델 내부 구조를 탐색하는 연구 문제가 된다.
NVFP4와 FP4가 보여주는 저비트 수치 형식의 진화
NVIDIA 측 패널은 FP4, 특히 NVFP4를 설명하면서 단순히 숫자를 4비트로 줄이는 것이 전부가 아니라고 강조했다. FP4는 4비트 부동소수점(Floating Point 4-bit) 형식이지만, NVFP4의 핵심은 마이크로 블록 스케일링(Micro Block Scaling)에 있다. 이는 일정한 개수의 요소가 하나의 스케일 값을 공유하게 만들어, 매우 낮은 비트 수에서도 표현력을 유지하는 방식이다.
강연자는 NVFP4에서 16개의 요소가 하나의 추가 FP8 스케일 값을 공유한다고 설명했다. 이 아이디어는 bitsandbytes와 Tim Dettmers의 연구 흐름과 연결되며, NVIDIA는 유사하지만 자체적인 설계를 통해 Blackwell 세대와 모델 최적화 파이프라인에 맞게 적용한 것으로 설명된다. 중요한 점은 4비트라는 작은 표현 공간을 그대로 쓰는 것이 아니라, 블록 단위 스케일링을 통해 값의 상대적 분포를 더 잘 보존한다는 데 있다.
17:08 - NVFP4의 마이크로 블록 스케일링과 16개 요소가 하나의 FP8 스케일 값을 공유하는 구조를 설명하는 구간
이러한 수치 형식은 단순히 메모리 절감만 만드는 것이 아니다. NVIDIA 측은 FP4가 가중치 압축뿐 아니라 4비트 GEMM 연산을 통한 수학 연산 가속과도 연결된다고 설명했다. 즉, 잘 설계된 숫자 형식은 저장 공간을 줄이고, 대역폭 부담을 낮추며, 연산 처리량까지 끌어올리는 복합적인 최적화 수단이 된다.
평가는 벤치마크만으로 끝나지 않는다
모델 압축의 성공 여부를 판단하는 방식에 대해 NVIDIA 측은 AI 벤치마크를 폭넓게 실행한다고 설명했다. Model Optimizer 팀은 Hugging Face Hub에 양자화된 체크포인트를 공개하며, FP4 기준으로 전체 AI 벤치마크에서 1% 미만의 정확도 저하를 목표로 한다고 언급했다. 이 기준은 압축 모델이 원본 BF16 모델에 비해 실질적으로 얼마나 성능을 유지하는지 확인하는 기본적인 잣대가 된다.
15:49 - NVIDIA Model Optimizer와 FP4 양자화 평가, 민감한 레이어 유형을 설명하는 구간
그러나 Ollama 측에서는 벤치마크만으로는 충분하지 않다고 덧붙였다. 벤치마크는 검증 가능한 문제에서는 강력하지만, 실제 사용자가 모델을 테스트 환경에 넣고 코딩 작업이나 에이전트 작업을 수행할 때 느끼는 모델의 행동 특성까지 완전히 포착하지 못한다. 그래서 Ollama는 기본 양자화 모델을 제공할 때 단순히 가장 작은 모델을 고르는 것이 아니라, 실제 실행 경험과 사용성을 함께 본다고 설명했다.
이 관점은 기업 환경에서도 중요하다. 기업은 대형 클러스터에서 모델을 서빙할 수도 있지만, 동시에 직원 개인의 노트북이나 사내 장비에서 모델을 실행해야 하는 요구도 있다. 압축은 서버 비용을 낮추는 동시에 동시성(Concurrency)을 높이고, 민감한 데이터를 외부 API로 보내지 않는 로컬 배포 전략을 가능하게 만든다.
작은 원본 모델과 큰 압축 모델 중 무엇이 나은가
패널은 “작은 모델을 원래 정밀도로 쓰는 것”과 “큰 모델을 강하게 압축해 쓰는 것” 사이의 선택도 다루었다. Unsloth 측은 관련 연구를 언급하며, 같은 디스크 크기라면 작은 BF16 모델보다 더 큰 모델을 4비트로 양자화한 쪽이 지능 측면에서 더 나을 가능성이 크다고 설명했다. 예를 들어 35B 모델을 16비트로 쓰는 것과 120B 모델을 4비트로 줄여 쓰는 경우, 저장 공간이 비슷하다면 후자가 더 강한 성능을 보일 수 있다는 주장이다.
이 논리는 앞으로 모델이 더 커질수록 중요해진다. 현재도 테라바이트 단위의 모델은 로컬 실행에 부담이 크지만, 앞으로 10조 파라미터급 모델이 등장한다면 기업 인프라에서도 그대로 서비스하기 어려울 수 있다. 따라서 압축은 선택적 최적화가 아니라, 더 큰 모델에서 가치를 추출하기 위한 필수 조건이 된다.
다만 작은 모델의 장점도 분명하다. 큰 모델을 압축하면 더 높은 지능을 얻을 수 있지만, 충분한 GPU 성능이 없다면 초당 5~10토큰 수준으로 느려질 수 있다. 반면 작은 모델은 초당 200토큰 수준의 속도를 낼 수 있기 때문에, 계획은 큰 모델이 맡고 실행은 작은 모델이 수행하는 모델 라우팅(Model Routing) 전략이 현실적인 대안으로 제시된다.
PTQ, QAT, Distillation이 나뉘는 지점
NVIDIA 측은 Post-Training Quantization(PTQ)이 대형 모델에서는 비교적 잘 작동한다고 설명했다. 이미 학습된 BF16 모델을 가져와 FP4 같은 형식으로 변환하는 방식이며, Blackwell 노드에서는 대형 GLM급 또는 조 단위 파라미터 모델도 몇 시간 안에 양자화 체크포인트를 만들 수 있다고 말했다. 그러나 실제 어려움은 양자화 자체보다 이후 평가와 모델 카드 수준의 검증에서 시작된다.
대형 및 중형 모델, 특히 20B~30B 이상의 Dense 모델에서는 PTQ가 선택적 양자화와 휴리스틱을 곁들이면 대체로 잘 작동한다고 설명된다. Sparse MoE(Mixture of Experts) 계층은 더 공격적으로 양자화할 수 있고, 자동 민감도 분석과 Knapsack Solver를 활용하는 Auto-Quantize 접근도 언급되었다. 이는 압축 가능한 부분과 보존해야 할 부분을 자동으로 고르는 최적화 문제로 볼 수 있다.
30:52 - PTQ, 선택적 양자화, Auto-Quantize, Knapsack Solver 기반 민감도 분석을 설명하는 구간
반대로 20B 미만의 작은 모델에서는 PTQ만으로 정확도를 회복하기 어려운 경우가 많다. 이때는 Quantization-Aware Training(QAT)이나 Quantization-Aware Distillation 같은 학습 기반 방법이 필요해진다. 하지만 reasoning 모델은 다단계 학습, RL, 여러 teacher 모델을 사용하는 distillation을 거치는 경우가 많기 때문에, 잘못된 데이터로 QAT를 수행하면 모델을 개선하기보다 오히려 망가뜨릴 수 있다고 패널은 경고했다.
모델 아키텍처의 다양화가 압축을 더 어렵게 만든다
Llama 시대의 오픈 모델들은 대체로 비슷한 Transformer 계열 구조를 공유했기 때문에, 압축 휴리스틱을 반복 적용하기가 상대적으로 쉬웠다. 그러나 최근 모델들은 Hybrid Attention, Linear Attention, Sliding Window Attention, Sparse MoE, MLA(Multi-head Latent Attention) 등 다양한 구조를 채택하며 점점 이질적으로 변하고 있다. 강연자는 이를 Transformer++에서 Transformer+++로 넘어가는 흐름에 비유하며, 각 모델 랩이 장문 컨텍스트나 효율성 개선을 위해 조금씩 다른 선택을 하고 있다고 설명했다.
이 변화는 양자화 난이도를 크게 높인다. 예전에는 특정 레이어 유형에 대한 경험적 규칙이 여러 모델에 통했지만, 이제는 모델마다 민감한 영역이 달라질 수 있다. Unsloth 측은 MoE 레이어는 1비트 수준까지 양자화해도 깨지지 않는 경우가 있지만, Linear Attention 계층은 양자화하면 겉보기 벤치마크는 괜찮아도 긴 컨텍스트 환경이나 실제 프로덕션 사용에서 출력이 무너질 수 있다고 말했다.
36:41 - Linear Attention 계층을 잘못 양자화했을 때 긴 컨텍스트에서 출력이 무너질 수 있음을 설명하는 구간
Ollama 측도 같은 문제를 UX 관점에서 설명했다. 모델 랩에서 사전 공개된 여러 변형 모델을 지원해야 하는 경우가 있고, 각 변형마다 구현과 양자화 품질을 확인해야 한다. 특히 작은 파라미터 모델은 너무 낮은 정밀도로 줄이면 사용 경험이 나빠질 수 있기 때문에, Ollama는 어떤 경우에는 더 높은 정밀도를 기본값으로 유지한다고 설명했다.
기업 관점에서 압축은 비용 절감 이상의 의미를 갖는다
기업에게 모델 압축은 단순히 GPU 비용을 줄이는 기술이 아니다. Hugging Face 측은 많은 기업이 중형 모델을 더 작은 모델로 distill해 re-ranking 같은 특정 작업에 활용하면서 수백만 달러 규모의 비용을 줄이는 사례가 있다고 언급했다. 이는 모든 작업에 거대한 LLM 출력을 사용할 필요가 없으며, 작업의 성격에 맞는 작은 모델을 배치하는 것이 더 효율적이라는 뜻이다.
압축은 또한 배포 위치를 바꾼다. 서버에서만 실행되던 모델이 개인 장비나 사내 엣지 장치에서 실행되면, 개인정보와 민감한 데이터가 외부로 나가지 않아도 된다. 패널은 privacy 요구가 커질수록 로컬 실행과 엣지 배포의 수요가 증가할 것이며, 압축 기술이 그 전환을 가능하게 하는 핵심 도구가 될 것이라고 전망했다.
이 관점에서는 압축이 “더 싼 모델”을 만드는 기술이 아니라 “더 많은 장소에서 지능을 실행하는 기술”이 된다. 서버 비용, 동시성, 응답 속도, 데이터 거버넌스, 사용자 제어권이 모두 연결되기 때문이다. 따라서 기업이 압축을 이해하지 못하면, 단순히 모델을 작게 만드는 수준을 넘어 AI 시스템 아키텍처의 선택지를 놓치게 된다.
다음 전장, KV Cache와 Sparsity 그리고 휴대폰 위의 지능
패널 후반부에서 NVIDIA 측은 앞으로의 압축이 가중치 압축을 넘어 더 넓은 영역으로 확장될 것이라고 전망했다. 현재 논의는 대부분 Weight Compression에 집중되어 있지만, 긴 컨텍스트와 장기 추론이 중요해질수록 KV Cache 압축이 더 중요해진다. 큰 모델에서는 4비트 KV Cache가 품질을 잘 유지하는 경우가 있지만, 작은 모델에서는 성능 저하가 관찰될 수 있어 아직 더 많은 연구가 필요하다고 설명했다.
Sparsity도 중요한 축으로 언급되었다. NVIDIA 하드웨어는 이미 희소성을 지원해 왔지만, 양자화에 비해 정확도 저하가 더 크기 때문에 널리 채택되지는 못했다. 다만 Rubin 세대에서 Dynamic Activation Sparsity 같은 기능이 attention 연산 개선에 기여할 수 있다고 언급되며, 향후 압축은 양자화 하나가 아니라 여러 기법이 결합되는 방향으로 나아갈 가능성이 제시되었다.
40:32 - KV Cache 압축, 4비트 캐시, Sparsity, Dynamic Activation Sparsity 등 미래 압축 방향을 설명하는 구간
Hugging Face 측은 지능이 휴대폰까지 내려갈 것이라고 전망했다. 과거에는 서버에서만 모델을 실행하는 것이 자연스러웠지만, privacy와 personal data 요구가 커지면서 로컬 장치에서 직접 실행되는 AI의 필요성이 커지고 있다. Llama.cpp 생태계와 저비트 양자화가 발전하면, 앞으로는 노트북뿐 아니라 휴대폰에서도 더 강력한 모델을 실행하는 흐름이 본격화될 수 있다.
벤치마크의 빈틈과 KLD 기반 비교
질의응답에서는 수많은 변형 모델과 양자화 모델 중 어떤 것이 실제로 좋은지 판단할 수 있는 종합 리소스가 있는지에 대한 질문이 나왔다. 패널은 아직 그런 비교가 충분히 포괄적으로 이루어지고 있지는 않다고 답했다. 일부 모델에 대해서는 Unsloth가 동적 양자화 결과와 벤치마크를 공개하지만, 전체 생태계를 대상으로 모든 quant와 변형 모델을 일관되게 비교하는 체계는 부족하다는 것이다.
Unsloth 측은 정확도 벤치마크가 생각보다 복잡하다고 설명했다. 샘플링 방식, trial 수, 평균 처리 방식에 따라 결과가 흔들릴 수 있기 때문이다. 그래서 대안적 지표로 KL Divergence(Kullback-Leibler Divergence)를 언급했는데, 이는 원본 BF16 모델과 양자화 모델의 출력 logits 분포가 얼마나 다른지를 측정하는 방식이다.
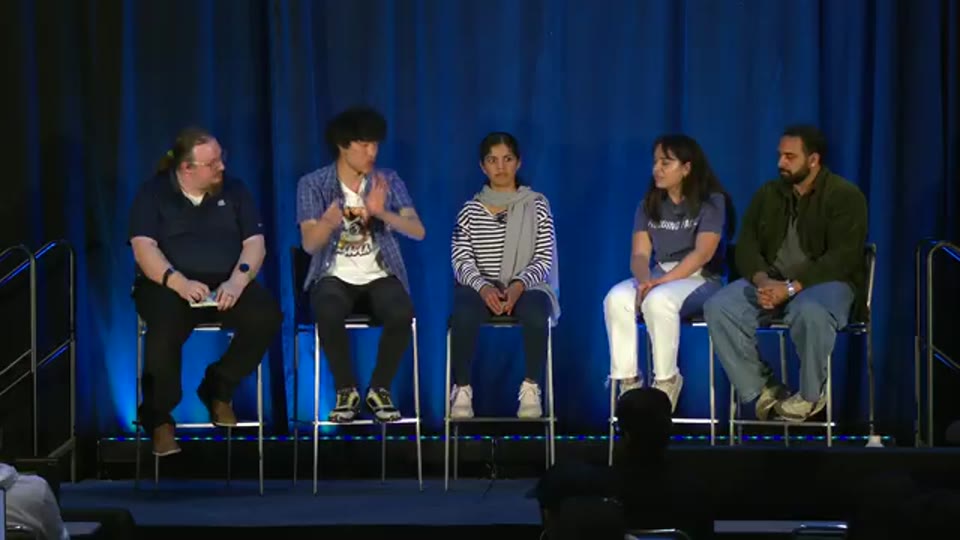
45:20 - BF16 원본 모델과 양자화 모델의 output logits를 비교하는 KL Divergence 평가 방식을 설명하는 구간
이 접근의 목표는 단순하다. 동일한 calibration data를 원본 모델과 양자화 모델에 넣고, 두 모델의 출력 logits 간 거리를 가능한 한 0에 가깝게 만들면서 모델 크기를 줄이는 것이다. 강연자는 이와 관련해 “Accuracy is Not All You Need”라는 논문을 참고할 수 있다고 언급했다.
참고할 만한 기술 키워드
이 강연을 더 깊게 이해하려면 몇 가지 주변 기술을 함께 살펴볼 필요가 있다. QLoRA는 저비트 양자화와 효율적 파인튜닝이 어떻게 결합되는지 보여주는 대표 사례이며, bitsandbytes는 이러한 실험을 실제 개발자가 다룰 수 있는 라이브러리 수준으로 끌어내린 중요한 도구다. llama.cpp는 로컬 실행 생태계의 핵심 축으로, CPU와 다양한 하드웨어 백엔드에서 양자화 모델을 실행하는 흐름을 대중화했다.
NVIDIA ModelOpt는 대형 모델을 FP4, FP8 등 다양한 수치 형식으로 최적화하고 배포하기 위한 도구 체계와 연결된다. 또한 KV Cache Quantization, Activation Sparsity, Quantization-Aware Training, Distillation은 앞으로 모델 압축을 단일 기법이 아니라 전체 추론 시스템 최적화 문제로 확장시키는 키워드다. 다만 이 섹션은 강연 내용을 이해하기 위한 별도 참고 맥락이며, 구체적인 구현 세부사항은 원본 영상의 발언 범위를 넘어선다.
마무리 / 핵심 정리
이 패널의 핵심 메시지는 압축이 모델을 “덜 똑똑하게 만드는 타협”이 아니라, 지능을 더 많은 장치와 더 낮은 비용의 환경으로 옮기는 기술이라는 점이다. 물론 압축에는 항상 trade-off가 있으며, 잘못된 레이어를 낮은 정밀도로 만들거나 잘못된 데이터로 QAT를 수행하면 모델은 쉽게 망가질 수 있다. 그러나 레이어별 민감도, 수치 형식 설계, 동적 양자화, KV Cache 압축, sparsity를 정교하게 조합하면 모델 크기와 비용을 크게 줄이면서도 실질적인 성능을 보존할 수 있다.
앞으로 모델은 더 커지고, 아키텍처는 더 다양해지며, 사용자는 더 많은 지능을 로컬 장치에서 원하게 될 것이다. 이 흐름에서 압축은 부가 기능이 아니라 오픈 모델 생태계의 실행 조건이 된다. 패널이 그리는 미래는 거대한 frontier model의 능력이 클라우드 API에만 갇히지 않고, 개인의 노트북과 휴대폰, 기업의 내부 장비 위에서 직접 실행되는 세계다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Compression at the Edge — NVIDIA, Unsloth, HuggingFace, Ollama |
| 채널 | AI Engineer |
| 영상 길이 | 45분 41초 |
| 리포트 작성 | 2026-08-07 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.