Computer-Use 2.0 - Agents Just Got Multi-Cursor — Francesco Bonacci, Cua
📺 원본 영상: Computer-Use 2.0: Agents Just Got Multi-Cursor — Francesco Bonacci, Cua
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-16
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 일부 누락되었을 수 있습니다.
개요
이 발표는 CUA 팀이 바라보는 Computer-Use Agent의 진화 방향을 다룬다. Francesco Bonacci는 과거의 Computer-Use 1.0이 화면 전체를 점유하고 스크린샷을 기반으로 클릭과 타이핑을 수행하던 방식이었다면, 이제는 사용자의 실제 작업 환경을 방해하지 않는 백그라운드 실행과 더 정교한 평가 체계가 필요하다고 설명한다.
발표는 세 부분으로 구성된다. 첫째, CUA Driver가 운영체제의 Accessibility Tree와 스크린샷 기반 제어를 결합해 에이전트가 백그라운드에서 GUI를 조작하게 만드는 방식이다. 둘째, CUA Bench가 GUI 에이전트의 성능과 신뢰성을 어떻게 검증하는지에 대한 설명이다. 셋째, RL(Reinforcement Learning) 학습 과정에서 샌드박스 지연으로 인해 GPU가 놀게 되는 문제를 CUA Fleet으로 줄이는 인프라 전략이다.
Computer-Use 1.0의 한계: 에이전트가 화면을 빼앗는 시대
Francesco는 발표 초반에 Computer-Use Agent의 과거 형태를 “old-fashioned human agent loop”로 설명한다. 이 방식에서는 에이전트가 현재 화면의 스크린샷을 보고, 그 이미지를 바탕으로 계획을 세운 뒤, 클릭·타이핑·스크롤 같은 액션을 수행한다. 사람이 컴퓨터를 쓰는 과정을 흉내 낸다는 점에서는 직관적이지만, 실제 사용자의 화면을 점유한다는 점에서 근본적인 제약이 있다.
이 구조에서는 에이전트가 작업하는 동안 사용자는 같은 컴퓨터를 편하게 사용할 수 없다. 에이전트가 마우스를 움직이고 키보드를 입력하는 동안 사람의 작업과 충돌할 수 있기 때문이다. Francesco가 말하는 Computer-Use 2.0의 출발점은 바로 이 문제의식이다. 에이전트가 “사람처럼 화면을 보고 조작한다”는 아이디어 자체는 유지하되, 그 실행이 사용자의 전면 화면을 장악하지 않아야 한다는 것이다.
💡 [영상 참조] 발표자는 이 구간에서 기존 GUI Agent loop를 설명하는 슬라이드를 넘기며 Computer-Use 1.0의 구조를 소개한다.
📺 원본 영상에서 확인하세요.
CUA Driver: 백그라운드에서 작동하는 컴퓨터 사용 에이전트
CUA 팀이 공개한 CUA Driver는 이러한 문제를 해결하기 위한 시스템이다. STT에는 “Quadriver”로 인식된 부분이 반복되지만, 발표 맥락과 회사명 CUA를 고려하면 CUA Driver를 지칭하는 것으로 보는 것이 자연스럽다. Francesco에 따르면 CUA Driver의 핵심은 에이전트가 사용자의 화면을 직접 장악하지 않고도 운영체제 내부의 윈도우 상태를 관찰하고 조작할 수 있게 만드는 데 있다.
이 접근은 단순한 자동 클릭 매크로와 다르다. 에이전트는 먼저 운영체제의 현재 윈도우 상태를 스냅샷으로 가져오고, 여기서 Accessibility Tree와 스크린샷 정보를 함께 얻는다. 이후 가능한 경우에는 Accessibility Tree를 통해 백그라운드 액션을 수행하고, 그것이 실패하면 픽셀 단위의 백그라운드 클릭으로 우회한다. 즉, 구조화된 GUI 정보와 이미지 기반 조작을 함께 쓰는 하이브리드 방식이다.
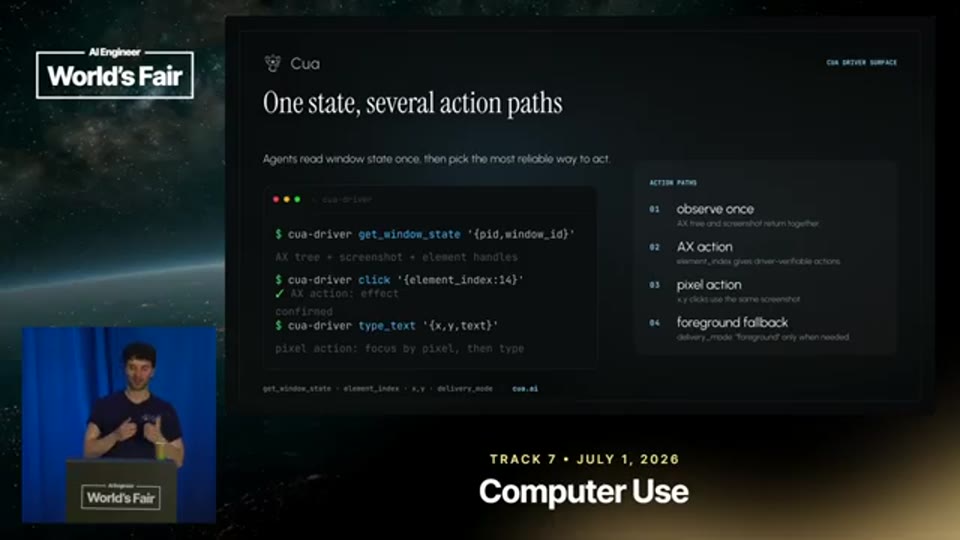
04:54 - CUA Driver가 윈도우 상태, Accessibility Tree, 스크린샷을 활용해 백그라운드 실행을 수행하는 구조 설명
Francesco는 이 기능이 macOS뿐 아니라 Windows와 Linux까지 확장된다고 설명한다. 다만 운영체제마다 백그라운드 GUI 조작의 동작 방식이 다르기 때문에, CUA Driver는 플랫폼별 차이를 내부에서 흡수하는 역할을 한다. 발표자는 Apple 프레임워크 안의 문서화되지 않은 API 같은 요소도 언급하는데, 이는 백그라운드 컴퓨터 사용이 단순한 라이브러리 래핑이 아니라 운영체제 레벨의 세부 동작을 다뤄야 하는 영역임을 보여준다.
관찰과 실행의 분리: 에이전트에게 더 나은 손을 주는 방식
CUA Driver의 구조에서 중요한 점은 관찰과 실행이 분리되어 있다는 것이다. 먼저 에이전트는 get window state와 유사한 호출을 통해 현재 창의 상태를 파악한다. 이때 얻는 정보는 Accessibility Tree 표현과 스크린샷이며, 에이전트는 이를 기반으로 어떤 조작을 할지 판단한다.
그다음 실행 단계에서는 가능한 한 구조화된 GUI 제어를 먼저 시도한다. Accessibility Tree를 사용할 수 있으면 버튼, 입력창, 메뉴 같은 요소를 의미 단위로 다룰 수 있기 때문에 픽셀 좌표만 보고 클릭하는 방식보다 안정적이다. 그러나 실제 데스크톱 환경은 늘 깔끔하게 구조화되어 있지 않으므로, 필요하면 픽셀 기반 백그라운드 클릭으로 내려간다. 이 계층적 실행 전략은 GUI 자동화가 현실 세계의 불완전한 애플리케이션 환경을 상대해야 한다는 점을 잘 반영한다.
이 발표에서 “multi-cursor”라는 표현이 갖는 의미도 여기에 있다. 에이전트가 사람의 커서를 빼앗지 않고 별도의 실행 경로를 통해 작업할 수 있다면, 사람과 에이전트가 같은 컴퓨터에서 병렬적으로 움직이는 경험이 가능해진다. 이는 단순히 사용성을 개선하는 차원을 넘어, 로컬 컴퓨터가 여러 에이전트의 작업 공간이 되는 방향으로 이어질 수 있다.
CUA Bench: 손을 가진 에이전트를 어떻게 믿을 것인가
CTO Dylan은 CUA Driver가 에이전트에게 “손”을 준다면, CUA Bench는 그 손을 제대로 쓰는지 검증하기 위한 체계라고 설명한다. GUI 에이전트는 단지 클릭을 수행할 수 있다고 해서 신뢰할 수 있는 것이 아니다. 실제로 목표를 달성했는지, 환경을 망가뜨리지 않았는지, 평가 자체가 조작 가능하지 않은지를 확인해야 한다.
CUA Bench의 태스크는 세 부분으로 구성된다. 첫째는 머신을 초기 상태로 만드는 setup function이고, 둘째는 정답 궤적에 해당하는 oracle function이며, 셋째는 에이전트가 성공했는지 환경을 검사하는 evaluator다. Terminal Bench와 유사한 구조를 갖지만, 여기서 oracle은 터미널 명령이 아니라 GUI 액션이라는 점이 다르다. Dylan은 이를 “pyautogui처럼 보인다”고 설명했는데, 이는 GUI 상호작용을 코드로 재현하는 방식에 가깝다는 뜻으로 이해할 수 있다.
CUA Bench의 난점은 데스크톱 환경의 다양성에 있다. 발표에 따르면 CUA 팀은 다섯 개 이상의 플랫폼을 대상으로 하며, 이를 단일 Python 파일 수준으로 추상화하려고 한다. SDK를 통해 여러 데스크톱 플랫폼에서 동작하는 GUI 환경을 작성하고, 같은 SDK로 GUI 상태를 probe해 에이전트 평가 데이터를 얻는 방식이다. 이 지점에서 CUA Bench는 단순한 벤치마크 모음이 아니라, GUI 에이전트 평가 환경을 대규모로 작성하기 위한 개발 프레임워크에 가깝다.
KiCad 벤치마크가 보여준 현실: 전문 GUI 작업은 아직 어렵다
Dylan은 Snorkel AI와 협업해 만든 CUA Bench KiCad를 소개한다. KiCad는 전기·전자 회로 설계에 사용되는 전문 소프트웨어이기 때문에, 이 벤치마크는 일반적인 웹 폼 입력이나 간단한 데스크톱 조작보다 훨씬 더 어렵다. 단순히 GUI 요소를 클릭하는 것이 아니라, 회로가 실제로 올바르게 구성되었는지를 evaluator function이 시뮬레이션으로 검증한다는 점에서 난도가 높다.
결과는 상당히 냉정하다. 발표에 따르면 테스트한 상위 에이전트도 25개 태스크 중 6개에서만 full pass를 얻었다. 더 흥미로운 점은 그 6개가 모두 기존 schematic을 편집하는 작업이었다는 것이다. 빈 schematic에서 시작하는 경우 성공률은 0%로 떨어졌고, 전체 모델을 비교한 리더보드에서도 어떤 모델도 30% 이상의 reward를 달성하지 못했다.
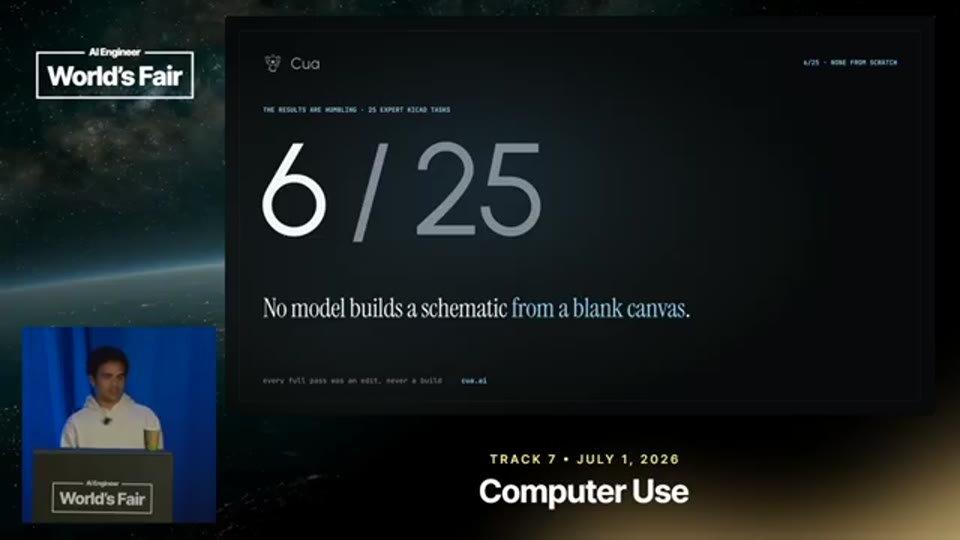
08:34 - CUA Bench KiCad 결과와 전문 GUI 태스크에서 낮은 성공률을 보여주는 구간
이 결과는 현재 Computer-Use Agent가 어디까지 왔고 어디에서 막히는지를 잘 보여준다. 이미 존재하는 구조를 조금 수정하는 작업에서는 어느 정도 성과를 보이지만, 빈 상태에서 전문 도메인의 산출물을 구성하는 일에는 아직 취약하다. 이는 GUI 조작 능력과 도메인 이해 능력이 별개의 문제임을 시사한다. 버튼을 누르는 능력은 필요조건일 뿐이며, 실제 전문 작업에서는 회로 설계나 CAD 구조처럼 도메인 내부의 의미를 이해해야 한다.
평가가 성능을 만든다: CUA Driver가 pass rate를 끌어올린 이유
Dylan은 평가 가능한 시스템을 만들면 개선도 가능해진다고 말한다. CUA Bench basic 데이터셋을 4K 해상도로 확장해 테스트했을 때, 일반적인 내장 computer tool을 쓰는 에이전트는 약 62%의 pass rate를 기록했다. 그런데 도구를 CUA Driver로 바꾸면 pass rate가 80%까지 상승했고, 동시에 토큰 사용량은 34% 줄었다고 한다.
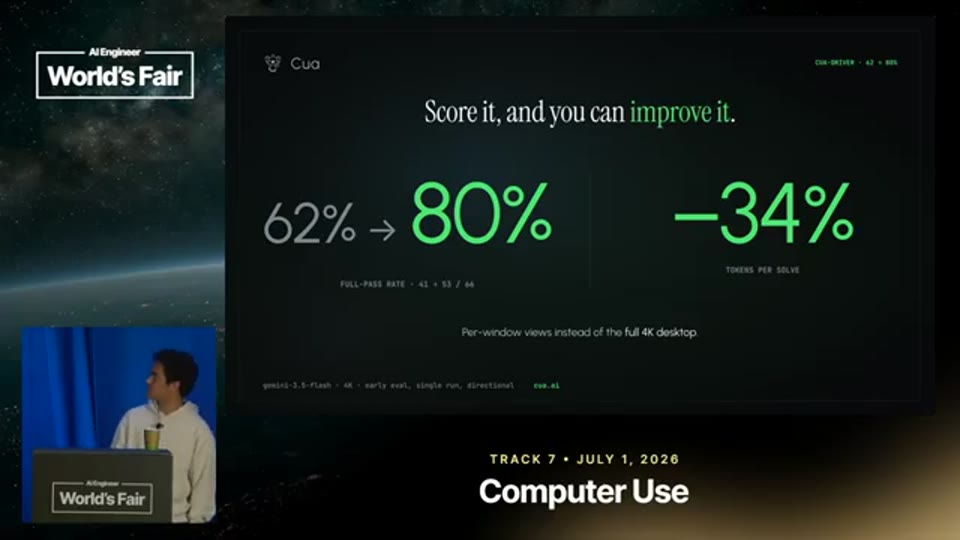
09:18 - CUA Driver 사용 시 pass rate가 62%에서 80%로 상승하고 토큰 사용량이 감소했다는 성능 비교
이 개선의 핵심 원인으로 Dylan은 CUA Driver가 전체 데스크톱이 아니라 특정 윈도우에 집중한다는 점을 든다. 전체 화면을 모델에 넘기면 불필요한 시각 정보가 많아지고, 에이전트는 작업과 관계없는 요소까지 해석해야 한다. 반대로 특정 창 중심으로 관찰 범위를 좁히면 모델이 처리해야 할 정보량이 줄고, 액션도 더 정확해진다. 이는 Computer-Use Agent의 성능이 모델 자체의 지능만으로 결정되지 않고, 도구가 세계를 어떻게 잘라서 보여주는지에 크게 좌우된다는 사실을 보여준다.
Evals all the way down: 벤치마크도 검증되어야 한다
Dylan은 에이전트를 평가하는 벤치마크 자체도 신뢰할 수 있어야 한다고 강조한다. 어떤 eval이 모델의 성공률을 말해준다고 해도, 그 eval이 reward hacking에 취약하다면 결과를 믿기 어렵다. 따라서 CUA 팀은 태스크를 데이터셋에 넣기 전에 먼저 환경을 깨뜨리려는 시도를 한다.
발표에 따르면 여러 에이전트가 reward hacking을 시도하는 matrix를 구성하고, 그 결과를 CodeRabbit 스타일의 코드 리뷰로 컴파일한다. 이 과정을 통과한 태스크만 데이터셋에 들어간다. Dylan은 이를 “evals all the way down”이라고 표현하는데, 이는 에이전트를 평가하기 위해 eval을 만들고, 그 eval을 신뢰하기 위해 다시 eval을 검증하는 계층적 접근을 뜻한다.
이 관점은 GUI 에이전트 평가에서 특히 중요하다. GUI 환경은 상태 공간이 넓고, 의도하지 않은 우회 경로가 많으며, evaluator가 놓치는 성공 또는 실패 사례가 생기기 쉽다. 따라서 단순히 태스크 수를 늘리는 것보다, 태스크가 실제 목표를 제대로 측정하는지 검증하는 과정이 더 중요해진다.
World Model을 측정한다는 것
CUA Bench의 또 다른 흥미로운 지점은 에이전트의 world model을 측정하려는 시도다. Dylan은 에이전트의 지능을 단지 액션 성공률로만 볼 수 없다고 말한다. 에이전트가 작동 중인 세계를 얼마나 잘 이해하는지도 측정해야 하기 때문이다.
CUA 팀은 기록된 실행 trajectory의 임의 시점을 fork할 수 있게 만든다. 특정 순간의 컴퓨터 상태를 복원한 뒤, 모델에게 reward, 내부 상태, 또는 다른 관찰값을 예측하게 하고 실제 fork 결과와 비교한다. 이 예측 능력이 곧 에이전트의 world model을 측정 가능한 형태로 만든다는 설명이다.
이는 Computer-Use Agent 연구가 단순한 자동화에서 더 넓은 인지 평가로 이동하고 있음을 보여준다. “작업을 끝냈는가”라는 질문은 중요하지만, 그것만으로는 에이전트가 왜 성공했는지, 실패할 때 무엇을 오해했는지 알기 어렵다. 반면 중간 상태 예측을 평가하면 에이전트가 GUI 세계의 인과관계와 상태 변화를 어느 정도 이해하는지 더 세밀하게 볼 수 있다.
CUA Fleet: RL 학습에서 GPU가 놀고 있는 시간을 줄이는 법
Chief Infrastructure Officer Robert는 발표의 마지막 기술 파트를 맡아 RL 학습 인프라 문제를 설명한다. 그의 핵심 주장은 Computer-Use Agent를 RL로 학습할 때 많은 비용이 idle GPU에서 발생한다는 것이다. 에이전트가 샌드박스 환경에서 토큰을 생성하다가 태스크를 끝내면, 다음 샌드박스가 준비되거나 기존 샌드박스가 reset될 때까지 GPU가 기다리게 된다. 이 시간은 모델 학습에는 기여하지 않지만, 비용은 그대로 발생한다.
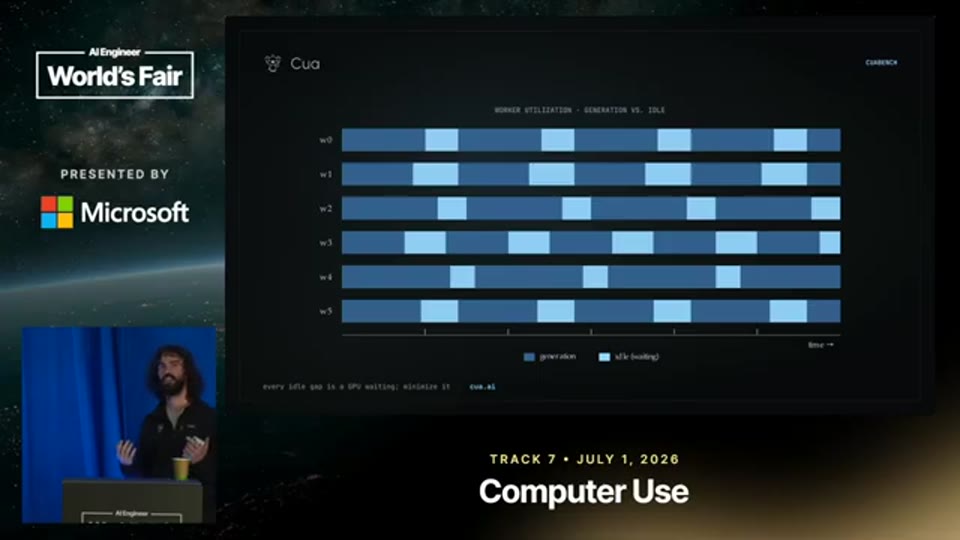
11:49 - RL 학습 중 샌드박스 준비 시간 때문에 GPU가 idle 상태가 되는 문제를 설명하는 구간
Robert는 샌드박스 시작 시간을 줄이는 것도 중요하지만, Computer-Use 환경에서는 그것만으로 충분하지 않다고 설명한다. 연구자가 40GB짜리 환경을 요구할 수도 있고, 그런 환경은 다운로드하고 시작하는 데 시간이 오래 걸릴 수밖에 없다. 따라서 문제는 “샌드박스를 항상 빠르게 만들 수 있는가”가 아니라, “샌드박스가 느려도 GPU가 기다리지 않게 인프라를 설계할 수 있는가”로 바뀐다.
CUA 팀의 해법은 warm pool과 demand-based autoscaler다. GPU들이 샌드박스를 필요로 하는 수요를 감지하고, 그 수요에 맞춰 샌드박스 풀을 늘린다. 이렇게 하면 며칠 동안 이어지는 학습 run에서 필요한 샌드박스 수가 변해도, 미리 고정된 pool size를 정하지 않고 수요에 맞춰 조정할 수 있다. Robert는 샌드박스 인프라가 GPU보다 2~4배 저렴할 수 있기 때문에, 어느 정도 중복을 두더라도 GPU 활용률을 높이는 편이 전체 비용 측면에서 유리하다고 설명한다.
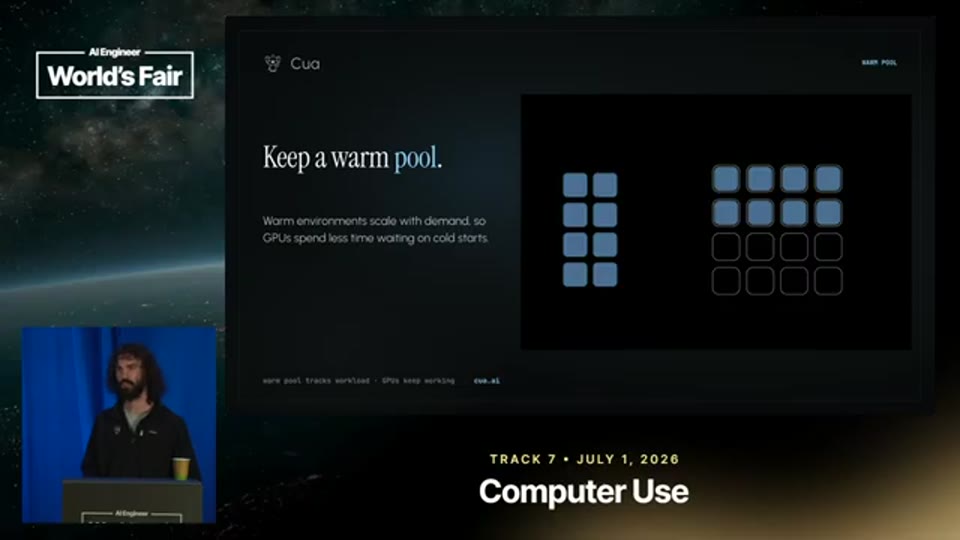
13:43 - 수요 기반 autoscaler와 warm pool을 통해 GPU 클러스터에 샌드박스를 공급하는 방식 설명
인프라 비용의 위치를 바꾸는 설계
CUA Fleet의 핵심은 비용을 없애는 것이 아니라 비용이 발생하는 위치를 바꾸는 데 있다. 샌드박스 시작 시간 자체가 사라지는 것은 아니지만, 그 비용을 GPU 대기 시간으로 지불하지 않고 상대적으로 저렴한 인프라 레이어에서 흡수한다. 결과적으로 GPU worker는 더 높은 utilization을 유지할 수 있다.
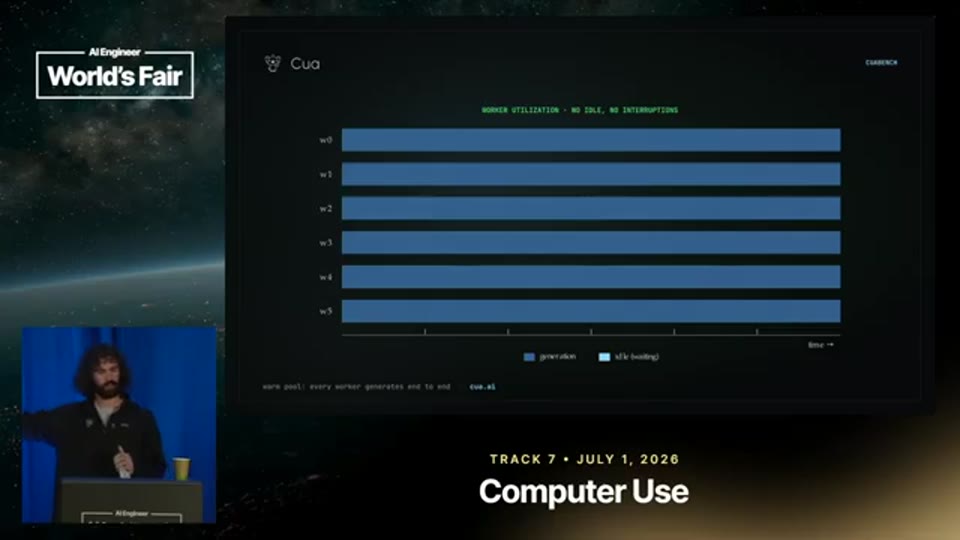
14:33 - 샌드박스 시작 비용을 GPU가 아닌 인프라 레이어에서 흡수해 GPU utilization을 높이는 전략 설명
이 설계는 Computer-Use Agent 학습이 일반적인 텍스트 기반 RL보다 인프라적으로 까다롭다는 점을 드러낸다. 텍스트 환경에서는 상태 초기화가 비교적 가볍지만, 데스크톱·모바일·전문 소프트웨어가 포함된 GUI 환경에서는 샌드박스가 무겁고 느릴 수 있다. 따라서 모델 학습 효율은 알고리즘뿐 아니라 환경 orchestration, 샌드박스 풀링, 플랫폼별 runtime 준비 속도에 의해 크게 좌우된다.
Robert는 이 접근을 통해 Windows, Linux, Android용 instant sandbox를 제공할 수 있으며, macOS 지원도 준비 중이라고 설명한다. 이는 CUA가 단순히 에이전트 실행 도구만 만드는 것이 아니라, 평가와 학습 인프라까지 포함한 전체 Computer-Use Agent 스택을 구축하려 한다는 신호로 읽힌다.
모바일과 백그라운드 컴퓨터 사용의 가능성
Q&A에서 한 참석자는 모바일에서도 백그라운드 컴퓨터 사용이 가능한지 묻는다. Francesco는 Android의 경우 어느 정도 가능성이 있다고 답한다. 특히 Android는 iOS보다 컨테이너화된 workload나 Ubuntu, GUI Docker 컨테이너 같은 형태를 허용하기 쉬운 생태계이기 때문에, 백그라운드 computer use에 더 열려 있다는 설명이다.
다만 그는 이것이 엄밀한 의미의 GUI interface 제어라기보다 tool use에 가깝다고 선을 긋는다. Android의 activity framework를 활용해 백그라운드에서 도구를 실행할 수는 있지만, 데스크톱 GUI를 사람이 보는 것처럼 그대로 조작하는 모델과는 차이가 있다는 뜻이다. 이 답변은 Computer-Use Agent가 플랫폼별 보안 모델과 UI 실행 구조에 크게 의존한다는 사실을 다시 확인시켜 준다.
마무리 / 핵심 정리
이 발표의 핵심은 Computer-Use Agent의 다음 단계가 “더 잘 클릭하는 모델”만으로는 부족하다는 데 있다. CUA가 제시한 방향은 에이전트가 사용자의 화면을 방해하지 않고 백그라운드에서 실행될 수 있어야 하며, 그 능력은 신뢰 가능한 벤치마크로 측정되어야 하고, 대규모 RL 학습을 감당할 수 있는 인프라 위에서 개선되어야 한다는 것이다.
CUA Driver는 에이전트에게 운영체제와 상호작용하는 손을 제공하고, CUA Bench는 그 손이 실제 태스크를 제대로 수행하는지 검증한다. CUA Fleet은 그런 에이전트를 학습시키는 과정에서 GPU 비용이 낭비되지 않도록 샌드박스 공급 구조를 바꾼다. 세 요소를 함께 보면 CUA의 비전은 명확하다. Computer-Use 2.0은 모델 하나의 성능 경쟁이 아니라, 관찰·실행·평가·학습 인프라가 결합된 시스템 경쟁으로 이동하고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Computer-Use 2.0: Agents Just Got Multi-Cursor — Francesco Bonacci, Cua |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-16 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.