Dynamic Asynchronous Tasking with Dependencies
📺 원본 영상: Dynamic Asynchronous Tasking with Dependencies - Tsung-Wei (TW) Huang - CppCon 2025 🎙️ 채널: CppCon 📅 정리 일자: 2026-04-02 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(코드, 슬라이드, 성능 그래프 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 University of Wisconsin-Madison의 Tsung-Wei (TW) Huang 교수가 CppCon 2025에서 발표한 것으로, 비정형(Irregular) 병렬 워크로드를 효율적으로 처리하기 위한 새로운 동적 태스크 그래프 프로그래밍(Dynamic Task Graph Programming, DTGP) 모델인 AsyncTask를 소개한다. 기존 C++ 비동기 태스킹 라이브러리들이 공통으로 가진 네 가지 구조적 한계를 진단하고, 이를 극복하기 위해 고안된 lock-free 스케줄러의 설계 원리와 실제 성능을 상세히 다룬다. 강연은 마이크로벤치마크와 VLSI 정적 타이밍 분석(Static Timing Analysis)이라는 실제 산업 응용을 통해 AsyncTask의 우수성을 검증하며, 해당 기능이 오픈소스 Taskflow 프로젝트에 통합되어 있음을 밝힌다.
왜 병렬 프로그래밍인가 — 하드웨어가 먼저 달려나갔다
현대 컴퓨터 하드웨어는 태생적으로 병렬 실행을 전제로 설계되어 있다. 강연자는 2013년 출시된 Intel Haswell 마이크로아키텍처를 예로 들며 이 점을 구체적으로 설명했다. 해당 CPU는 기본 4코어 구성에 온칩 통합 GPU를 탑재하고 있으며, 수퍼스칼라(Superscalar) 아키텍처를 기반으로 단일 사이클에 여러 개의 독립 명령을 발행하고 완료할 수 있다. 또한 하이퍼스레딩(Hyperthreading) 기술을 통해 단일 물리 코어가 운영체제에 두 개의 논리 프로세서로 인식된다.
이러한 하드웨어 진보는 단순한 기능 나열이 아니다. 강연자의 핵심 메시지는 간결하다. “병렬 프로그래밍을 하지 않는다면 하드웨어를 효율적으로 활용하지 못하는 것이다.” CPU 40개로 머신러닝 모델을 학습시키면 10배의 속도 향상을, GPU 1개를 추가하면 다시 10배 향상을 얻을 수 있다는 실례는, 병렬화가 선택이 아닌 필수임을 직관적으로 보여준다.
문제의 복잡성 — 현실의 병렬 워크로드는 비정형이다
그러나 병렬화가 쉬운 문제라면 이미 모두가 해결했을 것이다. 강연자가 강조하는 것은 “오늘날의 병렬 컴퓨팅 문제는 매우 복잡하고 비정형(Irregular)하다”는 점이다. 이를 설명하기 위해 두 가지 실제 사례가 제시되었다.
첫 번째는 GPU 가속 회로 시뮬레이션이다. NVIDIA 딥러닝 가속기 설계—5억 개 이상의 게이트와 넷을 포함—를 시뮬레이션하는 워크로드를 태스크 그래프로 표현하면, 1,000개 이상의 비동기 커널 태스크와 1,000개 이상의 태스크 의존성이 생성된다. GPU를 사용하더라도 수 시간이 소요될 정도로 방대한 규모다.
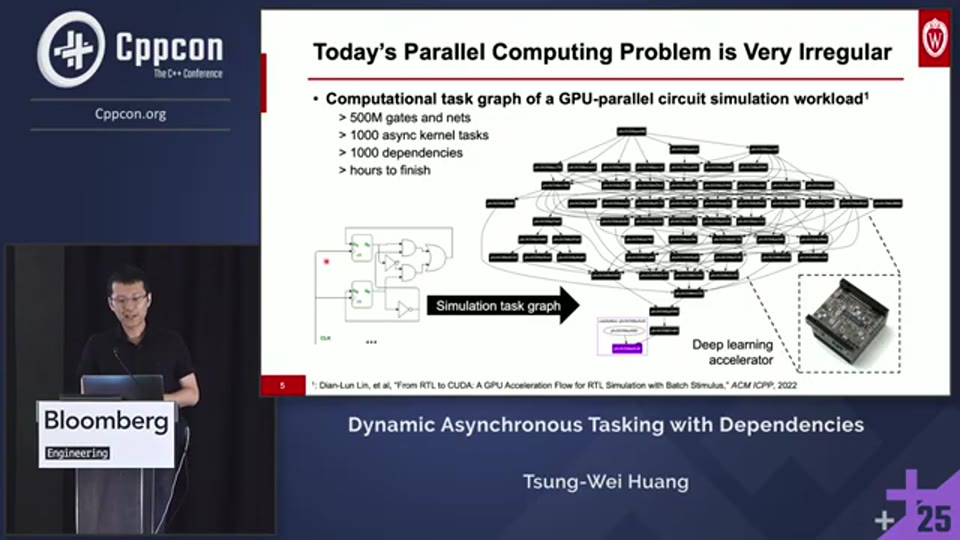
02:17 - GPU 가속 회로 시뮬레이션 워크로드의 비정형 계산 태스크 그래프 시각화
두 번째는 VLSI(Very Large Scale Integration) 회로 타이밍 분석 알고리즘의 병렬화다. 대형 설계의 경우, 타이밍 값을 회로 입력에서 출력까지 전파하는 알고리즘을 태스크 그래프로 모델링하면 1억 개 이상의 비동기 태스크와 1억 5천만 개 이상의 의존성이 발생한다. 이 숫자는 가상의 예시가 아니라 강연자 연구팀이 실제로 다루는 규모다.
이러한 비정형 문제를 병렬화하는 것이 어려운 이유는 병렬성과 추상화, 동시성 제어(Concurrency Control), 스케줄링 효율성 등의 기술적 세부사항을 모두 직접 처리해야 하기 때문이다. 강연자는 “우리가 원하는 것(단순하고 유지보수 가능하며 이식성 높은 구현)과 그 비용(성능 저하) 사이에는 항상 트레이드오프가 존재한다”고 지적하며, 이 모든 기술적 세부사항을 대신 관리해 줄 상위 레벨 솔루션이 필요함을 역설했다.
태스크 병렬 프로그래밍의 부상과 기존 모델들
이러한 배경에서 태스크 병렬 프로그래밍(Task Parallel Programming, TPP)이 비정형 워크로드에 대한 유력한 솔루션으로 주목받고 있다. TPP는 개발자가 알고리즘을 하향식(Top-down) 태스크 그래프로 분해하는 의도를 명확히 표현할 수 있게 해주는 동시에, 부하 분산(Load Balancing)이나 동시성 제어 같은 어려운 스케줄링 세부사항은 최적화된 런타임에 위임할 수 있다. 최근 수 년간 OpenMP의 Task Dependency Clauses, C++26 Execution Control Library, Intel TBB FlowGraph 등 다양한 라이브러리가 등장하며 이 흐름을 반영하고 있다.
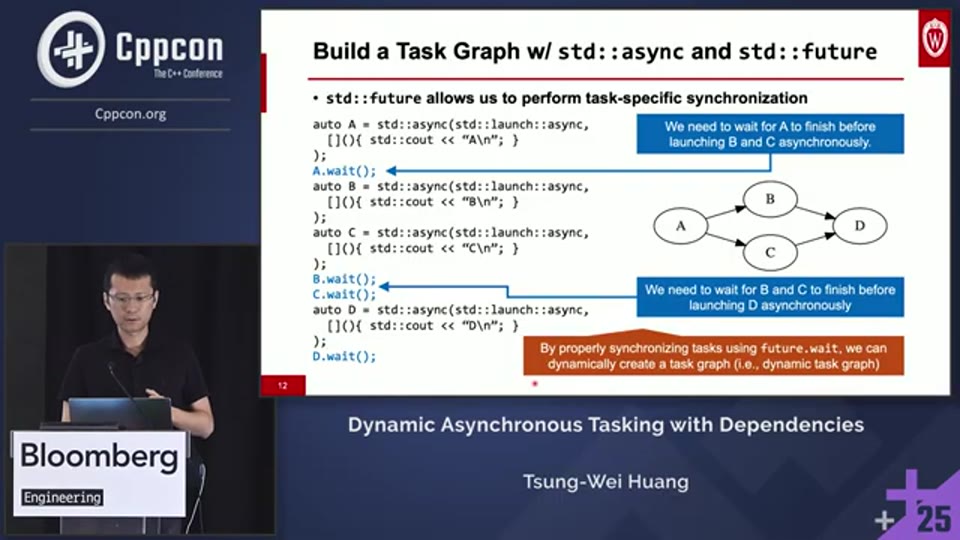
강연자는 동일한 태스크 그래프—A가 B와 C보다 먼저 실행되어야 하고, D는 B와 C가 모두 끝난 후에 실행되는 4-노드 DAG(Directed Acyclic Graph)—를 다섯 가지 주요 라이브러리로 구현하는 예시를 보여주었다.
std::async + std::future: C++ 표준 라이브러리 기반의 고수준 비동기 태스크 실행 인터페이스다. 내부적으로는 함수 타입과 인자 타입에 대한 두 개의 템플릿 매개변수, 타입 트레이트(Type Trait)를 통한 반환 타입 추론, promise-future 쌍을 통한 스레드 간 동기화, 람다 캡처와 완벽한 전달(Perfect Forwarding), 그리고 스레드 detach를 통한 fire-and-forget 동작으로 구성된다. future.wait() 혹은 future.get()을 적절한 위치에 삽입함으로써 동적으로 태스크 그래프를 구성할 수 있다.
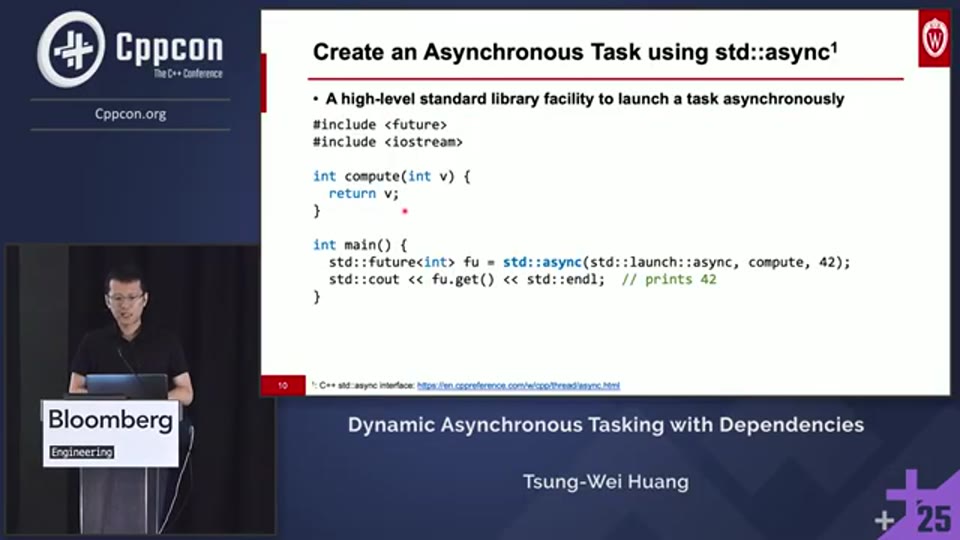
05:28 - std::async를 사용한 비동기 태스크 생성 코드 예시 및 내부 구현
C++26 Sender/Receiver 모델: std::execution을 통한 표준화된 태스크 의존성 합성 추상화로, 정적 스레드 풀 위에서 sender 태스크를 생성하고 sync_wait, when_all 등의 함수를 조합하여 의존성을 표현한다. 강연자의 예시에서는 A를 sync_wait로 동기화한 뒤 B와 C에 대한 sender 태스크를 생성하고, when_all로 양쪽 완료를 기다린 후 D를 생성하는 구조를 보여주었다.
08:10 - C++26 Sender/Receiver 모델로 구현한 동일 태스크 그래프 코드 비교
Intel TBB Task Group: task_group 클래스의 run 메서드로 비동기 태스크를 생성하고 wait 메서드로 완료를 기다리는 방식이다. 구성 방식은 std::async와 유사하게 명시적인 wait 호출로 의존성을 표현한다.
OpenMP Task Dependency Clauses: 컴파일러 디렉티브(#pragma omp task)를 사용하여 태스크와 의존성을 선언적으로 표현하며, 컴파일러가 병렬 코드를 자동으로 생성한다. 정수형 의존성 핸들 변수(a_b, a_c, b_d, c_d 등)를 선언하고 depend(in:...), depend(out:...) 절을 통해 태스크 간 의존 관계를 명시한다.
OpenCilk: Fork-join 기반 프로그래밍 모델로, cilk_spawn과 cilk_sync 같은 언어 확장을 통해 자식 스레드 생성과 동기화를 표현한다. OpenMP와 마찬가지로 해당 문법을 지원하는 전용 컴파일러가 필요하다.
💡 [영상 참조] 강연자는 각 라이브러리의 구현 코드를 별도 슬라이드로 보여주며 비교합니다. 📺 상세 코드는 원본 영상에서 확인하세요.
기존 모델의 네 가지 구조적 한계
다양한 라이브러리를 살펴본 후 강연자는 기존 비동기 태스킹 모델들이 공통으로 가진 네 가지 구조적 한계를 짚었다. 이 네 가지 한계야말로 AsyncTask 개발의 직접적인 동기다.
**첫 번째 한계는 태스크와 의존성의 분리(Decoupling)**다. 앞서 살펴본 모델들을 주의 깊게 보면, 태스크 생성 로직과 의존성 표현이 서로 분리된 형태로 작성된다. 이 분리는 두 가지 문제를 낳는다. 프로그래머가 태스크 그래프 구조를 머릿속으로 추적하기 어려워지고, 더 중요하게는 런타임 시스템이 태스크 배치와 부하 분산을 최적화할 기회를 잃는다. 런타임은 현재 생성 중인 태스크의 후속 태스크나 선행 태스크가 무엇인지 알지 못하기 때문이다.
두 번째 한계는 동기화 위치가 전적으로 프로그래머 책임이라는 점이다. future.wait()이나 동기화 호출의 정확한 위치를 프로그래머가 직접 결정해야 하며, 최악의 경우 동기화 호출 수가 그래프의 의존성 수와 동일해진다. 그래프가 커질수록 이 세밀한 동기화는 복잡해지고 오류 가능성이 높아지며 불필요한 오버헤드를 유발한다. 실제로 많은 애플리케이션은 중간 태스크의 완료보다 전체 태스크 그래프의 완료만을 필요로 하는 경우가 대부분이어서, 이런 세밀한 동기화는 불필요하고 비용만 초래한다.
세 번째 한계는 고도로 동적인 태스크 그래프 구성에 대한 지원 부족이다. 그래프 구조, 의존성, 태스크 내용이 런타임 변수나 동적 제어 흐름 결과에 따라 달라지는 워크로드의 경우, OpenMP처럼 컴파일러가 생성한 정적 정보에 의존하는 방식은 근본적으로 적합하지 않다.
네 번째 한계는 이식성(Portability) 문제다. OpenMP와 OpenCilk 같은 라이브러리는 병렬 코드 생성을 위해 비표준 C++ 컴파일러 확장에 의존하므로, 다양한 컴퓨팅 플랫폼에 걸쳐 심각한 이식성 문제가 발생할 수 있다.
정적 vs 동적 태스크 그래프 프로그래밍
AsyncTask를 이해하기 위해 강연자는 먼저 정적 태스크 그래프 프로그래밍(Static TGP, STGP)과 동적 태스크 그래프 프로그래밍(Dynamic TGP, DTGP)의 차이를 명확히 했다.
STGP는 “구성 후 실행(Construct-then-Run)” 모델을 따른다. 태스크 그래프를 먼저 완전히 정의한 뒤, 해당 그래프를 런타임 executor에 제출하면 executor가 스케줄링 세부사항을 처리한다. 강연자의 Taskflow 라이브러리가 STGP의 대표적 구현이다. Taskflow에서는 Taskflow 객체 안에 C++ 람다 함수 객체로 태스크를 정의하고 precede(), succeed() 메서드로 의존성을 연결한 뒤 executor에 제출하는 깔끔한 패턴을 사용할 수 있다. 태스크 그래프의 구성과 실행이 명확히 분리된다.
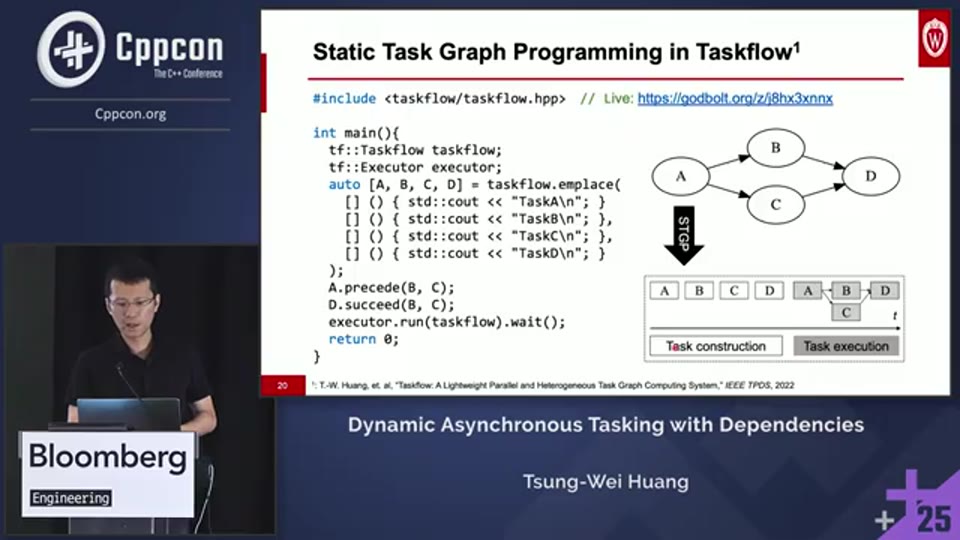
16:37 - Taskflow를 이용한 정적 태스크 그래프 프로그래밍(STGP) 구현 코드 및 구성-실행 분리
반면 DTGP는 태스크 그래프 구성과 실행이 중첩(Overlap)될 수 있다. 의존성이 충족되는 즉시 비동기 태스크가 실행을 시작하기 때문이다. 이 중첩이 가져오는 이점은 특히 매우 큰 태스크 그래프에서 두드러진다. STGP에서 태스크 그래프 구성은 일반적으로 단일 스레드에서 이루어지며, 이 시간이 대형 그래프에서는 전체 실행 시간의 상당 부분을 차지할 수 있다. 실제로 강연자의 실험에서 BJLCD 벤치마크(약 40만 태스크와 의존성 보유)의 경우 그래프 구성에 전체 런타임의 15%가 소요되었으며, 이때 DTGP가 STGP 대비 약 9% 더 빠른 성능을 보였다. 단, 그래프가 매우 작을 때는 DTGP의 스케줄링 오버헤드가 이 중첩 이점을 상회할 수 있다.
AsyncTask — 새로운 동적 태스크 그래프 프로그래밍 모델
AsyncTask는 처음부터 새로 구현하는 대신 기존 Taskflow의 스케줄링 인프라 위에 구축된 DTGP 모델이다. 이를 통해 5년 이상의 연구가 축적된 work-stealing 스케줄러의 성숙된 구현을 재사용할 수 있었다.
AsyncTask의 핵심 API는 두 가지다. silent_dependent_async는 태스크를 비동기적으로 실행하되 future 객체를 반환하지 않는 “fire and forget” 방식이다. 반면 dependent_async는 future 객체를 반환하여 세밀한 태스크별 동기화가 필요한 경우에 사용된다. 두 메서드 모두 C++의 가변 인자 파라미터 팩(Variadic Parameter Pack)을 통해 임의의 수의 의존성을 지정할 수 있다. 예를 들어 태스크 D를 생성할 때 B와 C를 마지막 인수로 전달하면, “D는 B와 C가 모두 완료된 후에만 실행된다”는 의존성이 단 하나의 함수 호출 안에서 표현된다. 이것이 기존 라이브러리들에서 태스크 생성과 의존성 표현이 분리되었던 것과 근본적으로 다른 점이다.
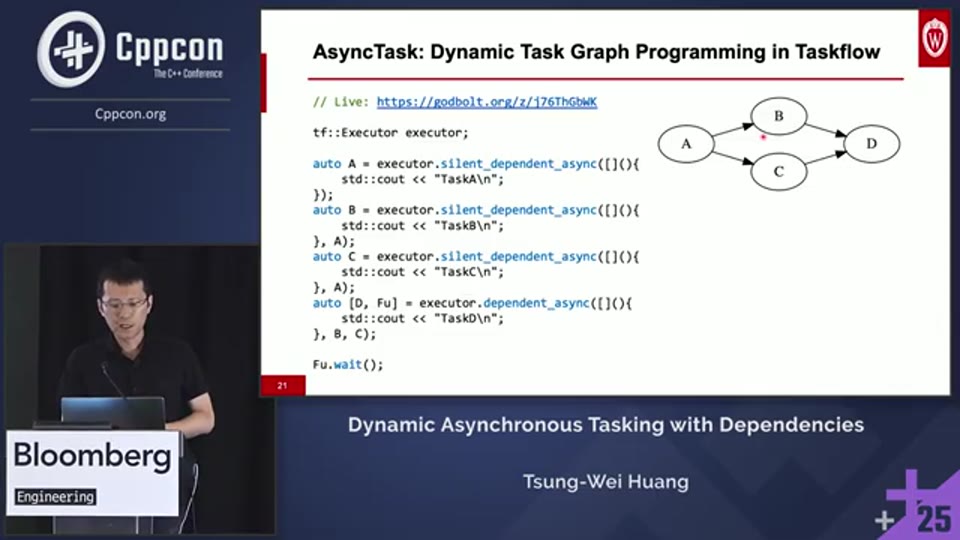
17:53 - AsyncTask의 dependent_async / silent_dependent_async API를 사용한 동적 태스크 그래프 구현 코드
세밀한 동기화가 필요하지 않다면, wait_for_all() 메서드로 전체 태스크 그래프가 완료될 때까지 기다릴 수 있다. 이는 중간 태스크별 동기화 오버헤드를 줄이며, 특히 그래프가 매우 클 때 의미 있는 성능 이점을 가져온다.
AsyncTask는 런타임 변수로 결정되는 의존성도 자연스럽게 지원한다. 예를 들어 파일에서 로드하거나 함수 반환값으로 얻어진 태스크 그래프 구조를 표현할 때, dependent_async 핸들의 벡터를 생성하고 STL 스타일의 범위(Range) 연산을 사용하여 의존성을 지정할 수 있다. 강연자는 이 기능이 겉보기엔 사소해 보이지만, OpenMP나 C++ sender/receiver 모델로는 구현이 매우 어렵다고 강조했다. 두 모델 모두 태스크 생성과 의존성 표현이 구조적으로 분리되어 있기 때문이다.
더 나아가 DTGP는 런타임 변수나 제어 흐름 결과에 따라 완전히 다른 구조의 태스크 그래프를 조립하는 것도 가능하다. 예를 들어 어떤 변수의 참·거짓에 따라 G1 이후에 G2를 실행하거나 G3을 실행하는 분기 구조를, 혹은 태스크 그래프 G1의 태스크 수에 따라 후속 그래프 구성을 달리하는 로직을 자연스럽게 표현할 수 있다. 이런 유연성은 그래프 구조를 사전에 완전히 결정해야 하는 STGP로는 달성하기 어렵다.
💡 [영상 참조] 강연자는 이 시점에서 AsyncTask의 API 코드 예시와 runtime-driven execution의 다양한 패턴을 슬라이드로 보여줍니다. 📺 원본 영상에서 확인하세요.
DTGP에서는 올바른 위상 정렬 순서(Correct Topological Order)가 필수적이다. 의존성을 지정할 때 부모 태스크가 이미 존재해야 하기 때문이다. 앞서 예시의 ABCD 그래프에서 ABCD 혹은 ACBD 순서 모두 유효한 위상 정렬이지만, D를 B와 C보다 먼저 생성하려 한다면 아직 존재하지 않는 B와 C에 대한 의존성을 지정할 수 없다. 따라서 애플리케이션에서 올바른 위상 정렬 순서를 알 수 없다면, DTGP는 적합한 도구가 아니다.
데이터 추상화를 건드리지 않는다는 철학적 결정
AsyncTask의 설계에서 특히 주목할 만한 것은 데이터 추상화(Data Abstraction)를 전혀 다루지 않는다는 의도적 선택이다. 이는 수년간의 응용 경험에서 도출된 결정으로, 세밀한(Fine-grained) 데이터 병렬성이 아닌 거친(Coarse-grained) 태스크 병렬성에 집중한다는 목표를 명확히 한다. 사용자는 C++ 람다 함수 객체를 통해 필요한 데이터를 스스로 캡처하거나 함수 인자로 전달하면 된다.
이 결정은 두 가지 실질적 이점을 가져온다. 첫째, 사용자가 데이터 레이아웃과 소유권에 대한 완전한 제어권을 보유한다. 데이터 구조를 구성하고 메모리 레이아웃을 최적화하는 방법은 알고리즘과 애플리케이션 도메인에 전적으로 의존하며, AsyncTask는 이에 개입하지 않는다. 둘째, 사용자가 데이터 저장 방식을 직접 결정하게 함으로써 AsyncTask 자체가 경량(Lightweight)이고 비침투적(Non-intrusive)으로 유지된다. 기존 데이터 구조를 수정하지 않고도 애플리케이션을 병렬화할 수 있다.
이는 FastFlow나 TBB Pipeline처럼 라이브러리 고유의 데이터 추상화를 요구하여 병렬성을 얻기 위해 코드를 재작성하도록 강제하는 데이터 병렬 프로그래밍 모델과 근본적으로 다른 접근법이다.
스케줄러 설계 — 세 가지 도전 과제와 해결책
AsyncTask의 스케줄러는 Taskflow의 work-stealing 스케줄러 위에 구축된다. 이 스케줄러는 태스크 레벨(의존성이 충족된 태스크를 어느 worker에 배정할지)과 worker 레벨(태스크가 가용해지면 어느 worker가 실행할지)의 두 계층으로 동작한다. 이 기반 시스템은 5년 이상의 연구 결과물이며, 강연자는 세부 내용에 관심 있는 청중에게 TPDS(IEEE Transactions on Parallel and Distributed Systems)에 게재된 원본 논문을 참조하도록 권했다.
DTGP를 이 work-stealing 기반 위에서 지원하기 위해 세 가지 핵심 도전 과제를 해결해야 했다.
도전 1 - ABA 문제
ABA 문제란, 의존성을 지정할 때 참조하는 태스크 포인터가 실제로 의도한 태스크를 가리키고 있음을 보장해야 한다는 문제다. DTGP에서 태스크 A는 생성되자마자 즉시 실행을 시작할 수 있으며, 매우 빠르게 완료될 수도 있다. 만약 worker가 메모리 풀(Memory Pool)이나 객체 재활용(Object Recycling) 같은 최적화로 태스크 A의 리소스를 재사용한다면, 새로 할당된 다른 태스크가 같은 메모리 주소를 갖게 될 수 있다. 이 경우 이전에 태스크 A를 참조하던 포인터는 전혀 다른 태스크를 가리키게 된다. 이것이 고전적인 ABA 문제다.
해결책으로 AsyncTask는 각 태스크에 대한 공유 소유권(Shared Ownership)을 보장하는 특별한 핸들 타입을 도입했다. 이 async_task 핸들은 std::shared_ptr처럼 동작하여, 해당 태스크가 필요한 동안에는 메모리에서 제거되지 않도록 보장한다. 이를 통해 지정된 의존성이 항상 올바른 태스크를 가리키며 ABA 문제가 발생하지 않는다.
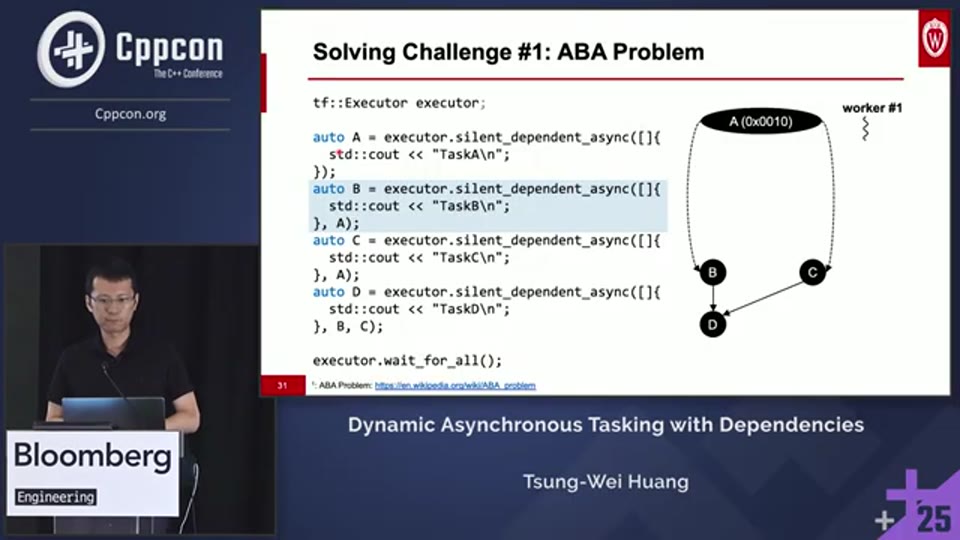
27:40 - ABA 문제 다이어그램 및 async_task 핸들(shared_ptr 방식) 해결책
도전 2 - 데이터 레이스(Data Race)
DTGP에서는 태스크 그래프 구성과 실행이 동시에 일어날 수 있기 때문에, 여러 worker 스레드가 동시에 하나의 dependent_async 태스크의 내부 데이터 구조에 접근할 수 있다. 예를 들어 태스크 B와 C가 동시에 태스크 A의 후속 목록에 자신을 추가하려 할 수 있고, A는 완료되면서 자신의 후속 태스크 목록을 정리하려 할 수 있다.
단순한 해결책은 뮤텍스(Mutex)를 사용하는 것이지만, 뮤텍스는 의존성이 많을수록 성능 비용이 커진다. 대신 연구팀은 CAS(Compare-and-Swap) 연산과 스피닝(Spinning)의 조합으로 배타적 접근을 구현했다. 이 스피닝이 실제로 큰 오버헤드를 유발하지 않는 이유는, 현실 애플리케이션에서 대부분의 태스크 그래프가 매우 희소(Sparse)하기 때문이다. 강연자는 태스크 그래프가 지나치게 밀도가 높다면 그 자체로 태스크 그래프가 적합하지 않은 구조임을 시사한다고 지적했다.
도전 3 - 동기화 오버헤드
애플리케이션은 실행 중 언제든지 세밀한(future.wait()) 혹은 거친(wait_for_all()) 동기화를 발행할 수 있다. 뮤텍스와 조건 변수(Condition Variable)를 사용하는 단순한 해결책은 태스크와 스레드 수가 증가할수록 비용이 급격히 늘어난다.
이를 해결하기 위해 연구팀은 C++20의 원자적 wait/notify 연산을 활용했다. 이는 동기화 작업의 상당 부분이 커널을 거치지 않고 사용자 공간(User Space)에서 처리되도록 한다. 강연자에 따르면 이 변경만으로 약 11%의 성능 향상을 달성했다. 조건 변수를 사용하는 async_task_cd 버전과의 비교를 통해 이 수치가 도출되었다.
이 세 가지 해결책을 종합한 결과, AsyncTask의 스케줄링 알고리즘은 완전히 lock-free다. 뮤텍스가 전혀 없다. 이 알고리즘은 ICCAD 2023에 발표되었으며, 강연자는 더 깊은 내용에 관심 있는 청중에게 해당 논문 참조를 권했다.
성능 평가 — 마이크로벤치마크
연구팀은 네 가지 일반적인 태스크 그래프 패턴으로 구성된 마이크로벤치마크를 통해 AsyncTask의 성능을 측정했다. Linear Chain은 태스크가 순차적으로 연결된 구조, Binary Tree는 병렬 분할 정복(Divide and Conquer) 알고리즘 구현에 자주 사용되는 패턴으로 각 태스크가 두 개의 종속 태스크를 스폰하는 형태, Embarrassing Parallelism은 모든 태스크가 완전히 독립적이며 의존성 없이 병렬 실행되는 구조, Random Graph는 의존성이 무작위로 할당된 비정형 워크로드다.
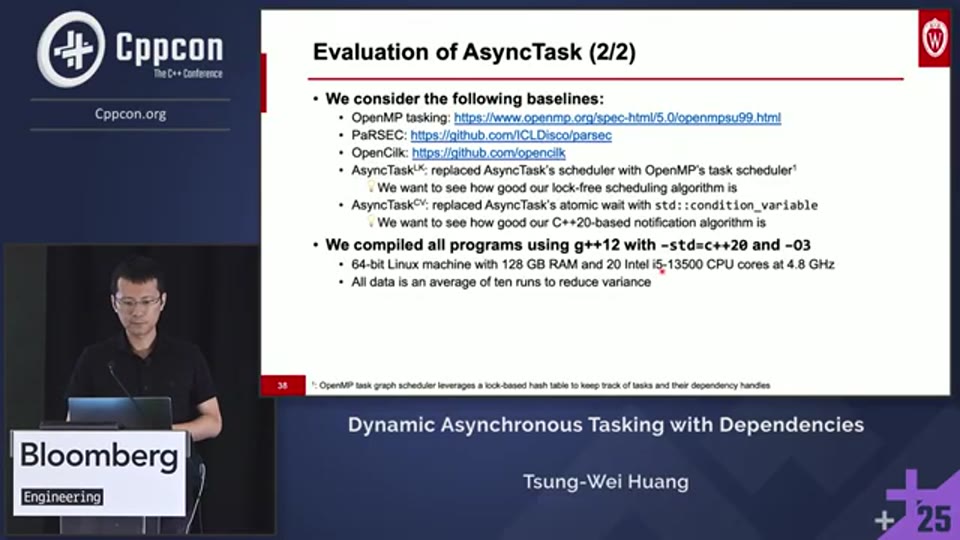
비교 기준선(Baseline)은 OpenMP Tasking, Parsec, OpenCilk, async_task_lk(OpenMP 스케줄러로 교체한 버전), async_task_cd(조건 변수 기반 동기화로 교체한 버전)였다. async_task_lk는 lock-based 해시 테이블로 태스크와 의존성을 추적하는 OpenMP 스케줄러와의 비교를 통해 연구팀의 스케줄링 알고리즘의 우위를 측정하기 위한 것이고, async_task_cd는 C++20 원자 변수 대신 C++17 조건 변수를 사용했을 때의 성능 차이를 측정하기 위한 것이다. 실험 환경은 GCC 12, C++20, 최적화 레벨 O3으로 컴파일되었으며, 128GB 메모리와 20개의 Intel i5 코어(각 4.8GHz)를 탑재한 64비트 Linux 머신에서 진행되었다. 결과 데이터는 10회 실행의 평균값이다.
34:42 - 네 가지 마이크로벤치마크(Linear Chain, Binary Tree, Embarrassing Parallelism, Random Graph)의 성능 비교 차트
전반적으로 AsyncTask는 거의 모든 시나리오에서 기준선을 능가했다. Random Graph 패턴에서 태스크 수가 증가할수록 AsyncTask의 확장성(Scalability)이 다른 기준선보다 훨씬 우수했으며, 특히 OpenMP와의 성능 격차가 그래프 크기에 따라 지속적으로 확대되었다. 2백만 개의 태스크를 고정한 상태에서 스레드 수를 변화시켰을 때 런타임은 스레드 수 증가에 따라 감소하다가 약 4~8 스레드에서 포화 상태에 도달했는데, 이는 태스크 그래프 구조에서 이용 가능한 최대 병렬성에 의해 결정된다.
성능 평가 — 프로그래밍 생산성 설문
강연자는 성능 측정에 그치지 않고 UW-Madison의 HPC(High Performance Computing) 수업을 수강하는 300명 이상의 대학원생을 대상으로 프로그래밍 생산성 설문도 공유했다. 학생들에게 AsyncTask, OpenMP, OpenCilk, Parsec, std::async 다섯 가지 DTGP 라이브러리를 사용하여 앞서의 마이크로벤치마크를 구현하는 과제를 제시하고, 완료 후 각 라이브러리를 1~10점으로 평가하도록 했다.
결과는 의미심장했다. 학습 용이성(Ease of Learning) 측면에서 AsyncTask, OpenMP, OpenCilk, std::async는 대체로 높은 점수를 받았다. 디버깅(Debugging) 용이성에서는 DTGP의 동적 특성 때문에 전반적으로 점수가 낮았지만, AsyncTask가 가장 높은 점수를 받았다. 이는 태스크와 의존성이 분리되지 않고 함께 표현되는 설계 덕분으로 분석된다.
가장 극적인 결과는 정확성(Correctness)에서 나왔다. Random Graph 벤치마크에서 대부분의 학생이 AsyncTask를 제외한 기존 라이브러리로는 올바른 구현을 완성하지 못했다. 특히 OpenMP에서는 90%의 학생이 정확한 구현에 실패했다. 이 결과는 강연 초반부에 강연자가 강조했던 메시지—기존 라이브러리에서 의존성 표현 방식이 어떻게 오류를 유발하는지—를 강력하게 뒷받침한다. 올바른 추상화가 성능만큼이나 중요하다는 것을 250명 이상의 학생 데이터가 직접 증명한 셈이다.
성능 평가 — 실세계 응용: VLSI 정적 타이밍 분석
강연자 팀은 EDA(Electronic Design Automation) 업체와의 협업을 통해 실세계 응용인 정적 타이밍 분석(Static Timing Analysis, STA)에 AsyncTask를 적용하고 성능을 평가했다. STA는 VLSI 및 디지털 회로의 전체 설계 흐름에서 매우 중요한 단계로, 주어진 클럭 주파수에서 모든 신호가 정해진 시간 안에 도착하는지 검증한다. 타이밍 전파 알고리즘은 동적 태스크 그래프로 모델링되어, 도착 시간(Arrival Time), 지연(Delay), 제약 값(Constraint Value) 등 타이밍 데이터를 회로 입력에서 출력까지 전파한다.
평가에 사용된 네 개의 산업 표준 벤치마크 회로는 다음과 같다.
| 벤치마크 | 비고 |
|---|---|
| AES-Core | 암호화 회로 |
| Dasper | VLSI 자동화 공개 벤치마크 |
| BJLCD | 약 40만 태스크, 40만 의존성 |
| Leon II | VLSI 자동화 공개 벤치마크 |
평가된 가장 큰 태스크 그래프는 400만 개 이상의 태스크와 800만 개의 의존성을 포함한다.
이들은 모두 VLSI 설계 자동화(EDA) 분야의 공개 벤치마크이며, 규모와 특성이 다양하다는 점에서 이 실험은 단순한 이론 검증을 넘어 실제 산업 워크로드에서의 검증이라는 의미를 가진다.
💡 [영상 참조] 강연자는 이 시점에서 STA 응용의 성능 비교 차트를 보여줍니다. 📺 원본 영상에서 확인하세요.
실험 결과 AsyncTask는 사용하는 스레드 수에 관계없이 모든 기준선을 지속적으로 능가했다. 이 일관된 성능 격차는 lock-free 스케줄링 알고리즘의 효율성을 직접 증명한다.
Q&A 하이라이트 — 실무 관점의 심화 논의
강연 후 진행된 질의응답에서는 실무 사용자들의 구체적인 관심사가 드러나며 AsyncTask의 설계 철학이 더욱 명확해졌다.
태스크 간 데이터 전달에 관하여: AsyncTask는 데이터 추상화를 다루지 않으므로, 태스크 간 데이터 전달은 전적으로 개발자 책임이다. 공유 메모리 아키텍처를 기본 전제로 하며, 람다 함수 객체에서 레퍼런스 캡처를 통해 데이터에 접근하는 방식을 사용하면 된다.
태스크의 원자성에 관하여: 모델에서 각 태스크는 단일 스레드로 실행되는 원자적 단위다. 태스크 내부에서 더 많은 병렬성을 활용하려면 해당 태스크를 여러 하위 태스크로 분해하여 별도의 태스크 그래프 계층을 구성해야 한다.
예외 처리에 관하여: 병렬 환경에서의 예외 처리는 매우 까다로운 문제다. AsyncTask는 AMD와의 협업을 통해 두 가지 수준의 예외 처리를 지원한다. 거친 수준에서는 전체 그래프 완료를 기다린 후 발생한 예외를 포착할 수 있고, 세밀한 수준에서는 dependent_async로 얻은 future 객체를 통해 특정 태스크가 던진 예외를 직접 포착할 수 있다. 각 태스크별 예외 포인터를 통해 어느 태스크에서 예외가 발생했는지 식별도 가능하며, 예외 발생 시 나머지 태스크 그래프 실행이 자동으로 취소된다.
사이클 의존성 감지에 관하여: AsyncTask에서는 A→B→A 같은 순환 의존(Cycle Dependency)을 지원하지 않는다. 제어 흐름을 태스크 그래프 외부에서 처리하고, 그 결과에 따라 다른 태스크 그래프를 구성하는 것이 AsyncTask의 철학이다. 다만 Taskflow의 STGP 모드에서는 제어 흐름을 태스크 의존성에 통합하는 특화된 인터페이스를 별도로 제공하며, 이것이 Taskflow와 기존 라이브러리의 중요한 차별점 중 하나다.
태스크 일시 정지(Pause)에 관하여: 현재 AsyncTask는 태스크 그래프 실행의 일시 정지를 지원하지 않는다. 이를 구현하려면 태스크 내 멀티태스킹을 가능하게 하는 C++20 코루틴(Coroutine)이 필요한데, 많은 산업 사용자들이 여전히 C++17을 사용하고 있어 아직 마이그레이션을 결정하지 않고 있다. 강연자는 이것이 미래의 연구 방향임을 시사했다.
Taskflow 프로젝트 — AsyncTask의 집
AsyncTask에서 논의된 모든 내용은 오픈소스 Taskflow 프로젝트에 통합되어 있다. Taskflow는 헤더 전용(Header-only) C++ 라이브러리로, 표준 C++ 시설만으로 완전히 구현되어 외부 라이브러리에 대한 의존성이 없다. 사용 방법도 간단하다. Taskflow 프로젝트를 다운로드하고 컴파일 시 헤더 파일 위치를 컴파일러에 알려주는 것으로 충분하며, 복잡한 설치 과정이 없다.
프로젝트는 2018년경 미국 국방부(Department of Defense)의 핵심 회로 설계 자동화 과제를 기존 모델로는 효율적으로 처리할 수 없다는 문제의식에서 출발했다. 현재는 AMD, Roach(바이오인포매틱스 기업) 등 다양한 산업 사례와 함께, 강연자의 예상을 뛰어넘어 컴퓨터 그래픽스 분야—특히 렌더링 엔진 구현—에서도 활발히 활용되고 있다.
마무리 — 무엇을 가져가야 하는가
이 강연의 핵심 메시지는 명확하다. 비정형 병렬 워크로드를 처리하는 기존 C++ 비동기 태스킹 모델들은 태스크-의존성 분리, 복잡한 수동 동기화, 동적 그래프 지원 부족, 이식성 문제라는 네 가지 구조적 한계를 가지고 있다. AsyncTask는 이를 근본적으로 해결하기 위해 설계된 DTGP 모델로, 태스크 생성과 의존성 표현을 하나의 API 호출로 통합하고, lock-free 스케줄러와 C++20 원자 연산을 통해 성능을 극대화했다.
이 접근법의 가치는 단순히 이론적 우위에 그치지 않는다. 마이크로벤치마크에서의 확장성 우위, 300명 이상 학생 설문에서의 사용 편의성 우위, 그리고 4백만 개 이상의 태스크를 다루는 실제 VLSI STA 응용에서의 성능 우위가 이를 증명한다. 무엇보다 90%의 학생이 올바른 구현에 실패한 OpenMP와 달리 AsyncTask에서는 대부분의 학생이 성공했다는 결과는, 올바른 추상화 설계가 성능만큼이나—어쩌면 그 이상으로—중요하다는 것을 상기시킨다.
C++ 병렬 프로그래밍을 고려하는 개발자에게, 특히 비정형이고 의존성이 복잡한 워크로드를 다루는 경우, AsyncTask와 Taskflow 프로젝트는 구체적으로 검토할 만한 선택지다.
📚 참고 자료 (강연 내용과 별개)
이 강연의 내용을 더 깊이 이해하기 위해 참고할 만한 배경 지식과 자료들이다. 아래 내용은 강연에서 직접 다룬 내용이 아니며, 이해를 돕기 위한 보충 자료임을 밝힌다.
Work-Stealing 스케줄러: 강연에서 언급된 Taskflow의 work-stealing 스케줄러는 IEEE TPDS에 게재된 논문에 상세히 설명되어 있다. Work-stealing은 각 worker 스레드가 자신의 태스크 큐가 비면 다른 스레드의 큐에서 태스크를 “훔쳐오는” 방식으로 부하를 자동 분산하는 스케줄링 기법으로, Intel의 Cilk 프로젝트에서 처음 널리 알려졌으며 현재 다수의 고성능 병렬 런타임에서 사용된다.
Lock-Free 프로그래밍과 CAS: 강연에서 데이터 레이스 해결에 사용된 CAS(Compare-and-Swap) 연산은 현대 CPU가 하드웨어 수준에서 원자적으로 지원하는 연산이다. 특정 메모리 위치의 값이 예상 값과 일치할 때만 새로운 값으로 교체하는 방식으로, 뮤텍스 없이 동시성 문제를 해결하는 lock-free 알고리즘의 핵심 도구다.
C++20 원자 변수 Wait/Notify: C++20에서 도입된 std::atomic::wait()과 std::atomic::notify_one()/notify_all()은 커널 공간으로의 컨텍스트 전환 없이 사용자 공간에서 효율적인 동기화를 가능하게 한다. 이는 Linux의 futex와 유사한 메커니즘을 C++ 표준으로 추상화한 것으로, 빈번한 동기화가 필요한 고성능 병렬 코드에서 조건 변수 대비 상당한 성능 이점을 제공한다. 강연에서 측정된 11% 향상이 이를 직접 보여준다.
AsyncTask 스케줄링 알고리즘 논문: lock-free 스케줄링 알고리즘은 ICCAD 2023(IEEE/ACM International Conference on Computer-Aided Design)에 발표되었다. 해당 논문에서 ABA 문제, 데이터 레이스, 동기화 오버헤드에 대한 해결책의 정확성 증명과 상세한 구현 설명을 찾아볼 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Dynamic Asynchronous Tasking with Dependencies - Tsung-Wei Huang - CppCon 2025 |
| 채널 | CppCon |
| 리포트 작성 | 2026-04-02 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.