EP 108. 칩과 칩을 빛으로 연결한다 - 실리콘 포토닉스와 AI 데이터센터의 다음 병목
📺 원본 영상: EP 108. 칩과 칩을 빛으로 연결한다: 실리콘 포토닉스와 AI 데이터센터의 다음 병목
🎙️ 채널: AI Frontier Korea (노정석)
📅 정리 일자: 2026-08-09
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이번 대화의 핵심은 AI 데이터센터의 병목이 단순히 GPU 연산 성능이나 HBM 메모리 대역폭에만 머물지 않고, 장치와 장치 사이의 데이터 이동으로 확장되고 있다는 점이다. 강연자는 기존에는 랙 내부는 구리선, 랙 간 또는 데이터센터 간은 광통신이라는 구분이 자연스럽게 받아들여졌지만, AI 모델과 클러스터 규모가 커지면서 광통신을 칩과 칩 사이까지 끌어오는 실리콘 포토닉스가 중요한 기술 축으로 부상하고 있다고 설명한다.
특히 이번 에피소드는 실리콘 포토닉스의 물리적 원리만 다루지 않는다. 박준호 연구자와 김태한 연구자는 포토닉스 소자를 더 작고 제조 친화적으로 만들기 위해 Inverse Design(역설계), Conditional Variational Autoencoder(CVAE), Integrated Gradients(통합 기울기) 같은 AI 방법론을 접목하는 연구를 소개한다. 따라서 이 영상은 “왜 빛으로 칩을 연결해야 하는가”에서 출발해, “그 빛의 회로를 어떻게 AI로 설계하고 제조 가능하게 만들 것인가”로 이어지는 Hard Tech 리포트로 읽을 수 있다.
AI 데이터센터의 병목은 계산에서 이동으로 옮겨간다
강연의 출발점은 AI 인프라를 구성하는 세 가지 축이다. 첫째는 GPU나 TPU가 얼마나 빠르게 계산하는가라는 Compute 문제이고, 둘째는 HBM과 SRAM 사이에서 데이터를 얼마나 빠르게 가져오는가라는 Memory 문제이며, 셋째는 GPU, 서버, 랙, 데이터센터 사이를 얼마나 빠르게 연결하는가라는 Interconnect 문제다. 기존 AI 시스템 논의에서는 Compute와 Memory가 더 자주 주목받았지만, 대규모 모델이 하나의 디바이스에 들어가지 않게 되면서 통신 자체가 모델 성능과 비용을 좌우하는 핵심 변수로 올라왔다.
FlashAttention 같은 연구가 HBM과 SRAM 사이의 데이터 이동을 줄이기 위해 IO-aware 방식으로 설계되었다면, 대규모 학습과 추론에서는 비슷한 문제가 여러 장치 사이에서 반복된다. 모델 병렬화(Model Parallelism)는 하나의 모델을 여러 GPU에 나누어 올리고, 데이터 병렬화(Data Parallelism)는 여러 배치를 여러 장치에 분산해 학습시킨 뒤 결과를 합친다. 이 과정에서 연산 장치가 충분히 빠르더라도 데이터를 제때 주고받지 못하면 GPU는 놀게 되고, 시스템 전체의 효율은 급격히 떨어진다.
강연자는 이 흐름을 로컬 디바이스 중심의 사고에서 데이터센터 규모의 사고로 전환해야 한다고 본다. 과거에는 “한 장의 GPU가 얼마나 빠른가”가 중요한 질문이었다면, 이제는 수십 개, 수백 개, 더 나아가 데이터센터 단위의 가속기를 하나의 거대한 컴퓨터처럼 묶는 방식이 중요해졌다. 이 변화는 AI 모델 스케일링이 단순한 칩 성능 경쟁이 아니라 전력, 냉각, 배치, 네트워크, 패키징까지 포함하는 시스템 엔지니어링 문제로 바뀌었음을 보여준다.
💡 [영상 참조] 강연자는 이 부분에서 AI 인프라의 세 가지 병목과 데이터센터 규모 확대를 설명하는 슬라이드를 참조합니다.
📺 원본 영상에서 확인하세요.
Scale Up, Scale Out, Scale Across라는 세 개의 축
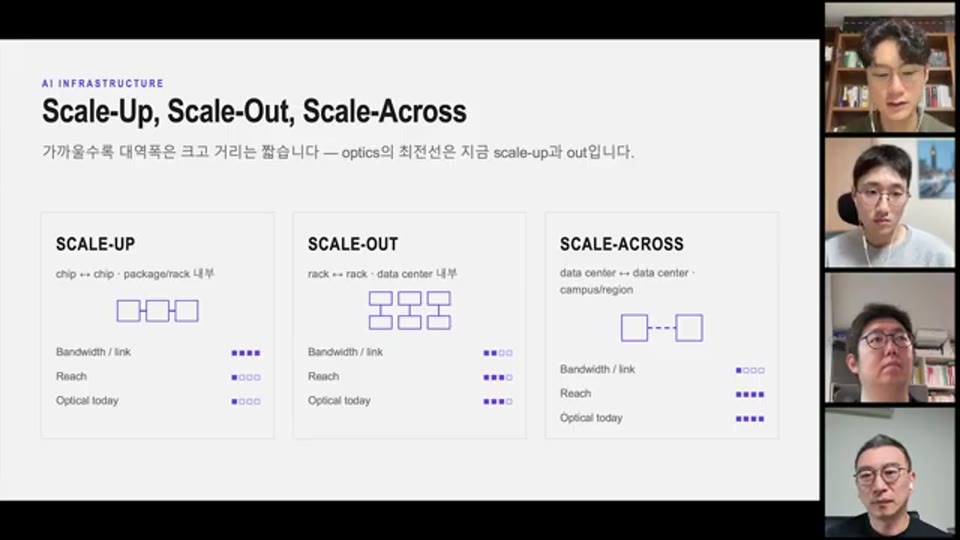
포토닉스 업계에서는 데이터센터 확장을 Scale Up, Scale Out, Scale Across라는 세 가지 축으로 나누어 설명한다고 한다. Scale Up은 하나의 랙 안에서 GPU와 GPU, 또는 칩과 칩을 위아래로 연결하는 문제에 가깝다. NVIDIA의 NVL72, NVL144 같은 구성은 같은 랙 안에 최대한 많은 GPU를 넣고, 그 GPU들을 가능한 한 촘촘하고 빠르게 연결하려는 시도로 이해할 수 있다.
Scale Out은 랙과 랙 사이의 연결이다. 하나의 랙 안에서 해결할 수 있는 컴퓨팅 규모를 넘어서면 여러 랙을 묶어야 하고, 이때부터는 물리적 거리가 길어지며 구리선의 한계가 더 뚜렷해진다. Scale Across는 데이터센터와 데이터센터 사이를 연결하는 개념으로, AI 데이터센터의 물리적 크기와 전력 요구량이 지나치게 커지면서 하나의 거대한 시설로 모든 것을 처리하기 어려워지는 상황을 반영한다.
이 구분이 중요한 이유는 포토닉스가 들어갈 위치를 판단하게 해주기 때문이다. 강연자는 “언제 모든 것이 광으로 바뀌는가”보다 “어느 구간부터 광으로 옮기는 것이 합리적인가”가 더 중요한 질문이라고 본다. 짧은 거리에서는 여전히 구리선이 저렴하고 효율적일 수 있지만, 거리가 미터 단위로 늘어나거나 대역폭 요구가 급격히 커지는 순간 광통신의 장점이 빠르게 커진다.
구리선의 한계와 광통신의 강점
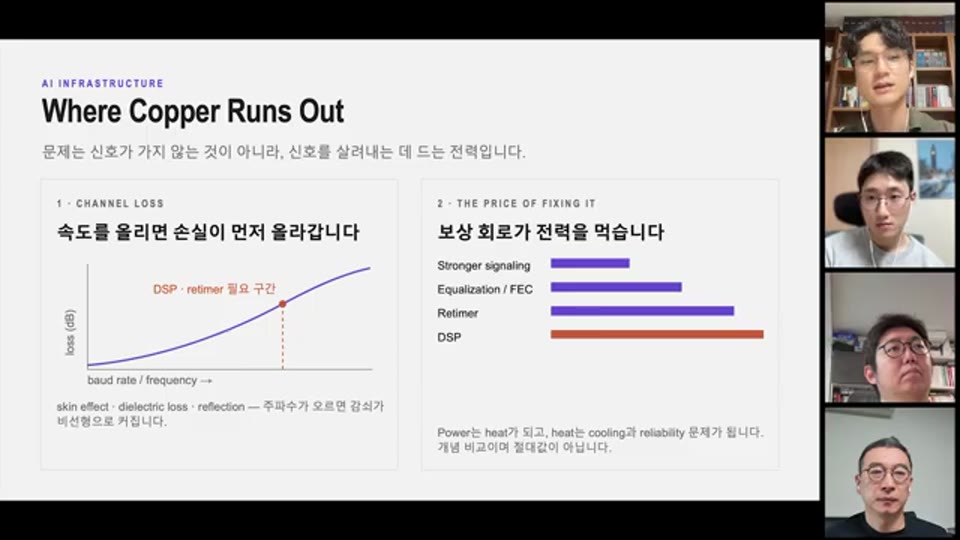
구리선은 단거리 인터커넥트에서는 여전히 강력하다. 가격이 싸고 제조가 쉬우며, 매우 짧은 구간에서는 에너지 효율도 나쁘지 않다. 그러나 거리와 주파수가 올라가면 구리선은 물리적 손실을 피하기 어렵다. 강연자는 Skin Effect(표피 효과)와 Dielectric Loss(유전 손실)를 언급하며, 구리선에서 대역폭을 높이기 위해 주파수를 올릴수록 신호 손실이 커지고, 이를 보정하기 위해 Retimer나 DSP 같은 부가 회로가 필요해진다고 설명한다.
반대로 Optical Fiber(광섬유)는 거리 증가에 따른 bit당 에너지가 상대적으로 평탄하다는 장점이 있다. 음성 설명에 따르면 구리선은 미터 단위로 갈수록 신호 손실이 빠르게 증가하지만, 광섬유는 장거리에서도 신호 손실이 훨씬 작고 대역폭 측면에서도 구리보다 2~3 orders of magnitude 수준으로 높을 수 있다. 이는 데이터센터 안팎에서 AI 가속기를 대규모로 묶는 데 광통신이 점점 더 매력적인 선택지가 되는 이유다.
10:17 - 구리선과 광섬유의 거리별 신호 손실 및 에너지 효율 차이
문제는 광통신을 어디까지 칩에 가깝게 가져올 수 있느냐다. 현재 산업 표준에 가까운 방식은 Pluggable Optics(플러거블 옵틱스)처럼 랙 간 연결에 쓰는 모듈형 광 연결이다. 이후 On-board Optics는 광 모듈을 보드 위로 가져오고, Co-packaged Optics(CPO)는 ASIC과 광 인터커넥트를 같은 패키지 안으로 넣으며, Optical IO는 더 나아가 리소그래피 단계에서 광 컴포넌트를 칩과 거의 함께 만드는 방향을 뜻한다.
| 구분 | 위치와 특징 | 장점 | 부담 |
|---|---|---|---|
| Pluggable Optics | 랙 간 연결용 외부 모듈 | 교체가 쉽고 제조 난이도가 낮음 | 구리선 구간이 상대적으로 길어 에너지 효율이 낮음 |
| On-board Optics | 보드 위에 광 모듈 집적 | 전기 신호 이동 거리를 줄임 | 보드 설계와 패키징 복잡도 증가 |
| Co-packaged Optics | ASIC과 광 모듈을 같은 패키지에 배치 | bit당 에너지 감소와 대역폭 개선 | 수율, 열, 서비스성 문제가 커짐 |
| Optical IO | 칩 수준에서 광 IO를 통합 | 구리선 구간을 극단적으로 줄임 | 제조 난이도와 공정 통합 부담이 가장 큼 |
이 표는 강연자가 설명한 방향성을 요약한 것이다. 오른쪽으로 갈수록 구리선 구간이 줄어 에너지 효율과 대역폭 측면에서는 유리해지지만, 동시에 제조 난이도, 수율, 열 관리, 고장 시 교체 가능성 같은 현실적 문제가 커진다. 따라서 실리콘 포토닉스의 상용화는 단순히 광이 더 좋다는 논리만으로 결정되지 않고, 성능 이득과 제조 리스크 사이의 균형을 맞추는 문제로 전개된다.
14:08 - Pluggable Optics, On-board Optics, Co-packaged Optics, Optical IO의 집적 단계 비교
실리콘 포토닉스의 기본 원리
실리콘 포토닉스는 전기 신호를 광 신호로 바꾸고, 빛을 통해 정보를 보낸 뒤, 다시 광 신호를 전기 신호로 바꾸는 기술이다. 송신 측 칩에서 나온 전기 신호는 Optical Engine 또는 Transceiver를 통해 빛에 실리고, 그 빛은 Fiber 또는 Waveguide를 따라 이동한 뒤 수신 측에서 다시 전기 신호로 복원된다. 이 과정에서 핵심은 전기 신호를 어떻게 빠르고 효율적으로 빛에 “임베딩”하느냐다.
강연자는 이를 Electro-Optic Modulation(전기광학 변조)으로 설명한다. 과거에는 레이저 자체를 켰다 끄거나 차폐막을 움직여 빛의 Intensity(세기)를 조절하는 방식이 고려되었지만, 레이저의 물리적 응답 속도와 기계적 움직임의 한계 때문에 고속 대역폭 요구를 따라가기 어렵다. 그래서 현대의 많은 모듈레이터는 레이저를 계속 켜둔 상태에서, 전압을 가해 물질의 굴절률을 바꾸고, 그 결과 빛의 Phase(위상)를 바꾸는 방식을 사용한다.
이 설명은 Mach-Zehnder Interferometer와 유사한 구조로 이해할 수 있다. 레이저 빛이 두 갈래로 나뉘고, 한쪽 경로에만 전압을 가해 굴절률과 위상을 바꾼 뒤, 두 빛을 다시 합치면 Constructive Interference(보강 간섭) 또는 Destructive Interference(상쇄 간섭)가 발생한다. 그 결과 최종 출력의 세기가 1 또는 0처럼 달라지고, 이 변화를 통해 비트 정보를 표현할 수 있다.
이 방식의 장점은 매우 빠른 속도다. 물질에 전압을 걸었을 때 굴절률이 바뀌는 속도는 레이저를 직접 껐다 켜는 속도보다 훨씬 빠르기 때문에, 기가비트에서 테라비트급 대역폭으로 넘어가는 통신 요구에 더 잘 맞는다. 다만 이 구조가 제대로 작동하려면 레이저가 칩 어딘가에 있어야 하는데, 여기서 실리콘 포토닉스의 가장 어려운 제조 문제가 등장한다.
실리콘은 빛을 만들기 어렵다
실리콘은 CMOS 공정의 중심 재료이지만, 레이저를 만들기에는 좋은 재료가 아니다. 강연자는 실리콘이 Indirect Band Gap(간접 밴드갭)을 가지기 때문에 빛을 효율적으로 생성하기 어렵다고 설명한다. 따라서 실리콘 포토닉스 칩 위에 레이저를 구현하려면 Indium Phosphide(인듐 인화물) 같은 III-V 계열 반도체로 만든 레이저를 실리콘 다이 위에 붙이는 방식이 필요하다.
이 과정을 Heterogeneous Integration(이종 집적)이라고 부른다. 서로 다른 물질과 다이를 원자 단위에 가까운 정밀도로 결합해야 하므로, 기존 실리콘 공정처럼 한 재료 체계 안에서 레이어를 쌓아가는 것보다 훨씬 어렵다. 강연자는 이 결합 공정이 실리콘 포토닉스의 수율과 제조 난이도를 높이는 주요 원인 중 하나라고 말한다.
그럼에도 이 접근이 선택되는 이유는 효율 차이가 크기 때문이다. 음성 설명에 따르면 Indium Phosphide 기반 레이저와 실리콘 레이저의 효율 차이는 100배에서 1000배 수준까지 날 수 있어, 실리콘만으로 억지로 레이저를 만드는 것보다 외부에서 만든 레이저를 붙이는 편이 현실적이다. 결국 실리콘 포토닉스는 “실리콘 공정의 장점”과 “광소자 재료의 장점”을 결합하려는 기술이며, 그 결합 자체가 가장 큰 난제이기도 하다.
빛의 진짜 강점은 Multiplexing이다
포토닉스가 구리선보다 매력적인 또 하나의 이유는 Multiplexing(다중화)이다. 구리선에서 네 종류의 정보를 동시에 보내려면 일반적으로 네 개의 물리적 채널이 필요하지만, 빛은 하나의 Waveguide나 Fiber 안에 서로 다른 파장의 빛을 동시에 실어 보낼 수 있다. 쉽게 말해 다른 색깔의 빛마다 다른 정보를 담고, 수신 측에서 Demultiplexer(역다중화기)가 이를 다시 분리해 처리하는 방식이다.
이 구조는 Shoreline Density(쇼어라인 밀도) 문제와 직접 연결된다. 칩의 면적은 2차원으로 늘어나지만, 외부와 신호를 주고받는 가장자리 길이는 1차원으로만 늘어난다. 칩이 커질수록 면적 대비 가장자리 비율은 낮아지고, 결국 IO를 낼 수 있는 물리적 공간이 병목이 된다. 포토닉스는 하나의 물리 채널 안에 여러 파장의 정보를 실을 수 있으므로, 같은 가장자리 길이에서 더 높은 대역폭을 제공할 가능성이 있다.
다만 이 장점에도 조건은 있다. 파장 간격을 매우 촘촘하게 쪼갤수록 온도 변화에 민감해지고, 강연자는 0.3 nm 단위로 파장을 나눌 경우 온도가 1도만 변해도 파장이 이동해 정보가 섞일 수 있다고 설명한다. 따라서 CPO와 Optical IO의 핵심 과제 중 하나는 단순히 빛을 칩 가까이 가져오는 것이 아니라, 온도 변화 속에서도 Mux와 Demux가 안정적으로 동작하도록 패키징하고 제어하는 일이다.
흥미로운 점은 Mux와 Demux 자체가 Passive Device(수동 소자)라는 점이다. 빛을 합치고 나누는 과정에 별도의 전압이나 에너지가 크게 필요하지 않기 때문에, 잘 설계된 포토닉스 회로는 에너지 효율 측면에서 강력한 잠재력을 갖는다. 결국 포토닉스의 경쟁력은 단순한 장거리 전송 성능이 아니라, 대역폭 밀도와 에너지 효율을 동시에 끌어올릴 수 있다는 데서 나온다.
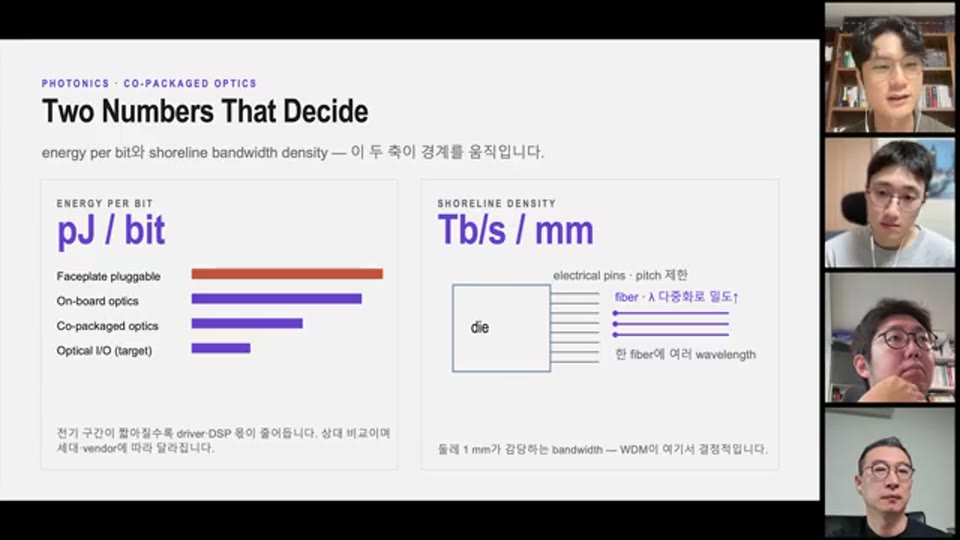
20:23 - Energy per bit와 Shoreline Density를 기준으로 한 광 IO의 장점
Inverse Design은 포토닉스 소자를 작게 만드는 열쇠다
강연의 후반부는 실리콘 포토닉스를 어떻게 더 작고 실용적으로 만들 것인가에 집중한다. 기존 포토닉스 컴포넌트는 밀리미터에서 센티미터 스케일에 이르는 경우가 많아, 나노미터급 트랜지스터가 빽빽하게 들어가는 전자 칩과 비교하면 집적도가 낮다. 빛의 파장 자체가 마이크론 스케일이기 때문에 포토닉스 소자가 트랜지스터처럼 극단적으로 작아질 수는 없지만, 그래도 현재의 컨벤셔널 디자인보다 훨씬 작게 만드는 여지는 있다.
여기서 등장하는 방법이 Inverse Design이다. 전통적인 설계는 사람이 직관적으로 형상을 만들고, 시뮬레이션을 돌려 성능을 확인한 뒤, 다시 사람이 조금씩 수정하는 방식이다. 반면 Inverse Design은 원하는 성능 목표를 먼저 정하고, 알고리즘이 그 목표를 만족하는 물리적 형상을 찾아가도록 만든다. 강연자는 이를 본질적으로 Gradient Descent(경사하강법)에 가까운 최적화 문제로 설명한다.
이 방식의 결과물은 사람이 직관적으로 이해하기 어려운 형상이 되는 경우가 많다. 실리콘 슬랩에 공기 구멍이 복잡하게 뚫린 형태가 나오고, 겉보기에는 “왜 이 모양이 빛을 잘 나누는지” 직관적으로 알기 어렵다. 그러나 시뮬레이션과 최적화가 목표 함수에 맞춰 찾은 구조이기 때문에, 기존 밀리미터 스케일의 Mux, Demux, Power Splitter를 마이크론 스케일로 줄일 가능성을 제공한다.
강연자는 이 축소 폭을 50배에서 1000배 수준까지 언급한다. 이 숫자는 영상 음성에서 설명된 연구 맥락상의 표현이며, 특정 제품 스펙으로 확정하기보다는 Inverse Design이 제공하는 잠재적 압축 효과로 이해하는 것이 적절하다. 중요한 것은 이 접근이 Shoreline Density를 개선하고, 같은 칩 가장자리에서 훨씬 더 많은 광 채널을 배치할 수 있는 방향을 연다는 점이다.
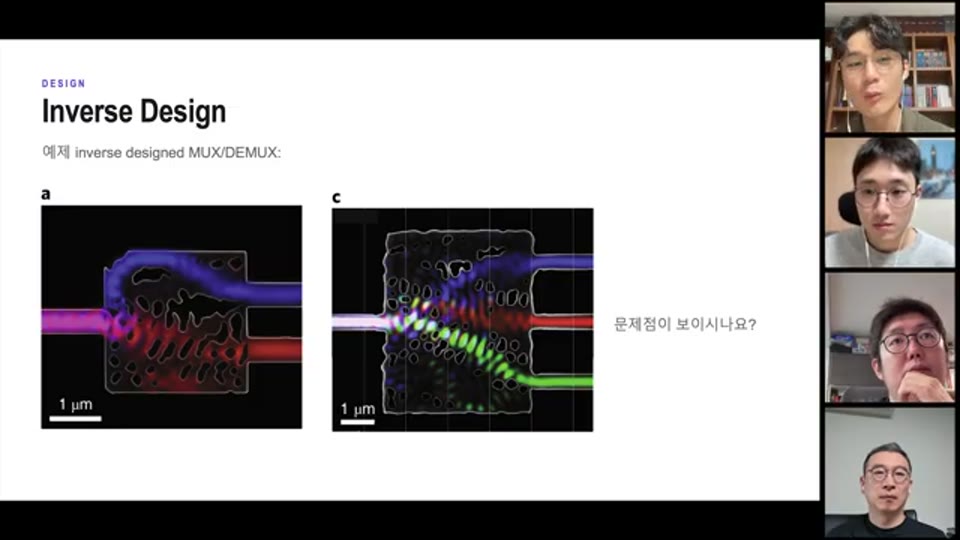
41:05 - Inverse Design으로 포토닉스 컴포넌트를 마이크론 스케일로 줄이는 예시
AI for Science가 포토닉스 설계 루프를 바꾼다
김태한 연구자는 이 문제를 Protein Design(단백질 설계)과 연결해 바라본다. 단백질 분야에서도 과거에는 과학자가 기존 구조를 보고, 시뮬레이션하고, 조금씩 수정하면서 반복적으로 설계했다. 그러나 최근 AI for Science 접근에서는 원하는 기능을 정하고, 뼈대 구조를 만들고, 중요한 부위를 정교하게 다듬고, 결과를 다시 피드백 루프에 넣는 방식이 부상했다. 강연자는 이 사고방식을 포토닉스에도 적용할 수 있다고 본다.
기존 Inverse Design 파이프라인에서는 여러 후보를 만든 뒤 실제 제작 또는 시뮬레이션 결과가 좋지 않은 디자인은 버리는 경우가 많다고 한다. 예를 들어 열 개의 후보 중 여덟 개가 나쁘고 두 개만 좋다면, 기존 접근은 좋은 두 개만 가져가고 나머지 여덟 개의 정보는 충분히 재사용하지 않는다. 그러나 연구자들은 좋은 디자인과 나쁜 디자인 모두를 라벨링하고, 이 정보를 모델의 피드백 루프에 넣으면 설계 탐색의 효율을 크게 높일 수 있다고 본다.
이때 사용한 모델은 Conditional Variational Autoencoder(CVAE)다. CVAE는 좋은 포토닉스 디자인들의 분포를 학습하고, 특정 파장이나 Demux 스펙 같은 조건을 입력받아 새로운 디자인의 “시작점”을 빠르게 생성할 수 있다. 강연자는 기존에는 하나의 디자인을 만들기 위해 시뮬레이션을 몇 시간씩 반복해야 했다면, 학습된 모델은 이론상 1초에 만 개의 디자인 시드를 뽑을 수 있다고 설명한다.
이 접근의 가치는 속도만이 아니다. 좋은 디자인과 제조 친화적인 디자인을 학습 데이터로 넣으면, 모델이 만들어내는 초기 형상도 더 Fabrication Friendly한 방향으로 편향될 수 있다. 따라서 CVAE는 최종 설계를 직접 완성하는 만능 도구라기보다, 느리고 비싼 물리 시뮬레이션이 출발할 좋은 초기 조건을 제공하는 가속 장치로 이해하는 편이 정확하다.
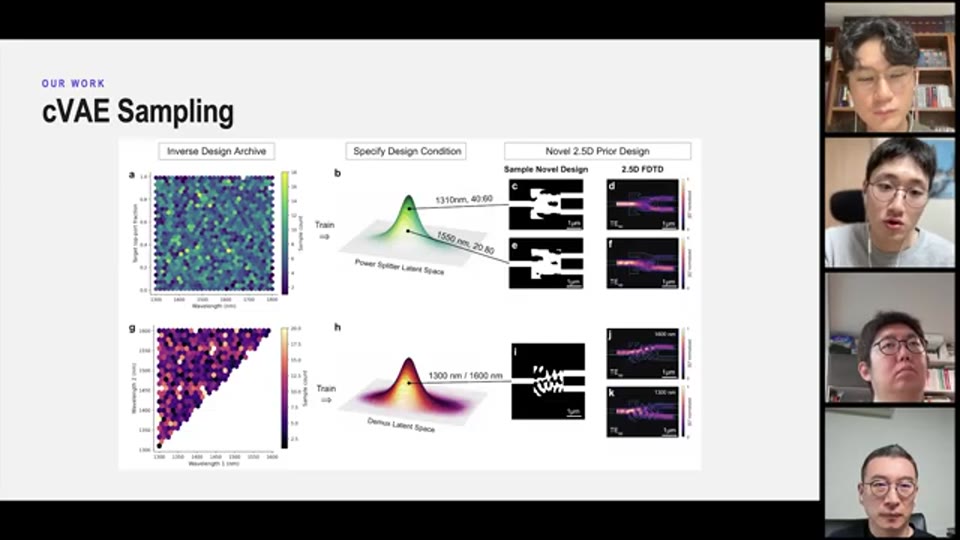
57:39 - CVAE 기반 디자인 시드가 빠른 수렴과 제조 친화적 형상을 만든다는 결과
제조 가능성은 별도의 최적화 대상이다
포토닉스 설계에서 좋은 시뮬레이션 결과가 곧 좋은 제품을 의미하지는 않는다. 실제 Fabrication(제조)에서는 설계한 구멍과 구조가 100% 동일하게 만들어지지 않기 때문이다. 강연자는 미시간대학교 Fab에서 사용하는 장비가 20 nm 수준까지 패턴을 낼 수 있다고 하더라도, 실제로는 20 nm 구멍이 25 nm처럼 찍히거나 15 nm처럼 달라질 수 있다고 설명한다. 포토닉스 소자는 빛의 간섭과 위상 변화에 민감하기 때문에 이런 작은 편차도 성능 저하로 이어질 수 있다.
연구자들은 이를 위해 Manufacturability Index(제조 가능성 지표)를 정의했다. 강연에서는 이를 sqrt(A) / P 형태로 설명하는데, 여기서 A는 실리콘 영역의 면적이고 P는 실리콘 섬과 조각들의 둘레를 뜻한다. 조각이 잘게 흩어지고 섬처럼 분리될수록 둘레가 커지므로, 같은 면적이라도 P가 커지면 제조 가능성이 낮다고 해석할 수 있다. 이 지표는 연구자들이 임의로 정의한 것이지만, 복잡하고 깨지기 쉬운 형상보다 덩어리감 있는 형상이 제조에 유리하다는 직관을 수치화하려는 시도다.
실제 제조 공정은 “쌓아 올린다”기보다 “깎아낸다”에 가깝게 설명된다. 실리콘 웨이퍼와 산화층 위에 실리콘을 증착하고, Photoresist(포토레지스트)를 올린 뒤, Electron Beam Lithography(EBL)로 패턴을 그린다. 이후 Etching(식각)을 통해 원하지 않는 부분을 깎아내면 설계한 포토닉스 구조가 남는다. 이 과정은 복잡한 다층 반도체 회로를 계속 쌓아가는 방식과 달리 상대적으로 단순한 단일 패턴 식각에 가깝지만, 마이크론과 나노미터 단위의 작은 오차가 성능에 큰 영향을 줄 수 있다는 점에서 어렵다.
Integrated Gradients는 어디를 잘 만들어야 하는지 알려준다
설계와 제조 사이의 간극을 줄이기 위해 연구자들이 사용한 또 하나의 방법은 Integrated Gradients다. 이 기법은 딥러닝 모델의 Interpretability(해석 가능성)를 높이기 위해 쓰이던 방법으로, 어떤 입력 위치가 최종 출력에 얼마나 중요한 영향을 미쳤는지를 추적한다. 강연에서는 이를 포토닉스 구조에 적용해, 복잡한 소자 안에서 어떤 픽셀 또는 영역이 Figure of Merit(성능 지표)에 중요한지 찾는 방식으로 설명한다.
이 접근은 제조 현장에서 매우 실용적인 의미를 가진다. 모든 영역을 완벽하게 만들 수 없다면, 적어도 성능에 결정적인 영역은 더 정밀하게 관리해야 한다. Integrated Gradients로 빨간색 핫스팟이 표시된다면, 그 부분은 빛의 주파수를 나누는 데 중요한 역할을 하므로 Fabrication 과정에서 특별히 신경 써야 할 대상이 된다. 이는 설계자가 이해하기 어려운 Inverse Design 결과물에 대해 “어디가 중요한가”라는 해석 가능성을 부여한다.
연구자들은 실제로 미시간대학교 Fab에서 제작한 D-Mux의 전자현미경 이미지 위에 Integrated Gradients로 찾은 중요 픽셀을 오버레이했다고 설명한다. 이어 중요한 영역과 중요하지 않은 영역에 각각 Perturbation(교란)을 주었을 때, 중요한 영역을 건드린 경우 디바이스 성능이 더 크게 떨어지는 것을 실험적으로 확인했다고 말한다. 이 결과는 Integrated Gradients가 단순한 시각화가 아니라, 제조 검사와 품질 관리(QC)의 우선순위를 정하는 데 쓰일 수 있음을 시사한다.
이 아이디어가 확장되면 웨이퍼 전체를 무차별적으로 검사하는 방식보다 더 효율적인 검사 전략을 만들 수 있다. 모든 픽셀을 같은 비용으로 검사하는 대신, 성능에 중요한 영역을 더 집중적으로 확인하면 검사 시간과 비용을 줄이면서도 결과의 신뢰도를 높일 수 있다. 강연자는 이러한 Data-driven Feedback Loop가 제대로 작동하면 포토닉스 공정의 상용화 속도가 빨라질 수 있다고 본다.
💡 [영상 참조] 강연자는 이 구간에서 실제 제작된 D-Mux 전자현미경 이미지 위에 Integrated Gradients 핫스팟을 겹쳐 보여주며 설명합니다.
📺 원본 영상에서 확인하세요.
산업적 함의 - NVIDIA, Marvell, 그리고 수직 통합 경쟁
강연에서는 포토닉스가 더 이상 학술적 흥미에만 머물지 않고 산업 전략의 일부가 되고 있다는 점도 강조된다. Marvell은 Celestial AI와 Polariton 같은 포토닉스 관련 기업과의 협력 또는 관련 생태계 사례로 언급되고, NVIDIA는 Lumentum과 Coherent 같은 광통신 관련 기업에 투자한 것으로 소개된다. 음성 기준으로 각각의 금액과 시점은 강연자의 설명에 의존하므로, 구체적 투자 규모는 원본 영상과 별도 공시를 함께 확인하는 것이 안전하다.
이 흐름의 핵심은 수직 통합이다. AI 데이터센터에서 네트워크와 인터커넥트가 병목이 되면, GPU 기업이나 네트워킹 기업은 단순히 칩만 잘 만드는 것으로 충분하지 않다. 광 모듈, 패키징, 제조 라인, 공급망을 미리 확보해야 다음 세대 시스템에서 병목을 통제할 수 있다. 강연자가 Jensen Huang의 발언을 언급하며 “먼저 Manufacturing 라인을 먹어버리겠다”는 취지로 해석한 것도 같은 맥락이다.
다만 CPO나 Optical IO가 즉시 모든 구리 연결을 대체한다고 보기는 어렵다. 구리선은 여전히 싸고, 짧은 거리에서 효율적이며, 고장이 났을 때 교체하기 쉽다. 반대로 패키지 안으로 들어간 광소자는 고장이 나면 모듈만 뽑아 바꾸기 어렵고, ASIC에서 발생하는 열의 영향을 직접 받으며, 제조 수율 리스크도 커진다. 따라서 산업의 실제 전환은 성능과 비용의 균형이 맞는 구간부터 단계적으로 진행될 가능성이 높다.
실리콘 포토닉스는 작은 분야이지만 큰 병목을 겨냥한다
흥미로운 점은 이처럼 중요한 분야임에도, 실리콘 포토닉스를 깊게 연구하는 인력과 연구실이 많지 않다는 것이다. 강연자는 한국에서 전문 연구실이 열 손가락 안에 들 정도이고, 미국에서도 많아야 30개 정도로 알고 있다고 말한다. 특히 Wet Lab과 Fabrication까지 함께 다루면서 AI/ML 방법론을 포토닉스 설계 프레임워크에 적용하는 연구는 더 드물다고 설명한다.
이 희소성은 위험이면서 기회다. 한편으로는 공정, 광학, 전자공학, 머신러닝을 모두 이해해야 하므로 진입 장벽이 높다. 다른 한편으로는 도메인 간 연결을 할 수 있는 연구자에게는 아직 발굴되지 않은 Low-hanging Fruit가 많을 수 있다. 김태한 연구자가 Protein Design에서 얻은 발상을 포토닉스에 가져오고, 박준호 연구자가 Fabrication 현장의 문제를 AI 설계 루프와 연결한 것이 바로 그런 예다.
노정석 진행자는 이 대목에서 최근 과학 연구와 상업화 사이의 시간 간격이 크게 줄어들고 있다고 해석한다. 과거에는 물리학 연구가 산업화되기까지 10년에서 20년이 걸린다는 인식이 있었지만, AI 모델과 시뮬레이션 기반 탐색이 결합되면서 그 간격이 4~5년 수준으로 압축될 수 있다는 것이다. 특히 Maxwell Equation Solver(맥스웰 방정식 솔버)가 포토닉스 시뮬레이션에서 매우 정확한 Verifier 역할을 할 수 있다면, AI가 설계하고 시뮬레이터가 검증하며 Fab이 피드백을 주는 루프는 다른 과학 분야보다 빠르게 돌 가능성이 있다.
다음 단계 - Agent가 광회로를 설계하는 세계
마지막 부분에서 연구자들은 CVAE와 Integrated Gradients를 넘어, Agent 기반 Photonic Integrated Circuit(광집적회로) 설계 가능성을 언급한다. 현재는 사람이 문제를 정의하고, CVAE를 통해 좋은 초기 구조를 만들고, Integrated Gradients로 중요한 영역을 해석하는 방식이라면, 다음 단계는 이런 도구들을 Agent에게 제공해 회로 설계 자체를 맡기는 방향이다. 이는 단순히 하나의 소자를 최적화하는 수준을 넘어, 여러 포토닉스 컴포넌트가 연결된 회로 전체를 탐색하는 문제로 확장된다.
이 관점에서 AI의 역할은 발명가라기보다 대규모 Search Engine에 가깝다. 인간은 어떤 문제가 중요한지, 어떤 제약이 현실적인지, 어떤 성능 지표를 최적화해야 하는지 정의하고, AI는 그 정의된 공간 안에서 사람이 직접 탐색하기 어려운 조합을 빠르게 찾아낸다. 강연자는 이를 “Unknown Unknown Sector”를 Compute로 탐색하는 방식으로 해석하며, 현대 연구와 제품 개발의 기본 방법론이 점점 이렇게 바뀌고 있다고 말한다.
따라서 이 에피소드의 메시지는 실리콘 포토닉스 자체에만 국한되지 않는다. AI 시대의 기술 병목은 도메인 전문가와 AI 연구자가 함께 문제를 재정의할 때 빠르게 풀릴 수 있다는 점이 더 큰 주제다. 칩 간 통신이라는 물리적 병목을 해결하려면 광학과 반도체 공정을 알아야 하고, 그 광학 회로를 현실적으로 설계하려면 머신러닝과 최적화의 언어가 필요하다. 이 두 언어가 만나는 지점에서 AI 데이터센터의 다음 세대 인프라가 만들어질 가능성이 있다.
마무리 / 핵심 정리
이번 강연은 AI 데이터센터의 병목이 Compute와 Memory를 넘어 Interconnect로 이동하고 있음을 분명히 보여준다. 모델이 커지고 GPU 클러스터가 거대해질수록, 장치 사이의 데이터 이동은 단순한 배선 문제가 아니라 전체 시스템 성능과 전력 효율을 결정하는 핵심 인프라 문제가 된다. 구리선은 짧은 거리에서 여전히 유효하지만, 대역폭 요구와 거리 증가가 겹치는 구간에서는 광통신의 에너지 효율과 대역폭 밀도가 강력한 대안으로 떠오른다.
실리콘 포토닉스의 난점은 기술 방향이 아니라 구현이다. 레이저 통합, CPO와 Optical IO의 패키징, 열 관리, 서비스성, 제조 수율은 모두 해결해야 할 현실적 제약이다. 그러나 Inverse Design, CVAE, Integrated Gradients처럼 AI for Science에서 검증된 방법론이 포토닉스 설계와 제조 피드백 루프에 들어오면, 기존보다 훨씬 빠르게 설계 후보를 만들고, 중요한 제조 영역을 식별하며, 상용화 가능성을 높일 수 있다.
결국 이 에피소드의 핵심은 “칩과 칩을 빛으로 연결한다”는 기술적 문장보다 더 넓다. AI가 만들어낸 수요가 새로운 하드웨어 병목을 드러내고, 그 병목을 다시 AI 기반 설계 방법론이 해결하려는 순환 구조가 형성되고 있다. 실리콘 포토닉스는 AI 데이터센터의 다음 병목을 겨냥하는 기술이면서, 동시에 도메인 지식과 머신러닝이 결합될 때 연구 속도가 어떻게 바뀌는지를 보여주는 대표적인 사례다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | EP 108. 칩과 칩을 빛으로 연결한다: 실리콘 포토닉스와 AI 데이터센터의 다음 병목 |
| 채널 | AI Frontier Korea (노정석) |
| 영상 길이 | 약 84분 51초 |
| 리포트 작성 | 2026-08-09 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.