EP 94. Claude Opus 4.7 과 낮게 열린 과실들
📺 원본 영상: EP 94. Claude Opus 4.7 과 낮게 열린 과실들 🎙️ 채널: 노정석 📅 정리 일자: 2026-04-22 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
2026년 4월 19일 녹화된 이 에피소드는 2주간의 공백 동안 쏟아진 AI 업계의 주요 이슈들을 총정리한다. Claude Opus 4.7의 출시, 공개가 보류된 Anthropic의 초대형 모델 ‘미소스(가칭)’, Claude Design의 등장이 야기하는 생태계 지각변동, 그리고 AI 시대에 개인과 기업이 어떤 방향으로 ‘도망’해야 하는가에 대한 두 가지 전략적 프레임이 심층적으로 다루어진다. 강연자는 이 모든 흐름의 본질을 “캐퍼빌리티 오버행(Capability Overhang)”, 즉 모델이 이미 가진 과잉 능력을 누가 먼저 어디에 잘 꺼내 쓰느냐의 경쟁으로 정의한다.
1. AI 모델 출시 주기 — 매 70일의 지진
Claude 모델들의 출시 간격을 시각화한 데이터는 흥미로운 패턴을 드러낸다. Opus 4.0이 5월 22일, Opus 4.1이 8월 5일, Opus 4.5가 11월, Opus 4.6이 2월 5일에 출시되었고, 이번 Opus 4.7로 이어지는 흐름을 평균 내면 약 70일 간격마다 새 모델이 등장하고 있다. 이 간격을 기준으로 보면 다음 모델은 6월 말에서 7월 초 즈음 출시될 것으로 예측된다.
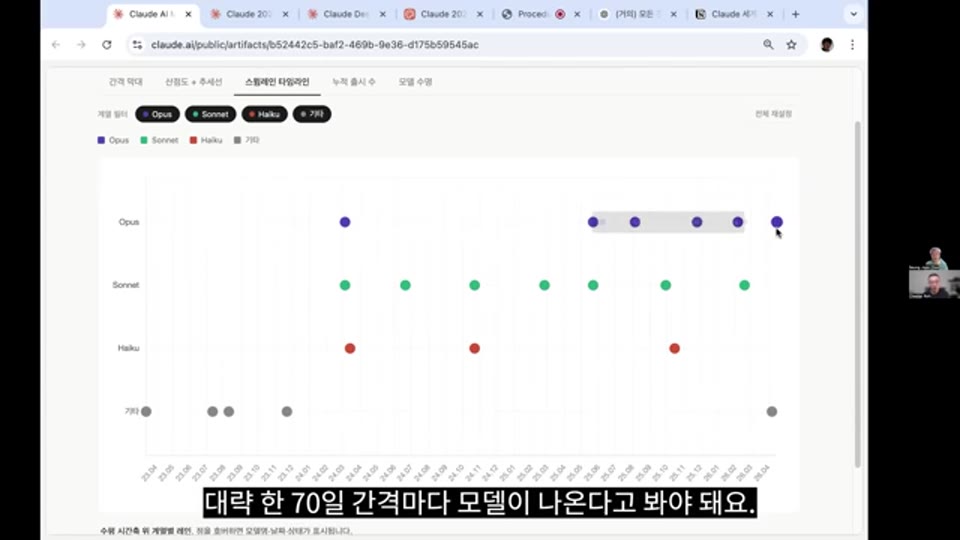
02:44 - Claude Opus 모델 출시 일자(4.0 ~ 4.7) 및 약 70일 출시 간격을 보여주는 시각화 차트
더욱 주목할 만한 것은 모델 계층별 트렌드다. Sonnet과 Haiku의 출시 간격은 점차 늘어나는 반면 Opus의 간격은 반대로 좁아지고 있다. 이는 시장 수요가 최고 성능 모델로 집중되고 있다는 신호로 해석된다. “원래 고급 모델은 조금 쓰고 Sonnet 같은 걸 작업에 많이 쓰는 형태가 될 줄 알았는데, 사람들은 항상 최고의 모델을 좋아한다”는 것이 강연자의 관찰이다. Sonnet, Haiku 계열이 ‘미소스(가칭)‘라는 새 티어의 등장으로 위로 한 칸씩 밀려올라가면서 이 현상이 더욱 뚜렷해질 가능성이 있다.
이 패턴에는 실무적 함의가 따른다. 70일마다 새 모델이 나올 때마다 하네스(Harness) 조정, 프롬프트 재검토, 기존 파이프라인 리팩터링 작업이 수반된다. 혁신의 가속이 곧 유지보수의 가속으로 전환되는 구조이며, 강연자는 이를 두고 “한 달이 1년 같은 세상, 2주라면 반년의 임팩트”라고 표현했다.
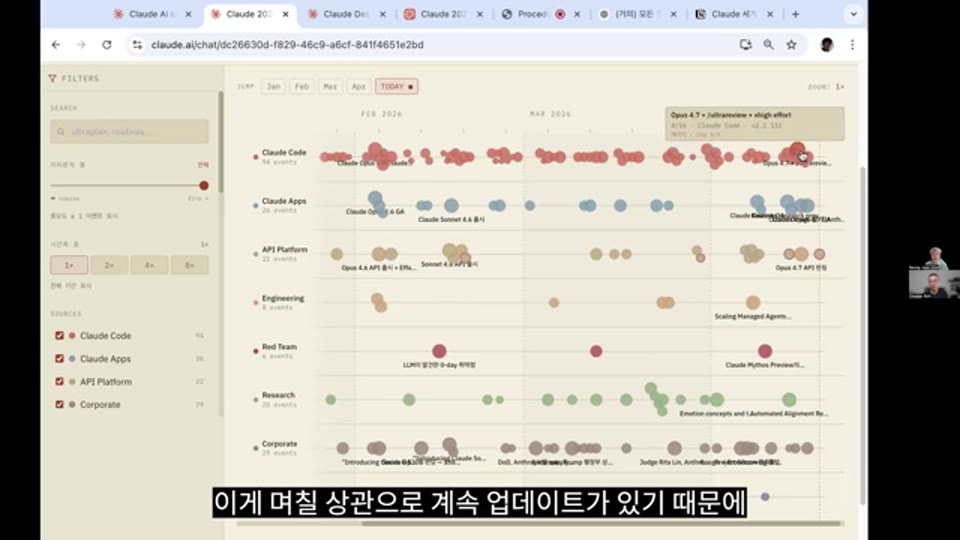
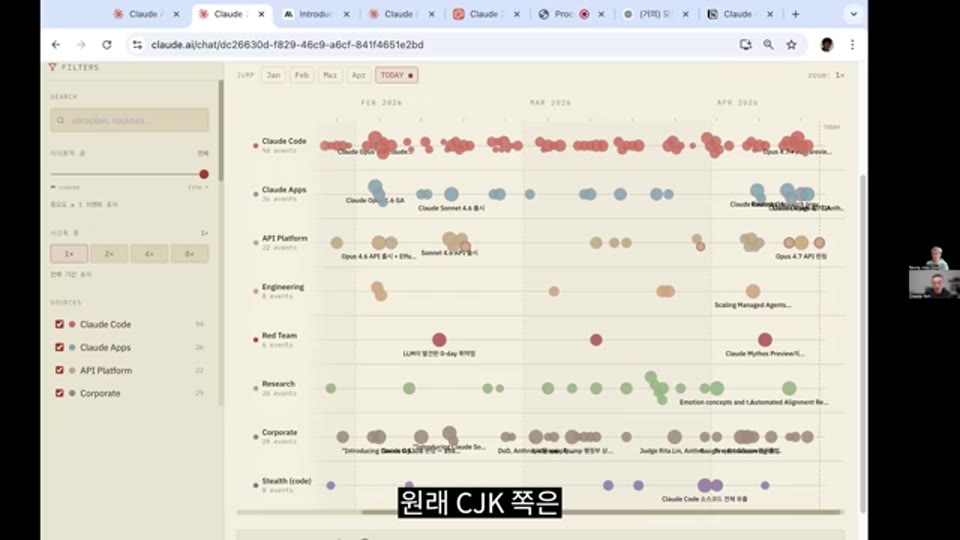
04:59 - 2026년 1분기 Anthropic 관련 주요 이벤트를 고밀도로 시각화한 타임라인 차트
2. 미소스(가칭) — 공개를 보류한 Anthropic의 최대 모델
Anthropic이 사이버 보안 능력을 이유로 정식 출시를 유보하고 있는 ‘미소스(가칭)‘는 약 10조(10 Trillion) 개 파라미터를 가진 것으로 알려져 있다. 인간의 뇌는 약 1,000억(100 Billion) 개 뉴런에 이론상 최대 100조 개의 시냅스 연결이 가능한데, 미소스는 그 이론적 최대치의 10분의 1에 해당하는 규모다. 현재 약 50개 기관에만 얼리 액세스(Early Access)가 제공되고 있다.
이 모델이 공개되지 않는 이유에 대해서는 두 가지 시각이 존재한다. 하나는 Anthropic이 주장하는 사이버 보안 능력에 대한 진정한 우려이고, 다른 하나는 GPU 인프라 부족이라는 현실적 제약이다. 강연자는 Google, OpenAI, Anthropic 3사 중 Anthropic의 GPU 확보량이 상대적으로 가장 부족하며, 이로 인해 서빙 자체가 어렵다는 시각도 소개했다. AWS의 Trainium이나 Google TPU 방향으로 인프라 전략을 전환하고 있다는 정황도 언급되었는데, 이는 하드웨어 리드 타임(2~3년)과 소프트웨어 출시 주기(60~70일)의 미스매치에서 비롯된 전략적 선택으로 해석된다.
보안 연구자 Nicolas Carlini의 발언도 주목된다. 그는 미소스의 사이버 보안 능력이 “완전히 다른 차원의 무언가가 아니라 코딩을 잘 하는 모델로 가다 보니 자연스럽게 제로데이(Zero-day)를 찾을 정도의 능력이 생겼다”는 뉘앙스로 이야기했다. 강연자는 30년 전 해커 경험을 근거로 이를 설명했다. 해킹의 본질은 수많은 노드들 사이의 연결에서 탄생하는 취약점을 발견하는 것이고, 이는 단품 지식이 아니라 서로 다른 영역의 지식이 결합될 때 발생하는 창발적(Emergent) 현상에 대한 암묵지를 요구한다. 인간은 정수론과 위상수학처럼 같은 수학 안에서도 멀리 떨어진 분야를 동시에 깊이 다루기 어렵지만, 모델은 삼라만상(森羅萬象)의 지식을 연결해낼 수 있는 상태가 된 것이다.
마케팅적 관점에서 강연자는 이를 “IPO 맥시밍”이라는 표현으로도 해석했다. 출시 불가 모델에 대한 신비감을 조성하면서 4.7을 내놓는 방식이 기업 가치 제고 측면에서 유리하게 작용할 수 있다는 것이다.
3. Claude Opus 4.7의 기술적 특징 — 토크나이저 변경과 비용 인상
토크나이저(Tokenizer) 교체의 기술적 의미
Claude 4.7의 가장 주목할 만한 기술적 변화는 토크나이저의 교체다. 어휘(Vocabulary) 크기가 줄어들었는데, 역설적으로 이는 동일한 텍스트를 표현하는 데 더 많은 토큰이 필요해짐을 의미한다. 예컨대 이전 모델에서 두 토큰으로 처리되던 단어가 세 토큰으로 분리되는 방식이다.
이 변화가 모델 아키텍처에 미치는 영향과 관련해 강연자는 BPE(Byte Pair Encoding) 특성을 근거로 흥미로운 분석을 제시했다. 어휘 크기가 줄어드는 방향의 토크나이저 변경은 기존 단어가 더 잘게 쪼개지는 것인데, 그렇게 나뉜 서브워드(Subword)들은 이미 이전 모델의 임베딩 공간에 존재했을 가능성이 높다. 따라서 LLM 헤드(Head)나 내부 레이어의 전면 교체 없이 앞뒤 임베딩 레이어만 조정하면 되는 구조여서, 프롬 스크래치(From Scratch) 학습이 아닌 컨티뉴얼 프리 트레이닝(Continual Pre-Training, CPT) 방식으로 4.7이 만들어졌을 가능성이 높다.
실용적 영향은 분명하다. 커뮤니티에서 수행된 통계 분석에 따르면, 영어(라틴 계열)와 코드에서 토큰 수가 약 1.3~1.4배 증가했다. CJK(중국어·일본어·한국어) 계열 언어는 거의 변화가 없었다. Claude Code를 업무에 주로 활용하는 개발자에게는 사실상 비용이 1.3~1.4배 인상된 셈이다.
26:42 - CJK 언어 vs 영어/코드 언어별 Claude 4.7 토큰 증가율 통계 분석 데이터
어댑티브 씽킹(Adaptive Thinking)과 트래픽 전략
4.7에서 도입된 또 다른 변화는 모델이 씽킹(Thinking) 여부를 자율적으로 판단하는 어댑티브 씽킹이다. 4.6까지는 추론 모드를 고정할 수 있었지만, 이제는 GPT-5 방식처럼 모델이 상황의 복잡도에 따라 추론 사용 여부를 결정한다. 강연자는 이를 트래픽 부담 분산 전략으로 해석했다. 문제는 웹 인터페이스에서 씽킹을 강제 활성화하기 어려워졌다는 점으로, 실험 결과 “세차장까지 100피트 거리를 차로 갈 것인가 걸어갈 것인가” 같은 상황 판단 문제에서 씽킹 없이 응답하면 “걸어가야 한다”고 답하지만 씽킹을 프롬프트로 강제하면 “차를 가져가야 한다”는 식의 차이가 관찰되었다. API나 Claude Code를 사용하는 파워 유저와 웹 인터페이스를 사용하는 일반 사용자 간의 경험 격차가 사실상 Anthropic의 자원 배분 정책으로 만들어지는 상황이 된 것이다.
4. Knowledge Distillation — Anthropic 모델 훈련 전략에 대한 추론
커뮤니티에서는 Claude 4.7의 토크나이저 변경과 시스템 카드(Model Card)에 미소스가 언급된 점을 근거로 “미소스로부터 Knowledge Distillation(KD)이 이루어진 것 아니냐”는 분석이 제기되었다. 강연자는 이와 관련해 KD의 주요 방법론 세 단계를 설명했다.
가장 기본적인 오프-폴리시(Off-policy) 증류는 교사 모델(Teacher Model)이 학습 데이터에 대해 정답지를 작성하면, 그 정답지를 원-핫(One-hot) 레이블로 삼아 작은 학생 모델(Student Model)을 지도 학습 방식으로 훈련시키는 것이다. 그 다음 단계인 로짓(Logit) 분포 기반 증류는 단일 정답 단어만 레이블로 쓰는 대신, 교사 모델이 각 위치에서 계산한 로그 확률(Log Probability) 분포 전체(보통 Top-50~100)를 학습 신호로 활용한다. 온도(Temperature)를 높여 모델이 분기할 수 있는 후보 단어들의 확률 분포를 학생 모델에게 전수함으로써 훨씬 풍부한 정보 이전이 가능하다.
세 번째이자 가장 발전된 방식인 온-폴리시(On-policy) 훈련은 학생 모델이 직접 텍스트를 생성하게 한 뒤, 같은 프롬프트에 대해 교사 모델이 실시간으로 확률 값을 비교하면서 학생이 틀린 부분에 강한 피드백 신호를 주는 방식이다. 이를 통해 학생 모델이 아직 보지 못한 분포에도 적응할 수 있게 되는데, 마치 인스트럭션 파인튜닝(Instruction Fine-tuning)을 거친 것처럼 범용성이 높아진다.
강연자는 4.7 시스템 카드에서 미소스가 “오딧(Audit)에 참여”한 형태로 언급된 점을 근거로 세 번째 온-폴리시 방식이 활용되었을 가능성을 시사했다. 또한 신정류 대표의 분석을 인용하며, Anthropic이 Opus/Sonnet/Haiku 각자의 베이스 모델을 별도로 훈련하는 방식에서 벗어나 하나의 큰 베이스 모델(미소스)로부터 KD를 통해 세 가지 크기의 모델을 생산하는 통합 파이프라인으로 전환했을 가능성을 제기했다. 4.7의 트레이닝 날리지 컷오프(Training Knowledge Cutoff)가 올해 1월로 매우 최근인 점, 그리고 미소스의 내부 사용이 2월 24일에 시작되었다는 점이 이 타임라인 추론을 뒷받침한다.
5. Claude Design — 프론트엔드 생태계의 지각변동
Claude 4.7 출시 이후 커뮤니티에서 더 큰 화제를 모은 것은 Claude Design의 등장이었다. 이 제품은 AI 기반 UI 생성을 넘어 Figma 스타일의 에셋 관리, 실시간 CSS 편집, 그리고 인터랙티브 HTML 애니메이션 생성 기능을 통합한 플랫폼으로 소개되었다. 강연자에 따르면 Claude Design의 인트로 영상 자체도 동영상이 아닌 실시간 HTML 애니메이션으로 구현되어 있으며, 기존에 Remotion이라는 회사가 비슷한 일을 하고 있었다.
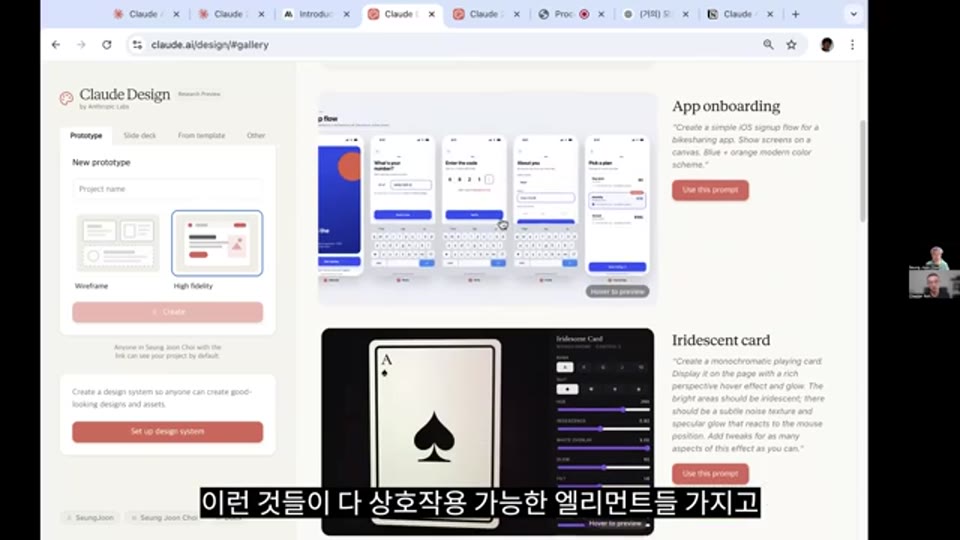
38:54 - Claude Design 인터페이스 및 실시간 인터랙티브 HTML 애니메이션 생성 데모 화면
이 제품의 등장은 ‘딸깍 현상’, 즉 Anthropic의 내부 제품 한 번으로 외부 스타트업의 존재 이유가 사라지는 패턴의 반복이다. Pencil 같은 AI 디자인 도구 스타트업들이 별도 인수 없이도 흡수되는 형태다. Figma 주가가 약 7% 하락했다는 언급도 있었다. 강연자는 이를 3체 문제의 비유로 설명했다. “밖에 나와서 무언가 목적물인 이런 거다, 최종 산출물의 오브젝티브(Objective)를 딱 찍어줄 수 있는 무언가가 더 상향의 인텔리전스의 타겟팅이 되면, 걔는 그냥 바로 딸깍 당하는 거죠.”
Claude Design이 가능해진 기술적 배경도 짚었다. 최근 Claude Code 앱과 Codex(OpenAI) 앱 모두 업데이트에서 **인앱 브라우저(In-App Browser)**가 탑재되었다. 이제 웹 형태의 산출물을 외부 브라우저 없이 앱 내에서 바로 인스펙트(Inspect)하고 캡처하여 모델에게 피드백할 수 있다. UI 생성 → 렌더링 확인 → 피드백 → 재생성의 루프가 모델 내부에서 완결되면서, 프론트엔드 생성 품질이 임계점을 넘은 것이다. 강연자는 “이게 된 다음에 Claude Design 같은 제품이 나온 것”이라며 인과 관계를 명확히 했다.
6. Scaled Managed Agents — 뇌와 손의 분리
4월 중순 Anthropic이 발표한 Scaled Managed Agents는 에이전트 인프라를 체계적으로 모듈화하는 시도다. 핵심 개념은 모델의 연산 코어(뇌)와 실행 레이어(손)를 명확히 디커플링(Decoupling)하는 것이다. 메모리(Storage), 샌드박스 코드 실행 환경(Tools), 그리고 모델 자체가 각각 독립된 레이어로 구성되며, API 키나 크레덴셜 같은 중요 시크릿이 모델에 직접 노출되지 않도록 격리된다.
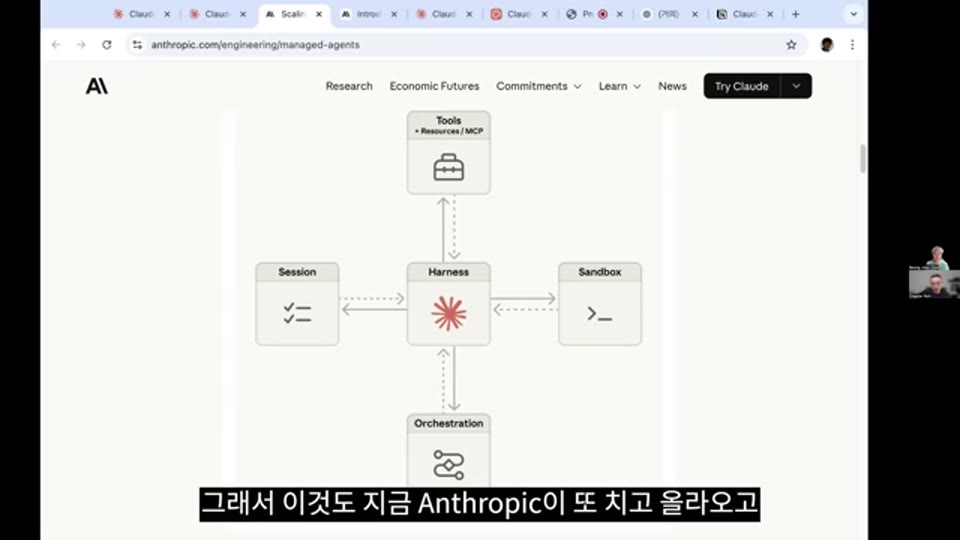
28:15 - Scaled Managed Agents 아키텍처 다이어그램 (뇌-손 분리 구조)
강연자는 이를 “매니지드 C# 위의 C++“이나 “매니지드 쿠버네티스(Kubernetes)“처럼 하위 레이어의 복잡성을 추상화하는 접근으로 해석했다. 세션 연속성과 장기 스토리지 관리 기능도 포함되어 모델이 작업 중 생성한 결과물을 장기 세션에 걸쳐 주요 자산으로 관리하는 접근법도 담겨 있다. Amazon S3의 새로운 기능과 연계되는 흐름도 언급되었다.
강연자는 “하네스(Harness)의 존재는 반드시 필요해질 것 같고, 이 영역이 프론티어 모델을 직접 개발하지 않는 우리들이 고객과 프론티어 모델 사이에서 유일하게 남아 있는 영역인 것 같다”고 평가했다. 개인적으로는 이 위에서 직접 개발하기보다 오픈소스 에이전트 프레임워크를 포크(Fork)하는 방식이 더 빠르다는 의견도 덧붙였다.
7. Automated Alignment Researcher — 스스로 정렬을 연구하는 AI
4월 14일 발표된 Automated Alignment Researcher 논문은 AI가 자신의 얼라인먼트(Alignment) 문제를 스스로 연구하는 시스템을 다룬다. 저자 목록 마지막에는 OpenAI 출신으로 Ilya Sutskever와 함께 SSI(Safe Superintelligence Inc.)를 공동 창업한 Jan Leike가 포함되어 있다.
이 연구가 다루는 핵심 질문은 “위크 모델(Weak Model)이 어떻게 강한 모델을 가이드할 수 있는가”이다. 힐 클라이밍(Hill Climbing) 방식만으로는 취향과 다양성에 관련된 문제를 자동으로 해결하기 어려우며, 여전히 인간의 가이드가 필요하다는 결론을 도출한다. Anthropic이 그간 발표해온 컨트라스티브 방법(Contrastive Method) 기반의 페르소나 벡터(Persona Vector), 컨셉 벡터(Concept Vector), 그리고 최근의 펑셔널 이모션(Functional Emotion) 개념이 이 연구에 녹아들었다고 강연자는 분석했다. Anthropic은 펑셔널 이모션을 인간 감정과 명확히 구분하는 표현을 사용하고 있는데, 강연자는 감정 관련 벡터가 모델 내 특정 영역에 집중되지 않고 여기저기 분산되어 있는 것을 보고 “이모션도 프로그램이구나”라는 생각이 들었다고 말했다.
“위크 모델”이라는 표현은 단순히 작은 AI 모델의 비유가 아니라 미래에 인간 자신이 처하게 될 위치, 즉 초지능 대비 상대적으로 약한 존재로서의 인간을 가리킨다. 강연자는 인간이 더 이상 검증자(Verifier)로 개입할 수 없는 지점이 오면 어떻게 정렬을 유지할 것인가라는 근본적 문제를 제기했다. 알파고의 37수가 처음에 전문가들도 이해하기 어려웠던 것처럼, 모델로부터 인간이 이해하기 어려운 연구가 나오기 시작할 때를 대비하는 것이 이 연구의 목적이라는 것이다.
8. 기업 전략 비교 — Anthropic, OpenAI, Google의 세 갈래 길
현재 AI 패권 경쟁에서 세 기업은 뚜렷이 다른 전략적 방향을 걷고 있다.
Anthropic은 텍스트와 코딩에 집중하며 B2B 유즈케이스 위에 애플리케이션을 스택처럼 쌓아가는 전략을 취하고 있다. Claude Code를 코딩 에이전트의 사실상 표준으로 자리잡게 한 것이 대표적이며, 이번 Claude Design도 같은 맥락에서 프론트엔드 생성 시장으로의 확장이다. Dario Amodei는 경쟁사 대비 약 6~10개월 앞서 있지만 따라잡힐 것이라고 이야기하기도 했다.
OpenAI는 코딩 에이전트 레이스에 뒤늦게 합류했지만 빠르게 추격하고 있다. GPT-5.5(코드명 Spur)가 미소스급 모델이라는 소문이 돌고 있으나 확인되지는 않았다. 경쟁사 대비 사용량 한도 정책을 유연하게 운영하며 사용자 이탈을 방지하고 있다는 점도 언급되었다.
Google DeepMind는 코딩 에이전트 경쟁에서 상대적으로 조용한 행보를 보이지만, 강연자는 이를 단순한 후퇴로 보지 않는다. Isomorphic Labs, AlphaGenome과 같은 AI4Science 방향에 훨씬 더 많은 자원을 투입하고 있기 때문이다. Demis Hassabis는 인터뷰에서 여전히 과학 분야 이야기를 하고 코딩 툴 진화에 대해서는 거의 언급하지 않는다. 강연자의 표현에 따르면 Google DeepMind는 “코딩이나 B2B 엔터프라이즈 문제가 인류를 구원할 정도의 문제라고 보고 있지 않은 것 같다.”
9. 두 가지 도망의 방향 — 슈퍼인텔리전스 시대의 생존 전략
강연자는 AI 능력의 급격한 향상 속에서 개인과 중소 기업이 취할 수 있는 방향을 ‘도망자의 관점’으로 제시했다. 전제는 “Claude Code, Codex 등 현존하는 하네스 엔지니어링을 극강으로 쓸 수 있다”는 것이다.
첫 번째 방향: AI 도구의 언번들링(Unbundling)
Benedict Evans가 제시한 “ChatGPT의 언번들링” 프레임에서 출발한다. Claude Code, Codex, Claude Design 같은 범용 도구들은 각각 수많은 작은 비즈니스 영역으로 분해될 수 있다. 아직 전체 인구의 1~5%만이 최신 AI 도구를 적극적으로 활용하고 있으며, 나머지 95~99%는 여전히 과거의 방식으로 일한다. “파워포인트가 30년이 지난 지금도 능숙하게 사용하는 사람이 많지 않은 것처럼” 이 격차를 채워주는 B2B·B2C 애플리케이션 시장은 향후 10년에 걸쳐 열린다는 것이 강연자의 전망이다. 웹 2.0, 모바일 앱 붐이 각각 거대한 시장을 만들었듯, AI 애플리케이션 붐도 필연적이라는 관점이다.
다만 경쟁 강도가 높아질 수 있다는 점은 주의가 필요하다. AI 도구 자체가 모두에게 공개된 공유재(共有財)이기 때문에 도구 활용 능력만으로는 지속 가능한 경쟁 우위를 확보하기 어렵다.
두 번째 방향: AI4Science — 중후장대한 도메인
Isomorphic Labs가 걷는 길처럼, 수명 연장(Longevity), 초전도체 개발, 희귀 질환 치료와 같이 극도로 전문화된 과학 도메인으로의 진입이 또 다른 방향이다. 진입 장벽이 높고 경쟁이 덜하지만 도메인 지식 축적에 상당한 투자가 필요하다. 강연자의 기준은 명쾌하다. “어떤 도메인을 봤을 때 그 도메인에 있는 사람들이 얘기하는 용어들이 귀에 안 박히면, 그거 그냥 새 도메인이에요.” 귀에 낯선 언어가 들리는 도메인이 곧 아직 선점되지 않은 기회 영역이라는 역설적 신호다.
두 방향 모두의 본질은 동일하다. “모든 사업은 모델의 슈퍼인텔리전스의 캐퍼빌리티 오버행에 기반한 서비스업에 불과하다.” 모델이 이미 가진 능력을 누가 먼저 어디에 연결하느냐가 승부를 결정한다.
10. AI4Science의 최전선 — 개인화 의료와 생명공학
GitLab 전 CEO의 암 치료 사례
이 도메인이 얼마나 현실적인 기회를 열고 있는지를 보여주는 사례로, GitLab의 전 CEO Sid Sijbrandij의 이야기가 소개되었다. 그는 척추에 발생하는 희귀 악성 종양인 골육종(Osteosarcoma)을 진단받았으나, 개인화 mRNA 백신 요법을 통해 생존했다.
치료 과정을 단순화하면 다음과 같다. 먼저 종양의 유전자 서열을 시퀀싱하여 암세포에서 과발현되는 단백질을 식별한다. 그다음 COVID-19 백신과 동일한 mRNA 기술을 활용해 해당 단백질을 항원으로 삼는 개인화 백신을 제작한다. 마지막으로 이 백신을 투여하여 환자 자신의 TCR-T(T세포 수용체 T세포 치료)가 암세포를 인식하고 공격하도록 유도한다. 강연자는 이 과정의 핵심이 “전부 다 소프트웨어 엔지니어링”이라고 강조했다. 마지막 Wet Lab 단계만 기존 생명공학 기법을 사용할 뿐, 나머지는 유전자 서열 분석과 계산 생물학의 영역이다.
Sid Sijbrandij 본인은 “의사의 인센티브(라이어빌리티 최소화)와 환자의 인센티브(치료 효과 극대화)가 병원에서 명확히 충돌하기 때문에, 특히 희귀암 환자에게는 답이 없는 구조”라고 지적했다. 개인화 정밀 의료(Personalized Precision Medicine)는 이 간극을 메울 수 있는 아직 존재하지 않는 산업이다. 강연자는 “암은 사실상 끝난 문제”라고 표현할 만큼, 이 방향으로의 솔루션이 기술적으로 이미 가시권에 들어왔다는 낙관적 전망을 내놓았다.
게놈 파운데이션 모델 EVO2와 에피제네틱스
Arc Institute가 개발한 EVO2는 유전체 파운데이션 모델(Genomic Foundation Model)로, 약 41억(41B) 파라미터 규모다. 바이러스부터 세균, 닭, 포유류, 인간에 이르기까지 다양한 생물의 진화적 서열 데이터를 프리트레인했다. LLM이 텍스트 시퀀스를 학습하듯 게놈 서열을 학습한 것인데, 강연자는 “LLM하고 너무 결이 잘 맞는 친연성이 있다”고 표현했다.
에피제네틱스(Epigenetics, 후생 유전학)의 개념도 간략히 다루어졌다. 동일한 게놈을 가진 세포들이 심장세포, 신경세포, 피부세포 등으로 분화하는 것은 에피게놈(Epigenome)이 유전자 발현을 켜고 끄는 방식으로 제어하기 때문이다. 정자와 난자가 수정된 이후 모든 세포가 동일한 게놈을 가지지만, 에피제네틱 제어가 각 세포의 정체성을 결정하는 것이다. 나이가 들며 자외선이나 화학적 자극에 노출될수록 이 에피제네틱 구조가 무너지는 것이 암으로 이어지기도 한다. DeepMind의 AlphaGenome이 이 에피제네틱 발현 메커니즘의 해석에 기여하고 있다.
강연자는 모델이 날리지 컷오프 이후의 최신 바이오 논문에서 결론만 보여주고 앞 가정들을 넣어 추정을 요청했을 때, 실제 발견과 매우 유사한 방향을 제시했다고 밝혔다. “얘는 어쩌면 이미 이 통일장 이론에 대한 심상을 저 어딘가에 갖고 있겠다”는 인상이었다는 것이다.
11. 메모리 관리와 개인 온톨로지 — 지식 과잉 시대의 대응
강연자는 AI를 사용해도 정보가 너무 많다는 역설적 상황을 해결하는 마지막 주제로 개인 지식 관리를 꺼냈다. 두 가지 접근이 필요하다고 제안했다.
첫 번째는 반복적이고 위임 가능한 업무를 에이전트에 델리게이션(Delegation)하는 것이고, 두 번째는 그 속에서 시그널과 노이즈를 구별하는 능력을 기르는 것이다. 강연자는 이 취사선택 능력, 즉 “취향에 대한 의사결정”이 AI 시대에 인간이 가질 수 있는 가장 중요한 가치라고 결론 내렸다. Automated Alignment Researcher 논문에서 AI가 여전히 인간의 취향 가이드를 필요로 한다는 결론과 정확히 맥이 닿는다. 정보를 처리하는 것은 AI가 더 잘하지만, 무엇이 중요한지를 판단하는 것은 여전히 인간의 영역이라는 것이다.
개인 온톨로지(Personal Ontology) 기반의 지식 베이스 구축이 최근 급격히 유행하고 있으며, 국내에서는 신영유 대표의 ‘결’, 김서준 대표의 ‘맴카프트(MemCraft)’ 등이 이 방향을 추구하는 서비스로 소개되었다. 이 주제는 별도 에피소드에서 상세히 다룰 예정이라고 밝혔다.
마무리 — 낮게 열린 과실들, 그리고 취향이라는 마지막 경쟁력
이번 에피소드 제목인 “낮게 열린 과실들(Low-Hanging Fruits)“은 역설적인 풍경을 그린다. AI 모델들이 이미 수많은 문제를 해결할 능력을 갖추고 있지만, 그 능력을 꺼내 쓰는 인터페이스와 응용은 아직 충분히 만들어지지 않았다. 캐퍼빌리티 오버행 상태에서, 가장 쉽게 딸 수 있는 과실들이 여전히 낮은 가지에 매달려 있다는 것이다.
강연자가 제시한 두 가지 방향 — AI 도구의 언번들링과 AI4Science — 은 모두 이 오버행을 전제로 한 전략이다. 그러나 어느 방향으로 가더라도, 모델을 넘어서는 사람이 지금 존재하지 않는 시대에 남아 있는 인간의 가치는 결국 “의미 있는 것을 선택하는 능력”, 즉 취향이다. 수많은 신호 중에서 무엇을 붙잡고 무엇을 흘려보낼지를 결정하는 판단력이 개인과 조직의 유일한 차별점이 되어가고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | EP 94. Claude Opus 4.7 과 낮게 열린 과실들 |
| 채널 | 노정석 |
| 녹화 일자 | 2026-04-19 |
| 리포트 작성 | 2026-04-22 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.