알고리즘에 그치지 않고 인프라까지 상세히 기술한다는 점이 이번 논문의 또 다른 특징이다.
MoE 파이프라인 최적화
분산 학습 환경에서는 “통신(Communication)“과 “연산(Computation)“이 교대로 발생하는 구조가 일반적이다. 이 두 작업을 겹쳐(Overlap) 수행하면 효율성이 크게 향상되는데, 이를 위한 기법이 파이프라이닝(Pipelining)이다. DeepSeek는 ByteDance의 COMET 연구(MoE에서 통신과 연산을 겹치는 기법)를 기반으로, 이를 더욱 세분화하여 추가 개선을 이루었다. V3에서도 이 최적화가 포함되어 있었는데, 당시 NVIDIA의 고성능 칩이 중국 수출 제한 대상인 상황에서 연산 자원의 한계를 소프트웨어 혁신으로 극복했다는 점이 주목을 받았다. V4에서는 MoE 자체를 추가로 개선하여 통신과 연산 사이의 유휴 시간(“버블”)을 한 단계 더 줄였다.
MEGA 커널과 전력 제한
커널(CUDA Kernel) 측면에서도 대규모 최적화가 이루어졌다. 연산과 통신을 하나의 거대한 “MEGA 커널”로 통합하여 연산 밀도(Computation Density)를 극한까지 끌어올렸다. 그 결과가 흥미롭게도, 연산 밀도가 너무 높아져 전력(Power)이 하드웨어 병목이 되는 상황이 발생했다고 논문은 밝힌다. GPU 가속기가 아니라 전력 인프라가 제약이 되는 수준까지 연산을 끌어올렸다는 뜻으로, 앞으로 전력 인프라를 확충해야 할 것이라는 언급이 논문에 직접 등장한다. 소프트웨어 최적화가 하드웨어의 절대적 한계에 근접했음을 의미하는 상황이다.
DeepSeek는 또한 커널 개발 DSL(Domain-Specific Language)인 TileLang(STT 오인식 가능성 있음, 정확한 이름 불명)에 기여하며 오픈소스 생태계에도 참여했다. 배치 불변성(Batch Invariance) 커널 최적화도 이번에 포함되었는데, 이는 “Sticking Machines(STT 오인식 가능성, 원어 불명)“라는 연구 그룹의 블로그 포스트가 화제가 된 기법을 DeepSeek가 재구현하고 추가 최적화하여 공개한 것이다.
MXFP4 양자화
V3에서 8비트 양자화(8-bit Quantization)가 메인으로 사용된 데 비해, V4에서는 MoE의 전문가 가중치(Expert Weights)에 대해 MXFP4(4-bit Floating Point, 마이크로스케일 부동소수점) 양자화를 적용했다. 이는 GPT-5.5에서도 등장한 기법으로, NVIDIA의 최신 하드웨어(Blackwell 이후)에서 가속이 지원된다. 모델 가중치 크기 절감과 함께 해당 하드웨어에서 추론 성능을 더욱 높이는 방향으로 진화하고 있으며, 강연자는 “Expert에 대한 MXFP4 압축은 이제 거의 표준이 되어가는 것 같다”고 언급한다.
프리트레이닝 전략
데이터
DeepSeek-V4는 총 32T(32조) 토큰으로 프리트레이닝되었다. 비교적 최근까지 공개된 주요 모델들의 프리트레이닝 데이터가 15~20T 수준이었음을 감안하면 거의 2배에 달하는 규모다. 데이터의 구체적인 구성에 대해서는 논문이 상세히 언급하지 않으며, 합성 데이터(Synthetic Data)에 대한 언급도 없다. 강연자는 DeepSeek의 OCR 관련 연구 성과를 감안하면 PDF 문서와 e-book이 대거 포함되었을 것으로 추측하며, 합성 데이터도 사용했을 확률이 높다고 본다. 강연자가 “데이터와 트레이닝이 진짜 핵심인데 사람들이 잘 다루지 않는다”고 지적하는 부분은, 기술 논의에서 알고리즘에만 집중하는 경향에 대한 경고이기도 하다.
롱 컨텍스트 프리트레이닝
이번 V4에서 가장 혁신적인 프리트레이닝 전략 중 하나는 롱 컨텍스트를 프리트레이닝 단계에 통합한 것이다. 기존 대부분의 모델은 4K 또는 8K 토큰의 짧은 컨텍스트로 프리트레이닝을 마친 후, 포스트 트레이닝의 마지막 단계에서 컨텍스트 길이를 점진적으로 늘리는 방식을 취했다. 그러나 DeepSeek-V4는 초기 약 1T 토큰을 4K→16K 컨텍스트로 학습한 후, 나머지 30T 이상의 토큰을 64K 이상의 컨텍스트로 학습했다. 이는 두 가지를 방증한다. 첫째, Sparse Attention 덕분에 64K 이상의 컨텍스트에서도 학습 비용이 현실적인 수준을 유지한다는 것이다. 둘째, 32K 이상의 긴 문서들이 학습에 의미 있는 분량만큼 충분히 확보되어 있다는 것이다. 강연자는 이 방식이 중국 모델들 전반으로 확산될 것이며, 포스트 트레이닝 단계에서 롱 컨텍스트를 별도로 다루는 단계가 사라지고 프리트레이닝에 흡수되는 흐름이 자리 잡을 것이라고 전망한다.
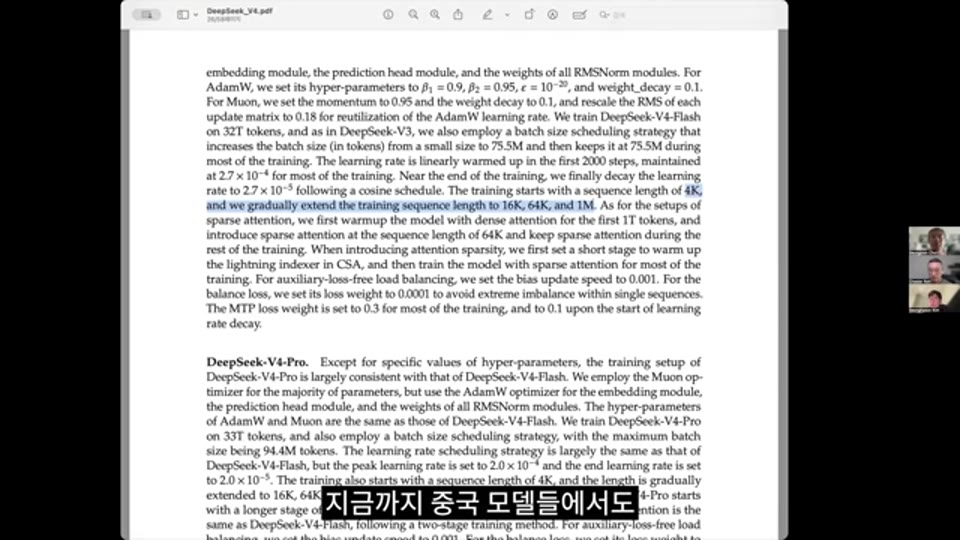
40:47 - 프리트레이닝 컨텍스트 길이 진행 방식(4K→16K→64K+)과 Dense/Sparse Attention 전환 구간을 나타낸 트레이닝 셋업 도표
학습 불안정성과 그 극복
이번 논문에서 가장 이례적인 부분 중 하나는 **학습 불안정성(Training Instability)**에 대한 솔직한 서술이다. 최근 대부분의 LLM 논문들이 “학습이 매우 안정적이었다”고 강조하는 추세와 대조적으로, DeepSeek-V4 팀은 상당한 불안정성을 겪었음을 인정하고 다양한 대응책을 공개했다. 불안정성의 주요 원인은 MoE의 게이팅(Gating) 구조 변경과 Sparse Attention의 조합으로 추정된다.
대응책 중 특히 주목할 만한 것은 “비동기적 라우팅(Anti-routing)“으로 불리는 기법이다. 이는 MoE에서 현재 학습 중인 가중치가 아닌, 몇 스텝 전의 과거 가중치를 사용해 MoE 라우팅을 결정하는 방식이다. 구현 자체가 매우 복잡하고 별도의 인프라가 필요하지만, DeepSeek는 이를 실제로 구현했다. 강연자들은 이 선택의 직관적 이유를 논문에서 명확히 제시하지 않는다고 언급하며, “일종의 레귤라리제이션(Regularization)으로서 피드백 루프의 자기강화를 억제하기 위해 의도적으로 노이즈를 삽입한 것”이라는 해석을 제시한다. 이 부분은 앞으로도 커뮤니티에서 많은 분석이 나올 것이라고 강연자는 덧붙인다.
포스트 트레이닝
포스트 트레이닝 측면에서도 DeepSeek-V4는 상당한 공을 들인 흔적이 있다. 코딩, 수학 등 전문 분야별로 각각의 전문가 모델을 학습시킨 뒤, 이를 온라인 지식 증류(Online Knowledge Distillation) 방식으로 최종 모델에 통합했다. 또한 R1 논문에서 소개된 루브릭 기반 리워드 모델(Rubric-based Reward Model)을 채택하여 강화학습(RL) 과정을 정교화했다.
특히 주목할 만한 것은 1M(100만) 토큰 컨텍스트에서의 에이전트 포스트 트레이닝이다. 100만 토큰을 생성하면서 동시에 샌드박스 환경과 상호작용하는 에이전트 포스트 트레이닝은 인프라적으로 매우 복잡한 요구 사항을 수반한다. 실시간으로 Docker 컨테이너를 빠르게 띄우고, 스토리지 서비스와의 고속 연동이 필요하며, 에러와 실패 상황에 즉각 대응하는 인프라가 갖추어져야 한다. 논문이 이러한 인프라 구성 요소를 상세히 기술한 것은, 에이전트 포스트 트레이닝의 인프라 복잡성이 이미 알고리즘 자체만큼이나 중요한 과제가 되었음을 방증한다. 또한 MXFP4를 활용한 RL 학습도 이번에 포함되었는데, 강연자는 이를 “쉽게 들리지만 실제로는 매우 어려운 문제”라고 설명한다.
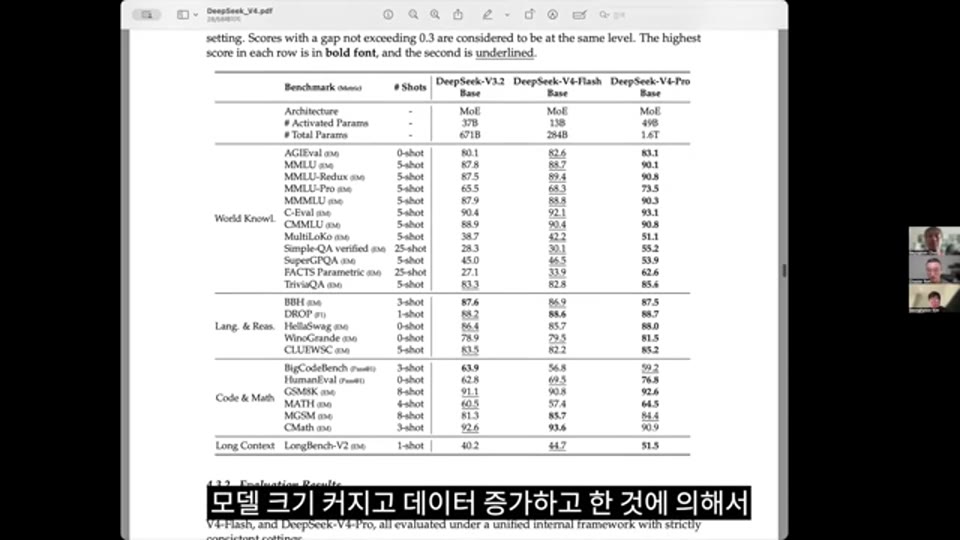
46:11 - DeepSeek-V4 포스트 트레이닝 성능 벤치마크 비교표 (V3, Gemini, Kimi 2.5 등과의 비교)
벤치마크 측면에서 베이스 모델과 포스트 트레이닝 모델 모두 크게 향상되었고, 롱 컨텍스트 성능도 두드러진 개선을 보였다. 중국어 글쓰기 품질을 Gemini와 비교하며 개선하기 위해 상당한 노력을 기울였다는 점도 논문에 명시되어 있다. 강연자들은 포스트 트레이닝에 아직 여지가 있으며, 더 나은 프리트레이닝 기반 위에서 포스트 트레이닝 연산량을 추가로 투입하는 V4.1, V4.2에서 더 큰 개선을 기대한다고 말한다.
하드웨어와 중국의 AI 인프라
논문 말미에는 NVIDIA 칩과 화웨이(Huawei) 칩을 함께 사용했다는 언급이 나온다. 비중은 공개되지 않았지만, 화웨이 칩이 DeepSeek 수준의 프론티어 모델 학습에 사용되었다는 점 자체가 중국 AI 반도체 생태계의 의미 있는 진전을 보여준다. NVIDIA의 고성능 칩이 중국 수출 제한 대상인 상황에서, 중국은 소프트웨어 최적화와 함께 자국 반도체 대안을 병행 발전시키고 있다는 점을 이 논문이 공식적으로 확인시켜 주었다.
이번 주의 다른 주요 소식들
이 영상은 DeepSeek-V4 리뷰 외에도, 녹화 당시(2026년 4월 26일) 한 주간의 AI 주요 소식을 간략히 다루었다.
GPT-5.5 출시: OpenAI가 예고대로 GPT-5.5를 출시했다. 사용 경험 측면에서 확실한 속도 향상과 성능 개선이 확인되었으며, 기존에 한계로 지적되던 유니콘 그리기(Unicorn Drawing) 벤치마크에서도 성능 향상이 나타났다. 단, 이는 이미지 생성 모델(이미지 2.0)로 먼저 이미지를 생성한 뒤 이를 활용하는 방식으로 달성된 것으로, 향후 LLM이 이미지 생성 모델을 내부적으로 활용하는 방향으로 발전할 것임을 시사한다는 해석이 나온다. 또한 3D 분야에서도 주목할 만한 성능 향상이 GPT-5.5에서 확인되었다.
Google Cloud Next: 8세대 TPU(학습용 및 추론용 신제품)가 발표되었으나, 강연자들 기준으로는 “크게 주목할 만한 점이 없었던” 주로 평가되었다.
Anthropic: Claude 제품팀 인터뷰(담당자 성명은 STT 오인식으로 불확실)에서, “높은 주파수에서 회복 탄력성을 가지는 인재상”이 핵심 역량으로 언급되었다. 빠른 AI 발전 속도에서 번아웃 없이 버티는 방법에 대한 이야기이기도 하다.
Meta의 모델: Meta에서 새로운 프론티어 모델(“[뮤즈 스파크?]”, STT 오인식으로 정확한 이름 불명)을 출시했으나, 어마어마한 컴퓨터 자원과 인재를 투입한 것에 비해 DeepSeek-V4 대비 임팩트가 약하게 느껴진다는 평가가 나왔다.
마무리 - 프론티어의 프론티어
강연자 성현 님의 말을 빌리면, DeepSeek-V4는 “기술적으로도 경이롭고, 이런 구조를 만들어내고 구현하고 학습에 성공했다는 것 자체가 놀랍다”는 평가를 받는 작품이다. 세 가지 알고리즘 혁신—Sparse Attention, MHC, Muon Optimizer—각각이 이미 독립적인 논문 주제가 될 만한 수준이고, 이를 동시에 새로운 모델에 통합하여 성공적으로 학습시킨 것은 수십 명의 연구팀이 1년 이상 치열하게 매달린 결과다. 논문에는 그 “고통의 증거들”이 학습 불안정성, 비직관적인 모델링 선택, 극도로 복잡한 인프라의 형태로 고스란히 남아 있다.
DeepSeek-V3가 Kimi를 포함한 중국 내 여러 모델의 베이스가 되었듯, V4 역시 향후 나올 중국 모델들의 새로운 기준점이 될 가능성이 높다. 동시에, 이 아키텍처를 재현하는 과정이 쉽지 않으리라는 점도 강연자는 덧붙인다—DeepSeek 팀이 겪은 고통은 이 구조를 따라가려는 다른 팀들도 상당 부분 반복해야 할 과정이기 때문이다. 더 큰 그림에서 보면, 프리트레이닝에서는 중국과 미국의 격차가 이미 거의 사라졌거나 역전된 부분도 있고, 남은 싸움터는 포스트 트레이닝이라는 시각이 설득력을 얻고 있다. DeepSeek가 V4.1, V4.2를 내놓으면서 포스트 트레이닝에 본격적으로 연산을 투입할 때, 이 베이스 모델의 진짜 잠재력이 드러날 것이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | EP 95. DeepSeek-V4 논문 읽기 |
| 채널 | 노정석 |
| 녹화 일자 | 2026-04-26 |
| 리포트 작성 | 2026-04-29 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
📖 관련 참고 자료 (강연 내용과 별개)
이하의 자료들은 강연에서 언급되었거나 본문 이해를 위해 참고할 만한 배경 지식으로, 강연 내용 자체와는 별개입니다.
- DeepSeek-R1 논문 (2025년 1월): 강화학습 기반의 추론 모델로 V4의 전작. 루브릭 기반 리워드 모델 기법도 이 논문에서 소개됨
- Native Sparse Attention (DeepSeek, 2025): Sparse Attention의 From Scratch 학습을 처음 시도한 DeepSeek 내부 연구로 V4 아키텍처의 출발점
- COMET (ByteDance): MoE의 통신-연산 파이프라이닝 최적화 연구. V4 인프라의 참조 기반이 된 논문
- Muon Optimizer: Adam 이후의 새로운 최적화 알고리즘으로, 중국 프론티어 모델들이 광범위하게 채택 중
- MXFP4: NVIDIA Blackwell 이후 하드웨어 가속이 지원되는 4비트 부동소수점 포맷. GPT-5.5에서도 채택