EUV 없이 1.4나노? 화웨이가 꺼낸 중국 반도체 우회로 전략의 진실
📺 원본 영상: EUV 없이 1.4나노? 화웨이가 꺼낸 중국 반도체 우회로 전략의 진실 🎙️ 채널: 안될공학 - IT 테크 신기술 📅 정리 일자: 2026-05-28 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
화웨이가 2031년까지 1.4나노급 칩을 목표로 한다는 발표를 내놓았다. 미중 갈등의 여파로 EUV(Extreme Ultraviolet) 장비 도입이 사실상 차단된 상황에서 나온 이 선언은, 겉으로 보기에 충격적이지만 실상은 기존 파운드리 경쟁과는 전혀 다른 접근법을 담고 있다. 이 영상은 화웨이가 제시한 ‘타우 스케일링(Tau Scaling)‘과 ‘로직 폴딩(Logic Folding)‘이라는 두 가지 핵심 개념의 기술적 의미를 해설하고, 그 현실적 가능성과 한계를 냉정하게 평가한다.
제재의 벽 앞에 선 화웨이: 현재 상황 진단
반도체 산업에서 무어의 법칙(Moore’s Law)이 작동해온 방식은 단순명쾌했다. 트랜지스터 자체의 물리적 크기를 줄여 같은 면적에 더 많은 셀을 집어넣는 것이다. 셀 간격이 좁아질수록 배선 길이가 짧아지고, 그만큼 전력 효율도 향상된다. 그러나 14나노 이후 FinFET(핀펫) 구조로 전환되면서 ‘3나노’, ‘2나노’라는 공정 명칭은 더 이상 실제 물리적 치수를 의미하지 않게 되었다. 실제 셀 크기는 여전히 10~20나노 수준이지만, FinFET이나 GAA(Gate All Around, 게이트 올 어라운드) 구조를 통해 그에 상당하는 성능이 구현되는 방식이다. TSMC의 3나노, 삼성의 3나노, 인텔의 3나노가 서로 다른 밀도를 가지고 있는 것도 바로 이 때문으로, 공정 명칭은 마케팅적 등가 개념에 가깝다고 볼 수 있다.
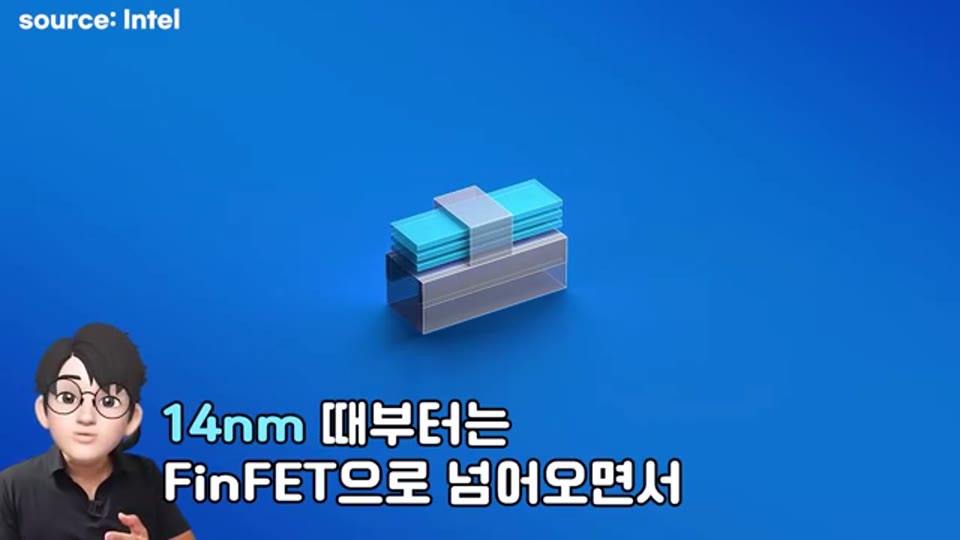
01:54 - FinFET 이후 공정 노드 명칭이 실제 물리적 치수가 아닌 등가 성능 개념임을 설명하는 슬라이드
화웨이는 이 구조적 변화의 흐름 속에서 근본적인 제약에 직면해 있다. 미중 갈등의 심화로 EUV 장비 도입이 막혀 있고, ASML의 핵심 광원 기술이 미국에서 출발했기 때문에 미국이 수출을 통제할 수 있는 구조다. 강연자는 이전에 ASML에서 오래 근무한 박사와 실리콘밸리에서 인터뷰한 영상을 통해 이 맥락을 상세히 다룬 바 있다고 언급한다. 그 결과 화웨이의 위탁 생산을 담당하는 SMIC는 DUV(Deep Ultraviolet) 장비를 이용한 멀티 패터닝으로 겨우 4나노를 표방하는 공정을 유지하고 있지만, 실질적으로는 5나노 수준에 가깝다는 평가가 지배적이다. 이 상황에서 화웨이가 꺼낸 카드가 바로 ‘정면 돌파’ 대신 ‘우회로’다.
화웨이의 선언: 1.4나노급, 그러나 공정이 아닌 ‘밀도 등가’의 개념
화웨이가 2031년까지 1.4나노급 칩을 목표로 한다고 발표했을 때, 많은 사람들이 EUV 없이 미국 제재를 뚫고 TSMC를 추격하는 기술적 돌파구를 상상했을 것이다. 그러나 강연자는 이 지점에서 명확히 선을 긋는다. 이것은 1.4나노 공정의 양산 성공을 선언한 것이 아니라, 1.4나노 수준의 트랜지스터 밀도(Density) 등가를 달성하기 위한 새로운 개념적 접근을 제시한 것이라고 정리한다.
구체적으로 화웨이가 제시한 방법론은 3D 적층, 그리고 NAND 플래시에서 이미 활용 중인 하이브리드 본딩(Hybrid Bonding) 같은 패키징 기술을 결합해 배선 길이 자체를 단축하고, 시스템 전체를 최적화함으로써 ‘1.4나노처럼 보이는’ 밀도를 달성하겠다는 것이다. 이는 TSMC, 삼성, 인텔이 트랜지스터 자체를 작게 만드는 방식으로 접근하는 기존 로드맵과는 근본적으로 다른 철학이다. TSMC 3나노와 삼성 3나노가 명칭은 같지만 밀도가 다르듯, 화웨이의 1.4나노 역시 기존 파운드리가 사용하는 의미의 1.4나노 공정과는 다른 개념으로 이해해야 한다.
핵심 개념 1: 타우 스케일링(Tau Scaling) - 신호 지연 시간을 줄인다
화웨이가 제시한 첫 번째 핵심 개념은 타우 스케일링(Tau Scaling)이다. 여기서 ‘타우(τ)‘는 전기 회로에서 시간 지연을 나타내는 기호로, RC 딜레이(RC Delay)를 의미한다. 저항(R, Resistance)과 캐패시터(C, Capacitor)의 곱으로 계산되는 이 RC 상수(RC Time Constant)가 바로 신호가 회로 내에서 목표 전위에 안정화되는 데 걸리는 시간이다. 전자공학을 공부한 사람이라면 익숙한 이 개념이, 화웨이 전략의 중심에 놓여 있다.
반도체 칩 내부에서 전자가 이동할 때는 단순히 흐르는 것이 아니라, 배선 저항과 기생 캐패시터(Parasitic Capacitor)의 영향을 받으며 움직인다. 배선을 통과할 때의 저항, 접촉 지점에서의 저항, 그리고 주변 구조물과의 정전기적 간섭으로 발생하는 기생 캐패시터 값이 모두 딜레이를 결정하는 요소가 된다. 더 나아가 크리티컬 패스(Critical Path)나 클락 스큐(Clock Skew) 같은 설계 문제도 모두 이 전자들의 기본적인 이동 속성, 즉 저항과 캐패시터에 의해 결정된다. 화웨이는 이 모든 지연 요소를 ‘타우’라는 하나의 심벌로 묶어 표현한 것이다.
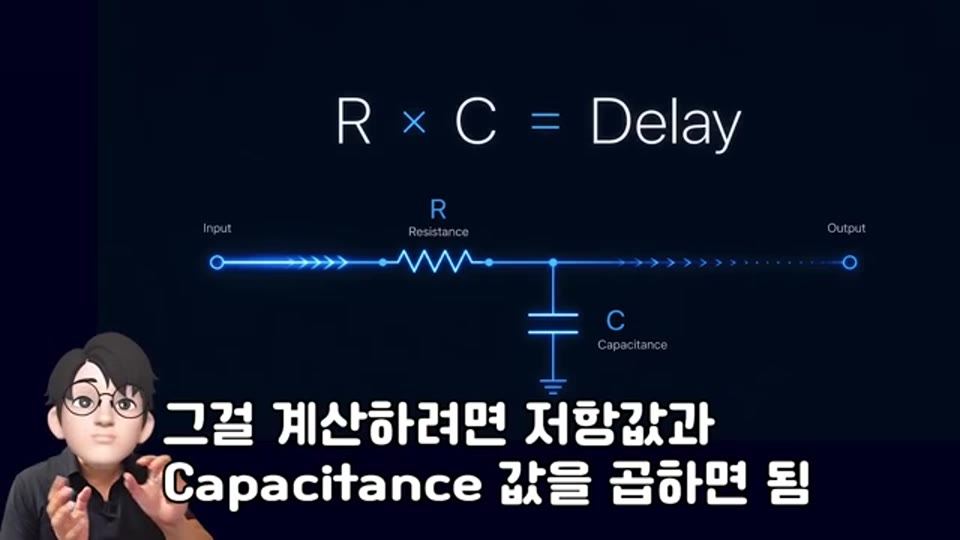
05:46 - 타우(τ) = RC 딜레이 원리
화웨이의 접근은 트랜지스터 크기를 줄이는 것 대신, 이 RC 딜레이 자체를 줄임으로써 동일한 성능 향상 효과를 노리겠다는 것이다. 강연자는 이를 도시 비유로 설명한다. 빽빽하게 건물을 지어 인구를 늘리는 것이 기존 무어의 법칙적 접근이라면, 화웨이의 접근은 인구 밀도를 늘리기 어려운 상황에서 아예 이동 거리 자체를 단축시켜 교통 체증(딜레이)을 해소하겠다는 발상이다. 타우 스케일링 자체가 완전히 새로운 물리 법칙은 아니지만, EUV 도입이 막힌 화웨이가 자신들의 제약 안에서 체계적으로 접근하겠다는 방향성을 명시적으로 선언했다는 점에서 의미가 있다고 평가한다.
핵심 개념 2: 로직 폴딩(Logic Folding) - 회로를 3D로 접다
두 번째 개념인 로직 폴딩(Logic Folding)은 이름 그대로 회로(Logic)를 공간적으로 접는다는 개념이다. 평면적으로 길게 펼쳐진 회로 경로를 3D 구조로 재배치하여, 자주 연결되는 회로끼리 위아래로 가깝게 위치시킴으로써 배선 길이를 단축하겠다는 접근이다. 이는 폴더블폰처럼 칩을 물리적으로 구부리는 것이 아니라, 원래 평면에서 멀리 떨어져 있던 회로 요소들을 3D 구조 안에서 가깝게 재배치한다는 설계 철학의 전환을 의미한다.
💡 [영상 참조] 강연자는 이 시점에서 화웨이의 로직 폴딩 개념을 도식화한 슬라이드를 참조하며, 평면 회로와 3D 재배치 구조의 차이를 시각적으로 설명합니다. 상세 내용은 원본 영상을 확인하세요.
강연자는 이 개념을 듣고 자연스럽게 AMD의 3D V-Cache 기술을 떠올렸다고 언급한다. 기존 캐시 메모리 위에 추가 캐시를 3D로 패키징하는 AMD 3D V-Cache, 혹은 TSV(Through Silicon Via)를 활용한 HBM(High Bandwidth Memory)은 구조적으로 로직 폴딩과 유사한 철학을 공유한다. 그러나 둘 사이에는 중요한 기술적 차이가 있다. AMD 3D V-Cache의 핵심은 SRAM(캐시)을 추가로 얹는 것이기 때문에, 규칙적이고 반복적인 구조를 가진 메모리 레이어를 쌓는 방식으로 구현된다. 반면 화웨이가 목표로 하는 로직 폴딩은 SoC(System on Chip) 내의 복잡하고 불규칙한 로직 회로 자체를 3D로 접는 것이다. 로직 회로는 메모리와 달리 회로 활성도(Activity)가 높고 비정형적이라 발열이 훨씬 크다는 점에서, 메모리 적층과는 차원이 다른 기술적 도전이 요구된다.
07:44 - 로직 폴딩과 AMD 3D V-Cache의 기술적 난이도 비교
화웨이 발표에 따르면, 로직 폴딩을 통해 클락 버퍼(Clock Buffer) 감소, 클락 스큐(Clock Skew) 감소, 와이어 길이(Wire Length) 감소를 달성할 수 있다고 했다. 이 세 가지는 단순히 캐시 용량을 늘리는 것으로는 해결할 수 없는 설계상의 핵심 병목이기 때문에, 화웨이의 접근이 패키징의 범주를 넘어 훨씬 광범위한 설계 최적화를 지향한다는 것을 보여준다.
로드맵 수치와 논문 발표
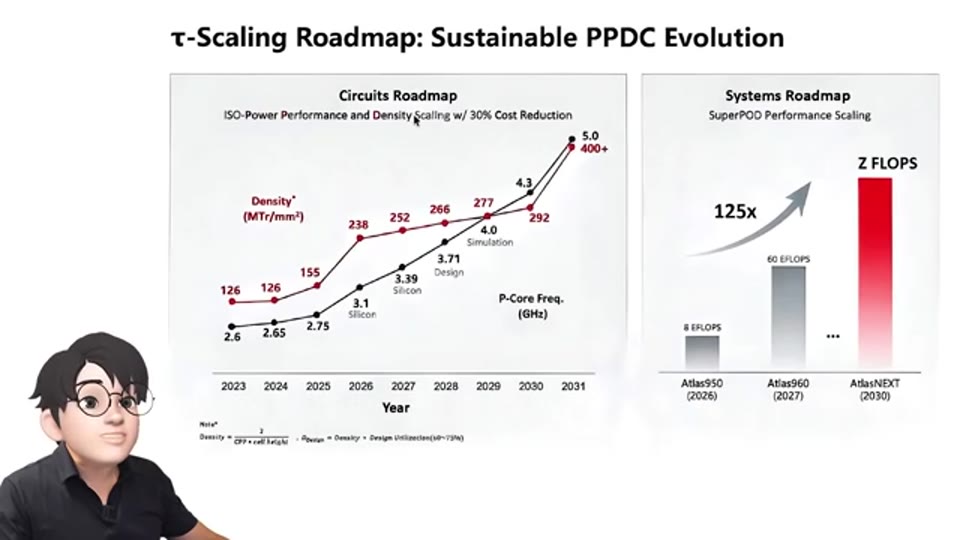
04:50 - 화웨이의 회로 로드맵 슬라이드 - 2023년부터 2031년까지 트랜지스터 밀도 및 클락 속도(GHz) 향상 목표 차트
현재 화웨이가 목표로 삼는 트랜지스터 밀도 수치는 155에서 238 수준까지 올리는 것을 포함하고 있으며, 2026년 기준 현재 밀도가 238 수준이라고 언급된다. 이 밀도를 해마다 점진적으로 끌어올리다가 로드맵 말미에 급격히 상승하는 구간이 있는데, 강연자는 이를 현실적인 달성 경로라기보다는 타우 스케일링과 로직 폴딩이 효과를 발휘하기 시작할 경우의 목표치로 이해해야 한다고 설명한다. 해당 발표는 실제 논문으로도 중국판 arXiv에 게재되었으며, 이는 단순한 홍보성 발표가 아닌 기술적 접근에 일정한 근거가 있음을 시사한다.
화웨이는 이러한 접근을 통해 퍼포먼스 코어의 전력 효율(Power Efficiency)을 41% 향상시킬 수 있다고 주장한다. 배선 길이 단축, 클락 트리(Clock Tree) 최적화를 통한 클락 버퍼 감소, 분배 전력(Distribution Power) 절감 등을 복합적으로 적용한 결과라는 설명이다. 기린(Kirin) 칩을 SoC로 설계하여 이 목표를 실현하겠다는 포부도 함께 제시되었다.
주장의 한계: 화웨이가 말하지 않은 것들
강연자는 41%라는 수치에 대해 신중한 시각을 유지한다. 반도체 설계에서 가장 중요한 품질·신뢰성 지표 중 하나인 누설전류(Leakage Power)에 대해 화웨이가 전혀 언급하지 않았다는 점을 지적한다. 실제 회로에 전류를 흘렸을 때 목적 없이 새어나가는 전류가 많으면 발열과 소비 전력이 폭증하는데, 이 누설전류 문제는 파운드리 수율과 직결되는 핵심 지표다. 어떤 전압(VDD) 조건에서, 어떤 온도 환경에서 측정된 수치인지도 명확하지 않다. 제품 출시 전 벤치마크 점수는 좋게 나오지만 실제 양산 제품의 성능은 기대에 못 미치는 경우가 적지 않듯, 이 발표는 양산 완료 선언이 아닌 개념적 가능성의 제시에 훨씬 더 가깝다고 평가한다.
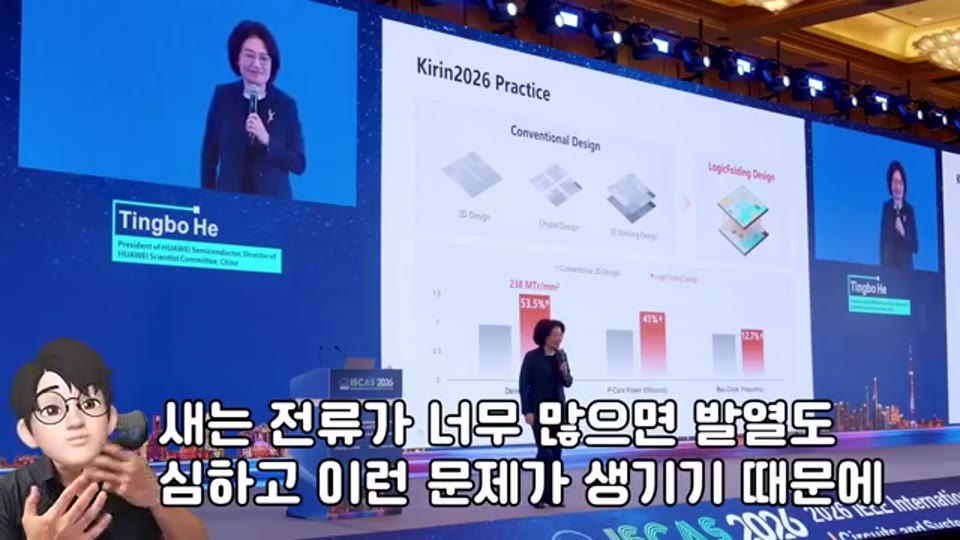
10:29 - 누설전류(Leakage Power) 미공개와 41% 효율 주장의 검증 한계
나아가 화웨이가 공개하지 않은 또 다른 중요한 정보는 어떤 조건에서 어떻게 구현될 것인가, 그리고 양산 시 수율이 얼마인가에 대한 목표치다. 검증 복잡도와 실제 제조 비용에 대해서도 발표는 침묵한다. 강연자는 이를 “가능성에 대한 얘기를 아직은 하는 것”이라고 정리한다.
기술적 장벽: 열 관리, EDA, 수율
화웨이의 로직 폴딩 접근이 가진 기술적 한계는 여러 방면에서 지적된다. 첫째로 열 관리(Thermal Management) 문제가 있다. 로직 회로를 3D로 적층하면 단위 면적당 열 밀도(Thermal Density)가 급격히 높아진다. 로직은 메모리와 달리 구조가 불규칙하고 활성도가 높아 발열이 크기 때문에, 서로 적층될수록 열이 축적되기 쉽다. 배선 길이가 아무리 단축되더라도 열이 제대로 방출되지 않으면 안정적인 동작을 보장하기 어렵다는 것이다.
둘째로 EDA(Electronic Design Automation) 툴의 진화 문제가 있다. 기존 2D 평면 구조에서의 회로 설계 및 검증은 이미 정교한 EDA 도구가 지원하지만, 3D 구조에서는 검증해야 할 포인트가 기하급수적으로 증가한다. SMIC와 협력하여 설계 데이터를 주고받는 과정에서도 3D 설계를 완전히 표현하고 검증할 수 있는 툴 생태계가 반드시 뒷받침되어야 한다. 강연자는 이 영역에서도 별도의 발전이 필요하다고 지적한다.
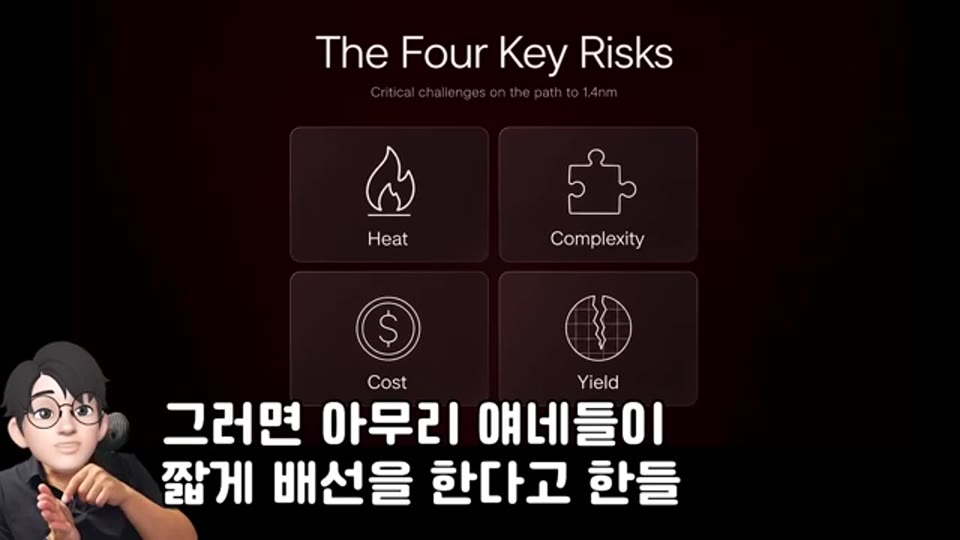
11:22 - 로직 3D 적층 시 열 밀도 증가 문제와 EDA 도구 검증 복잡도
셋째이자 가장 근본적인 문제는 제조 비용과 수율(Yield)이다. 3D 패키징, 하이브리드 본딩, 복잡한 적층 공정은 각 단계마다 수율 손실을 누적시킨다. 각 공정 단계의 수율이 조금씩만 떨어져도 전체 양산 수율은 크게 낮아질 수 있으며, 그 비용은 결국 제품 단가에 반영된다. 강연자는 이 모든 공정을 감당해야 하는 입장에서 중국이 “해야 한다”는 국가적 의지로 밀어붙이고 있는 구조가 아닌가 하는 시각을 제시한다.
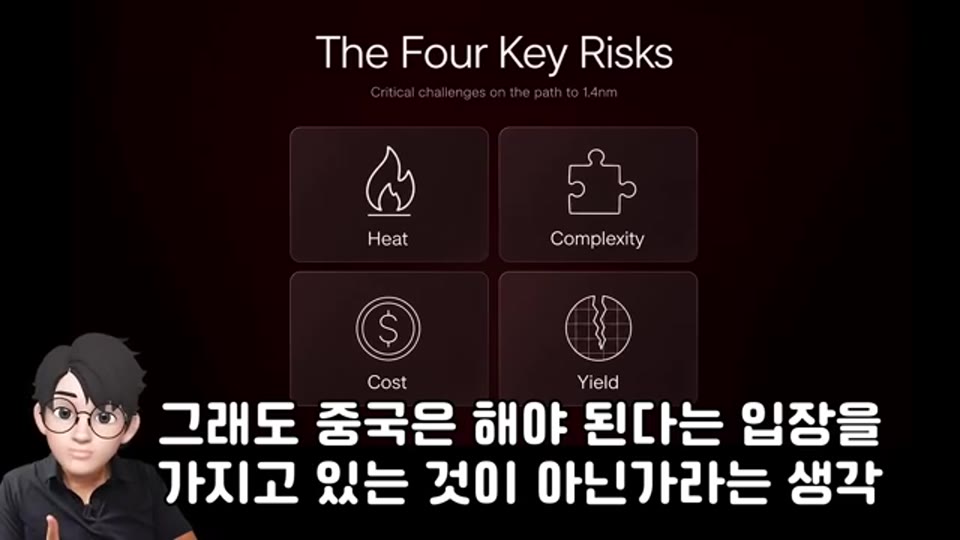
12:22 - 3D 패키징·하이브리드 본딩의 단계별 수율 누적 손실
SMIC의 미래: 화웨이 전용 파운드리로의 전환
강연자는 이 상황이 SMIC에도 구조적 변화를 가져올 것이라고 분석한다. EUV를 도입할 수 없는 SMIC는 사실상 첨단 공정을 필요로 하는 다른 고객사를 유치하기 어려운 상황이다. 화웨이가 타우 스케일링과 로직 폴딩이라는 독자적인 방향성을 설정하면서, SMIC 역시 이에 맞춰 공정과 설계 협력 체계를 최적화할 수밖에 없는 구조가 된다. 결과적으로 SMIC는 화웨이 전용 파운드리로서의 역할을 강화해나갈 가능성이 높다고 진단한다. 그리고 그 협력의 핵심 인프라 중 하나가, 앞서 언급한 3D 설계를 완전히 지원하는 EDA 툴 생태계가 될 것이다.
마무리 / 핵심 정리
화웨이의 이번 발표는 단순히 허풍이거나, 반대로 단순히 혁신이라고 단정 짓기 어렵다. 타우 스케일링과 로직 폴딩 모두 완전히 새로운 물리 원리가 아니라, 이미 반도체 설계 현장에서 부분적으로 활용되어온 개념들이다. TSMC, 삼성, 인텔도 트랜지스터 스케일링과 함께 이러한 3D 패키징 기술을 병행하며 발전시키고 있기 때문에, 화웨이만이 이 방향을 독점하는 것도 아니다.
그러나 강연자는 의미 있는 가능성도 인정한다. 딥시크(DeepSeek)가 제한된 GPU 환경에서 극한의 최적화를 통해 새로운 가능성을 보여줬듯, 화웨이 역시 EUV라는 제약이 오히려 특정 방법론을 깊이 파고드는 계기가 될 수 있다는 것이다. 무어의 법칙의 종언이 거론되고, 핀펫에서 GAA로의 전환이 논의되는 오늘날, 반도체 병목이 단순한 트랜지스터 축소에 있지 않다는 것은 업계 전체가 공유하는 인식이다. 화웨이는 EUV 없이 그 문제를 풀어야 한다는 훨씬 가혹한 조건 속에서 자신만의 해법을 고안하고 있다. 2031년이라는 목표 시점까지, 이 발표는 ‘달성했다’는 선언이 아닌 ‘이 방향으로 가겠다’는 포부로 읽어야 한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | EUV 없이 1.4나노? 화웨이가 꺼낸 중국 반도체 우회로 전략의 진실 |
| 채널 | 안될공학 - IT 테크 신기술 |
| 리포트 작성 | 2026-05-28 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.