프론티어 소형 모델 훈련에서 배운 모든 것
📺 원본 영상: Everything I Learned Training Frontier Small Models — Maxime Labonne, Liquid AI 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-30 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Liquid AI에서 Post-training을 총괄하는 Maxime Labonne는 이 강연에서 소형 언어 모델(Small Language Models)이 단순히 대형 모델을 축소한 버전이 아니라는 점을 역설한다. 350M에서 24B 파라미터에 이르는 엣지 모델을 실제로 개발하고 배포해온 경험을 바탕으로, 소형 모델이 가진 고유한 특성과 그에 따른 아키텍처 설계, 훈련 전략, 그리고 실제 운용에서 발생하는 문제점과 해결 방안을 체계적으로 소개한다. 궁극적으로 그가 전달하려는 핵심은 하나다 — 소형 모델은 대형 모델과 같은 방식으로 접근해서는 안 되며, 그렇게 할 때야만 진정한 잠재력이 발휘된다.
소형 모델의 고유한 특성 — 왜 다르게 생각해야 하는가
소형 모델에는 세 가지 핵심적인 특성이 있으며, 이 특성들이 서로 긴밀하게 연결되어 전체 설계 철학을 규정한다고 Labonne는 설명한다. 첫 번째는 메모리 제약(Memory-bound)이다. 스마트폰이나 자동차 내 컴퓨팅 환경은 하드웨어 자체의 물리적 한계로 인해 대형 모델 실행이 불가능하고, 이 때문에 모델 크기를 극도로 최소화하는 것이 전제 조건이 된다. 두 번째는 이로부터 자연스럽게 파생되는 낮은 지식 용량(Low Knowledge Capacity)이다. 파라미터 수가 적을수록 저장할 수 있는 지식의 양이 제한되며, 이는 필연적으로 할루시네이션 빈도를 높이는 원인이 된다. 세 번째는 높은 지연 민감성(Latency Sensitivity)이다. 엣지 환경에서는 응답 속도가 사용자 경험에 직결되기 때문에, 처리량(Throughput)과 추론 속도 최적화는 타협의 여지가 없는 요구사항이다.
그러나 이러한 제약이 반드시 약점으로만 작용하는 것은 아니다. 낮은 지식 용량이라는 한계는 오히려 특정 작업에 집중하게 만드는 원동력이 된다. ChatGPT와 같은 범용 챗봇으로 활용하는 것은 소형 모델에 적합하지 않지만, 문서 요약, 데이터 추출, 특정 API 호출 등 좁게 정의된 태스크에서는 오히려 뛰어난 성능을 발휘할 수 있다. Liquid AI가 가장 최근에 출시한 VLM 450M과 350M 텍스트 모델이 이 접근법의 실증적인 사례다.
아키텍처 분석 — 임베딩 레이어의 숨겨진 비효율
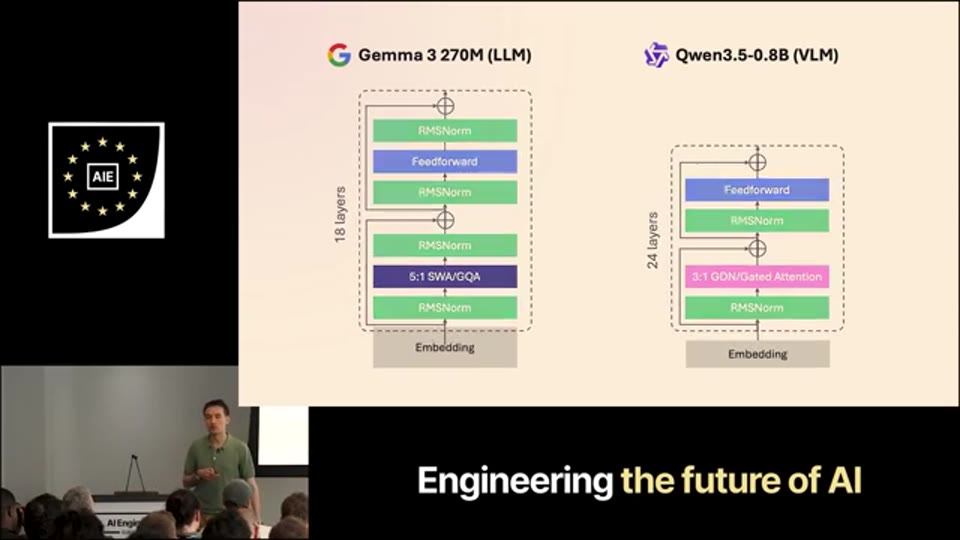
강연은 현존하는 소형 모델들의 아키텍처를 해부하는 것으로 시작된다. Gemma 3 270M과 Qwen 3.5 0.8B는 각각 최신 하이브리드 아키텍처를 채택하고 있다. Gemma 3는 슬라이딩 윈도우 어텐션(Sliding Window Attention)과 GQA(Grouped Query Attention) 하이브리드 구조를, Qwen 3.5는 Gated DeltaNet과 Gated Attention을 결합한 새로운 아키텍처를 사용한다. 두 모델 모두 각자의 방식으로 속도와 메모리 효율성을 추구하고 있으며, 이는 소형 모델 아키텍처 연구의 방향성을 잘 보여준다.
그런데 Labonne는 여기서 간과하기 쉬운 중요한 비효율을 지적한다. 전체 파라미터 중 임베딩 레이어(Embedding Layer)가 차지하는 비율이 지나치게 높다는 것이다. Gemma 3 270M의 경우 전체 파라미터의 무려 63%가 임베딩 레이어에 집중되어 있으며, Qwen 3.5 0.8B도 약 29%를 임베딩이 차지한다. 임베딩 파라미터는 어휘(Vocabulary)를 벡터로 표현하는 데 쓰이는 것으로, 실질적인 추론과 지식 처리에 기여하는 “유효 파라미터(Effective Parameters)“와는 구분된다. 다시 말해, 메모리의 절반 이상이 어휘 테이블에 소모되고 있으며, 같은 메모리 사용량에서 훨씬 더 많은 추론 능력을 확보할 여지가 존재한다는 뜻이다.
이런 비대한 임베딩 레이어가 생기는 구조적 이유는 훈련 방식에 있다. 이 모델들은 대형 교사 모델(Teacher Model)로부터 지식 증류(Knowledge Distillation)를 통해 학습하는데, 교사 모델이 방대한 어휘 크기(Vocabulary Size)를 사용하기 때문에 학생 모델(Student Model)인 소형 모델도 이에 맞는 대형 임베딩 레이어를 갖게 된다. 결국 모델의 실제 “지능”을 담당하는 부분보다 어휘를 표현하는 테이블이 더 많은 공간을 차지하는 아이러니한 구조가 만들어진다.
LFM2 아키텍처 — 온디바이스 프로파일링에서 탄생한 설계
Liquid Foundation Model 2(LFM2) 아키텍처는 앞서 지적한 비효율을 의식적으로 극복하려는 시도의 산물이다. Labonne에 따르면, LFM2의 임베딩 레이어는 전체 파라미터의 약 10% 수준에 불과하며, 나머지 약 90%가 실질적인 연산에 활용되는 유효 파라미터다. 경쟁 모델들과 비교하면 이 수치의 차이가 얼마나 극적인지 명확해진다. 아키텍처 구성 자체는 역시 하이브리드 방식으로, Short Convolution과 GQA를 결합한 구조를 채택했다.
LFM2가 특별한 진짜 이유는 이 아키텍처를 어떻게 설계했느냐에 있다. Liquid AI는 이론적인 FLOPs 계산보다 실제 타겟 하드웨어에서의 직접 프로파일링(On-device Profiling)을 통해 아키텍처를 최적화하는 방식을 선택했다. AMD Ryzen AI Max+ 395와 Samsung Galaxy S25 Ultra를 대표 타겟 디바이스로 설정하고, 실제 추론 성능을 직접 측정하며 최적의 연산자(Operator)를 선별했다. 이 과정에서 도출된 핵심 구성 요소가 바로 게이티드 쇼트 컨볼루션 블록(Gated Short Convolution Block)이다.
02:56 - Short Convolution과 Sliding Window Attention, Gated Linear Attention, GQA 등 연산자 간 비용 비율(Cost Ratio) 비교 차트
Short Convolution은 슬라이딩 윈도우 어텐션을 비롯한 모든 대안적 연산자 대비 월등히 낮은 비용 비율을 보였으며, 이는 지연 민감성이 핵심인 엣지 환경에 최적화된 선택이었다. 실제 하드웨어 프로파일링 결과에서도 LFM2 아키텍처는 CPU 환경에서 타 모델 대비 빠른 속도와 낮은 메모리 사용량을 동시에 달성했으며, GPU 환경에서도 높은 동시 접속(Concurrency) 수준에서 높은 처리량을 유지하는 것이 확인되었다.
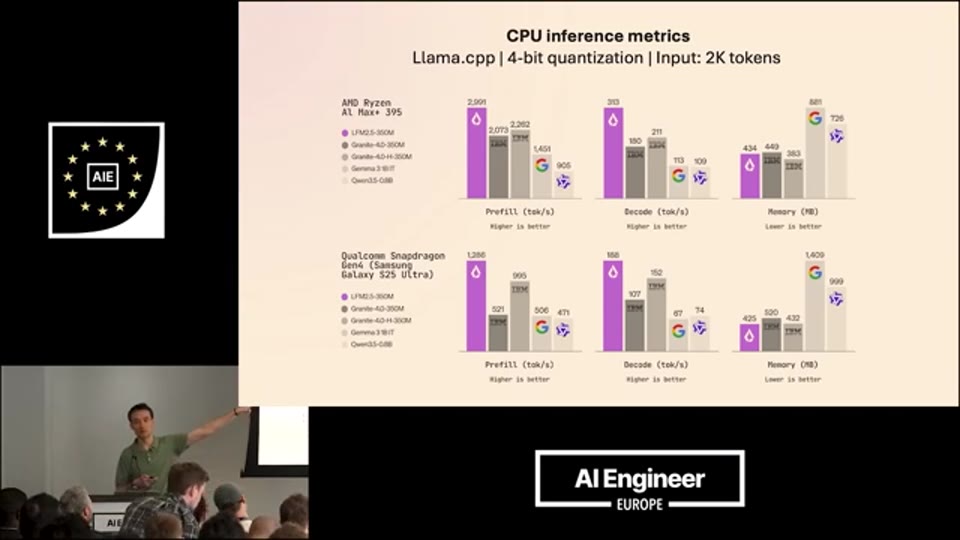
05:43 - AMD Ryzen AI Max+ 395와 Samsung Galaxy S25 Ultra에서의 실제 추론 프로파일링 결과 - LFM2의 속도 및 메모리 효율 비교
훈련 전략 — Chinchilla 스케일링 법칙을 초과하는 이유
LFM2.5의 훈련 파이프라인은 단계(Stage) 측면에서는 대형 모델과 크게 다르지 않다. 28조(Trillion) 토큰 규모의 사전 훈련(Pre-training) 및 중간 훈련(Mid-training)을 거쳐, 지도 미세 조정(SFT), 선호도 정렬(Preference Alignment), 강화 학습(Reinforcement Learning)으로 이어지는 표준적인 구조다.
여기서 주목할 지점은 350M 파라미터짜리 모델을 28조 토큰으로 훈련한다는 사실이다. 널리 알려진 Chinchilla 스케일링 법칙(Scaling Laws)에 따르면, 350M 파라미터 모델의 계산 최적(Compute-Optimal) 훈련 토큰 수는 고작 수십억 정도여야 한다. 이를 수백 배 초과하는 28조 토큰으로 훈련하는 것은 “낭비”처럼 보일 수 있지만, Labonne는 이것이 실제로 효과가 있다고 강조한다 — 사전 훈련 토큰을 늘릴수록 소형 모델의 성능이 계속 향상된다는 것이 실험으로 확인되었기 때문이다.
이를 뒷받침하는 이론적 근거도 제시된다. 강연자는 테스트 타임 스케일링 법칙(Test-Time Scaling Laws)에 관한 최근 논문을 언급하며(저자명은 STT 오인식으로 불확실), 이 새로운 스케일링 법칙에 따르면 LFM2.5-350M조차 아직 최적보다 적은 토큰으로 훈련된 상태이며 더 많은 투자가 가능함을 시사한다고 소개한다. 이는 특히 소형 모델 연구자들에게 희소식인데, 대형 모델에 비해 훈련 비용 자체가 극도로 저렴하기 때문에 막대한 토큰 규모의 사전 훈련이 경제적으로 실현 가능하기 때문이다.
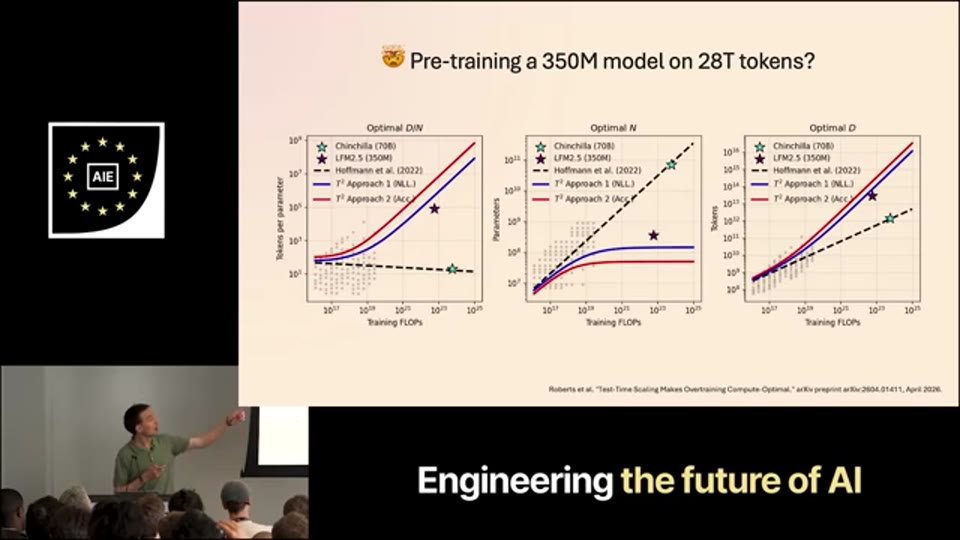
07:10 - Chinchilla 스케일링 법칙과 새롭게 제안된 테스트 타임 스케일링 법칙 비교 그래프, LFM2.5-350M 위치 표시
이러한 적극적인 사전 훈련 투자의 결과로, LFM2.5 350M은 이전 버전인 LFM2 350M 대비 다양한 벤치마크에서 눈에 띄는 성능 향상을 보였다. GPQA Diamond로 측정하는 지식 능력, IFEval 기반의 지시 따르기 능력, 데이터 추출 벤치마크, BFCL(Berkeley Function Calling Leaderboard)과 Tau-Bench를 통한 도구 사용(Tool Use) 능력이 그 평가 축이다. 중요한 것은, 이 모델이 데이터 추출과 도구 사용이라는 특정 영역에 집중적으로 최적화되어 있다는 점이다. 수학이나 코드 생성에서 최고 성능을 내는 것이 목표가 아니며, 사용자들이 실제로 이 크기의 모델을 그런 목적으로 사용하지 않는다는 것이 그 이유다. 이는 소형 모델 설계 철학의 핵심, 즉 “모든 것에서 평균”이 아니라 “중요한 것에서 최고”를 추구하는 방식의 실천이다.
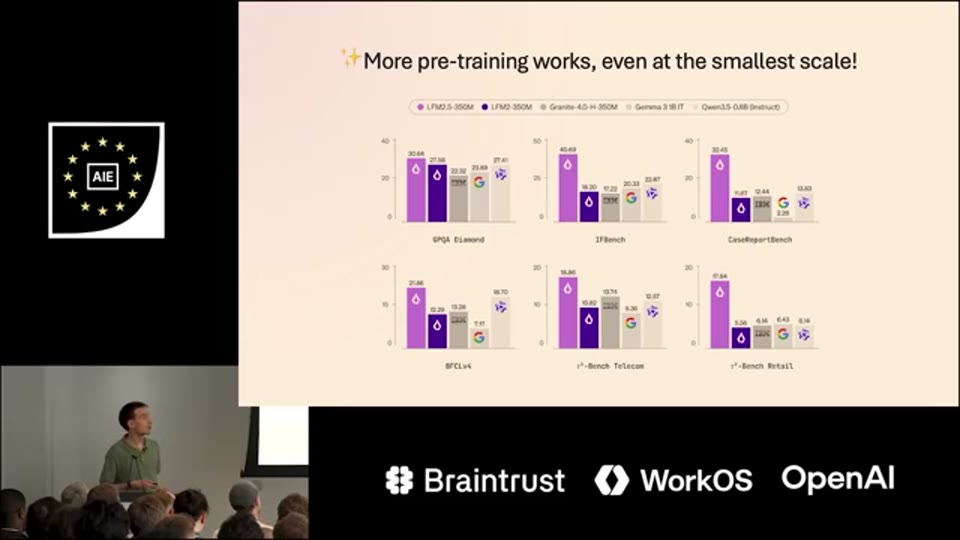
07:53 - LFM2.5 350M과 LFM2 350M의 GPQA Diamond, IFEval, BFCL, Tau-Bench 등 다양한 벤치마크 성능 비교
소형 모델 포스트 트레이닝의 핵심 — 단계보다 방법이 다르다
소형 모델과 대형 모델의 포스트 트레이닝(Post-training) 파이프라인은 단계 구성에서는 사실상 차이가 없다. 진짜 차이는 각 단계를 어떻게 수행하느냐에 있다.
지도 미세 조정(Supervised Fine-Tuning, SFT) 단계에서는 태스크의 범위를 최대한 좁게 가져가는 것이 핵심이다. 가령 특정 API 함수를 호출하는 단일 기능에만 집중하는 파인튜닝은 소형 모델에 매우 효과적인 접근법이다. 좁게 정의할수록, 구체적으로 설계할수록 성능이 향상된다는 것이 Labonne의 관찰이다. 이는 일반적인 포스트 트레이닝뿐 아니라 Hugging Face에서 베이스 모델을 받아 특정 유스케이스에 파인튜닝하는 실무 상황에서도 동일하게 적용된다.
선호도 정렬(Preference Alignment) 단계에서 Liquid AI는 Policy Length Normalized DPO(정책 길이 정규화 직접 선호도 최적화)라는 자체 알고리즘을 활용한다. 강연자는 선호도 정렬이 단순히 특정 벤치마크 점수를 높이는 것이 아니라 모델의 전반적인 품질을 향상시킨다고 강조한다. 응답의 자연스러움, 적절성, 사용감 등 정성적으로 체감할 수 있는 부분들이 선호도 정렬을 통해 개선되며, 이는 대형 모델과 소형 모델 모두에서 일관되게 나타나는 효과다.
강화 학습(Reinforcement Learning, RL)은 소형 모델에서도 극도로 효과적인 기법으로, Labonne는 이것이 “어디서나 사용하는 매우 중요한 기법”이라고 표현할 정도로 강조한다. 다만 RL은 본질적으로 협소한 환경에 집중하는 특성이 있기 때문에, 최대한 다양한 환경과 태스크를 포함시켜 모델이 잘 일반화되도록 유도하는 것이 중요하다. 또한 소형 모델에서 특히 두드러지는 점은 SFT 데이터와 RL의 관계다. RL 과정에서 특정 태스크가 잘 학습되지 않는다면, 이는 SFT 데이터에 해당 태스크에 대한 콜드 스타트(Cold Start) 샘플이 부족하다는 신호일 가능성이 높다. 이 경우 SFT 단계로 되돌아가 관련 데이터를 보강한 뒤 RL을 재시도하는 것이 효과적인 디버깅 전략이 된다.
둠 루핑(Doom Looping) — 소형 모델의 고질적 문제와 두 가지 해법
소형 추론(Reasoning) 모델을 어려운 태스크에 적용할 때 빈번하게 발생하는 독특한 문제가 있다. 바로 둠 루핑(Doom Looping)이다. 이는 모델이 특정 단어나 구절을 무한히 반복하며 절대 멈추지 않는 현상으로, 세 가지 조건이 겹칠 때 가장 극심해진다 — 모델 크기가 작을 때, 추론 모드로 동작할 때, 그리고 태스크가 모델의 능력 한계에 가까울 때. 이 세 조건이 동시에 만족되는 “작은 추론 모델에 매우 어려운 수학 문제”가 둠 루핑의 완벽한 발생 환경이다.
Liquid AI는 이 문제를 해결하기 위해 두 가지 독립적인 접근법을 개발하고 이를 조합하여 사용한다.
첫 번째 해결책: DPO 단계의 온-폴리시 데이터 생성
약 100만 개의 프롬프트에서 시작하여, 정책 모델(Policy Model)로 온도 샘플링(Temperature Sampling)을 사용해 5개의 롤아웃(Rollout)을 생성한다. 온도 샘플링의 다양성 덕분에 5개 중 적어도 하나는 둠 루프에 빠지지 않고 완성될 가능성이 높다. 동시에, 온도를 0으로 설정한 결정론적(Deterministic) 방식으로 하나의 추가 롤아웃을 생성하는데, 이 결과물은 둠 루프에 빠질 가능성이 높다. 이렇게 생성된 모든 롤아웃을 LLM 심사단(LLM Jury)이 평가하고, 최고 점수의 응답을 “선택된 답변(Chosen)”, 최저 점수의 응답(대개 둠 루프 포함)을 “거부된 답변(Rejected)“으로 지정하여 DPO 훈련을 진행한다. 이 방식은 모델이 둠 루프 패턴을 명시적으로 학습에서 배제하도록 유도한다.
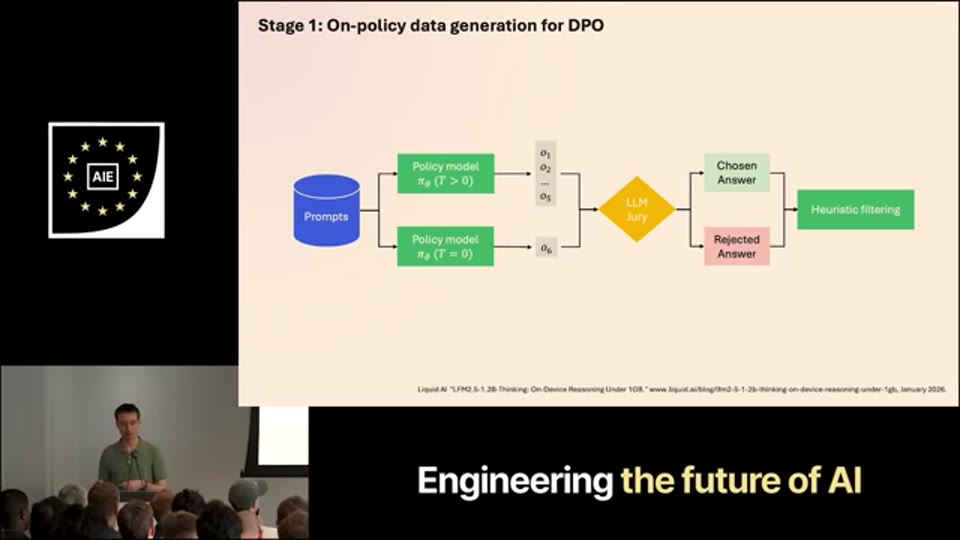
11:50 - 온-폴리시 DPO 데이터 생성 파이프라인 구조도 (프롬프트 → 온도 샘플링 롤아웃 5개 + 온도 0 롤아웃 1개 → LLM Jury → Chosen/Rejected)
두 번째 해결책: 검증 가능한 보상을 활용한 강화 학습
수학 문제처럼 정답이 명확한 태스크에서는, 모델이 최종 답을 도출하지 못하면 양의 보상(Positive Reward)을 받을 수 없다. 둠 루프에 빠진 응답은 자연스럽게 보상을 받지 못하게 되어, 이것이 암묵적인 패널티로 작용한다. 여기에 N-그램 반복 패널티(N-gram Repetition Penalty)를 추가적으로 적용하여 반복 생성을 직접 억제한다. RL에서도 마찬가지로 온도 샘플링을 사용하여 롤아웃의 다양성을 확보하며, 이것이 둠 루프 발생 확률 자체를 낮추는 데 기여한다.
이 두 가지 해결책의 실제 효과는 수치로 증명된다. LFM 2.5 1.2B 추론 모델을 기준으로 각 훈련 단계별 둠 루프 비율을 추적했을 때, 중간 훈련(Mid-training) 직후 약 15~16%에 달했던 비율이 SFT 단계를 거친 후에는 거의 변하지 않았다. SFT만으로는 이 문제를 해결할 수 없음을 보여주는 결과다. 그러나 DPO(첫 번째 해결책) 적용 후 비율이 눈에 띄게 감소했고, 이어진 RL(두 번째 해결책) 적용 후에는 문제가 거의 사라졌다.
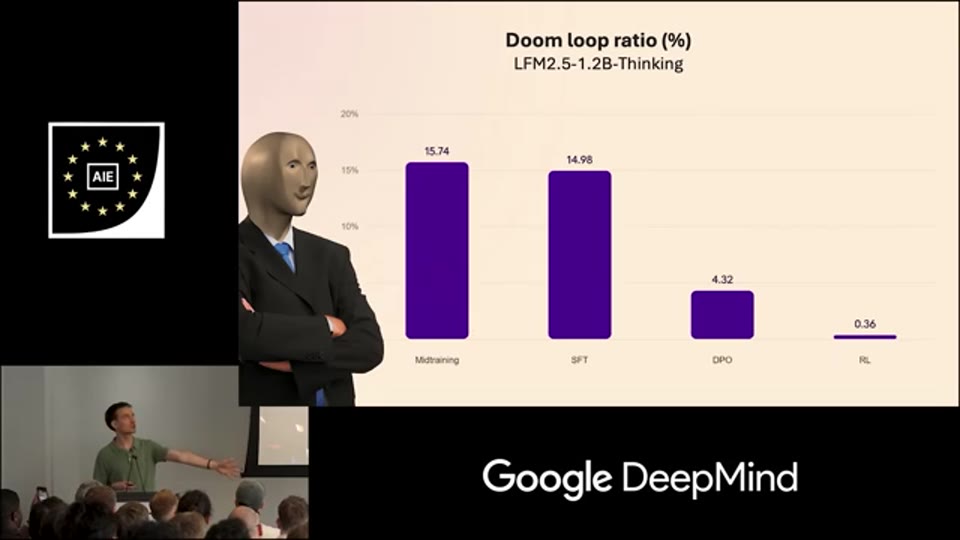
14:19 - LFM 2.5 1.2B 추론 모델의 Mid-training → SFT → DPO → RL 단계별 둠 루프 비율 감소 그래프
대조적인 사례로 Qwen 3.5 0.8B 추론 모드를 들었는데, 이 모델은 커뮤니티에서 50% 이상의 둠 루프 비율로 광범위한 불만이 제기되고 있다고 한다. 이는 대형 모델을 단순히 축소하는 방식의 근본적인 한계를 보여주는 사례이며, 소형 모델의 고유한 문제를 별도로 체계적으로 대응하는 접근법이 왜 필요한지를 역설적으로 증명한다.
소형 모델의 미래 — 에이전틱 AI가 열쇠다
강연의 마지막 부분에서 Labonne는 소형 모델의 가장 유망한 활용 방향으로 에이전틱 AI(Agentic AI)를 제시하며, 이것이 현재 가장 과소 탐색된 영역이라고 강조한다.
소형 모델이 가진 낮은 지식 용량과 높은 할루시네이션 경향이라는 약점은, 웹 검색 도구를 제공하는 것만으로도 상당 부분 해소될 수 있다. 모델이 모든 지식을 내부 파라미터에 저장할 필요 없이, 지식이 필요할 때마다 외부 도구를 활용해 실시간으로 검색하고 활용하는 에이전트 방식이 소형 모델의 약점을 가장 효율적으로 보완하는 전략이다. 짧은 컨텍스트 길이(Context Length) 한계 역시 재귀적 언어 모델 환경(Recursive Language Model Environment)에서 Python 같은 프로그래밍 언어를 활용하면 우회할 수 있다고 덧붙였다.
Labonne는 경험적으로 소형 모델이 에이전틱 태스크에 특히 강점을 보인다고 주장한다. 에이전틱 환경에서 실제로 중요한 것은 방대한 내장 지식이 아니라, 도구를 신뢰성 있게 사용하기 위한 추론 능력이기 때문이다. 대형 모델을 사용한 에이전틱 워크로드가 주로 논의되고 있지만, 이것이 반드시 최적의 선택인 것은 아니며, 목적에 맞게 최적화된 소형 에이전트 모델이 경우에 따라 훨씬 더 나은 비용 대비 성능을 제공할 수 있다는 것이 그의 핵심 주장이다.
Q&A — 실무 적용 관점의 추가 인사이트
강연 후 진행된 질의응답에서 소형 모델의 실제 적용 기준에 대한 질문이 나왔다. Labonne는 세 가지 상황을 소형 모델 선택의 주요 기준으로 제시했다. 첫째, 안정적인 인터넷 연결이 불가능한 환경(예: 자동차 내 배포)이다. 둘째, 지연(Latency)이 매우 민감한 워크로드로, 로컬에서 실행되는 소형 모델이 항상 우위를 가진다. 셋째, 금융이나 의료 같은 규제 환경에서의 데이터 프라이버시 요구사항이다.
또한 “RL을 통해 훈련된 대형 모델의 둠 루프 방지 능력을 증류(Distillation)로 소형 모델에 전이할 수 있는가”라는 날카로운 질문도 제기되었다. 이에 대해 Labonne는 회의적인 견해를 밝혔다. 단순 증류는 본질적으로 SFT에 가까운 방식이기 때문에, 둠 루프 문제를 완전히 해결하기 어려울 것이라고 보았다. Top-K 샘플링과 N개의 롤아웃 방식을 적용하더라도, RL을 소형 모델에 직접 적용하는 것에 비해 효과가 제한적일 것으로 예상했다.
마무리 / 핵심 정리
이 강연에서 Maxime Labonne가 전달하는 핵심 메시지는 단순하지만 강렬하다. 소형 언어 모델은 대형 모델의 열등한 사본이 아니며, 그렇게 접근해서도 안 된다는 것이다. 메모리 제약, 낮은 지식 용량, 높은 지연 민감성이라는 세 가지 특성이 만들어내는 도전들 — 비대한 임베딩 레이어, Chinchilla 법칙을 넘어서는 훈련 전략, 둠 루핑 문제 — 은 모두 소형 모델만의 고유한 문제이며, 이를 해결하기 위해서는 전용 접근법이 필요하다.
온디바이스 프로파일링을 통한 하드웨어 최적화 아키텍처 설계, 28조 토큰에 달하는 대규모 사전 훈련, LLM Jury 기반의 DPO와 검증 가능한 보상을 활용한 RL의 조합을 통한 둠 루프 해결은 모두 이 철학의 구체적인 실천이다. 그리고 이 모든 노력의 지향점은 에이전틱 환경에서 신뢰성 있게 도구를 활용하는 소형 모델이다. 지식은 외부에서 검색하고, 모델 내부에서는 추론만 잘하면 된다는 이 발상의 전환이 소형 모델 연구의 다음 프론티어를 가리키고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Everything I Learned Training Frontier Small Models — Maxime Labonne, Liquid AI |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-04-30 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Local Models - Trust, Control, Optimization - Carter Abdallah, NVIDIA
- The Base Model Is Dead — Varun Singh, Arcee AI
- Robotics — Cormac Brick, Google
- Data and Environment Curation for Post-Training LLMs — Mahesh Sathiamoorthy, Bespoke Labs
- Agents at Scale - Inside MiniMax’s Model and the Infrastructure Behind It - Olive Song