Fast Models Need Slow Developers
📺 원본 영상: Fast Models Need Slow Developers — Sarah Chieng, Cerebras 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-23 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다. 강연자 이름은 STT에서 “Sarah Chang”으로 인식되었으나, 영상 제목 기준 “Sarah Chieng”으로 교정하였습니다.
개요
Cerebras의 개발자 경험(Developer Experience) 총괄 Sarah Chieng은 이 강연에서 하나의 도발적인 명제를 던진다. 모델이 빨라질수록, 개발자는 오히려 더 신중해져야 한다는 것이다. Cerebras와 OpenAI가 공동 출시한 코딩 모델 Codex Spark는 초당 1,200토큰(tokens/sec)을 생성하는데, 이는 기존 Claude Sonnet이나 GPT 계열이 보여주던 초당 40~60토큰과 비교하면 약 20배에 달하는 속도다. 강연은 이 새로운 속도의 시대가 단순히 “더 빠른 자동완성”을 의미하는 것이 아니라, 개발자의 사고방식과 워크플로우 전체를 근본적으로 재설계해야 하는 변곡점임을 역설한다.
왜 지금 갑자기 이렇게 빨라졌는가 - AI 추론 스택 전반의 최적화
속도 향상이 단숨에 이루어진 것처럼 보이지만, 실제로는 AI 추론(inference) 스택의 모든 계층이 동시에 최적화되면서 누적된 결과다. Sarah Chieng은 이를 하드웨어, 모델 아키텍처, 추론 최적화라는 세 계층으로 나누어 설명한다.
하드웨어 - 메모리 장벽을 부수다
AI 추론의 지연 시간(latency) 중 50~80%는 메모리 이동(memory movement)에서 발생한다. 이것이 바로 “메모리 장벽(Memory Wall)” 문제다. 전통적인 NVIDIA GPU 아키텍처에서 모델의 가중치(weights)와 KV 캐시(KV cache) 값은 칩 외부의 HBM(High Bandwidth Memory)에 저장되기 때문에, 추론이 실행될 때마다 이 데이터를 칩으로 불러오는 데 막대한 시간이 소요된다.
이 병목을 정면 돌파하는 방식으로 Cerebras와 Groq 같은 신흥 하드웨어 기업들이 등장했다. 예컨대 Cerebras는 웨이퍼(wafer) 전체에 걸쳐 SRAM을 분산 배치하여 모든 코어가 필요한 데이터에 직접 접근할 수 있게 설계했다.
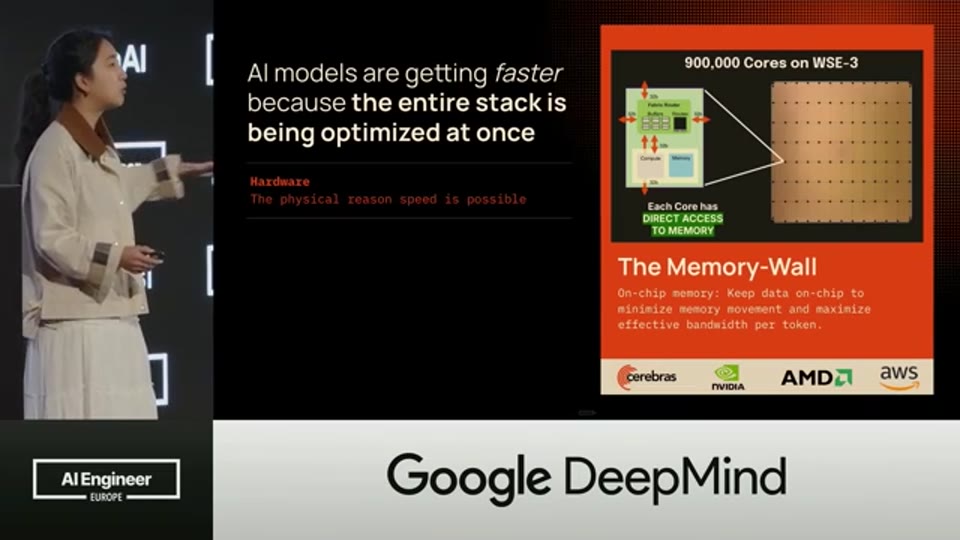
04:24 - Cerebras 웨이퍼 구조 다이어그램 - SRAM이 칩 전체에 분산 배치된 메모리 아키텍처 설명
여기에 더해, 최근 수개월 사이 상업화가 급속히 진행된 **분리형 추론(Disaggregated Inference)**이 또 다른 게임 체인저로 부상했다. 이것이 NVIDIA가 Groq을 200억 달러에 인수한 핵심 이유이기도 하다. 기존의 추론은 두 단계—프리필(pre-fill)과 디코드(decode)—가 동일한 하드웨어에서 실행되었다. 프리필은 사용자 입력 토큰 전체를 병렬로 처리하는 단계로 연산량(compute)이 집중되는 반면, 디코드는 출력 토큰을 하나씩 순차 생성하는 단계로 메모리 대역폭(memory bandwidth)에 의존한다. 두 단계의 요구사항이 근본적으로 다른데도 같은 하드웨어에서 처리했던 것이다. 분리형 추론은 이 두 단계를 서로 다른 하드웨어에 분리해 각자 최적화하는 방식으로, Cerebras와 AWS의 파트너십 역시 이 방향성을 따르고 있다.
05:37 - 분리형 추론(Disaggregated Inference) 다이어그램 - pre-fill과 decode를 각각 최적화된 하드웨어로 분리하는 구조
모델 아키텍처 - 필요한 전문가만 깨운다
하드웨어가 물리적 병목을 줄이는 동안, 모델 아키텍처 차원에서도 중요한 진화가 진행 중이다. 대표적인 예가 혼합 전문가(MoE, Mixture of Experts) 아키텍처다. 전통적인 모델은 모든 토큰 생성 시 전체 파라미터를 활성화하지만, MoE는 매 토큰마다 일부 “전문가(expert)” 서브네트워크만 선택적으로 활성화한다. 덕분에 훨씬 큰 모델의 지능을 훨씬 작은 모델의 연산 비용으로 구현할 수 있다.
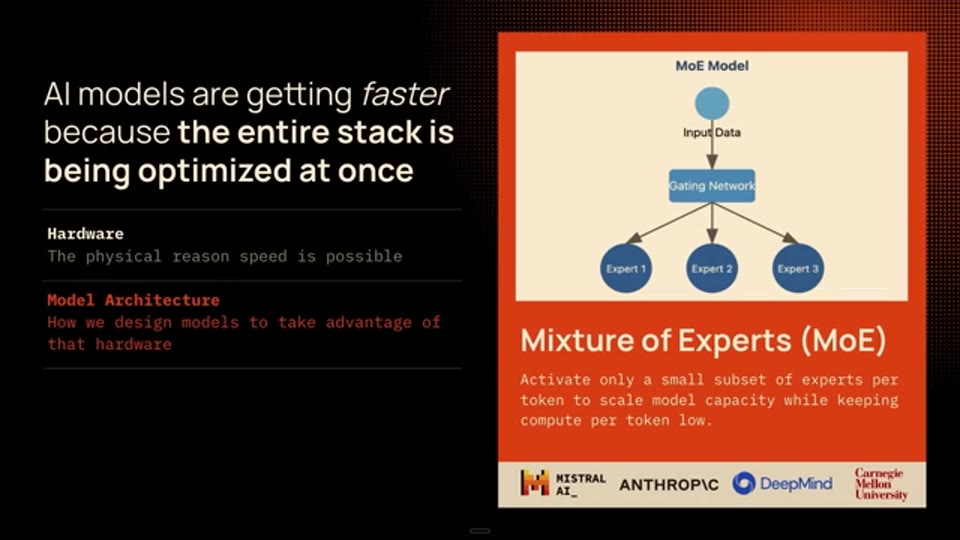
05:54 - 혼합 전문가(Mixture of Experts) 모델 아키텍처 슬라이드
여기서 더 나아가 **REAP(Router-Weighted Expert Activation Pruning)**이라는 기법도 등장했는데, 이는 실제로 거의 활성화되지 않는 전문가들을 아예 가지치기(pruning)하여 모델을 더욱 경량화하는 접근이다. 결국 아키텍처 수준에서의 핵심 과제도 “메모리를 어떻게 줄일 것인가”로 귀결된다.
추론 최적화 - KV 캐시 재활용
스택의 최상위 레이어에는 Together, Modal, Fireworks 등 여러 추론 최적화 전문 기업들이 활동하고 있다. 이 계층에서 가장 중요한 기법 중 하나가 **KV 캐시 재사용(KV cache reuse)**이다. 이미 처리된 토큰 표현을 저장하고 재활용함으로써 매 생성 단계마다 전체 시퀀스에 대한 어텐션(attention)을 재계산하는 비용을 피할 수 있다.
개발자의 나쁜 습관 - 20배 빠른 불량 코드가 온다
Sarah Chieng은 기술적 분석을 마친 뒤 곧바로 핵심 경고를 꺼낸다. 이전까지 우리 개발자들이 느린 AI 코드 생성 속도에 맞춰 형성해온 나쁜 습관들이 이제 치명적인 규모로 확대될 수 있다는 것이다. 그 대표적인 습관으로는 거대한 프롬프트로 원샷(one-shot) 시도하기, 방대한 커밋 한 번에 밀어 넣기, 열 개의 에이전트를 동시에 띄워놓고 누군가 알아서 해주길 기다리기 등이 있다.
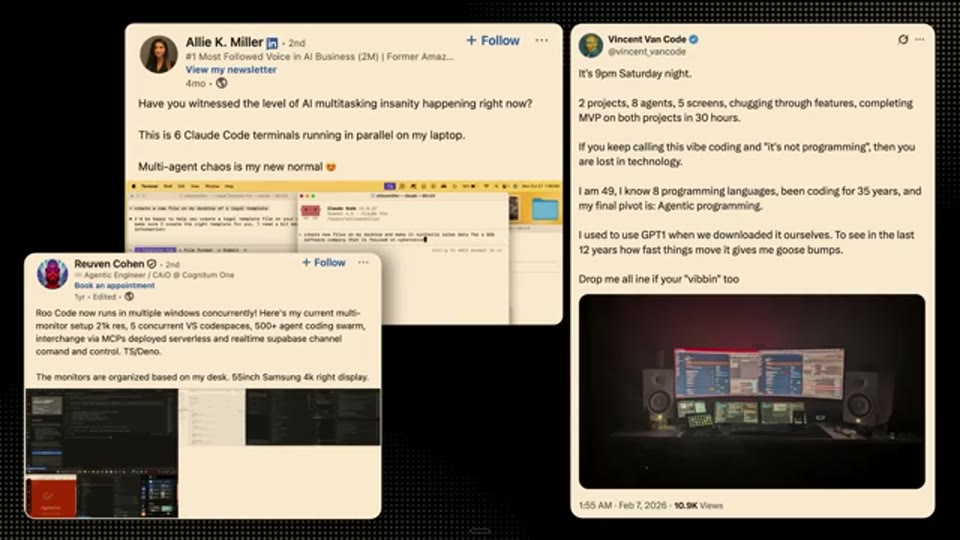
07:13 - 트위터/LinkedIn의 극단적 멀티에이전트 개발 설정 사례 화면 - 6개 Claude Code 터미널, 500+ 에이전트 군집 등
강연자에 따르면, 이런 설정의 실제 현실은 “아무도 검증하지 않는 막대한 양의 코드가 쏟아지는 것”이다. 초당 50토큰으로 불량 코드를 생성하던 시대는 그나마 속도가 방파제 역할을 했다. 그러나 초당 1,200토큰 시대에 동일한 습관을 유지한다면, 우리는 전례 없는 속도로 기술 부채(technical debt)를 쌓게 된다. 그리고 그 부채가 얼마나 쌓였는지조차 파악하지 못하는 상황에 빠질 것이다.
실전 플레이북 - 빠른 모델 시대의 개발자 워크플로우
강연의 핵심부는 이 새로운 현실에서 개발자가 취해야 할 구체적인 행동 지침들로 구성된다.
1. 모델 역할 분리 - 계획자와 실행자를 구분하라
지금까지 우리가 AI 코딩 모델을 선택할 때 고려했던 기준은 주로 두 가지, 즉 **지능(intelligence)**과 **비용(cost)**이었다. 그러나 이제는 세 번째 축인 **속도(speed)**가 20배 격차로 등장했다. 이에 Sarah Chieng이 제안하는 실용적인 멘탈 모델은 역할 분리다.
GPT-4.5 계열처럼 더 크고 사려 깊은 모델은 장기 계획 수립, 복잡한 아키텍처 결정, 상위 수준의 설계에 활용하고, Codex Spark 같은 초고속 모델은 그 계획을 단계별로 실제 실행하는 데 투입한다. 구체적인 예를 들면, GPT-4 계열 모델에게 전체 개발 계획을 생성하도록 하고, 그 계획에 따라 분기된 서브에이전트들을 Codex Spark로 구동해 각 단계를 빠르게 처리하는 방식이다.
더 나아가, 성공적인 세션의 궤적을 “스킬(skill)“로 포착해 재활용하는 방법도 제안된다. 고성능 모델이 어렵고 복잡한 작업을 한 번 해낸 경로를 캡처해 검증 가능하고 반복 가능한 워크플로우로 만들어 두면, 이후에는 더 빠른 에이전트가 그 궤적을 배경에서 반복 실행할 수 있다.
2. 검증을 무료로 - 모든 단계에 품질 게이트를 삽입하라
강연자에 따르면, 초당 1,200토큰이라는 속도는 검증(validation)을 사실상 **비용 제로(free)**로 만든다. 이전에는 속도가 느리다는 이유로 생략하거나 마지막에 몰아서 했던 품질 검사들—테스트 스위트(test suite), 린팅(linting), 프리커밋 훅(pre-commit hook), diff 리뷰(diff review), 브라우저 기반 QA 자동화 등—을 이제는 워크플로우의 매 단계에 상시 삽입할 수 있다. 코드를 푸시하기 직전에야 허겁지겁 돌리는 것이 아니라, 체크리스트의 각 항목이 완료될 때마다 자동으로 실행되도록 구조화하면 된다. 느려서 못 했다는 변명이 더 이상 통하지 않는 시대가 된 것이다.
3. 탐색과 선별 - 다양성에서 취향을 끌어내라
빠른 모델이 열어주는 또 하나의 완전히 새로운 가능성은 **대규모 탐색 후 선별(exploration and cherry-picking)**이다. 이전에는 하나의 결과를 기다리는 데도 시간이 걸렸기 때문에 여러 버전을 동시에 생성하는 것은 비현실적이었다. 그러나 이제는 네비게이션 바 하나를 구현할 때, 단일 결과 대신 같은 시간 안에 15개의 버전을 생성하고 그 중 가장 마음에 드는 것을 고를 수 있다. 여기서 5개의 서브에이전트가 각각 15개씩 생성한다면 단 한 번의 작업으로 75개의 후보군이 만들어진다.
강연자가 이 접근법을 특히 흥미롭게 보는 이유는, 이것이 AI 출력에 **취향(taste)**을 인위적으로 주입하는 효과적인 방법이 되기 때문이다. 모델이 스스로 취향을 갖지 못한다는 것은 공공연한 사실이다. 지금까지의 우회책은 개발자가 직접 예시를 만들어주거나, 사실상 작업을 직접 완성하는 수준의 상세한 프롬프트를 작성하는 것이었다. 대규모 생성 후 선별은 이 두 가지 부담을 동시에 줄이면서 더 나은 결과물을 얻는 방법이다. 연구 방향 탐색, 아키텍처 옵션 비교, 그래픽 디자인 등 다양성이 가치 있는 분야라면 어디에든 적용할 수 있다.
4. 실시간 협업 - 자리를 떠나지 마라
“에이전트 띄워놓고 햄버거 먹으러 가는” 시대는 끝났다. 초고속 모델은 개발자와 AI 사이의 상호작용 방식을 근본적으로 바꾼다. 이제는 한 명의 동료 프로그래머와 나란히 앉아 실시간으로 협력하듯 모델과 일할 수 있다. 이는 단순한 비유가 아니라 문자 그대로의 실시간 협업이다.
강연자는 개발자가 이 협업에서 반드시 주도권을 쥐어야 한다고 강조한다. 레포지토리 전체의 컨텍스트를 수집하게 하고 동작 방식을 직접 물어보는 것, 어떤 구현 결정을 내릴지 AI가 제안하되 최종 판단은 개발자가 내리는 것—이 방향성이 중요하다. AI가 개발자의 결정을 돕는 것이지, 그 역전이 일어나면 안 된다는 것이다.
5. 슬롭(Slop) 회피 - 에이전트에게 제약을 줘라
“슬롭(slop)“은 과도하게 생성된, 아무도 검토하지 않은 저품질 AI 코드를 가리키는 표현으로, 강연자도 이 단어가 이미 업계에서 남용되고 있다는 것을 인식하면서도 다루지 않을 수 없는 주제라고 언급한다. 슬롭을 막는 핵심은 에이전트 행동에 명확한 제약을 부여하는 것이다.
파일 삭제 금지, 최대 diff 크기 제한, 읽기·쓰기만 허용 같은 권한 제어뿐 아니라, “이 부분만 변경해라”, “타입은 아직 건드리지 마라”, “그 구현은 맞지 않았으니 다시 하자”와 같은 능동적인 스티어링(steering)이 필요하다. 동시에 10개의 에이전트를 풀어놓는 대신 2~3개의 세션으로 집중하며 코드와 함께 앉아 있어야 한다. 누군가 코드에 대해 물었을 때 처음 읽어보는 상황이 되면 이미 늦은 것이다.
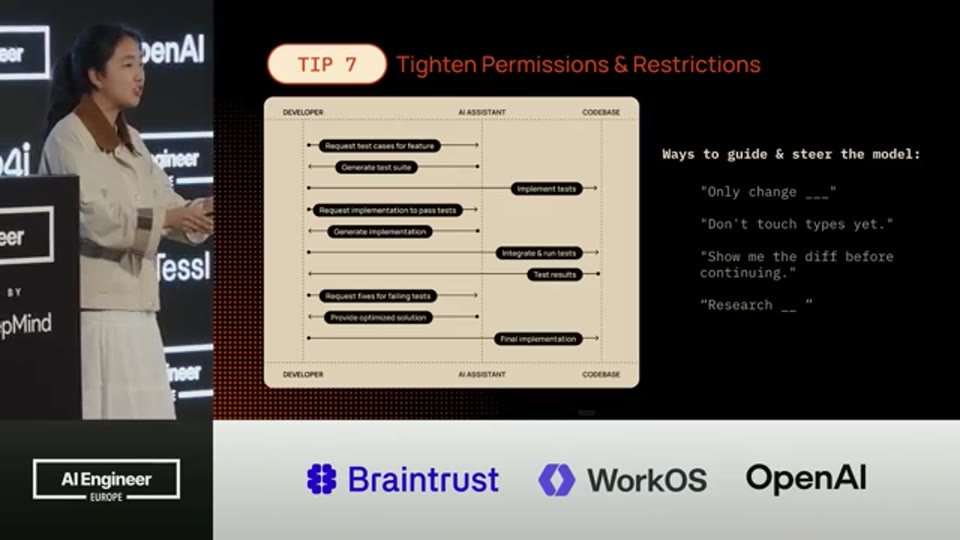
13:47 - 개발자-AI 에이전트-코드베이스 간 협업 구조 그래프
6. 자동 리팩토링 - 정리를 마지막으로 미루지 마라
검증과 마찬가지로, 코드 정리(refactoring)도 이제는 “커밋 직전에 한 번” 하는 이벤트가 아니라 상시 자동 실행되는 프로세스가 되어야 한다. 체크리스트의 각 작업이 완료될 때마다 모델에게 미사용 import 삭제, 불필요한 코드 라인 제거, 함수 구조 통일 등을 자동으로 처리하도록 워크플로우에 내장하면 된다. 초당 1,200토큰이라는 속도 앞에서 이 작업들의 비용은 사실상 0에 가깝다.
7. 컨텍스트 관리 - 네 개의 파일로 세션을 지탱하라
빠른 모델이 불러오는 예상치 못한 문제가 하나 있다. 컨텍스트 소진(context compaction)이 훨씬 빠르게 찾아온다는 것이다. 기존에 10분이 걸려서 컨텍스트가 꽉 찼다면, 20배 빠른 모델로는 30초 만에 같은 상황이 발생한다. 이제 컨텍스트 관리는 선택이 아닌 필수 습관이다.
강연자가 제시하는 핵심 원칙은 큰 작업을 작고 경계가 명확한 목표로 항상 쪼개라는 것이다.
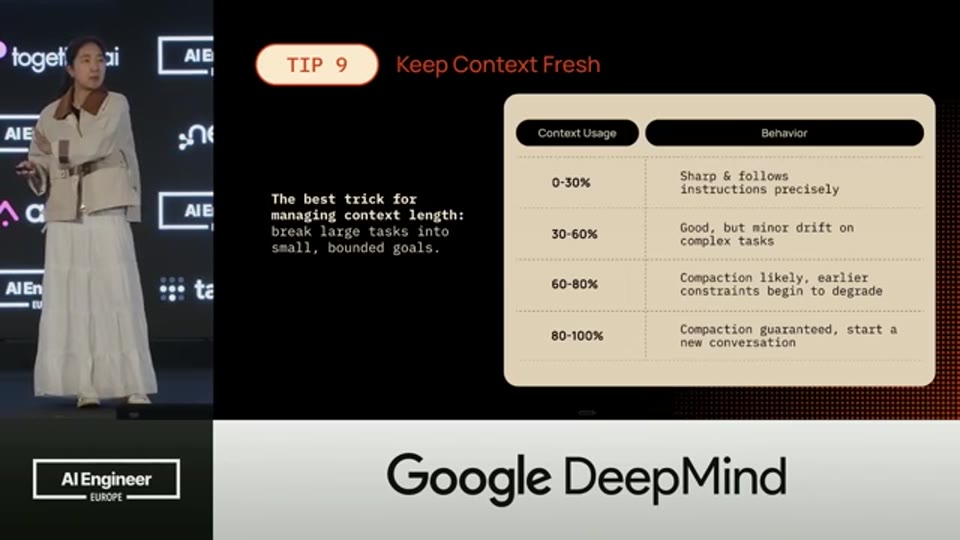
15:27 - 컨텍스트 사용률과 모델 행동 품질 간 상관관계 그래프 - 80~100% 구간 위험 영역 표시
이 원칙을 구체화한 시스템으로 강연자는 4개의 마크다운 파일을 사용한 외부 메모리 구조를 제안한다.
| 파일명 | 역할 |
|---|---|
AGENTS.md | 사용할 에이전트와 서브에이전트 정의 |
PLAN.md | 세션 시작 시 생성하는 전체 계획 및 단계별 체크리스트 |
PROGRESS.md | 완료된 작업과 남은 작업 현황 추적 |
VERIFY.md | 각 단계 완료 후 품질 확인에 사용하는 기준 |
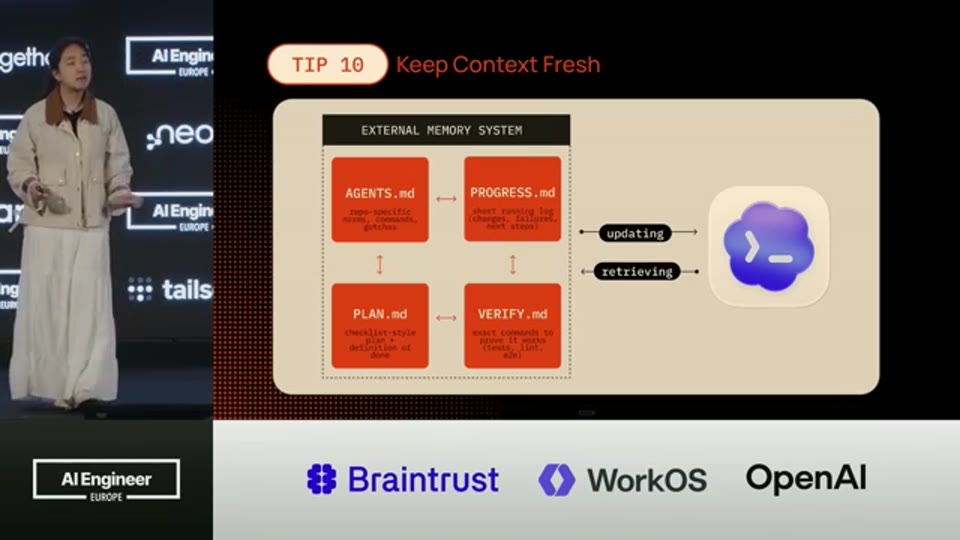
15:51 - 4파일 외부 메모리 시스템 다이어그램 - AGENTS.md, PLAN.md, PROGRESS.md, VERIFY.md 구조
이 구조의 핵심 가치는 세션 간 연속성이다. 새로운 에이전트 세션이 시작될 때 컨텍스트는 비어 있지만, PROGRESS.md를 읽는 것만으로 어디까지 진행됐는지 즉시 파악하고 다음 작업을 이어받을 수 있다. 고성능 GPT 계열 모델로 PLAN.md를 생성한 뒤, 이후 실행 단계는 Codex Spark 같은 빠른 모델에게 체크리스트를 하나씩 처리하도록 위임하는 방식이 대표적인 적용 예다.
마무리 / 핵심 정리
Sarah Chieng의 강연은 겉으로는 Codex Spark라는 특정 모델을 소개하는 자리처럼 보이지만, 본질은 훨씬 보편적인 메시지를 담고 있다. 모델 속도의 20배 도약은 기술적 이정표이기도 하지만, 동시에 개발자의 나쁜 습관을 20배로 증폭시키는 위험이기도 하다. 빠른 도구를 가졌다고 해서 좋은 결과가 보장되지는 않는다. 결국 품질을 결정하는 것은 개발자가 얼마나 신중하게 생각하고, 검증하고, 스티어링하느냐에 달려 있다.
강연자가 강조하는 것은 느리게 일하라는 것이 아니다. 빠른 모델이 선사하는 여유를 나쁜 코드를 더 빠르게 만드는 데 낭비하지 말고, 더 나은 검증과 더 세심한 협업에 투자하라는 것이다. 빠른 모델 덕분에 개발자 경험이 근본적으로 나아질 수 있고, 그 경험의 질을 결정하는 것은 결국 개발자 자신이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Fast Models Need Slow Developers — Sarah Chieng, Cerebras |
| 채널 | AI Engineer |
| 강연자 | Sarah Chieng, Head of Developer Experience, Cerebras |
| 리포트 작성 | 2026-05-23 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.