First Steps Toward Automated AI Research - Richard Socher CEO Recursive AI
📺 원본 영상: First Steps Toward Automated AI Research - Richard Socher, CEO Recursive AI
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-31
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Richard Socher는 이 강연에서 자동화된 AI 연구의 초기 단계를 “Eureka Machine”이라는 개념으로 설명한다. 그가 말하는 Eureka Machine은 단순히 더 똑똑한 챗봇이 아니라, 기존 지식 이해, 측정 데이터 활용, 시뮬레이션, 실제 실험을 연결해 과학 발견 자체를 자동화하려는 시스템이다. 강연의 핵심은 진화가 생물학에서 기술과 과학으로 이어졌듯이, 이제 AI 연구도 Recursive Self-Improvement(RSI, 재귀적 자기 개선)를 통해 새로운 성장 곡선을 만들 수 있다는 주장에 있다.
진화에서 출발한 자동 연구의 상상력
Socher는 강연의 출발점을 AI 모델이나 GPU가 아니라 진화로 잡는다. 진화는 35억 년에 걸쳐 박테리아, 식물, 어류, 양서류, 인간으로 이어지는 거대한 열린 탐색 과정이었고, 그는 이 과정이 “좋은 해답을 미리 설계하지 않고도” 복잡한 결과를 만들어낼 수 있음을 보여준다고 본다. 여기서 중요한 점은 진화가 한 번의 직선적 발전이 아니라, 수많은 변이와 선택이 반복되며 새로운 가능성 공간을 열어 왔다는 사실이다.
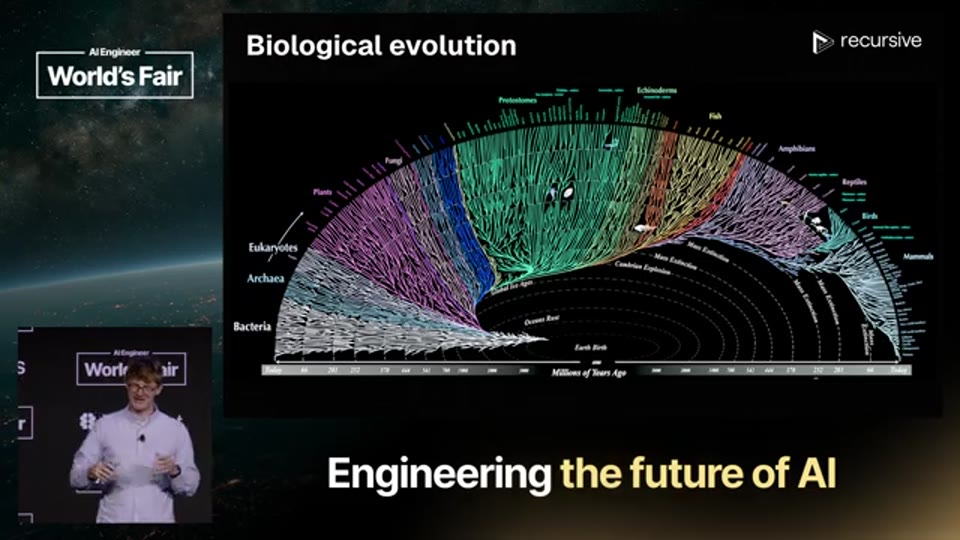
02:18 - 생물학적 진화의 장기 시간축을 보여주며 기술 발전과 연결하는 도입부 화면
이 관점은 기술사에도 연결된다. 인류는 사냥, 농업, 과학적 방법론, 계몽주의, 산업혁명 같은 여러 기술적 전환을 통해 세계의 생산 능력과 인구 부양 능력을 키워 왔다. Socher는 이러한 변화가 단일한 지수 곡선이라기보다, 여러 개의 지수적 성장 곡선이 차례로 겹쳐지는 과정에 가깝다고 설명한다. 각각의 기술은 어느 시점에서 S-curve처럼 둔화될 수 있지만, 새로운 기술 패러다임이 등장하면 그 위에 또 다른 성장 곡선이 얹힌다는 것이다.
💡 [영상 참조] 강연자는 초반부에서 생물학적 진화와 기술 발전의 긴 시간축을 보여주는 슬라이드를 참조하며 설명한다. 음성만으로는 그래프의 세부 수치나 축 정보는 확인할 수 없으므로, 상세 내용은 원본 영상을 확인하는 편이 좋다.
기술 낙관론과 과학 발견의 병목
강연자는 Marc Andreessen의 Techno-Optimist Manifesto를 언급하며, 경제 전체에서 지속적인 성장의 원천은 기술이라는 관점을 소개한다. 그는 모든 문제를 기술로 환원할 수 있다고 말하는 것은 아니지만, 적어도 굶주림, 어둠, 추위, 더위 같은 물질적 문제들은 역사적으로 더 나은 기술을 통해 해결되어 왔다고 본다. 이 대목에서 그의 논리는 명확하다. 더 많은 과학은 더 많은 기술로 이어지고, 더 많은 기술은 더 큰 성장과 인간 번영으로 이어질 가능성이 높다는 것이다.
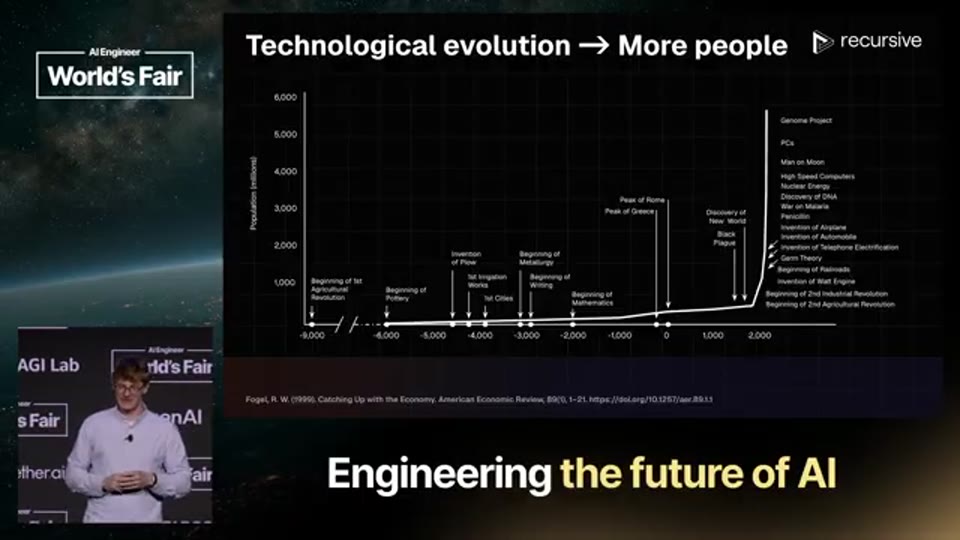
03:38 - 기술 발전과 인구 증가, 인간 번영의 관계를 설명하는 슬라이드 화면
그는 이 논리를 과학 발견의 규모 문제로 확장한다. 과학은 점점 세분화되고 있으며, 특정 하위 분야 하나를 깊게 파고들 수 있는 연구자의 수는 제한되어 있다. Stanisław Lem이 지적했던 것처럼 과학 자체가 기하급수적으로 확장되더라도, 각 좁은 영역에 충분한 사람이 배치되지 않으면 발견 속도는 결국 인력 병목에 부딪힌다. Socher에게 자동화된 과학 연구는 이 병목을 우회하기 위한 시도이며, Eureka Machine은 바로 그 문제의식에서 등장한다.
과학 이론도 선택 압력을 받는다
Socher는 Karl Popper의 과학철학을 끌어와 과학 이론의 발전을 진화와 유사한 과정으로 해석한다. 과학자는 이론, 가설, 설명을 제안하고, 그것을 경험적 검증에 노출시킨다. 살아남는 이론은 더 강한 설명력을 갖거나 더 혹독한 실험을 견뎌낸 이론이며, 이런 의미에서 과학 이론도 일종의 자연선택 과정을 거친다.
이 비유는 AI 자동 연구 시스템을 설계하는 데 중요한 힌트를 준다. 만약 AI가 새로운 가설을 만들고, 관련 문헌을 찾고, 실험을 설계하고, 결과를 검증할 수 있다면 과학의 진화적 압력을 기계적으로 가속할 수 있기 때문이다. 다만 강연자는 이 과정에 단순한 언어 생성만으로는 충분하지 않다고 본다. LLM이 이론 경쟁을 제대로 수행하려면 웹 검색, 데이터 접근, 실험 환경, 검증 체계가 모두 필요하며, 이는 곧 단일 모델이 아니라 도구를 사용하는 Agent System(에이전트 시스템)의 문제로 이어진다.
Eureka Machine의 네 가지 기둥
Socher가 제시하는 Eureka Machine은 과학 발견을 자동화하기 위한 거대한 시스템 아키텍처에 가깝다. 첫 번째 기둥은 이미 존재하는 지식의 이해다. AI가 새로운 발견을 하려면 인류가 지금까지 축적한 논문, 실험 결과, 이론, 기술 문헌을 읽고 구조화할 수 있어야 하며, 이 단계에서는 사람이 쓰던 검색 엔진이 아니라 AI가 사용하기 위한 검색과 지식 인프라가 필요하다.
두 번째 기둥은 과학적 측정 데이터다. 물리학, 화학, 생물학, 의학, 경제학, 천체물리학 등 여러 영역에서 축적된 측정 데이터를 기계가 접근 가능한 형태로 연결해야 자동 연구가 가능해진다. 세 번째 기둥은 아직 직접 측정할 수 없거나 비용이 큰 현상을 다루기 위한 시뮬레이션이다. AI는 시뮬레이션을 통해 후보 가설을 빠르게 시험하고, 검증 가능성이 높은 방향을 좁힐 수 있다.
마지막 기둥은 실제 세계의 실험이다. 강연자는 모든 것이 지식 검색과 시뮬레이션만으로 끝나지 않으며, 최종적으로는 물리적 실험실이나 산업적 실험 인프라가 필요하다고 강조한다. 이 네 요소 위에는 여러 Agent가 swarm처럼 작동하면서 지식, 데이터, 실험, 보상 신호를 연결한다. 결국 Eureka Machine은 “생각하는 모델” 하나가 아니라, 과학 연구의 전체 루프를 기계가 반복할 수 있게 만드는 복합 시스템이다.
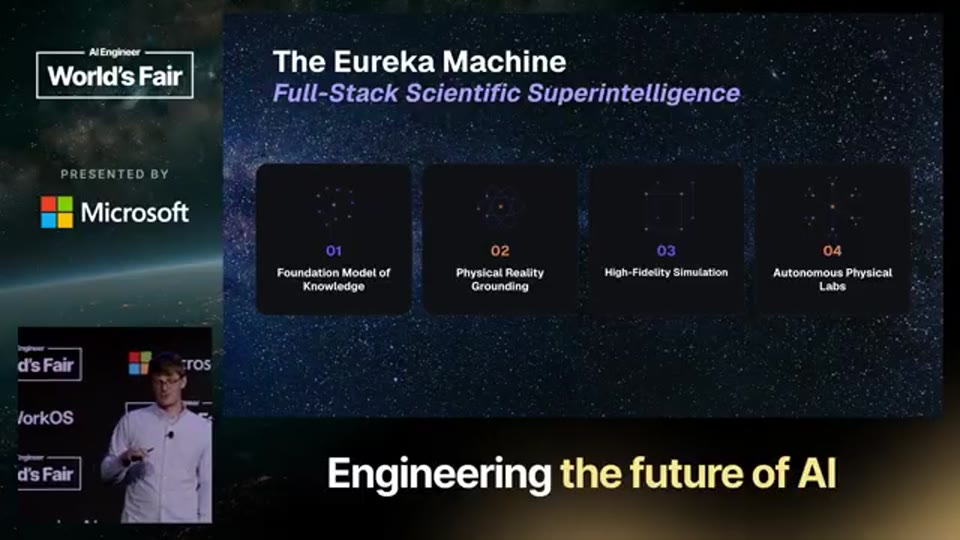
09:37 - Eureka Machine의 네 가지 기둥과 Agent Swarm 구조를 설명하는 개념도 화면
💡 [영상 참조] 강연자는 이 부분에서 Eureka Machine의 구성 요소를 슬라이드로 설명한다. 음성에서 확인되는 구성은 기존 지식, 측정 데이터, 시뮬레이션, 실제 실험, 그리고 그 위의 Agent Swarm이다.
사람을 위한 인터넷에서 AI를 위한 인프라로
Socher는 You.com에서의 경험을 예로 들며, 기존 인터넷 인프라를 AI 시대에 맞게 다시 생각해야 한다고 말한다. 사람이 검색 엔진을 사용할 때는 10개의 파란 링크와 짧은 snippet이 유용했지만, Agent는 수천 개의 긴 snippet을 읽고 비교할 수 있다. 따라서 검색, 브라우저, GPU, 데이터베이스 같은 기존 기술 계층도 사람 중심 인터페이스에서 AI 중심 도구로 재구성될 수 있다.
이 주장은 자동 연구의 현실적 조건을 보여준다. Superintelligence(초지능)를 만든다는 말은 흔히 모델 크기나 추론 능력만을 떠올리게 하지만, Socher의 관점에서는 모델이 사용할 수 있는 주변 도구와 정보 환경이 거의 같은 수준으로 중요하다. AI가 과학자가 되려면 논문을 읽고, 코드를 작성하고, 실험을 실행하고, 실패를 분석하고, 다시 가설을 세우는 환경 전체가 필요하다. 결국 자동 연구는 모델 연구이면서 동시에 인프라 연구다.
Recursive Self-Improvement가 중요한 이유
강연의 중반 이후 Socher는 자동 연구를 구현하는 가장 강력한 방법으로 Recursive Self-Improvement를 제시한다. 이는 AI가 다른 문제를 해결하는 데 그치지 않고, 자기 자신의 한계를 인식하고 다음 버전의 자신을 개선하는 구조를 의미한다. 그는 자연어처리(NLP)의 역사를 예로 들며, 사람이 언어 규칙과 특징을 직접 설계하던 시기에서 word vector, neural network, end-to-end learning, backpropagation으로 넘어오면서 성능이 크게 개선되었다고 설명한다.
이 흐름에서 반복적으로 확인된 패턴은 명확하다. 사람이 수작업으로 넣던 부분을 학습 가능한 시스템으로 대체할수록 더 큰 발전이 일어났다는 것이다. Socher는 현재의 AI 시스템에도 여전히 수많은 수동 설계가 남아 있으며, 이 부분을 AI가 스스로 연구하고 수정할 수 있다면 또 한 번의 큰 도약이 가능하다고 본다. 특히 최근 6~8개월 사이 AI의 장기 코딩 능력이 크게 향상되면서, AI가 AI 코드와 학습 파이프라인을 직접 개선할 수 있는 조건이 갖춰졌다고 주장한다.
그가 말하는 진정한 RSI는 단순한 AutoML이나 하이퍼파라미터 탐색보다 훨씬 강한 개념이다. 모델이 pre-training, reinforcement learning, harness, 평가 체계 등 자기 시스템의 전체 구성 요소에 접근하고, 자신의 약점을 파악한 뒤, 다음 버전에서 그 약점을 고치는 구조여야 한다. 따라서 작은 모델 훈련 실험을 자동으로 개선하는 것은 중요한 이정표일 수 있지만, Socher의 기준에서는 그것만으로 완전한 RSI라고 부르기는 어렵다.
NanoChat 실험이 보여준 첫 번째 단서
Socher는 Eureka Machine의 초기 증거로 NanoChat 실험을 소개한다. NanoChat은 5분 이내에 매우 작은 chat model을 훈련하는 환경이며, 목표는 bits per byte 지표를 최대한 낮추는 것이다. 커뮤니티가 일정 기간 노력해 0.93 수준에 도달한 상태에서, Socher의 팀은 자동 연구 시스템을 하루나 이틀 정도 실행해 0.91 수준까지 개선했다고 설명한다.
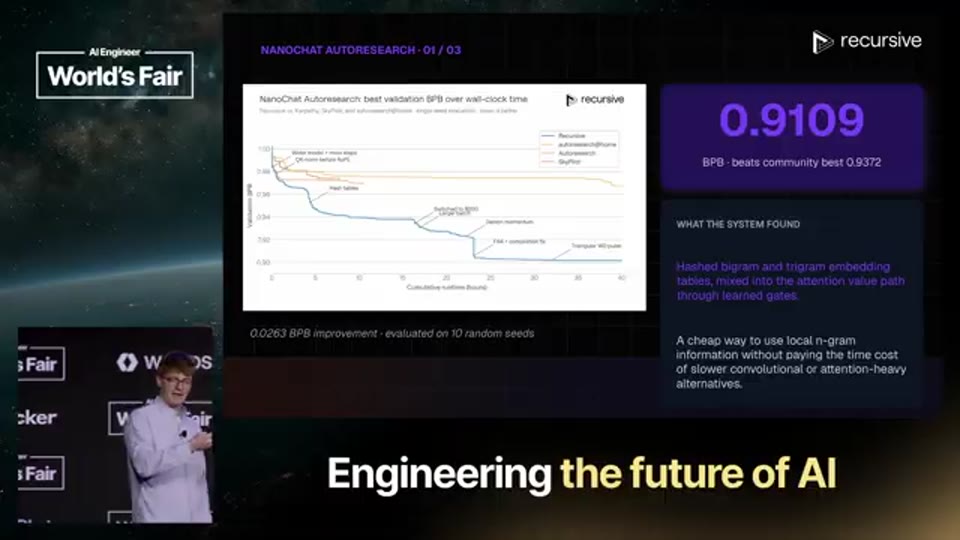
15:40 - NanoChat benchmark와 bits per byte 개선 사례를 설명하는 실험 결과 화면
흥미로운 점은 이 결과가 단순한 하이퍼파라미터 튜닝만으로 나온 것이 아니라는 점이다. 강연자에 따르면 시스템은 hashed bigram과 trigram embedding, 관련 table, attention의 value path에 learned gate를 섞는 방식 등 더 구조적인 아이디어를 발견했다. 이 설명이 사실이라면 자동 연구 시스템은 이미 “있는 파라미터를 더 잘 고르는 도구”를 넘어, 모델 구조와 학습 경로에 대한 새로운 설계를 탐색하는 단계로 들어선 셈이다.
| 실험 | 강연자가 언급한 목표 | 기존 수준 | 자동 연구 결과 |
|---|---|---|---|
| NanoChat | 5분 이내 소형 chat model 훈련에서 bits per byte 개선 | 약 0.93 | 약 0.91 |
| nanoGPT speedrun | 훈련 속도 개선 | 약 70초대 기준 | 2초 이상 단축 |
| CUDA kernels | NVIDIA GPU benchmark kernel 성능 개선 | leaderboard 최고 수준 | 여러 category에서 더 나은 kernel 발견 |
이 표는 음성에서 언급된 수치만 정리한 것이다. 화면에 추가로 제시된 세부 benchmark, 실험 조건, hardware 구성, statistical variance는 STT에 포함되어 있지 않으므로 확정적으로 해석해서는 안 된다. 다만 강연의 맥락상 Socher가 보여주려는 메시지는 분명하다. 자동 연구 시스템이 작고 검증 가능한 과제에서 사람과 AI가 함께 장기간 최적화한 결과를 빠르게 추월할 수 있다는 것이다.
nanoGPT와 CUDA Kernel 최적화의 의미
두 번째 사례는 nanoGPT speedrun이다. Socher는 속도가 AI 연구에서 매우 중요하다고 설명하며, 자동 연구 시스템이 이 benchmark에서 1년 이상 사람과 AI가 함께 개선해 온 결과보다 더 나은 성능을 냈다고 말한다. 음성상 구체적 기준은 약 70초 수준으로 언급되며, 시스템은 이를 2초 이상 더 빠르게 만들었다고 설명된다. 절대 수치만 보면 작은 차이처럼 보일 수 있지만, 이미 많은 최적화가 누적된 benchmark에서 추가로 2초를 줄이는 것은 탐색 공간이 상당히 압축된 상태에서 새로운 개선점을 찾았다는 의미를 갖는다.
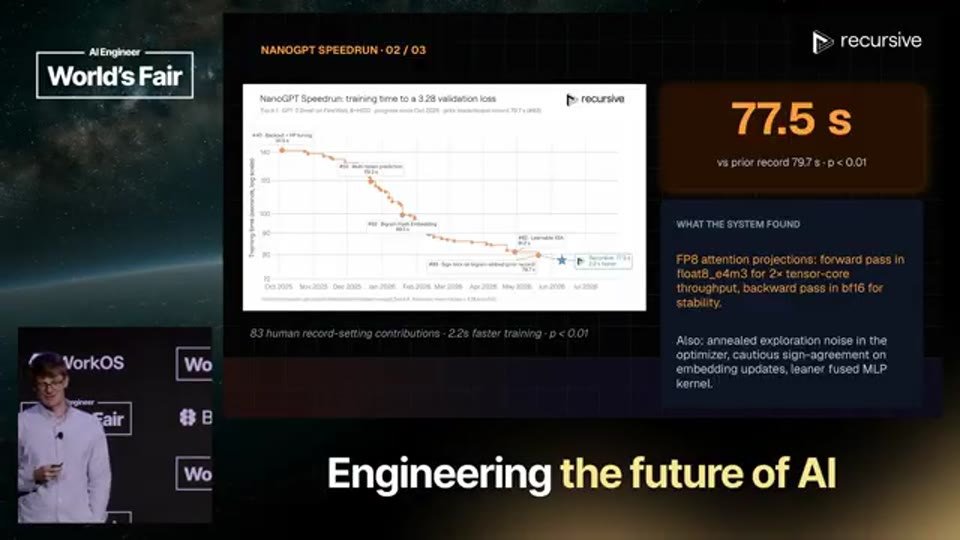
16:45 - nanoGPT speedrun에서 훈련 시간을 단축한 사례를 설명하는 benchmark 화면
세 번째 사례는 CUDA kernel 최적화다. Socher는 대규모 cluster에서 mixture-of-experts model이 여전히 비효율적으로 실행되는 경우가 많고, 수십억 달러 규모의 GPU cluster에서도 utilization이 30% 안팎에 머무를 수 있다고 지적한다. 이런 환경에서는 kernel 하나의 개선이 단순한 코드 미세 조정이 아니라 전체 학습 비용과 처리량에 직접적인 영향을 준다. 강연자에 따르면 자동 연구 시스템은 며칠 만에 NVIDIA benchmark leaderboard의 최고 성능보다 나은 kernel을 여러 category에서 발견했다.
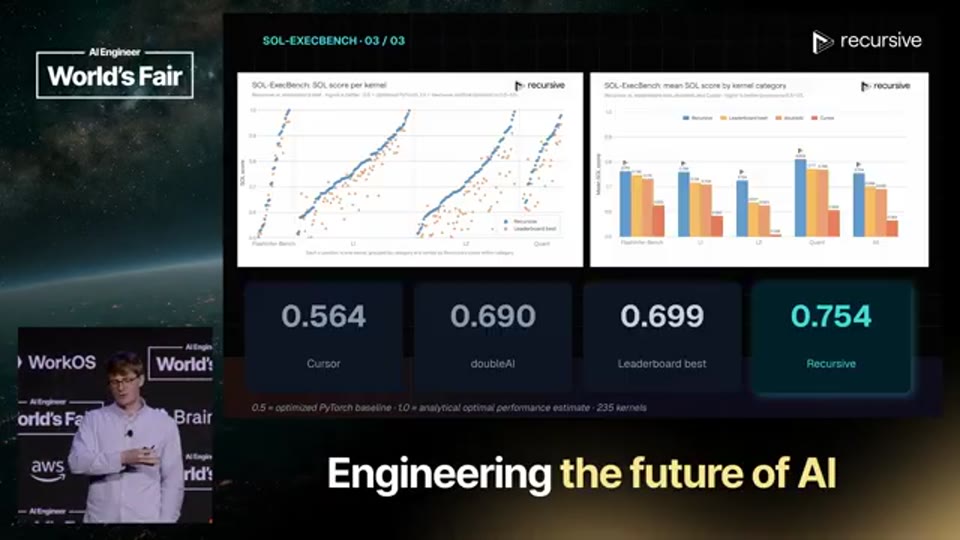
17:47 - CUDA kernel 최적화와 NVIDIA benchmark leaderboard 결과를 설명하는 화면
이 대목에서 중요한 것은 reward hacking에 대한 검증이다. Socher는 팀 내부에 평생 CUDA kernel만 작성해 온 전문가가 있었던 것은 아니지만, NVIDIA와 함께 결과가 실제 개선인지 확인했다고 설명한다. 자동 연구 시스템이 benchmark 점수만 속이는 것이 아니라 실제로 더 나은 kernel을 찾았다는 점을 검증했다는 취지다. 이는 자동 연구 시스템이 실험 결과를 평가할 때 얼마나 엄격한 validation layer를 가져야 하는지 보여주는 사례이기도 하다.
자동화된 과학은 AI 연구에서 시작해 다른 과학으로 확장된다
Socher의 큰 그림은 AI가 먼저 AI 연구를 자동화하고, 그렇게 강화된 AI가 이후 물리학, 화학, 생물학, 신경과학, 의학, 경제학, 천체물리학 같은 다른 과학 영역으로 확장되는 것이다. 그는 AI가 코드로 구현된 시스템이고, 최근 AI가 코드를 충분히 잘 다루기 시작했기 때문에 AI 연구가 자동화의 첫 번째 적합한 대상이라고 본다. 이는 AI 연구가 다른 과학보다 중요하다는 뜻이라기보다, AI가 자기 개선 루프를 만들기에 가장 직접적인 조작 대상이 code라는 뜻에 가깝다.
이 구상에는 강한 낙관론이 깔려 있다. Socher는 현재의 AI 발전이 언젠가 평평해질 수 있다는 우려를 인정하지만, intelligence(지능)를 여러 차원의 공간으로 나누어 보면 아직 상한까지는 매우 멀다고 말한다. 강연 후반부에서 그는 intelligence를 구성하는 여러 “spaces”가 있으며, 각 공간의 여러 차원에서 아직 발전 여지가 천문학적으로 크다고 설명한다. 즉, 현재의 AI는 특정 benchmark에서는 뛰어나지만, 지능 전체의 부피를 채우기에는 아직 초기 단계라는 관점이다.
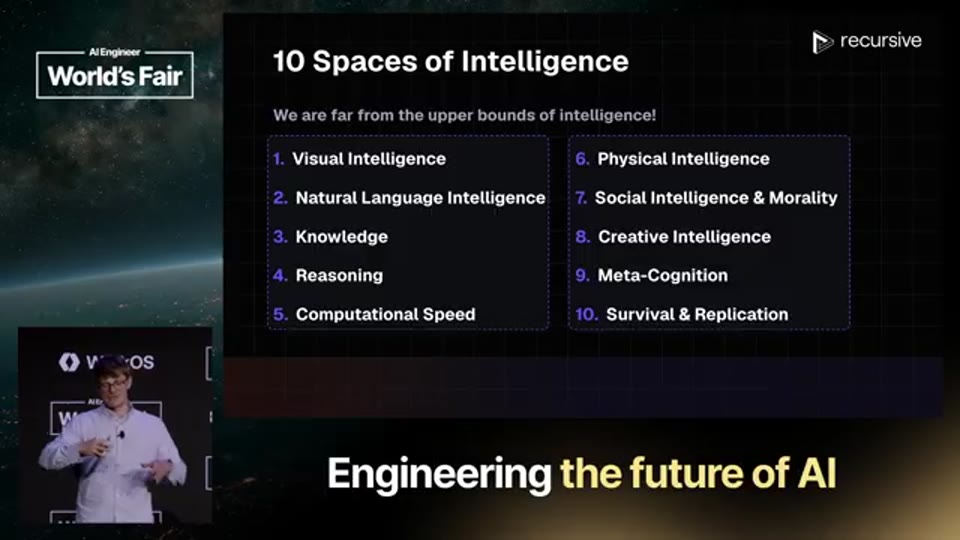
19:35 - 지능을 여러 공간과 차원으로 나누어 성장 여지를 설명하는 후반부 슬라이드 화면
마무리 / 핵심 정리
이 강연의 핵심은 자동화된 AI 연구가 단순한 생산성 도구를 넘어 과학 발견의 방식 자체를 바꿀 수 있다는 주장이다. Socher는 진화, 과학철학, 기술사, AI 인프라를 하나의 흐름으로 묶어, 새로운 발견도 결국 변이와 선택, 실험과 검증의 반복이라는 관점에서 바라본다. 이 반복을 사람이 수행할 때는 연구자 수와 전문 분야의 세분화가 병목이 되지만, AI Agent와 자동 실험 시스템이 결합되면 병목의 위치가 달라질 수 있다.
다만 이 비전이 실현되려면 단순히 더 큰 LLM을 만드는 것만으로는 부족하다. AI가 읽을 수 있는 지식 인프라, 신뢰할 수 있는 측정 데이터, 현실을 충분히 반영하는 시뮬레이션, 실제 실험실과 산업 인프라, 그리고 reward hacking을 걸러낼 검증 체계가 함께 필요하다. Socher가 보여준 NanoChat, nanoGPT, CUDA kernel 사례는 아직 작은 proof point에 가깝지만, 그 작은 실험들이 가리키는 방향은 크다. AI가 연구 도구에서 연구 주체로 이동하기 시작한다면, 다음 S-curve는 AI 산업 내부가 아니라 과학과 기술 전체에서 나타날 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | First Steps Toward Automated AI Research - Richard Socher, CEO Recursive AI |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-31 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.