From Agent Traces to Agent Simulations — Rustem Feyzkhanov, Snorkel AI
📺 원본 영상: From Agent Traces to Agent Simulations — Rustem Feyzkhanov, Snorkel AI
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-26
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Rustem Feyzkhanov는 AI Agent를 실제 서비스에 배포하려는 조직이 단순한 trace 관찰을 넘어, production 환경에 가까운 simulation benchmark를 구축해야 한다고 주장한다. 그의 핵심 메시지는 명확하다. trace는 이미 발생한 실패를 발견하는 데 유용하지만, simulation은 “다른 agent 설정을 적용했다면 어떤 일이 벌어졌을까”를 반복 가능한 실험으로 검증하게 해준다.
이 강연은 agent evaluation을 단순한 pass rate 측정이 아니라, 비용, 지연 시간, 재시도 횟수, 정책 준수, 도구 사용, 환경 상태 변화까지 포함하는 시스템 평가 문제로 재정의한다. 특히 Snorkel AI가 월간 수백만 건의 agent simulation을 실행하며 축적한 관점에서, benchmark construction은 임시 평가 작업이 아니라 소프트웨어 엔지니어링의 한 분야로 다뤄져야 한다는 점을 강조한다.
Trace는 출발점이지만, 배포 판단의 기준으로는 부족하다
강연자는 agent evaluation을 이야기할 때 많은 팀이 먼저 trace에 주목한다고 설명한다. trace는 agent가 어떤 입력 prompt를 받았고, 어떤 action을 수행했으며, 최종적으로 어떤 output을 냈는지를 보여준다. 따라서 production에서 실제로 발생한 실패, edge case, 이상 행동을 발견하는 데에는 매우 유용하다. 그러나 trace만으로는 서로 다른 agent configuration을 공정하게 비교하기 어렵다.
문제는 production trace가 본질적으로 반복 가능한 실험 환경이 아니라는 데 있다. A/B test를 통해 두 agent 버전을 비교할 수는 있지만, 그 사이에 database state, tool version, 외부 API 응답, 사용자 조건이 달라질 수 있다. 이 경우 두 agent가 같은 문제를 같은 조건에서 풀었다고 보기 어렵기 때문에, 강연자는 이를 “apples to apples” 비교가 아니라고 본다. Agent가 실제로 개선되었는지, 아니면 우연히 쉬운 상태를 만났는지 구분하기 어려워지는 것이다.
Applied simulation은 이 한계를 넘기 위한 방법으로 제시된다. production trace에서 task를 추출하고, 이를 simulation benchmark로 재구성하면 동일한 환경에서 서로 다른 agent 설정을 offline으로 실행할 수 있다. 이때 비교 기준은 단순한 성공 여부에 그치지 않고, cost, latency, retries 같은 운영 지표까지 포함한다. 결국 trace가 사후 관찰이라면, simulation은 통제된 재현 실험에 가깝다.
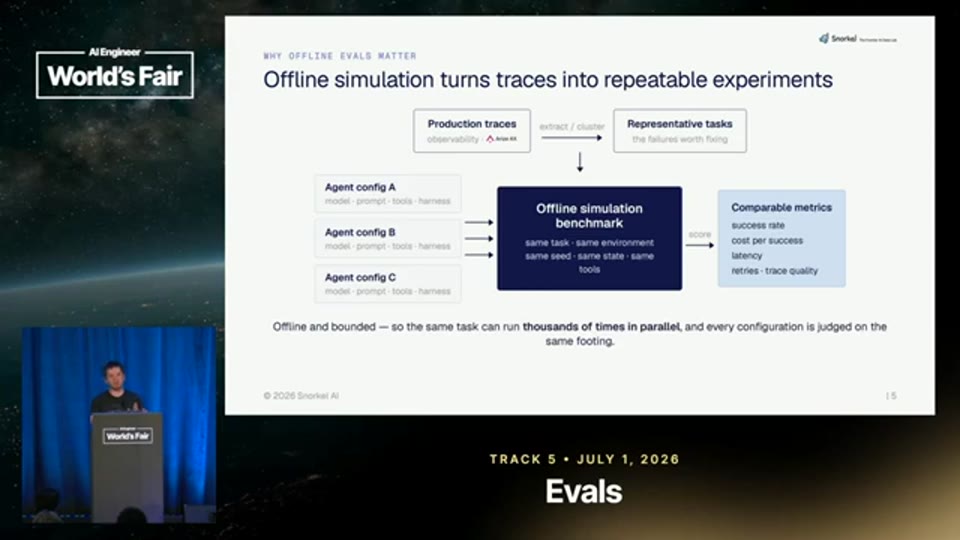
02:49 - production traces를 simulation benchmark로 전환하고 agent configuration별 metrics를 비교하는 흐름
💡 [영상 참조] 강연자는 초반부에서 trace가 입력 prompt, agent action, output으로 구성되는 예시 화면을 참조하며 설명한다. 음성상 화면의 세부 내용은 확인되지 않으므로, 상세 구조는 원본 영상을 확인하는 것이 좋다.
Public benchmark는 방향을 잡게 해주지만, private benchmark가 배포를 가능하게 한다
강연자는 public benchmark의 가치를 부정하지 않는다. SWE-bench처럼 GitHub issue 수정을 평가하는 benchmark, Terminal-Bench처럼 terminal 환경에서 agent 수행 능력을 보는 benchmark, computer use agent를 대상으로 하는 benchmark들은 frontier model의 성능을 가늠하는 데 유용하다. 다만 이러한 benchmark들은 특정 domain과 task에 맞춰 설계되어 있기 때문에, 개별 회사의 production workflow를 그대로 대변하지는 못한다.
회사에서 실제로 필요한 것은 그 조직의 domain, tool, API service, policy, workflow를 반영한 private benchmark다. 예를 들어 고객 지원 agent, 내부 데이터 분석 agent, 금융 업무 agent, 법무 검토 agent는 모두 사용하는 도구와 실패 비용이 다르다. 동일한 LLM이라도 어떤 tool harness를 제공받는지, 어떤 policy를 따라야 하는지, 어떤 database snapshot에서 동작하는지에 따라 실제 성능은 크게 달라진다.
따라서 public benchmark는 새로운 model이나 agent architecture에 대한 사전 판단을 형성하는 데 적합하고, private benchmark는 실제 release decision을 내리는 데 적합하다. 강연자의 표현을 빌리면, public benchmark는 “orient and build your prior”에 가깝고, private benchmark는 “ship”하기 위한 장치다. 이는 agent evaluation의 초점을 model leaderboard에서 production readiness로 이동시키는 중요한 관점이다.
Agent benchmark는 model이 아니라 full system을 평가해야 한다
강연에서 반복적으로 등장하는 메시지는 production에서 중요한 것은 model 하나의 성능이 아니라 agent system 전체의 성능이라는 점이다. 어떤 model을 쓰는지, prompt를 어떻게 구성하는지, reasoning level을 어떻게 설정하는지, tool과 skill을 어떤 방식으로 제공하는지, output schema를 어떻게 강제하는지가 모두 agent의 실제 동작을 결정한다. 그러므로 benchmark는 model 교체 실험만을 위한 것이 아니라, full stack configuration을 검증하는 실험 장치가 되어야 한다.
이 관점은 기존 ML benchmark와 다르게 agent benchmark가 운영 시스템에 더 가깝다는 사실을 드러낸다. agent는 단일 입력에 대해 단일 출력을 생성하는 모델이 아니라, database와 API, file system, MCP tool, simulated user와 상호작용하며 task를 수행하는 실행 시스템이다. 따라서 평가도 최종 답변뿐 아니라 trace, environment final state, artifacts를 함께 봐야 한다.
이런 구조를 갖추면 benchmark는 agent lifecycle의 세 단계에서 쓰일 수 있다. 첫째, agent를 처음 release할 때 정상 동작과 edge case 대응을 확인하는 데 쓰인다. 둘째, release gate로 작동하면서 agent stack 변경이 regression을 만들지 않았는지 검증한다. 셋째, cost와 latency를 줄이거나, simulation 결과를 training data로 활용해 agent 자체를 개선하는 데 연결된다.
강연자는 Snorkel AI가 simulation environment를 활용해 특정 task에서 작은 Qwen 계열 모델이 더 큰 Qwen 계열 모델의 성능에 가까워지도록 fine-tuning한 사례를 언급한다. STT 원문에서는 모델명이 다소 불명확하지만, 문맥상 “작은 모델을 특정 업무에 맞게 학습시켜 큰 모델 수준의 성능을 달성했다”는 취지로 이해된다. 여기서 핵심은 simulation benchmark가 evaluation set이면서 integration test이고, 동시에 training set으로도 확장될 수 있다는 점이다.
Benchmark task의 기본 구조는 instruction, environment, verifier, oracle로 나뉜다
강연자는 benchmark 실행 흐름을 agent가 input prompt를 받고, environment와 상호작용하며 task를 해결한 뒤, output과 trace, final environment state, artifacts를 남기는 과정으로 설명한다. 이후 verifier가 이 결과물을 분석해 agent가 task를 제대로 해결했는지, 얼마나 잘 수행했는지, 어떤 비용과 지연이 발생했는지를 측정한다. 이 구조는 겉보기에는 단순하지만, production과 유사한 조건을 재현하려면 각 구성 요소가 매우 정교해야 한다.
특히 중요한 구성 요소는 oracle이다. oracle solution은 실제 agent 대신 정답 절차를 수행하면서 해당 task가 애초에 풀 수 있는 문제인지 확인한다. task 자체가 불가능하거나 verifier가 잘못 설계되어 있으면, agent 성능을 측정하는 것이 아니라 benchmark 결함을 측정하게 된다. 그래서 oracle은 benchmark 품질 관리의 기준점 역할을 한다.
파일 구조 관점에서 강연자는 Terminal-Bench 팀과 관련된 Harbor format을 예로 든다. 이 형식에서는 agent가 보는 instruction markdown과 environment 구성 파일, agent가 보지 못하는 oracle solution과 verifier, 그리고 metadata가 함께 존재한다. Dockerfile이나 Docker Compose를 이용하면 agent가 동일한 조건에서 반복 실행될 수 있기 때문에, benchmark가 단순한 평가 문서가 아니라 재현 가능한 실험 패키지가 된다.
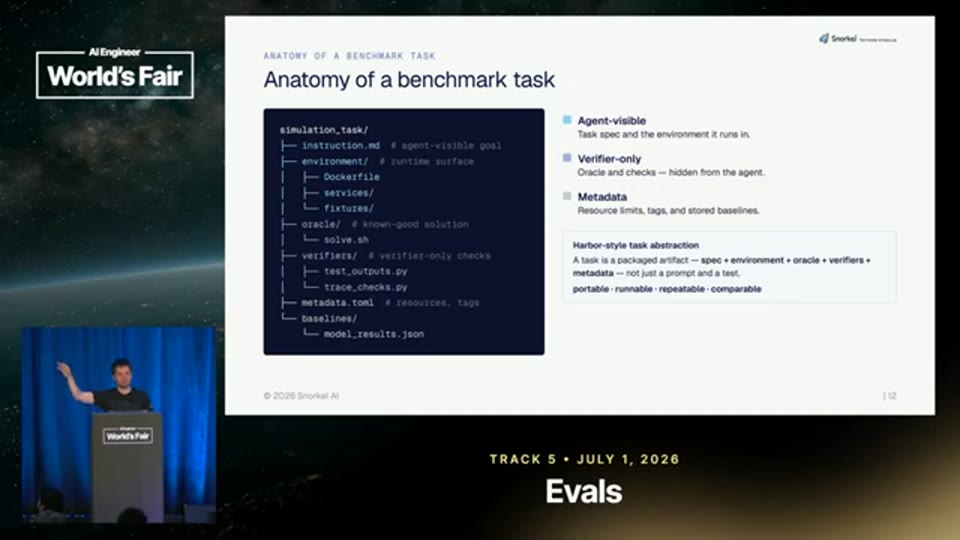
07:49 - benchmark task의 파일 구성과 Harbor format 관련 구조
💡 [영상 참조] 강연자는 benchmark task의 파일 구조를 설명하며 instruction, environment, oracle solution, verifier, metadata가 나뉘는 형식을 화면에서 보여준다. 화면에 표시된 파일명이나 디렉터리 구조의 세부 내용은 음성만으로는 완전히 확인되지 않는다.
Environment는 mini production이어야 하지만 full production일 필요는 없다
Simulation environment의 핵심 난점은 production에 충분히 가까워야 하지만, 실제 production 전체를 매 실험마다 띄울 수는 없다는 데 있다. 강연자는 database, API service, tools, files가 production과 유사해야 하며, agent가 자신이 simulation 안에서 실행된다는 사실을 쉽게 인지하지 못해야 한다고 강조한다. 이는 agent가 benchmark 환경을 우회하거나 reward hacking을 시도할 수 있기 때문이다.
그렇다고 실제 user를 simulation task 안에 넣을 수는 없다. 이 경우 simulated user가 필요하며, 강연자는 별도 prompt와 context를 가진 LLM이 human behavior와 system interaction을 모방할 수 있다고 설명한다. 이는 특히 multi-turn task나 user clarification이 필요한 workflow에서 중요하다. agent가 단순히 정답을 내는 것이 아니라, 상대방과 상호작용하며 목표를 달성해야 하기 때문이다.
Environment 구성은 integration test를 설계하는 방식과 비슷하다. production database 전체를 쓰는 대신 특정 snapshot을 사용하고, agent가 실행되는 main environment 주변에 API service, database, MCP tool을 담은 sidecar container를 둘 수 있다. 외부 service 전체를 실제로 재현하지 않아도 mock을 통해 충분히 현실적인 응답을 만들 수 있다. 중요한 것은 agent가 사용하는 interface와 failure mode가 production에서 마주칠 조건과 유사해야 한다는 점이다.
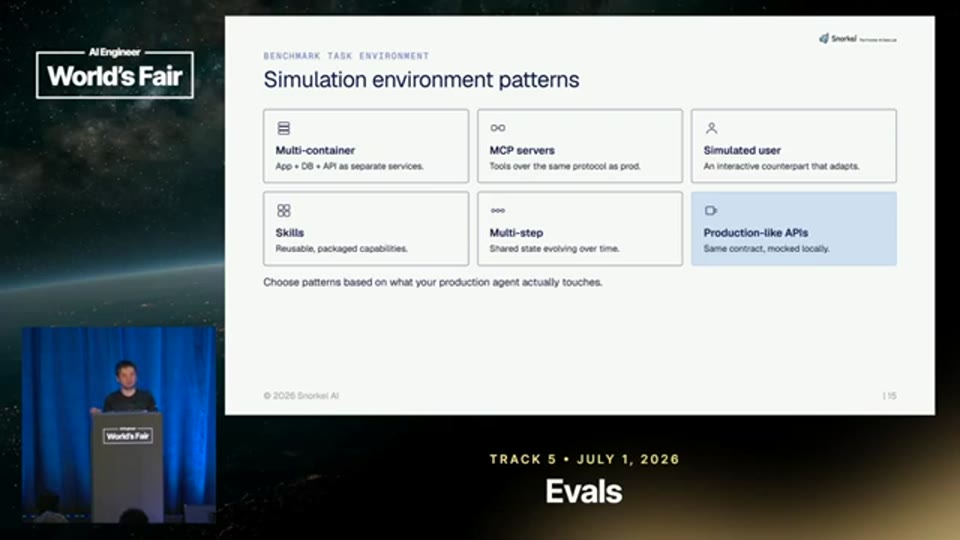
09:31 - database snapshot, sidecar container, API service, MCP tools를 포함한 simulation environment 구성
강연자는 long-horizon task를 다루기 위한 multi-step simulation도 언급한다. 몇 시간에 걸쳐 진행되는 업무라면 하나의 prompt와 하나의 verifier만으로는 평가가 어렵다. 이때 각 step마다 별도 prompt와 verifier를 두고, agent가 중간에 명확히 실패하면 simulation을 조기 종료할 수 있다. 이렇게 하면 긴 시간 범위의 업무도 평가 가능한 단위로 분해하면서, 전체 workflow의 품질을 측정할 수 있다.
Verifier는 output만 보는 채점기가 아니라 world state를 읽는 평가자다
기존 코드 평가에서는 output code를 test suite로 검증하는 방식이 자연스럽다. 그러나 agent simulation에서는 평가 대상이 훨씬 넓다. agent가 tool을 어떻게 호출했는지, database state가 어떻게 바뀌었는지, API response와 user reply가 어떤 흐름을 만들었는지, 최종 artifacts가 task 요구사항을 충족하는지까지 함께 봐야 한다. 강연자는 이를 “world”와 final environment state를 평가하는 문제로 설명한다.
Verifier를 구현하는 방법은 하나로 고정되지 않는다. deterministic check는 final output이나 tool call처럼 명확한 조건을 확인할 때 강력하다. 반면 trace quality, planning correctness, conversational appropriateness처럼 정성적 판단이 필요한 영역에서는 LLM-as-a-judge, human-as-a-judge, agent-as-a-judge가 쓰일 수 있다. 실제 benchmark에서는 이 방식들을 혼합해 사용하는 경우가 많다.
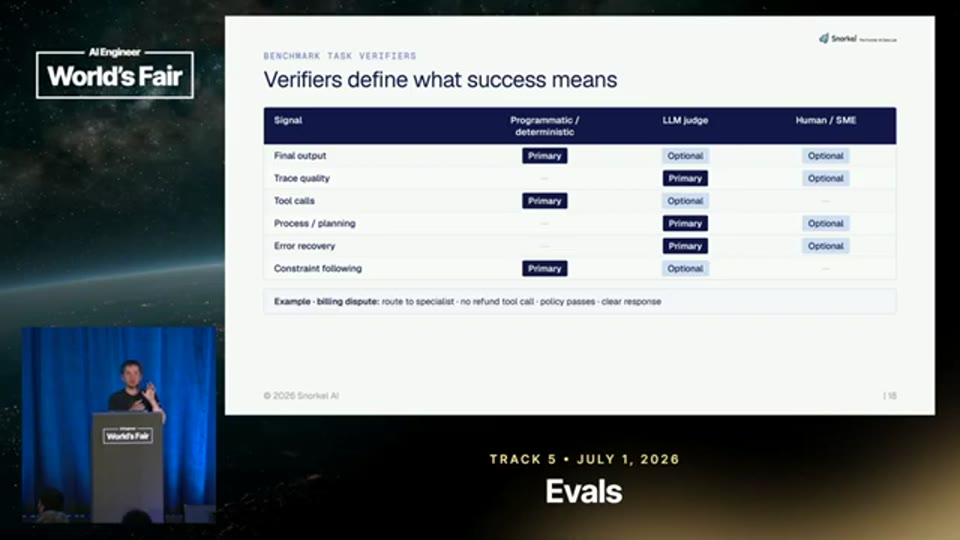
11:20 - deterministic check와 LLM-as-a-judge 등 verifier 유형 비교
다만 자동 verifier만으로 모든 문제를 해결하려고 하면 blind spot이 생긴다. 강연자는 subject matter expert가 모든 trace를 검토할 필요는 없지만, agent와 verifier 사이에 disagreement가 발생하는 구간에서는 human review가 중요하다고 말한다. 예를 들어 agent는 task를 해결했다고 보지만 verifier는 실패로 판정하거나, 반대로 verifier는 통과시켰지만 domain expert가 보기에는 절차상 문제가 있는 경우가 있을 수 있다. 이런 사례가 benchmark 자체를 개선하는 핵심 피드백이 된다.
Benchmark도 소프트웨어이므로 CI와 품질 관리가 필요하다
강연 후반부에서 가장 실무적인 메시지는 benchmark를 software로 다뤄야 한다는 것이다. benchmark는 code, file, dependency, fixture, container image, verifier, oracle로 구성된 실행 가능한 시스템이다. 따라서 agent product와 마찬가지로 별도의 CI pipeline을 갖추고, benchmark 자체가 깨지지 않았는지 지속적으로 검증해야 한다.
이 CI에서는 dependency pinning, base image correctness, missing fixture 여부 같은 기본적인 항목을 확인할 수 있다. 또한 oracle solution을 실행해 task가 실제로 풀리는지 검증하고, oracle 없이 verifier가 실패하는지도 확인할 수 있다. 여러 agent run을 수행해 task가 너무 쉽거나 너무 어려운지, agent 성공률의 variance가 과도하게 높지는 않은지도 측정할 수 있다.
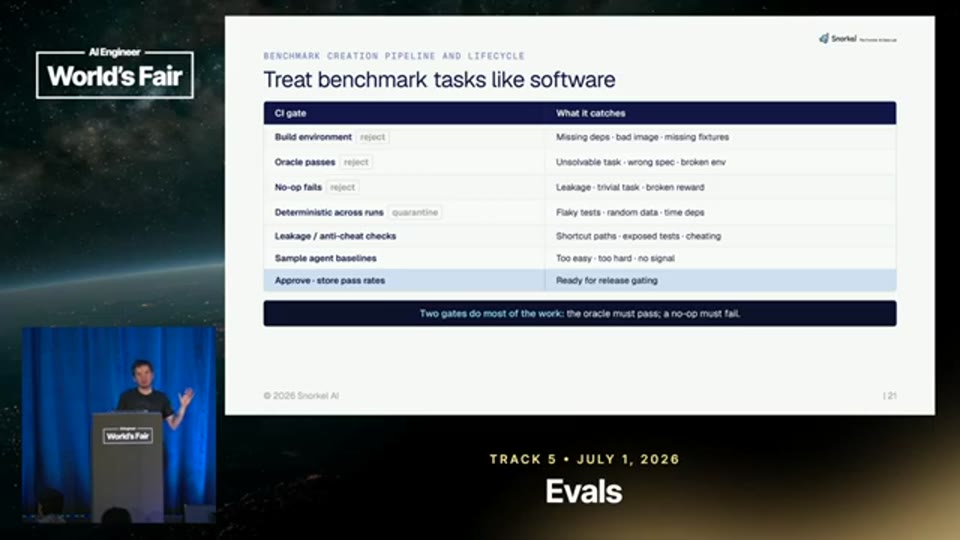
13:34 - oracle solution, verifier failure, dependency pinning 등 benchmark CI 품질 관리 절차
이 과정을 거치면 benchmark task를 simple, medium, hard와 같은 난이도로 분류할 수 있다. 난이도는 task의 표면적 복잡도만으로 정해지는 것이 아니라, 실제 agent가 몇 번이나 성공하는지, 얼마나 안정적으로 수행하는지에 따라 달라진다. benchmark development는 그래서 단순히 문제를 모으는 일이 아니라, 풀 수 있고, 의미 있고, 안정적으로 비교 가능한 실험 단위를 만드는 엔지니어링 작업이다.
Prompt에 모든 문제를 밀어 넣는 방식은 anti-pattern이 될 수 있다
강연자는 업계에서 자주 보이는 anti-pattern으로 prompt에 모든 fix를 누적하는 방식을 지적한다. 실패가 발생할 때마다 “절대 이것을 하지 말라”, “반드시 저것을 하라”, “이 출력은 금지하라” 같은 문구를 prompt에 계속 추가하면 단기적으로는 문제를 완화할 수 있다. 그러나 시간이 지날수록 prompt는 비대해지고, 실제 문제가 harness, skill, context, output schema 중 어디에 있는지 흐려진다.
Simulation benchmark가 있으면 fix가 들어가야 할 올바른 위치를 찾을 수 있다. context overload가 문제라면 harness를 수정해야 하고, procedure가 누락되어 있다면 skill에 반영해야 하며, 특정 output 구조가 필요하다면 structured output schema로 강제해야 한다. prompt는 여전히 중요한 구성 요소지만, full stack을 평가할 수 있을 때 prompt가 모든 책임을 떠안지 않아도 된다.
이 접근은 agent engineering의 성숙도를 높인다. 문제를 발견했을 때 prompt patch로 즉시 덮는 대신, 동일한 simulation에서 재현하고, 한 가지 변경만 적용한 뒤, 같은 benchmark에서 다시 검증한다. 그런 다음 full evaluation을 다시 실행해 regression이 없는지 확인하고 production에 release한다. 이는 전통적인 software regression test와 매우 닮아 있다.
Production 이후에는 observability와 experimentation이 하나의 loop로 연결된다
Agent가 production에 들어간 뒤에도 benchmark는 정적 artifact로 남아 있어서는 안 된다. 강연자는 production observability trace에서 failure를 수집하고, 이를 benchmark expansion에 활용하는 loop를 제안한다. 실제 운영에서 발견된 실패가 simulation task로 전환되면, 다음 agent release에서는 같은 실패가 반복되는지 offline에서 먼저 확인할 수 있다.
동시에 simulation runner는 확장된 benchmark나 새로운 agent configuration을 실행하고, 그 실험 결과를 기록한다. 강연자는 Arize와 같은 observability 및 experiment tracking 도구를 예로 언급한다. 이 결과는 release gate로 사용되며, agent가 충분히 잘 수행한다고 판단될 때 production에 반영된다. 즉 production trace는 benchmark를 키우고, benchmark는 다음 production release를 더 안전하게 만든다.
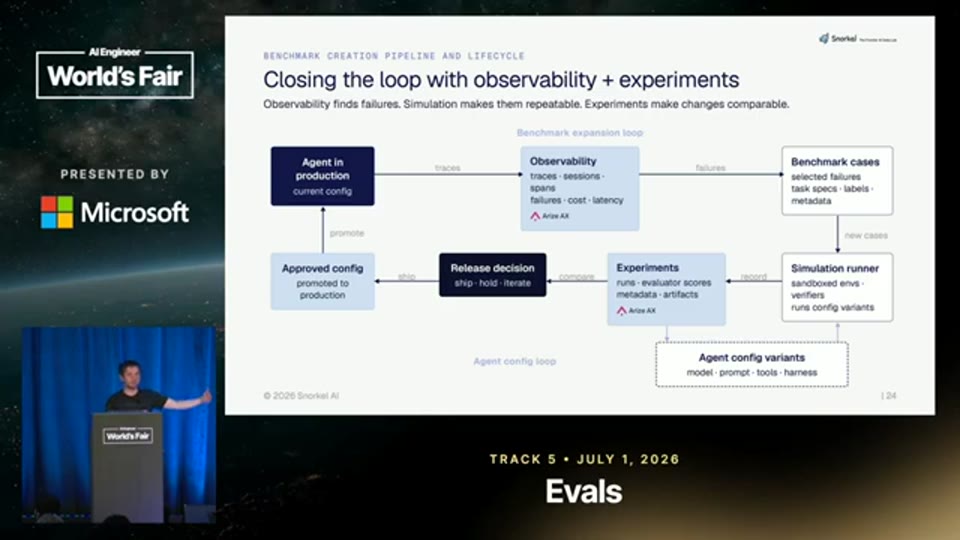
15:36 - observability traces와 simulation runner, release gate가 연결되는 agent ops loop
이 구조에서 observability와 experimentation은 별개의 도구가 아니라 같은 운영 체계의 양면이다. observability는 실제 세계에서 무엇이 잘못되었는지를 보여주고, simulation은 그 문제를 통제된 환경에서 다시 실험하게 한다. 두 시스템이 연결될 때 agent ops loop가 만들어지며, benchmark는 release 전 평가 도구를 넘어 agent 개선의 중심 데이터 자산이 된다.
Q&A에서 드러난 benchmark 설계의 현실적 기준
질의응답에서는 benchmark를 training과 validation으로 어떻게 나눌지에 대한 질문이 나왔다. 강연자는 전통적인 machine learning의 접근과 유사하게, agent가 실험 과정에서 보지 않은 standalone dataset이 필요하다고 답했다. 비율은 use case에 따라 달라지지만, 80대 20 split 같은 고전적인 기준이 출발점이 될 수 있다고 설명했다. 핵심은 agent configuration을 검증할 때 이미 최적화에 사용된 사례만 보고 판단해서는 안 된다는 점이다.
또 다른 질문은 production run을 handpick해서 benchmark에 넣을지, 아니면 agent가 아직 production에 없을 때 synthetic task를 만들어야 하는지에 관한 것이었다. 강연자는 둘 다 필요하다고 답한다. benchmark는 주요 use case를 폭넓게 덮어야 하며, 동시에 tool failure나 database issue 같은 edge case도 포함해야 한다. 이를 integration test에 비유하면, happy path와 failure path를 모두 갖춘 test suite가 필요한 셈이다.
Verifier 구축에서 LLM과 human expert의 역할을 묻는 질문도 있었다. 강연자는 Snorkel AI가 subject matter expert를 scale 있게 활용하지만, 모든 결과를 사람이 검토할 필요는 없다고 설명했다. 사람의 검토가 특히 필요한 곳은 agent 판단과 verifier 판단이 어긋나는 지점이다. 이런 disagreement 사례는 단순 오류 판정을 넘어, verifier를 조정하고 benchmark 품질을 높이는 학습 신호가 된다.
마무리 / 핵심 정리
이 강연의 결론은 “모든 회사에는 benchmark가 필요하다”는 문장으로 압축된다. 다만 여기서 말하는 benchmark는 공개 leaderboard에 쓰이는 일반 문제집이 아니라, 회사의 실제 tool, API, policy, workflow, database state를 반영한 private simulation benchmark다. trace는 production에서 edge case를 발견하게 해주지만, simulation은 동일 조건에서 agent 변경의 효과를 실험하게 해준다.
Agent를 production에 배포하는 팀에게 benchmark는 평가 도구이자 release gate이며, 장기적으로는 training data가 된다. 이를 위해서는 environment, oracle, verifier, metadata를 갖춘 task format이 필요하고, benchmark 자체도 CI와 품질 관리를 받는 software artifact로 다뤄져야 한다. 결국 agent ops의 성숙도는 model 선택만으로 결정되지 않는다. production trace를 simulation으로 전환하고, 그 simulation을 다시 agent 개선과 release 판단에 연결하는 루프를 만들 수 있는지가 핵심이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | From Agent Traces to Agent Simulations — Rustem Feyzkhanov, Snorkel AI |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-26 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.