Functional Composition Beyond Monads — 함수 합성으로 읽는 C++의 설계 패턴
📺 원본 영상: Functional Composition Beyond Monads - Jonathan Müller - C++Now 2026
🎙️ 채널: CppNow
📅 정리 일자: 2026-09-14
⚠️ Note: 본 리포트는 STT를 바탕으로 작성된 보고서의 문맥과 표현을 검수한 문서다. 이번 검수에는 원문 STT와 영상·스크린샷의 실제 내용이 제공되지 않아 음성 오인식이나 화면의 코드를 직접 재확인하지 못했다. 아래 타입 표기는 음성 설명을 정리한 개념 표현이며, 강연 중 상충하는 표준 라이브러리 관련 발언은 확정된 사양으로 취급하지 않았다. 스크린샷 목록에는 로컬 경로만 있고webUrl이 없어 이미지를 삽입하지 않았다.
개요
Jonathan Müller는 이 강연에서 함수형 프로그래밍의 여러 추상화를 C++ 개발자가 이미 사용하는 합성 문제와 연결한다. 값이 없을 수 있는 optional, 여러 값을 담는 range, 비동기 작업을 표현하는 sender에서 출발해, 소비자를 조합하는 반공변 구조와 자료구조의 형태를 보존하는 순회, 특정 필드를 다루는 lens까지 논의를 확장한다. 강연의 중심 주장은 이러한 개념이 이론 용어에 머무르지 않고, 어떤 정보와 실행 가능성을 보존하면서 코드를 연결할 것인지 설명하는 설계 어휘라는 데 있다.
평범한 함수 합성이 실패하는 순간
함수 합성(function composition)의 출발점은 단순하다. T를 받아 U를 반환하는 함수와 U를 받아 V를 반환하는 함수가 있다면, 두 함수를 연결해 T에서 V로 가는 함수를 만들 수 있다. 강연에서는 사용자 ID로 사용자를 찾는 lookupUser와 사용자에게서 주소를 얻는 getAddress를 연결해 lookupAddress를 만드는 사례를 사용한다. 앞 함수의 출력이 뒤 함수의 입력과 맞아떨어지는 동안에는 중간 결과를 지역 변수에 저장하든, 람다로 감싸든, 파이프 연산자로 연결하든 본질적인 동작은 같다.
파이프 표현이 주는 이점은 중간 값보다 작업의 연결 관계를 전면에 드러낸다는 데 있다. 구독 해지 버튼의 클릭 동작을 현재 사용자 ID 조회, 사용자 조회, 주소 추출, 구독 해지라는 일련의 합성으로 표현하면, 개별 대입문 대신 처리 흐름 자체가 코드의 중심이 된다. 강연자는 이를 Haskell의 포인트 프리 스타일(point-free style)과 연결한다. 다만 C++에서는 오버로드 집합이나 함수 템플릿을 전달하고, 인자 의존 이름 탐색(ADL)이 연산자를 찾도록 만들어야 하므로, 호출 가능 객체를 감싸는 타입과 람다를 생성하는 보조 매크로 같은 장치가 필요하다고 설명한다.
문제가 흥미로워지는 시점은 사용자 조회가 실패할 수 있을 때다. lookupUser가 User 대신 std::optional<User>를 반환한다면, 평범한 User를 요구하는 getAddress에 그 결과를 바로 전달할 수 없다. 함수들이 더 이상 같은 타입의 경계에서 맞물리지 않기 때문이다. 따라서 강연의 실제 질문은 파이프 문법을 만드는 방법이 아니라, 추가적인 의미를 가진 결과와 일반 함수를 어떻게 합성할 것인가이다.
상자는 값의 저장 방식보다 계산의 조건을 표현한다
강연자는 optional, range, sender를 모두 값을 둘러싼 상자(box)라는 비유로 설명한다. optional은 값이 없을 가능성을, range는 여러 값이 존재할 가능성을 표현하며, sender는 작업이 진행된 뒤에야 결과를 전달할 수 있는 계산을 나타낸다. expected도 등장하지만, 강연에서는 오류 채널을 분석하지 않고 성공 값의 존재 여부만 다루기 때문에 optional과 같은 관점에서 취급한다. 이는 두 타입의 전체 의미가 같다는 주장이 아니라, 이번 설명에서 관찰할 부분을 제한한 것이다.
상자 비유는 일반적인 컨테이너 밖으로도 확장된다. Reader는 데이터베이스 핸들 같은 환경을 나중에 제공해야 결과를 얻을 수 있는 계산이며, Writer는 결과와 함께 로그 같은 부가 정보를 유지하는 계산이다. 이 경우 상자 안에 값이 이미 물리적으로 들어 있다고 생각하면 오히려 이해하기 어렵다. 강연자가 말하는 상자는 값을 얻는 데 필요한 조건, 결과의 개수, 함께 보존해야 할 정보를 포함하는 추상화다.
이러한 상자는 일반적으로 무조건 벗겨낼 수 없다. 비어 있는 optional에는 꺼낼 값이 없고, range에서 임의의 값 하나만 고르면 나머지 결과를 잃으며, 비동기 계산을 동기적으로 기다리면 실행 모델이 달라진다. Reader에는 아직 환경이 없을 수 있고, Writer에서 값만 취하면 로그를 버리게 된다. 따라서 합성의 목표는 상자를 제거하는 것이 아니라, 그 의미를 유지한 채 내부 값에 필요한 연산을 적용하는 것이다.
Functor — 상자를 유지하면서 결과를 변환한다
펑터(Functor)는 강연에서 값을 매핑할 수 있는 타입 생성자(type constructor)로 소개된다. 여기서 중요한 대상은 std::optional<int>라는 특정 타입 하나가 아니라, 원소 타입에 따라 여러 타입을 만드는 std::optional이라는 계열이다. 일반 함수가 T → U라면, 펑터의 매핑 연산은 이를 F<T> → F<U>로 끌어올린다. Haskell에서는 이 연산을 fmap이라고 부르며, 강연자는 함수를 상자에 맞게 들어 올린다는 리프팅(lifting) 관점을 강조한다.
optional에서는 값이 있을 때만 함수를 호출하고 결과를 다시 optional로 감싸며, 값이 없으면 빈 상태를 유지한다. range에서는 각 원소에 함수를 적용하고, sender에서는 앞선 작업이 전달한 성공 값에 후속 함수를 적용한다. 강연은 이 대응을 각각 transform, views::transform, then으로 설명한다. API 이름은 달라도 기존 계산의 틀을 유지하면서 성공 값의 형태를 바꾼다는 공통점이 있다.
| 계산 구조 | 강연에서 대응시킨 매핑 연산 | 보존하는 의미 |
|---|---|---|
optional | transform | 값의 존재 또는 부재 |
expected | 성공 값에 대한 transform | 기존 오류를 포함한 결과 구조 |
| range | views::transform | 원소들의 순회 구조 |
| sender | then | 비동기 계산의 연결 |
이 관점에서는 lookupUser와 getAddress의 연결도 명확해진다. getAddress 자체를 모든 상자 타입에 맞춰 다시 구현하는 대신, fmap으로 들어 올린 함수를 조회 결과에 적용하면 된다. 강연의 range 예시는 결과를 컨테이너에 즉시 모으는 구현과 지연 평가하는 뷰를 구분하므로, 같은 개념이 동일한 저장 방식이나 실행 시점을 뜻하지 않는다는 점도 드러난다. 또한 슬라이드의 std::function 표기는 함수 시그니처를 보여주기 위한 것으로, 실제 구현에 그 타입을 사용하라는 권고가 아니라고 강연자는 명시한다.
Applicative — 독립적인 여러 결과를 함께 사용한다
단일 값의 변환만으로 해결되지 않는 사례는 주소와 청구서를 따로 조회한 뒤 발송할 우편물을 만드는 작업이다. 두 조회 결과가 모두 상자에 들어 있다면, 우편물을 만드는 함수에는 두 상자의 내부 값이 동시에 필요하다. 이때 fmap을 중첩하면 안쪽 매핑이 만든 F<Mail>을 바깥 매핑이 다시 감싸므로 F<F<Mail>>이 된다. 문제는 값에 접근할 수 없다는 데 있지 않고, 결과를 감싸는 층이 의도보다 하나 더 생긴다는 데 있다.
어플리커티브(Applicative)는 이 문제를 여러 상자에 대한 매핑으로 설명할 수 있게 한다. 강연자는 C++의 가변 인자 관점에서, 여러 일반 값을 받아 하나의 결과를 만드는 함수를 여러 상자에 직접 적용하는 연산으로 소개한다. optional이라면 모든 입력에 값이 있어야 결과를 만들고, sender라면 필요한 작업들의 결과가 모두 준비된 뒤 결합 함수를 실행한다. 후자의 설명에서는 when_all로 작업들을 결합한 뒤 then으로 결과를 처리하는 구성이 등장한다.
range에서는 어떤 방식으로 여러 입력을 결합할지 선택해야 한다. 모든 주소와 모든 청구서의 가능한 조합을 만든다면 데카르트 곱(Cartesian product)이 되고, 같은 위치의 주소와 청구서를 대응시킨다면 zip이 된다. 강연은 두 해석을 모두 보여주며, 같은 자료형을 사용하더라도 합성 연산의 의미가 하나로 고정되는 것은 아니라고 설명한다. 주소와 청구서가 각각 여러 개 있을 때 모든 조합을 생성하는 것과 위치별로 대응시키는 것은 결과의 의미와 개수 모두에서 크게 다르다.
강연자는 make_tuple을 결합 함수로 사용하면 일반적인 when_all 형태를 얻을 수 있다고 설명한다. 반대로 최종 연산을 직접 가변 인자 매핑에 전달하면 중간 튜플을 명시적으로 만드는 단계를 피할 수 있다. 이는 불필요한 중간 표현을 줄이는 설계상의 가능성이며, 모든 구현에서 측정 가능한 성능 향상을 보장한다는 뜻은 아니다. zip_transform도 같은 맥락에서, 값을 묶은 뒤 다시 풀어 적용하는 작업을 하나의 연산으로 표현하는 사례다.
입력이 없는 경우가 추상화의 경계를 드러낸다
가변 인자 연산이라면 입력이 0개인 경우도 생각할 수 있다. 강연에서는 인자를 받지 않고 값을 반환하는 함수를 상자 안에서 실행하는 경우를 통해 pure를 도출한다. 이는 이미 가진 값을 해당 계산 구조 안에 넣는 연산이며, 입력 개수를 줄여 생각하는 것만으로 필요한 기본 연산이 드러나는 사례다. 어플리커티브를 단순히 여러 컨테이너를 함께 순회하는 편의 기능으로만 이해하면 이러한 경계 조건을 놓치게 된다.
강연의 std::map 사례는 왜 모든 펑터가 자연스럽게 어플리커티브가 되는 것은 아닌지 보여준다. 키를 유지하고 값만 변환하는 매핑은 정의할 수 있지만, 키 집합이 다른 여러 맵을 어떻게 결합할지는 추가적인 의미 선택이 필요하다. 특히 입력 맵이 전혀 없는 상태에서 값 하나를 넣는 pure를 생각하면, 어떤 키들을 만들어야 하는지 답하기 어렵다. 강연의 요지는 보통의 유한한 키 기반 맵과 키 보존 매핑에 대해, 기대하는 성질을 만족하는 확장이 자연스럽게 따라오지 않는다는 것이다.
Alternative — 모두가 아니라 선택 가능한 결과를 결합한다
사용자의 연락처가 여러 개 등록되어 있지만 그중 사용할 수 있는 주소 하나만 필요하다면, 모든 결과를 요구하는 어플리커티브는 지나치게 강한 조건이 된다. 여러 optional에 매핑해 그중 하나를 반환하더라도, 매핑 함수가 호출되려면 우선 모든 주소가 존재해야 한다. sender에서도 같은 방식은 모든 작업의 완료를 기다리게 된다. 강연자는 이처럼 필요한 정보와 합성 연산이 요구하는 정보가 어긋나는 상황에서 얼터너티브(Alternative)를 도입한다.
강연의 설명에서 optional의 선택 연산은 값이 있는 첫 번째 상자를 고르는 방식이다. sender의 대응물은 여러 후보 중 먼저 완료되는 작업을 선택하는 when_any 형태이며, range에서는 가능한 선택들을 모두 나열하는 연결(concatenation)로 해석할 수 있다. range의 또 다른 구현으로 첫 번째 비어 있지 않은 범위를 선택하는 방식도 소개된다. 따라서 여기서 선택한다는 말은 반드시 값 하나만 반환한다는 뜻이 아니라, 해당 계산 구조에서 대안들을 어떻게 결합할지 정한다는 뜻이다.
입력이 없는 선택 연산은 empty로 연결된다. optional에서는 빈 값이, range의 연결에서는 빈 범위가 다른 후보의 결과를 바꾸지 않는 항등원 역할을 한다. 강연이 단순화한 sender 경쟁 모델에서는 영원히 완료되지 않는 작업이 선택되지 않는 후보에 해당한다. 어플리커티브가 모든 결과를 모으는 논리곱의 성격을 가진다면, 얼터너티브는 가능한 결과를 선택하는 논리합의 성격을 가진다는 대칭이 여기서 나타난다.
이 설명은 강연에서 사용하는 C++ 중심의 개념화이며, Haskell의 정확한 타입 클래스 계층 전체와 동일하게 읽어서는 안 된다. 또한 비동기 작업에서 먼저 완료된다는 것과 먼저 성공한다는 것은 서로 다른 조건이고, 실제 구현에서는 오류와 취소를 어떻게 다루는지도 필요하다. 강연은 이러한 채널의 전체 정책보다 성공 값의 합성을 중심으로 설명한다. 비어 있지 않음을 보장하는 컨테이너는 매핑할 수 있어도 empty를 제공할 수 없다는 예시 역시, 선택 연산에 필요한 조건을 드러내기 위한 것이다.
Monad — 이전 결과에 따라 다음 계산을 결정한다
모나드(Monad)가 필요한 상황은 뒤에 연결할 함수도 상자를 반환할 때다. 사용자 조회가 optional<User>를 반환하고 주소 조회도 User → optional<Address>라면, 평범한 fmap의 결과는 optional<optional<Address>>가 된다. 원하는 결과는 중첩된 실패 상태가 아니라 사용자 조회 또는 주소 조회의 실패를 반영하는 하나의 optional<Address>다. 모나드의 bind는 상자를 반환하는 함수를 기존 상자의 값에 적용하면서 이러한 중첩을 추가하지 않도록 한다.
강연은 이 연산을 optional의 and_then, range의 transform과 join 조합, sender의 let_value에 대응시킨다. range에서는 각 입력이 다시 여러 결과를 만들기 때문에 중첩된 범위를 평탄화해야 하고, sender에서는 앞 작업의 결과로 다음 비동기 작업을 만들어 연결한다. 이때 기본적인 bind 설명은 같은 종류의 상자를 전제로 한다. sender와 optional처럼 서로 다른 의미의 상자를 결합하면 두 의미를 모두 보존하는 중첩이 필요할 수 있으므로, 이를 같은 상자의 평탄화와 혼동해서는 안 된다.
bind가 더 강력한 이유는 다음 단계가 이전 값에 따라 계산의 구조를 바꿀 수 있기 때문이다. optional을 반환하는 함수는 값을 보고 실패를 선택할 수 있고, range를 반환하는 함수는 값마다 서로 다른 개수의 결과를 만들 수 있다. sender를 반환하는 함수는 이전 결과를 바탕으로 새로운 작업이나 다른 완료 경로를 선택할 수 있다. 반면 fmap은 해당 상자의 성공 값을 변환하는 역할이므로, 강연은 두 연산을 구분하면 코드가 가진 능력을 더 정확히 읽을 수 있다고 주장한다.
여기서 fmap의 함수는 실패하지 않는다는 표현은 상자가 표현하는 실패 경로를 새로 만들지 않는다는 뜻으로 이해해야 한다. C++의 일반 함수가 예외를 던지지 않는다거나 부작용을 갖지 않는다는 보장까지 자동으로 생기는 것은 아니다. bind 역시 모든 중첩을 무조건 제거하는 만능 연산이 아니라, 해당 모나드가 정의하는 계산 연결 규칙을 따른다. 이러한 범위를 분명히 해야 강연의 타입 수준 설명을 실제 C++의 실행 동작과 혼동하지 않을 수 있다.
더 강한 추상화가 동시 실행의 기회를 줄이는 이유
강연자는 bind와 단일 입력 fmap으로 여러 결과를 결합하는 연산을 만들 수 있다고 설명한다. 다만 모나드에는 값을 넣는 pure도 필요하며, 강연 중 질의응답에서는 0개 입력을 처리하려면 이 경우까지 포함해야 한다는 점이 보완된다. 중첩된 상자를 합치는 join도 bind에 항등 함수를 전달하는 방식으로 도출할 수 있다. 이 관계는 모나드가 어플리커티브의 기능을 제공할 수 있음을 보여주지만, 구현상 같은 성질을 얻는다는 뜻은 아니다.
sender를 let_value로 하나씩 연결해 when_all과 비슷한 결과를 만들면, 첫 작업이 완료된 다음 두 번째 작업을 시작하는 연쇄가 될 수 있다. 최종적으로 모든 결과를 모으더라도, 독립적인 작업을 함께 진행할 가능성을 잃는 것이다. 반면 어플리커티브 방식의 결합은 후속 작업을 앞선 값으로 생성해야 한다는 의존성을 요구하지 않는다. 따라서 강연자는 필요한 것이 독립적인 결과의 결합뿐이라면, 인터페이스가 불필요하게 모나드 수준의 의존 관계를 요구하지 않도록 해야 한다고 강조한다.
이 주장은 모나드를 사용하는 프로그램 전체가 반드시 순차 실행된다는 뜻이 아니다. 핵심은 bind로 표현한 해당 의존 경계에서는 다음 계산을 결정하기 위해 앞선 결과가 필요하다는 데 있다. 작업 내부에서 동시 실행을 사용할 수도 있고, 독립적인 부분은 어플리커티브로 묶은 뒤 의존적인 부분만 bind로 연결할 수도 있다. 강연의 설계 교훈은 더 강력한 연산을 항상 선택하는 대신, 실제 의존성을 정확히 표현하는 연산을 선택하라는 것이다.
range의 zip 사례도 이러한 구분을 뒷받침한다. 강연자는 각 입력에 따라 서로 다른 길이의 범위를 반환하는 일반적인 bind로부터, 위치별 결합이라는 zip 의미를 일관되게 복원하기 어렵다고 설명한다. 이는 어플리커티브와 모나드가 단순히 연산 개수만 다른 관계가 아니라, 연산들이 서로 어떤 의미로 호환되는지가 중요한 구조임을 보여준다. 한 타입이 어떤 매핑과 결합을 지원한다는 사실만으로 더 강한 모든 추상화를 지원한다고 결론 내릴 수는 없다.
Contravariant Functor — 결과를 바꾸는 대신 입력을 준비한다
강연 후반부는 값을 생산하는 계산에서 값을 소비하는 계산으로 관점을 전환한다. 공변성(covariance)은 타입 사이의 관계를 같은 방향으로 유지하고, 반공변성(contravariance)은 그 방향을 뒤집는다. 일반 사용자를 처리할 수 있는 콜백은 프리미엄 사용자만 전달되는 자리에서도 사용할 수 있지만, 프리미엄 사용자만 처리할 수 있는 콜백을 모든 사용자가 전달되는 자리에 놓을 수는 없다. 이 사례는 소비자가 받아들일 수 있는 입력 범위로 반공변성을 설명한다.
펑터의 fmap이 생산된 결과 뒤에 변환을 붙인다면, 반공변 펑터의 contramap은 소비자의 앞에 변환을 붙인다. T를 소비하는 기능이 있을 때 U → T라는 변환을 제공하면, 이를 이용해 U를 소비하는 기능을 만들 수 있다. 청구서를 받아 연체 여부를 판단하는 술어(predicate)에 사용자 ID로 청구서를 조회하는 함수를 앞세우면, 사용자 ID를 받아 연체 여부를 판단하는 술어가 된다. 최종 판단 로직을 복제하지 않고 입력을 그 로직이 이해하는 형태로 바꾸는 것이다.
강연자는 C++ ranges 알고리즘의 투영(projection)을 이 관점과 연결한다. 알고리즘에 술어와 투영을 따로 전달하면, 원소를 먼저 변환한 뒤 술어에 넘기는 구성이 만들어진다. 이는 라이브러리가 contramap이라는 이름을 사용하지 않아도 같은 합성 패턴을 제공할 수 있음을 보여준다. 직렬화기(serializer) 역시 값을 소비하므로, 기존 직렬화기 앞에 필요한 변환을 배치해 더 큰 객체나 다른 입력 표현을 처리하도록 확장할 수 있다.
Divisible과 Decidable — 소비자를 분해와 분기로 조합한다
여러 생산자의 결과를 결합하는 어플리커티브에 대응해, 여러 소비자로 하나의 입력을 처리하는 구조가 디비저블(Divisible)이다. 입력 객체를 여러 부분으로 나눈 다음 각 부분을 알맞은 소비자에 전달하면, 전체 객체를 소비하는 기능을 만들 수 있다. 강연의 청구서 예시는 객체를 만기일과 결제 상태로 분해하고, 각 부분의 술어를 결합해 최종 판단을 수행한다. 강연자는 이 대목에서 첫 번째 술어가 청구서 전체가 아니라 날짜에 대한 연산이어야 한다고 직접 정정한다.
직렬화에서는 이 구조가 특히 직관적이다. 복합 객체를 필드들로 분해하고 각 필드의 직렬화기를 실행하면 전체 객체의 직렬화기를 구성할 수 있다. 아무 부분도 소비하지 않는 경우는 conquer에 대응하며, 직렬화에서는 아무것도 기록하지 않는 소비자, 논리곱으로 결합하는 술어에서는 항상 참을 반환하는 소비자로 이해할 수 있다. 이름은 분할 정복을 연상시키지만, 강연의 핵심은 재귀 알고리즘보다 소비자를 구조적으로 조합하는 방식이다.
디사이더블(Decidable)은 모든 부분을 소비하는 대신 입력을 보고 적절한 소비자 하나로 분기한다. 사용자가 일반 사용자라면 무료 체험 여부를 검사하고, 프리미엄 사용자라면 그 유형에 맞는 규칙을 적용하는 식이다. 생산된 상자를 선택할 때와 달리 소비자들은 아직 입력을 받지 않았으므로, 입력을 어느 갈래로 보낼지 결정하는 분류 함수가 필요하다. 강연은 이를 variant로 분류한 뒤 방문 연산으로 해당 소비자를 실행하는 형태와 연결한다.
| 소비자 합성 | 입력을 바라보는 방식 | 직렬화에서의 대응 | 대표 연산 및 경계 연산 |
|---|---|---|---|
Contravariant | 입력을 다른 형태로 변환 | 변환 후 기존 직렬화기 사용 | contramap |
Divisible | 입력을 여러 부분으로 분해 | 튜플이나 구조체의 필드 처리 | conquer |
Decidable | 입력을 가능한 갈래 중 하나로 분류 | variant의 활성 대안 처리 | lose |
이 관계에서 Divisible은 모든 구성 요소가 함께 있는 곱 타입(product type), Decidable은 가능한 대안 중 하나가 있는 합 타입(sum type)의 소비 방식과 연결된다. lose는 선택지가 하나도 없는 불가능한 입력에 대한 경계 사례이며, 단순히 호출되어도 아무것도 하지 않는 conquer와 다르다. 강연자는 이러한 대칭을 통해 술어와 직렬화기를 개별 구현으로만 보지 않고 재사용 가능한 조합 규칙으로 바라보게 한다. 다만 완성된 직렬화 포맷에 필요한 구분자, 태그, 오류 처리 규약까지 이 연산만으로 자동 결정되는 것은 아니다.
Comonad는 반공변 모나드와 다르다
강연자는 같은 방식으로 반공변 모나드를 만들 수 있는지도 질문한다. 그러나 모나드의 연산에는 이미 상자가 포함된 함수가 등장하기 때문에, 단순히 입력과 출력의 방향을 바꾸는 방식으로 앞선 대칭을 이어갈 수 없다고 설명한다. 이어서 전체 상자 문맥을 관찰하는 계산과 상자를 중첩시키는 duplicate를 가진 코모나드(Comonad)를 짧게 소개한다. 중요한 구분은 코모나드도 일반적인 공변 펑터 구조를 가지며, 소비자용 모나드라는 뜻이 아니라는 점이다.
Foldable — 구조를 하나의 요약으로 바꾼다
상자를 일반적으로 제거할 수 없더라도, 어떤 자료구조는 값들을 요약해 하나의 결과로 만들 수 있다. 정수들의 합, 원소 수, 청구서 총액처럼 시작 값과 결합 규칙이 있으면 전체를 누적할 수 있기 때문이다. 강연은 이때 사용하는 구조를 모노이드(Monoid)로 설명한다. 모노이드는 결합법칙을 만족하는 이항 연산과 그 연산의 결과를 바꾸지 않는 항등원을 가지며, 이 덕분에 빈 입력까지 포함한 요약 규칙을 정의할 수 있다.
폴더블(Foldable)의 foldMap은 각 원소를 요약에 적합한 값으로 바꾼 뒤 그 값들을 결합한다. 청구서들을 금액으로 변환해 더하면 총액이 되고, 각 원소를 1로 매핑해 더하면 길이가 되며, 원소를 순서대로 모으면 리스트 형태의 결과를 만들 수 있다. 강연은 이러한 요약 가능성을 통해 자료구조가 어느 정도 리스트처럼 관찰될 수 있다고 설명한다. 다만 최대·최소처럼 빈 입력의 결과가 자명하지 않은 연산에서는, 대상 타입에 적절한 경곗값이 있는지 또는 빈 결과를 별도로 표현할지 확인해야 한다.
Foldable과 Functor는 서로 다른 능력을 표현한다. 강연의 std::set 사례에서는 원소를 순회해 누적하는 것은 가능하지만, 임의의 결과 타입으로 변환한 뒤에도 집합의 정렬 요구를 충족한다고 보장할 수는 없다. 복소수 예시는 기본적인 순서 관계를 기대하는 집합과 임의 타입 매핑 사이의 제약을 드러내는 것이며, 별도 비교자를 갖춘 복소수 집합까지 불가능하다는 뜻은 아니다. 반대로 sender는 결과를 매핑할 수 있어도, 여기서 논의하는 동기적인 요약 연산으로 즉시 값을 꺼내려면 실행 모델을 바꿔야 하므로 같은 의미의 Foldable로 취급하지 않는다.
Traversable — 효과를 모으면서 원래 구조를 보존한다
사용자들이 담긴 자료구조에서 모든 사용자가 유효한지 검사한다고 해보자. 불리언 결과만 필요하면 참으로 시작해 각 검증 결과를 논리곱으로 누적할 수 있다. 그러나 모두 유효한 경우에는 원래 구조의 사용자들을 반환하고, 하나라도 잘못되면 전체 실패를 반환하려면 요구가 달라진다. 원하는 결과는 S<optional<User>>가 아니라 optional<S<User>>이며, 여기서 S는 원래 자료구조의 형태를 나타낸다.
평범한 fmap은 각 사용자에 검증 함수를 적용해 구조 안쪽에 optional을 만든다. Foldable만 사용하면 값들을 모으는 것은 가능하지만, 임의의 원래 구조를 복원할 정보가 일반 인터페이스에 충분히 남아 있지는 않다. 특히 트리처럼 단순한 원소 나열 이상의 형태를 갖는 자료구조에서는 이 차이가 중요하다. 강연은 구조를 유지하면서 내부 효과를 바깥으로 모으는 연산으로 sequence를 도입한다.
벡터의 경우 vector<optional<T>>를 optional<vector<T>>로 바꾸는 동작은 명확하다. 처음에는 빈 벡터가 들어 있는 성공한 optional을 만들고, 누적 결과와 다음 원소가 모두 유효할 때만 값을 추가한다. 원소 하나라도 비어 있으면 전체 결과가 빈 optional이 된다. 반면 입력 벡터 자체가 비어 있으면 실패한 원소가 없으므로, 결과는 빈 벡터를 담은 유효한 optional이다.
이 구현을 추상적으로 읽으면 초기화는 pure, 누적은 두 상자에 대한 어플리커티브 매핑에 해당한다. 따라서 같은 구조를 optional뿐 아니라 다른 어플리커티브에도 적용할 수 있다. 강연은 작업들의 벡터를 벡터 결과를 내는 하나의 작업으로 바꾸는 경우를 예로 들며, 이를 동적 개수의 작업에 대한 when_all과 연결한다. 다만 일반적인 이항 결합을 중첩하는 구현보다 전용 구현이 효율적일 수 있다는 점도 명시한다.
Traverse는 변환과 효과 수집을 하나로 묶는다
각 원소를 효과가 있는 값으로 변환한 뒤 sequence하는 패턴은 traverse로 합쳐진다. 개념적으로 T → F<U>인 함수와 구조 S<T>가 있을 때, 순회 결과는 F<S<U>>가 된다. 입력의 구조 S는 원소의 배치를 제공하고, 각 원소에서 발생한 효과 F는 어플리커티브 규칙에 따라 결합되어 결과의 바깥쪽에 놓인다. 이를 지원하는 구조가 트래버서블(Traversable)이다.
sequence는 traverse에 항등 함수를 전달한 경우로 볼 수 있다. 이미 각 원소가 효과를 가진 값이라면 새 변환 없이 그 효과의 배치만 바꾸면 되기 때문이다. 다만 모든 중첩 타입을 임의로 뒤집을 수 있다는 뜻은 아니며, 바깥 구조에는 순회 능력이, 모으려는 효과에는 적절한 어플리커티브 구조가 필요하다. 서로 다른 두 상자를 다루는 이 연산은 같은 종류의 상자를 평탄화하는 모나드의 join과 구별된다.
강연 후반의 질의응답은 optional 순회의 실패 의미를 재확인한다. 원소 중 하나라도 빈 값이면 전체가 실패하며, 빈 원소들을 제거한 성공 벡터로 바꾸는 연산이 아니다. 또한 최종 결과가 실패한다는 의미와, 구현이 이후 검증 함수 호출이나 반복을 즉시 중단한다는 실행 특성은 구분해야 한다. 강연에서도 단순 누적 구현의 효율성은 별도 문제로 다루므로, 모든 어플리커티브 순회에 동일한 단락 평가(short-circuiting)를 가정해서는 안 된다.
Identity와 Const — 같은 순회에서 변환과 요약을 얻는다
강연자는 Traversable의 관계를 설명하기 위해 Identity와 Const라는 작은 도구를 도입한다. Identity는 값을 감싸되 추가적인 실패나 비동기 의미를 부여하지 않는 구조이며, 매핑은 함수를 적용하고 결과를 다시 감싸는 동작이다. 순회의 효과로 Identity를 사용하면 전체 과정은 각 원소를 변환하고 구조를 다시 만드는 일로 귀결된다. 따라서 traverse에서 일반적인 fmap을 얻을 수 있다.
Const는 반대로 매핑 함수가 요청하는 값의 변환을 무시하고 별도로 보관한 정보를 유지한다. 모노이드 값을 보관하도록 만들면 여러 Const를 결합할 때 그 정보들을 누적할 수 있다. 순회에 이를 사용하면 구조를 변환하는 대신 각 위치에서 얻은 정보를 요약하게 되므로 foldMap을 얻는다. 여기서 Const는 C++의 const 한정자가 아니라 별도의 함수형 래퍼 개념이다.
이 두 구성을 통해 강연자는 Traversable이 Functor와 Foldable의 기능을 모두 제공한다는 관계를 설명한다. 반대 방향이 자동으로 성립하지 않는 이유도 드러나는데, 값을 요약할 수 있다는 사실만으로 원래 구조를 보존하며 효과를 수집할 수 있는 것은 아니다. 마지막 질의응답에서 Identity를 안전하게 벗길 수 있는 이유를 묻자, 강연자는 호출자가 바로 그 상자를 선택했기 때문이라고 답한다. 이는 임의의 상자를 제거할 수 있다는 주장이 아니라, 추가적인 조건이 없는 특정 구조의 성질을 사용한 것이다.
Traversal과 Lens — 컨테이너에서 객체의 특정 필드로
마지막 주제는 일반 컨테이너가 아니라 구체적인 객체 내부의 일부를 다루는 합성이다. 연락처 구조체에 이메일 주소 두 개와 물리적 주소 하나가 있을 때, 이메일들만 검증하고 하나라도 잘못되면 전체 연락처를 실패로 만들고 싶을 수 있다. 이 구조체는 임의 원소 타입으로 매개변수화된 컨테이너가 아니므로, 앞선 Traversable을 그대로 적용하는 방식과는 차이가 있다. 대신 이메일들이 있는 위치를 알고 방문하는 트래버설(traversal)을 정의한다.
이메일 traversal은 전달받은 함수를 각 이메일에 적용한 뒤, 어플리커티브 연산으로 결과들을 모아 연락처를 다시 구성한다. 효과가 optional이면 어느 이메일의 검증이라도 실패할 때 전체 결과가 실패한다. 이 실패 의미는 모든 어플리커티브에 공통인 성질이 아니라, 선택한 optional 효과에서 나온다. 또한 강연에서 다루는 구체적 구조체는 이메일 필드의 타입이 고정되어 있으므로, 이 예시의 순회는 해당 필드 타입을 유지하는 변환으로 제한된다.
검증 대신 이메일 정규화처럼 일반적인 변환을 적용하고 싶다면 Identity를 사용하면 된다. 각 변환 결과를 Identity로 감싸 순회한 뒤 마지막 래퍼를 제거하는 패턴이 over라는 연산으로 정리된다. 기존 값을 무시하고 지정한 값으로 바꾸는 함수를 over에 전달하면 set도 얻는다. 한 번 방문 위치를 정의해두면 검증, 정규화, 일괄 교체가 같은 구조적 지식을 공유하게 되는 것이다.
정확히 하나를 가리킨다는 정보의 가치
물리적 주소는 하나뿐이므로 여러 효과를 결합하는 어플리커티브까지 필요하지 않다. 주소에 함수를 적용하고 그 결과로 연락처를 다시 만드는 단일 fmap만 있으면 된다. 강연에서는 정확히 하나의 대상에 초점을 맞추며 Functor만 요구하는 이러한 구성을 렌즈(lens)라고 부른다. 렌즈는 traversal이 필요한 자리에서도 사용할 수 있지만, 요구 조건이 더 약하기 때문에 추가적인 활용이 가능하다.
그 대표적인 활용이 view다. 렌즈에 Const를 사용하면 객체를 갱신하는 변환은 무시하고, 초점을 맞춘 주소만 보관해 반환할 수 있다. 대상이 정확히 하나이므로 여러 결과를 합칠 모노이드 규칙도 필요하지 않다. 여러 대상을 다루는 순회와 하나를 읽는 렌즈의 차이는 단순한 편의 API 차이가 아니라, 대상 개수에 대한 정보가 어떤 연산을 가능하게 하는지 보여준다.
강연은 더 넓은 옵틱스(optics) 계열로 동형사상(isomorphism)과 프리즘(prism)도 짧게 언급한다. 동형사상은 양방향 변환을, 프리즘은 가능한 대안 중 특정 갈래처럼 0개 또는 1개의 대상에 초점을 맞추는 구조를 이해하는 출발점으로 소개된다. 다만 프리즘을 정확히 하나의 대상을 보장하는 렌즈와 동일한 것으로 읽어서는 안 된다. 이 부분은 개념의 확장 가능성을 보여주는 예고이며, 세부 연산과 법칙은 강연에서 본격적으로 다루지 않는다.
성능 측면에서는 객체를 복사해 수정한 결과를 반환하는 형태를 C++에 맞게 제자리 변경으로 바꿀 수 있다는 언급이 나온다. 그러나 이번 검수 자료에는 참조의 수명, 이동, 별칭, 예외 발생 시 부분 변경을 처리하는 실제 코드가 없다. 따라서 제자리 변경이 언제나 더 낫다거나 같은 보장을 유지한다고 단정할 근거는 없다. 강연에서 확실히 드러나는 장점은 복잡한 객체의 방문 위치를 한 번 표현한 뒤 여러 연산에서 재사용할 수 있다는 점이다.
기술적 해석에서 구분해야 할 경계
이 강연은 개념을 실제 합성 문제에서 도출하는 데 집중하므로, 각 추상화의 법칙을 모두 형식적으로 전개하지는 않는다. fmap, pure, bind처럼 이름과 타입 모양이 맞는 연산이 있다는 사실만으로 법칙까지 자동으로 성립하는 것은 아니다. 예를 들어 range의 데카르트 곱과 zip은 같은 자료형에 대한 서로 다른 결합 의미이며, 0개 입력과 무한 범위를 포함한 세부 정의도 함께 고려해야 한다. 따라서 강연의 가변 인자 설명은 설계 직관으로 읽고, 범용 라이브러리 구현에서는 연산 사이의 일관성을 별도로 검증해야 한다.
표준화 상태에 관한 발언도 주의해서 읽어야 한다. 기존 리포트에 따르면 when_all이 0개의 sender를 지원하는지에 대해 강연 중 서로 반대되는 답변이 등장하며, 후반에는 이를 수정하는 문서를 준비했다는 발언이 나온다. 이 리포트는 별도 표준 문서를 확인하지 않았으므로 어느 발언을 현재 사양으로 확정하지 않는다. 여기서 설명하는 개념적 구분은, 어플리커티브 모델의 0개 입력은 즉시 성공하는 계산으로, 경쟁적 선택 모델의 0개 입력은 완료되지 않는 계산으로 이해한다는 것이다.
전체 설명에서 비용 모델 역시 추상화의 이름과 분리해야 한다. 지연 range는 명시적인 중간 컨테이너를 줄일 수 있고, 독립적인 sender 결합은 동시 진행을 허용하지만, 실제 할당 횟수나 실행 시간은 구현과 스케줄링에 달려 있다. 범용 sequence의 의미가 전용 when_all과 대응한다고 해서 작업 상태의 저장 방식이나 결합 깊이까지 같아지는 것도 아니다. 강연자가 지향하는 것은 추상화만으로 비용을 없애는 방식이 아니라, 잘 최적화된 구성 요소들을 올바른 의미로 연결하는 방식이다.
마무리 — 필요한 능력만 요구하는 합성의 설계
강연의 흐름을 따라가면 각 개념은 서로 다른 질문에 답한다. Functor는 결과를 어떻게 바꿀지, Applicative는 독립적인 결과들을 어떻게 함께 사용할지, Monad는 앞선 결과에 따라 다음 계산을 어떻게 정할지 설명한다. Contravariant와 그 확장들은 입력을 소비자에게 맞게 준비하고 분해하거나 분류하는 문제를 다룬다. Foldable과 Traversable, traversal과 lens는 값을 요약할지, 구조를 유지할지, 특정 위치에 초점을 맞출지를 구분한다.
이러한 구분이 중요한 이유는 더 많은 기능을 가진 추상화가 언제나 더 좋은 인터페이스는 아니기 때문이다. 독립적인 작업을 불필요한 bind 연쇄로 표현하면 동시 실행의 기회를 감추고, 원래 구조가 필요한 작업을 fold로만 표현하면 복원에 필요한 정보를 잃기 쉽다. 정확히 하나의 필드를 다루는 연산에서 다중 결과 결합까지 요구하면, 단순한 읽기처럼 더 약한 조건으로 가능한 활용을 놓칠 수 있다. 좋은 합성은 필요한 계산 능력을 제공하면서도 불필요한 의존성과 제약을 추가하지 않는다.
Müller가 제시하는 최종 관점은 함수형 합성 패턴을 C++의 설계 패턴으로 받아들이는 것이다. 같은 구조를 알아보면 작업 벡터의 결합을 sequence로 이해하고, 투영을 소비자 앞에 붙는 변환으로 읽으며, 빈 입력의 동작을 임의의 예외가 아닌 기본 연산의 성질에서 도출할 수 있다. 그 위에서 실제 구성 요소의 성능과 정확성을 검증하면, 추상화는 구현 세부를 감추는 데 그치지 않고 재사용의 근거가 된다. 강연이 모나드를 넘어 전달하는 메시지는 이러한 관계를 이해할수록 더 정확하고 유연하게 코드를 연결할 수 있다는 것이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Functional Composition Beyond Monads - Jonathan Müller - C++Now 2026 |
| 채널 | CppNow |
| 강연자 | Jonathan Müller |
| 기존 리포트에 기재된 STT 범위 | 00:00–75:25 [?] — 원문 STT 미제공으로 종료 시점 재확인 불가 |
| 리포트 작성 | 2026-09-14 |
| 작성 방식 | STT 기반 기존 리포트의 문맥 및 표현 검수 |
| 자료 확인 범위 | 기존 리포트와 스크린샷 목록. 원문 STT, 영상 화면, 스크린샷 이미지 및 외부 표준 문서는 별도로 확인하지 않음 |
강연자는 Applicative를 더 자세히 다룬 Ben Deane의 강연과, 작업 벡터에 대한 when_all 구현을 다룬 Robert의 강연을 참고 사례로 언급한다. 다만 이번 검수 자료만으로는 정확한 제목과 발표 정보를 확정하기 어려워 개별 링크를 제시하지 않았다. Divisible을 설명하는 Haskell 문서도 등장하지만, 이 리포트는 해당 문서를 직접 확인한 별도 해설을 포함하지 않는다.
💬 본 리포트는 강연 STT를 바탕으로 작성된 기존 보고서를 검수한 문서다. 정확한 코드와 슬라이드, 강연 중 정정의 맥락은 원본 영상을 참조해 주세요.
영상 주요 장면
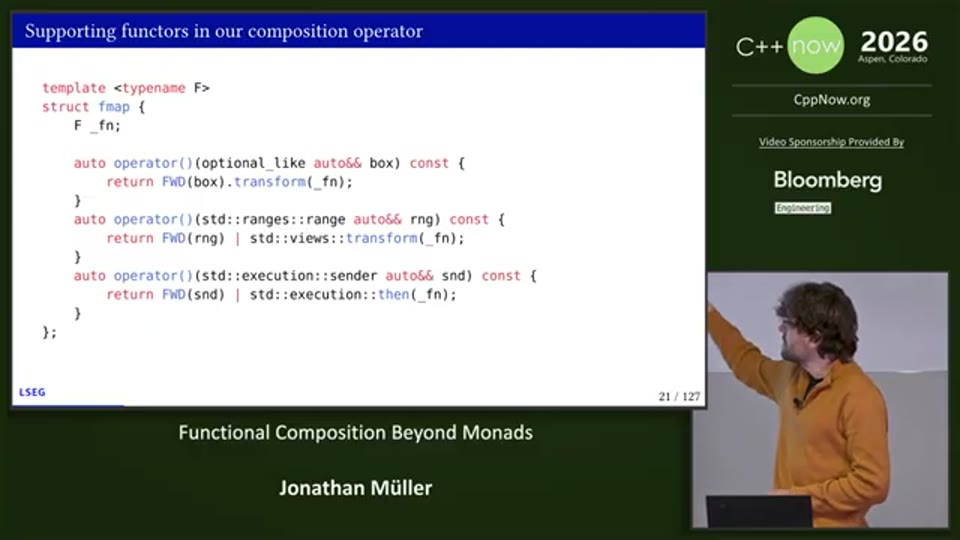
10:38 - fmap으로 일반 함수를 상자에 대한 함수로 들어 올리는 구현 설명 구간이며 optional과 range 및 sender의 대응 코드 확인 지점
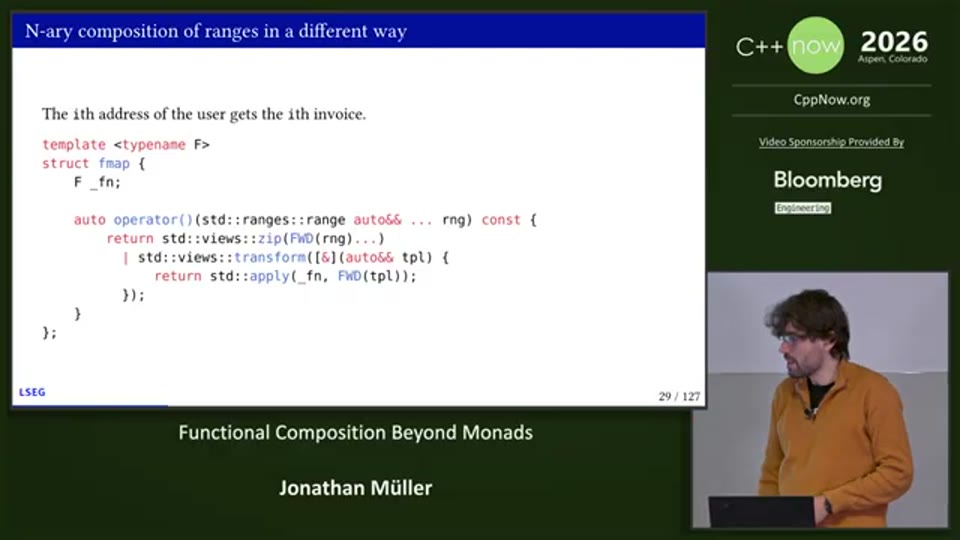
14:58 - range의 Applicative 구현에서 데카르트 곱과 위치별 zip 결합을 비교하는 설명 구간
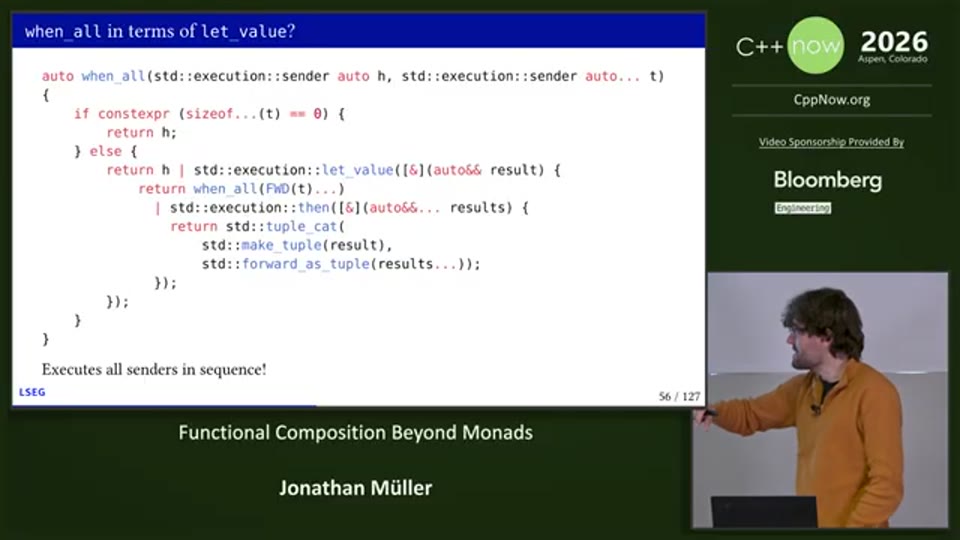
30:55 - let_value로 구성한 when_all이 앞 작업 완료 후 다음 작업을 시작하게 되는 실행 의존성 설명 구간
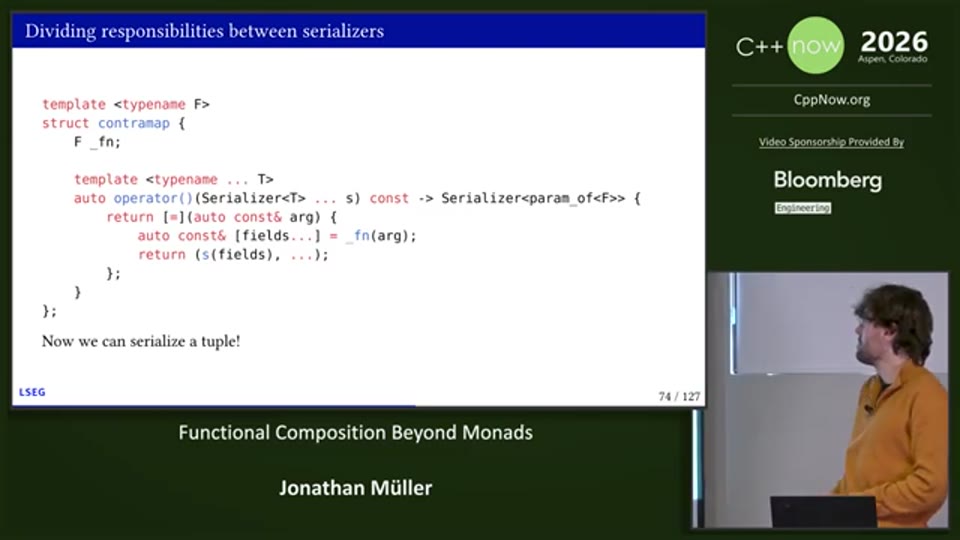
43:33 - Divisible을 이용해 복합 객체를 필드로 분해하고 개별 직렬화기를 결합하는 설명 구간
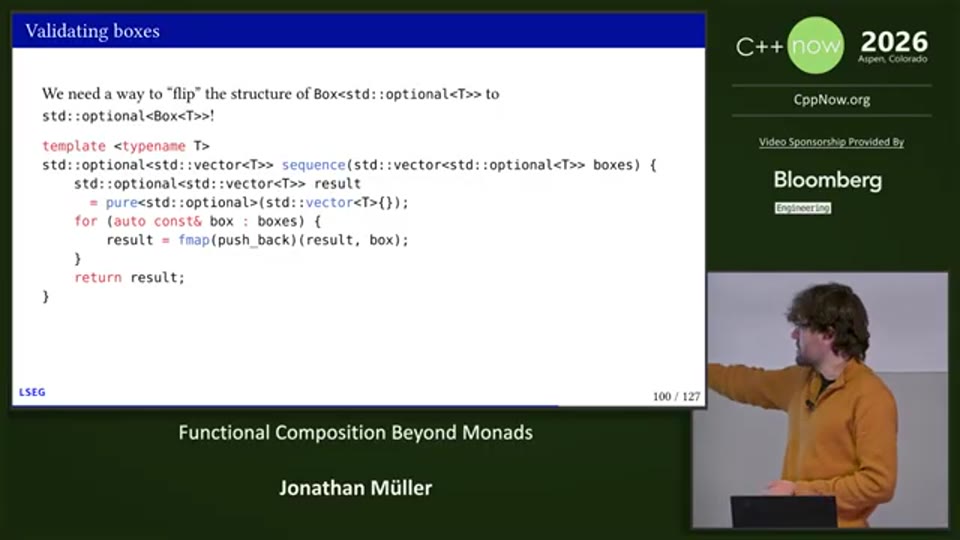
58:45 - vector의 optional 원소들을 pure와 이항 fmap으로 결합해 optional vector를 만드는 sequence 구현 설명 구간