GPT 5.5 vs Claude Opus 4.7 — 같은 프롬프트로 맞붙다
📺 원본 영상: GPT 5.5 vs 클로드 4.7! 같은 프롬프트로 싸움 붙이기! 앙 🎙️ 채널: 코드팩토리 📅 정리 일자: 2026-04-24 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 코드 결과물, 차트, 데모 시연 등의 시각 자료는 포함되지 않을 수 있으며, 결과물에 대한 모든 묘사는 강연자의 음성 해설에 의존합니다.
개요
GPT 5.5가 출시되자 소셜미디어는 또 한 번 AI 모델 전환 논쟁으로 가득 찼다. 당시 Claude에 대한 여론이 좋지 않던 시점이라 “GPT로 갈아타야 하나”는 이야기가 무성했는데, 코드팩토리 채널은 그런 분위기에 편승하지 않고 정량적 비교를 시도했다. Google의 Gemini를 심판 겸 프롬프트 생성자로 세운 뒤, 동일한 프롬프트를 GPT 5.5(Codex)와 Claude Opus 4.7 양쪽에 입력하는 방식으로 6개 프로젝트를 수행했다. 단순히 결과물의 품질만 비교한 것이 아니라, 비용·아웃풋 토큰·실행 시간·툴 호출 횟수·입력 토큰·달러당 출력 토큰 효율까지 실측 데이터로 분석했다는 점이 이 영상의 핵심 가치다.
GPT 5.5의 주요 특징과 강점 주장
OpenAI는 GPT 5.5 출시와 함께 에이전틱 코딩(Agentic Coding), 컴퓨터 사용(Computer Use), 지식 작업(Knowledge Work)과 지식 베이스(Knowledge Base), 그리고 광범위한 연구 영역에서 성능이 크게 향상됐다고 발표했다. 강연자가 특히 주목한 부분은 바이오 분야다. GPT 5.5 릴리즈 노트에는 특정 바이오 기업에서 신약 발견(Drug Discovery)에 GPT 5.5를 활용한 사례가 testimonial로 수록되어 있다. 강연자는 이 대목에서 Claude Opus 4.7 릴리즈 때도 비슷하게 바이오 화학(Biochemical) 역량이 강조됐다는 사실을 상기시켰다.
이 흐름은 우연이 아니라는 것이 강연자의 해석이다. “AI가 발전하기 시작하면 다음은 무조건 바이오 쪽”이라고 강조하며, 이미 머신러닝이 활발하게 활용되던 바이오 도메인이 LLM의 고도화와 맞물리면서 가장 빠르게 진화하는 분야가 될 것이라고 전망했다. 두 경쟁 모델이 동시에 같은 영역을 강조한다는 사실 자체가, LLM 역량이 단순한 텍스트 생성을 넘어 복잡한 실세계 문제를 향해 수렴하고 있음을 보여주는 신호라는 것이다.
가격 측면에서 GPT 5.5는 입력 토큰 100만 개당 30으로 책정됐으며, 이는 전작인 GPT 5.4 대비 소폭 인상된 수치다. OpenAI는 토큰 효율이 향상되어 Codex 등에서 더 적은 토큰으로 동등한 퍼포먼스를 낼 수 있기 때문에 실질 비용은 오히려 줄 수 있다고 주장했다. 프리미엄 버전인 GPT 5.5 Pro는 입력 180으로 매우 높은 단가를 자랑하며, 현재 Plus·Pro·Business·Enterprise 모든 플랜에서 제공된다. 컨텍스트 윈도우는 400K이며, Fast Mode를 사용하면 1.5배 빠른 속도를 제공하는 대신 비용은 2.5배로 증가한다.
공정한 심판, Gemini — 그리고 6가지 테스트 항목
💡 [영상 참조] 강연자는 이 시점에서 Gemini가 생성한 프롬프트 화면과 실제 테스트 구성을 화면으로 보여줍니다. 📺 원본 영상을 확인하세요.
비교의 공정성을 확보하기 위해 강연자는 Google의 Gemini를 프롬프트 생성자 겸 심판으로 활용했다. 강연자 스스로 “Gemini가 요즘 업데이트가 없으니 심판이나 하고 있다”고 너스레를 떨 만큼, Gemini가 직접 생성한 프롬프트를 아무런 수정 없이 양쪽 모델에 그대로 입력하는 방식을 채택했다. 이렇게 설계된 6개의 테스트 프로젝트는 다음과 같다.
- UI/UX & CSS 애니메이션 — 패럴렉스(Parallax) 효과를 활용한 반응형 웹 구현
- 복잡한 웹 구현 — DNA를 3D 모델로 시각화
- 3D 게임 제작 — 물리 시뮬레이션 포함
- 2D 게임 제작 — Flappy Bird 클론
- 한국어 소설 창작 — SF 미스터리 단편
- 스페이스 미션 앱 (Artemis Project) — GPT 5.5 프로모션에서 제공된 프롬프트 그대로 적용
비교 차트에서 주황색이 Claude Opus 4.7, 초록색이 GPT 5.5 Codex를 각각 나타낸다.
코딩 & 웹 개발 능력 비교
패럴렉스 반응형 웹: 이제는 둘 다 그냥 잘한다
💡 [영상 참조] 강연자가 Claude와 GPT 각각이 생성한 패럴렉스 웹 결과물을 실제로 시연합니다. 📺 원본 영상을 확인하세요.
04:10 - Claude Opus 4.7이 만든 패럴렉스(Parallax) 반응형 웹 데모 시연 화면
패럴렉스 효과를 포함한 반응형 웹 구현 테스트에서 두 모델 모두 요구사항을 충분히 만족시키는 결과물을 냈다. 강연자는 주관적으로 Claude의 결과물이 조금 더 마음에 들었다고 언급했으나, GPT 역시 요구사항을 어기거나 결함이 있는 부분은 전혀 없었다고 평가했다. 이 테스트에서 강연자가 끌어낸 결론은 하나다. “이 정도 수준의 UI 구현 작업은 GPT든 Claude든 어떤 LLM이든 전반적으로 잘한다.” 두 모델의 차이를 논하기보다는, 현세대 LLM 전반의 기초 코딩 역량이 이미 성숙 단계에 도달했음을 보여주는 결과였다.
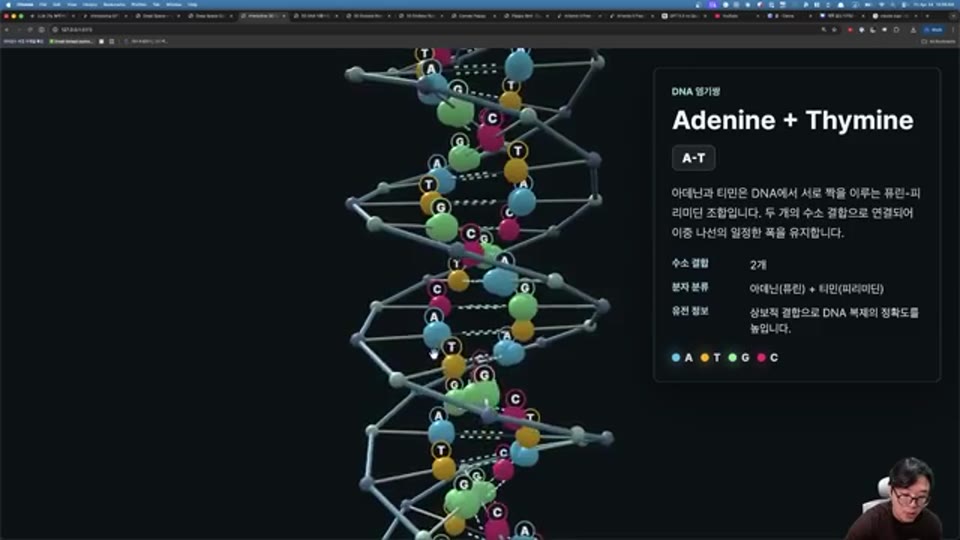
3D DNA 모델링: 방향성의 차이
💡 [영상 참조] 강연자가 GPT와 Claude가 각각 생성한 3D DNA 모델 시연 영상을 보여주며 비교합니다. 📺 원본 영상을 확인하세요.
DNA를 3D로 모델링하는 작업에서는 두 모델 사이에 성격 차이가 처음으로 드러났다. GPT 5.5의 결과물은 염기 구조 등 분자(Molecular) 표현이 정교하게 구현됐고, 회전 애니메이션도 매끄럽게 작동했다.
04:45 - GPT 5.5 Codex가 만든 3D DNA 모델 — 회전 애니메이션과 분자 구조 표현 비교
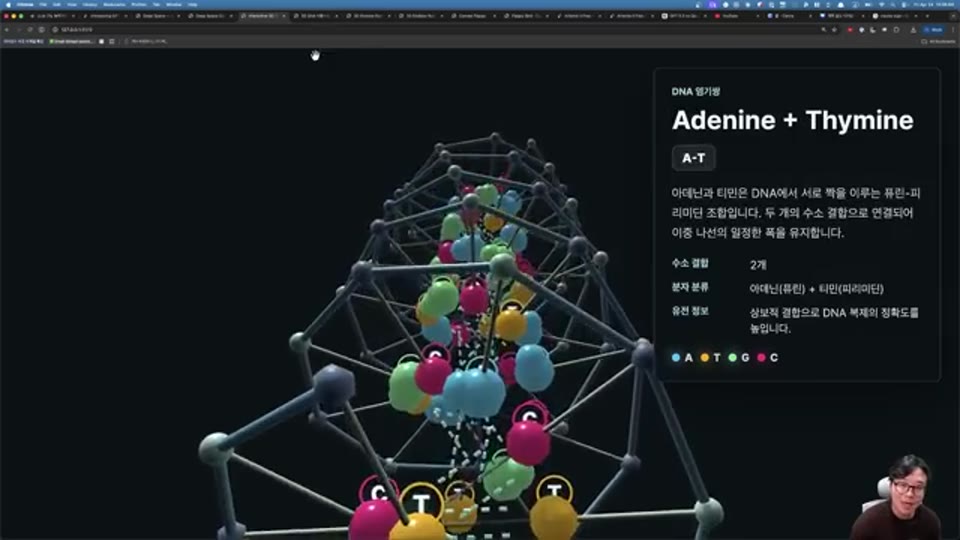
반면 Claude Opus 4.7의 결과물은 강연자 스스로 “약간 대충한 것 같은 느낌”이 든다고 평가했다. 구체적으로는 DNA를 구성하는 네 가지 염기(구아닌·아데닌·시토신·티민) 중 일부만 표현되는 이슈가 있었는데, 강연자는 그 이유를 정확히 기억하지 못한다고 했다(원본 영상 참조). 흥미롭게도 Claude의 애니메이션은 오히려 더 자연스러운 움직임을 보여줬다. 시각적 디테일을 중시하느냐, 움직임의 자연스러움을 중시하느냐에 따라 선호가 갈릴 수 있는 결과였다.
05:05 - Claude Opus 4.7이 만든 3D DNA 모델 — GPT 결과물과 나란히 비교되는 시점
3D 게임: 물리 시뮬레이션의 질감 차이
💡 [영상 참조] 강연자가 GPT와 Claude가 만든 3D 게임을 각각 플레이하며 물리 감각의 차이를 설명합니다. 📺 원본 영상을 확인하세요.
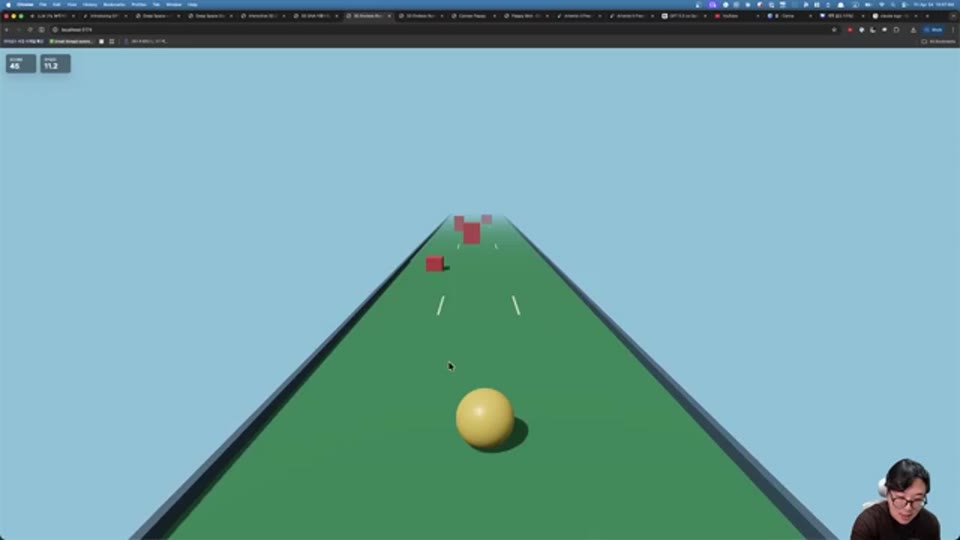
이 테스트의 핵심 평가 기준은 그림자 생성과 물리(Physics) 시뮬레이션의 완성도였다. GPT 5.5의 게임은 오브젝트가 이동할 때 무게감과 가속감이 느껴지는 현실적인 물리 감각이 구현됐다.
05:50 - GPT 5.5 Codex의 3D 게임 물리 시뮬레이션 — 무게감과 가속감 설명 중
반면 Claude Opus 4.7의 결과물은 그림자를 더 넓은 영역까지 표현하는 등 시각적 범위 측면에서 앞섰지만, 물리 시뮬레이션 감각이 부족해 강연자 표현으로 “거의 순간 이동하는 느낌”이 든다는 평가를 받았다. 결국 두 모델이 서로 다른 측면에서 강점을 보인 셈이다. 한편 이 프로젝트에서 실행 시간은 예외적으로 Claude Opus 4.7이 압도적으로 빨랐으며, 이는 이후 비용 분석 섹션에서 더 자세히 다룬다.
2D 게임 (Flappy Bird): 사실상 동등
Flappy Bird 클론 제작에서는 양쪽 모두 스페이스바 입력, 충돌 처리, 게임 오버 처리까지 기본 메커니즘을 무난하게 구현했다. 강연자는 “Flappy Bird는 이미 충분히 학습되어 있어서 다들 잘 된다”고 설명했다. 두 모델을 유의미하게 차별화하기 어려운 테스트였으며, 현세대 LLM의 표준화된 역량을 확인하는 정도의 의미를 가진다.
스페이스 미션 (Artemis Project): 놀랍도록 유사한 결과
💡 [영상 참조] 강연자가 Claude와 GPT의 Artemis Project 결과물을 나란히 화면으로 비교합니다. 📺 원본 영상을 확인하세요.
GPT 5.5 출시 당시 화려하게 소개됐던 스페이스 미션 앱(Artemis Project) 프롬프트를 그대로 양쪽에 입력한 이 테스트는 가장 흥미로운 결과를 낳았다. 강연자는 GPT 프로모션 화면을 스크린샷으로 찍어 해당 프롬프트와 함께 두 모델에 동시에 입력했는데, 결과물이 너무 비슷하게 나와 강연자 스스로도 “잘못 클릭한 게 아닌가” 하고 착각할 정도였다. 강연자는 이에 대해 “LLM들이 이렇게 만들 수 있도록 전반적으로 학습된 뭔가가 있는 것 같다”고 분석했으며, 혹시 이 현상의 이유를 아는 분은 댓글로 알려달라고 요청했다. 이 프로젝트는 두 모델 모두에서 토큰 소모가 가장 많았던 작업이기도 했다.
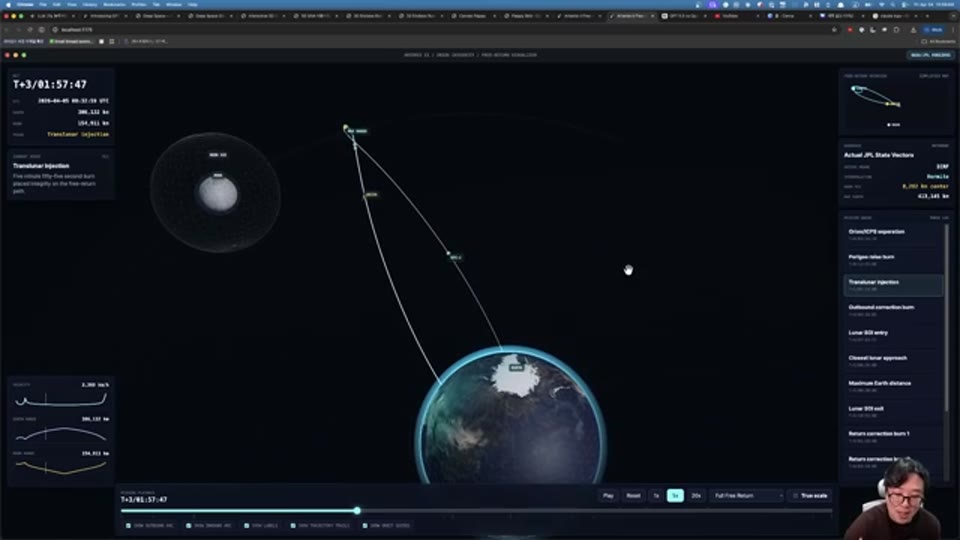
06:54 - GPT 5.5가 만든 Artemis Project 앱 — Claude 결과물과 거의 동일하게 나온 비교 화면
한국어 소설 창작 능력 비교
창작 테스트에서 강연자는 다음과 같은 프롬프트를 설계했다. “너는 한국문학상을 수상한 경력 있는 SF 미스터리 소설가야”라는 역할 부여를 출발점으로, 분량·테마를 지정하고, 배경은 2080년 을지로, 등장인물은 기억 감정사 ‘태경’과 손님 ‘Y’, 그리고 태경이 기계로 Y의 기억을 감정하다 그 기억이 10년 전 자신이 잃어버린 가족의 마지막 순간임을 깨닫게 되는 반전 구조를 필수 요소로 제시했다.
Claude Opus 4.7은 “산성비가 또 내리고 있다 / 을지로 삼가의 낡은 골목 / 네온사인이 비에 번지며 / 웅덩이마다 불꽃 푸른 혀를 남겼다”라는 거칠고 감각적인 첫 문장으로 디스토피아적 분위기를 빠르게 구축했다. 결말은 “카운터 너머 Y가 모자를 벗고 있었다 / 태경보다 스무 살은 더 늙은 얼굴 / 그 주름 사이로 희미한 미소가 번졌다 / 그러나 태경은 그 눈을 알아보았다 / 10년 뒤에 자신의 눈이었다”로 마무리했다.
GPT 5.5(Codex)는 “산성비는 오후 6시마다 을지로의 지붕을 두드렸다 / 2080년 서울의 비는 뭐보다도 정확했고 / 사람보다 오래 남았다”라는 도입부로 시작해, “태경은 그제야 Y의 젖은 후드 아래의 얼굴을 보았다 / 기계가 감정 수치를 띄우기 직전 / 화면 속 아이가 마지막으로 고개를 들었다 / 아이의 입술이 움직였다”라는 결말로 완결했다. 강연자는 두 작품 모두 “굉장히 감성적으로 잘 쓴 것”이라고 평가하면서도, 어느 쪽이 더 낫다는 판단은 극히 주관적인 영역이라며 시청자들의 댓글 의견으로 위임했다.
토큰 비용 & 효율 심층 분석
이 영상에서 가장 주목할 만한 데이터는 결과물 품질이 아니라 비용과 효율 실측값이다.
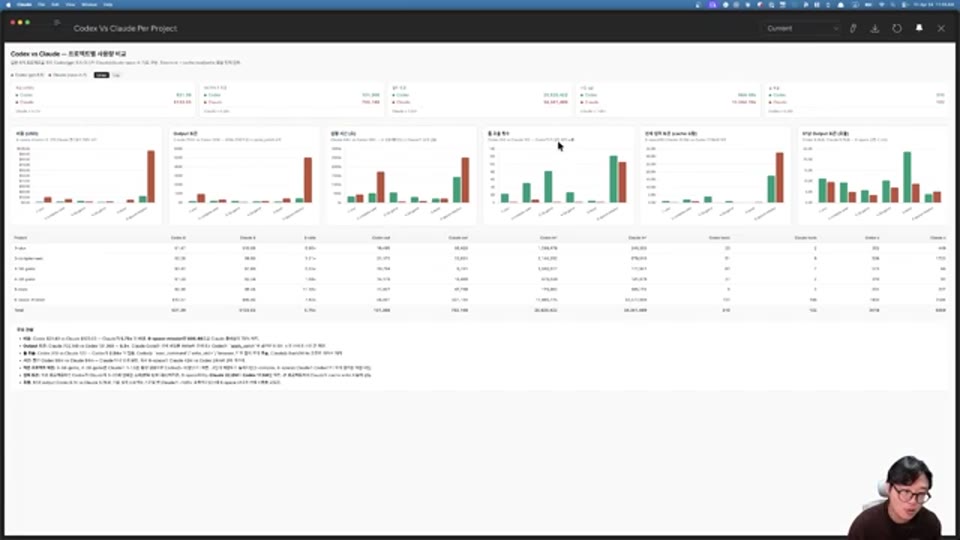
10:05 - 6개 프로젝트 전체 비용·아웃풋 토큰·실행 시간·툴 호출 횟수 비교 차트 (주황=Claude, 초록=GPT)
총 비용: Claude가 약 6배 더 비싸다
6개 프로젝트를 모두 완성하기 위해 GPT 5.5 Codex는 약 123이 소모됐다. 강연자는 “GPT에서 주장하는 것처럼 실제로 오퍼스가 훨씬 더 비싼 게 맞다”고 데이터로 확인했다. 프로젝트별로는 마지막 스페이스 미션 프로젝트가 양쪽 모두에서 가장 많은 비용을 소진했다.
| 항목 | GPT 5.5 Codex | Claude Opus 4.7 |
|---|---|---|
| 6개 프로젝트 총 비용 | ~$21 | ~$123 |
| 단가 — 인풋 (100만 토큰) | $5 | (Opus 4.7 기준 별도) |
| 단가 — 아웃풋 (100만 토큰) | $30 | (Opus 4.7 기준 별도) |
실행 시간: 복잡도가 역전을 만든다
실행 시간은 단순히 “어느 쪽이 빠르다”는 일방적인 결론이 나오지 않았다. 3D 게임과 2D 게임처럼 상대적으로 단순한 작업에서는 Claude Opus 4.7이 압도적으로 빨랐다. 그러나 복잡한 웹 구현(DNA 3D 프로젝트)과 가장 난이도가 높았던 스페이스 미션에서는 반대로 Opus가 압도적으로 느렸다. 강연자는 이를 “복잡한 작업일수록 Opus가 불리한 경향이 있다”고 해석하면서, Opus가 내부적으로 더 많은 추론 처리를 수행하기 때문일 수 있다고 덧붙였다. GPT 5.5는 이제 막 출시된 모델이라 레이턴시(Latency) 측면에서 불리한 조건임에도 빠른 속도를 보였다는 점이 강연자 입장에서는 의외였다고 한다.
툴 호출 횟수: 적게 부르고도 느린 역설
강연자가 “순간 버그인 줄 알았다”고 표현할 만큼 놀라운 결과가 나온 항목이다. GPT 5.5가 Claude Opus 4.7보다 훨씬 많은 툴 호출(Tool Call)을 수행한 것이다. 가장 복잡한 프로젝트인 스페이스 미션에서도 그 차이가 다소 줄었을 뿐, 여전히 Opus의 툴 호출 횟수가 더 적었다. 강연자는 이 현상의 원인을 두 가지로 분석했다. 하나는 Opus가 파일 하나에 더 많은 정보를 한 번에 기록하는 방식을 선호할 가능성, 다른 하나는 자체적으로 더 많은 문제를 내부 추론으로 해결하려는 성향이 강하다는 것이다. 흥미로운 점은, 툴 호출이 더 적음에도 복잡한 작업에서 Opus가 더 느렸다는 사실이다. 이는 Opus가 도구를 덜 쓰는 대신 그만큼 더 깊은 내부 추론을 수행하고 있다는 방증일 수 있다.
입력 토큰과 캐시 히트율: 비용 역설의 열쇠
입력 토큰 소비 패턴에서도 예상 밖의 데이터가 나왔다. 스페이스 미션을 제외한 대부분의 프로젝트에서 GPT 5.5가 Claude Opus 4.7보다 약 10배 이상 많은 입력 토큰을 소모했다. 입력 토큰을 이렇게 많이 쓰면서도 GPT의 총 비용이 훨씬 낮은 이유는 캐시 히트율(Cache Hit Rate) 덕분이다. GPT 5.5의 캐시 히트율은 약 98%에 달하는 것으로 측정됐다. 즉, 아무리 많은 입력 토큰이 청구되더라도 그 대부분이 캐시에서 처리되어 실제 비용이 대폭 절감된다는 구조다. OpenAI가 “토큰 효율이 좋아서 실질 비용이 낮다”고 주장한 근거가 바로 이 캐시 히트율에 있었던 셈이다.
결론 및 사용 가이드
강연자는 두 가지 관점에서 결론을 제시했다.
결과물 품질의 관점에서 보면, 이미 어느 한 쪽 서비스를 구독 중이고 만족하고 있다면 굳이 갈아탈 필요가 없다는 것이다. “이제는 LLM들이 너무 강력해서 솔직히 차이를 잘 모르겠다. 다 잘한다”는 것이 강연자의 솔직한 평가였다. 6개의 다양한 프로젝트를 수행하면서도, 어느 한 모델이 압도적으로 우월한 결과를 낸 경우는 없었다.
API 사용 비용의 관점에서 보면 이야기가 달라진다. Opus급의 지능이 필요한 작업을 API로 처리해야 한다면, 현재로서는 GPT 5.5가 절대적으로 유리하다는 것이 강연자의 분석이다. 다만 단순한 작업에서는 Opus의 속도가 빠르고, 복잡한 작업에서는 GPT 5.5가 빠르다는 경향이 있으므로, 작업의 성격에 따라 두 모델을 균형 있게 혼용하는 전략이 비용과 성능 모두를 잡을 수 있는 방법이라고 제안했다.
마지막으로 강연자가 제시한 변수는 이미지 생성 기능이다. GPT 계열의 특정 기능이 한국어 글쓰기 역량에서 크게 향상됐으며, 텍스트 생성과 이미지 생성이 함께 필요한 워크플로우라면 Claude를 포기하고 GPT 쪽으로 완전히 전환하는 편이 오히려 더 효율적일 수 있다는 조심스러운 제안도 덧붙였다.
💡 [영상 참조] 강연자는 마무리 시점에서 이전 영상(GPT 이미지/한국어 관련 영상)을 링크로 제시합니다. 관련 내용은 원본 영상 영상 설명란을 확인하세요.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | GPT 5.5 vs 클로드 4.7! 같은 프롬프트로 싸움 붙이기! 앙 |
| 채널 | 코드팩토리 |
| 리포트 작성 | 2026-04-24 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.