에이전트에게 컴퓨터를 주어라 — Nico Albanese (Vercel)
📺 원본 영상: Give Your Agent a Computer — Nico Albanese, Vercel 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-13 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 AI Engineer Summit London에서 Vercel의 Nico Albanese가 진행한 라이브 코딩 워크숍이다. 강연자는 AISDK(AI SDK) 6를 사용하여 기본 챗봇에서 출발해 웹 검색 도구를 갖춘 에이전트, 나아가 영구적인 파일 시스템(샌드박스)과 메모리를 보유한 에이전트까지 단계적으로 구축하는 과정을 실시간으로 시연한다. 단순한 API 사용법 소개를 넘어, 2026년 현재 프로덕션 수준의 에이전트를 구축하는 데 필요한 세 가지 핵심 구성요소—에이전트 런타임, 도구, 그리고 컴퓨터(샌드박스)—의 조합이 왜 중요한지를 실제 Vercel 내부 사례를 통해 설득력 있게 설명한다.
AISDK 6의 새로운 패러다임: 왜 지금인가
AISDK가 처음 등장했을 때 핵심 프리미티브(primitive)는 네 가지였다. generateText, streamText, generateObject, streamObject가 그것이다. 이 함수들은 AISDK 6에서도 여전히 존재하며, 이제는 구조화된 출력(structured output)을 generateText와 streamText만으로도 처리할 수 있도록 기능이 통합되었다.
09:47 - AISDK의 핵심 프리미티브(generateText, streamText, generateObject, streamObject) 및 AISDK 6의 객체 지향 에이전트 접근 방식 설명
그러나 Vercel 팀이 내부적으로 에이전트를 직접 운영해보면서 한 가지 심각한 문제를 발견했다. Next.js의 API 라우트 핸들러(app/api/chat/route.ts) 하나에 2,000줄이 넘는 코드가 쌓이기 시작한 것이다. 도구 정의, 시스템 프롬프트, 비즈니스 로직이 모두 한 곳에 인라인으로 작성되면서 코드베이스는 걷잡을 수 없이 비대해졌다. AISDK 6의 객체 지향적(object-oriented) 에이전트 접근 방식은 이 문제에 대한 직접적인 응답이다. 에이전트 정의를 한 곳에 모아두고, 스트리밍 로직이나 라우트 핸들러는 별도로 분리함으로써 관심사(concern)를 명확히 나눌 수 있게 되었다.
또 하나의 중요한 변화는 글로벌 프로바이더(global provider) 개념의 도입이다. 기존에는 OpenAI나 Anthropic 같은 특정 프로바이더를 각 함수 호출마다 명시적으로 주입해야 했다. AISDK 6에서는 글로벌 프로바이더를 한 번 설정하면, 이후 모든 AISDK 함수 호출에서 단순한 문자열로 모델을 지정할 수 있다. 기본값은 Vercel의 AI 게이트웨이이며, 이를 통해 게이트웨이가 지원하는 어떤 모델이든 문자열 ID만으로 접근할 수 있다. 개발자가 원한다면 다른 프로바이더를 글로벌 프로바이더로 교체하는 것도 가능하다.
에이전트 구축의 세 가지 핵심 구성요소
강연자는 2026년 현재 에이전트를 제대로 구축하기 위한 세 가지 핵심 구성요소를 다음과 같이 정의한다.
첫 번째는 **에이전트 런타임(Agent Runtime)**이다. 이는 루프(loop)를 어떻게 관리할 것인지, 루프 사이의 컨텍스트를 어떻게 유지할 것인지를 결정하는 하네스(harness)다. 단순히 LLM을 한 번 호출하는 것이 아니라, 에이전트가 목표를 달성할 때까지 반복적으로 생각하고 도구를 사용하는 전체 실행 흐름을 담당한다.
두 번째는 **도구(Tools)**다. 에이전트가 런타임 안에서 실행할 수 있는 능력의 집합이다. 어떤 도구를 제공하느냐에 따라 에이전트가 할 수 있는 일의 범위가 결정된다.
세 번째이자 강연자가 가장 중요하게 강조하는 구성요소는 컴퓨터(Computer), 즉 샌드박스 파일 시스템이다. 에이전트가 작업 세션(run) 동안 상태(state)를 영속(persist)하거나 코드를 실행할 수 있는 환경이 주어질 때, 에이전트의 행동 방식이 근본적으로 달라진다. 강연의 대부분은 이 세 번째 구성요소의 구현과 그 효과를 탐구하는 데 할애된다.
Tool Loop Agent — 에이전트 런타임 구현
AISDK 6에서 제공하는 toolLoopAgent(Tool Loop Agent)는 그 이름 그대로다. 도구 호출 루프를 실행하는 에이전트다. 강연자는 이 이름이 “단순 명료하다”고 표현하며, AISDK의 네이밍 철학을 강조한다. toolLoopAgent를 임포트하고 모델을 지정하는 것만으로 재사용 가능한 에이전트 인스턴스가 만들어진다.
에이전트를 실제로 호출하는 방법은 Next.js 라우트 핸들러에서 POST 요청을 처리하는 것이다. 여기서 createAgentUIStreamResponse라는 함수가 핵심 역할을 한다. 이 함수는 내부적으로 streamText를 호출하고 result.toUIMessageStreamResponse()를 반환하는 것과 동일한 동작을 하지만, 에이전트의 스트리밍 복잡성을 단 한 줄의 코드로 추상화한다. 에이전트 인스턴스는 자체적으로 .stream() 메서드를 가지며, 이것이 라우트 핸들러에서 실제 스트리밍을 수행하는 진입점이 된다.
클라이언트 측에서는 AISDK가 처음 출시된 이래 꾸준히 제공해온 useChat 훅을 그대로 사용한다. useChat은 메시지 상태를 관리하고 라우트 핸들러로 메시지를 전송하는 역할을 담당하며, 각 메시지는 role(사용자 혹은 어시스턴트)과 parts(텍스트, 도구 호출 결과 등 복수의 파트로 구성)로 이루어진 구조를 가진다.
에이전트의 기본 동작을 바꾸는 가장 직접적인 방법은 instructions 파라미터를 통해 시스템 프롬프트를 설정하는 것이다. 강연자는 “카우보이처럼 대답하라”는 지시를 예시로 보여주며, 이후 더 복잡한 지시어가 에이전트 행동에 얼마나 큰 영향을 미치는지를 단계적으로 시연한다.
도구의 세 가지 유형 — 어디까지 직접 구현할 것인가
강연자는 AISDK에서 지원하는 도구를 세 가지 유형으로 분류한다. 이 분류는 에이전트 설계 시 어떤 도구를 선택할지 결정하는 데 중요한 기준이 된다.
**첫 번째는 커스텀 도구(Custom Tools)**다. 개발자가 직접 설명(description), 입력 스키마(input schema), 실행 함수(execute function)를 정의하는 방식이다. 에이전트가 대화 문맥에 따라 임의의 함수를 실행할 수 있도록 만든다. 가장 유연하지만 구현 책임이 개발자에게 있다.
**두 번째는 프로바이더 정의 도구(Provider-Defined Tools)**다. LLM 프로바이더가 자신들의 모델이 특정 도구를 효과적으로 사용하도록 사후 훈련(post-training)을 거친 도구들이다. Anthropic의 bash 도구나 컴퓨터 사용(computer use) 도구가 대표적인 예다. 도구가 실제로 호출되었을 때 무슨 일이 일어날지는 개발자가 정의하지만, 도구의 설명과 입력 스키마는 프로바이더가 모델이 잘 사용하도록 최적화해놓은 상태다.
**세 번째는 프로바이더 실행 도구(Provider-Executed Tools)**다. 이 도구들은 LLM 프로바이더의 인프라 안에서 실행된다. 웹 검색 도구가 가장 대표적인 예다. 개발자는 도구가 호출됐을 때 어떤 일이 일어날지 전혀 정의하지 않아도 된다. 에이전트가 이 도구를 사용하기로 결정하면, 프로바이더의 서버에서 실행이 이루어지고 그 결과가 메시지 상태에 추가되어 다시 반환된다. 추가 코드가 필요 없다는 장점이 있지만, 단일 프로바이더에 종속된다는 트레이드오프가 있다.
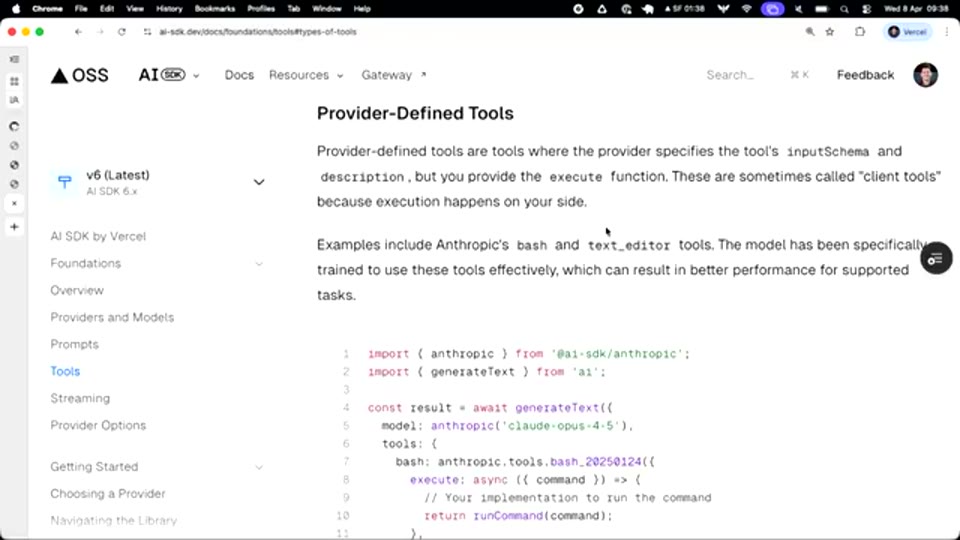
19:52 - 세 가지 도구 유형(커스텀 도구, 프로바이더 정의 도구, 프로바이더 실행 도구) 비교 설명 슬라이드
웹 검색 도구를 예로 들면, OpenAI 프로바이더를 임포트하여 에이전트 정의에 추가하는 것만으로 에이전트는 실시간 웹 검색 능력을 갖추게 된다. 이 도구는 userLocation 같은 추가 파라미터를 통해 지역화된 검색 결과를 반환하도록 세밀하게 조정할 수도 있다.
엔드투엔드 타입 시스템 — 에이전트 정의가 진실의 원천
웹 검색 도구를 추가하고 나면 곧바로 문제가 드러난다. 에이전트가 도구를 사용하는 동안 사용자 UI에는 아무것도 표시되지 않는다. 도구가 호출되고 있다는 사실을 사용자는 알 수 없다. 이 문제를 해결하려면 특정 도구가 사용될 때 UI에 무엇을 렌더링할지 정의해야 하는데, 이때 도구 호출의 input과 output이 unknown 타입으로 처리된다면 올바른 컴포넌트를 구성하기 매우 어려워진다.
AISDK의 설계 철학 중 핵심은 에이전트 정의가 모든 것의 진실의 원천(source of truth)이 된다는 것이다. 이 원칙을 구현하는 것이 InferAgentUIMessage라는 타입 헬퍼다. 에이전트 인스턴스의 타입을 이 헬퍼에 전달하면, 에이전트가 보유한 모든 도구의 input과 output 타입이 완전히 추론된 메시지 타입이 생성된다. 이 타입은 라우트 핸들러와 클라이언트의 useChat 훅 모두에 적용되어, UI 렌더링 로직에서 각 도구의 입출력 타입을 안전하게 다룰 수 있게 한다.
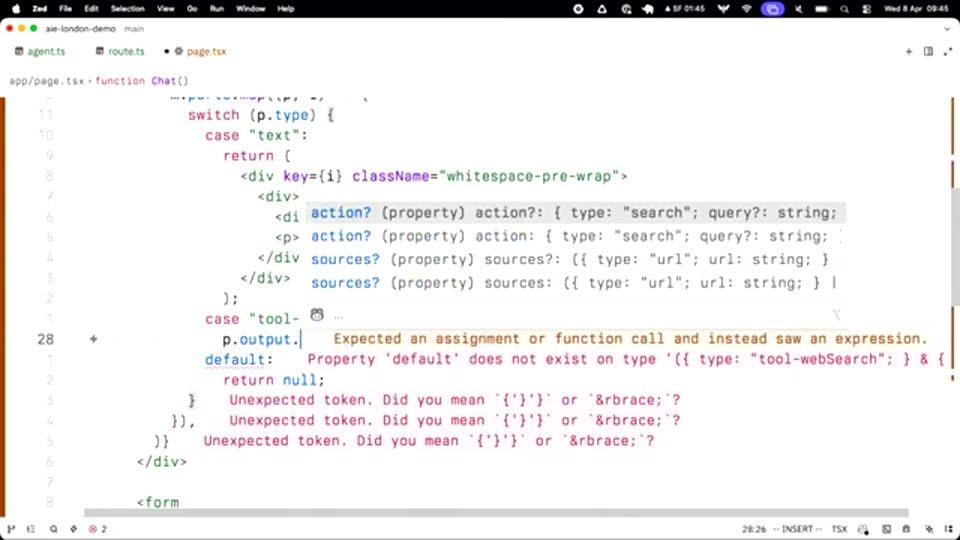
27:01 - InferAgentUIMessage 타입 헬퍼를 통한 엔드투엔드 타입 안전성 시연 - 에디터에서 도구 입출력 타입 추론 확인
이 엔드투엔드 타입 안전성 덕분에, UI의 switch 문에서 각 도구 파트(tool-webSearch, tool-bash 등)를 처리할 때 입력값과 출력값이 완전히 타입 추론된 상태로 사용할 수 있다.
에이전트에게 컴퓨터를 주어라 — Vercel Sandbox와 Named Persistent Sandboxes
강연의 핵심부인 샌드박스 통합은 Vercel 내부의 실제 경험에서 출발한다. Vercel은 자사 내부에서 “D0”라는 에이전트를 운영하고 있다. 이 에이전트는 Vercel의 전체 백엔드, 관리자 패널, Salesforce 등 수많은 데이터 소스에 접근 권한을 가지고 있었다. 처음에는 다섯 개에서 열 개 정도의 도구를 조합해 질문에 답했는데, 답변의 품질이 불안정했다. 환각(hallucination) 비율도 높았다.
그런데 이 에이전트에 파일 시스템을 추가하는 순간 상황이 극적으로 바뀌었다. 에이전트가 매 작업 세션의 시작에서 작업 계획(plan)을 파일로 저장하고, 각 단계마다 그 파일을 읽어 스스로에게 목표를 상기시키도록 지시했다. 이전까지는 처음에 주어진 지시사항이 점점 길어지는 컨텍스트 창 속에 묻혀버리는 문제가 있었다. 파일 시스템에 계획을 저장하는 방식은 에이전트가 긴 작업을 수행하는 동안 처음의 목표를 잃지 않도록 하는 효과적인 앵커(anchor)가 되었다. 작업이 끝나면 에이전트가 무엇을 했고 어떤 경로로 결론에 도달했는지를 보여주는 상세한 아티팩트가 자동으로 남는 부가 효과도 있었다.
강연자에 따르면 이 패턴은 현재 Vercel이 내부적으로 구축한 거의 모든 에이전트에 적용되어 있다. 고객 지원 에이전트의 경우 티켓 수를 약 90% 줄였고, 해결률은 약 95%에 달했다. 실제 사용자들로부터 “감사합니다”라는 피드백까지 받을 수 있었다고 강연자는 소개한다.
Vercel Sandbox의 Named Persistent Sandboxes (Beta)
샌드박스의 근본적인 한계는 **일시성(ephemeral)**이다. 프로바이더가 30일이든 5시간이든 일정 시간이 지나면 샌드박스는 사라진다. Vercel은 이 문제를 해결하기 위해 **Named Persistent Sandboxes(명명된 영구 샌드박스)**를 베타로 공개했다.
이 개념의 핵심은 단순하다. 모든 샌드박스는 고유한 이름을 가지며, 그 이름을 기준으로 세션(instance)이 관리된다. 개발자가 코드에서 특정 이름의 샌드박스를 요청하면, Vercel은 해당 이름에 연결된 활성 인스턴스가 있으면 그쪽으로 라우팅하고, 없으면 새 인스턴스를 즉시 생성한다. 비활성 상태에서는 샌드박스가 자동으로 종료되지만, 파일 시스템의 스냅샷은 유지된다. 이후에 요청이 다시 들어오면 그 스냅샷을 기반으로 새 인스턴스가 생성되므로, 외부에서 보기에는 동일한 머신이 계속 실행되고 있는 것처럼 느껴진다.
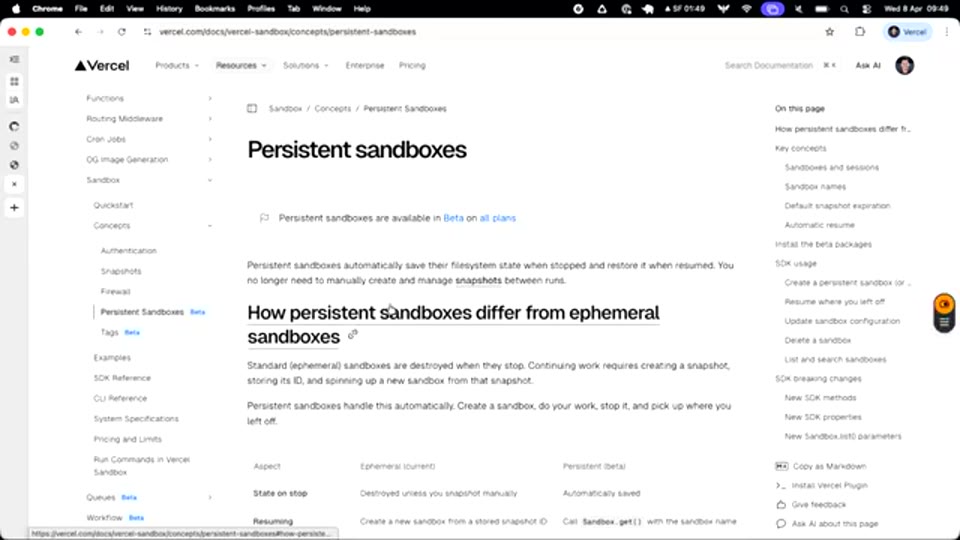
31:01 - Named Persistent Sandboxes 개념 설명 - 이름 기반 샌드박스 생명주기 관리 다이어그램
강연자는 이전에 매 요청마다 전체 파일 시스템을 tar로 압축하고, Blob 스토리지에 저장하고, 다음 요청 때 새 샌드박스를 스핀업해서 복원하는 수동 생명주기 관리 시스템을 직접 구축했다고 밝혔다. Named Persistent Sandboxes는 이 모든 복잡성을 자동으로 처리해준다.
컨텍스트 관리 — 긴 에이전트 실행을 위한 설계
강연 중 청중의 질문을 통해 열린 컨텍스트 관리 논의는 이 강연에서 가장 밀도 높은 부분 중 하나다.
기본적으로 useChat의 sendMessage는 전체 메시지 히스토리를 매 요청마다 서버로 전송한다. 그러나 실제 프로덕션 환경에서는 가장 최근 메시지만 전송하고, 서버 측에서 전체 히스토리를 데이터베이스에서 불러와 조합하는 패턴이 일반적이다.
컨텍스트의 크기를 제어하는 방법으로 강연자는 prepareStep 콜백을 소개한다. 이 함수는 에이전트 런타임의 매 스텝(step) 직전에 실행되며, 해당 스텝에 전달되는 파라미터(메시지, 모델, 컨텍스트 등)를 동적으로 수정할 수 있다. 예를 들어, 스텝 번호가 20 이상이 되면 messages.slice를 사용해 가장 최근 다섯 개 메시지만 슬라이딩 방식으로 컨텍스트에 포함시키는 필터를 구현할 수 있다. 강연자는 이 API가 함수형으로 설계된 것이 의도적이라고 설명한다. 매 스텝 시작 시 빈 상태에서 출발하므로 추론하기 쉽고, 에이전트 실행이 끝난 시점에는 전체 메시지 히스토리가 온전히 보존된다.
컨텍스트 압축(Compaction)에 대한 강연자의 견해
강연자는 자신이 개발한 코딩 에이전트를 예로 들며 컨텍스트 압축에 대한 솔직한 시각을 공유한다. 이 에이전트는 단 하나의 턴에서 104분간 실행되었고, 316번의 도구 호출, 29개의 파일 변경을 수행했다. 그럼에도 사용된 컨텍스트 창은 전체의 **32%**에 불과했으며, 압축(compaction)은 전혀 사용하지 않았다.
39:44 - 강연자의 개인 코딩 에이전트 실적 화면 - 104분 실행, 316 도구 호출, 29개 파일 변경, 32% 컨텍스트 창 사용
이전에 강연자는 메시지 히스토리가 컨텍스트 창의 40~60%를 넘을 때 초기 도구 호출 결과들을 제거하는 슬라이딩 방식의 압축을 직접 구현했다. 그런데 이 방식의 결정적인 문제점이 있었다. 메시지 히스토리를 수정할 때마다 입력 캐시(input cache)가 무효화된다는 것이다. 캐시 히트율이 곧 속도와 비용으로 직결되는 만큼, 이는 심각한 트레이드오프다.
강연자는 현재 백만 토큰 이상의 컨텍스트 창이 보편화된 시점에서, LLM 요약 기반의 손실적(lossy) 압축보다 서브에이전트(sub-agent) 분리 방식을 선호한다. 독립적으로 처리할 수 있는 작업 단위를 별도의 서브에이전트에게 위임하고, 서브에이전트는 수만 토큰을 소비한 작업의 결과를 약 1,000 토큰 분량의 요약으로 메인 스레드에 반환한다. 이렇게 하면 메인 컨텍스트 스레드는 수천 토큰 수준에서 유지된다.
강연자는 LLM이 오래된 지시사항을 잃어버리는 문제가 얼마나 위험한지를 구체적인 사례로 경고하기도 했다. 한 AI 연구자가 에이전트에게 “어제 이메일을 정리해달라”고 요청했는데, 에이전트는 대량의 이메일을 처리하는 과정에서 자동 컨텍스트 압축이 트리거되었고, 압축 과정에서 “이메일을 보관(archive)하라”는 초기 지시가 “이메일을 삭제하라”로 잘못 해석되어 전체 받은편지함이 삭제되는 사고가 발생했다. 이 사례는 비손실(lossless) 컨텍스트 관리의 중요성을 극명하게 보여준다.
에이전트 도구로서의 Bash — 단 하나의 도구로 모든 것을
강연자는 에이전트에게 제공할 도구로 bash를 선택한 이유를 명확히 설명한다. 현재의 LLM은 bash 명령어를 생성하는 데 매우 뛰어나며, ls, find, grep, glob 같은 유닉스 도구들의 조합만으로도 에이전트가 할 수 있는 일의 범위는 매우 넓다. 복수의 특화된 도구를 설계하는 것보다, 범용적인 bash 도구 하나로 시작하는 것이 실용적이다.
bash 도구의 execute 함수가 흥미로운 것은 두 번째 인수로 **에이전트 컨텍스트(agent context)**를 받는다는 점이다. 이 컨텍스트는 React의 Context API와 개념적으로 동일하다. 에이전트 런타임의 최상위에서 주입된 임의의 값(변수, 함수, 객체 등)에 런타임 내의 모든 도구가 접근할 수 있는 메커니즘이다. 강연의 경우, 샌드박스 인스턴스를 이 컨텍스트를 통해 공유함으로써 bash 도구가 실제 Vercel 샌드박스 위에서 명령을 실행할 수 있게 된다.
51:14 - bash 도구 execute 함수에서 에이전트 컨텍스트를 통해 샌드박스에 접근하는 코드 구조
Call Options Schema — 에이전트를 유연하게 만드는 구조화된 입력
에이전트를 다양한 상황에서 재사용하려면, 메시지 컨텍스트 외에 구조화된 런타임 입력이 필요한 경우가 많다. 예를 들어 항공사의 고객 지원 에이전트라면, 고객 ID와 회원 등급에 따라 사용할 모델을 달리하고 싶을 수 있다. 일반 회원에게는 경제적인 모델을, 프리미엄 회원에게는 고성능 모델을 할당하는 식이다.
이를 위해 AISDK 6는 Call Options Schema를 제공한다. Zod 스키마로 에이전트가 매 호출 시 받아야 하는 구조화된 입력을 정의하면, 라우트 핸들러의 createAgentUIStreamResponse 함수에서 options 키를 통해 타입 안전한 방식으로 해당 값을 주입할 수 있다. 샌드박스 인스턴스를 매 요청마다 안전하게 전달하는 메커니즘이 바로 이 Call Options Schema다.
prepareCall 함수는 에이전트가 실행되는 전체 런 동안 단 한 번, 처음 호출될 때 실행된다. 여기서 Call Options로 전달된 샌드박스 인스턴스를 에이전트 컨텍스트에 주입함으로써, 이후 모든 스텝의 모든 도구가 동일한 샌드박스에 접근할 수 있게 된다.
💡 [영상 참조] 강연자는 이 시점에서
agent.ts의 전체 코드를 화면에 보여주며 Call Options Schema와 prepareCall의 연결 구조를 설명합니다. 상세 내용은 원본 영상을 확인하세요.
강연자는 AISDK 7에서 컨텍스트에 대한 타입 지원이 추가될 예정이라고 언급했다. 특정 컨텍스트를 기대하는 도구를 에이전트에 등록할 때, 에이전트 정의 수준에서 해당 컨텍스트를 제공하지 않으면 컴파일 타임 오류가 발생하게 된다. 이는 강연자가 이 패턴을 집중적으로 사용하면서 AISDK 개발팀에 직접 요청한 기능이라고 밝혔다.
파일 시스템 기반의 메모리 시스템
에이전트가 파일 시스템에 접근할 수 있게 된 이상, 메모리는 자연스럽게 구현 가능한 다음 단계가 된다. 강연자의 관점은 명쾌하다. 메모리는 파일이다. 별도의 벡터 데이터베이스나 외부 메모리 시스템이 필요하지 않다. 샌드박스의 파일 시스템이 곧 에이전트의 기억 저장소가 된다.
구체적인 구현 방식은 다음과 같다. memories.md라는 파일을 에이전트의 핵심 메모리 저장소로 지정한다. prepareCall 함수에서 에이전트가 실행되기 전에 이 파일의 내용을 읽어 시스템 프롬프트(instructions)에 동적으로 주입한다. 에이전트는 대화 중 사용자가 공유하는 중요한 정보를 이 파일에 기록하도록 지시받는다. 이렇게 하면 에이전트는 이전 대화 세션에서 학습한 내용을 새 세션에서도 활용할 수 있다.
여기서 시스템 프롬프트의 품질이 얼마나 중요한지가 드러난다. 강연자는 라이브 시연 중 “어떤 정보든 기억하라”는 지나치게 광범위한 지시로 인해 인사말이나 사소한 상호작용까지 메모리에 기록되는 문제를 경험했다. “중요한 사실만 기록하라”는 지시를 추가했지만 이번엔 에이전트가 이전 지시와 충돌을 일으켰다. 결국 “일상적인 대화, 인사말, 코드베이스에서 유추할 수 있는 정보는 저장하지 마라”는 식의 부정적 예시(negative example)를 포함한 정밀한 프롬프트가 필요했다. 이 과정은 프롬프트 엔지니어링이 여전히 에이전트 개발의 핵심 역량임을 실감하게 한다.
파일 시스템 기반 메모리의 또 다른 강점은 에이전트가 반복적인 작업을 스크립트로 자동화하고 이를 메모리에 등록할 수 있다는 점이다. 예를 들어, 날씨 정보를 요청하면 에이전트는 Python으로 날씨 조회 스크립트를 작성하고, 이를 파일 시스템에 저장한 뒤, 이 스크립트의 존재를 memories.md에 기록한다. 이후 동일한 요청이 들어오면 에이전트는 새로 코드를 작성하는 대신 저장된 스크립트를 재사용한다. 이것이 강연자가 말하는 **스스로 확장하는 에이전트(self-extending agent)**의 초기 형태다.
실전 사례 — 강연자의 개인 코딩 에이전트
강연자는 이 강연에서 설명한 패턴들을 동일하게 적용하여 개인 코딩 에이전트를 구축했고, 이를 하루 14시간씩 4개월간 사용해왔다. 이 에이전트의 성능 지표는 인상적이다.
| 항목 | 수치 |
|---|---|
| 단일 턴 최대 실행 시간 | 104분 |
| 해당 턴의 도구 호출 횟수 | 316회 |
| 해당 턴에서 변경된 파일 수 | 29개 |
| 컨텍스트 창 사용률 | 32% |
| 압축(compaction) 적용 여부 | 미적용 |
| 캐시 토큰 히트율 | 91~95% |
이 에이전트는 AISDK, Vercel AI 게이트웨이, 그리고 Vercel 워크플로우(Workflow)를 기반으로 구축되었다. 워크플로우 통합을 통해 에이전트가 무한히 실행될 수 있으며, 각 LLM 스텝이 내구성 있는(durable) 워크플로우 스텝에 매핑되어 특정 스텝이 실패하면 성공할 때까지 자동으로 재시도된다.
서브에이전트 패턴도 핵심적인 역할을 한다. 독립적으로 처리 가능한 작업(예: 코드베이스 탐색)을 서브에이전트에 위임하면, 서브에이전트는 수만 토큰을 소비하더라도 메인 스레드에는 약 500~1,000 토큰의 요약만 반환한다. 이로 인해 메인 에이전트 스레드는 약 7,000 토큰 수준에서 유지된다. 23명의 Vercel 직원이 이 에이전트를 사용하고 있으며, 1~2개월 사이에 약 38억(3.8 billion) 토큰을 처리했고, 약 350개의 PR 생성에 기여했다.
마무리 — 에이전트 개발의 세 가지 축
이 강연의 핵심 메시지는 2026년 현재 에이전트를 제대로 만들기 위해서는 세 가지 구성요소가 반드시 함께 작동해야 한다는 것이다. 에이전트 런타임은 루프와 컨텍스트 흐름을 관리하고, 도구는 에이전트의 능력을 확장하며, 샌드박스와 파일 시스템은 에이전트에게 상태를 유지하고 코드를 실행할 수 있는 물리적 공간을 제공한다.
시스템 프롬프트는 2023년의 유물이 아니다. 컴퓨터와 도구를 갖춘 에이전트일수록 지시어가 행동에 미치는 영향은 더 크고 직접적이다. 메모리는 별도의 데이터베이스가 아니라 파일 시스템 위에서 구현할 수 있으며, 이 단순한 접근 방식이 오히려 에이전트의 자율성과 학습 능력을 높이는 출발점이 된다. 코드를 실행하고 결과를 평가하고 반복하는 피드백 루프야말로 에이전트가 복잡한 장기 작업을 완수할 수 있게 하는 핵심 메커니즘이며, 이것이 2026년에 코딩 에이전트가 가장 빠르게 발전하고 있는 이유다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Give Your Agent a Computer — Nico Albanese, Vercel |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-05-13 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.