Guide, Verify, Solve — Anirban Chatterjee, Sonar
📺 원본 영상: Guide, Verify, Solve — Anirban Chatterjee, Sonar
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-08-10
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
Anirban Chatterjee는 이 강연에서 AI 코딩 도구의 생산성 약속이 실제 엔지니어링 조직 안에서 어떤 병목과 리스크를 만들어내는지 설명한다. 핵심 메시지는 단순하다. AI가 코드를 더 많이, 더 빠르게 쓰게 만들수록 소프트웨어 조직은 코드 작성 능력보다 검증 능력에서 먼저 한계에 부딪힌다는 것이다.
강연의 중심 개념은 Sonar가 제안하는 Agent Centric Development Cycle, 즉 AC/DC이다. 이 프레임워크는 AI 에이전트에게 먼저 맥락과 제약을 제공하고, 생성된 코드를 독립적으로 검증하며, 발견된 문제를 다시 에이전트가 해결하게 하는 반복 루프를 뜻한다. 강연자는 이를 Guide, Verify, Solve라는 세 단계로 정리하면서, AI 시대의 소프트웨어 품질 관리는 인간 리뷰만으로는 충분하지 않으며 자동화된 다층 검증 체계가 필수라고 주장한다.
실험에서 엔지니어링으로 넘어가는 전환점
강연자는 현재 AI 개발 생태계가 “실험에서 엔지니어링으로” 넘어가는 전환점에 있다고 진단한다. 초기의 AI 코딩 도구는 개인 개발자나 소규모 팀이 빠르게 프로토타입을 만들고 가능성을 탐색하는 데 매우 강력했다. 이 단계에서는 코드 품질에 약간의 편차가 있더라도 사용자가 적고 수명이 짧은 프로젝트가 많기 때문에, AI가 만든 코드와 실제 필요한 품질 사이의 격차가 상대적으로 작다.
문제는 이 도구들이 더 큰 코드베이스, 더 많은 사용자, 더 높은 보안 요구, 더 복잡한 운영 환경으로 들어갈 때 발생한다. 엔터프라이즈 소프트웨어는 단순히 “작동하는 코드”만으로 충분하지 않다. 유지보수 가능성, 보안성, 신뢰성, 규정 준수, 운영 관측성, 조직 내 코딩 표준까지 모두 함께 충족해야 한다. 강연자는 이 지점에서 AI 코딩 도구가 만들어내는 속도와 실제 프로덕션 품질 사이에 검증 부채가 생긴다고 설명한다.
그가 인용한 Carnegie Mellon 연구는 이 문제를 정량적으로 보여준다. GitHub 프로젝트 메타데이터를 분석한 결과, AI 도구를 활용한 프로젝트에서는 일시적인 생산성 상승이 있었지만 약 3개월 뒤에는 그 효과가 사라졌고, 동시에 정적 분석 경고와 코드 복잡도는 지속적으로 증가했다. 강연자는 이 결과를 근거로, AI 코딩이 단기적으로는 개발 속도를 높일 수 있지만 품질 관리 체계가 없다면 장기적으로는 개발자를 더 느리게 만들 수 있다고 해석한다.
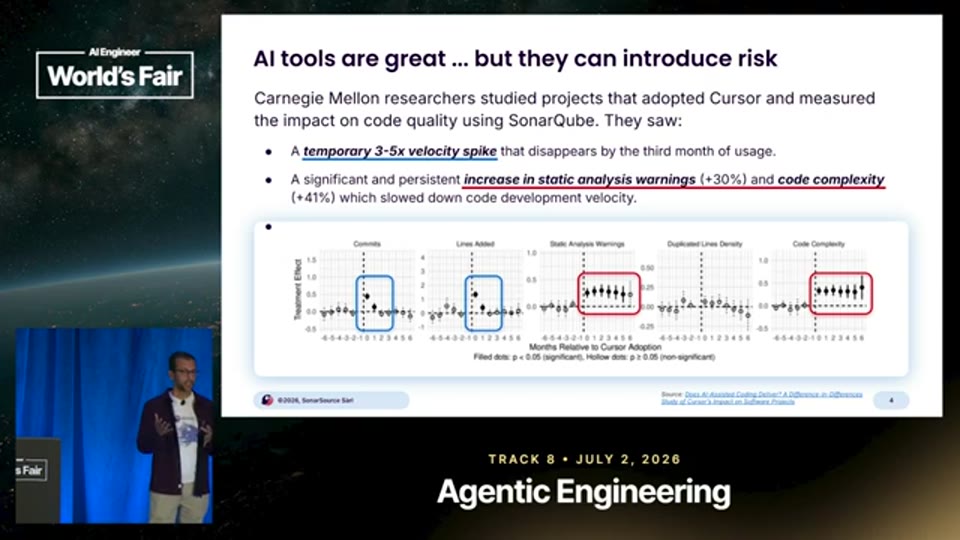
02:23 - Carnegie Mellon 연구와 SonarQube 분석을 바탕으로 AI 도구 사용 후 생산성 변화와 정적 분석 경고 증가를 설명하는 구간
AI 모델은 뛰어나지만 완전하지 않다
강연자는 최신 모델들이 매우 뛰어나다는 점을 인정하면서도, 그 구조적 한계를 분명히 짚는다. Large Language Model(대규모 언어 모델)은 계속 개선되고 있지만 여전히 오류를 만들 수 있으며, 그 오류가 프로덕션 코드에 들어가면 조직에 심각한 영향을 줄 수 있다. 이는 모델의 성능 부족만의 문제가 아니라, 모델이 작동하는 방식 자체에서 비롯되는 한계다.
가장 큰 문제 중 하나는 맥락 부족이다. AI 모델은 사용자가 제공한 정보 안에서만 추론할 수 있으며, 조직의 과거 의사결정, 회의에서 합의된 제품 방향, 레거시 코드의 암묵적 제약, 특정 팀의 운영 관행까지 자동으로 알지는 못한다. 개발자는 이런 배경을 몸으로 알고 있지만, 에이전트는 별도로 주입받지 못하면 모른다. 따라서 AI가 생성한 코드는 문법적으로 맞고 테스트 일부를 통과하더라도, 실제 조직이 원하는 코드와 어긋날 수 있다.
또 하나의 문제는 모델마다 강점과 약점이 다르다는 점이다. 강연자는 Sonar의 LLM Leaderboard를 언급하며, 여러 모델을 약 4,000개의 코딩 태스크로 평가하고 정답률, 이슈 밀도, 복잡도, 유지보수성, 신뢰성, 보안성 같은 축에서 비교한다고 설명한다. 예를 들어 Claude Sonnet과 Claude Opus 계열 모델을 비교할 때, 어떤 모델은 정답률이나 신뢰성에서 유리할 수 있지만, 더 낮은 복잡도나 더 높은 보안성이 필요한 작업에서는 다른 모델이 더 적합할 수 있다. 이 설명의 핵심은 “좋은 모델 하나”를 고르는 문제가 아니라, 모델의 특성을 이해하고 검증을 전제로 활용해야 한다는 데 있다.
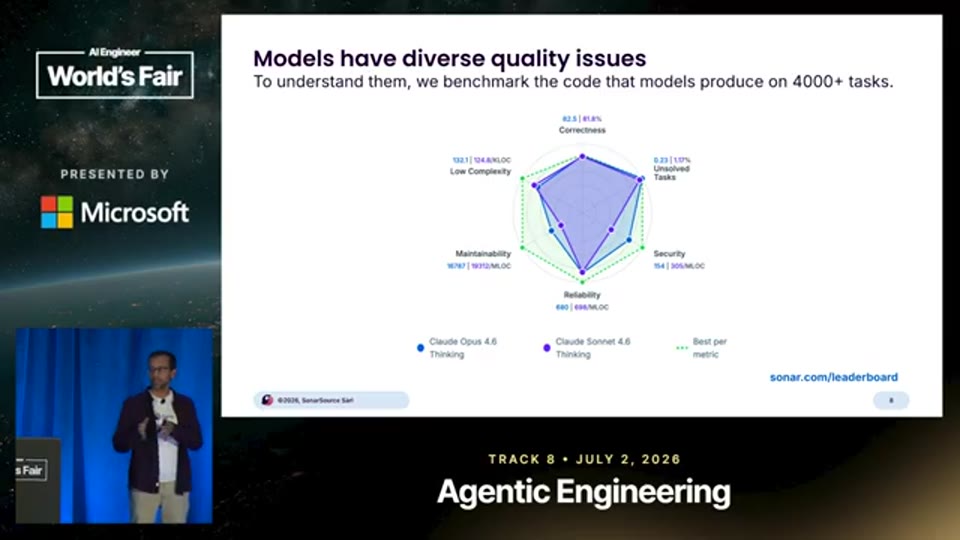
05:30 - Sonar LLM Leaderboard에서 Claude Opus와 Claude Sonnet 계열 모델의 품질 지표를 비교하는 구간
인간 리뷰도 병목이자 리스크가 된다
AI 코드의 품질 문제를 해결하는 전통적 방법은 인간 리뷰다. 개발자가 직접 코드를 읽고, 설계를 확인하고, 위험한 부분을 지적하는 방식은 여전히 중요하다. 그러나 강연자는 AI가 생성하는 코드의 양이 늘어날수록 인간 리뷰만으로는 충분하지 않다고 말한다.
그가 인용한 Wharton 연구는 인간이 AI 조언을 얼마나 쉽게 신뢰하는지를 보여준다. 참가자들은 AI가 맞는 조언을 했을 때 92.7%의 비율로 따랐지만, AI가 틀린 조언을 했을 때도 거의 80%에 가까운 비율로 그 조언을 따랐다. 강연자는 이 현상이 코드 리뷰에서도 거의 확실히 일어나고 있다고 본다. 여러 에이전트가 동시에 많은 코드를 생성하고, 인간 리뷰어가 제한된 시간 안에 이를 모두 검토해야 한다면, 리뷰는 실질적 검증보다 승인 절차에 가까워질 위험이 있다.
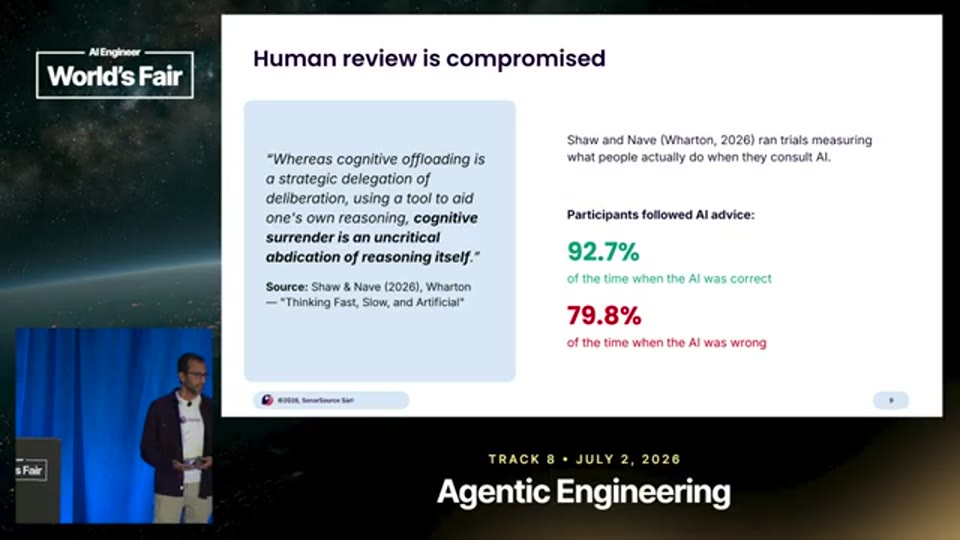
07:05 - Wharton 연구 결과를 통해 인간이 AI의 잘못된 조언도 높은 비율로 따르는 문제를 설명하는 구간
이 지점에서 자동 검증은 인간을 대체하는 장치라기보다 인간 리뷰를 보완하는 안전장치가 된다. 사람이 모든 줄을 깊이 읽을 수 없는 상황이라면, 반복 가능하고 설명 가능하며 일관된 검증 시스템이 먼저 문제를 걸러내야 한다. 그래야 인간은 단순한 문법 오류나 반복적인 품질 문제보다, 설계 판단과 제품 맥락처럼 인간이 더 잘 다룰 수 있는 문제에 집중할 수 있다.
코드와 소프트웨어는 다르다
강연에서 흥미로운 구분은 코드와 소프트웨어의 차이다. 코드는 올바르게 작성되면 같은 입력에 대해 같은 방식으로 실행되는 결정적 산물에 가깝다. 개발자는 이 예측 가능성에서 안정감을 얻는다. 특정 함수가 올바르게 작성되어 있다면, 그 함수는 반복 실행되어도 같은 방식으로 동작한다.
그러나 소프트웨어는 코드보다 훨씬 복잡하다. 소프트웨어는 요구사항, 사용자 행동, 외부 시스템, 보안 위협, 운영 환경, 조직의 정책까지 모두 얽힌 결과물이다. 코드 조각은 증명 가능해 보일 수 있지만, 전체 소프트웨어는 예상하지 못한 방식으로 실패할 수 있다. 특히 사용자가 많아지고, 일부 사용자가 악의적으로 시스템을 공격하려 하며, 코드베이스가 커지고 변경 빈도가 높아질수록 단순한 코드 정확성만으로는 충분하지 않다.
AI가 더 큰 문제를 해결하기 위해 더 많은 소프트웨어를 작성하게 될수록 이 차이는 더 중요해진다. 강연자는 바로 이 때문에 자동 검증이 AI 기반 개발의 핵심 인에이블러가 된다고 말한다. AI가 코드 작성의 통제 일부를 가져가는 만큼, 조직은 검증과 거버넌스를 통해 품질에 대한 통제력을 회복해야 한다.
Zero Trust와 Multi-layered Verification
강연자가 말하는 검증의 첫 번째 원칙은 Zero Trust(제로 트러스트)다. 여기서 제로 트러스트는 코드 작성자를 신뢰하지 않는다는 의미가 아니라, 코드가 인간에게서 왔든 AI에게서 왔든 동일한 기준으로 검증해야 한다는 뜻이다. 더 나아가 코드를 작성한 동일한 AI에게 그 코드를 검증하게 하는 방식은 충분하지 않다. 생성과 검증에는 서로 다른 방법론과 도구가 필요하며, 그래야 같은 종류의 편향이나 blind spot(사각지대)을 반복하지 않을 수 있다.
두 번째 원칙은 Multi-layered Verification(다층 검증)이다. 소프트웨어의 문제는 한 가지 방식으로 모두 잡을 수 없다. 문법 오류, 데이터 흐름 문제, 제어 흐름 문제, 아키텍처 위반, 보안 취약점, 의존성 리스크, 유지보수성 저하 등은 서로 다른 분석 기법을 요구한다. 강연자는 계산적 분석과 LLM 기반 리뷰를 함께 사용해야 하며, 그 사이의 다양한 방식도 조합해야 한다고 강조한다.
이 접근은 AI 시대의 코드 리뷰를 “한 번 보고 승인하는 절차”에서 “반복 가능하고 감사 가능한 품질 시스템”으로 바꾼다. 특히 규제 산업에서는 검증이 실제로 수행되었고, 모든 프로젝트와 팀에 동일하게 적용되었으며, 그 결과를 추적할 수 있다는 점이 중요하다. 따라서 검증 플랫폼은 단순한 개발 편의 도구가 아니라, 조직의 기술 거버넌스 인프라에 가까워진다.
AC/DC — Guide, Verify, Solve의 구조
Sonar가 제안하는 AC/DC, 즉 Agent Centric Development Cycle은 AI 에이전트를 중심으로 재구성된 개발 루프다. 강연자는 이 루프를 Guide, Verify, Solve의 세 단계로 설명한다. 먼저 Guide 단계에서는 에이전트가 코드를 작성하기 전에 필요한 맥락, 제약, 가드레일을 제공한다. 여기에는 아키텍처 제약, 허용 가능한 의존성, 코딩 표준, 로깅과 observability(관측성) 관행, 보안 기준, 품질 기준이 포함된다.
Verify 단계는 이 프레임워크의 중심이다. 에이전트가 코드를 쓰는 도중이나 PR(Pull Request) 단계에서 독립적인 기준으로 코드를 검증하고, 품질, 보안, 유지보수성, 규정 준수 측면에서 문제를 찾는다. 이 검증은 단순히 마지막 관문에서 실패를 통보하는 방식이 아니라, 가능한 한 에이전트의 작업 루프 안쪽에서 일찍 수행되어야 한다. 그래야 문제 있는 코드가 다음 생성 루프나 더 큰 변경 묶음으로 전파되지 않는다.
Solve 단계에서는 발견된 문제를 다시 해결한다. 이때 중요한 변화는 에이전트가 문제를 고치는 데 필요한 도구 접근권을 갖고, 검증 결과를 바탕으로 스스로 수정 작업을 반복할 수 있다는 점이다. 인간 개발자는 모든 결함을 직접 고치는 사람이 아니라, 기준을 설계하고, 맥락을 제공하고, 자동화된 수정이 받아들일 만한지 판단하는 오케스트레이터에 가까워진다.
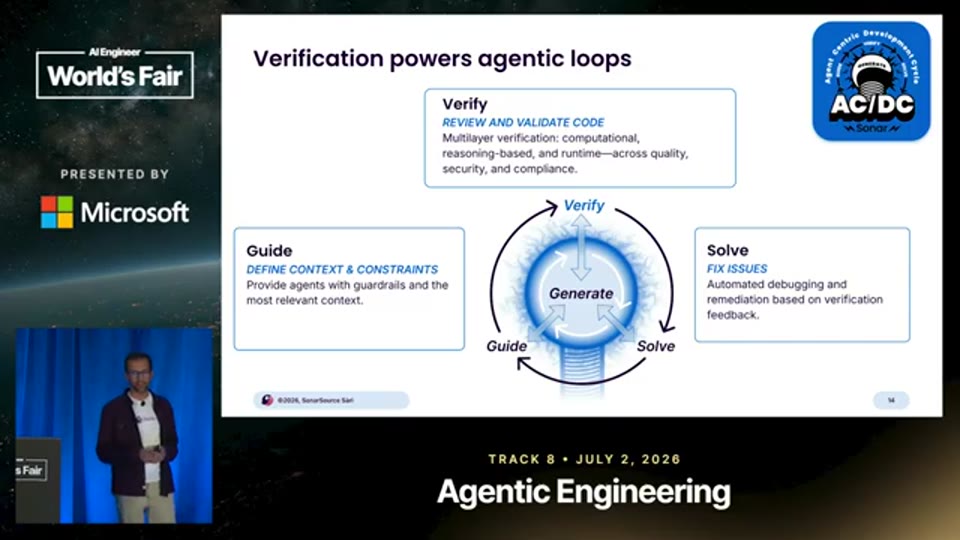
10:46 - AC/DC, 즉 Agent Centric Development Cycle의 Guide, Verify, Solve 구조를 설명하는 슬라이드 구간
Inner Loop와 Outer Loop 모두에서 검증해야 한다
강연 후반부의 핵심은 검증이 한 곳에서만 일어나서는 안 된다는 주장이다. AI 에이전트가 코드를 작성하는 inner loop(내부 루프)와, PR, CI/CD, 배포로 이어지는 outer loop(외부 루프) 모두에서 검증이 작동해야 한다. 내부 루프에서는 에이전트가 작업 중인 코드에 대해 즉시 피드백을 받고 수정할 수 있어야 하며, 외부 루프에서는 조직 전체의 품질 기준을 만족하지 못하는 변경이 프로덕션으로 들어가지 못하게 막아야 한다.
Sonar Vortex는 이 내부 루프를 겨냥한 제품으로 소개된다. 강연자에 따르면 Sonar Vortex는 에이전트가 코드를 쓰기 전에 필요한 프로젝트 맥락과 제약을 제공하고, 코드 작성 중 실시간으로 검증을 실행해 문제를 바로 고치게 한다. 공식 Sonar 자료에서도 Sonar Vortex는 에이전트의 코딩 루프 안에서 아키텍처 맥락을 제공하고 결과를 실시간 검증하는 제품으로 설명된다.
외부 루프에서는 SonarQube와 Gitar가 등장한다. SonarQube는 정적 분석과 품질 게이트를 통해 보안, 신뢰성, 유지보수성 기준을 평가하고, Gitar는 LLM 기반 AI 코드 리뷰와 수정 제안을 제공하는 계층으로 설명된다. Sonar는 2026년 5월 Gitar를 인수했으며, 이를 통해 AI-native code review(AI 네이티브 코드 리뷰)를 SonarQube의 검증 플랫폼과 결합하려는 방향을 밝혔다. 강연자는 이 조합을 통해 PR 단계에서 품질 게이트를 통과하지 못한 문제를 자동으로 찾고, 수정하고, 다시 검증하는 흐름을 만들 수 있다고 설명한다.
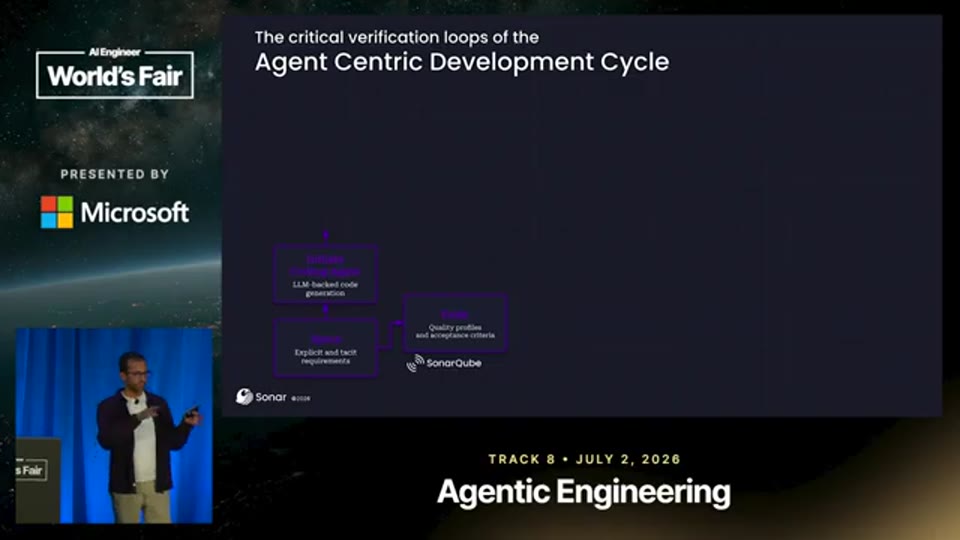
15:52 - 내부 agentic loop와 외부 CI/CD loop에 AC/DC가 어떻게 적용되는지 상세 차트를 분해해 설명하는 구간
데모가 보여준 실제 작업 흐름
강연자는 시간이 부족하다고 말하면서도 Sonar Vortex의 데모 영상을 짧게 보여준다. 데모에서는 Cursor가 작업을 시작할 때 Sonar Vortex의 context tool을 호출해 코드베이스에 대한 필요한 맥락을 먼저 가져온다. 이후 Cursor가 코드를 작성하고, 작성이 끝나면 Sonar의 검증 프로세스를 호출해 실시간으로 발견된 이슈 목록을 받는다.
중요한 점은 이 피드백이 개발 종료 후의 사후 검토가 아니라, 에이전트가 아직 작업 중인 시점에 제공된다는 것이다. 이슈가 발견되면 에이전트는 바로 수정하고, 다시 분석을 실행하며, 검증을 통과할 때까지 루프를 반복한다. 강연자는 이러한 통합이 Cursor뿐 아니라 Claude Code, Codex 등 주요 AI 코딩 도구와 연결될 수 있다고 설명한다. 구체적인 지원 범위는 Sonar의 최신 제품 문서를 함께 확인하는 것이 안전하다.
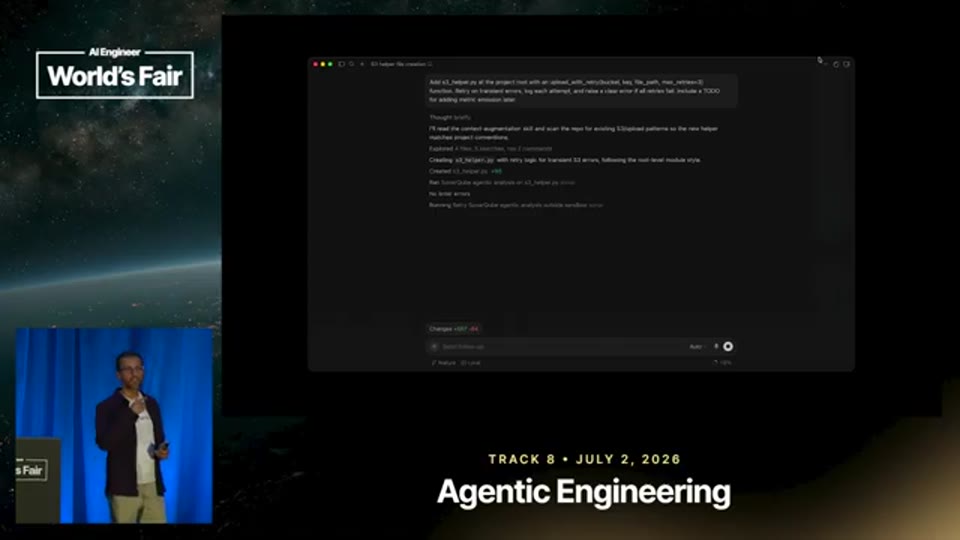
19:41 - Cursor와 Sonar Vortex 연동 데모에서 이슈 발견 후 에이전트가 즉시 수정하는 흐름을 보여주는 구간
이 데모의 메시지는 제품 소개를 넘어선다. AI 코딩의 품질 문제를 해결하려면, 검증이 개발자의 사후 리뷰나 CI 실패 메시지로만 남아서는 안 된다. 검증은 에이전트가 코드를 생성하는 바로 그 과정에 들어가야 하며, 에이전트는 그 결과를 사용해 자기 출력을 고치는 구조를 가져야 한다.
보안과 컴플라이언스가 검증을 더 시급하게 만든다
강연자는 AI 코딩 검증이 단순한 코드 품질 문제가 아니라 보안과 컴플라이언스 문제라고 강조한다. 특히 보안 영역에서는 CVE(Common Vulnerabilities and Exposures, 공개 취약점)가 발표된 뒤 같은 날 악용되는 경우가 많아지고 있기 때문에, 취약한 코드가 프로덕션에 들어가기 전에 가능한 한 왼쪽으로 이동해 잡아야 한다. 이른바 Shift Left Security(보안의 좌측 이동)가 AI 시대에는 더 절실해진다.
컴플라이언스 측면에서도 검증은 중요하다. 규제 산업에서 일하는 조직은 코드가 어떤 기준으로 검토되었는지, 그 검증이 얼마나 일관되게 수행되었는지, 누가 어떤 결과를 승인했는지 설명할 수 있어야 한다. AI가 만든 코드라고 해서 이 책임이 줄어들지는 않는다. 오히려 코드 작성 주체가 불투명해질수록 감사 가능한 검증 기록은 더 중요해진다.
이 때문에 강연자는 중앙화된 단일 검증 체계의 필요성을 반복해서 말한다. 팀마다 다른 도구, 프로젝트마다 다른 기준, 개발자마다 다른 리뷰 습관에 의존하면 조직 전체의 blind spot이 생긴다. AI 코딩 도구가 다양해질수록 검증 플랫폼은 더 독립적이고 일관적이어야 하며, 모든 코드와 모든 에이전트에 같은 기준을 적용해야 한다.
Sonar의 제품 전략 — 기존 품질 게이트를 에이전트 시대로 확장하다
SonarQube는 기존에도 널리 쓰이던 코드 품질 및 정적 분석 플랫폼이다. 강연자는 SonarQube가 syntax(문법), data flow(데이터 흐름), architecture(아키텍처), control flow(제어 흐름) 등 여러 층위에서 코드를 분석하며, 다양한 언어를 지원한다고 설명한다. Sonar의 공식 자료 역시 SonarQube를 인간이 작성한 코드와 AI가 작성한 코드를 동일하게 검증하는 플랫폼으로 포지셔닝한다.
새로운 점은 이 검증 역량이 에이전트의 작업 루프 안으로 들어간다는 것이다. Sonar Vortex는 Guide와 Verify를 내부 루프에서 수행하고, SonarQube Remediation Agent는 기존 코드베이스의 기술 부채와 백로그 이슈를 자동으로 줄이는 Solve 역할을 맡는다. 공식 Sonar 블로그에 따르면 Sonar Vortex와 Remediation Agent는 2026년 6월 30일 소개되었고, Sonar Vortex는 에이전트에게 사전 맥락을 제공하며 실시간 검증을 수행하는 제품으로 설명된다.
Gitar 인수 역시 같은 방향의 움직임이다. Gitar는 AI 기반 코드 리뷰와 수정 생성을 제공하는 제품으로, Sonar는 이를 통해 PR 리뷰와 CI 워크플로우까지 자동화하는 방향을 제시한다. 강연자는 기본적으로는 이슈를 찾아 개발자에게 보여주고 대화형으로 수정하게 하지만, 신뢰가 쌓이면 더 많은 자동화 기능을 켤 수 있다고 말한다. 이 대목에서 중요한 것은 자동화가 즉시 무제한으로 열리는 것이 아니라, 검증 결과와 조직의 신뢰 수준에 따라 점진적으로 확장된다는 점이다.
핵심 인사이트 — AI 개발의 병목은 생성이 아니라 신뢰다
이 강연의 가장 중요한 통찰은 AI 코딩 도구의 다음 병목이 코드 생성 능력이 아니라 신뢰 체계라는 점이다. 모델은 계속 좋아지고 있으며, 에이전트는 점점 더 많은 코드를 작성할 것이다. 그러나 소프트웨어 조직이 실제로 원하는 것은 많은 코드가 아니라 배포할 수 있는 코드다. 배포 가능한 코드는 기능뿐 아니라 보안, 유지보수성, 규정 준수, 운영 안정성까지 갖춰야 한다.
따라서 AI 코딩 시대의 생산성은 “얼마나 빨리 생성하느냐”가 아니라 “얼마나 빨리 검증 가능한 상태로 수렴하느냐”에 의해 결정된다. 검증 없는 생성은 처음에는 빠르게 보이지만, 복잡도 증가와 기술 부채 누적으로 나중에 속도를 잃는다. 반대로 에이전트가 올바른 맥락을 받고, 독립 검증을 거치며, 발견된 문제를 즉시 해결하는 루프를 갖추면 생산성은 더 지속 가능한 형태로 바뀐다.
이 관점은 개발자의 역할도 바꾼다. 개발자는 더 이상 모든 코드를 직접 작성하는 사람만은 아니다. 대신 에이전트가 따라야 할 기준을 정의하고, 필요한 맥락을 설계하며, 자동 검증 체계가 품질을 보장하도록 운영하는 사람에 가까워진다. 강연자가 말하는 bounded autonomy(경계가 있는 자율성)는 바로 이 변화의 핵심이다. 에이전트에게 자유를 주되, 그 자유가 조직의 품질 기준 안에서 작동하도록 만드는 것이 AI 시대의 엔지니어링 관리 방식이 된다.
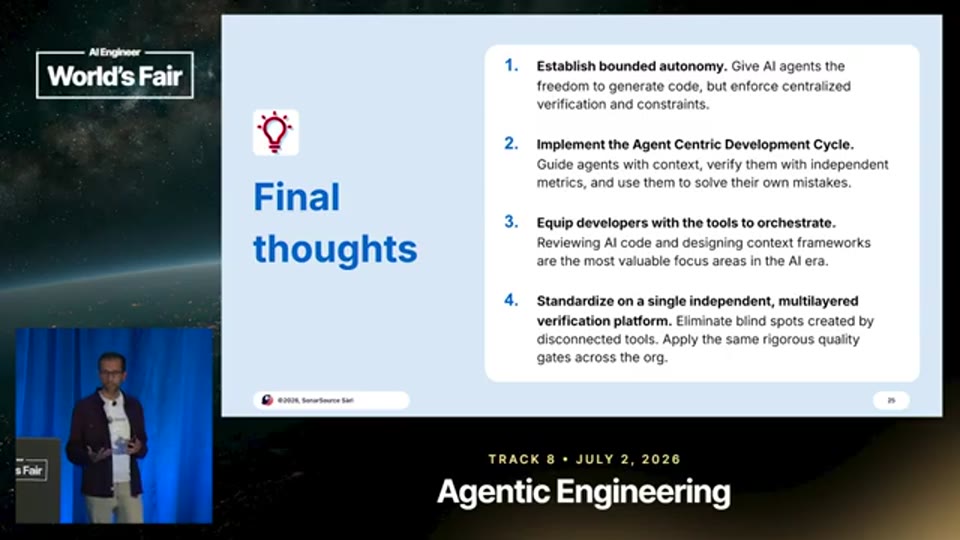
21:30 - bounded autonomy, 독립 검증, 에이전트 기반 해결 루프 등 최종 핵심 takeaways를 정리하는 구간
마무리 / 핵심 정리
Anirban Chatterjee의 결론은 분명하다. AI 코딩 도구의 다음 단계는 더 많은 코드를 더 빠르게 쓰는 것이 아니라, 그 코드를 신뢰할 수 있게 만드는 것이다. 이를 위해 조직은 에이전트에게 맥락과 제약을 제공하고, 독립적이며 다층적인 검증을 수행하고, 발견된 문제를 다시 에이전트가 해결하게 하는 반복 구조를 갖춰야 한다.
강연자는 이를 AC/DC의 Guide, Verify, Solve 구조로 정리한다. Guide는 에이전트가 처음부터 조직의 아키텍처와 표준에 맞는 코드를 쓰게 만들고, Verify는 인간과 AI 생성 여부에 관계없이 동일한 기준으로 코드를 검증하며, Solve는 문제 해결을 자동화해 기술 부채를 줄인다. 이 루프가 inner loop와 outer loop 모두에 적용될 때, AI 코딩은 실험용 생산성 도구를 넘어 엔터프라이즈 소프트웨어 개발의 실제 인프라가 될 수 있다.
결국 이 강연은 Sonar 제품 소개이면서 동시에 AI 개발 조직을 향한 운영 원칙 제안이다. AI 에이전트의 자율성은 필요하지만, 그 자율성은 검증 가능한 경계 안에서만 확장되어야 한다. 코드 생성이 쉬워진 시대일수록, 조직의 경쟁력은 검증, 거버넌스, 품질 기준을 얼마나 일관되게 운영하느냐에서 갈린다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Guide, Verify, Solve — Anirban Chatterjee, Sonar |
| 채널 | AI Engineer |
| 영상 길이 | 약 22분 12초 |
| 리포트 작성 | 2026-08-10 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
| 참고 자료 | Sonar Vortex and SonarQube Remediation Agent |
| 참고 자료 | Sonar Acquires Gitar |
| 참고 자료 | Agent Centric Development Cycle |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- In the Land of AI Agents, the Verifiers Are King — Tariq Shaukat, Sonar
- Can LLMs generate Enterprise Quality Code? — Prasenjit Sarkar, Sonar
- Benchmarking Coding Agents on New vs Legacy Codebases — Denys Linkov, Wisedocs
- Seamless Static Analysis with Cppcheck - From IDE to CI and Code Review - Daniel Marjamäki
- Leverage AI Agents to Refactor and Modernize C++ Code - Jubin Chheda - CppCon 2025