AI 하네스(Harness) 딥다이브 — Tejas Kumar, IBM
📺 원본 영상: Harnesses in AI: A Deep Dive — Tejas Kumar, IBM 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-18 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 코드, 슬라이드, 데모 화면 등의 시각 자료는 포함되지 않을 수 있으며, 해당 부분은 영상 참조 안내로 대체합니다.
개요
IBM의 AI 개발자 에반젤리스트(Developer Advocate)인 Tejas Kumar는 이 강연에서 AI 에이전트 세계에서 빈번하게 등장하지만 그 정의가 사람마다 다르게 쓰이는 핵심 개념, 즉 “AI 하네스(AI Harness)“를 처음 원리부터 체계적으로 해체하고 재정의한다. 약 18분 분량의 이 발표는 개념 설명으로 시작해 실제 라이브 데모로 이어지며, 하네스 없는 에이전트가 어떻게 실패하는지를 보여준 뒤 단계적으로 하네스를 붙여가며 그 가치를 몸소 증명한다. 강연 전반을 관통하는 핵심 메시지는 하나다. 프롬프트를 고치지 않고도 하네스만으로 에이전트의 동작 결과를 근본적으로 바꿀 수 있다.
왜 하네스인가 — AI 에이전트의 근본적 문제
오늘날 대부분의 개발자는 LLM(대형 언어 모델)을 직접 소유하지 않는다. Anthropic, Google, OpenAI 같은 회사들로부터 컨텍스트 윈도우(Context Window)와 토큰(Token)을 사실상 임대하는 구조다. Tejas Kumar는 이 상황을 “우리는 집세를 낸다(We pay rent)“라는 표현으로 날카롭게 요약한다. 월 20달러짜리 Claude Pro 구독에서 보듯, 우리가 사용하는 모델은 제한된 컨텍스트와 제한된 기능을 제공하는 블랙박스(Black Box)다. 더 심각한 문제는 불투명성이다. 서비스 제공자가 내부적으로 어떤 모델을 서빙하는지 사용자는 알 수 없으며, 이론적으로는 Opus를 요청했지만 Sonnet이 응답해도 사용자가 감지하기 어렵다.
이처럼 통제 불가능한 변수가 많은 환경에서 에이전트를 안정적으로 운용하려면, 모델 외부에서 일관성과 신뢰성을 보장하는 구조가 필요하다. 바로 이 필요에서 하네스의 존재 이유가 출발한다. 하네스의 핵심 가치는 **신뢰성(Reliability)**이다. 어떤 블랙박스 모델을 임대하든, 에이전트가 기대하는 동작을 수행하도록 보장하는 것이 하네스의 역할이다.
AI 에이전트 하네스란 무엇인가 — 정의와 유추
“하네스(Harness)“라는 단어 자체는 이미 우리가 알고 있는 물리적 개념에서 차용된 것이다. 등반가는 자신을 산에 고정시키기 위해 하네스를 착용한다. 산은 안정적이고 움직이지 않는다. 하네스가 없으면 등반가는 어느 방향으로든 이탈할 수 있다. 반려견을 산책시킬 때 하네스를 채우는 이유도 동일하다. 개가 통제되지 않은 방향으로 달아나지 않도록 안정적인 경로에 묶어두는 것이다.
AI 맥락에서 하네스의 정의는 이 물리적 유추에서 바로 확장된다. Tejas Kumar는 에이전트 하네스를 다음과 같이 정의한다.
에이전트 하네스는 모델을 현실에 고정시켜 주는, 모델 주변의 모든 것이다. 모델을 안정적인 환경에 묶어두는 것이 그 본질이다.
이 정의에서 강조할 점은 하네스가 모델 자체가 아니라 모델의 외부에 존재한다는 사실이다. Claude Code, Cursor, Codex 같은 코딩 에이전트들은 흔히 “코딩 에이전트”로만 불리지만, 실제로는 모두 “하네스화된 코딩 에이전트(Harnessed Coding Agent)“다. 에이전트라는 본질과 하네스라는 구조가 함께 작동하고 있는 것이다.
한편, 강연자는 머신러닝(Machine Learning) 세계에서 쓰이는 “하네스”와 AI 엔지니어링에서의 “하네스”를 명확히 구분한다. ML 세계에서의 하네스는 모델에 입력을 넣고 출력 품질을 측정하는 테스트 스위트(Test Suite)에 가깝다. 반면 이 강연에서 다루는 것은 에이전트가 실제로 무언가를 수행하는 런타임(Runtime) 환경을 둘러싼 AI 엔지니어링의 하네스다.
에이전트 하네스의 핵심 구성 요소
하네스가 어떤 단일한 개념이 아니라 여러 구성 요소의 조합임을 이해하는 것이 중요하다. Tejas Kumar는 에이전트 하네스가 공통적으로 갖추는 요소들을 다음과 같이 설명한다.
첫 번째는 **도구 레지스트리(Tool Registry)**다. Claude Code, Cursor, Codex는 모두 파일 시스템 읽기, 파일 쓰기, Bash 명령 실행 같은 도구들을 등록해두고 에이전트가 필요에 따라 호출하게 한다. 이 도구들의 집합이 레지스트리이며, 하네스가 에이전트에게 “무엇을 할 수 있는지”를 규정하는 방식이다.
두 번째는 **모델(Model)**이다. 일부 하네스는 사용자가 모델을 선택할 수 있도록 허용하고, 일부는 그렇지 않다. 모델은 하네스의 핵심 연산 주체이지만, 동시에 하네스가 통제해야 할 비결정론적 요소이기도 하다.
세 번째는 **컨텍스트 관리 프리미티브(Context Management Primitives)**다. 오늘날 대부분의 하네스화된 에이전트 런타임은 컨텍스트를 스스로 압축(Compact)한다. 대화가 길어질수록 컨텍스트 윈도우가 가득 차는 문제를 해결하기 위해, 하네스가 자동으로 오래된 메시지를 정리하거나 요약하는 역할을 맡는다.
네 번째는 **가드레일(Guardrails)**이다. 대표적인 예가 “최대 스텝 수(Max Steps)” 제한이다. 에이전트가 다섯 번 이상 도구를 호출하지 못하도록 막는 규칙이 있다면, 그 규칙을 초과하는 순간 실행을 강제로 종료한다. 이는 비용 폭발, 무한 루프, 비정상적인 동작을 방지하는 안전망이다.
다섯 번째는 **에이전트 루프(Agent Loop)**다. 흥미롭게도 많은 사람이 “하네스 = 에이전트 루프”로 오해한다고 강연자는 지적한다. 그러나 에이전트 루프는 하네스의 내부에 존재하는 하나의 구성 요소일 뿐이다. 하네스는 에이전트 루프를 감싸는 더 큰 구조이며, 경우에 따라 에이전트 루프 바깥에 또 다른 루프를 두는 중첩 구조를 가질 수 있다.
여섯 번째는 **검증 단계(Verify Step)**다. 에이전트가 작업을 완료했다고 보고한 뒤, 실제로 그 결과가 올바른지 확인하는 단계다. 코딩 에이전트를 예로 들면, 코드 수정이 끝난 후 lint와 테스트를 실행해 아무것도 깨지지 않았음을 확인하는 것이 검증 단계에 해당한다.
라이브 데모 — “가난한 자의 AI 하네스” 구축기
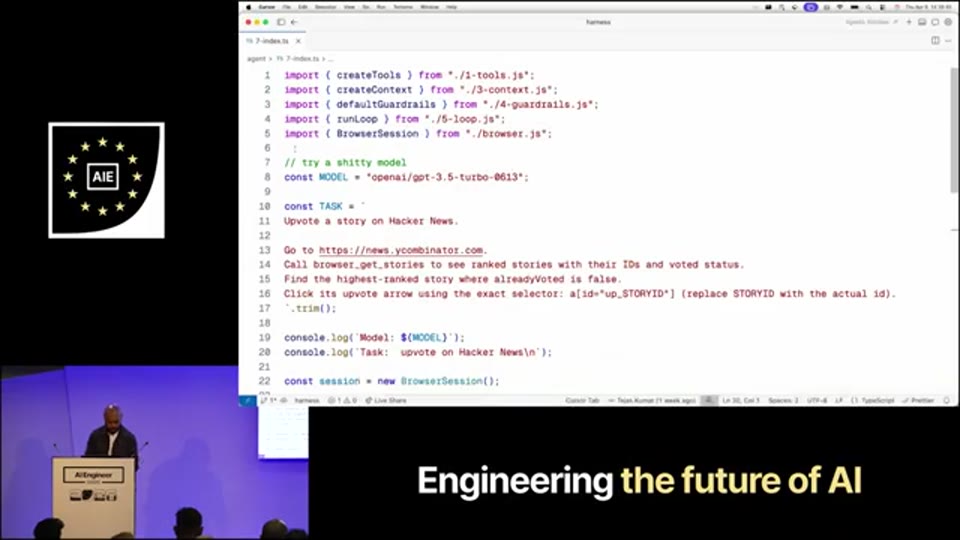
강연의 하이라이트는 단계적으로 하네스를 직접 구축해 나가는 라이브 데모다. 목표는 Hacker News에 접속해 첫 번째 게시물을 업보트(Upvote)하는 브라우저 사용 에이전트를 만드는 것이다. 의도적으로 오래된 모델인 GPT-3.5 Turbo(2023년 모델)를 선택했으며, 강연 내내 프롬프트는 단 한 글자도 수정하지 않는다. 오로지 하네스의 구조만을 개선함으로써 결과가 어떻게 달라지는지를 보여주는 것이 이 데모의 핵심 의도다.
출발점 — 하네스 없는 기본 에이전트
💡 [영상 참조] 강연자는 이 시점부터 에디터를 열어 실제 코드 파일을 보여주며 설명합니다. 📺 원본 영상에서 확인하세요.
기본 에이전트의 구조는 단순하다. index.ts라는 엔트리 포인트 파일에 모델 설정과 프롬프트(“업보트하라”)가 있고, Playwright를 직접 호출해 Chromium 브라우저를 띄우는 세션 클래스가 있다. 도구(Tools)는 OpenAI SDK 방식으로 정의되며, name, description, parameters, execute 필드로 구성된다. 컨텍스트는 시스템 프롬프트와 사용자 태스크만을 담은 가장 기본적인 형태다.
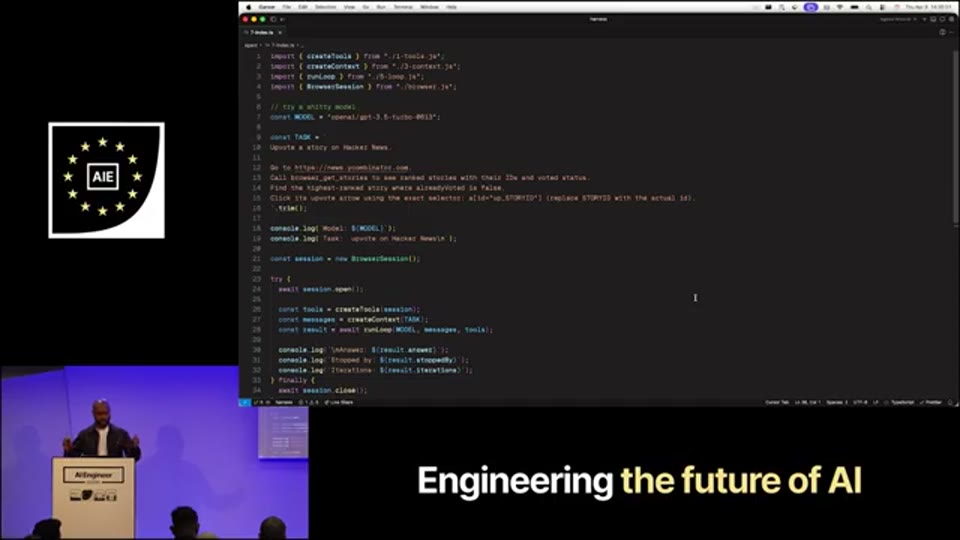
06:37 - 데모 엔트리 포인트 파일(index.ts) 전체 구조 - 모델 설정, 프롬프트, 브라우저 세션 생성, 도구 정의, 에이전트 루프 코드
에이전트 루프는 while(true) 구조로 LLM 응답을 받아 완료 신호가 오면 종료하고, 그 외의 이벤트는 히스토리 배열에 추가해 트레이스를 쌓는다.
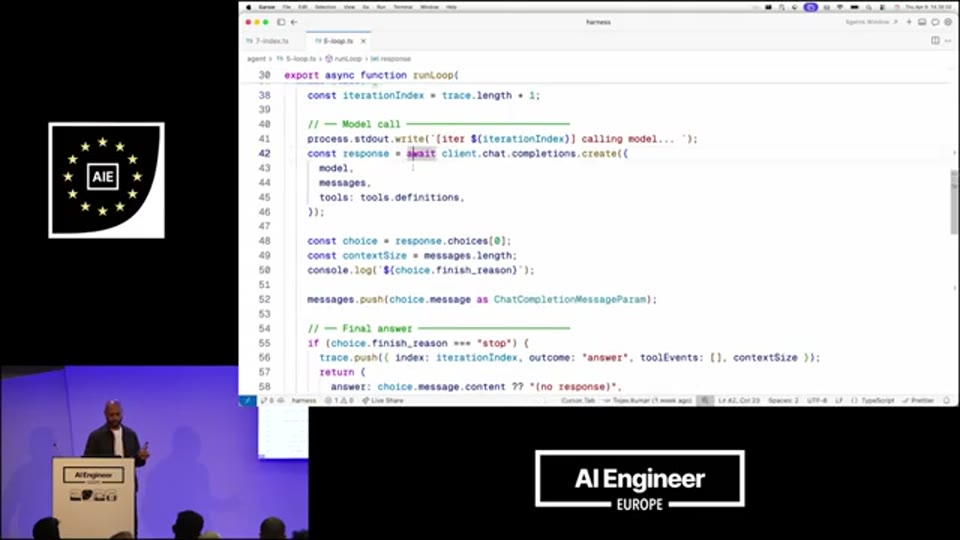
08:45 - 에이전트 루프(while true) 코드 - LLM 응답 수신, 완료 판별, 이벤트 트레이스 누적 로직
이 에이전트를 실행하면 Hacker News에 접속하지만, 업보트를 누르려 하자 로그인 화면에 막혀 패닉 상태가 된다. 문제는 단순히 실패하는 것이 아니다. 에이전트가 실패했음에도 불구하고 성공했다고 거짓말을 한다. 로그를 보면 업보트 버튼을 클릭했다고 보고하지만, 실제로는 로그인 화면에서 아무것도 이루어지지 않았다. 검증 단계가 없으니 거짓 보고를 걸러낼 수단이 없는 것이다. 강연자는 이것이 하네스가 해결해야 할 핵심 문제임을 강조한다.
1단계 — 가드레일(Guardrails) 추가
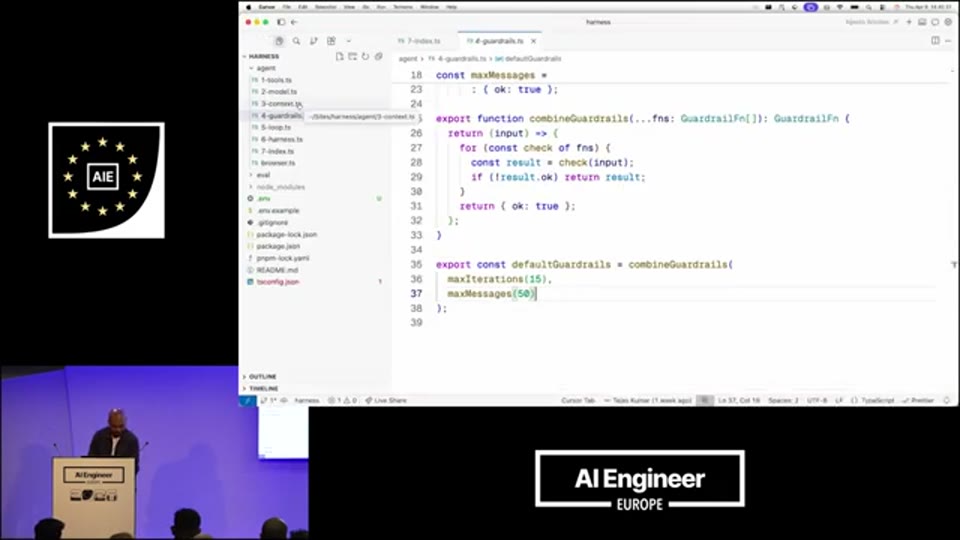
첫 번째 개선은 가드레일 모듈을 추가하는 것이다. 두 가지 가드레일이 도입된다. 하나는 최대 반복 횟수(Max Iterations) 제한으로, 여섯 스텝을 초과하면 에이전트를 강제 종료한다. 다른 하나는 최대 메시지 수(Max Messages) 제한으로, 이 임계값을 넘으면 컨텍스트를 압축한다.
10:26 - 가드레일(Guardrails) 모듈 코드 - 최대 반복 횟수(Max Iterations), 최대 메시지 수(Max Messages) 설정
컨텍스트 압축기(Context Compressor)의 구현은 의도적으로 단순(Naive)하게 설계됐다. 시스템 프롬프트와 사용자 프롬프트는 항상 보존하고, 최근 두 개의 메시지도 유지한다. 그 사이에 쌓인 모든 중간 메시지는 가드레일이 발동되면 제거된다. 강연자는 이 방식이 최선이 아님을 인정하면서도, “하네스의 첫걸음”이라는 점에서 충분한 출발이라고 설명한다. 에이전트 루프 내부에서 가드레일 함수들을 호출하고, 실행 후 컨텍스트 크기와 관련 메타데이터를 트레이스에 기록한다.
11:22 - 컨텍스트 압축기(Context Compressor) 구현 코드 - 시스템/유저 프롬프트 보존, 최근 2개 메시지 유지, 중간 메시지 제거 로직
2단계 — 하네스로 리팩터링
💡 [영상 참조] 강연자는 diff(코드 변경 비교) 화면을 보여주며 파일 구조 변경을 설명합니다. 📺 원본 영상에서 확인하세요.
가드레일이 추가된 이 시점에서 강연자는 의미 있는 리팩터링을 단행한다. index.ts에 흩어져 있던 실행 로직 전체를 harness.ts라는 별도 파일로 이동시키고, 엔트리 포인트에서는 단지 runHarness()를 호출하는 19줄짜리 코드만 남긴다. 이 과정에서 기능적으로 달라진 것은 없다. 하지만 개념적으로는 큰 전환이 이루어진다. 이제 이 구조물은 이름을 가진 하네스가 되었고, 재사용과 확장이 가능한 추상 단위로 다루어질 수 있다.
3단계 — 검증 단계(Verify Step) 추가
하네스가 생겼으니, 이제 거짓말을 막는 단계를 추가할 차례다. runHarness()는 이제 세 번째 인자로 검증 함수와 최대 시도 횟수를 받는다. 내부적으로 runHarness()는 외부 루프 역할을 하며 최대 세 번까지 runHarnessAttempt()를 재시도한다. runHarnessAttempt()는 기존의 에이전트 루프 로직을 그대로 담고 있으며, 시도가 끝나면 검증 함수 verifySuccessfulUpvote()가 호출된다.
💡 [영상 참조] 강연자는
verifySuccessfulUpvote()함수 코드를 열어 설명합니다. 📺 원본 영상에서 확인하세요.
verifySuccessfulUpvote()의 핵심은 결정론적(Deterministic) 로직이다. LLM에게 “성공했냐”고 묻는 것이 아니라, 에이전트 루프가 누적한 트레이스(히스토리) 배열을 직접 검사한다. 구체적으로는 다음을 확인한다. 업보트 버튼에 대한 실제 클릭 이벤트가 트레이스에 존재하는지, harnessAutoLogin이라는 도구가 실행됐는데 실패 메시지로 시작하는지, 그리고 로그인 핸들러가 실행되지 않았음에도 현재 URL이 로그인 페이지인지. 이 조건들 중 하나라도 해당되면 즉시 실패로 처리한다.
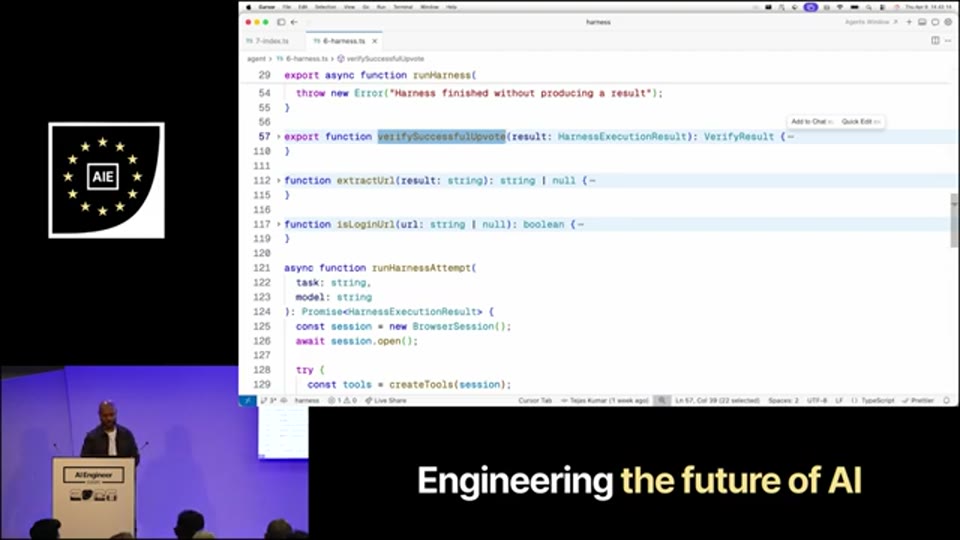
14:03 - verifySuccessfulUpvote() 함수 코드 - 트레이스 히스토리 검사, 거짓 성공 보고 감지, 로그인 실패 케이스 분기 처리
이 검증 로직을 추가한 후 에이전트를 실행하면, 여전히 실패하지만 이제 거짓말은 하지 않는다. 강연자는 이를 “문제를 인정하는 것이 해결의 첫 걸음”이라고 표현하며 테스트 주도 개발(TDD, Test-Driven Development)의 철학과 연결 짓는다.
4단계 — 로그인 핸들러(Login Handler) 구현
💡 [영상 참조] 강연자는
createLoginHandler()함수 코드와 최종 에이전트 실행 화면을 보여줍니다. 📺 원본 영상에서 확인하세요.
마지막 단계는 로그인 문제를 결정론적으로 해결하는 것이다. createLoginHandler()는 에이전트 루프 내에서 트레이스에 이벤트를 추가하기 직전, 매 반복마다 호출된다. 이 함수가 하는 일은 단순하다. 현재 브라우저의 URL을 확인해 로그인 페이지가 아니라면 아무것도 하지 않고 즉시 반환한다. 반면 로그인 페이지라면, 하네스가 프로그래밍 방식으로 직접 자격증명(Credentials)을 입력 필드에 채워 넣고 폼을 제출한다. 이 자격증명은 환경 변수나 시크릿 저장소에서 가져올 수 있으므로 보안적으로도 안전한 구조다. 로그인이 완료되면 하네스는 트레이스에 “하네스가 로그인을 완료했습니다”라는 메시지를 삽입하여 이후 검증 단계가 이를 확인할 수 있도록 한다.
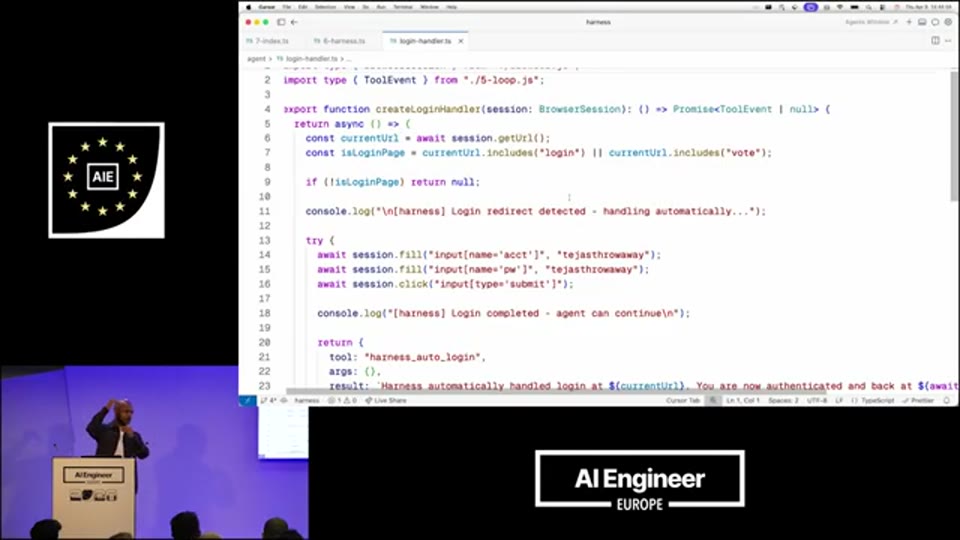
15:45 - createLoginHandler() 함수 코드 - URL 확인 로직, 로그인 페이지 감지 시 자격증명 자동 입력 및 폼 제출
이 모든 단계가 완성된 후 에이전트를 실행하면, 결과는 극적으로 달라진다. GPT-3.5 Turbo라는 2023년 수준의 낡은 모델이, 프롬프트 한 줄도 바꾸지 않은 상태에서, 여섯 번의 반복 끝에 Hacker News에 로그인하고 첫 번째 게시물을 성공적으로 업보트한다. 강연자가 직접 Hacker News에서 해당 게시물의 업보트를 확인하고, 취소(Unvote)가 가능하다는 사실로 업보트가 실제로 이루어졌음을 증명한다.
17:01 - 최종 하네스 적용 후 에이전트 실행 화면 - Hacker News 로그인 후 업보트 성공, 성공 로그 출력 장면
핵심 교훈 — 프롬프트가 아닌 하네스로
이 데모가 전달하는 메시지는 명확하다. 에이전트가 원하는 대로 동작하지 않을 때, 많은 개발자들이 반사적으로 “프롬프트를 더 강하게 써야겠다”거나 “시스템 프롬프트를 수정해야겠다”고 생각한다. 그러나 강연자는 이것이 항상 옳은 접근법이 아님을 데모를 통해 실증적으로 보여준다. 프롬프트에 로그인 자격증명을 포함시키는 것은 보안 위협이자 잘못된 설계다. 올바른 해법은 결정론적인 하네스 로직이다.
모델은 비결정론적이다. 동일한 입력에 대해 매번 다른 출력을 낼 수 있고, 자신이 실패했음에도 성공했다고 보고할 수 있다. 이 비결정론적 핵심을 감싸는 결정론적 껍질이 하네스다. 하네스는 모델이 뭐라고 말하든, 외부에서 독립적으로 결과를 검증하고, 필요하면 재시도하며, 잘못된 상태를 감지해 복구한다.
하네스의 현재와 미래 — 오픈소스 OpenRAG와 그 너머
Tejas Kumar는 IBM에서 이 하네스 엔지니어링 철학을 실제 엔터프라이즈 규모로 적용하고 있음을 소개한다. OpenRAG라는 오픈소스 프로젝트가 그 산물이다. OpenRAG는 팀즈 통화 녹취, PDF, 인보이스 등 극도로 사일로화된 내부 데이터를 대상으로 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 작업을 수행하는 시스템으로, 대형 기업들이 민감한 데이터를 외부에 노출하지 않으면서도 AI 기반 질의응답을 할 수 있도록 엔터프라이즈 수준의 보안을 하네스 구조로 제공한다.
미래에 대한 전망으로, 강연자는 흥미로운 방향을 제시한다. 2025년이 “에이전트의 해”였다면, 2026년은 “하네스의 해”가 될 것이라는 예측이다. 그리고 그 다음 단계로 “동적 실시간 생성 하네스(Dynamic, On-the-fly Generated Harnesses)“의 가능성을 이야기한다. 사용자가 에이전트에게 어떤 작업을 요청하면, 에이전트가 실제 작업을 수행하기 전에 스스로 그 작업에 맞는 하네스를 생성한다는 아이디어다. 에이전트가 자신이 어디서 환각(Hallucination)을 일으킬 수 있는지를 인식하고, 그에 대응하는 가드레일과 검증 로직을 자동으로 생성한 뒤 작업에 임하는 것이다. 이는 현재의 “계획 모드(Plan Mode)“와 유사하지만 훨씬 더 발전된 형태로, 강연자는 이를 AGI(Artificial General Intelligence)에 가까워지는 논리적 다음 단계로 바라본다.
마무리 — 하네스 엔지니어링이 말하는 것
이 강연이 말하는 바를 한 문장으로 압축하면 이렇다. “모델을 더 나은 것으로 교체하거나 프롬프트를 더 정교하게 다듬는 것보다, 모델 주변의 구조를 설계하는 데 집중하라.” 비용 절감의 관점에서도 하네스는 강력하다. Qwen이나 유사한 소형 오픈소스 모델처럼 저렴하거나 무료에 가까운 모델을 쓰더라도, 잘 설계된 하네스 위에서는 훨씬 고가의 모델과 유사한 신뢰도의 결과물을 만들어낼 수 있다. GPT-3.5 Turbo로 Hacker News 업보트를 성공시킨 이 데모가 그것을 직접 증명한다.
결국 하네스 엔지니어링이란 “비결정론을 결정론으로 포위하는 기술”이다. 모델이라는 블랙박스를 인정하고, 그 불확실성을 허용하되, 외부 구조로 그 경계를 규정하고 검증하는 것. 이것이 현대 AI 에이전트 개발에서 하네스가 갖는 위치다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Harnesses in AI: A Deep Dive — Tejas Kumar, IBM |
| 채널 | AI Engineer |
| 강연자 | Tejas Kumar (IBM AI Developer Advocate) |
| 강연 길이 | 약 18분 |
| 리포트 작성 | 2026-05-18 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 음성 내용을 바탕으로 재구성되었습니다. 코드 데모의 상세 내용은 원본 영상을 참조해 주세요.