Hierarchical Memory: Context Management in Agents
📺 원본 영상: Hierarchical Memory: Context Management in Agents — Sally-Ann Delucia 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-11 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 AI 관측 가능성(Observability) 플랫폼 Arize의 Head of Product인 Sally-Ann Delucia가 AI 에이전트 Alex를 약 1년간 개발하면서 직접 부딪힌 컨텍스트 관리 문제와 그 해결 과정을 다룬다. 단순한 이론이 아니라 실제 프로덕션 환경에서 반복적으로 실패하고, 그 실패로부터 학습한 내용을 솔직하게 공유한다는 점에서 가치가 높다. 핵심 주장은 하나다. 에이전트는 프롬프트가 나빠서 실패하는 것이 아니라, 컨텍스트가 잘못 관리되기 때문에 실패한다.
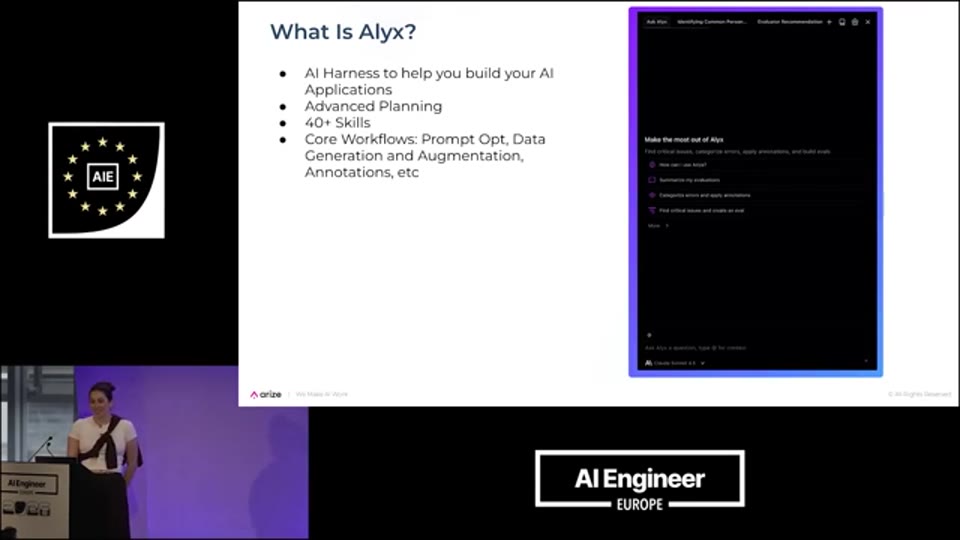
01:25 - Arize Alex 제품의 실제 스크린샷 - 40개 이상의 스킬과 워크플로우 구성 화면
왜 컨텍스트 엔지니어링이 중요한가
지난 몇 년간 AI 개발의 중심은 빠르게 이동했다. 초기에는 좋은 프롬프트를 작성하는 것이 전부처럼 여겨졌다. Andrej Karpathy가 “컨텍스트 엔지니어링이 프롬프트 엔지니어링보다 중요하다”는 내용을 게시하면서 커뮤니티의 관심이 전환되기 시작했고, 이제 AI 스택에서 진짜 도전 과제는 무엇을 모델에게 보여줄 것인가의 문제임이 명확해졌다.
Sally-Ann Delucia는 컨텍스트 관리를 단순히 “토큰 한도 안에 얼마나 많이 넣느냐”의 공학적 문제로 보는 시각에 이의를 제기한다. 토큰 한도를 채우는 것이 목표가 아니라, 모델이 봐야 할 정보를 전략적으로 선택하는 것이 핵심이라는 것이다. 그녀의 표현을 빌리면, “최선의 컨텍스트 전략은 에이전트가 필요한 것은 기억하고 필요하지 않은 것은 잊게 만드는 것”이다. 이 단순해 보이는 원칙 뒤에는 수개월의 실패와 반복적인 개선이 담겨 있다.
Arize는 AI 에이전트의 추적(trace)과 스팬(span) 데이터를 다루는 관측 가능성 플랫폼이다. 사용자가 Alex와 상호작용하면 입력, 프롬프트, 메타데이터가 쌓이고, 여기에 여러 트레이스에 걸친 패턴 분석까지 요구되면 데이터는 기하급수적으로 불어난다. 이 환경에서 컨텍스트를 전략적으로 관리하는 것은 선택이 아닌 생존의 문제였다.
악순환의 고리: 직접 겪은 실패
Arize 팀은 “Alex로 Alex를 만든다”는 원칙으로 개발을 시작했다. 자신들이 사용하고 싶다고 느낀다면 사용자들도 원할 것이라는 가설이었다. 그러나 이 접근 방식은 예상치 못한 악순환을 만들었다. Alex가 트레이스와 스팬 데이터를 처리하면 스팬이 더 많이 생성되고, 그로 인해 데이터가 폭증하며 컨텍스트 한도에 도달하고 Alex는 실패한다. 실패한 스팬 데이터가 그대로 남아 있기 때문에 재시도를 하면 더 많은 데이터가 쌓이고 다시 실패하는 구조였다. 데이터를 분석해야 하는 시스템이 바로 그 데이터에 의해 제약받는, 자기 참조적인 문제였다.
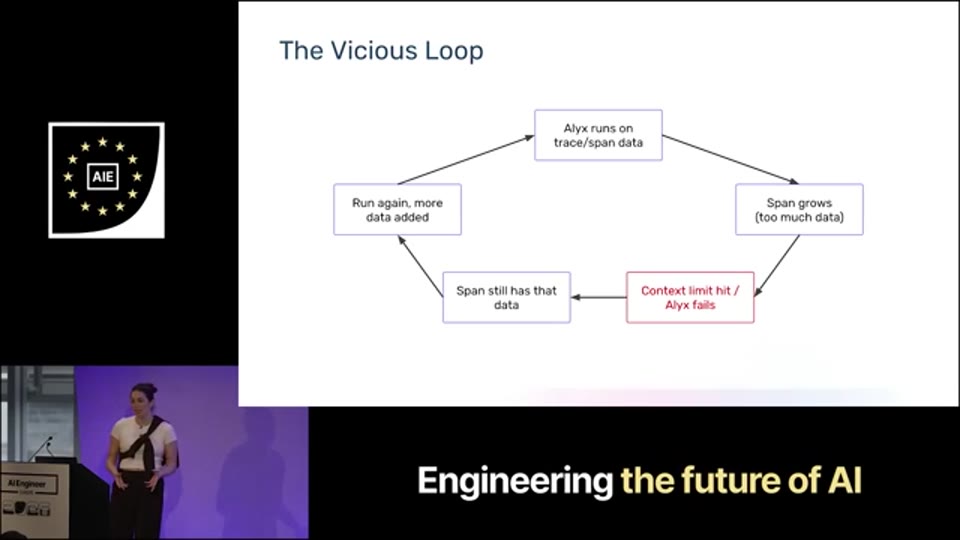
04:26 - 컨텍스트 한도 초과 → 실패 → 재시도 → 더 많은 데이터 → 다시 실패로 이어지는 악순환 루프 다이어그램
이 고리를 탈출하기 위해 팀이 학습한 내용은 크게 세 가지로 정리된다. 컨텍스트를 어떻게 제어할 것인가, 컨텍스트와 메모리를 어떻게 분리할 것인가, 그리고 무거운 작업을 어떻게 다른 에이전트로 이전할 것인가이다.
실패한 시도들: 순진한 트런케이션과 요약
첫 번째 시도는 가장 직관적인 방법이었다. 길고 긴 컨텍스트에서 앞부분 100자만 유지하고 나머지를 버리는 방식이었다. 처음에는 단순한 질의에서 작동하는 것처럼 보였다. 그러나 금방 근본적인 한계가 드러났다. 에이전트가 모든 맥락을 잃어버리면서 후속 질문이 전혀 새로운 대화처럼 처리되기 시작한 것이다. 사용자가 “가장 흔한 입력이 무엇인가요?”라고 묻고, Alex가 답한 뒤, “그럼 입력 B에 대해 더 설명해 주세요”라고 이어 물으면 Alex는 “입력 B”가 무엇인지 전혀 인식하지 못했다. 과도한 트런케이션이 추론 자체를 망가뜨린 것이다.
두 번째 시도는 LLM의 요약 능력을 활용하는 방법이었다. 전체 컨텍스트를 더 짧은 토큰으로 압축한 요약본을 모델에게 전달하면 되지 않을까? 논리적으로 가장 자명한 해법처럼 보였지만, 결과는 실망스러웠다. 무엇이 중요한지 결정하는 기준이 없는 상태에서 요약을 LLM에 맡기면 그 결과가 너무 일관성이 없었다. 어떤 정보가 보존되고 어떤 정보가 손실되는지 예측할 수 없었고, 이는 프로덕션 환경에서 용납할 수 없는 불안정성이었다.
실전 해법: 스마트 트런케이션 메모리
두 번의 실패 끝에 팀이 도달한 방법이 현재 Alex에서 실제로 사용 중인 스마트 트런케이션 메모리(Smart Truncation Memory)다. 이 접근법의 핵심 아이디어는 단순하지만 효과적이다. 대화의 앞 100자와 뒤 100자를 보존하고, 중간 부분은 메모리 저장소에 보관하는 것이다. 중간 내용을 단순히 버리는 것이 아니라 에이전트가 언제든 다시 꺼낼 수 있는 형태로 저장해두기 때문에, 필요한 시점에 과거의 툴 콜 결과나 중요한 메시지를 복구할 수 있다.
07:03 - 스마트 트런케이션 메모리 구조 - 앞 100자(head), 중간(메모리 저장), 뒤 100자(tail)를 분리하는 아키텍처 다이어그램
이 방식의 또 다른 중요한 특성은 시스템 프롬프트를 리셋하지 않는다는 점이다. 중복 메시지가 있으면 최신 결과만 유지하고, 툴 콜의 경우 가장 최근 실행 결과를 남긴다. 결과적으로 에이전트는 자신이 어떤 컨텍스트를 중요하게 여기는지 선택권을 갖게 되었다. Sally-Ann Delucia는 이를 한 문장으로 요약했다. “컨텍스트는 모델이 무엇을 보는지를 결정하고, 메모리는 무엇이 살아남는지를 결정한다.” 이 시스템은 도입 이후 수개월간 별도의 수정 없이 안정적으로 작동하고 있다.
장기 세션의 함정과 평가 전략
스마트 트런케이션이 도입된 후에도 새로운 문제가 수면 위로 떠올랐다. 사용자들은 대화를 새로 시작하지 않는다. Arize에서는 사용자들이 애플리케이션의 여러 페이지를 이동하면서도 같은 대화 세션을 계속 유지하는 패턴이 일반적이었다. 대화가 길어질수록 실패는 뒤늦게 나타났고, 이미 많은 에러가 발생한 뒤에야 사용자 보고나 데이터 분석을 통해 문제를 발견할 수 있었다. 처음에는 잘 작동하던 스마트 트런케이션도 20턴, 30턴을 넘어가는 긴 대화에서는 Alex가 초기 맥락을 망각하기 시작했다.
이에 대한 해법으로 팀이 도입한 것이 장기 세션 평가(Long Session Evals)다. 10턴을 로드한 뒤 11번째 턴의 성능을 테스트하는 방식으로, 컨텍스트 관리가 얼마나 잘 작동하고 있는지를 정량적으로 측정한다. 이 접근법의 진짜 가치는 버그가 테스트 가능한 단위로 전환된다는 점이다. 사용자가 문제를 보고할 때까지 기다리거나 운 좋게 이상 징후를 발견할 필요 없이, 개발 단계에서 체계적으로 장기 세션의 취약점을 검출할 수 있게 되었다.
아키텍처 전환: 서브에이전트로 책임 분산
장기 세션 평가로 문제를 조기에 발견할 수 있게 되었지만, 근본적인 데이터 과부하 문제는 여전히 남아 있었다. 팀이 내린 핵심 결론은 “모든 컨텍스트가 같은 에이전트에 있을 필요는 없다”는 것이었다. 특히 검색(Search) 작업의 경우, Alex가 Arize 내 데이터를 탐색할 때 수백 개의 스팬에 걸친 다중 쿼리, 방대한 데이터, 단계별 중간 추론이 동시에 발생한다. 이 모든 것이 메인 대화 컨텍스트 안에 있어야 할 이유가 없었다.
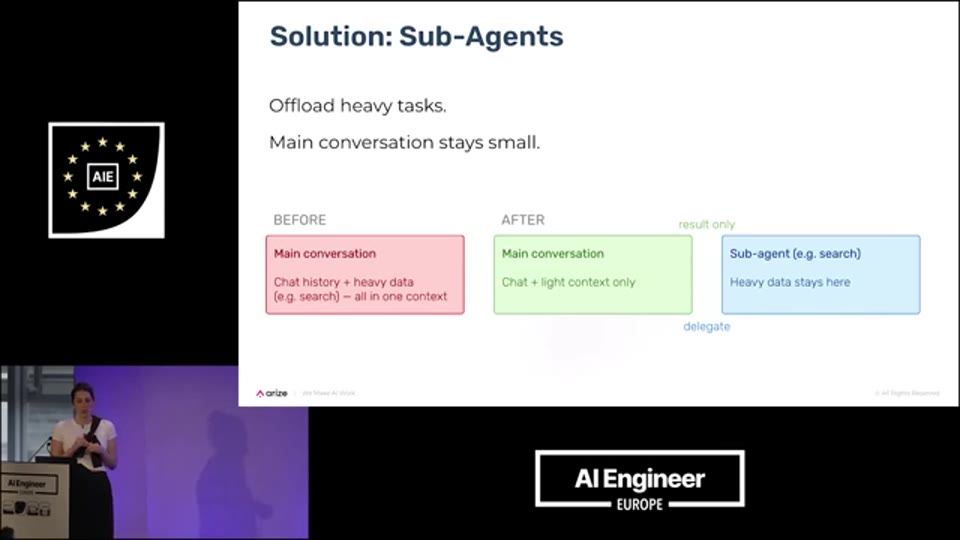
10:20 - 단일 에이전트 구조(이전) vs 메인 에이전트 + 서브에이전트 구조(이후) 비교 다이어그램
개편 이후 아키텍처는 명확하게 분리된다. 메인 에이전트는 대화 기록과 가벼운 컨텍스트만 유지하면서 무거운 데이터 집약 작업을 서브에이전트에게 위임한다. 서브에이전트는 대용량 데이터와 복잡한 중간 추론을 독립적으로 처리하고, 결과만 메인 에이전트에게 전달한다. 필요할 경우 메인 에이전트는 메모리 저장소에서 추가 컨텍스트를 조회할 수도 있다. 이 구조가 도입된 이후 팀은 데이터 집약적인 작업에 대해 반복적으로 서브에이전트 패턴을 적용해왔고, 이것이 현재 Arize의 표준 접근 방식이 되었다.
아직 해결 중인 과제들
몇 가지 중요한 문제는 여전히 진행 중이다. 첫째, 극도로 큰 컨텍스트는 아직도 시스템을 망가뜨린다. Arize의 고객들이 Alex를 통해 이해하려는 대상이 곧 AI 에이전트의 시스템 프롬프트, 사용자 메시지, 대화 기록 자체이기 때문에, 고객의 컨텍스트가 커질수록 Alex가 처리해야 할 컨텍스트도 함께 커지는 구조적인 문제가 있다. 팀은 계속해서 서브에이전트로 책임을 분산하는 패턴으로 이 문제에 대응하고 있다.
둘째, 진정한 의미의 장기 메모리(Long-term Memory)가 아직 없다. 현재 Alex의 메모리는 같은 세션 내에서의 컨텍스트 저장소 수준에 머물러 있다. 사용자가 새 대화를 시작하면 이전에 Alex와 논의한 내용을 참조할 수 없다. 강연 시점 기준으로 엔지니어링 팀이 이 기능을 활발히 개발하고 있으며, Sally-Ann Delucia는 이것이 사용자로부터 가장 많이 받는 불만 사항이라고 밝혔다.
셋째, 컨텍스트 선택 로직이 여전히 휴리스틱 수준이다. “앞 100자, 뒤 100자”라는 규칙은 단순하고 예측 가능하지만, 이것이 정말 최적의 컨텍스트를 유지하는지 보장하는 원칙적인 기준(principled context budget)이나 컨텍스트 품질 지표가 없다. 팀은 평가(evals)를 통해 간접적으로 이를 측정하고 있지만, 더 정교한 방법론을 연구 중이다. 흥미로운 점은 Claude Code의 소스 코드가 공개되었을 때 Arize 팀이 자신들과 유사한 트런케이션 및 압축 전략을 사용하고 있다는 사실을 발견했다는 것이다. 자신들만의 비밀 무기를 기대했다는 Sally-Ann Delucia의 솔직한 발언은 이 분야가 아직 모든 팀이 비슷한 고민을 하고 있는 탐색의 시대임을 보여준다.
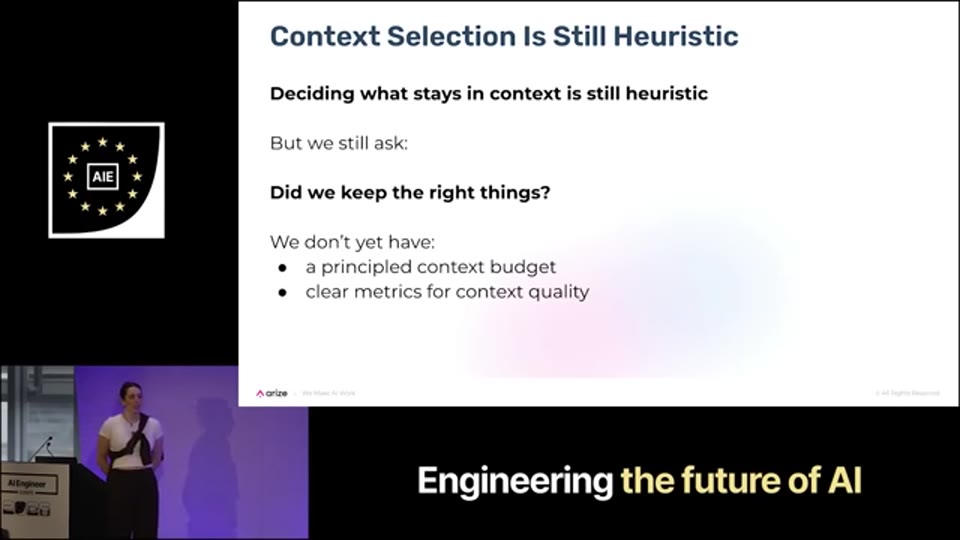
13:05 - 현재 컨텍스트 선택 휴리스틱(앞 100자, 뒤 100자) 및 향후 개선 방향 슬라이드
마무리: 에이전트는 프롬프트가 아닌 컨텍스트로 실패한다
이 강연이 남기는 핵심 메시지는 세 가지다. 컨텍스트 엔지니어링은 중요하다. 메모리 관리는 중요하다. 그리고 평가(evaluation)는 중요하다. Sally-Ann Delucia는 이 세 가지를 Arize가 자체 개발 경험과 고객 사례 양쪽에서 도출한 가장 확실한 교훈으로 제시했다.
특히 “에이전트는 프롬프트 때문에 실패하지 않는다. 컨텍스트 때문에 실패한다”는 결론은 AI 엔지니어링의 패러다임 전환을 한 문장으로 집약한다. 초기 LLM 애플리케이션 개발이 정교한 프롬프트 작성에 집중했다면, 이제 실제 프로덕션 에이전트의 성패를 가르는 전선은 컨텍스트를 얼마나 전략적으로 관리하는가로 이동했다. 그리고 이 문제는 순수한 엔지니어링 문제가 아니라, 사용자가 무엇을 필요로 하는지를 이해하는 제품과 UX의 문제이기도 하다는 관점은 이 강연이 기술 강연이면서 동시에 제품 철학 강연인 이유를 설명한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Hierarchical Memory: Context Management in Agents |
| 채널 | AI Engineer |
| 발표자 | Sally-Ann Delucia (Head of Product, Arize) |
| 리포트 작성 | 2026-05-11 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Does GenAI belong to data scientists — Phil Hetzel, Braintrust
- LLM Observability, Evaluation, Experimentation Platform — Dat Ngo, Arize
- Context Is the New Code — Patrick Debois, Tessl
- Ralph Wiggum (and why Claude Code’s implementation isn’t it) with Geoffrey Huntley and Dexter Horthy
- Shipping AI That Works - An Evaluation Framework for PMs – Aman Khan, Arize