How Transformers Finally Ate Vision
📺 원본 영상: How Transformers Finally Ate Vision – Isaac Robinson, Roboflow 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-09 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
컴퓨터 비전(Computer Vision) 분야는 오랫동안 합성곱 신경망(CNN, Convolutional Neural Network)이 지배해 왔다. 그러나 어느 순간부터 자연어 처리(NLP) 분야에서 혁명을 일으킨 트랜스포머(Transformer)가 비전 영역까지 침투하기 시작했고, 결국 CNN을 압도하게 되었다. Roboflow의 연구책임자 Isaac Robinson은 이 강연에서 왜 Vision Transformer(ViT)가 수많은 도전과 개선 시도에도 불구하고 최종 승자가 되었는지를 역사적 진화 과정을 통해 분석하고, 그 결과가 실제 배포 환경에 어떤 의미를 가지는지를 논한다.
CNN의 시대 — 귀납적 편향(Inductive Bias)이 만든 황금기
합성곱 신경망은 인간의 시각 체계에서 영감을 받은 강력한 귀납적 편향(Inductive Bias)을 내재하고 있다. 여기서 귀납적 편향이란 모델이 학습 전부터 갖고 있는 가정, 즉 “어떤 구조로 세상이 이루어져 있다”는 사전 지식을 의미한다. CNN의 경우 그 핵심은 바로 **이동 불변성(Translation Invariance)**이다. 이미지에 필터(filter)를 컨볼브(convolve)하면, 해당 특징이 이미지의 어느 위치에 나타나든 동일한 방식으로 활성화된다. 강연자의 표현을 빌리자면, “이미지 안에 있는 사람은 왼쪽 위에 있든 오른쪽 아래에 있든 사람이다.” 이처럼 직관적이고 강력한 가정 덕분에 CNN은 ResNet 등 계층적(hierarchical) 구조로 발전하며 오랫동안 컴퓨터 비전의 표준으로 자리 잡았다. 연산 복잡도 측면에서 CNN은 이미지 해상도 N에 대해 O(N²)의 스케일링을 보이는데, 이는 픽셀 수에 비례하는 매우 효율적인 구조다.
Vision Transformer의 등장 — 편향 없는 도전자
트랜스포머는 원래 집합(set)을 집합으로 변환하는 연산, 즉 토큰(token) 사이의 모든 쌍에 대해 어텐션(attention)을 계산하는 구조다. 여기에는 근본적으로 어떤 귀납적 편향도 없다. 인과 마스크(causal mask)를 추가하면 순차적 모델링이 되고, 패치 분할과 위치 인코딩(positional encoding)을 추가하면 Vision Transformer(ViT)가 된다.
ViT의 동작 방식은 다음과 같다. 입력 이미지를 16×16 픽셀 크기의 패치로 분할하고, 각 패치에 학습된 위치 인코딩을 더한 뒤 트랜스포머에 입력한다. 단순하다.
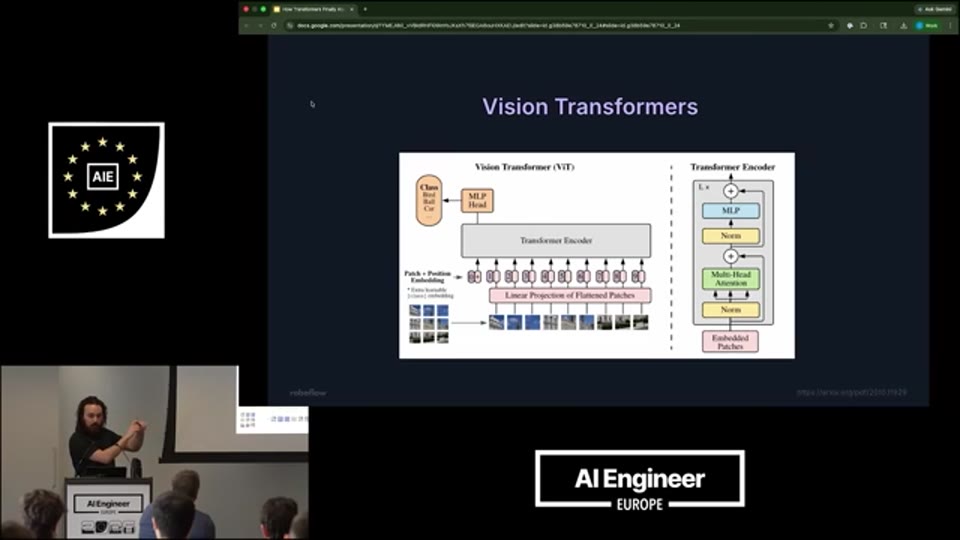
02:05 - Vision Transformer(ViT) 구조 설명 슬라이드 - 이미지를 16×16 패치로 분할하고 위치 인코딩을 적용하는 과정
그러나 연산 복잡도 측면에서는 CNN과 크게 다르다. 해상도 N의 이미지에서 한 변에 N/16개의 패치가 생성되므로 총 패치 수는 (N/16)²이 된다. 어텐션은 모든 패치 쌍에 대해 계산되므로 전체 연산량은 O(N⁴)에 비례한다. 또한 “이미지 왼쪽 위에 있는 객체”와 “오른쪽 아래에 있는 동일한 객체”는 서로 전혀 다른 활성화 패턴을 가질 수 있다. 귀납적 편향이 없기 때문이다.
이러한 단점에도 불구하고, 결론부터 말하면 ViT가 이겼다. 강연자는 이 반직관적인 결과를 설명하기 위해 “대규모 ViT 특화 사전 학습(massive ViT-specific pre-training)“과 “LLM 생태계에서 빌려온 인프라 가속”이라는 두 가지 핵심 요인을 제시한다.
더 나은 것을 찾아서 — Swin, ConvNext, Hiera의 도전
Swin Transformer — 창문 속의 어텐션
ViT가 공개된 직후, 연구자들은 당연히 “이게 최선일 리 없다”고 생각했다. 그 첫 번째 대응이 Swin Transformer다. Swin의 아이디어는 간단하다. 전체 이미지의 모든 패치에 대해 글로벌 어텐션(global attention)을 계산하는 대신, 국소적인 윈도우(window) 안에서만 어텐션을 수행하는 것이다. 그러나 윈도우만 고정하면 서로 다른 윈도우 안의 토큰들이 영원히 상호작용하지 못하는 문제가 생긴다. 이를 해결하기 위해 Swin은 레이어를 거칠수록 윈도우를 조금씩 이동(shift)시킨다. 홀수 레이어와 짝수 레이어가 서로 겹치는 위치의 윈도우를 사용하는 방식이다.
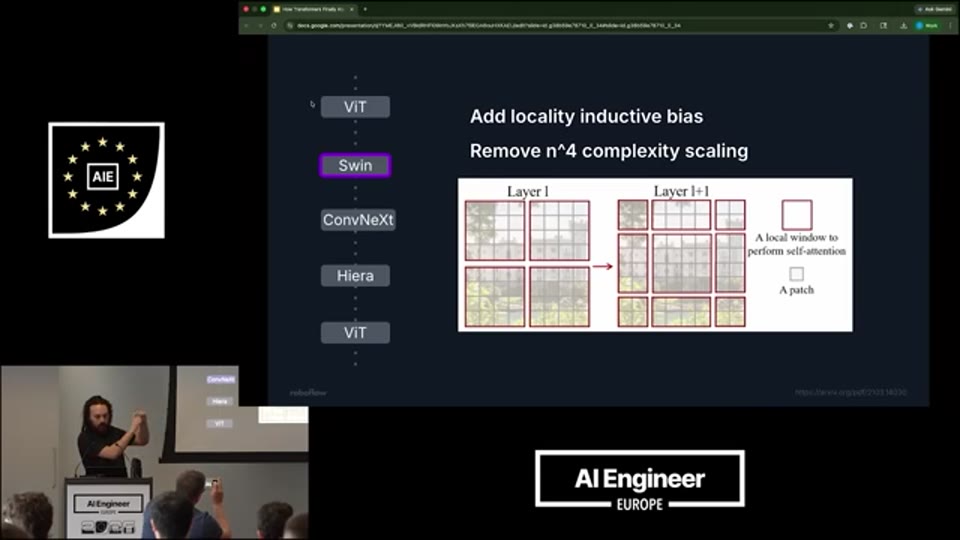
04:18 - Swin Transformer의 이동 윈도우(shifted window) 어텐션 구조 시각화
강연자는 이 구조가 CNN의 컨볼루션 연산과 매우 유사하다는 점을 지적한다. 국소 영역에 동일한 연산을 반복하고, 그 적용 위치가 겹치는 구조이기 때문이다. 이 덕분에 Swin은 윈도우 크기가 해상도에 독립적이라면 연산 복잡도를 O(N²)으로 낮출 수 있고, CNN처럼 지역성(locality)에 대한 귀납적 편향도 회복한다. 논리적으로 타당하고, 실제로도 잘 작동했다.
ConvNext — 트랜스포머의 교훈을 CNN에 이식하다
Swin과는 반대 방향의 시도도 나왔다. Meta의 ConvNext는 “트랜스포머와 비전 사이의 본질적 연관성은 없다. 그렇다면 ViT에서 얻은 모든 학습을 순수한 합성곱 네트워크에 이식하면 어떻게 될까?”라는 질문에서 출발했다. ConvNext는 ViT의 구조적 패턴을 그대로 차용한다. ViT가 ‘자기 어텐션(self-attention) → 피드포워드(feedforward)’ 블록을 반복하는 것처럼, ConvNext는 ‘공간 믹서로서의 컨볼루션(convolution) → 피드포워드’ 블록을 반복한다. 여기에 ViT에서 가져온 Layer Normalization 등의 기법을 추가하고, 기존 CNN의 계층적(hierarchical) 구조도 유지했다. 또한 패치파이(patchify) 연산을 4×4 패치 크기로 도입했다.
결과는 놀라웠다. 표준 ImageNet 벤치마크에서 ConvNext는 ViT와 Swin을 모두 앞질렀다. 마침내 상식적으로 납득이 가는 구조가 승리한 것처럼 보였다. 그러나 속도 측면에서는 그리 빠르지 않다는 한계가 있었다.
Hiera와 MAE — 귀납적 편향의 해부학
ConvNext의 성과를 보며 Meta의 연구팀은 또 다른 질문을 던졌다. “ConvNext가 성능이 좋은 이유는 무엇인가? 이 귀납적 편향들 중 실제로 중요한 것은 무엇인가?” 이 질문에 답하기 위해 그들은 **Hiera(Hierarchical Vision Encoder)**를 개발했다. 방법론은 정교하다. 귀납적 편향이 잘 갖춰진 트랜스포머 기반 모델에서 편향을 하나씩 제거한다. 편향을 제거할수록 특화된 하드웨어 장비가 필요 없어져 속도가 빨라진다. 그리고 제거된 편향은 사전 학습(pre-training)을 통해 모델이 스스로 학습하도록 한다.
이 사전 학습의 핵심 도구가 **MAE(Masked Autoencoder, 마스크 오토인코더)**다. 동작 방식은 NLP의 BERT와 유사하다. 이미지를 패치로 분할하고, 그 중 상당수를 무작위로 제거(마스킹)한 뒤, 모델에게 나머지 패치의 맥락만을 보고 제거된 패치를 재구성하라고 요구한다. 이 과정을 대규모로 수행하면, 모델은 이미지를 어떻게 이해해야 하는지에 대한 귀납적 편향을 스스로 학습하게 된다.
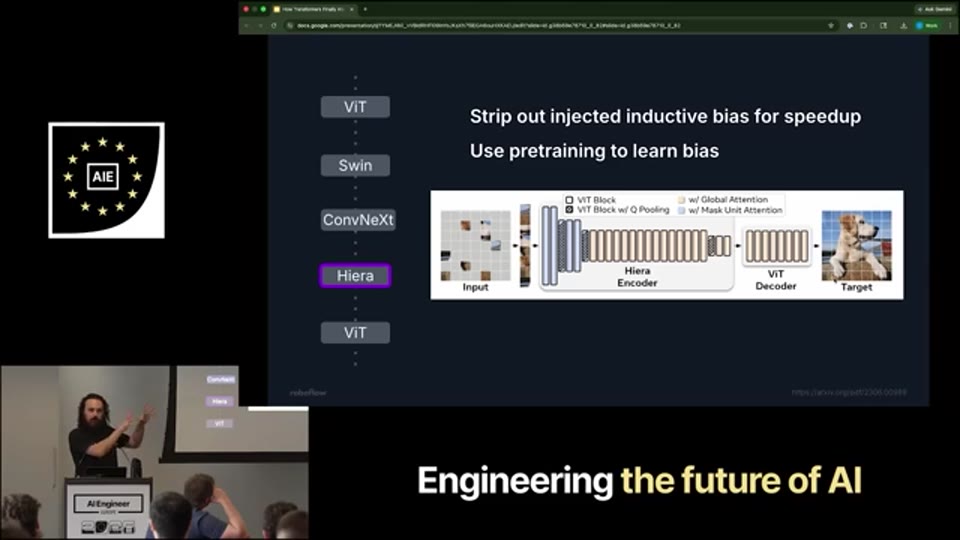
07:30 - MAE(Masked Autoencoder) 동작 원리 - 패치 마스킹 후 재구성 과정 다이어그램
강연자는 여기서 중요한 점을 하나 짚는다. MAE는 ViT에만 적용 가능한 기법이라는 것이다. 컨볼루션은 패치 전반에 걸쳐 불변하는 방식으로 작동하기 때문에, 패치를 제거(dropout)하는 것이 구조적으로 불가능하다. 즉, MAE는 ViT의 결함을 보완하는 ViT 전용 무기다. 이것이 ViT가 CNN에 대해 갖는 결정적 비대칭 우위다.
DINOv2와 자기지도 학습의 혁명
MAE의 원리를 극한까지 밀어붙인 것이 Meta의 DINOv2(그리고 후속 버전)다. 이 모델들은 ViT에 특화된 자기지도 학습(self-supervised learning) 기법을 대규모로 적용하여, 단순히 귀납적 편향을 복원하는 수준을 넘어선다. DINOv2로 사전 학습된 ViT의 특징 맵(feature map)을 PCA(주성분 분석)로 분해하면, 서로 다른 고양이의 발(paw)이 올바른 색으로 구분되고, 위성 이미지가 의미론적으로 유의미한 방식으로 분해된다. 모델이 감독 없이도 세상의 의미 구조를 내면화한 것이다.
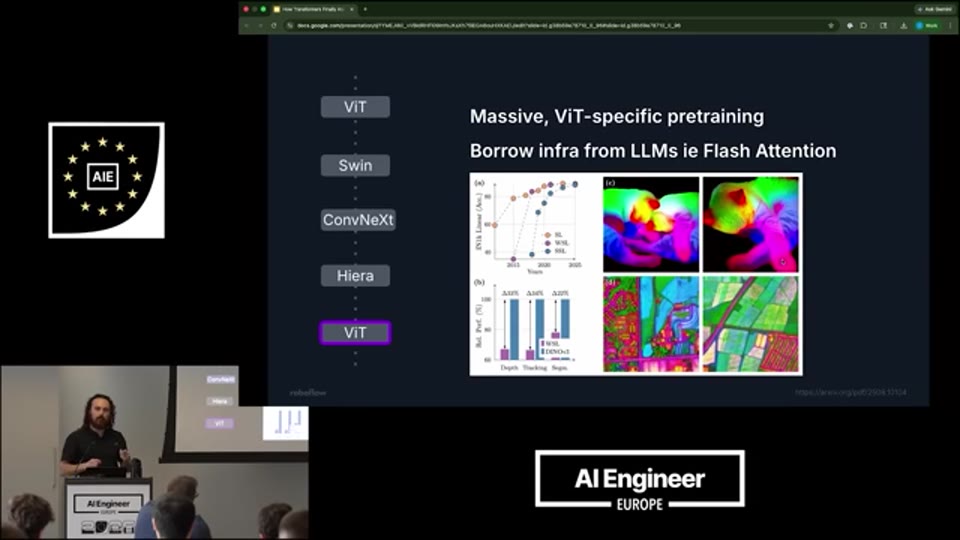
08:43 - DINOv2 사전 학습 ViT의 PCA 특징 맵 시각화 - 고양이 발 구분 및 위성 이미지 의미론적 분해
더욱 놀라운 것은 이 자기지도 학습의 성능이 완전 지도 학습(fully supervised learning)에 근접하고 있다는 점이다. 강연자는 선형 프로브(linear probe) 실험을 언급한다. 사전 학습된 특징을 완전히 동결(freeze)하고, 그 위에 선형 투영(linear projection) 레이어만 학습시키는 방식인데, 이 단순한 방법만으로도 완전 지도 학습의 최고 성능에 매우 근접한 결과를 얻었다는 것이다. 레이블 없이 학습한 표현이 레이블을 사용한 학습과 견줄 수 있게 된 것은 패러다임의 전환을 의미한다.
Flash Attention — 속도 문제의 최종 해결
이 시점까지도 ViT에는 O(N⁴) 스케일링이라는 근본적 속도 문제가 남아 있었다. Hiera는 같은 정확도에서 ViT 대비 속도 향상을 달성했음을 논문에서 강조했다. 그러나 강연자는 Hiera 논문에 흥미로운 각주가 있다고 지적한다. Hiera 팀은 속도 비교 실험에서 Flash Attention을 의도적으로 제외했다는 것이다.
Flash Attention은 LLM 연구 커뮤니티에서 개발된 어텐션 연산 최적화 기법으로, GPU 메모리 접근 패턴을 재구성하여 어텐션 계산을 극적으로 가속한다. LLM이 폭발적으로 성장하면서 이 인프라가 성숙해졌고, ViT는 동일한 트랜스포머 구조를 공유하기 때문에 이 모든 가속 기법을 그대로 차용할 수 있었다. Hiera의 비교 실험에 Flash Attention을 다시 추가하면, Hiera의 속도 우위는 사실상 사라진다. ViT는 여전히 O(N⁴)의 비효율적 구조이지만, Flash Attention이라는 강력한 무기 덕분에 그 비효율이 실용적으로 무의미해진 것이다.
강연자는 이것이 ViT의 승리를 결정지은 두 번째 핵심 요인이라고 강조한다. 강력한 ViT 전용 사전 학습 기법과, LLM 생태계에서 공짜로 얻어온 인프라 가속. 이 두 가지의 결합이 ViT를 넘어설 수 없게 만들었다.
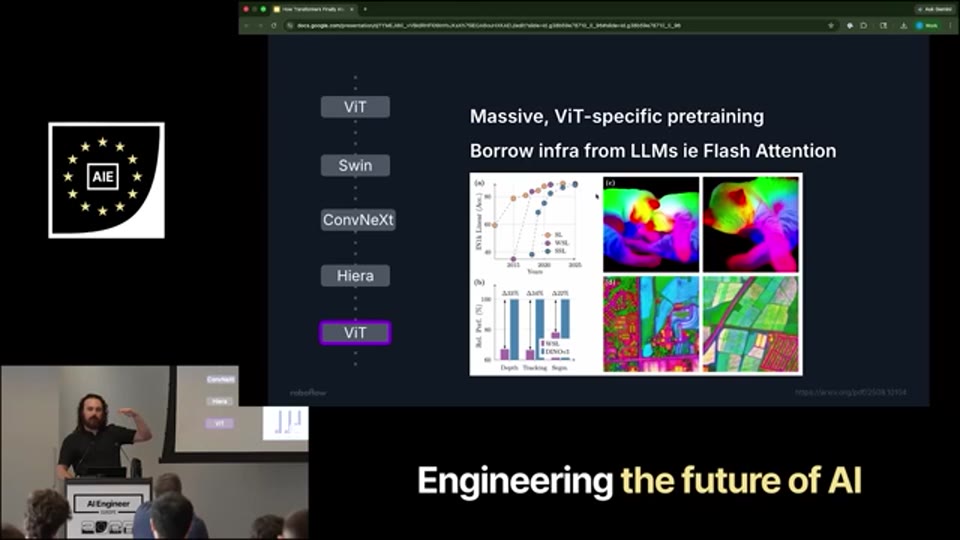
10:26 - 비전 백본 아키텍처 진화 타임라인 슬라이드 (ViT → Swin → ConvNext → Hiera → ViT)
실전 적용 — SAM 시리즈의 진화가 보여주는 패턴
강연자는 비전 분야의 가장 중요한 파운데이션 모델 시리즈 중 하나로 Meta의 **SAM(Segment Anything Model)**을 꼽는다. SAM 시리즈의 역사는 앞서 설명한 아키텍처 경쟁의 축소판이다.
초기 SAM은 MAE로 사전 학습된 ViT를 백본(backbone)으로 사용했다. 그러자 연구자들은 또 말했다. “이게 최선일 리 없다.” MobileSAM은 ViT 백본을 TinyViT라는 특화된 합성곱-트랜스포머 하이브리드 구조로 교체했다. 뒤이어 나온 SAM2는 다시 Hiera와 MAE 사전 학습의 조합으로 백본을 변경했다. 그리고 SAM3는 아키텍처 탐색을 포기했다. 강연자는 SAM3의 접근법을 이렇게 표현한다. “대규모 사전 학습된 백본을 그냥 집어넣었다. 그것이 최선이다.”
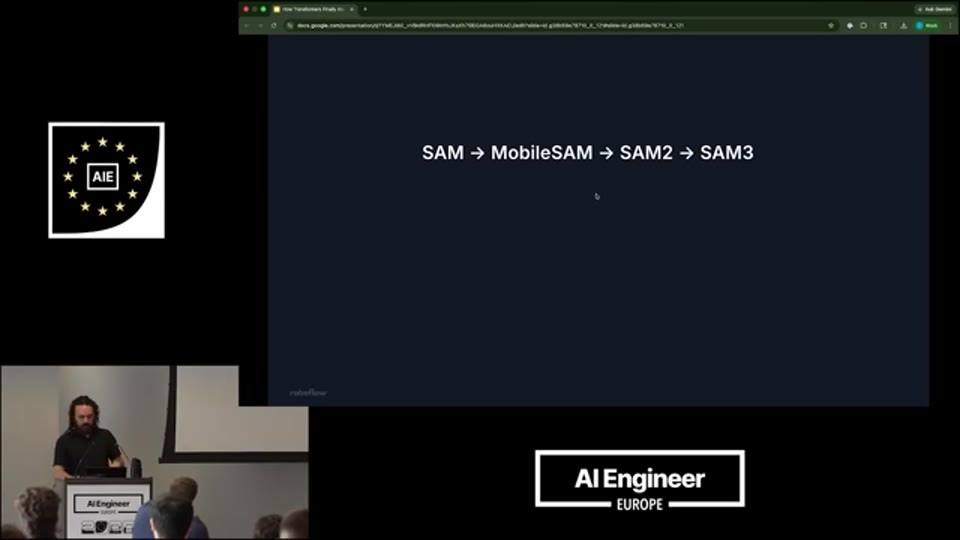
11:02 - SAM 시리즈 진화 과정 - SAM → MobileSAM → SAM2 → SAM3 백본 변화 비교
이 패턴은 앞서 본 전체 진화 과정과 정확히 일치한다. 더 나은 아키텍처를 찾으려는 시도 → 일시적 성공 → 결국 대규모 사전 학습된 단순한 ViT로의 회귀. 매번 더 복잡한 구조로 개선을 시도했지만, 결국 가장 잘 스케일링되는 단순한 것으로 돌아오는 것이 머신러닝의 반복되는 교훈이라는 것이다.
배포 유연성 문제 — Roboflow의 접근법
그러나 ViT의 승리에는 심각한 실용적 문제가 따른다. 대규모 사전 학습에 의존하는 파운데이션 모델은 배포 유연성(deployment flexibility)이 없다. SAM3는 강력하지만 8억(800M) 개의 파라미터를 가지며, T4 GPU에서 실행하는 데 300밀리초가 걸린다. 이는 비전 AI가 주로 활용되는 저전력 에지 디바이스(edge device)나 리소스 제약이 있는 환경에서는 사실상 사용 불가능한 수준이다.
Roboflow는 이 문제를 해결하기 위해 두 가지를 수행했다. 첫째, RF100-VL이라는 데이터셋을 도입하여, 파운데이션 모델이 객체 탐지라는 핵심 비전 태스크에서 다양한 다운스트림 태스크로 얼마나 잘 전이(transfer)되는지를 측정하는 벤치마크를 만들었다. 둘째, RF-DETR이라는 자체 모델을 개발했는데, 동일한 정확도에서 SAM3를 파인튜닝(fine-tuning)하는 것 대비 약 40배의 속도 향상을 달성했다. 또한 약 15배의 속도 향상을 허용할 경우 정확도는 오히려 의미 있게 향상된다는 결과도 제시했다.
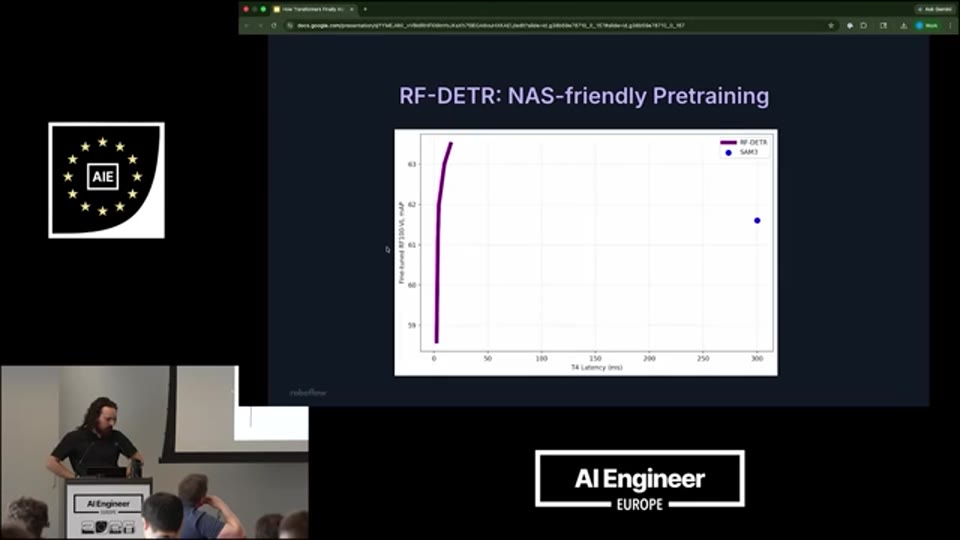
13:13 - RF100-VL 벤치마크 결과 및 SAM3 대비 RF-DETR 속도/정확도 비교 차트
Roboflow의 핵심 아이디어는 **신경망 아키텍처 탐색(Neural Architecture Search, NAS)**을 활용하여 동일한 파운데이션 모델을 기반으로, 타깃 데이터와 타깃 하드웨어에 맞게 조정 가능한 여러 가지 유연한 조절 장치(knob)를 도입하는 것이다. 이 조절 장치들은 기존 파운데이션 모델 인프라와 완전히 호환되는 드롭인(drop-in) 방식으로 설계되어, 하나의 파운데이션 모델에서 다양한 성능/속도 프로필을 가진 모델 패밀리 전체를 한 번에 생성할 수 있다. 강연자는 이것이 파운데이션 모델의 배포 유연성 부재 문제를 해결하는 방향이라고 주장한다.
마무리 — 핵심 정리
이 강연이 제시하는 전체 이야기의 핵심은 간결하다. “사전 학습이 귀납적 편향을 이긴다.” CNN이 가진 이동 불변성이라는 탁월한 귀납적 편향은, 충분히 큰 규모의 ViT 특화 사전 학습 앞에서 결국 무력화되었다. Swin, ConvNext, Hiera가 보여주듯이 더 나은 귀납적 편향을 설계하려는 노력은 계속 이루어졌지만, 매번 더 단순하고 스케일이 잘 되는 ViT가 이겼다.
이 결론은 머신러닝 역사에서 반복적으로 나타나는 패턴을 재확인한다. 영리하게 설계된 귀납적 편향보다, 충분한 데이터와 연산으로 스케일을 늘린 단순한 아키텍처가 궁극적으로 승리한다는 것이다. 그리고 이 패러다임 전환의 실용적 결과는, 고성능을 위해서는 막대한 사전 학습이 필수가 되어버렸고, 이는 배포 유연성이라는 새로운 병목을 만들어냈다는 것이다. Roboflow를 비롯한 다음 세대의 연구는 이 병목을 해결하는 것에 집중될 것이다.
강연자가 제시한 최종 공식을 정리하면 다음과 같다.
| 구성 요소 | 역할 |
|---|---|
| 대규모 ViT 전용 사전 학습 (MAE, DINOv2 등) | 귀납적 편향 부재를 보완하고 풍부한 피처 맵 제공 |
| LLM 생태계의 가속 인프라 (Flash Attention 등) | O(N⁴) 비효율을 실용적으로 무력화 |
| 사전 학습 호환 신경망 아키텍처 탐색 (NAS) | 배포 유연성 부재 문제를 해결하는 다음 단계 |
이 세 가지의 결합이 트랜스포머가 비전을 완전히 집어삼킨 방식이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | How Transformers Finally Ate Vision – Isaac Robinson, Roboflow |
| 채널 | AI Engineer |
| 강연자 | Isaac Robinson (Research Lead, Roboflow) |
| 리포트 작성 | 2026-05-09 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.