How to Talk to Statues — Joe Reeve, ElevenLabs
📺 원본 영상: How to talk to statues — Joe Reeve, ElevenLabs 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-02 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 ElevenLabs의 성장(Growth) 조직에서 일하는 Joe Reeve가 런던 영국 박물관에서 조각상과 실시간으로 대화할 수 있는 앱을 단 2시간 만에 제작하고 소셜 미디어에서 150만 뷰를 달성한 경험을 중심으로, 바이브 코딩(Vibe Coding)의 가능성, 음성 인터랙션 UX의 현재와 미래, 그리고 AI 기술이 문화·박물관 경험에 미치는 함의를 청중과 함께 탐구한 세션이다. 단순한 제품 데모를 넘어 “AI 시대에 무엇을 어떻게 만들어야 하는가”라는 보다 근본적인 질문을 다루고 있다는 점에서 엔지니어와 기획자 모두에게 가치 있는 강연이다.
Statue App: 조각상에게 목소리를 부여하다
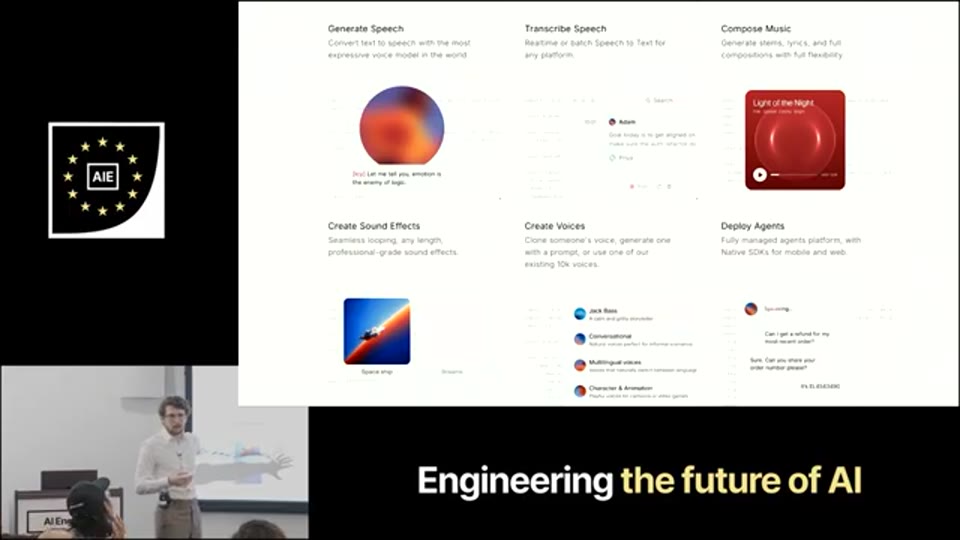
01:16 - ElevenLabs의 제품 라인업 소개 슬라이드 — 텍스트 투 스피치, 트랜스크립션, 음악 생성, 사운드 이펙트, 보이스 생성(Voice Design API), 에이전트 플랫폼 등 전체 제품군
Joe가 제작한 이 앱의 기본 아이디어는 간단하다. 사용자가 조각상 사진을 찍으면, 앱이 그 조각상의 정체를 파악하고 AI 목소리를 생성해 마치 조각상이 살아서 말을 거는 것처럼 대화를 나눌 수 있게 해준다. 그러나 이 단순한 경험의 이면에는 여러 AI 시스템이 유기적으로 결합된 파이프라인이 작동하고 있다.
💡 [영상 참조] 강연 초반, Joe는 실제로 영국 박물관에서 촬영한 시연 영상을 틀어 보여준다. “I am Pharaoh”, “I am Demeter”, “I am Han Sloan” 등 다양한 조각상들이 자신의 목소리로 말을 건네는 장면이 담겨 있다. 📺 원본 영상에서 확인하세요.
기술적 파이프라인은 다음 단계로 구성된다. 사용자가 사진을 찍으면, 먼저 OpenAI의 Deep Research 기능이 해당 조각상의 신원을 조사하고 역사적 배경 지식과 “이 조각상이 살아있다면 어떤 목소리를 가졌을까”에 대한 프롬프트를 생성한다. 이후 ElevenLabs의 Voice Design API가 그 설명을 바탕으로 적합한 목소리를 만들어내고, 마지막으로 ElevenLabs 에이전트가 생성되어 실제 통화 세션이 시작된다. 이 모든 과정이 30초 안에 완료된다는 것이 핵심이다.
02:28 - Statue App의 동작 원리 — 사진 촬영 → OpenAI Deep Research → Voice Design → 에이전트 생성 → 통화 시작의 전체 파이프라인 흐름
강연자가 특별히 강조한 것은 Voice Design API의 활용도인데, 그는 이것이 ElevenLabs에서 가장 저평가된 API 중 하나라고 설명했다. 목소리에 대한 텍스트 설명을 입력하면 그에 맞는 목소리를 생성해주는 이 기능은 해커톤이나 프로토타입 개발 시 특히 강력하다.
Joe는 이 앱을 일요일에 지루함을 느끼던 중 Cursor를 이용해 2시간 만에 만들었다고 밝혔다. 그리고 화요일에 시연 영상과 함께 전체 프롬프트(앱을 원샷으로 구현하는 데 사용한)를 ElevenLabs 블로그와 트위터에 공유했다. 첫날 5만 뷰, 이튿날 150만 뷰. 바이브 코딩의 파워를 다시 한 번 입증한 사례가 탄생한 순간이었다.
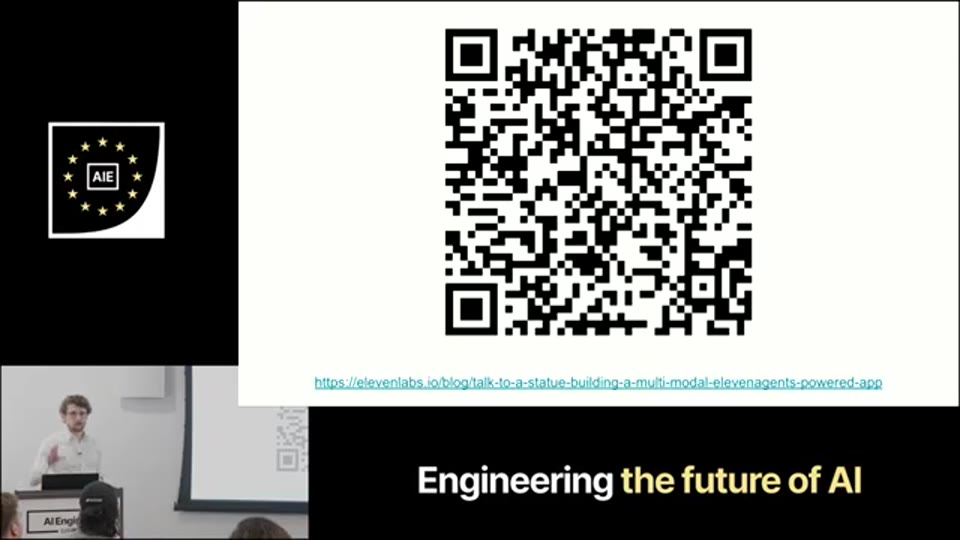
03:18 - 앱 제작 과정이 담긴 ElevenLabs 블로그 포스트 링크 QR 코드 — Cursor에서 원샷으로 구현한 전체 프롬프트 포함
바이럴 이후: 생각지도 못한 반응들
이 앱이 주목받은 것은 단순히 조회수 때문만이 아니었다. 세 곳의 박물관 또는 박물관 그룹 대표가 연락을 해왔고, TripAdvisor 경쟁사를 포함한 여러 기업들도 사업 협력 가능성을 타진해왔다. 가장 인상적인 에피소드는 한 기업 CEO가 Joe의 WhatsApp 번호를 어딘가에서 찾아내 직접 전화를 걸어왔다는 것이다. 그 CEO는 “우리 팀 10명이 1년 동안 이 문제를 풀려고 했는데, 당신은 어떻게 만들었냐”고 물었다고 한다.
이튿날 Joe는 “많은 흥미로운 분들께 연락을 받았다. 이것을 2시간 만에 바이브 코딩으로 만들었다는 점을 자랑이 아닌, ‘이게 얼마나 강력한가’라는 신호로 공유한다”는 내용을 리포스트했다. 이것이 오히려 두 번째 바이럴의 기폭제가 되었다. 이후 초상화 박물관부터 Bonhams, Christie’s 같은 경매 회사들까지, “우리가 판매하는 물건들과 대화할 수 있게 해달라”는 요청이 쇄도했다. 그리고 이 경험은 ElevenLabs 내에서 ‘11 Hacks’라는 이니셔티브로까지 이어졌다고 한다.
프로토타입에서 프로덕션으로: 진짜 어려운 것은 무엇인가
청중 중 한 명이 “프로토타입을 만드는 것은 쉬운데, 프로덕션으로 확장하는 게 어렵지 않냐”고 질문했다. Joe의 답변은 흥미롭게도 낙관적이었다. 그가 한 일의 본질은 기존의 잘 구축된 API들을 연결(stitching together)한 것이기 때문에, 스케일링 자체는 이미 그 API들이 감당하고 있다는 것이다. 에이전트 유지와 Voice Design은 모두 ElevenLabs의 API가 처리하므로 개인이 트래픽 급증에 대응할 필요가 없다.
그가 진짜 어렵다고 꼽은 것은 기술적인 부분이 아니었다. 바로 큐레이터와의 협업이었다. OpenAI Deep Research가 구글에서 긁어온 정보들은 결국 ‘이 조각상에 대해 누군가가 인터넷에 올린 내용’에 불과하다. 반면 진정한 가치는 박물관 큐레이터가 오랜 연구를 통해 구성한 내러티브, 즉 “이 조각상의 실제 이야기는 무엇인가”에 있다. 다행히 많은 박물관들이 자신들의 핵심 지적 자산을 데이터베이스 형태로 보유하고 있으며, Victoria & Albert Museum(V&A)처럼 공개 API를 제공하는 곳도 있다는 점은 긍정적인 신호다. 사용자 관리(Supabase 등 서드파티 활용)나 로그인·매직 링크 구현은 Cursor가 거의 원샷으로 처리할 수 있는 영역이라, 진짜 긴 테일 작업은 결국 사람과 사람 사이의 협업, 즉 콘텐츠 설계에 있다는 것이 Joe의 결론이었다.
음성 인터랙션 UX: 해결되지 않은 문제들
강연의 두 번째 큰 축은 음성 인터랙션 UX에 대한 심층 토론이었다. Joe와 청중은 현재 음성 인터페이스가 가진 여러 구조적 문제들을 솔직하게 짚어냈다.
10:23 - 음성 인터랙션의 현재 문제점 토론 시작 — 이진적 상호작용 모드, 병렬 UI+Voice 부재 등 핵심 UX 이슈 논의
이분법적 상호작용 모드의 한계. 현재의 음성 에이전트 경험은 “음성으로만 상호작용하거나, 아니면 다른 방식으로 상호작용하거나”의 이분법에 갇혀 있다. Joe는 Lovable 같은 코딩 에이전트를 예로 들며, 자신이 원하는 것은 코딩 에이전트에게 직접 말을 거는 게 아니라 그 앞단에 있는 ‘제품 매니저 에이전트’와 대화하고 싶다는 것이라고 설명했다. 즉, 직접 작업을 수행하는 에이전트와 사용자가 대화하는 에이전트가 분리되는 구조, ‘중간자’로서의 음성 인터페이스가 필요하다는 것이다. 이는 단순한 인터페이스 디자인의 문제가 아니라 에이전트 아키텍처의 재설계를 요구하는 통찰이다.
정보 밀도의 문제. 청중 중 한 명은 음성 출력의 정보 밀도가 텍스트나 시각 자료에 비해 현저히 낮다는 불만을 제기했다. 생각을 빠르게 말로 쏟아낼 수 있다는 점에서 음성 입력은 매력적이지만, 그 결과를 다시 음성으로만 받으면 만족스럽지 않다는 것이다. 이에 대해 Joe는 “나는 음성에서 정보보다 동반자감(companionship)을 얻는다”고 답했다. 음성으로 에이전트와 대화할 때 외로움이 덜 느껴지고 작업에 더 동기부여된다는 것이다. 즉, 음성은 정보 전달 매체이기 이전에 감정적·심리적 경험이라는 관점이다. 이 두 관점은 서로 충돌하지 않으며, 오히려 이상적인 인터페이스가 “음성 입력 + 정보 밀도 높은 시각적 출력”이라는 방향을 가리킨다.
방해하기와 ‘uh-huh’의 문제. Joe는 음성 에이전트와 대화할 때 사람들이 너무 예의 바르다는 점을 지적했다. 사람들은 에이전트가 말하는 도중 끊기를 꺼려하지만, 실제로 적극적으로 끊어야 경험이 훨씬 좋아진다는 것이다. 그러나 그보다 더 미묘한 문제가 있다. 인간 대화에서 우리는 상대방의 말을 자르지 않으면서도 “응”, “맞아”, “그래” 같은 추임새로 존재감을 표현한다. 음성 에이전트는 이 추임새를 새로운 발화로 인식하고 대화를 오해할 수 있다. 또한 텍스트에서의 ‘훑어보기(skim reading)‘에 해당하는 ‘훑어 듣기(skim listening)‘가 아직 존재하지 않는다는 점도 논의됐다. 낡은 iPod처럼 개념 단위로 앞뒤를 빠르게 탐색하는 기능, 에이전트가 자신이 하고 싶은 말이 있다는 것을 시각적 신호로 알려주는 기능 등 아직 구현되지 않은 인터랙션 패턴들이 많다.
에이전트 트랜스크립트의 가변성. Joe는 에이전트의 내부 구조에 대한 흥미로운 통찰을 공유했다. 에이전트는 본질적으로 ‘다음 메시지를 결정하는 로직 + 대화 트랜스크립트’로 구성된다. 그리고 이 트랜스크립트는 완전히 가변적이다. 현재 대부분의 에이전트 플랫폼은 전체 텍스트를 생성한 뒤 오디오로 변환하기 때문에, 사용자가 중간에 말을 걸어도 이미 생성된 전체 오디오가 재생된 뒤에야 반영된다. 그러나 오디오 재생 진행도(타임스탬프)를 알고 있다면, 사용자가 끊어 들어온 시점 이후의 LLM 출력을 트랜스크립트에서 삭제하는 방식으로 진정한 실시간 대화 중단을 구현할 수 있다는 것이다.
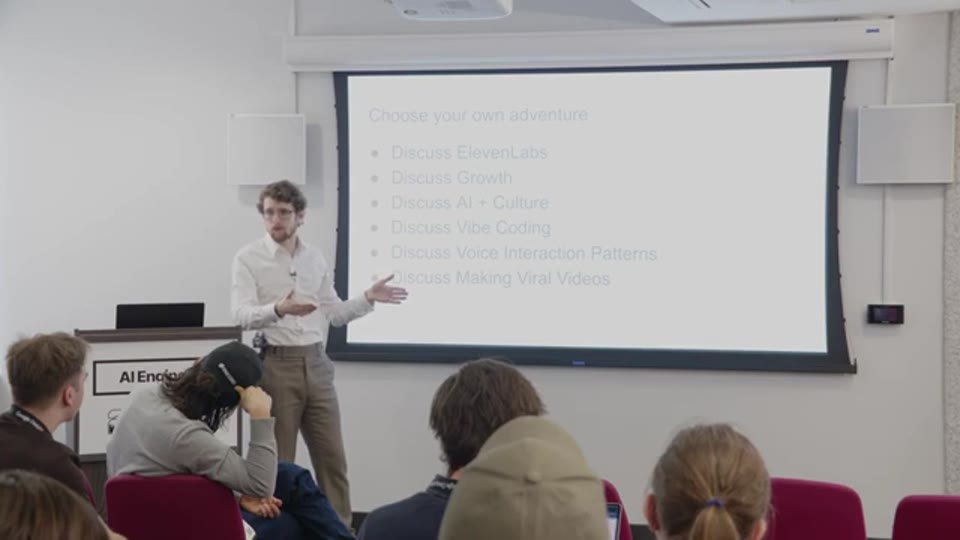
28:35 - 에이전트 트랜스크립트 실시간 편집 가능성 — 오디오 재생 타임스탬프 기반으로 LLM 출력을 소급 수정하는 아이디어
바이브 코딩의 현재와 소비자 주류화
Joe는 현재 바이브 코딩이 여전히 개발자와 얼리어답터의 영역에 머물러 있다고 진단한다. Lovable 같은 서비스도 결국은 B2B SaaS 앱을 만들고 싶은 사람들을 주 타겟으로 한다는 것이다. 진정한 소비자 바이브 코딩의 주류화는 아직 오지 않았다.
그가 소비자 주류화의 가장 유망한 선례로 꼽은 것은 Facebook Instant Games API다. 더 이상 존재하지 않는 이 플랫폼은 Messenger 내에서 소셜 그래프와 연동된 게임을 즐길 수 있게 해줬다. Joe는 직접 £15짜리 Fruit Ninja 클론 게임을 구매해 Facebook Instant Games API(사용자 정보 조회, 친구 목록, 리더보드, 광고)를 연동했고, 다음 날 아침 일어나보니 베트남에서만 1500만 명의 사용자가 생겨있었다는 경험을 공유했다. 이처럼 소셜 그래프와 즉각적인 공유 메커니즘이 결합될 때 폭발적인 소비자 확산이 일어난다. “바이브 코딩의 Instagram 필터 순간, 혹은 TikTok 순간”이 언제 찾아올지는 모르지만, 그 패턴은 개인 창작물이 소셜 그래프를 통해 자연스럽게 확산되는 구조일 것이라는 것이 Joe의 예측이다.
바이브 코딩 이벤트에 대한 그의 묘사는 인상적이다. 그곳에는 코드를 한 번도 써본 적 없는 사람들이 온다. 심지어 “앱은 사람이 만드는 건가요? 그냥 앱스토어에 원래 있던 줄 알았어요”라고 말하는 사람도 있다. 이들이 기존 소프트웨어 엔지니어라면 “이건 드롭다운 메뉴, 이건 아코디언”이라고 정의하고 시작할 것들을 아무 제약 없이 “이게 있고 저게 있고 이것도 원해요”라고 말하면, LLM이 그냥 만들어버린다. 이 과정에서 완전히 새로운 창의적 결과물이 나온다는 것이다.
AI와 문화: 사물에게 어떤 목소리를 줄 것인가
이 강연에서 가장 철학적인 부분은 물리적 사물, 특히 문화재에 AI 목소리를 부여할 때의 함의에 대한 논의였다.
Joe는 전 영국 박물관 남북아메리카 담당 총괄이자 현재 Sainsbury Centre 소장인 Jago라는 인물과의 대화를 공유했다. Jago는 “무생물에게 어떤 목소리가 어울리는가”를 학문적으로 연구하고 있다. 중국 산에서 채굴된 돌이 베트남으로 옮겨져 조각되고, 이후 200년간 영국 박물관에 전시된 작품이라면, 그 목소리는 중국식이어야 할까, 베트남식이어야 할까, 아니면 수백만 명의 관광객과 함께한 세월로 인해 영국식이 어울릴까? 이 질문은 단순한 UX 디자인의 문제가 아니라 정체성, 문화, 역사에 대한 깊은 물음이다.
같은 맥락에서 Joe는 엘리베이터 음성에 대한 예시를 들었다. 현재 엘리베이터 안내 음성은 엘리베이터라는 공간과 어딘가 불일치하는 경우가 많다. 앞으로 우리가 엘리베이터에 타서 “X층으로 가주세요”라고 말하게 될 가능성이 높아지면, 그 엘리베이터의 목소리는 어떠해야 하는가라는 질문이 점점 더 중요해진다.
박물관에 대한 현실적인 관찰도 주목할 만하다. 과학 박물관 공동 CEO와의 대화에서, 그들 역시 AI 경험을 어떻게 통합해야 하는지 답을 모른다는 것을 솔직히 인정했다고 한다. 기존의 시도들, 예컨대 큰 태블릿 화면을 배치해 상호작용을 유도하는 방식은 때로 “기술을 전시물에 갖다 붙인 것”처럼 느껴진다는 것이다. 이 문제를 해결하기 위해 Joe 팀이 실험하고 있는 것은 기술을 숨기는 것이다. 스피커, 마이크, 전화기를 내부에 내장한 실제 조각상을 의뢰 제작해서 스마트폰이라는 매개 없이 조각상 자체와 직접 대화할 수 있게 하는 것이다. 또한 AI Engineer 컨퍼런스 현장에는 K6 빨간 런던 전화 부스가 설치되어 있으며, 수화기를 들면 Sir Michael Caine 에이전트와 대화할 수 있다고 소개되었다.
바이럴 영상 제작: 실전 팁
강연 후반부에서 Joe는 어떻게 영상을 제작해 바이럴시켰는지에 대한 구체적인 팁을 공유했다.
핵심은 80/20 원칙의 적용이다. Statue App 영상 수준의 편집 퀄리티는 실제로 모바일로 20~25분 작업하면 달성할 수 있다. 그 이상의 퀄리티를 추구하면 데스크톱 편집 툴로 넘어가야 하는데, 이는 체감 난이도가 3배 이상 상승하고 구독료도 훨씬 비싸진다. 따라서 처음에는 모바일 편집으로 충분히 출발할 수 있다.
조회수 분석을 통해 그가 발견한 것은, 영상의 중간 시청 시간(median view time)이 6~12초라는 점이다. 대부분의 시청자는 이 시점 이전에 떠나버린다. 따라서 훅(hook)을 최전방에 배치하는 것이 가장 중요한 전략이다. 자막(captions) 추가도 큰 효과가 있으며, 음악은 많은 이들이 과소평가하는 요소다. ElevenLabs의 음악 생성 기능을 활용하면 영상을 먼저 만든 후 다양한 장르의 음악을 실험하거나, 반대로 원하는 바이브에 맞는 음악을 먼저 생성하고 그에 맞는 내레이션을 구성할 수도 있다. Statue App의 경우, 영국 박물관이라는 배경에 어울리는 제국적이고 장엄한 느낌의 음악을 먼저 선택한 뒤 영상을 제작했다. 오디오 품질을 위해 DJI의 블루투스 라펠 마이크(약 £200)를 사용했다는 점도 참고할 만하다.
마무리 / 핵심 정리
이 강연이 전하는 메시지는 단순히 “빠르게 만들어서 공유하라”는 실용적 조언을 넘어선다. Joe Reeve의 Statue App 사례는 바이브 코딩이 단순한 개발 기법이 아니라, 기술과 창의성 사이의 마찰을 제거하는 새로운 문화적 현상임을 보여준다. 10명의 팀이 1년간 풀지 못한 문제를, 한 사람이 2시간 만에 풀 수 있게 된 것은 단순히 더 나은 도구가 생겼기 때문이 아니다. 기존의 잘 만들어진 API들을 이야기(story)로 엮어내는 능력, 즉 “좋은 글루 코드와 좋은 내러티브”가 결합될 때 비로소 임팩트가 생긴다는 것이 그의 핵심 통찰이다.
음성 인터랙션 UX에 대한 논의는 아직 많은 문제가 미해결 상태라는 솔직한 진단을 담고 있다. 그러나 그 해결 방향은 분명해 보인다. 음성 입력의 자연스러움과 시각적 출력의 정보 밀도를 결합한 멀티모달 인터페이스, 끊기(interrupt)와 추임새를 자연스럽게 허용하는 대화 아키텍처, 에이전트 트랜스크립트의 실시간 편집 가능성 등이 그것이다. 이 분야는 아직 누군가가 결정적인 해법을 내놓지 못한, 즉 기회가 가득한 영역이다.
마지막으로 AI가 문화재에 목소리를 부여하는 것의 함의는, 기술이 단순한 편의를 넘어 우리가 역사와 사물을 인식하는 방식 자체를 바꿀 수 있다는 가능성을 시사한다. “이 조각상은 어떤 목소리를 가져야 하는가”라는 질문은, 어쩌면 “우리는 역사를 어떻게 경험해야 하는가”라는 더 큰 질문의 시작점일지도 모른다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | How to talk to statues — Joe Reeve, ElevenLabs |
| 채널 | AI Engineer |
| 강연자 | Joe Reeve (ElevenLabs, Growth 조직) |
| 리포트 작성 | 2026-06-02 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.