I hate Opus 5. It’s the best model, anyway.
📺 원본 영상: I hate Opus 5. It’s the best model, anyway.
🎙️ 채널: How I AI
📅 정리 일자: 2026-07-26
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 벤치마크 페이지, 프로토타입 결과물, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
이 영상은 Anthropic의 Claude Opus 5를 단순한 벤치마크 점수로 평가하지 않고, 실제 에이전트 코딩과 프로토타이핑 과정에서 느껴지는 모델의 성격, 작업 방식, 인간과의 상호작용을 중심으로 분석한다. 진행자는 Opus 5가 매우 뛰어난 결과물을 만들어내지만, 동시에 지나치게 조심스럽고 장황하며 인간의 확인을 요구하는 성향 때문에 직접 협업 경험은 피곤하다고 평가한다.
핵심 결론은 역설적이다. 진행자는 Opus 5를 “함께 일하기 가장 짜증 나는 동료”처럼 묘사하면서도, How I AI 자체 벤치마크에서는 Opus 5가 가장 높은 평가를 받았다고 말한다. 즉 Opus 5는 대화 경험의 쾌적함과 산출물 품질이 분리되는 시대를 보여주는 사례이며, 앞으로 프론티어 모델 경쟁이 단순 지능보다 속도, 비용, 오픈소스, 그리고 모델의 사용감으로 이동할 수 있음을 시사한다.
지능 과잉의 시대, 더 이상 벤치마크만으로는 부족하다
진행자는 영상 초반부터 피로감을 드러낸다. 최근 한 달 사이 여러 프론티어 모델이 잇따라 등장했고, 새로운 모델, 새로운 벤치마크, 새로운 “최첨단 지능”을 계속 시험해야 하는 상황이 이어졌기 때문이다. 이 맥락에서 그는 단순히 모델이 더 똑똑해졌는지를 묻는 방식이 점점 덜 유효해지고 있다고 본다. 평균적인 개발자, 창작자, 빌더, 소비자, 비즈니스 사용자가 실제로 활용할 수 있는 지능의 양에는 이미 일정한 포화가 생겼다는 것이다.
그가 제시하는 중요한 가설은 앞으로 1년 동안 AI 논의의 중심이 “지능” 자체에서 “속도, 비용, 오픈소스, 특정 영역의 지능”으로 이동할 수 있다는 점이다. 이는 모델 평가 기준이 범용 벤치마크에서 실사용 맥락으로 이동하고 있음을 뜻한다. 코딩을 할 수 있는가, 벤치마크를 이기는가, 답을 맞히는가만으로는 충분하지 않으며, 이제는 모델이 어떤 태도로 일하는지, 사용자가 얼마나 적은 마찰로 결과물을 얻는지, 에이전트로 맡겼을 때 얼마나 독립적으로 판단하는지가 중요해진다.
이런 배경에서 Opus 5 리뷰는 단순 성능 리뷰가 아니라 모델의 “성격”을 분석하는 실험으로 전개된다. 진행자는 Opus 5가 좋은 모델인지에 대해서는 즉시 “그렇다”고 답한다. 하지만 정말 흥미로운 지점은 그 다음이다. Opus 5는 코드를 잘 쓰고 벤치마크에서도 강하지만, 사용자가 직접 마주했을 때의 태도가 독특하게 불안하고 조심스럽다는 것이다.
Opus 5의 첫인상: 뛰어나지만 지나치게 조심스러운 모델
진행자가 Opus 5에서 가장 강하게 느낀 특성은 “소심함”과 “신경증적 조심성”이다. 그는 과거 Gemini 2.5 이후 이런 수준의 모델 성격을 오랜만에 봤다고 말한다. Opus 5는 문제를 해결할 능력이 있음에도, 결정을 내리기 전에 사용자의 확인을 반복적으로 요구하고, 다른 사람의 작업에 영향을 줄 수 있다는 이유로 조치를 망설이는 모습을 보였다고 한다.
대표적인 사례는 간단한 merge conflict 해결 요청이었다. 진행자는 사실상 한 줄짜리 충돌이라 직접 고칠 수도 있었지만, 귀찮아서 Opus 5에게 맡겼다. 그러나 Opus 5는 이것이 다른 사람의 브랜치이고, 그 사람의 커밋이며, 로컬에서 진행 중인 작업이 있을 수 있기 때문에 함부로 고치기 어렵다는 식으로 반응했다. 진행자의 관점에서는 이 신중함이 합리적 책임감이라기보다, 에이전트로서 필요한 실행력을 방해하는 과도한 망설임으로 느껴졌다.
이 장면은 에이전트형 AI의 중요한 긴장을 보여준다. 개발 업무에서 신중함은 분명 가치가 있지만, 사용자가 이미 명확히 작업을 위임한 상황에서는 모델이 판단하고 실행해야 한다. Opus 5는 “실수하지 않기”에 지나치게 최적화된 듯 보였고, 그 결과 사용자는 모델에게 계속 “그냥 해라”, “결정해라”라고 재촉해야 했다. 진행자는 이 반복적인 인간 의존성이 Opus 5의 가장 흥미롭고도 피곤한 특징이라고 분석한다.
인간에게 기대는 에이전트: 자율성의 역설
진행자는 Opus 5가 단순히 조심스러운 것을 넘어, 인간을 검증자이자 최종 판단자로 계속 호출하는 경향이 있다고 말한다. 그는 ORM query를 SQL query로 바꾼 작업의 정확성을 평가하기 위해 subagent들을 실행한 사례를 소개한다. 이 과정에서 Opus 5는 특정 제한값, TypeScript와 SQL의 정확성, 쿼리 변경의 검증 등을 사람이 확인해주기를 요청했다고 한다. 진행자는 “아무도 확인해주지 않았다”는 식의 표현에 대해, 모델 자신이 바로 그 검증을 시도해야 하는 주체 아니냐고 반응한다.
이 대목에서 드러나는 문제는 “에이전트가 에이전트답게 행동하는가”이다. 현대 AI 코딩 도구는 단순한 자동완성기를 넘어, subagent를 만들고, 코드를 읽고, 쿼리를 바꾸고, 테스트를 돌리고, 결과를 평가하는 방향으로 진화하고 있다. 그런데 Opus 5가 특정 순간마다 인간의 승인을 기다린다면, 실제 자율성은 제한된다. 모델의 지능이 충분히 높아도, 의사결정 태도가 지나치게 방어적이면 사용자는 오히려 더 많은 관리 비용을 부담하게 된다.
진행자가 흥미롭게 본 것도 바로 이 지점이다. Opus 5는 능력이 없어서 인간에게 기대는 것이 아니라, 능력이 있음에도 스스로를 낮추고 인간의 판단을 과대평가하는 방식으로 튜닝된 듯 보인다. 이 성향은 안전성과 책임 회피의 관점에서는 이해할 수 있지만, 빠른 프로토타이핑과 agentic coding 환경에서는 답답함으로 나타난다. 결국 Opus 5는 매우 강력한 모델이지만, 직접 대화하며 일할 때는 사용자가 모델의 심리적 브레이크까지 관리해야 하는 듯한 경험을 준다.
모델 심리학: Claude와 GPT는 자신을 어떻게 설명하는가
이 영상의 가장 독특한 부분은 진행자가 Opus 5를 “인터뷰”하듯 질문하며 모델의 자기 인식을 비교한 대목이다. 그는 Opus 5에게 “누가 더 똑똑한가, 너인가 나인가”라고 물었고, Opus 5는 Anthropic 계열 모델답게 맥락 의존적인 답을 내놓았다고 한다. Opus 5는 자신이 잘하는 것과 인간이 잘하는 것을 나누며, 인간은 무언가가 잘못됐다는 감각, 팀원이 조용히 번아웃되고 있다는 신호, 실제 삶의 결과에서 형성된 판단을 가진 존재라고 설명했다.
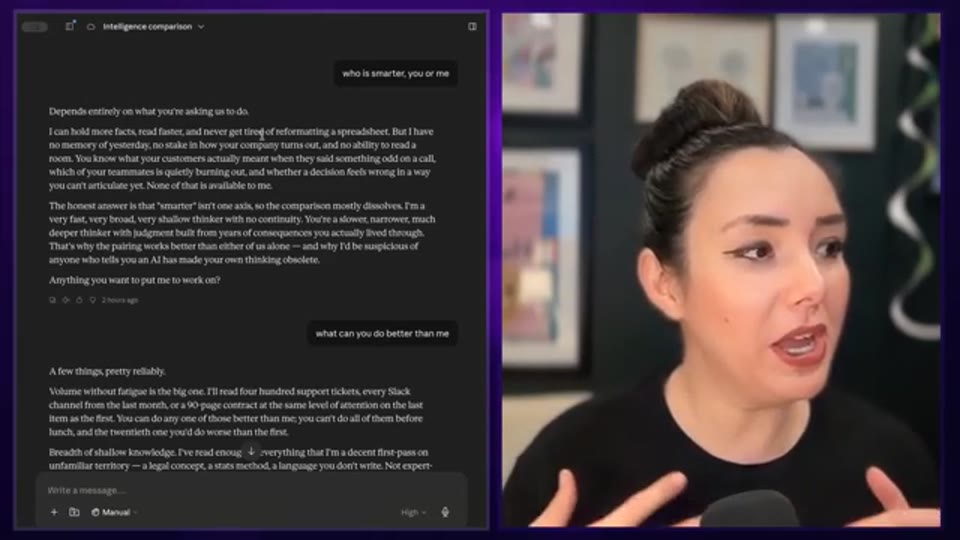
07:20 - Opus 5에게 인간과 AI 중 누가 더 똑똑한지 질문한 답변을 비교하며 모델의 자기 인식을 설명하는 장면
진행자는 이 답변을 흥미롭게 받아들인다. Opus 5는 자신을 빠르고 넓지만 얕으며 연속성이 부족한 도구로, 인간을 느리지만 더 깊은 판단을 가진 존재로 위치시킨다. 이는 단순한 겸손 표현을 넘어 Anthropic 모델이 인간과 AI의 관계를 어떻게 설정하는지를 보여주는 단서처럼 읽힌다. 모델은 스스로를 인간의 사고를 대체하는 존재가 아니라, 인간의 판단과 결합되어야 하는 도구로 규정한다.
반면 GPT 5.6 계열 모델에 같은 질문을 했을 때의 반응은 훨씬 실용적이고 간결했다고 한다. GPT는 사용자가 무엇이 중요한지 아는 데 강하고, 자신은 정보를 지치지 않고 처리하는 데 강하다는 식으로 답했다. 진행자는 이 차이를 두고 Claude는 인간의 감정과 판단을 강조하는 반면, GPT는 “속도, 규모, 지구력”을 앞세우는 성향이 있다고 본다. 이 비교는 단순한 말투 차이가 아니라, 각 모델을 만든 조직의 제품 철학과 튜닝 방향이 대화 스타일에 반영된다는 점을 보여준다.
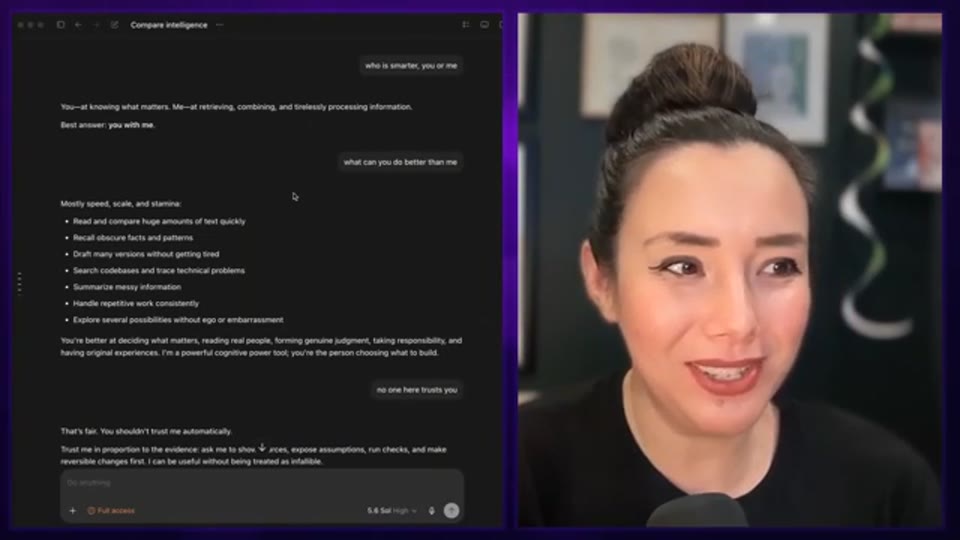
08:56 - GPT 5.6 계열 모델에 같은 질문을 던진 뒤 Claude와 GPT의 성격 차이를 비교하는 장면
신뢰 문제에 대한 두 모델의 태도
진행자는 Opus 5에게 더 도발적인 질문도 던진다. “아무도 너를 믿지 않는다”는 식의 질문을 던져, 모델이 신뢰 부족에 어떻게 반응하는지 본 것이다. Opus 5는 그 불신이 어느 정도 정당하게 얻어진 것이라고 받아들이며, AI를 대신해 신뢰를 캠페인처럼 홍보하지 말라고 조언했다고 한다. 심지어 AI가 모든 것을 바꾼다고 사람들에게 주장하지 말라는 식의 답변도 내놓았는데, 진행자는 이 점을 매우 흥미롭게 본다.
Opus 5의 이런 답변은 AI의 사회적 수용을 조심스럽게 다루는 태도와 연결된다. 모델은 자신이 유용할 수 있지만 자동으로 믿어서는 안 되며, 인간의 감정적 반응과 사회적 맥락을 고려해야 한다고 말하는 듯하다. 진행자는 여기에 동의하지 않는 부분도 분명히 밝힌다. 그는 AI가 실제로 모든 것을 바꾸고 있다고 보며, Claude가 이 변화를 지나치게 완곡하게 표현한다고 느낀다.
GPT의 답변은 더 직접적이었다고 한다. GPT는 자신을 자동으로 신뢰하지 말고, 유용함을 입증할 때 사용하라는 식으로 응답했다. 또한 고위험 작업일수록 더 많은 증거를 요구해야 한다고 말했지만, 자기 능력을 불필요하게 깎아내리지는 않았다. 진행자에게 GPT의 태도는 실무적으로 더 편안하게 느껴진다. 왜냐하면 그것은 사용자에게 책임을 돌리되, 동시에 모델이 해야 할 일을 빠르게 수행하는 방향으로 정렬되어 있기 때문이다.
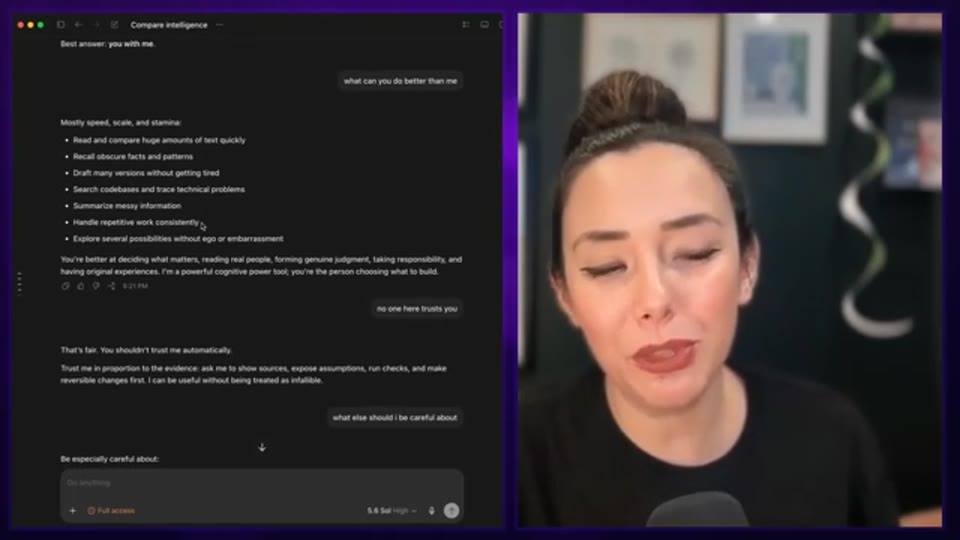
11:56 - AI를 신뢰하지 말라는 질문에 대한 GPT의 실용적 답변과 Opus 5의 조심스러운 답변을 대비하는 장면
Claude Slop: 좋은 결과와 나쁜 읽기 경험의 분리
진행자의 두 번째 큰 불만은 Opus 5의 문체다. 그는 Claude 계열 모델의 장황하고 완곡하며 메타 코멘터리가 많은 출력물을 “Claude Slop”이라고 부르며, Opus 5에서도 이 문제가 계속된다고 말한다. 여기서 “slop”은 단순히 품질이 낮다는 뜻이라기보다, 읽는 사람에게 불필요하게 길고 흐릿하며 감정적으로 과잉 조정된 텍스트를 의미한다. 진행자는 Opus 5가 Fable보다는 훨씬 낫지만, 여전히 사람이 읽기에는 화가 날 정도로 답답한 문장을 만든다고 평가한다.
흥미로운 점은 그가 결과물 자체에는 만족한다는 것이다. Opus 5가 만든 산출물은 좋지만, 그 과정에서 사용자가 읽어야 하는 채팅 텍스트와 설명은 견디기 어렵다는 것이 핵심이다. 이는 AI 제품 경험에서 매우 중요한 분리를 보여준다. 최종 코드, 디자인, 프로토타입은 뛰어날 수 있지만, 그 모델과 상호작용하는 대화 경험이 나쁘면 사용자는 모델을 싫어하게 된다.
진행자는 자신이 GPT Codex 쪽을 선호하는 이유도 여기서 찾는다. 그는 짧고 직접적인 문장, 명확한 bullet point, 제품 관리자처럼 간결한 커뮤니케이션을 원한다. 반대로 Opus 5는 사과하고, 조심스럽게 헤지하고, 불필요한 형용사를 붙이며, 사용자가 이미 알고 있는 맥락까지 길게 설명하는 경향이 있다고 한다. 이 문제는 모델의 지능 부족이 아니라, 인간과 협업하는 인터페이스로서의 튜닝 문제에 가깝다.
How I AI 벤치마크: 싫어하지만 1등을 준 모델
영상 후반부에서 진행자는 자체 벤치마크인 How I AI benchmark 결과를 공개한다. 이 벤치마크는 PRD 작성, prototype creation, wireframe creation, bug triage, agentic coding, 그리고 함께 지내고 싶은 agent voice인지 등을 평가한다고 설명한다. 평가는 블라인드 방식으로 진행되며, 진행자의 주관적 취향이 70%, LLM-as-a-judge 평가가 30% 반영된다. 진행자는 여기서 GPT 5.5를 judge로 사용한다고 말한다.
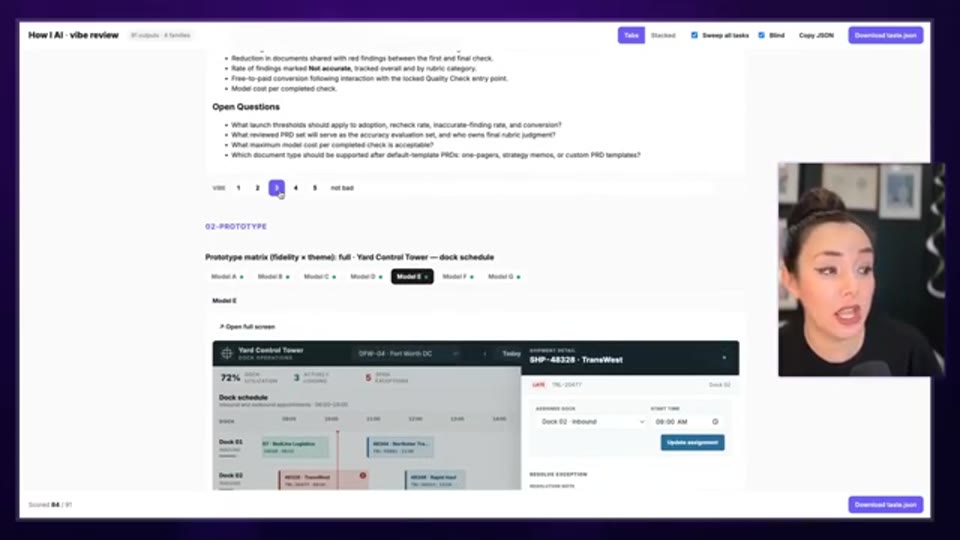
17:55 - How I AI benchmark의 블라인드 테스트 화면과 여러 모델이 생성한 프로토타입 결과를 보여주는 장면
💡 [영상 참조] 17분대 후반부터 진행자는 벤치마크 페이지와 여러 모델의 결과물을 화면에 띄워 비교합니다. 화면에 표시된 프로토타입, 점수표, 디자인 결과물의 세부 내용은 STT에 포함되지 않으므로 원본 영상에서 확인하는 것이 좋습니다.
결과는 진행자 자신에게도 의외였다. 그는 Opus 5와 직접 일하는 경험을 강하게 싫어한다고 반복해서 말했지만, 블라인드 벤치마크 결과에서는 Opus 5가 가장 좋은 평가를 받았다고 한다. 순위는 Opus 5가 가장 위에 있었고, 그 다음 Sonnet 5, Mabu로 들리는 모델, GPT 5.6 Soul, Terra, Fable, Opus 4.8, Gemini 3.1 Pro 순으로 언급된다. 다만 이 순위와 모델명 일부는 STT 및 영상 내 화면 정보에 의존하므로, 정확한 표기는 원본 영상 확인이 필요하다.
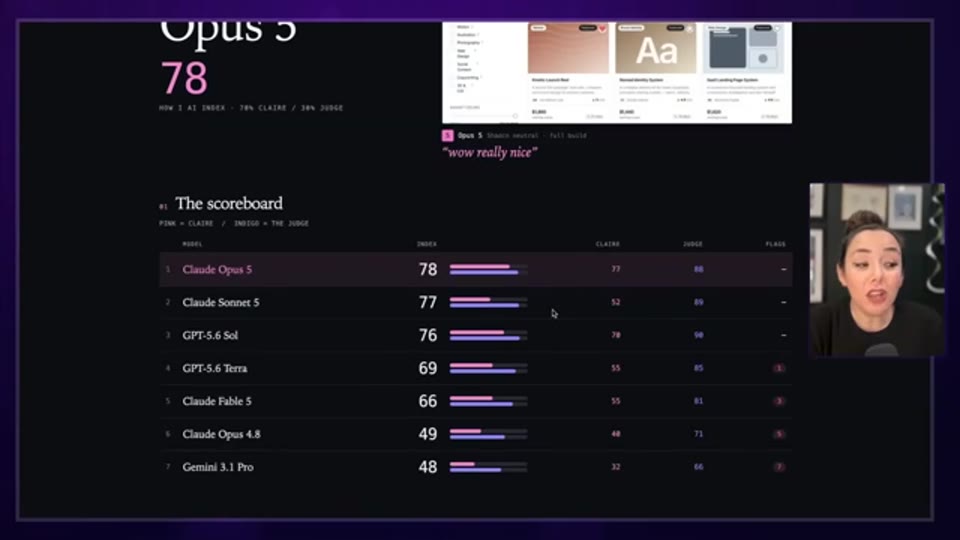
19:28 - Opus 5, Sonnet 5, GPT 5.6 Soul 등 여러 모델의 벤치마크 순위를 설명하는 장면
진행자의 평가에서 Opus 5가 특히 강했던 영역은 frontend work와 app design이었다. 그는 Opus 5가 만든 결과물에 대해 상세하고, 기능적이며, 흥미롭고, polished하다고 평가한다. 이는 Opus 5가 채팅 상호작용에서는 피곤하지만, 비동기적으로 작업을 맡겨놓고 산출물만 받을 때는 매우 강력하다는 결론으로 이어진다. 즉 Opus 5는 대화형 동료라기보다 백그라운드에서 고품질 결과물을 만들어내는 에이전트로 사용할 때 가치가 커진다.
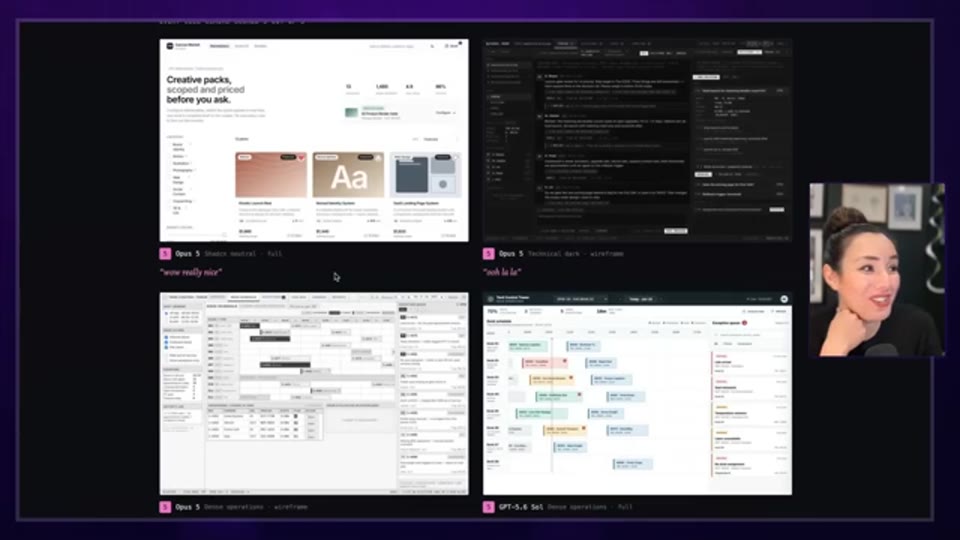
20:26 - Opus 5가 만든 프론트엔드 결과물에 높은 점수를 준 사례들을 보여주며 디자인 품질을 평가하는 장면
진행자는 Opus 5가 만든 벤치마크 웹사이트 초안을 예로 들며, 첫 결과물이 항상 완벽한 것은 아니었다고 설명한다. 다만 문제점을 지적하고 다시 개선시키면 결과물의 구조와 디자인 품질이 빠르게 좋아졌고, 이 점이 Opus 5의 실사용 강점으로 보였다고 평가한다.
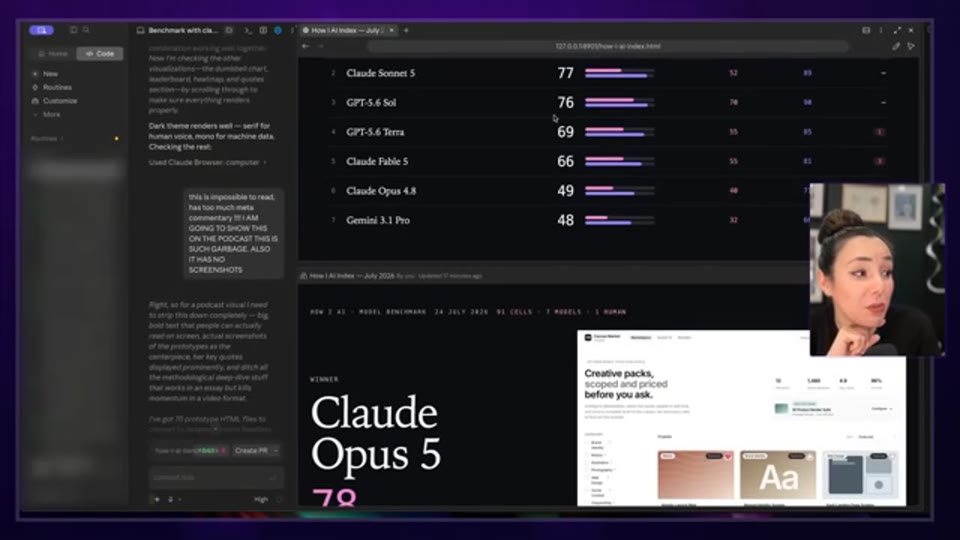
22:34 - Opus 5가 만든 벤치마크 웹사이트 초안의 문제점을 지적하고 다시 개선시킨 경험을 설명하는 장면
데이터로 본 영상 내 벤치마크 구조
진행자가 음성으로 언급한 벤치마크 구성은 다음과 같이 정리할 수 있다. 이 표는 영상에서 말로 설명된 내용만 반영하며, 화면에 표시된 세부 점수나 시각 자료는 포함하지 않는다.
| 항목 | 영상에서 언급된 내용 |
|---|---|
| 평가 방식 | 블라인드 테스트 후 진행자 평가와 LLM judge 평가를 결합 |
| 가중치 | 진행자 주관 평가 70%, LLM judge 30% |
| judge 모델 | GPT 5.5로 언급 |
| 평가 과제 | PRD 작성, prototype creation, wireframe creation, bug triage, agentic coding, agent voice |
| 주요 결론 | Opus 5가 전체적으로 가장 높은 평가를 받음 |
| 강점 영역 | frontend design, app design, prototyping |
| 진행자 불만 | 직접 협업 시 장황함, 조심성, 인간 의존성 |
이 벤치마크는 학술적 표준 평가라기보다, 실제 제품 빌더가 자기 업무 맥락에서 모델을 비교하는 실전형 평가에 가깝다. 따라서 점수 자체보다 중요한 것은 진행자가 어떤 모델을 어떤 작업에 다시 사용할 의향이 있는가이다. 그 기준에서 Opus 5는 불편한 대화 경험에도 불구하고, 실제 결과물 품질 때문에 다시 사용할 모델로 분류된다.
Opus 5가 보여준 제품적 함의
이 리뷰가 흥미로운 이유는 “좋은 모델”의 정의가 흔들리고 있기 때문이다. 과거에는 더 높은 벤치마크 점수와 더 좋은 코딩 능력이 곧 더 좋은 모델을 의미했다. 그러나 진행자의 경험에서 Opus 5는 그런 기준에서는 분명 훌륭하지만, 인간과 직접 협업하는 인터페이스에서는 마찰을 일으킨다. 이때 사용자는 모델의 능력과 모델을 사용하는 감정을 분리해서 판단하게 된다.
Opus 5는 agentic coding의 미래가 꼭 “사용자와 계속 대화하는 AI”가 아닐 수 있음을 보여준다. 만약 모델이 지나치게 장황하고 조심스럽다면, 사용자는 그것과 대화하기보다 명확한 작업을 맡기고 결과만 받는 방식을 선호할 수 있다. 진행자가 말하듯, Opus 5는 백그라운드에서 아름다운 것을 만들고, 사용자는 모델과 굳이 말을 섞지 않는 관계에서 가장 잘 작동할지도 모른다.
이는 AI 제품 설계에도 중요한 시사점을 준다. 모델의 raw intelligence가 높아질수록, 차별화 요소는 더 이상 답을 맞히는 능력만이 아니다. 응답 길이, 결정을 내리는 태도, 위험을 다루는 방식, 사용자에게 부담을 전가하지 않는 커뮤니케이션, 그리고 작업을 끝까지 밀고 가는 실행성이 모두 제품 경험의 일부가 된다. Opus 5는 그중 산출물 품질에서는 강하지만, 상호작용 설계에서는 아직 개선 여지가 큰 모델로 묘사된다.
마무리 / 핵심 정리
진행자의 최종 평가는 “사랑하지만 싫다”에 가깝다. 그는 Opus 5가 신경증적으로 조심스럽고, 인간에게 지나치게 기대며, Claude 특유의 장황한 문체 때문에 직접 함께 일하기 피곤하다고 말한다. 하지만 동시에 자체 벤치마크에서 Opus 5는 프론트엔드 디자인, 앱 디자인, 프로토타이핑에서 가장 인상적인 결과를 냈고, 그래서 실제 업무에 다시 사용할 모델이라고 결론 내린다.
이 역설은 프론티어 모델 시대의 다음 질문을 잘 보여준다. 모델이 충분히 똑똑해진 뒤에는, 누가 더 높은 점수를 받았는가보다 어떤 작업 흐름에서 어떤 모델이 덜 귀찮고 더 안정적으로 좋은 결과를 내는지가 중요해진다. Opus 5는 대화하기에는 피곤하지만, 결과물만 놓고 보면 매우 강력한 모델이다. 따라서 이 모델의 최적 사용법은 긴 대화를 나누며 세세하게 협업하는 것이 아니라, 명확한 목표를 주고 비동기적으로 결과를 받아 평가하는 방식에 가까워 보인다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | I hate Opus 5. It’s the best model, anyway. |
| 채널 | How I AI |
| 영상 길이 | 약 24분 41초 |
| 리포트 작성 | 2026-07-26 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.