LLM 관측가능성, 평가, 실험 플랫폼 — Dat Ngo, Arize AI
📺 원본 영상: LLM Observability, Evaluation, Experimentation Platform — Dat Ngo, Arize 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-08 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 Arize AI의 AI Architect인 Dat Ngo가 LLM 및 에이전트 시스템을 실제 프로덕션에서 제대로 작동시키기 위해 필요한 세 가지 핵심 요소, 즉 관측가능성(Observability), 평가(Evaluation), 그리고 실험(Experimentation)을 다룬다. 강연자는 세계 최대 규모의 엔터프라이즈 기업들과 함께 일하며 얻은 현장 경험을 바탕으로, AI 시스템이 단순히 “느낌상 잘 작동하는” 수준을 넘어 측정 가능하고 지속적으로 개선될 수 있는 구조를 갖추는 방법을 설명한다. 전체적인 메시지는 간결하다. AI 엔지니어링은 마법이 아니라, 기존 소프트웨어 엔지니어링의 패턴을 새로운 맥락에 적용한 것이다.
AI 엔지니어링은 결국 소프트웨어 엔지니어링이다
Dat Ngo는 강연 초반부터 AI 붐의 본질에 대해 흥미로운 관점을 제시한다. 많은 사람들이 에이전트(Agent)나 하네스(Harness)를 구축하면서 이것이 완전히 새로운 패러다임이라고 느끼지만, 그의 시각은 다르다. AI 공간은 실제로 소프트웨어를 재상상한 것(software reimagined)에 불과하며, 같은 패턴의 집합이 조금 다른 형태로 나타날 뿐이라는 것이다. 마법처럼 느껴지지만 마법이 아니고, 결국은 모두 엔지니어링이다.
이 관점은 단순한 철학적 선언이 아니라, 강연 전체를 관통하는 핵심 프레임이다. 과거 소프트웨어 엔지니어링이 관측가능성과 테스트, 실험적 배포를 통해 성숙해졌듯이, AI 시스템도 같은 경로를 밟아야 한다는 주장이다. Arize AI는 바로 이 맥락에서 탄생한 회사로, 수많은 엔터프라이즈 기업들이 AI를 실제로 작동시키는 과정에서 겪는 고통을 해결하는 데 집중하고 있다. 강연자 스스로도 지난 한 해에 1천억 개에서 1조 개 사이의 토큰을 소비했다고 밝혔는데, 이는 그가 이 공간에서 얼마나 깊이 실무적으로 관여하고 있는지를 단적으로 보여준다.
1부. 관측가능성(Observability) — 에이전트 안에서 무슨 일이 벌어지는가
OpenTelemetry(OTEL)를 기반으로 한 표준화된 접근
관측가능성은 강연자가 제시하는 세 단계의 첫 번째이자, 그가 가장 강조하는 기반이다. 핵심 질문은 단순하다. “내가 만든 것 안에서 지금 무슨 일이 일어나고 있는가?” Arize가 관측가능성을 구현하는 방식에서 가장 주목할 점은 OpenTelemetry(OTEL) 표준을 전면적으로 채택했다는 것이다. OTEL은 소프트웨어 엔지니어링 세계에서 이미 검증된 강력한 패턴으로, Arize는 모든 것을 이 표준 위에 구축함으로써 특정 프레임워크, SDK, 모델, 또는 에이전트 구성 방식에 종속되지 않는 범용적인 관측 체계를 만들어냈다.
실용적인 측면에서 이것이 의미하는 바는 명확하다. 자동 인스트루멘터(auto-instrumenter)를 사용할 경우, 코드 한 줄을 추가하는 것만으로 해당 프레임워크나 SDK 주변에서 일어나는 모든 일을 감지하고, OpenTelemetry 트레이스(trace)와 스팬(span)을 생성해 시각화된 뷰를 만들어낼 수 있다. 이는 에이전트 시스템의 감사 기록(audit record)으로서의 역할을 한다. 기존에는 코드 자체가 감사를 담당했지만, 비결정론적으로 동작하는 에이전트 세계에서는 텔레메트리(telemetry)가 그 역할을 대신한다는 것이 강연자의 설명이다.
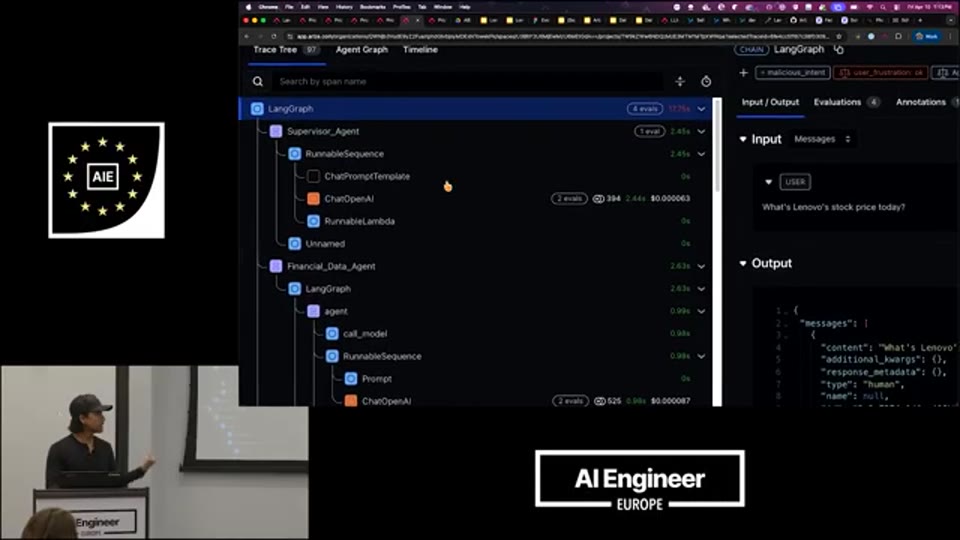
03:25 - Arize 플랫폼의 OpenTelemetry 기반 트레이스/스팬 시각화 뷰
트레이스와 스팬을 넘어서 — 세션과 분포적 시각
트레이스와 스팬이 관측가능성의 기본이라면, 그 위에 더 높은 수준의 개념들이 존재한다. 강연자는 강연 이틀 전에 Anthropic이 공개한 “Multi-Agent” 논문을 언급하면서 세션(session)의 개념을 소개했다. 세션은 단순한 단일 호출이 아니라, 에이전트 실행 과정에서 발생하는 상태(state)의 흐름, 즉 여러 차례의 주고받음(back-and-forth)이 이루어지는 대화나 실행 흐름 전체를 의미한다. 엔터프라이즈 환경에서 많은 팀들이 개별 툴 호출(tool call) 하나하나보다는 “최종 사용자가 만족했는가”, “모든 질문이 답해졌는가”라는 세션 단위의 결과에 더 큰 관심을 보인다는 점에서 이 개념은 실용적으로도 중요하다.
한층 더 독특한 개념은 에이전트의 분포적 뷰(distributional view)다. 에이전트는 본질적으로 비결정론적이기 때문에, 단일 실행 결과를 보는 것만으로는 부족하다. 강연자는 “에이전트의 모든 인스턴스화(instantiation)를 한꺼번에 보고 싶다면 어떻게 해야 하는가”라는 질문을 던진다. Arize AX는 에이전트가 취할 수 있는 다양한 경로와 분기(branch), 그리고 루프(loop)를 시각화하며, “내 트래픽의 몇 퍼센트가 A 분기를 타고 몇 퍼센트가 B 분기를 타는가”라는 분포적 질문에 답할 수 있는 뷰를 제공한다.
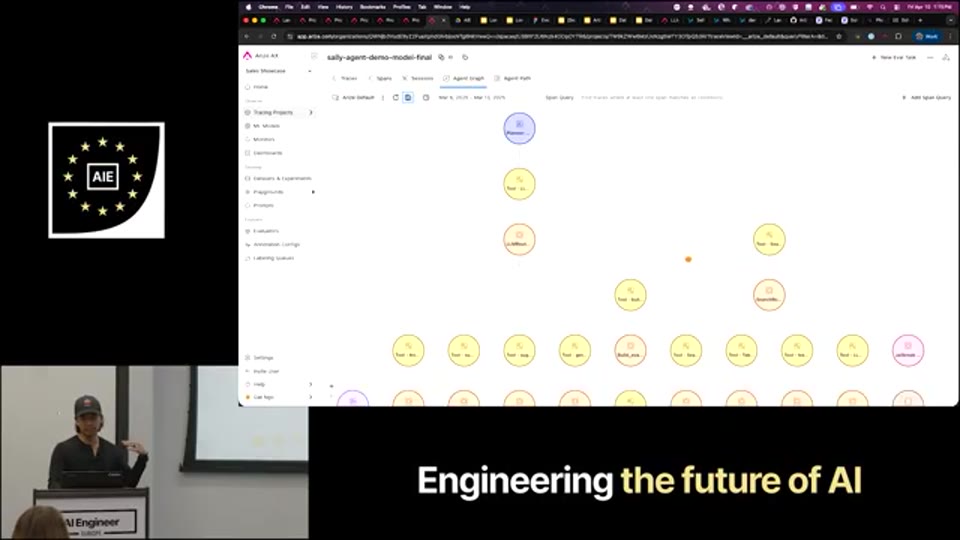
05:20 - 에이전트의 다양한 실행 경로(분기, 루프)를 보여주는 분포적 시각화 화면
이 분포적 시각은 단순한 시각적 편의를 넘어 실질적인 디버깅 도구가 된다. 예를 들어, 특정 분기를 탔을 때 지연 시간(latency)이 유독 증가한다면, 그 분기의 어떤 컴포넌트가 원인인지 추적할 수 있다. 혹은 LLM이 A 작업 이전에 B 작업을 수행해야 함에도 불구하고 순서를 뒤바꾼 경우—B가 A에 의존성이 있는 상황에서—이를 감지하고 프롬프트에 맥락 정보를 추가해 올바른 순서를 유도하는 것이 가능해진다.
2부. 평가(Evaluation) — 신호를 어떻게 추출할 것인가
다섯 가지 신호의 맛(Five Flavors of Signal)
관측가능성이 “무슨 일이 일어나는가”를 보는 것이라면, 평가는 “그 일이 잘 일어나고 있는가”를 판단하는 신호를 뽑아내는 것이다. 강연자는 이 신호를 다섯 가지 유형으로 구분한다.
첫 번째는 LLM as a Judge다. 많은 사람이 이미 익숙한 개념이지만, 강연자는 이것이 단순해 보여도 실제로는 상당히 복잡해질 수 있다고 경고한다. 두 번째는 인간 피드백(Human Feedback)이다. 제품을 실제로 사용하는 최종 사용자들의 반응은 기술적 지표로는 잡히지 않는 실용적 신호를 제공하며, 기술적이든 비기술적이든 모든 팀원이 관심을 가져야 한다. 세 번째는 황금 데이터셋(Golden Dataset)이다. 도메인 전문가가 직접 레이블링한 신뢰할 수 있는 데이터로, LLM as a Judge를 튜닝하는 기준으로 활용된다. 즉, “내 LLM 판정자가 이 신뢰받는 데이터셋을 얼마나 잘 근사하는가”를 측정하는 방식이다.
네 번째는 결정론적(Deterministic) 평가다. LLM 호출 비용이 항상 정당화되지는 않으며, 때로는 단순한 로직으로 충분하다. 예를 들어 LLM이 JSON을 출력할 때 “이것이 유효한 JSON인가”, “필요한 스키마를 갖추고 있는가”, “필수 필드가 null이 아닌가”와 같은 검증은 코드로 완벽하게 처리할 수 있다. 다섯 번째는 비즈니스 지표(Business Metrics)다. 결국 AI 시스템은 수익 창출, 비용 절감, 시간 절약이라는 세 가지 목적 중 하나를 위해 만들어지기 때문에, 이 상위 지표와의 연계가 중요하다.
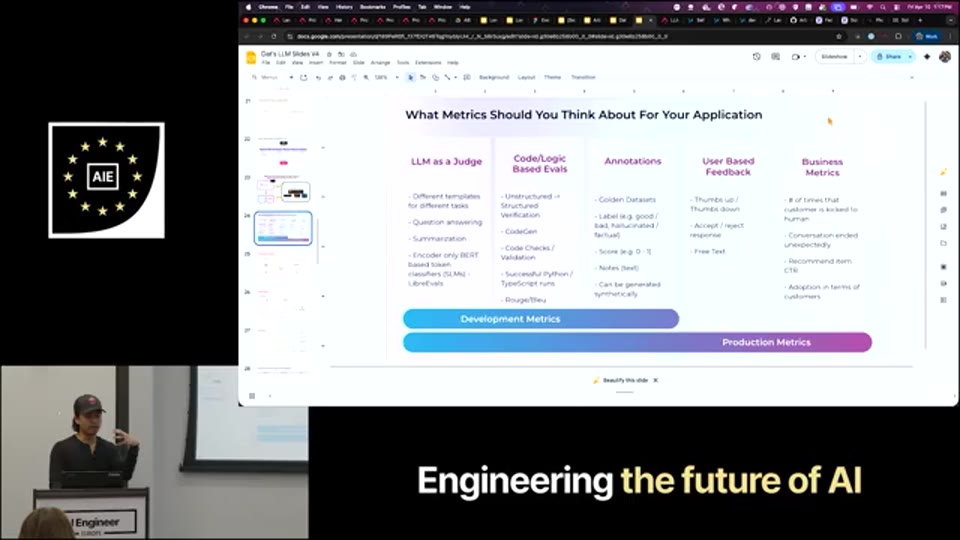
07:09 - 다섯 가지 신호 유형(LLM as a Judge, Human, Golden Dataset, Deterministic, Business Metrics) 슬라이드
평가의 범위와 깊이 — 얼마나 넓게, 얼마나 깊게 볼 것인가
평가를 어떤 유형으로 수행할지만큼 중요한 것은 어떤 범위(scope)에서 수행할지다. 강연자는 네 가지 수준의 평가 범위를 제시한다.
가장 기본적인 단위는 스팬 평가(Span Eval)로, 단일 LLM 호출의 입력과 출력만을 대상으로 한다. 대부분의 팀이 여기서 출발하며, 개념도 단순하다. 그러나 시스템이 복잡해질수록 스팬 평가만으로는 부족하다. 멀티-스팬 평가(Multi-Span Eval)는 여러 컴포넌트에 걸친 데이터를 종합해야 할 때 필요하다. 예를 들어 “에이전트들이 서로 데이터를 얼마나 잘 전달하는가”를 평가하려면 모든 에이전트의 입출력 데이터가 필요하기 때문이다.
트래젝토리 평가(Trajectory Eval)는 비즈니스 프로세스를 완수하기 위해 올바른 순서로 올바른 것들을 호출했는지를 전체 관점에서 검증한다. 마지막으로 세션 평가(Session Eval)는 가장 높은 수준의 줌아웃으로, 전체 대화나 상태 기계(state machine)를 평가 대상으로 삼는다. “이 대화에서 사용자가 좌절했는가”, “모든 질문이 답해졌는가”와 같은 질문이 여기에 해당한다.
강연자는 이 지점에서 중요한 경고를 덧붙인다. 평가할 수 있다고 해서 항상 평가해야 하는 것은 아니라는 것이다. 모든 것을 평가하려는 시도는 비용을 급격히 증가시킨다. 대신 “내 애플리케이션이 의도대로 작동하는지 파악하기 위한 최소한의 평가 세트”를 찾는 것이 현실적인 접근이다.
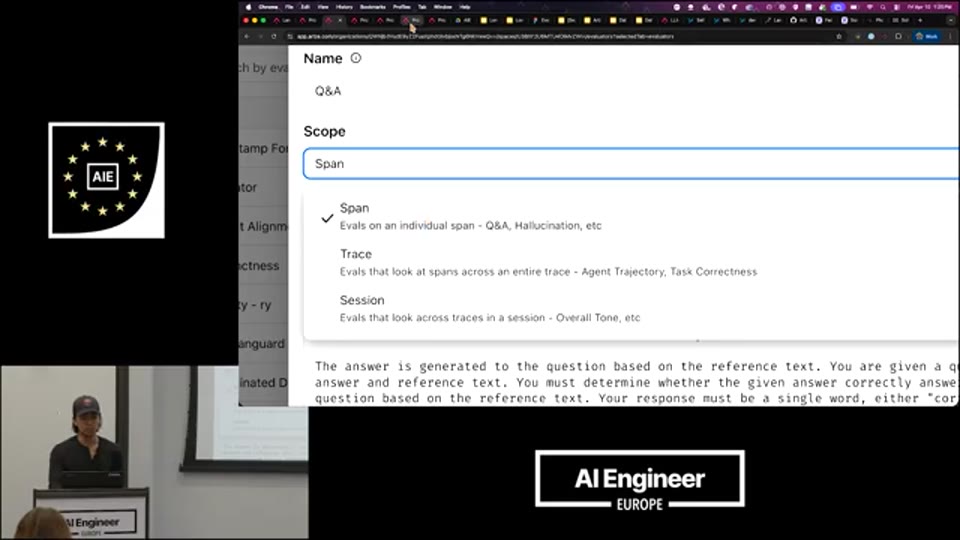
10:25 - 스팬 평가(Span Eval) 범위 설명 및 멀티-스팬, 트래젝토리, 세션 평가 계층 구조 화면
기술 팀과 도메인 전문가 간의 협업 구조
흥미로운 관점은 평가 체계가 단순히 기술적 도구의 문제가 아니라 조직 구조의 문제이기도 하다는 강연자의 시각이다. AI 프로덕트를 만들다 보면 두 유형의 인물이 자연스럽게 필요해진다. 코드를 작성하고 자동화를 구현하는 AI 엔지니어와, 코드는 모르지만 AI 경험이 어때야 하는지를 아는 도메인 전문가 및 프로덕트 매니저다. 전자는 코딩을 맡고, 후자는 프롬프트 엔지니어링의 방향과 어떤 평가가 중요한지를 결정해야 한다. Arize는 이를 반영해 비기술자도 UI를 통해 평가를 실행하고 모델을 선택하거나 평가 템플릿을 커스터마이징할 수 있는 환경을 제공하며, 기술자라면 동일한 작업을 코드로 프로그래밍적으로 수행할 수 있게 한다.
3부. 실험(Experimentation) — 어떻게 개선할 것인가
데이터셋 기반의 실험 루프
관측가능성과 평가가 현재 상태를 이해하는 것이라면, 실험은 개선을 위한 변화를 체계적으로 검증하는 과정이다. 강연자가 설명하는 실험 루프는 다음과 같다. 먼저 트레이스 데이터 중 신호가 나쁜 것들, 즉 문제가 있는 케이스들을 찾아낸다. 이것들을 수집해 데이터셋으로 만든다. 트레이스가 없는 경우라면 입출력 쌍(input-output pairs)을 직접 업로드해도 된다. 그 다음 이 데이터셋을 기반으로 실험을 실행하는데, 실험은 곧 변화(change)다.
강연자에 따르면, 에이전트나 하네스를 개선하기 위한 변화는 크게 네 가지 유형으로 나뉜다. 프롬프트 변경(changes to prompts), 모델 변경(changes to models), 오케스트레이션 변경(changes to orchestration), 그리고 설정 변경(changes to configurations)이다. Arize는 이러한 실험을 UI를 통해 수행할 수도 있고, 코드로 프로그래밍적으로 실행할 수도 있는 유연성을 제공한다.
중요한 함의는 강연 초반에 언급된 경고에서 드러난다. 비결정론적인 세계에서 “고쳤다고 생각한 것”을 고쳤을 때, 실제로는 두세 가지 새로운 회귀(regression)가 발생했을 수 있다. 이것이 바로 체계적인 실험과 평가가 필수적인 이유다. 직관에만 의존한 변경은 예상치 못한 부작용을 감지하지 못한 채 프로덕션에 배포될 위험이 있다.
4부. 미래 방향 — 자동화가 목표다
코딩 에이전트와의 통합
강연의 마지막 부분에서 Dat Ngo는 Arize가 나아가는 방향을 공유한다. 핵심 인식은 “대부분의 사람들이 대시보드나 버튼, 수동 작업 안에서 살고 싶어 하지 않는다”는 것이다. Claude Code나 Codex 같은 코딩 에이전트에 이미 익숙해진 개발자들은 자신의 작업 흐름 안에서 모든 것을 처리하길 원한다. 이에 Arize는 모든 기본 기능을 CLI와 툴(tools), 스킬(skills) 집합으로 노출하여 코딩 에이전트가 Arize 시스템을 직접 호출할 수 있게 만들었다.
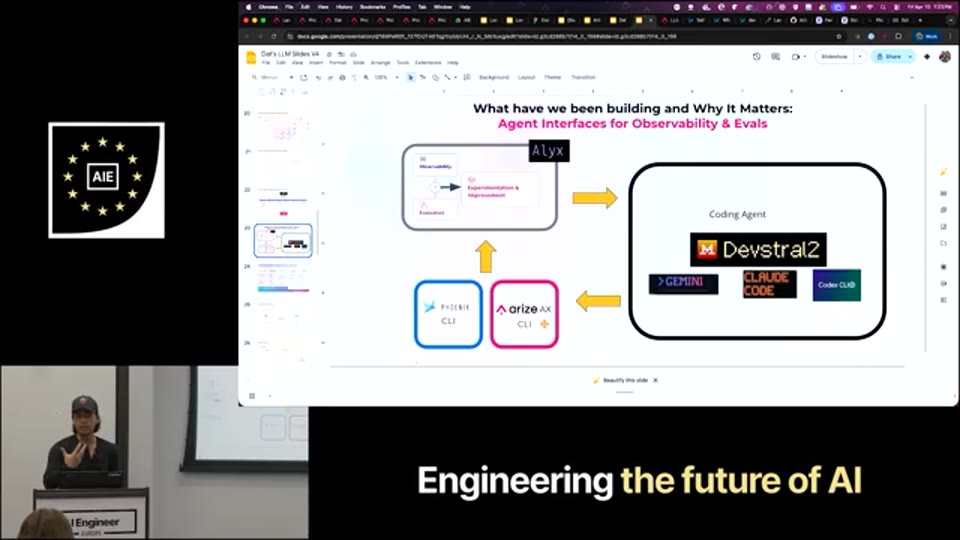
13:49 - Arize CLI 및 툴/스킬 노출 방식 - 코딩 에이전트 통합 구조 설명 화면
더 나아가 Arize는 “Alex”라는 이름의 AI 시스템을 플랫폼에 통합했다. Claude Code와 같은 외부 AI 시스템이 Alex를 호출해 “내 애플리케이션에 문제가 있어 보이는가?”라고 물으면, Alex가 전체 데이터와 훅(hook)에 접근하여 스스로 계획을 세우고 작업을 실행하는 방식이다.
14:15 - Alex AI 어시스턴트가 애플리케이션 이슈(고지연, 에러)를 감지하고 분석하는 데모 화면
완전 자동화라는 최종 목표
Arize의 궁극적인 목표는 선명하다. 관측가능성, 평가, 실험과 개선이라는 전체 플라이휠(flywheel)을 완전히 자동화하는 것이다. 강연자는 이상적인 미래 시나리오를 이렇게 묘사한다. 개발자가 Arize 생태계를 내려받으면, 시스템이 스스로 트레이스를 분석하고 맥락을 파악해 적절한 평가를 즉석에서 생성하며, 새로운 문제가 감지되면 새로운 평가를 만들어낸다. 개발자가 평가를 직접 선택할 필요조차 없는 세계가 목표다. 다시 한 번 강연자의 핵심 테제가 반복된다. 마법처럼 느껴져야 하지만, 마법이 아니다.
5부. Arize 제품 라인업
Arize AI는 현재 두 가지 제품을 제공한다. 엔지니어링 중심의 팀을 위한 Arize Phoenix는 오픈소스로 제공되며, 단일 컨테이너로 로컬에 배포할 수 있어 Kubernetes 레이어가 불필요하다는 것이 가장 큰 장점이다. 진입 장벽이 낮고 빠르게 시작할 수 있는 선택지다. 반면 Arize AX는 Uber, Booking.com, Reddit과 같은 초대형 엔터프라이즈 고객을 위한 플랫폼으로, 앞서 설명한 에이전트 분포 시각화, Alex AI 통합, 그리고 엔터프라이즈 규모의 관리 기능을 포함한다.
마무리 — AI를 실제로 작동시키는 것의 의미
Dat Ngo의 강연이 남기는 핵심 메시지는 명확하다. 에이전트를 만드는 것과 에이전트가 실제로 잘 작동하는 것 사이에는 커다란 간극이 있으며, 그 간극을 메우는 것이 관측가능성, 평가, 실험의 역할이다. 에이전트는 비결정론적이기 때문에 코드만으로는 감사할 수 없고, 직관만으로는 개선의 방향을 신뢰할 수 없다. 텔레메트리가 감사를 담당하고, 체계적인 평가가 신호를 제공하며, 데이터 기반의 실험이 개선을 검증해야 한다.
동시에 강연자는 미래를 낙관한다. 이 모든 과정 자체가 자동화될 수 있으며, 궁극적으로 개발자는 “AI가 잘 작동하는가”를 스스로 점검하는 수고에서 벗어나 실제 제품 개발에 집중할 수 있는 날이 올 것이라고 본다. 그리고 그 자동화를 구현하는 것 또한 결국 엔지니어링이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | LLM Observability, Evaluation, Experimentation Platform — Dat Ngo, Arize |
| 채널 | AI Engineer |
| 강연자 | Dat Ngo, AI Architect, Arize AI |
| 리포트 작성 | 2026-06-08 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Skill issue - Lessons from skilling up coding agents to use Langfuse - Marc Klingen
- Mind the Gap (In your Agent Observability) — Amy Boyd & Nitya Narasimhan, Microsoft
- Hierarchical Memory - Context Management in Agents — Sally-Ann Delucia
- Fighting AI with AI — Lawrence Jones, Incident
- The Future of Evals - From LLM as a Judge to Agent as a Judge - Aparna Dhinakaran, Arize AI