Lasting Quality — 오래가는 품질을 만드는 소프트웨어의 구조
📺 원본 영상: Lasting Quality - Michael Caisse - C++Now 2026
🎙️ 채널: CppNow
📅 정리 일자: 2026-09-23
⚠️ Note: 본 리포트는 STT를 바탕으로 작성된 제공 문서를 검수했다. 원본 STT와 영상·음성을 직접 대조하지 않았으며, 화면에 표시된 코드, 수식, 슬라이드의 세부 내용도 직접 확인하지 않았다. 재확인이 필요한 수치와 표현에는 [?]를 표시했다. 비용 수치와 성능 평가는 별도 검증된 결과가 아니라 강연자가 제시한 설명으로 구분한다. 제공된 스크린샷 목록에는 로컬 파일 경로만 있고 webUrl이 없어 이미지를 삽입하지 않았다.
개요
Michael Caisse의 질문은 단순하다. 엔지니어가 끊임없이 애쓰고, 테스트와 검증에 막대한 자원을 투입하는데도 왜 소프트웨어 품질은 쉽게 무너지는가? 약 37년[?]의 실무 경험과 그중 15년[?]의 컨설팅 경험을 바탕으로, 그는 품질을 유지하는 비용이 코드의 구조와 문제를 표현하는 방식에 깊이 연결되어 있다고 설명한다.
이 강연은 C++의 새로운 문법이나 메타프로그래밍 기법 자체보다, 그런 도구를 사용하는 이유를 다룬다. 핵심은 추상화(Abstraction)와 합성 가능성(Composability)을 통해 시스템을 이해하고 변경하고 검증하기 쉽게 만드는 것이다. 파서, 상태 머신, 컴파일 타임 의존성 그래프, CAN 메시지, 비동기 처리 사례는 모두 같은 질문으로 이어진다. 잘못된 조합을 일찍 막고, 올바른 의도가 코드에서 직접 읽히도록 만들 수 있는가?
품질을 위해 더 많이 일해야 한다는 전제부터 의심하기
강연은 많은 개발팀이 익숙하게 겪는 상황에서 출발한다. 새로운 기능을 빨리 내놓고, 다음 버그를 서둘러 고치고, 바뀐 요구사항을 즉시 반영하라는 압박이 계속된다. 어렵게 원인을 찾아 수정했는데 다른 결함이 생기고, 그 여파를 줄이기 위해 다음 수정은 더 조심스러워진다. Caisse는 이런 조직이 제품을 설계할 수 있는 팀을 키우는 대신, 특정 프로젝트를 완성하기 위한 소모 자원처럼 엔지니어를 사용하는 것은 아닌지 묻는다.
그가 문제 삼는 것은 품질에 대한 책임 자체가 아니다. 그는 FDA와 FAA의 규제를 받는 환경에서 일한 경험을 언급하며, 어떤 소프트웨어 오류는 사람의 생명과 연결되므로 높은 품질을 제공하는 일이 도덕적 책임이라고 말한다. 다만 그 책임을 완수하는 방식이 언제나 과도한 노동과 사후 수습이어야 할 이유는 없다는 것이다. 에너지를 투입하는 시점과 대상을 바꾸면, 더 적은 노력으로 더 높은 품질에 도달할 수 있다는 것이 강연의 출발점이다.
이를 설명하기 위해 그는 결함을 늦게 발견할수록 수정 비용이 커지는 상황을 제시한다. 요구사항을 검토하다 발견한 모순은 비교적 국소적으로 바로잡을 수 있지만, 이미 출하된 제품에서 드러난 문제는 원인 분석과 배포, 호환성, 추가 장애까지 고려해야 한다. 특히 ROM에 들어간 코드의 동시성 오류를 실리콘 제작 이후에 발견하면, 단순한 코드 수정만으로 해결되지 않을 수 있다. 여기서 비용은 수정할 코드의 줄 수보다, 그 코드가 이미 연결된 현실의 범위에 의해 결정된다.
| 강연에서 언급한 항목 | 제공 문서에 기재된 수치 | 해석상의 범위 |
|---|---|---|
| 2002년 NIST 연구의 미국 내 소프트웨어 버그 관련 연간 비용 추정 | 약 590억 달러[?] | 강연자가 소개한 과거 연구 수치로, 원문 수치와 추정 대상 재확인 필요 |
| 칩 제작 전 엔지니어링 검증 비용 사례 | 5억 달러에서 10억 달러 이상[?] | 금액의 단위와 범위, 검증 비용인지 전체 개발 비용인지 원음 재확인 필요 |
| 새 마스크 세트가 필요한 오류의 비용 사례 | 1,500만 달러에서 1억 5,000만 달러[?] | 금액의 단위와 범위, 마스크 자체 비용인지 오류 대응 총비용인지 원음 재확인 필요 |
이 수치들은 모든 소프트웨어 프로젝트에 적용할 비용 공식으로 제시된 것이 아니다. Caisse가 강조하는 바는 시스템이 물리적 제품과 고객 환경에 깊이 결합된 뒤에는 결함 하나의 파급력이 급격히 커진다는 점이다. 그는 Barry Boehm의 1981년 저서 Software Engineering Economics도 언급하며, 개발 생애주기의 뒤쪽으로 갈수록 결함 수정 비용이 커진다는 논지를 연결한다. 따라서 품질 개선의 중요한 방향은 검증량을 늘리는 것과 함께, 결함을 더 이른 단계에서 드러내거나 애초에 특정 결함을 표현하기 어렵게 만드는 데 있다.
기능과 일정 뒤에 있는 구조적 품질
Caisse는 품질을 기능적 품질(Functional Quality), 프로세스 품질(Process Quality), 구조적 품질(Structural Quality)로 나누어 설명한다. 기능적 품질은 요구사항을 충족하는지, 결함 수가 적은지, 성능이 충분한지와 관련된다. 프로세스 품질은 비용과 일정 안에서 결과를 내는 능력이지만, 여기에는 팀을 소진시키지 않고 그 과정을 반복할 수 있어야 한다는 조건도 포함된다. 이번 릴리스의 일정만 맞추고 팀이 무너진다면, 그의 기준에서 좋은 프로세스라고 할 수 없다.
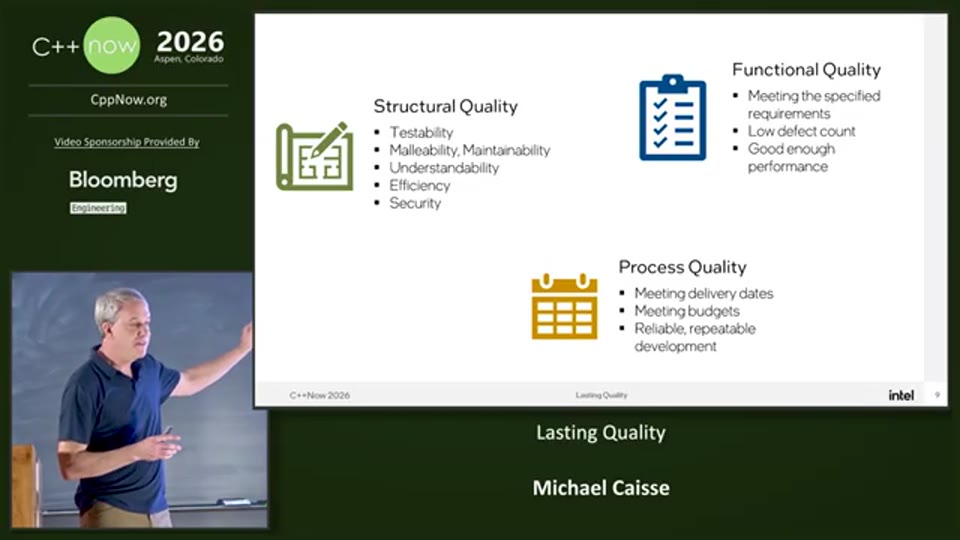
10:40 - 구조적 품질의 요소가 기능적 품질과 프로세스 품질에 미치는 관계를 설명하는 도표 구간
구조적 품질은 테스트 용이성, 유지보수성과 변경 용이성, 이해 용이성, 효율성, 보안성을 포괄한다. Caisse는 기능적 품질과 프로세스 품질이 상대적으로 측정하고 보고하기 쉬운 반면, 구조적 품질은 그 효과를 간접적으로 관찰해야 하는 경우가 많다고 말한다. 일정 준수율이나 결함 수는 그래프로 만들기 쉽지만, 어떤 설계가 앞으로 수십 번의 변경을 얼마나 안전하게 받아들일지는 하나의 수치로 표현하기 어렵다. 그렇다고 중요성이 낮은 것은 아니며, 오히려 구조가 나머지 품질의 조건을 만든다는 것이 그의 주장이다.
| 품질의 구분 | 핵심 질문 | 강연에서 강조한 관점 |
|---|---|---|
| 기능적 품질 | 요구한 동작을 정확하고 충분히 빠르게 수행하는가? | 사양 충족, 결함, 성능 |
| 프로세스 품질 | 비용과 일정 안에서 지속적으로 제공할 수 있는가? | 반복 가능성과 팀의 지속 가능성 |
| 구조적 품질 | 이해하고 시험하고 변경하기 좋은 구조인가? | 테스트 용이성, 변경 용이성, 이해 용이성, 효율성, 보안성 |
그의 변경 용이성 설명은 특히 실무적이다. 버그를 고친 뒤 다른 세 개의 버그가 생겼다면, 그 수정의 난이도만 문제가 아니라 시스템의 변경 용이성이 낮았다는 신호라는 것이다. 좋은 구조에서는 필요한 부분을 빠르게 바꾸면서도, 의도하지 않은 영향이 다른 영역으로 번지지 않을 것이라는 높은 확신을 가질 수 있다. 이해 용이성 역시 개별 반복문의 의미를 아는 수준을 넘어, 시스템이 무엇을 하고 구성요소들이 어떻게 상호작용하는지 파악하는 능력을 포함한다.
이 관점에서 구조적 품질은 보기 좋은 코드에 대한 취향으로 축소되지 않는다. 테스트하기 쉬운 경계는 문제를 더 빨리 격리하게 하고, 의도가 드러나는 표현은 잘못된 상태와 누락된 처리를 발견하기 쉽게 한다. 변경의 영향 범위가 작으면 수정과 검증에 드는 비용도 줄어든다. Caisse가 구조적 품질을 강조하는 이유는 이러한 효과가 기능과 일정의 안정성으로 이어진다고 보기 때문이다.
익숙함과 단순함을 구분해야 하는 이유
Caisse는 Rich Hickey의 강연을 소개하며 단순함(Simple)과 쉬움(Easy)을 구분한다. 그의 설명에서 단순함은 서로 다른 관심사가 뒤엉켜 있지 않은 상태에 가깝고, 쉬움은 어떤 개념이 자신에게 얼마나 익숙한지에 가깝다. 이미 알고 있는 문법으로 작성된 코드라도 상태와 정책, 데이터 선택과 실행 순서가 한데 엉켜 있다면 구조적으로 단순하지 않을 수 있다. 반대로 처음 보는 표기법도 의미를 익힌 뒤에는 문제의 구조를 훨씬 직접적으로 보여줄 수 있다.
그는 이 구분에서 단순함에 훨씬 높은 우선순위를 둔다. 신규 구성원이 처음 접했을 때 편하게 읽는지를 최우선 기준으로 삼으면, 장기적으로 더 풍부하고 정확한 표현을 포기할 수 있다는 것이다. 다만 강연 후반의 API 설계 논의까지 함께 읽으면, 이것은 사용성을 무시하라는 주장과는 거리가 있다. 잠깐의 낯섦을 줄이는 일과, 오랫동안 사고를 방해하는 얽힘을 줄이는 일을 구분하자는 주장으로 이해할 수 있다.
같은 맥락에서 그는 개수에 관한 설계 습관을 지적한다. 하나를 처리하도록 만든 코드에 두 번째 사례를 추가하고, 다시 세 번째 사례를 특수 처리하면 구조가 요구사항의 이력에 따라 굳어지기 쉽다. Caisse는 설계와 아키텍처 차원에서는 일반적인 N개의 경우를 생각하되, 일정 때문에 당장 하나나 두 개만 구현하는 선택은 가능하다고 말한다. 이는 미래의 모든 가능성을 미리 구현하라는 요구가 아니라, 현재 구현의 제한을 문제 자체의 본질로 착각하지 말라는 조언이다.
아키텍처와 구현을 구분하는 이유도 여기에 있다. 아키텍처와 여러 층의 설계는 시스템이 어떤 방향으로 발전해야 하는지 안내하고, 실제 구현은 현재의 지식과 시간 안에서 그 방향을 구체화한다. 오늘의 구현이 제한적이라는 사실은 받아들일 수 있지만, 그 제한 때문에 이후의 확장이 불필요하게 어려워질 필요는 없다. 강연 마지막의 실용주의는 이러한 설계 방향과 현실적 납품 사이의 균형으로 다시 돌아온다.
코드는 문제의 의도와 맥락을 전달하는 언어다
강연에서 영어 단어 ‘bowl’을 둘러싼 문장 만들기는 맥락의 중요성을 보여주는 장치다. ‘Ben has the bowl’에서는 그릇을 뜻하는 명사이지만, ‘Ben can bowl’에서는 동사가 된다. 동사라는 사실을 알아도 어떤 활동을 가리키는지는 충분한 맥락이 있어야 알 수 있다. Caisse는 코드에서도 이처럼 국소적인 표현만 보고서는 정확한 의미와 의도를 파악하기 어려운 상황이 반복된다고 설명한다.
그래서 그는 구현 요청을 그대로 받아들이기 전에 문제를 더 넓게 이해하라고 권한다. 왜 이 목록을 정렬해야 하는지, 왜 이 비트를 조작해야 하는지, 왜 고객이 해당 기능을 필요로 하는지를 계속 물으면 구현의 판단 기준이 달라진다. 요청에 이미 해결책의 모양이 포함되어 있더라도, 엔지니어의 역할은 그 해결책을 기계적으로 옮기는 데서 끝나지 않는다. 배경와 목적을 이해한 뒤 적합한 해결 방법을 제시해야 한다는 것이다.
Caisse는 코드도 아이디어를 표현하는 여러 수단 가운데 하나라고 본다. 다이어그램, 수식, 문서, 코드는 각각 어떤 측면을 잘 보여주지만, 그 하나만으로 전체 개념을 완전히 담아내지는 못한다. 그는 집의 여러 창문을 통해 내부를 들여다보는 비유로 이를 설명한다. 하나의 창문으로 보이지 않던 것이 다른 위치에서는 드러나듯, 서로 다른 표현은 문제에 대한 이해를 보완한다.
그렇다면 코드 안에도 더 많은 의미를 담을 수 있을까? 그가 추상화와 도메인 특화 언어(Domain-Specific Language, DSL)를 강조하는 이유가 여기에 있다. 수학 기호를 사용할 때 매번 그 정의를 가장 낮은 단계까지 풀어 쓰지 않듯, 잘 설계한 코드의 표현도 이미 합의된 의미를 하나의 단위로 다룰 수 있게 한다. 강연에서 인용한 Edsger Dijkstra의 요지도 추상화는 모호하게 만드는 일이 아니라, 다른 의미 수준에서 정확하게 말할 수 있게 만드는 일이라는 것이다.
파서와 상태 머신 — 문제의 표기와 코드의 거리를 줄이기
JSON 문법 사례에서 Caisse는 EBNF(Extended Backus–Naur Form)로 표현한 문법과 Spirit을 사용한 문법 코드를 비교한다. 배열은 대괄호 안에 쉼표로 구분된 값 목록이 선택적으로 들어가는 구조로, 객체는 이름과 값의 쌍으로 이루어진 멤버 목록이 중괄호 안에 선택적으로 들어가는 구조로 설명된다. 중요한 것은 두 표현이 정확히 같은 문자를 사용한다는 사실이 아니라, 문법의 구성요소와 조합 관계가 코드에서도 직접 읽힌다는 점이다. 독자는 반복문과 인덱스 조작을 추적한 뒤 문법을 역으로 추론하는 대신, 문법 자체에 가까운 수준에서 코드를 읽게 된다.
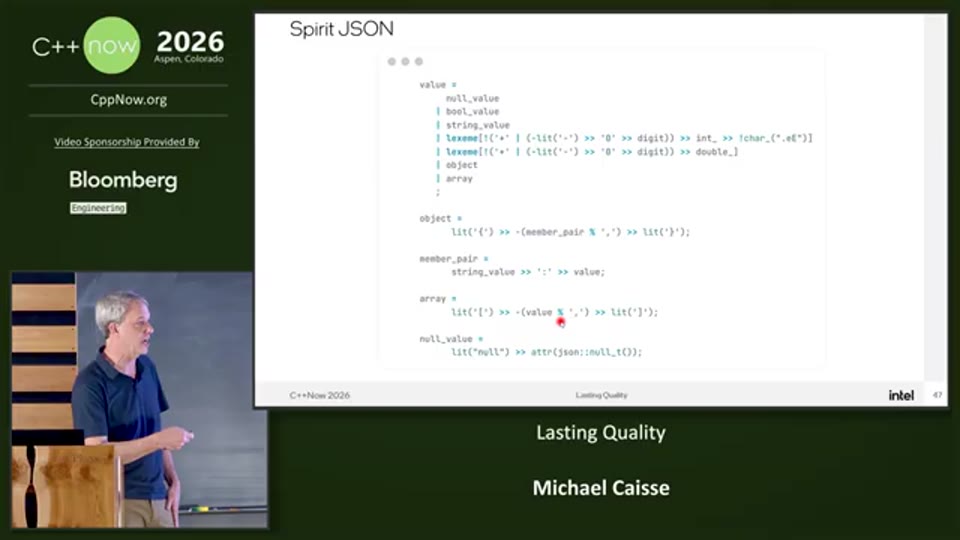
33:12 - Spirit JSON 문법에서 선택적 배열 요소와 쉼표로 구분된 값 목록의 표현을 설명하는 코드 구간
그는 이러한 표현이 코드에 많은 의미를 담는다고 설명한다. 제공 문서에는 이와 관련된 용어가 ‘semantic entropy’[?]로 기재되어 있으나, 정확한 용어는 원음 대조가 필요하다. 또한 이를 계산하거나 평가하는 정량적 방법은 제공 문서에 제시되지 않는다. 따라서 이 리포트에서는 해당 표현을 정보이론의 엄밀한 품질 지표로 사용하지 않는다. 이 사례에서 중요한 주장은 적절한 표기법이 코드가 무엇을 하는지와 다른 부분에 어떻게 연결되는지를 더 직접적으로 전달한다는 것이다.
상태 머신(State Machine) 사례에서도 같은 논리가 이어진다. Caisse는 UML 상태도에 있는 상태, 이벤트, 가드 조건, 실행 동작을 SML의 전이 표현과 연결한다. 연결이 설정된 상태에서 release 이벤트를 받으면 FIN_WAIT_1 상태로 이동하면서 FIN 전송 동작을 수행하고, ACK 이벤트에는 유효성을 확인하는 가드가 붙는다. 정확한 전이표 코드는 제공 문서에 포함되지 않지만, 그의 요점은 상태도에서 읽은 관계를 코드에서도 비슷한 형태로 파악할 수 있다는 데 있다.
이 접근의 이점은 요구사항이 늘어날 때 더 분명해진다. FIN_WAIT_1 상태에서 유효하지 않은 ACK를 받으면 오류 상태로 이동하고, 오류 상태에 들어갈 때마다 로그를 남겨야 한다는 조건을 추가해 보자. 임의로 배치된 if와 switch에서는 이벤트 판정, 상태 변경, 진입 동작이 흩어질 수 있지만, 상태 머신 표현에서는 각각을 해당 개념의 자리에 둘 수 있다. 제공된 설명에 따르면, 제시된 SML 예제에서는 ACK 가드가 성립하지 않을 때 오류 상태로 전이하고 오류 상태의 진입 동작을 실행한다. 정확한 가드 표현과 전이 선택 순서는 원본 코드 확인이 필요하다.
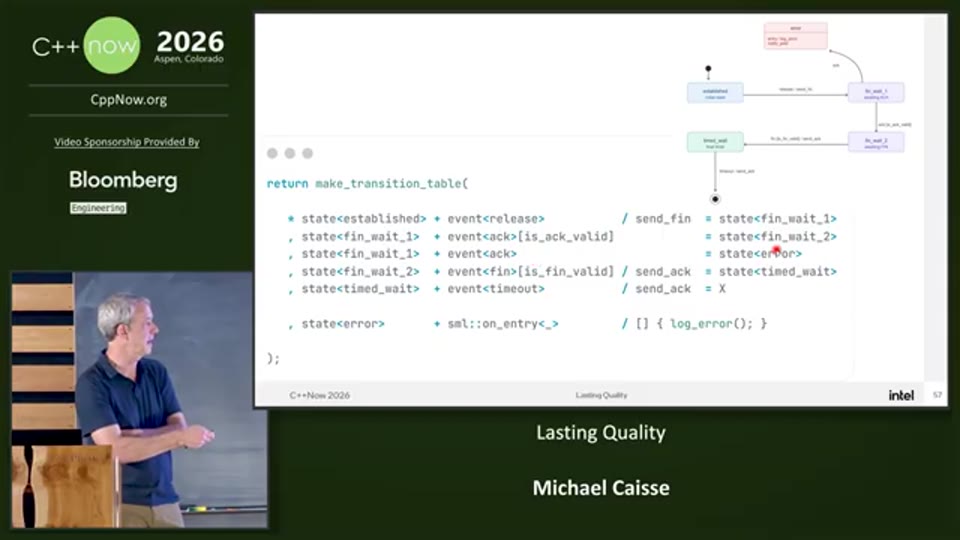
38:58 - SML 상태 머신에서 ACK 가드가 성립하지 않을 때 오류 상태로 전이하고 진입 동작을 실행하는 예제 구간
💡 [영상 참조] 38분 58초 부근에서는 ACK 가드가 성립하지 않을 때 오류 상태로 전이하고 진입 동작을 실행하는 SML 예제를 설명한다. 전이표의 정확한 문법과 배치는 원본 화면을 확인해야 한다.
이 사례를 특정 연산자 문법의 우월성으로만 읽어서는 안 된다. 질의응답에서 한 청중이 함수 이름으로도 같은 의도를 표현할 수 있다고 지적하자, Caisse는 명확히 동의한다. 팀에 적합하다면 이름 있는 함수로 높은 수준의 추상화를 표현해도 되며, 연산자 오버로딩은 필수 조건이 아니다. 그가 지키려는 핵심은 문제의 의미를 더 잘 전달하는 표현 수준이다.
의존성 그래프 — 잘못된 구성을 컴파일 단계에서 차단하기
작업 순서를 관리하는 예제는 추상화가 가독성을 넘어 검증 능력으로 이어지는 과정을 보여준다. 여러 기능이 각자 특정 이정표 이후나 이전에 실행되어야 한다고 가정하면, 개별 기능은 자신에게 필요한 의존성만 선언할 수 있다. Caisse는 여기에 필요 이상의 순서 정보를 넣지 않는 것이 중요하다고 말한다. 실제 제약보다 강한 순서를 미리 고정하면, 기능을 합치거나 제거할 때 불필요한 결합이 생길 수 있기 때문이다.
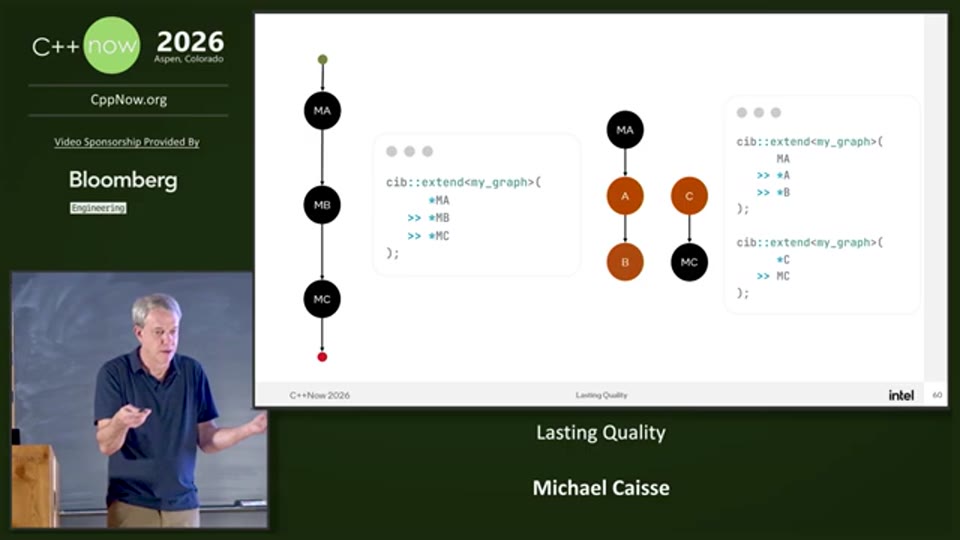
41:43 - 이정표와 작업 노드 사이의 의존성을 그래프와 닮은 코드로 구성하는 예제 구간
강연의 라이브러리는 각 모듈의 선언을 컴파일 타임에 모아 전체 그래프를 구성한다. 이후 의존성을 만족하는 순차 실행 형태로 그래프를 평탄화한다. 따라서 여기서 그래프를 사용한다는 사실이 런타임에 동적으로 노드를 탐색하거나 병렬 스케줄러를 운용한다는 뜻은 아니다. 개발자는 관계를 그래프로 표현하고, 실행에 필요한 구체적인 순서는 컴파일 과정에서 만들어지는 구조다.
더 중요한 것은 이 라이브러리가 그래프에 반드시 성립해야 할 조건을 검사한다는 점이다. 순환이 있거나, 참조한 노드가 실제로 추가되지 않았다면 컴파일 단계에서 문제를 드러낸다. 질의응답에서는 같은 노드가 두 번 추가되어 모호성이 생기는 경우도 차단한다고 설명한다. Caisse는 과거에 이러한 오류가 실제로 있었고, 존재하지 않는 노드를 참조한 탓에 어떤 작업이 실행되지 않았는데도 테스트가 이를 잡지 못한 경험을 언급한다.
| 그래프 구성의 문제 | 강연에서 설명한 위험 | 라이브러리를 통한 대응 |
|---|---|---|
| 의존성 순환 | 유효한 실행 순서를 만들 수 없음 | 컴파일 타임 검사 |
| 실제로 등록되지 않은 노드 참조 | 기대한 작업이 실행되지 않을 수 있음 | 참조의 유효성 검사 |
| 동일 노드의 중복 추가 | 구성의 모호성 발생 | 잘못된 중복 구성 차단 |
이 사례에서 컴파일러가 원래부터 응용 도메인의 그래프 규칙을 아는 것은 아니다. 라이브러리가 타입과 컴파일 타임 연산으로 그 규칙을 표현했기 때문에, 컴파일 과정에서 잘못된 구성을 거부할 수 있게 된 것이다. Caisse가 컴파일러에게 그래프를 읽는 방법을 가르친 것과 같다고 설명하는 이유도 여기에 있다. 추상화가 의미를 숨기는 외피에 머무르지 않고, 지켜야 할 규칙을 실행 가능한 검사로 바꾸는 역할을 한다.
동일한 표현에서 시각화 자료를 얻는 기능도 소개된다. Graphviz용 출력을 만들거나, 특정 노드 사이의 평탄화 결과를 컴파일러 경고 메시지로 확인할 수 있다는 것이다. Caisse에 따르면 최종 실행 코드는 인라인 코드로 정리되어, 해당 사례에서는 그래프라는 표현 때문에 추가적인 런타임 실행 구조를 유지할 필요가 없다. 다만 제공 문서에는 어셈블리나 벤치마크가 없으므로, 이를 모든 그래프 추상화와 모든 컴파일 환경에 대한 성능 보장으로 확대해서는 안 된다.
제품 변형을 복제 대신 기능 합성으로 다루기
Caisse는 노트북과 데스크톱이 서로 다른 주변장치와 전력 관리 요구를 가진다는 현실적인 문제를 제시한다. 같은 연도의 칩 제품군 안에서도 네다섯 개 이상의 펌웨어 변형이 필요해 보일 수 있다. 각 변형을 별도 코드로 관리하면 공통 기능의 수정과 검증이 여러 곳으로 퍼지기 쉽다. 그가 원하는 것은 하나의 소스에서 필요한 기능들을 선택해 각 제품의 구성을 만드는 방식이다.
앞서 설명한 의존성 그래프는 이 기능 합성의 연결 지점이 된다. 각 기능이 필요한 작업과 연결 규칙을 알고 있다면, 최상위 구성에서는 어떤 컴포넌트를 포함할지 선언하는 데 집중할 수 있다. 강연에서는 I²C 버스나 서보 모듈 같은 구성요소를 추가하는 예로 이를 설명한다. 결합을 줄여 놓은 기능들을 다시 합성함으로써, 제품별 차이를 코드 전체의 분기 대신 구성의 차이로 표현하려는 것이다.
이 대목에서 Caisse는 선언적 표현에는 일반적으로 버그가 없다는 강한 표현을 사용하지만, 곧 사양을 잘못 이해한 논리 오류는 있을 수 있다고 덧붙인다. 따라서 그의 발언은 선언적 코드의 무결성을 보장하는 주장으로 읽기보다, 반복적인 구현 실수의 종류를 줄이려는 취지로 읽는 편이 정확하다. 연결 방법과 실행 절차를 매번 수작업으로 작성하는 대신, 검증된 구성 규칙을 재사용하면 실수할 지점이 줄어든다는 것이다. 선언한 요구사항이 올바른지와 라이브러리 자체가 정확한지는 여전히 검증해야 할 대상으로 남는다.
요구사항이 변했다면 문제의 정의도 다시 살펴야 한다
강연 중반의 목록 처리 예제는 코드가 점진적으로 복잡해지는 과정을 보여준다. 처음에는 목록의 모든 원소에 부수효과가 있는 함수 f를 적용하면 충분하다. 이후 조건을 만족하는 원소만 처리해야 하고, 조건이 두 개로 늘어나며, 상태에 따라 서로 다른 목록과 조건을 사용해야 한다. 매번 기존 함수에 매개변수와 분기를 조금씩 추가하면 당장의 요청은 처리할 수 있지만, 코드는 처음의 문제를 중심으로 계속 변형된다.
Caisse가 권하는 전환은 현재 문제를 다시 서술하는 것이다. 지금 필요한 일이 대상 집합을 정하고, 조건으로 선택하고, 선택한 원소에 작업을 적용하는 것이라면, 그 세 가지를 구분해서 표현할 수 있다. 이때 데이터 선택과 실제 수행할 동작이 분리되며, 상태에 따른 선택 정책도 별도로 생각할 수 있게 된다. 강연에서 말하는 전체 집합 중심의 처리(Wholemeal Processing)는 개별 원소를 다루는 절차에 매달리기보다, 집합과 변환의 의미를 먼저 보려는 접근이다.
그의 리팩터링 관점도 이러한 문제 재정의에 기반한다. 새 알고리즘을 배웠거나 최신 C++ 기능을 사용할 수 있게 되었다는 이유만으로 문법을 바꾸는 것이 리팩터링의 전부는 아니다. 시간이 지나며 문제에 대한 이해가 달라졌다면, 현재 코드를 그 새로운 이해에 맞춰 재구성해야 한다. 커피 메이커에서 출발한 구현이 어느새 주스 제조기의 역할을 하고 있다면, 기존 설계가 여전히 적절한지부터 물어야 한다는 비유가 이를 압축한다.
Caisse는 재구성된 예제가 테스트 용이성, 변경 용이성, 이해 용이성에서 유리하고 생성 코드도 적어도 나쁘지 않을 것이라고 평가한다. 다만 제공 문서만으로는 비교 대상 코드의 전체 구조나 성능 결과를 확인할 수 없다. 보안성에 대한 설명 역시 코드가 읽기 쉬우면 자동으로 안전해진다는 보장이라기보다, 현재 상태에서 예상하지 못한 입력이 들어올 때 무엇이 일어나는지 검토하기 쉬워진다는 취지로 해석할 수 있다. 그가 의료 관련 작업에서 상태 머신을 선호했다고 설명하는 이유도 예외적인 입력과 상태의 조합을 명시적으로 사고할 수 있었기 때문이다.
CAN 메시지 — 비트 배치와 유효성 조건을 한곳에 모으기
서보 모터의 CAN 메시지 사례는 데이터 표현과 검증을 어떻게 결합할지 보여준다. Caisse가 설명하는 응답 메시지에는 명령 바이트, 모터 온도, 전압, 오류 상태 등이 들어 있다. 제공 문서에 따르면 전압은 16비트[?] 값으로 표현되며, 상태 정보는 특정 비트에 배치되어 있다. 그러나 정확한 비트 위치와 전압 범위는 제공 문서만으로 모두 확인할 수 없으므로, 이를 임의의 구조체나 파서 코드로 복원할 수는 없다.
그의 접근은 메시지가 필드를 가지고, 필드가 비트 구간에 대응한다는 데이터시트의 구조를 코드에서도 유지하는 것이다. 명령은 8비트 부호 없는 정수로, 전압은 앞서 설명한 정수 필드로 다루되, 상태는 단순한 불리언보다 의미가 드러나는 상태 타입으로 표현한다. 메시지 정의에는 명령 값이 특정 상수여야 한다는 조건과 전압이 추가적인 제약을 갖는다는 사실도 포함한다. 제공 문서의 명령 값 0xA9[?]는 원본 데이터시트와 코드로 재확인해야 한다. 핵심은 배치와 의미, 유효성 조건을 서로 떨어진 여러 처리 함수에 흩어 놓지 않는 데 있다.
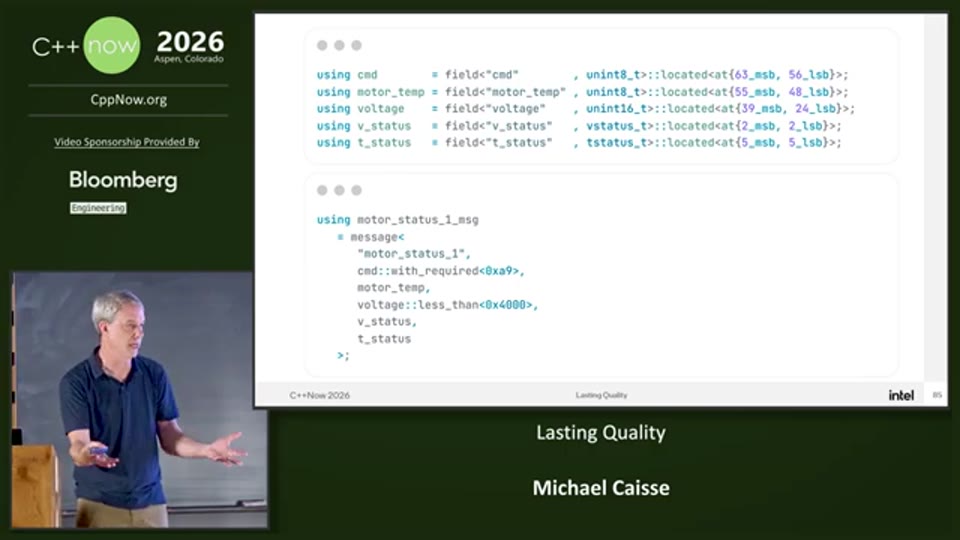
56:54 - CAN 모터 상태 메시지의 전압 필드에 비트 폭 외의 제약을 함께 정의하는 설명 구간
이렇게 메시지 정의가 마련되면 응용 로직은 비트 추출 방법보다 도메인의 상태를 다룰 수 있다. 강연에서는 전압 상태와 온도 상태가 모두 정상일 때의 처리, 저전압 또는 과온일 때의 처리를 콜백으로 표현한다. 읽는 사람은 마스크와 시프트 연산을 해석한 뒤 상태를 추론하는 대신, 어떤 상태에 어떤 행동이 연결되는지 직접 이해할 수 있다. 비트 조작과 형변환의 복잡성은 라이브러리 안으로 모이고, 그 구현을 사용하는 여러 사람이 같은 실수를 반복할 가능성도 줄어든다.
💡 [영상 참조] 56분 54초 부근에서는 메시지 정의에 전압 필드의 비트 폭 외에 추가 제약을 포함하는 문제를 설명한다. 정확한 비트 배치, 제약 값, 선언 문법은 원본 영상의 데이터시트와 코드를 확인해야 한다.
여기서 Caisse가 가장 분명하게 제시하는 원칙은 외부 데이터와 검증된 내부 데이터를 구분하는 것이다. 외부에서 들어온 비트열은 검증 대상이며, 시스템 내부는 검증을 통과한 데이터 타입을 다루도록 만들어야 한다. 그러면 각 소비자가 데이터의 정당성을 반복해서 판단하는 대신, 경계에서 성립한 조건을 전제로 도메인 작업을 수행할 수 있다. 이 구조에서 컴파일 타임에 메시지의 형태를 정의한다는 사실과, 실제 외부 입력을 검증해야 한다는 사실은 별개의 역할을 가지며 함께 필요하다.
질의응답에서 Caisse는 메시징 라이브러리가 비트 조작, 잘못된 캐스팅, 정수 승격(Integer Promotion)으로 인한 실수를 한곳에서 다루는 데 도움이 된다고 설명한다. 이는 복잡한 처리가 사라졌다기보다, 책임이 명확한 구현으로 모였다는 뜻이다. 그 구현의 정확성을 확보하면 각 응용 코드가 같은 저수준 문제를 다시 해결하지 않아도 된다. 제공 문서에서 메시지 라이브러리를 포함하는 프로젝트 명칭은 불명확하므로, 여기서는 특정 저장소 이름을 확정하지 않는다.
테스트를 시작하기 전에 방향을 알아야 한다는 주장
Caisse는 테스트 주도 개발(Test-Driven Development, TDD)에 비판적인 입장을 드러낸다. 그의 비판은 테스트를 작성하고 통과시키는 짧은 반복이, 문제의 구조를 충분히 재검토하지 않은 채 기능을 덧붙이는 방식으로 흐를 수 있다는 데 집중된다. 테스트를 추가하고 그 테스트를 통과할 만큼 구현한 다음, 리팩터링에서 현재의 문제를 다시 이해하는 작업을 생략하면 코드가 빠르게 뒤엉킬 수 있다는 것이다. 그는 자신이 TDD를 잘못 사용하고 있을 수 있다고 인정하면서도, 실제로 많은 코드베이스에서 리팩터링 단계가 충분히 수행되지 않는다고 주장한다.
이 부분을 테스트 자체에 대한 반대로 읽으면 강연의 나머지와 맞지 않는다. 그는 탐색과 연구를 통해 방향을 이해한 뒤에는 코드를 먼저 작성하고 테스트해도, 테스트를 먼저 작성하고 구현해도 된다고 말한다. 우선순위는 첫 테스트와 첫 구현 중 무엇이 먼저인가보다, 무엇을 만들려는지 이해하고 있는가에 있다. 탐색용으로 많은 코드를 작성할 수 있지만, 그것을 곧바로 최종 설계로 취급하지 않는 태도가 중요하다는 것이다.
그가 제시하는 대안에는 놀이와 실험도 포함된다. 당장 납품할 코드가 아닌 시도를 통해 도구의 가능성과 문제의 성격을 익히고, 그 경험이 실제 설계의 선택지를 넓힌다는 설명이다. 강연 후반에 소개하는 정책 주입 패턴도 동료가 실험하는 과정에서 나온 아이디어라고 말한다. 이 관점에서 엔지니어의 생산성은 코드를 얼마나 빨리 쓰는지만으로 판단할 수 없으며, 적절한 문제 표현을 찾는 시간이 구현과 유지보수 비용을 바꿀 수 있다.
하드웨어가 없을 때의 테스트는 설계 문제다
테스트 용이성을 설명하는 사례는 칩 내부 통신 구조와 원격 레지스터에서 출발한다. 하위 계층에는 하드웨어가 있고, 통신 드라이버는 MMIO(Memory-Mapped I/O)를 통해 이를 다룬다. 상위 계층에서는 멀리 있는 레지스터에 접근하는 개념으로 표현하되, 통신망을 거쳐 응답을 받아야 하므로 동작은 비동기적으로 진행된다. 이때 하드웨어가 아직 없다는 이유로 상위 기능의 테스트까지 모두 미룰 필요는 없다는 것이 Caisse의 주장이다.
그는 레지스터 라이브러리에 읽기와 쓰기의 대상을 대체할 수 있는 지점이 마련되어 있다고 설명한다. 드라이버와 가까운 계층에서 테스트 데이터를 제공할 수도 있고, 더 상위에서 레지스터 결과가 도착한 상황만 만들어 응용 로직을 검증할 수도 있다. 어떤 테스트는 하위 통신의 세부 사항을 포함해야 하지만, 다른 테스트는 그 아래를 모두 재현할 필요가 없다. 테스트 목적에 맞는 경계에서 대체 동작을 제공할 수 있도록 처음부터 설계해야 한다는 것이다.
베어메탈의 임계 구역(Critical Section)은 실행 환경의 차이를 보여주는 또 다른 사례다. Caisse가 설명하는 대상 환경에서는 인터럽트가 실행 흐름에 끼어들 수 있으므로, 임계 구역 동안 인터럽트를 비활성화하고 이후 인터럽트 상태를 복원하는 방식이 사용된다. 그러나 Linux에서 같은 코드를 시험할 때 응용 코드가 같은 방식으로 인터럽트를 제어할 수는 없다. 따라서 임계 구역의 의미와 구체적인 실행 수단을 분리할 필요가 생긴다.
그의 해법은 RAII(Resource Acquisition Is Initialization)로 수명에 묶인 처리를 표현하고, 동시성 라이브러리에 환경별 정책을 주입하는 것이다. 여기서 관심사는 최상위부터 모든 함수 호출을 거쳐 정책 객체를 전달하지 않고도, 라이브러리 차원에서 적절한 동작을 선택할 수 있게 하는 데 있다. 다만 이 사례는 강연자가 사용하는 베어메탈 실행 모델을 전제로 하므로, 인터럽트 제어만으로 모든 환경의 동시성 문제가 해결된다는 의미는 아니다. 강연의 일반화 가능한 원칙은 환경 의존적 동작의 교체 가능성을 테스트 설계의 일부로 확보하라는 것이다.
비동기 합성과 타입 — 무엇을 보장할 수 있는지 명시하기
CAN 수신 흐름의 예제에서는 모터 상태 메시지를 수신하고, 우선순위 5[?]에서 후속 작업을 이어 가며, 필요한 처리를 한 뒤 반복하는 구성이 제시된다. Caisse는 이 흐름을 Sender로 합성하고 start_detached로 시작하는 방식으로 설명한다. 여기서 중요한 것은 이벤트 수신, 실행 위치, 후속 동작, 반복이라는 의미가 하나의 조합된 흐름으로 읽힌다는 점이다. 정확한 API와 Sender 구현은 제공 문서에 제시되지 않으므로, 이를 특정 표준 버전의 기능과 동일한 것으로 단정하지 않는다.
이 구조는 테스트에도 연결된다. 메시지 수신 부분을 같은 합성 규칙에 맞는 테스트용 동작으로 대체할 수 있다면, 실제 CAN 장치가 없어도 후속 처리 흐름을 시험할 수 있다. 앞서 메시지의 의미와 형태가 정의되어 있으므로, 테스트 입력 역시 도메인 수준에서 만들 수 있다. Caisse는 이 사례를 쉽게 합성되고 동시성 문제를 피할 수 있는 방식으로 소개하지만, 제공 문서만으로 모든 수명 관리와 스케줄링 조건이 검증되었다고 말할 수는 없다.
그가 지향하는 것은 구성에 의한 정확성(Correct by Construction)이다. 어떤 조합이 유효한지를 타입과 라이브러리의 규칙으로 표현하면, 잘못된 프로그램의 일부를 실행 전에 거부할 수 있다. 그래프의 순환과 누락된 노드처럼 명시적으로 모델링한 문제는 테스트가 우연히 해당 경로를 실행하기를 기다릴 필요가 줄어든다. 이때 보장되는 범위는 타입과 검사에 담아 둔 성질이며, 시스템의 모든 동작이 컴파일 성공만으로 증명되는 것은 아니다.
Caisse 자신도 컴파일이 성공했을 때 신뢰할 수 있는 “일정한 성질들”이 생긴다는 방식으로 설명한다. 외부 입력이 올바른지, 하드웨어가 기대대로 동작하는지, 사용자의 실제 요구를 충족하는지는 다른 검증이 필요하다. 타입은 테스트와 경쟁하는 단일 해법이라기보다, 테스트가 맡기 전에 제거할 수 있는 오류를 구조적으로 차단하는 수단이다. 그는 이런 의미에서 TDD를 타입 주도 개발(Type-Driven Development)로 바꾸어 부르며 호감을 표현한다.
라이브러리 중심 사고와 사용자의 관점에서 시작하는 API
Caisse는 응용 프로그램을 라이브러리들의 결합으로 생각하라고 권한다. 기능 요청이 올 때마다 기존 코드에 덧붙이는 방식보다, 각각의 문제를 담당하는 구성요소를 분리하고 그것들을 연결하는 방식으로 시스템을 바라보라는 것이다. 그가 소개하는 응용 프로그램도 오픈소스 라이브러리와 내부 라이브러리, 소량의 연결 로직으로 구성된다. 라이브러리를 중심으로 생각하면 무엇이 그 구성요소의 책임이고 무엇이 밖에 있어야 하는지를 더 엄격하게 판단하게 된다는 설명이다.
이 주장은 반드시 외부 패키지를 많이 사용하라는 권고는 아니다. Caisse는 기존 라이브러리의 설계 철학이 맞지 않으면 직접 만들어도 된다고 말한다. 핵심은 문제를 정의 가능한 경계 안에 넣고, 독립적으로 시험하며, 다른 부분과 조합할 수 있는 형태로 만드는 데 있다. 강연에서 라이브러리 중심 사고의 장점으로 테스트 용이성, 확장성, 합성 가능성, 명확한 경계가 반복되는 이유다.
API 설계는 그 경계를 실제로 사용할 수 있게 만드는 과정이다. Caisse는 구현 방법을 확신하기 전에도 먼저 사용하고 싶은 API와 참고 문서를 작성한다고 설명한다. 선행 조건과 후행 조건, 기대하는 동작을 적고 작은 사용 예제를 반복해서 다듬으면, 겉으로는 그럴듯한 인터페이스가 필요한 두 가지 작업을 함께 지원하지 못한다는 사실을 발견할 수 있다. 이 단계에서는 구현자의 편의보다 소비자의 관점에서 문제를 바라보는 것이 중요하다.
질의응답에서는 DSL도 잘못 설계하면 일반 코드와 똑같이 읽기 어려워질 수 있다는 지적이 나온다. Caisse는 이를 인정하며, API가 이해와 의사소통을 좌우하기 때문에 반복적으로 수정해야 한다고 답한다. 추상화나 연산자 오버로딩을 도입했다는 사실 자체가 좋은 설계를 보장하지는 않는다. 실제 사용 과정에서 막히는 지점을 발견하고 개선하는 일이 필요하며, 강연에서 여러 차례 다시 설계한 로깅 라이브러리를 언급하는 것도 이 때문이다.
그는 조직과 저장소의 선택에도 같은 맥락 중심 사고를 적용한다. Conway의 법칙을 소개하며 라이브러리 관점, 도메인 관점, 고객 관점을 오가도록 권하고, 직접 만든 도구를 사용해 보는 도그푸딩(Dogfooding)을 강조한다. 모노레포에 대해서는 자신의 조직에 맞지 않는다는 강한 의견을 밝히지만, 설명의 근거는 조직별 작업 방식과 릴리스 방식의 차이에 있다. 유명한 조직의 선택을 복제하기보다, 현재 해결할 문제와 협업 구조에 맞는 선택을 해야 한다는 흐름이다.
실용주의와 구조적 품질의 보이지 않는 성과
강연의 실용주의는 이상적인 구조를 끝없이 추구하다 납품을 미루자는 주장을 경계한다. 기업은 실제 제품을 만들어 전달해야 하며, 현재의 시간과 역량 안에서 제한적인 구현을 선택할 수 있다. 다만 설계와 아키텍처에는 나아가려는 방향을 유지하고, 지금의 타협이 그 방향을 막지 않도록 해야 한다. N개의 경우를 어떻게 풀지 아직 모르더라도 우선 두 개를 지원하면서, 이후 확장할 경로를 마련하는 식이다.
Caisse는 구조적 품질이 좋아졌을 때 조직 안에서 생기는 역설도 설명한다. 변경이 예측 가능하고, 버그가 적고, 문제가 생겨도 빠르게 고칠 수 있으면 다른 팀은 그 팀이 맡은 일이 원래 쉬운 것이라고 생각할 수 있다. 하지만 겉으로 보이는 평온함은 문제의 부재가 아니라, 문제가 커지지 않도록 만든 설계의 성과일 수 있다. 장애를 수습하는 모습은 눈에 잘 띄지만, 발생하지 않게 만든 장애는 성과로 설명하기 어렵다는 것이다.
그가 강조하는 사업적 가치는 바로 그 반복 가능성에서 나온다. 품질을 유지하면서 더 많은 문제를 해결할 수 있고, 변경에 대한 신뢰가 쌓이면 팀은 사업의 안정적인 협력자가 된다. 이때 생산성 향상은 모든 엔지니어가 더 빠르게 타이핑해서 얻은 결과가 아니다. 복잡성을 다룰 위치를 정하고, 반복되는 실수를 공통 구현에서 해결하며, 잘못된 구성을 조기에 차단한 결과다.
강연 말미에 인용한 Tony Hoare의 설계 원칙도 같은 방향을 가리킨다. 결함이 없다는 점이 분명할 만큼 단순하게 만드는 일과, 너무 복잡해서 결함이 잘 보이지 않게 만드는 일은 다르다는 것이다. 전자는 어렵고 깊은 통찰을 요구하지만, Caisse는 바로 그 어려운 작업이 지속되는 품질의 기반이라고 본다. 구조적 품질을 높이는 노력은 나중의 반복 작업과 수습 비용을 줄이는 방식으로 보상된다.
마무리 / 핵심 정리
이 강연에서 추상화는 구현을 감추기 위한 장식이 아니라, 문제의 의미와 규칙을 코드 안에 담는 수단이다. 상태 머신은 상태와 이벤트의 관계를, 그래프는 실행 의존성을, 메시지 타입은 데이터의 배치와 제약을 드러낸다. 이렇게 표현한 개념은 이해하기 쉬워질 뿐 아니라, 라이브러리가 검사하고 테스트가 겨냥할 수 있는 명확한 대상이 된다. Caisse가 여러 C++ 라이브러리 사례를 통해 보여주려는 것은 바로 이 연결이다.
합성 가능성은 그 표현들을 변경에 강한 시스템으로 묶는 조건이다. 선택과 실행, 데이터 해석과 도메인 처리, 환경 의존적 동작과 응용 로직의 경계를 분리하면 각 부분을 이해하고 시험하기 쉬워진다. 이후 검증된 규칙에 따라 다시 연결하면, 기능을 추가할 때마다 시스템 전체를 다시 추론해야 하는 부담이 줄어든다. 컴파일 타임 추상화는 런타임과 메모리 비용을 늘리지 않는 형태로 구현될 수 있지만, Caisse는 그만큼 컴파일 시간의 비용이 생길 수 있다는 점도 명시한다.
강연 전체를 관통하는 기준은 특정 문법이나 개발 방법론에 대한 충성도가 아니다. 연산자 대신 함수 이름을 사용해도 되고, 외부 라이브러리 대신 내부 라이브러리를 만들어도 되며, 탐색 이후 테스트와 구현의 순서를 달리해도 된다. 중요한 것은 현재 해결할 문제의 본질을 다시 확인하고, 그 의도를 전달하며, 지켜야 할 규칙을 적절한 경계에 배치하는 것이다. 오래가는 품질은 그러한 구조 위에서 팀이 반복적으로 이해하고 변경하고 검증할 수 있을 때 만들어진다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Lasting Quality - Michael Caisse - C++Now 2026 |
| 채널 | CppNow |
| 강연자 | Michael Caisse |
| 원문에 기재된 STT 범위 | 00:00–88:35 |
| 리포트 작성 | 2026-09-23 |
| 작성 방식 | STT 기반 제공 리포트의 문맥 교정 및 불확실 수치·표현 표시 |
| 원본 대조 | 원본 STT·영상·음성 및 스크린샷 이미지 직접 대조는 수행하지 않음 |
| 외부 자료 검증 | 별도 수행하지 않음 |
강연에서 참고 대상으로 언급한 자료에는 Barry Boehm의 Software Engineering Economics, 단순함과 쉬움을 구분하는 Rich Hickey의 강연, 그리고 Types versus Tests가 있다. Dijkstra, Richard Hamming, Tony Hoare의 발언과 Conway의 법칙도 논지를 설명하는 데 사용된다. 이 리포트는 이들 자료의 원문을 별도로 검토하거나 독립적인 근거로 추가하지 않았으며, 강연자가 소개한 범위에서 의미를 정리했다. 화면에만 있는 수식과 코드, 출처의 세부 정보는 복원하지 않았다.
💬 본 리포트는 STT 기반 제공 문서를 검수한 결과다. [?]는 오류가 확정되었다는 뜻이 아니라 원본 대조가 필요하다는 표시다. 정확한 코드, 다이어그램, 수치의 적용 맥락은 원본 영상을 참조하기 바란다.
Related Reports
- Plato, Magritte, Sartre & Carroll - Learning Software Design from the Masters - Ben Deane - C++Now
- Code C++ Like a Library Author - Jon Kalb - C++Now 2026
- groov - Asynchronous Handling of Special Function Registers - Michael Caisse - CppCon 2025
- API Structure and Technique - Learnings from Code Review - Ben Deane - CppCon 2025
- When Abstractions Fix Too Much - Towards Flexible Library Design - Patrick Roberts - C++Now 2026