Better Expressiveness with Parallel Range Algorithms
📺 원본 영상: Lightning Talk: Better Expressiveness with Parallel Range Algorithms - Ruslan Arutyunyan 🎙️ 채널: CppCon 📅 정리 일자: 2026-04-21 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 슬라이드 및 코드는 포함되지 않을 수 있으며, 코드 예시는 강연자의 설명을 바탕으로 재구성한 것입니다.
개요
이 라이트닝 토크는 Ruslan Arutyunyan이 CppCon에서 발표한 본 강연의 마무리 부분을 독립적으로 진행한 세션이다. 핵심 주제는 단 하나의 구체적인 예제, 즉 문자열에서 단어 수를 세는 word_count 함수를 통해 C++17 방식과 Ranges 방식이 얼마나 다른 표현력을 가지는지를 대조적으로 보여주는 것이다. 강연자는 “단 두 슬라이드”로 이 차이를 명확하게 전달하겠다고 선언하며, 코드의 복잡도와 가독성 차이가 실제로 어느 정도인지를 직접적으로 체감하게 해준다.
C++17 방식 — transform_reduce의 어색함
단어 수를 세는 알고리즘의 핵심 아이디어는 인접한 두 문자를 비교하는 것이다. 구체적으로, 앞 문자가 알파벳이 아니고(!isalpha(s1)) 뒷 문자가 알파벳이면(isalpha(s2)), 그 위치가 새 단어의 시작임을 의미한다. 이 로직을 구현하려면 원본 텍스트에서 두 개의 범위가 필요한데, 하나는 마지막 문자를 제외한 범위이고 다른 하나는 첫 번째 문자를 제외한 범위다. 이 두 범위를 동시에 순회하면서 인접 쌍(pair)을 비교하는 구조다.
C++17에서 병렬로 이를 구현하기 위해 강연자는 std::transform_reduce를 std::execution::par 실행 정책(Execution Policy)과 함께 사용한다. 두 개의 이터레이터 범위를 받는 오버로드를 활용하는 방식이다. 그런데 강연자가 특히 재미있는 점으로 짚은 부분이 있다. transform_reduce의 인자 순서가 직관과 반대라는 것이다. 함수 이름은 “transform 후 reduce”이지만, 실제 인자 순서는 reduce 함수가 먼저, transform 함수가 나중에 온다. 초보자는 물론 숙련된 개발자도 헷갈리기 쉬운 인터페이스 설계다.
Transform 함수에서는 두 문자를 받아 새 단어의 시작이면 1, 아니면 0으로 변환하여 int로 반환한다. Reduce 단계에서는 이 int 값들을 모두 합산하여 최종 단어 수를 구한다. 강연자에 따르면 문자열의 경계 처리(corner case)가 추가로 필요하지만, 이 부분은 이 토크의 핵심이 아니라고 간략히 언급하고 넘어간다.
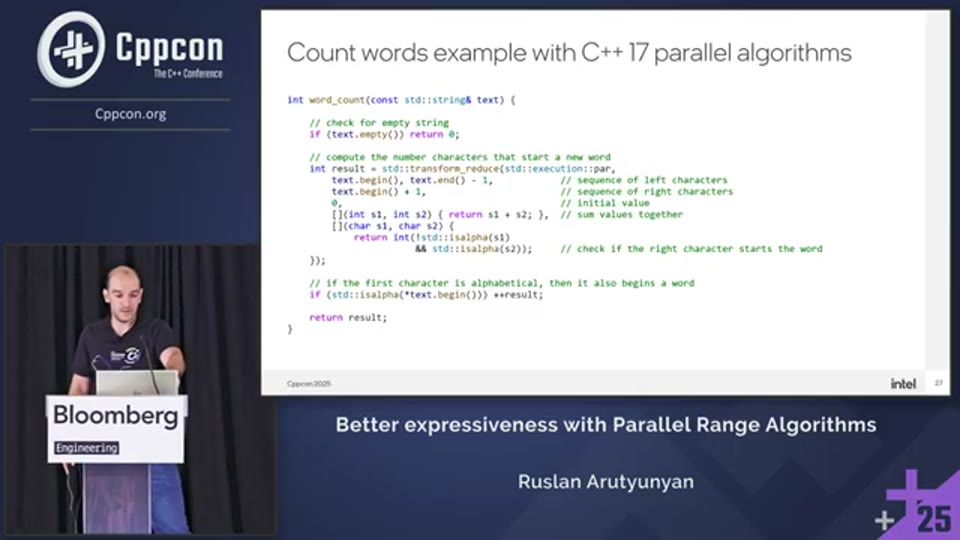
01:11 - transform_reduce를 std::execution::par 실행 정책과 함께 사용하는 C++17 word_count 코드 슬라이드
아래는 강연자의 설명을 바탕으로 재구성한 C++17 버전의 개념적 코드다.
// ⚠️ 재구성된 코드 — 원본은 원본 영상 참조
// https://www.youtube.com/watch?v=UavZbFgSuUc

int word_count(const std::string& text) {
    if (text.empty()) return 0;

    // 두 범위: [begin, end-1) 과 [begin+1, end)
    // transform_reduce는 reduce 함수가 먼저, transform 함수가 나중
    int count = std::transform_reduce(
        std::execution::par,
        text.begin(), text.end() - 1,   // 첫 번째 범위 (끝에서 하나 자름)
        text.begin() + 1,               // 두 번째 범위 (시작에서 하나 자름)
        0,                              // 초기값
        std::plus<>{},                  // reduce 함수 (먼저!)
        [](char s1, char s2) -> int {   // transform 함수 (나중!)
            return (!std::isalpha(s1) && std::isalpha(s2)) ? 1 : 0;
        }
    );

    // corner case: 첫 번째 문자가 알파벳이면 단어 하나 추가
    return count + (std::isalpha(text.front()) ? 1 : 0);
}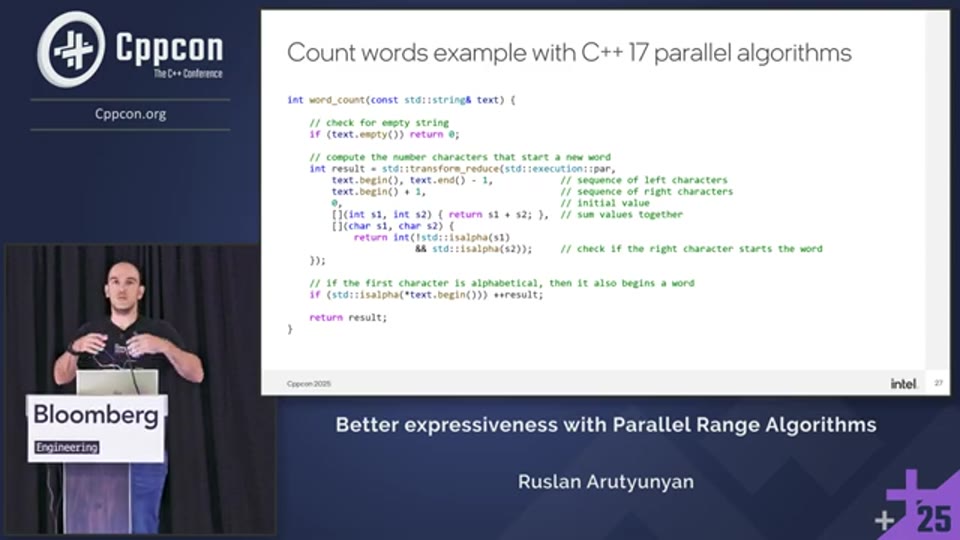
02:01 - transform 함수 람다 상세 설명 — !isalpha(s1) && isalpha(s2) 조건 및 int 변환 코드
Ranges 방식 — count_if와 zip의 자연스러움
Ranges를 도입하면 동일한 알고리즘이 의도를 훨씬 명확하게 드러내는 코드로 바뀐다. 강연자는 std::ranges::count_if를 사용한다고 언급하는데, 이름 그대로 “조건을 만족하는 원소의 수를 센다”는 의미가 알고리즘 선택 자체에서 이미 드러난다. transform_reduce처럼 “변환하고 합산한다”는 우회적인 표현이 필요 없어지는 것이다.
두 개의 인접 범위를 만들기 위해서는 std::views::zip을 활용한다. 강연자의 설명에 따르면, 텍스트에 take 뷰를 파이프(|)로 연결한 것과, 텍스트에 drop 뷰를 파이프로 연결한 것을 zip으로 묶어 인접 문자 쌍의 범위를 만든다. zip이 두 범위 중 더 짧은 것에 자동으로 맞춰지므로, C++17 버전에서 수동으로 begin+1, end-1로 범위를 조정했던 번거로움이 사라진다.
count_if에 넘기는 람다(lambda)에서도 표현력의 차이가 드러난다. zip 뷰가 생성하는 원소는 두 문자에 대한 참조를 담은 튜플(tuple)이다. Ranges의 구조적 바인딩(structured binding)을 통해 이를 s1, s2로 자연스럽게 언팩(unpack)할 수 있고, 반환 타입도 억지로 int로 변환할 필요 없이 의미에 맞는 bool로 그대로 반환할 수 있다. “이 위치가 새 단어의 시작인가?”라는 질문에 true/false로 답하는 것이 1/0의 정수 합산보다 훨씬 직관적이다.
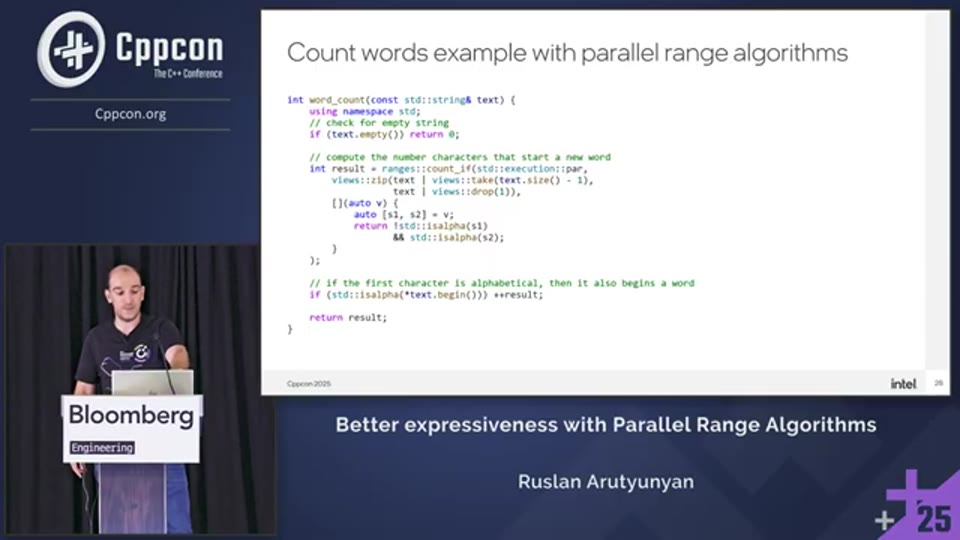
02:43 - Ranges 버전 코드 슬라이드 — count_if와 zip(text|take, text|drop) 구조 전체
아래는 강연자의 설명을 바탕으로 재구성한 Ranges 버전의 개념적 코드다.
// ⚠️ 재구성된 코드 — 원본은 원본 영상 참조
// https://www.youtube.com/watch?v=UavZbFgSuUc

int word_count(const std::string& text) {
    // zip: (text | take(n-1)) 과 (text | drop(1)) 을 묶어 인접 쌍 생성
    auto adjacent_pairs = std::views::zip(
        text | std::views::take(text.size() - 1),
        text | std::views::drop(1)
    );

    int count = std::ranges::count_if(
        adjacent_pairs,
        [](auto&& pair) {
            auto [s1, s2] = pair; // 구조적 바인딩으로 자연스럽게 언팩
            return !std::isalpha(s1) && std::isalpha(s2); // bool 반환
        }
    );

    return count + (std::isalpha(text.front()) ? 1 : 0);
}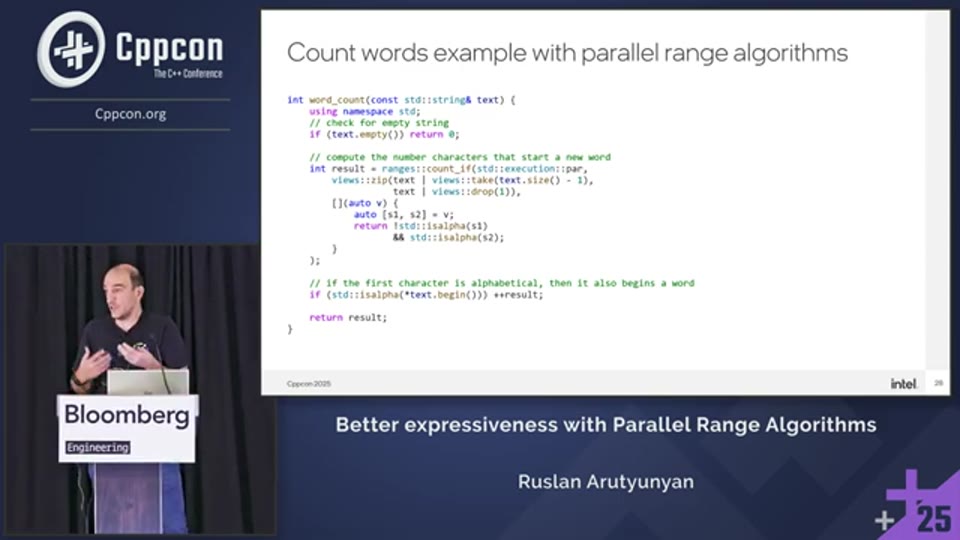
03:01 - Ranges 람다의 구조적 바인딩(s1, s2) 언팩 및 bool 반환 코드 클로즈업
두 방식의 핵심 차이 비교
강연자가 이 두 슬라이드로 전달하고자 한 메시지는 단순히 “Ranges가 짧다”가 아니다. 같은 알고리즘적 의도가 코드에 얼마나 직접적으로 드러나느냐, 즉 표현력(Expressiveness)의 문제다.
| 비교 항목 | C++17 (transform_reduce) | Ranges (count_if + zip) |
|---|---|---|
| 알고리즘 선택 | 우회적 (변환+합산으로 카운팅 구현) | 직접적 (count_if = 세기) |
| 범위 구성 | 수동으로 begin+1, end-1 조정 | zip + take/drop 뷰 |
| 인자 순서 | reduce 먼저, transform 나중 (역직관적) | 없음 (파이프라인으로 해결) |
| 반환 타입 | int 변환 필요 | bool 그대로 반환 |
| 의도 명확성 | 구현 세부사항이 노출됨 | 의도가 코드 자체에 드러남 |
마무리 — 표현력이 왜 중요한가
Ruslan Arutyunyan이 이 짧은 토크에서 전달한 핵심은, 병렬 Ranges 알고리즘이 단순히 C++17 병렬 알고리즘의 “더 짧은 버전”이 아니라는 점이다. transform_reduce는 C++17 당시 병렬 카운팅을 위한 사실상 유일한 표준적 수단이었고, 그 때문에 개발자는 “단어를 세겠다”는 의도를 “변환하고 합산하겠다”는 구현으로 번역해야 했다. 그 번역 과정에서 인자 순서의 혼동, int 강제 변환, 수동 범위 조정 같은 불필요한 인지 부하가 발생한다.
Ranges는 이 번역 계층을 제거한다. count_if는 세겠다는 의미이고, zip은 묶겠다는 의미이며, 람다는 조건을 표현한다. 코드를 읽는 사람이 “이게 무엇을 하는 코드인가”를 파악하기 위해 머릿속에서 역번역을 할 필요가 없어진다. 강연자가 이 예제를 선택한 이유도 바로 여기에 있다. 기능적으로 완전히 동일한 두 코드가 독자에게 주는 인지적 부담의 차이가 이처럼 극명하기 때문이다.
📚 참고 자료 (강연 내용과 별개)
강연 내용을 더 깊이 이해하는 데 도움이 될 수 있는 표준 문서 및 관련 자료들이다. 이는 강연자가 직접 언급한 자료가 아니라, 관련 학습을 위한 추가 참고용이다.
std::transform_reduce(cppreference):std::execution정책과 함께 사용하는 C++17 병렬 알고리즘std::ranges::count_if(cppreference): Ranges 기반 카운팅 알고리즘std::views::zip(cppreference): C++23에서 표준화된 zip 뷰 (두 범위를 쌍으로 묶음)- P2387 — Pipe support for user-defined range adaptors: Ranges 파이프라인 설계의 배경
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Lightning Talk: Better Expressiveness with Parallel Range Algorithms |
| 채널 | CppCon |
| 리포트 작성 | 2026-04-21 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Lambdas, Ranges and trivially_copyable - Why This Matters for Parallel Algorithms - Ruslan Arutyunyan
- Lightning Talk: Execution Policies: Not a Forward Progress Guarantee - Ruslan Arutyunyan
- Back to Basics: C++ Concepts - Jeff Garland - CppCon 2025
- Back to Basics: How To Improve C++ Code Reviews - Chandranath Bhattacharyya & Kathleen Baker
- Can Standard C++ Replace CUDA for GPU Acceleration? - Elmar Westphal - CppCon 2025