OpenRAG: 오픈소스 RAG 스택의 새로운 기준
📺 원본 영상: OpenRAG: An open-source stack for RAG — Phil Nash 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-08 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드, 데모 UI 등)는 포함되지 않을 수 있습니다.
개요
IBM의 Developer Relations 엔지니어 Phil Nash는 이 강연에서 “RAG는 해결됐다”는 업계의 안이한 인식에 정면으로 반박하며, 실전에서 RAG 시스템을 구축할 때 마주치는 구체적인 난제들을 짚어낸다. 그리고 그 해법으로 IBM이 주도하는 오픈소스 프로젝트 OpenRAG를 소개한다. OpenRAG는 문서 처리 엔진 Dockling, 검색 인덱싱 엔진 OpenSearch, 그리고 시각적 에이전트 오케스트레이터 Langflow라는 세 가지 기존 오픈소스 프로젝트를 하나의 통합 스택으로 묶어낸 결과물로, 고품질의 RAG 베이스라인을 누구나 쉽고 빠르게 구축할 수 있도록 설계되어 있다.
”RAG는 해결됐다”는 말의 함정
업계에서는 종종 “RAG는 이미 끝난 문제”라는 주장이 나온다. 컨텍스트 윈도우가 수백만 토큰 규모로 커진 지금, 데이터를 통째로 프롬프트에 집어넣으면 되지 않느냐는 논리다. Phil Nash는 이에 대해 냉소적이다. 만약 모든 비즈니스가 백만 토큰도 안 되는 데이터를 가지고 있다면 그 말이 맞을지도 모르지만, 현실에서 그런 기업은 거의 없다는 것이다. 게다가 질문 하나를 던질 때마다 수백만 토큰 규모의 입력 비용을 지불하는 것에 기꺼이 동의할 사람도 많지 않다.
그보다 더 미묘한 문제는 “RAG의 프로세스는 알겠다”는 과신에서 비롯된다. 비정형 데이터를 모으고, 텍스트를 추출하고, 청킹(Chunking)하고, 임베딩(Embedding)한 뒤 벡터 데이터베이스에 저장하고, 질문이 들어오면 유사 청크를 검색해 LLM에 컨텍스트로 넘기는 파이프라인은 누구나 안다. 하지만 Phil Nash가 강조하는 것은, 실제로 잘 동작하는 RAG 시스템을 만드는 것은 전혀 다른 이야기라는 점이다.
PDF 파싱은 여전히 악명 높은 난제이고, 임베딩 전략은 선택과 실험이 까다롭다. 임베딩 모델 자체도 계속 발전하기 때문에, 6개월 전에 선택한 모델이 이미 구식이 되어버리는 상황도 드물지 않다. 여기에 청크에 요약을 붙이는 기법, 청크 확장(Chunk Expansion), 크로스 인코더를 이용한 리랭킹(Reranking), 쿼리 재작성(Query Rewriting) 등 파이프라인을 개선할 수 있는 기법들이 끊임없이 등장하고 있어 RAG의 복잡도는 오히려 증가하고 있다. 게다가 모든 조직의 문서는 다르고, 사용자도 다르고, 질문 패턴도 다르기 때문에 보편적으로 최적인 단일 RAG 시스템이란 존재하지 않는다.
OpenRAG의 설계 철학 - 좋은 베이스라인
Phil Nash가 제안하는 해법은 처음부터 완벽한 시스템을 만들려 하지 말고, 품질 높은 베이스라인에서 출발하여 점진적으로 커스터마이징하는 것이다. 모든 RAG 시스템에 공통적으로 필요한 핵심 컴포넌트들은 분명히 존재하며, 그것들을 잘 통합된 형태로 제공하는 것이 OpenRAG의 역할이다. IBM은 지난 2년간 AI 및 RAG 관련 도구들을 개발하면서 Dockling, OpenSearch, Langflow라는 세 오픈소스 프로젝트를 조합하면 이 목표를 달성할 수 있다는 결론에 이르렀고, OpenRAG 0.4.0을 공개 버전으로 내놓은 상태다.
Dockling - 문서를 이해하는 엔진
왜 문서 처리가 어려운가
RAG 파이프라인에서 가장 먼저 부딪히는 벽은 원본 문서를 텍스트로 변환하는 과정이다. HTML이나 Markdown 같은 형식은 비교적 다루기 쉽지만, 기업 현장에서 가장 흔한 문서 형식인 PDF는 그야말로 RAG 시스템의 천적이다. 표, 이미지, 다단 레이아웃, 스캔 문서 등이 뒤섞인 PDF를 정확하게 파싱하는 것은 단순한 텍스트 추출과는 차원이 다른 문제다.
Dockling의 구조와 파이프라인
Dockling은 IBM Research 취리히 연구소에서 탄생한 오픈소스 문서 처리 프로젝트로, HTML, Markdown, Word 문서는 물론 슬라이드, 스프레드시트, 오디오, 비디오, 그리고 PDF까지 광범위한 파일 형식을 처리할 수 있다. 이 다양성을 가능하게 하는 핵심 설계는 파일 유형별로 특화된 파이프라인을 두는 것이다.
Markdown, HTML, Word처럼 비교적 단순한 텍스트 문서에는 **심플 파이프라인(Simple Pipeline)**이 적용된다. 이 파이프라인은 텍스트를 추출해 계층적 구조로 변환한 뒤 문서 객체로 출력한다. 오디오와 비디오는 ASR(Automatic Speech Recognition) 파이프라인을 통해 처리된다. PDF를 위해서는 두 가지 선택지가 제공된다.
**표준 파이프라인(Standard Pipeline)**은 레이아웃 분석, 표 추출, 이미지 추출 및 설명 등 각각의 작업에 특화된 소규모 모델들의 집합으로 구성된다. 스캔된 문서처럼 실제 텍스트 레이어가 없는 PDF를 처리하기 위한 OCR 백엔드도 선택적으로 사용할 수 있다.
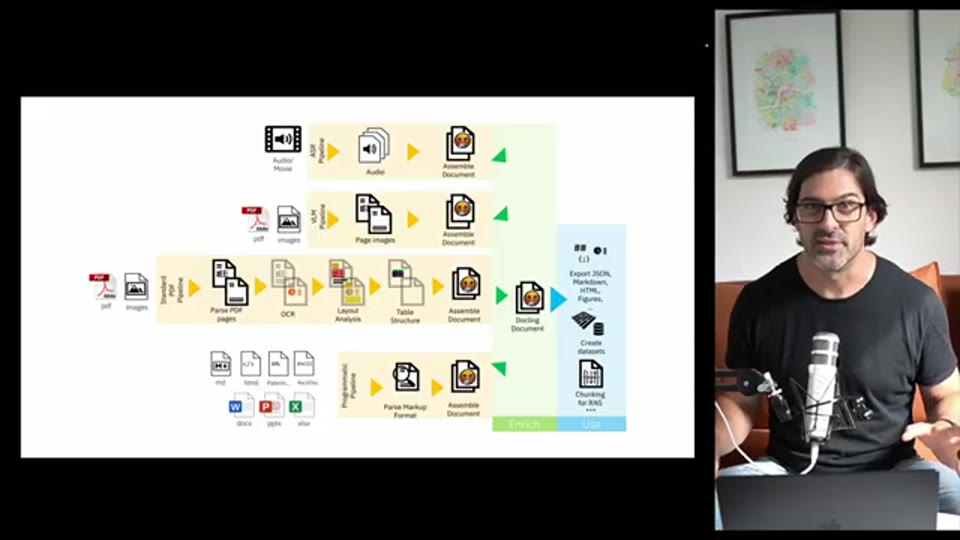
04:15 - Dockling의 표준 파이프라인 구성 - 레이아웃 분석, 표 추출, 이미지 추출 등 소규모 특화 모델들의 파이프라인 구조
한편 VLM(Vision Language Model) 파이프라인은 이 모든 작업을 하나의 모델로 수행한다. IBM이 공개한 2억5800만 파라미터 규모의 Granite Dockling 비전 모델이 이 파이프라인의 핵심으로, 문서 처리에 특화된 훈련을 받은 모델이기 때문에 파이프라인 구성이 단순하다는 장점이 있다. 다만 이 파이프라인은 아직 비교적 최신 기능이다.
DocTags와 계층적 청킹
💡 [영상 참조] 강연자는 이 시점에서 Dockling의 문서 변환 흐름을 도식화한 슬라이드를 보여주며 설명합니다. 📺 원본 영상에서 확인하세요.
Dockling이 문서를 파싱하고 나면, 그 결과물은 곧바로 최종 출력 형식으로 가지 않는다. 대신 먼저 중간 표현(Intermediate Representation) 형태인 “Dockling Document”로 변환된다. 이 중간 문서는 문서의 구조를 모델링하는 XML 계열의 포맷인 DocTags로 표현되며, 이로부터 Markdown, HTML, JSON 등 다양한 출력 형식으로 변환이 가능하다.
RAG에서 특히 중요한 것은 Dockling의 청킹 방식이다. Dockling의 내장 청커는 파서가 DocTags에 녹여낸 문서의 계층 구조를 활용하여 청크를 생성한다. 단순히 글자 수나 토큰 수를 기준으로 잘라내는 방식과 달리, 문서의 섹션, 제목, 단락 등 의미 단위의 경계를 존중하는 청킹이 가능해지는 것이다. 이는 검색 품질에 직접적인 영향을 미치는 핵심 차별점이다.
OpenSearch - 검색의 심장
유연한 벡터 및 키워드 검색
임베딩된 청크들은 OpenSearch에 인덱싱된다. OpenSearch는 Elasticsearch의 오픈소스 포크로서, 벡터 검색과 키워드 검색을 모두 지원하며 강력한 필터링과 집계(Aggregation) 기능을 갖추고 있다. OpenRAG는 기본적으로 벡터 검색과 키워드 검색을 결합한 하이브리드 검색을 사용하며, 이를 통해 의미적 유사도와 정확한 키워드 매칭을 동시에 활용한다.
05:43 - OpenSearch 소개 - 벡터 및 키워드 검색, 하이브리드 검색 구조 설명 슬라이드
OpenRAG는 임베딩 프로바이더에 대해 특별히 고집하지 않는다는 것도 설계상의 특징이다. OpenAI, WatsonX AI(IBM의 AI 플랫폼), 그리고 로컬 호스팅을 위한 Ollama까지 여러 외부 프로바이더를 지원하며, Dockling 자체도 오프라인으로 실행 가능하기 때문에 OpenRAG 스택 전체를 에어갭(Air-gap) 환경에서 완전히 오프라인으로 운영하는 것도 가능하다. 특히 OpenSearch가 다중 임베딩 모델을 동시에 지원하는 것은, 임베딩 모델 마이그레이션이 필요한 상황에서 유용하게 쓰인다. 벡터 검색 속도가 다소 느려지는 트레이드오프가 있지만, 전체 인덱스를 재구성하지 않고도 모델 전환이 가능해진다는 것은 운영 측면에서 큰 이점이다.
JVector - 인메모리 한계를 넘는 벡터 인덱스
OpenRAG에는 네 번째 오픈소스 컴포넌트가 조용히 포함되어 있다. OpenSearch의 기본 최근접 이웃(KNN) 플러그인이 HNSW(Hierarchical Navigable Small World)나 IVF(Inverted File Index) 기반의 벡터 인덱스를 제공하는 반면, OpenRAG는 기본값으로 JVector KNN 플러그인을 사용한다.
JVector는 오픈소스 벡터 인덱스로, **라이브 인덱싱(Live Indexing)**을 지원한다는 점이 핵심이다. 인덱스를 재구성하거나 서비스를 중단하지 않고도 실시간으로 새로운 벡터를 인덱스에 추가할 수 있다. 더 중요한 점은 JVector가 DiskANN(Disk-based Approximate Nearest Neighbors) 아키텍처를 기반으로 한다는 것이다. DiskANN 방식에서는 전체 인덱스가 메모리에 상주할 필요가 없어, 데이터 서버의 확장(Scaling) 옵션이 크게 넓어진다. 메모리 용량에 의해 인덱스 규모가 제한되는 기존 방식의 한계를 뛰어넘을 수 있는 것이다.
06:22 - JVector KNN 플러그인 소개 - DiskANN 아키텍처 기반 벡터 인덱스 특징
Langflow - 모든 것을 연결하는 오케스트레이터
Dockling의 문서 처리, OpenSearch의 인덱싱, 임베딩 모델 연동, 그리고 에이전트 기반의 생성(Generation) 파이프라인까지 이 모든 것을 하나로 엮어주는 것이 Langflow다. Langflow는 AI 플로우를 위한 드래그 앤 드롭(Drag-and-Drop) 방식의 시각적 편집기로, 복잡한 파이프라인을 코드 없이 구성하고 시각적으로 확인할 수 있게 해준다.
OpenRAG의 맥락에서 Langflow는 인제스천(Ingestion) 파이프라인과 에이전트 생성 플로우 양쪽 모두를 담당한다. 인제스천 쪽에서는 Dockling, OpenSearch, 임베딩 모델, 그리고 데이터 보강(Data Enrichment) 처리를 통합한 플로우를 제공하고, 생성 쪽에서는 사용자 질의를 받아 에이전트가 다양한 도구를 활용해 검색하고 응답하는 플로우를 구성한다. 사용할 수 있는 LLM도 Langflow를 통해 OpenAI, Anthropic, Ollama, WatsonX AI 등 다양한 선택지가 열려 있다.
에이전틱 검색 - 전통적 RAG를 넘어서
전통적 RAG의 한계
전통적인 RAG 생성 파이프라인은 직선적이다. 사용자 쿼리를 임베딩하고, 벡터 데이터베이스에서 가장 가까운 청크 K개를 검색하고, 이를 LLM에 컨텍스트로 전달해 답변을 생성하는 구조다. 이 방식의 약점은 단 한 번의 검색으로 충분한 컨텍스트를 확보해야 한다는 점이다. 질문의 의도가 복잡하거나 답변이 여러 문서에 흩어져 있다면, 이 방식은 쉽게 한계를 드러낸다.
에이전틱 검색의 작동 방식
OpenRAG는 이에 대한 대안으로 **에이전틱 검색(Agentic Retrieval)**을 채택한다. 이 방식에서는 사용자 쿼리가 직접 임베딩 검색으로 이어지지 않는다. 대신 쿼리가 **에이전트(Agent)**에게 전달되고, 에이전트는 주어진 지침(Instructions)과 도구(Tools)를 바탕으로 필요한 만큼 반복적으로 검색을 수행할 수 있다. 몇 번 검색할지, 어떤 키워드로 검색할지, 검색 결과를 어떻게 해석하고 조합할지 등 모든 판단을 모델 자체가 담당한다.
OpenRAG의 기본 에이전트 도구 세트에는 외부 URL의 문서를 즉석에서 인제스천하는 MCP 서버 기반 URL 인제스터, 그리고 계산기가 포함되어 있다. 계산기를 일부러 도구로 제공하는 것에 대해 Phil Nash는 “언어 모델은 수학 모델이 아니기 때문에 산술 계산은 도구에 맡기는 것이 맞다”고 설명한다. 마지막으로 OpenSearch의 멀티 모델 임베딩 검색 도구가 에이전트의 핵심 검색 수단으로 연결된다.
OpenRAG 데모 - 실제 작동 모습
Phil Nash는 자신의 노트북에서 실행 중인 OpenRAG를 직접 시연한다. 온보딩 과정을 마치면 채팅 인터페이스가 나타나며, 첫 질문으로 “OpenRAG는 무엇인가”를 입력하면 에이전트가 답변을 생성한다. 흥미롭게도 이 질문에 대한 답변은 에이전트의 프롬프트에 이미 포함되어 있어 검색이 필요 없었지만, 에이전트는 혹시 모를 경우를 대비해 현재 날짜를 조회하는 도구 호출도 수행했다. 이처럼 에이전트가 스스로 판단해 필요한 도구를 선택적으로 호출하는 모습이 에이전틱 RAG의 특성을 잘 보여준다. 응답과 함께 제공되는 “다음 질문 제안” 기능도 Langflow 플로우를 통해 구동된다.
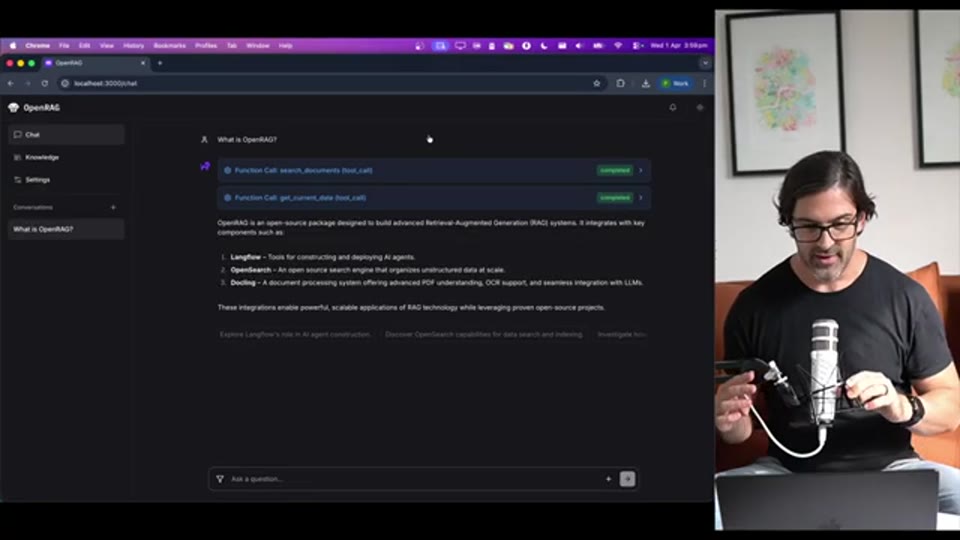
08:19 - OpenRAG 데모 시작 - 온보딩 후 채팅 인터페이스 첫 화면 및 에이전트 도구 호출 결과
지식(Knowledge) 섹션에서는 문서를 업로드하고 관리할 수 있다. 파일 단위 또는 폴더 단위로 업로드가 가능하며, 업로드된 문서의 청크 단위 내용도 직접 확인할 수 있다. 특히 지식 필터(Knowledge Filter) 기능이 눈에 띄는데, OpenSearch의 필터링 기능을 활용해 특정 문서 그룹에만 검색 범위를 한정하는 필터를 생성할 수 있다. 이를 통해 채팅 시 원하는 문서 집합에만 질문을 던지는 것이 가능해진다.
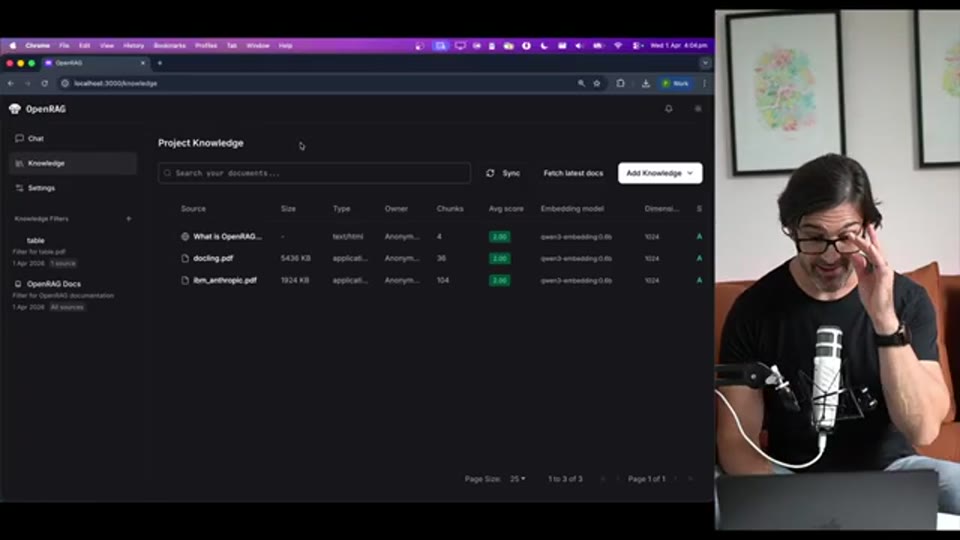
09:30 - Knowledge 섹션 - 문서 업로드, 청크 확인, 지식 필터 생성 화면
설정(Settings) 섹션에서는 클라우드 커넥터를 구성할 수 있다. Google OAuth를 통한 인증 설정이 완료되면 Google Drive, SharePoint, OneDrive와 연동해 사용자의 클라우드 문서를 OpenRAG와 직접 동기화할 수 있다. 파일을 일일이 업로드하지 않고도 외부 문서 저장소와 항상 최신 상태를 유지할 수 있다는 점에서 실용성이 높다. Phil Nash가 시연하는 환경에서는 LLM으로 Ollama의 Granite3 4B(IBM의 오픈소스 언어 모델)를, 임베딩 모델로 Ollama의 Qwen3 Embedding 0.6B를 로컬에서 실행하고 있다. OCR 처리와 이미지 설명 추출 기능은 파이프라인에 추가 모델이 필요해 속도가 느려지므로 기본값은 비활성화 상태이다.
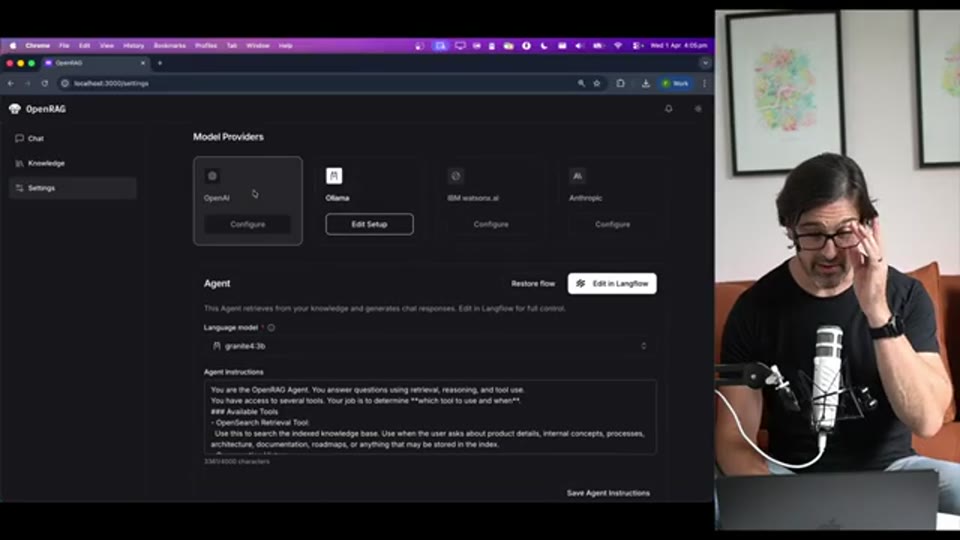
10:55 - Settings 섹션 - 모델 프로바이더 구성 및 Ollama 로컬 모델(Granite3 4B, Qwen3 Embedding 0.6B) 설정 화면
Langflow 편집기를 통한 심층 커스터마이징
OpenRAG의 설정 UI에서 한 단계 더 들어가면, Langflow의 시각적 편집기에서 에이전트 플로우 자체를 직접 수정할 수 있다. 플로우 편집기에서는 채팅 입력이 프롬프트 템플릿을 거쳐 에이전트로 연결되는 전체 흐름이 시각화되어 있으며, 각 노드를 드래그 앤 드롭으로 추가하거나 연결을 변경할 수 있다.
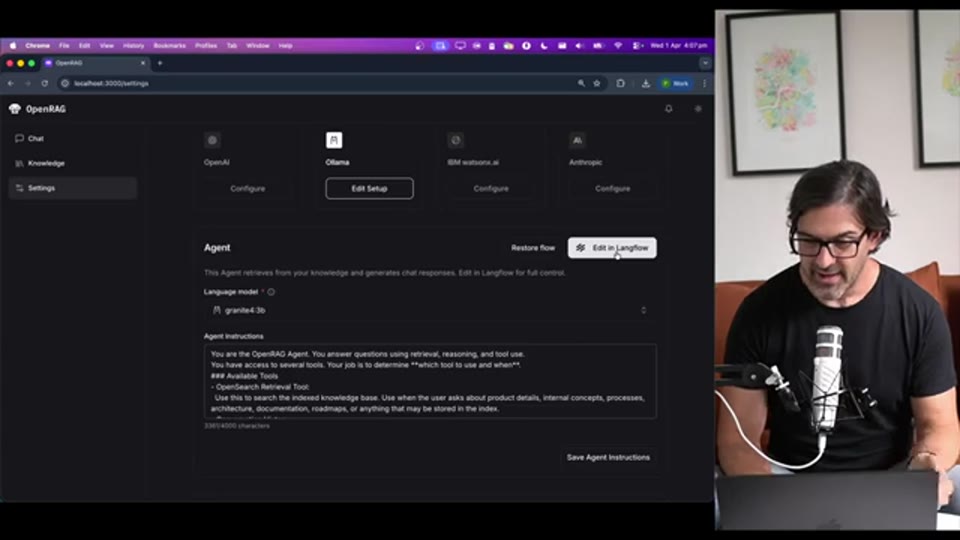
12:08 - Langflow 편집기 - 에이전트 생성 플로우 전체 구조 (채팅 입력 → 프롬프트 템플릿 → 에이전트 → 도구들)
Phil Nash는 실시간으로 이 편집기에서 가드레일(Guardrails) 컴포넌트를 플로우에 추가하는 과정을 시연한다. 채팅 입력 노드와 프롬프트 템플릿 사이에 가드레일 컴포넌트를 삽입하고, 가드레일 통과 시 원래 텍스트를 파서를 통해 추출해 다음 단계로 전달하고, 실패 시에는 에러 메시지를 채팅 출력으로 내보내는 구성을 몇 단계만으로 완성한다. OpenRAG의 확장성은 결국 Langflow가 허용하는 모든 것으로 이어지며, 이는 단순한 구성 변경을 넘어 파이프라인 아키텍처 수준의 변경도 가능함을 의미한다.
OpenRAG는 REST API와 함께 MCP(Model Context Protocol) 서버도 함께 제공한다. 이를 통해 OpenRAG의 검색 및 에이전트 기능을 외부 애플리케이션에서 호출하거나, 다른 에이전트에게 도구로 제공하는 것도 가능하다.
기술 스택 요약
| 컴포넌트 | 역할 | 주요 특징 |
|---|---|---|
| Dockling | 문서 처리 및 청킹 | 다양한 파일 형식 지원, DocTags 계층 구조, 오프라인 실행 가능 |
| OpenSearch | 벡터 및 키워드 인덱싱 | 하이브리드 검색, 다중 임베딩 모델 지원, 지식 필터 |
| JVector | 벡터 인덱스 | DiskANN 기반, 라이브 인덱싱, 인메모리 한계 초과 가능 |
| Langflow | 오케스트레이션 | 시각적 플로우 편집, 에이전틱 생성 파이프라인 |
마무리 - RAG는 해결됐는가
Phil Nash의 답은 명확하다. RAG가 해결됐는지는 각 팀의 데이터와 사용자에 달려 있다. 보편적으로 완성된 RAG 솔루션은 없다. 다만 OpenRAG는 그 출발점을 크게 앞당겨 준다. Dockling, OpenSearch, Langflow라는 세 오픈소스 프로젝트를 조합한 이 스택은 의견이 녹아있되(Opinionated) 에이전틱이며 완전히 오픈소스인 RAG 베이스라인을 제공하고, 동시에 각 팀이 자신의 데이터와 사용자에 맞게 커스터마이징할 수 있는 여지를 충분히 남겨둔다. 버전 0.4.0으로 이미 공개된 상태이며, 프론트엔드는 Next.js 애플리케이션으로, 나머지는 Python 기반으로 구성되어 있어 코드 기여도 환영한다. OpenRAG 자체뿐만 아니라 Dockling, OpenSearch, Langflow 각 컴포넌트 프로젝트에 대한 기여도 에코시스템 전체를 강화하는 길이라고 강연자는 말한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | OpenRAG: An open-source stack for RAG — Phil Nash |
| 채널 | AI Engineer |
| 강연자 | Phil Nash (Developer Relations Engineer, IBM) |
| 리포트 작성 | 2026-04-08 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- What Breaks When You Build AI Under Sovereignty Constraints - Bilge Yücel, deepset GmbH
- Harnesses in AI - A Deep Dive — Tejas Kumar, IBM
- Paperclip - Open Source Human Control Plane for AI Labor — Dotta Bippa
- Benchmarking semantic code retrieval on Claude Code — Kuba Rogut, Turbopuffer
- Mergeable by default - Building the context engine to save time and tokens - Peter Werry, Unblocked