Gemma 4 완전 해부 — Google DeepMind가 공개한 오픈 모델의 기술 내부
📺 원본 영상: Open Models at Google DeepMind — Cassidy Hardin, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-28 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(아키텍처 다이어그램, 벤치마크 차트, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Google DeepMind의 연구원 Cassidy Hardin은 2025년 공개된 Gemma 4 모델 패밀리의 기술적 설계 결정들을 상세히 설명한다. 이 강연은 단순한 성능 발표를 넘어, 어텐션 레이어 설계, Mixture of Experts(MoE) 아키텍처, 온디바이스 최적화를 위한 Per Layer Embedding(PLE), 그리고 비전과 오디오를 포함한 멀티모달 파이프라인의 동작 원리를 구체적으로 다룬다. Gemma 4는 온디바이스용 소형 모델부터 복잡한 에이전틱 워크플로우를 위한 대형 모델까지 네 가지 크기로 제공되며, Apache 2.0 라이선스로의 전환을 통해 상업적 활용 장벽을 낮춘 것이 핵심 변화 중 하나다.
Gemma 4 패밀리 — 네 가지 모델의 포지셔닝
Gemma 4는 단일 모델이 아니라 서로 다른 목적을 위해 설계된 네 가지 모델로 구성된 패밀리다. Hardin은 이를 크게 두 계층으로 설명한다. 첫 번째 계층은 온디바이스 애플리케이션을 겨냥한 두 개의 “effective” 모델로, 스마트폰, iPad, 노트북에서 외부 API 호출 없이 직접 실행되도록 최적화되어 있다. 두 번째 계층은 복잡한 추론과 에이전틱 워크플로우를 위한 두 개의 대형 모델로 구성된다.
대형 모델 중 31B 밀집(dense) 모델은 LM Arena 글로벌 순위에서 3위를 기록했으며, 자신보다 20배 이상 큰 모델들을 능가하는 성능을 보였다고 Hardin은 강조한다. 256K 컨텍스트 길이를 지원하고, 사고(thinking), 함수 호출(function calling), 구조화된 JSON 출력을 네이티브로 지원하도록 설계되었다. 26B 모델은 Gemma 패밀리 최초의 MoE(Mixture of Experts) 모델로, 총 파라미터는 26B이지만 실제 추론 시 활성화되는 파라미터는 약 3.8~3.9B에 불과해 효율성과 성능 사이의 균형을 추구한다. 두 대형 모델 모두 오픈 소스 모델 전체 리더보드 상위 6위 안에 진입했다고 밝혔다.
라이선스 측면에서는 Apache 2.0으로의 전환이 중요한 변화다. 이 결정은 개발자가 초기 프로토타이핑부터 프로덕션 배포까지 Gemma를 개발 사이클 전반에 걸쳐 자유롭게 통합할 수 있도록 하기 위한 의도적 선택이었다고 Hardin은 설명한다.
어텐션 아키텍처의 재설계 — 로컬-글로벌 인터리빙과 GQA
Gemma 4의 기술적 핵심 중 하나는 어텐션(attention) 메커니즘의 근본적인 재설계다. 기존의 트랜스포머 아키텍처에서 모든 레이어가 전체 컨텍스트에 어텐션하는 방식은 긴 시퀀스에서 메모리와 연산 비용이 폭발적으로 증가하는 문제를 야기한다. Gemma 4는 이를 해결하기 위해 로컬(local) 레이어와 글로벌(global) 레이어를 인터리빙(interleaving)하는 방식을 채택했다.
구체적으로, 31B와 26B 대형 모델에서는 로컬 대 글로벌 비율이 5:1로 설정되어 있고, 소형 Effective 2B 모델에서는 4:1 비율이 적용된다. 로컬 레이어는 슬라이딩 윈도우(sliding window) 방식으로 일정 범위의 선행 토큰만 참조하는데, 소형 모델에서는 512 토큰, 대형 모델에서는 1,024 토큰의 윈도우를 사용한다. 반면 글로벌 레이어는 모든 선행 토큰에 어텐션하며, 특히 마지막 레이어는 항상 글로벌 레이어로 고정되어 있어 시퀀스 전체 정보가 최종 출력에 반드시 반영되도록 보장한다. 이 설계는 대부분의 레이어에서 계산 비용을 절감하면서도 전체 컨텍스트 정보가 모델 전반에 흐를 수 있도록 하는 균형점을 찾은 것이다.
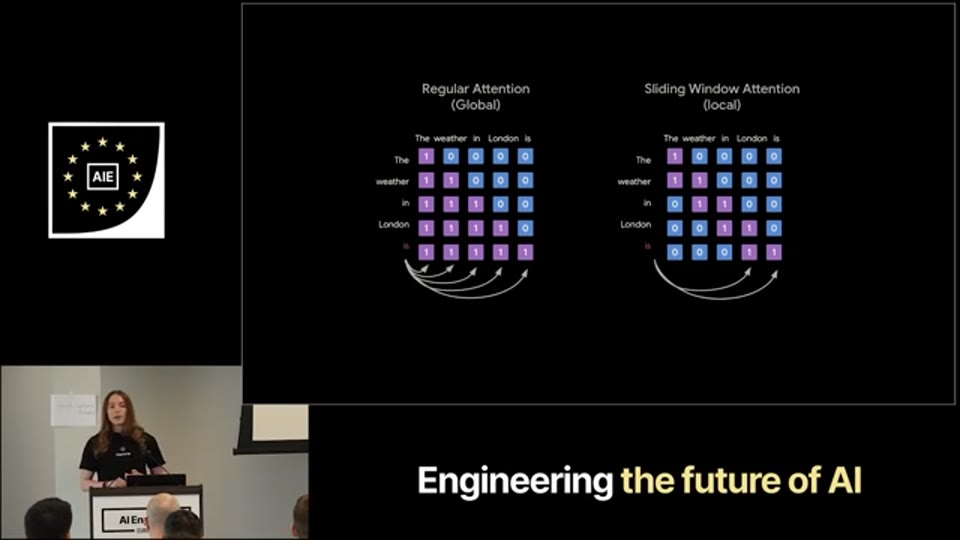
05:23 - 로컬-글로벌 어텐션 인터리빙 구조 설명 — 슬라이딩 윈도우 크기(소형 512, 대형 1,024 토큰)와 레이어 구성 다이어그램
그러나 글로벌 레이어는 여전히 모든 선행 토큰에 어텐션해야 하므로 메모리 집약적이고 비용이 높다. 이 문제를 완화하기 위해 도입된 것이 그룹 쿼리 어텐션(Grouped Query Attention, GQA)이다. 로컬 레이어에서는 2개의 쿼리가 동일한 키-값(key-value) 헤드를 공유하는 반면, 글로벌 레이어에서는 8개의 쿼리가 하나의 키-값 헤드를 공유한다. 키-값 헤드 수를 줄이면 성능에 영향을 줄 수 있으므로, 글로벌 레이어의 키-값 헤드 길이는 로컬 레이어의 256과 달리 512로 두 배 늘려 표현력을 보상했다. Hardin에 따르면, 이 8:1 쿼리 대 키-값 비율은 메모리 비용과 서빙 비용의 큰 증가 없이도 글로벌 레이어의 효율성을 크게 개선했다.
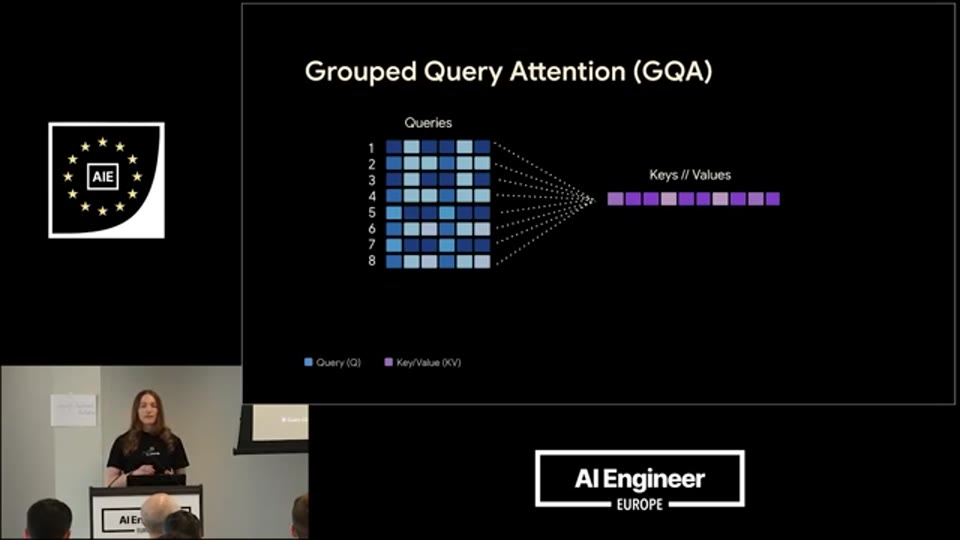
06:24 - 그룹 쿼리 어텐션(GQA) 설명 — 로컬 레이어 2:1, 글로벌 레이어 8:1 쿼리/키-값 비율 및 글로벌 레이어 키-값 헤드 길이 512 표기
MoE 아키텍처 — 26B 모델의 희소 전문가 설계
Gemma 4의 26B 모델은 Gemma 패밀리 최초의 MoE(Mixture of Experts) 아키텍처를 채택한다. 기존 밀집 모델에서 표준 피드포워드 신경망(feed-forward neural network)이 위치하던 자리를 MoE 블록이 대체하는 방식이다.
구조는 다음과 같다. 총 128개의 전문가(expert)가 존재하며, 이 중 매 포워드 패스(forward pass)마다 라우터(router)가 8개의 전문가를 선택하여 활성화한다. 모든 전문가는 소형 피드포워드 신경망으로 구성되어 있다. 여기에 더해 하나의 공유 전문가(shared expert)가 항상 활성화되는데, 이 공유 전문가는 일반 전문가의 세 배 크기를 가진다. 매 추론 시 8개의 선택된 전문가와 1개의 공유 전문가가 함께 작동하는 구조다.
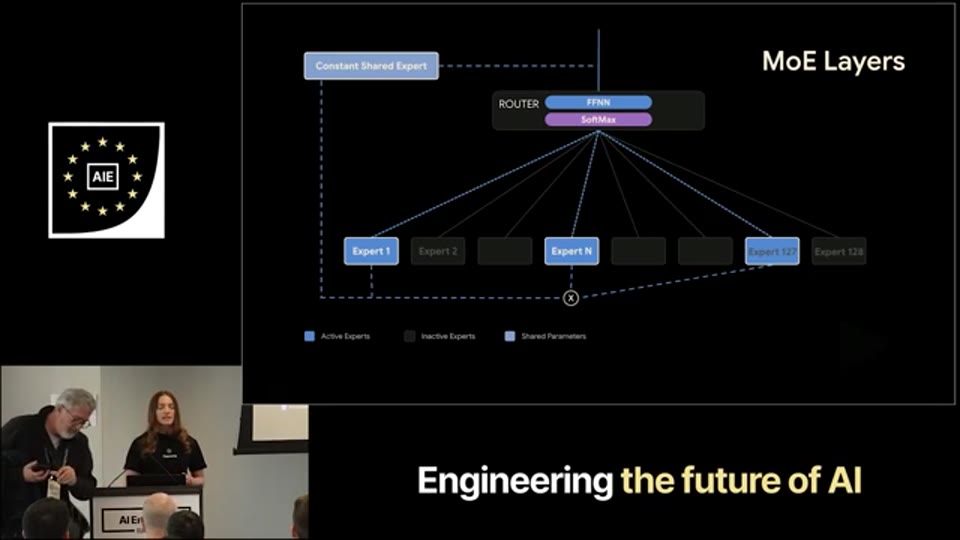
07:31 - MoE 아키텍처 구조 — 128개 전문가 중 8개 활성화, 공유 전문가(3배 크기) 포함 포워드 패스 다이어그램
이 설계의 실질적 의미는 26B의 전체 파라미터 중 약 3.8B만이 각 토큰 처리에 관여한다는 점이다. 전체 모델 표현력은 26B 수준으로 유지하면서, 실제 연산량은 약 3.8B 모델에 해당하는 수준으로 줄어든다. 이것이 26B MoE가 대형 모델 수준의 성능을 보이면서도 추론 효율성을 유지할 수 있는 핵심 원리다.
온디바이스 최적화의 핵심 — Per Layer Embedding(PLE)
Effective 2B와 Effective 4B 모델에서 온디바이스 성능을 가능케 하는 핵심 기술은 PLE(Per Layer Embedding, 퍼 레이어 임베딩)이다. 이 개념을 이해하려면 먼저 표준 임베딩 테이블이 어떻게 작동하는지 파악해야 한다.
기존의 표준 임베딩 테이블은 각 토큰 ID를 고정된 임베딩 벡터로 매핑한다. Effective 2B의 경우 임베딩 벡터 크기는 1,536이고, Effective 4B는 2,560이다. 이 임베딩 표현은 모든 레이어에 걸쳐 동일하게 사용된다. PLE는 여기서 한 걸음 더 나아가, 모델의 각 레이어마다 별도의 임베딩 테이블을 두는 방식이다. 즉, 특정 토큰 “hi”는 각 레이어에서 서로 다른 임베딩 표현을 가지게 된다. 2B 모델의 35개 레이어, 4B 모델의 42개 레이어 각각에서 토큰의 임베딩 표현이 점진적으로 발전해가는 구조다.
PLE의 가장 결정적인 특징은 이 추가 임베딩 테이블을 VRAM이 아닌 플래시 메모리(flash memory)에 저장한다는 점이다. VRAM은 스마트폰과 노트북에서 가장 빠르게 고갈되는 자원이기 때문에, PLE 테이블을 플래시 메모리로 이동시킴으로써 VRAM 부담 없이 추론 성능을 향상시킬 수 있다. PLE 임베딩 차원은 256으로, 본 모델의 전체 임베딩 크기보다 크게 축소되어 있다. 디코더 블록의 끝에서 이 256 차원의 PLE 임베딩을 조회한 뒤, 모델이 필요로 하는 전체 임베딩 크기로 프로젝션(projection)하는 과정을 거친다. 이 구조 덕분에 Effective 모델들은 이전 세대 Gemma 소형 모델들을 크게 능가하는 성능을 달성할 수 있었다.
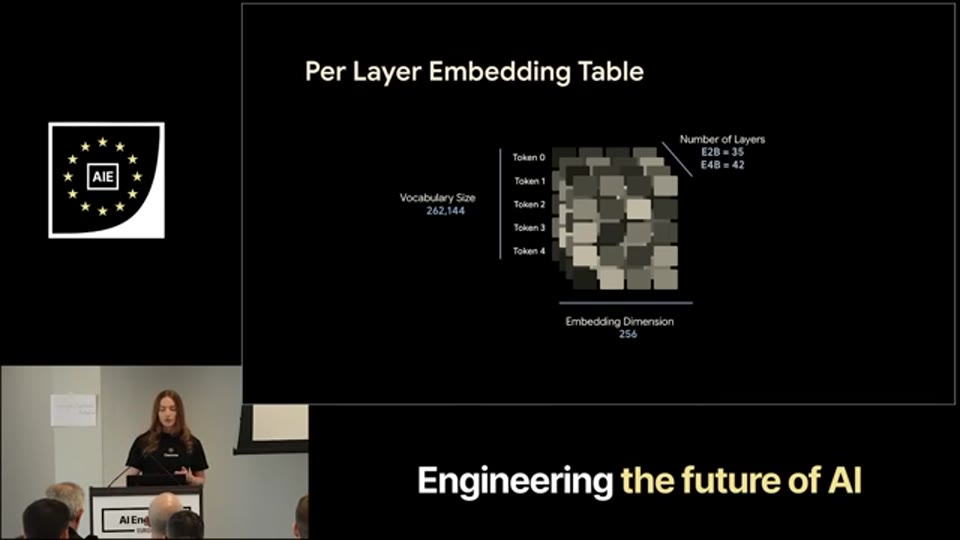
09:52 - PLE(Per Layer Embedding) 동작 원리 — 플래시 메모리 저장 구조와 256 차원 임베딩의 전체 크기 프로젝션 과정
멀티모달 아키텍처 — 비전 인코더의 작동 원리
Gemma 3에서 처음 도입된 비전(vision) 지원은 Gemma 4에서 모든 모델 크기에 걸쳐 처음부터 통합된 형태로 발전했다. 비전 인코더 규모는 모델 크기에 따라 달라진다. 31B와 26B 대형 모델은 5억 5천만(550M) 파라미터 비전 인코더를 사용하고, Effective 2B와 4B는 더 경량화된 1억 5천만(150M) 파라미터 인코더를 탑재한다.
비전 인코더의 기본 동작 방식은 이렇다. 입력 이미지는 먼저 16×16 픽셀 단위의 패치(patch)로 분할되고, 이 패치들은 평탄화(flatten)된 후 선형 프로젝션을 통해 패치 임베딩으로 변환된다. 위치 인코딩이 적용된 이 패치 임베딩이 최종적으로 모델에 전달되는 시각 정보다.
Gemma 4의 중요한 발전은 가변 종횡비(variable aspect ratio)와 가변 해상도(variable resolution) 지원이다. 이전 Gemma 3에서는 이를 처리하기 위해 “pan and scan” 방식을 사용했는데, 이미지를 여러 정사각형으로 분할하고 나머지는 패딩 처리하는 방식이었다. 결과적으로 하나의 이미지가 모델에 2~4개의 이미지로 전달되어 순차적으로 처리되는 비효율이 발생했다. Gemma 4에서는 이 문제를 근본적으로 해결하여, 이미지의 실제 종횡비와 해상도에 따라 다양한 수의 패치를 처리하는 방식을 채택했다.
이때 위치 인코딩의 정확성이 매우 중요해진다. 예를 들어, 4×2 이미지와 3×3 이미지를 함께 처리할 때 4번 패치의 공간적 위치는 두 이미지에서 전혀 다르다. 모델이 이 차이를 정확히 인식하도록 공간적 위치 인코딩(spatial positional encoding)을 함께 전달하는 것이 핵심 기술 과제였다.
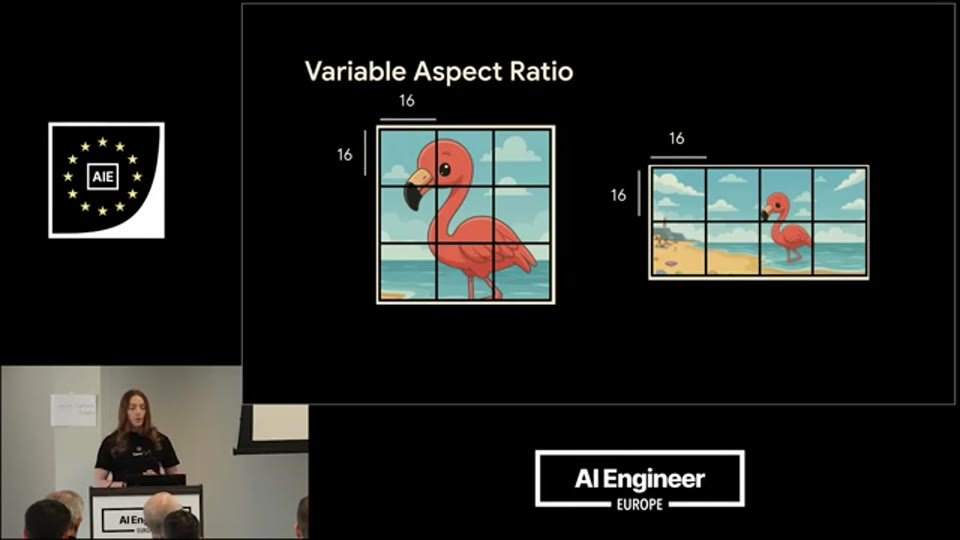
12:45 - 가변 종횡비(variable aspect ratio) 설명 — 4×2 이미지와 3×3 이미지에서 패치 4번의 위치 차이 및 공간 위치 인코딩 필요성 다이어그램
실제 토큰 효율화를 위해서는 3×3 패치 그리드를 하나의 임베딩으로 풀링(pooling)하는 방식을 사용한다. 예를 들어 토큰 예산 280으로 모델을 실행할 경우, 이는 실제로 2,520개의 서로 다른 패치로부터 구성된 임베딩에 해당한다. 개발자는 OCR, 공간 인식, 객체 탐지 같은 고해상도가 필요한 작업에는 높은 토큰 예산을, 텍스트 중심 작업에는 낮은 토큰 예산을 선택함으로써 성능과 비용 사이의 균형을 조절할 수 있다. Gemma 4는 이를 위해 다섯 가지 해상도 옵션을 제공하며, 560과 1,120이 고해상도 사용 사례를 위한 최대 옵션으로 제공된다.
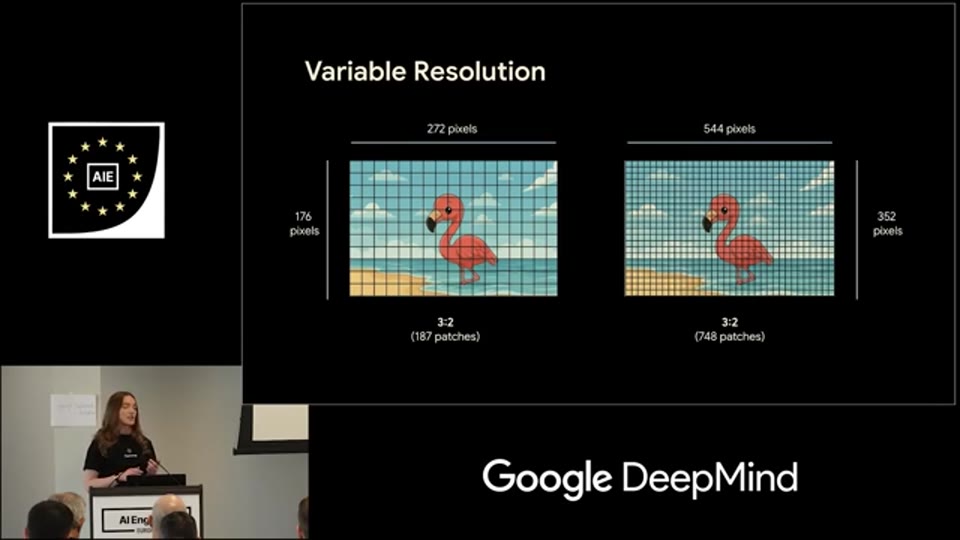
14:51 - 가변 해상도(variable resolution) 패치 처리 — 동일 종횡비에서 서로 다른 해상도 이미지의 패치 수와 소프트 토큰 예산 선택 구조
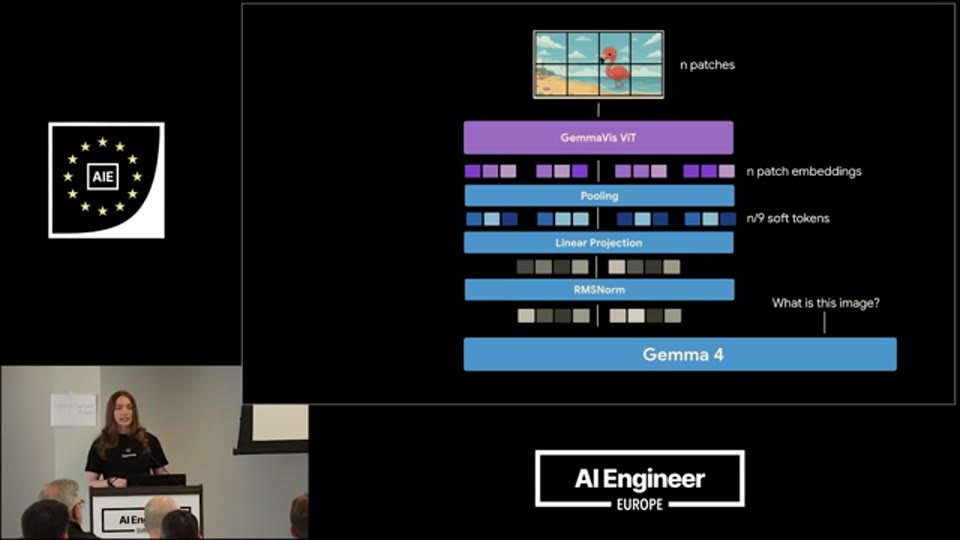
16:14 - 비전 파이프라인 전체 요약 — 이미지 → n개 패치 → n개 패치 임베딩 → n/9 소프트 토큰 → 선형 프로젝션 → 모델 입력 흐름도
오디오 지원 — MEL 스펙트로그램과 Conformer의 결합
오디오 지원은 Effective 2B와 Effective 4B 모델에 한정하여 도입되었으며, 주된 목적은 번역과 음성 인식(speech recognition) 지원이다. 이 기능은 오디오 토크나이저와 Conformer의 조합으로 구현된다.
파이프라인의 흐름은 다음과 같다. 우선 원시 오디오(raw audio)가 MEL 스펙트로그램(MEL spectrogram)을 통과하며 오디오 파일에서 특징(feature)이 추출된다. 추출된 MEL 스펙트로그램은 n개의 MEL 청크로 분할되고, 두 개의 컨볼루션 레이어(convolutional layer)를 통해 다운샘플링된다. 이 과정을 통해 n/4개의 소프트 토큰(soft token)이 생성된다. 이 오디오 임베딩이 Conformer로 전달된다.
Conformer는 3억 500만(305M) 파라미터 규모의 오디오 인코더로, 토큰이 아닌 임베딩 방식으로 처리한다. 아키텍처적으로는 밀집 모델 및 MoE 아키텍처와 유사한 구조를 따르지만, 여기에 추가적으로 컨볼루션 레이어가 삽입된다. 이는 오디오 신호의 국소적(local) 시간적 패턴을 포착하는 데 컨볼루션 연산이 특히 효과적이기 때문이다. 시퀀스 전반의 장거리 의존성을 처리하는 어텐션 메커니즘과 국소 패턴을 처리하는 컨볼루션의 결합이 Conformer 아키텍처의 핵심이다.
배포 옵션과 시작하기
Gemma 4 모델을 활용하는 방법은 크게 두 가지 경로로 나뉜다. 자체 호스팅 방식으로는 Hugging Face, Kaggle, Ollama를 통해 모든 모델 크기를 다운로드하여 직접 실행할 수 있다. 클라우드 호스팅 방식으로는 31B와 26B 대형 모델에 대해 AI Studio와 Vertex AI를 통해 즉시 API로 접근할 수 있다. 이 클라우드 옵션은 프로토타이핑, 에이전틱 워크플로우 구축, 함수 호출 기능 테스트를 빠르게 시작하고자 하는 개발자를 위한 경로다.
마무리 — Gemma 4가 제시하는 방향
Gemma 4는 단순히 기존 Gemma 3의 성능 개선판이 아니라, 온디바이스와 클라우드라는 두 극단의 요구사항을 동시에 만족시키기 위한 아키텍처 수준의 재설계를 담고 있다. 로컬-글로벌 어텐션 인터리빙과 GQA는 긴 컨텍스트 처리의 메모리 병목을 완화하고, PLE는 VRAM 제약이 극심한 온디바이스 환경에서도 풍부한 표현력을 유지하는 방법을 제시한다. MoE 아키텍처의 도입은 Gemma 패밀리가 희소 활성화(sparse activation) 패러다임으로 진화하고 있음을 보여준다.
특히 주목할 점은 Apache 2.0 라이선스로의 전환과 멀티모달의 네이티브 통합이다. 이 두 결정은 Gemma를 단순한 오픈 웨이트 모델을 넘어, 상업적 애플리케이션 생태계의 기반 모델로 포지셔닝하려는 Google DeepMind의 전략을 반영한다. 비전, 오디오, 텍스트를 모두 처음부터 통합한 아키텍처는 향후 더 복잡한 멀티모달 에이전트 구축을 위한 기반이 될 것이며, 작은 모델에서도 이 능력을 구현했다는 점에서 온디바이스 AI의 현실적 가능성을 한 단계 높인 시도로 평가할 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Open Models at Google DeepMind — Cassidy Hardin, Google DeepMind |
| 채널 | AI Engineer |
| 강연자 | Cassidy Hardin (Google DeepMind 연구원) |
| 리포트 작성 | 2026-04-28 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 아키텍처 다이어그램, 벤치마크 수치, 슬라이드 내용 등 시각 자료는 원본 영상을 직접 참조하시기 바랍니다.