LLM 시대의 개인화: Spotify는 어떻게 당신의 취향을 이해하는가
📺 원본 영상: Personalization in the Era of LLMs - Shivam Verma, Spotify 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-20 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 Spotify AI Foundation 팀의 Tech Lead인 Shivam Verma가 LLM 시대에 어떻게 음악·팟캐스트·오디오북 추천을 개인화하는지 그 기술적 원리를 상세히 설명한다. 강연자는 “유저 모델링(User Modeling)”, “카탈로그 이해(Catalog Understanding)”, 그리고 두 요소를 하나로 결합하는 “스티어러블 개인화 시스템(Steerable Personalized System)” 이라는 세 가지 축을 중심으로 논지를 전개한다. 이 강연은 일반적인 컨텍스트 엔지니어링 논의와 달리, 에이전트 설계 관점이 아닌 모델링 관점에서 컨텍스트를 어떻게 구성하는지를 다루며, 수십억 사용자 규모에서 실제 프로덕션으로 운용되는 시스템의 내부를 들여다볼 수 있는 희귀한 기회를 제공한다.
Spotify가 풀어야 할 문제의 규모
Spotify는 현재 약 7억 5천만 명의 MAU(Monthly Active Users)를 보유하고 있으며, 카탈로그에는 1억 개 이상의 트랙, 약 40만 개의 오디오북, 수백만 개의 팟캐스트 에피소드가 존재한다. 여기에 더해 점점 많은 크리에이터들이 비디오 포맷으로 전환하면서 영상 에피소드도 빠르게 늘고 있다. 서비스 지역은 184개 시장에 달한다. 이 규모는 단순히 큰 숫자가 아니라, 추천 시스템 설계에 근본적인 제약을 가한다. 어떤 모델도 7억 5천만 명의 모든 사용자를 동시에 개별적으로 학습할 수 없기 때문에, 추천 시스템은 개인화와 일반화 사이의 균형을 정교하게 다뤄야 한다.
Spotify가 ML 기반 추천을 시작한 것은 적어도 10년 전으로 거슬러 올라간다. 강연자가 대학원 재학 중이던 2015년에 출시된 ‘Discover Weekly’는 그 첫 번째 결실 중 하나였다. 매주 갱신되고 자신만을 위해 큐레이션되는 이 플레이리스트는 당시로서는 혁신적인 경험이었다. 이후 Spotify는 AI DJ(자연어로 대화하며 음악을 추천받는 기능), Prompted Playlist(사용자가 프롬프트를 입력하면 커스텀 플레이리스트를 생성하는 기능, 최근 팟캐스트 에피소드도 지원), 그리고 Taste Profile(자신에 대해 Spotify가 알고 있는 정보를 사용자가 직접 열람하고 수정할 수 있는 기능)까지 확장해 왔다.
전통적 추천 시스템에서 생성 모델로의 전환
강연자는 현재 Spotify가 경험하고 있는 패러다임 전환을 이해하기 위해 먼저 기존 방식, 즉 ‘Traditional Recommendation System(전통적 추천 시스템)‘의 구조를 설명한다. 전통적 구조는 기본적으로 다단계 파이프라인으로 이루어진다. 수백만 개의 아이템으로 구성된 방대한 카탈로그에서 Candidate Generation(후보군 생성) 단계가 수백 개의 후보로 압축하고, 이어지는 Ranking(랭킹) 단계들이 최종 추천 목록을 좁혀나가는 구조다. 이 접근은 홈 피드 랭킹, 개인화 플레이리스트, 검색, 팟캐스트, 광고 등 거의 모든 제품 영역에 걸쳐 사용되어 왔다.
문제는 이 구조가 사일로화(Siloed)되어 있다는 점이다. 각 제품 영역마다 별도의 팀이 별도의 모델을 유지해야 하기 때문에, 모델의 품질과 특성이 팀마다 다르고, 지식이 공유되지 않는다. 강연자는 이 구조로부터 벗어나 LLM과 유사한 방식으로 작동하는 단일 통합 모델로 이동하고 있다고 밝힌다. 이 통합 모델은 하나의 LLM 백본을 가지며, 사용자가 원하는 방향으로 추천을 조정(Steer)할 수 있는 능력을 갖는다. 강연의 나머지는 이 통합 모델을 가능하게 하는 세 가지 핵심 기술을 순서대로 설명하는 데 할애된다.
첫 번째 퍼즐 조각: 유저 모델링과 임베딩
강연자가 속한 User Representations 팀의 핵심 임무는 사용자를 이해하는 것이다. 구체적으로는 사용자의 과거 행동 이력(listening history) 전체를 압축하여 벡터(vector)로 표현하는 User Embedding 모델을 구축하고 운영한다. 이 임베딩은 이후 모든 다운스트림 추천 모델의 기반이 된다. 규모를 가늠하자면, 이 모델은 MAU뿐 아니라 비활성 사용자까지 포함하여 10억 명 이상의 사용자에 대한 임베딩을 매일 생성한다. 이는 엄청난 비용과 복잡성을 요구하는 파이프라인이다.
과거에는 이 사용자 표현 모델이 주로 Autoencoder 아키텍처를 기반으로 했다. Autoencoder는 사용자의 모든 특징(feature)을 받아 작은 벡터로 압축(인코딩)한 뒤, 그 벡터로부터 원래 특징을 복원(디코딩)하도록 학습된다. 이 압축-복원 과정에서 모델은 사용자를 표현하는 데 가장 핵심적인 정보가 무엇인지를 스스로 학습하게 된다. NLP나 컴퓨터 비전 분야에서도 유사한 접근이 오랫동안 사용되어 왔으며, 추천 시스템도 그 흐름과 맥을 같이했다.
그러나 산업 전반의 Transformer 중심 전환과 발맞추어, Spotify도 이제 이 Autoencoder 방식에서 단일 순차적(Sequential) 모델 방식으로 이동하고 있다. 새로운 접근에서는 사용자의 인터랙션 시퀀스(interaction sequence) — 사용자가 들은 곡이나 에피소드의 순서 — 가 모델의 컨텍스트, 즉 프롬프트의 일부로 입력된다. 여기에 현재 요청(query), 제품 표면(product surface), 그리고 추천 대상 아이템 정보를 함께 넣고 Transformer 레이어와 여러 헤드(head)를 통과시킨 후, 수억 명의 사용자 데이터로 학습하면 매우 강력한 결과를 얻을 수 있다.
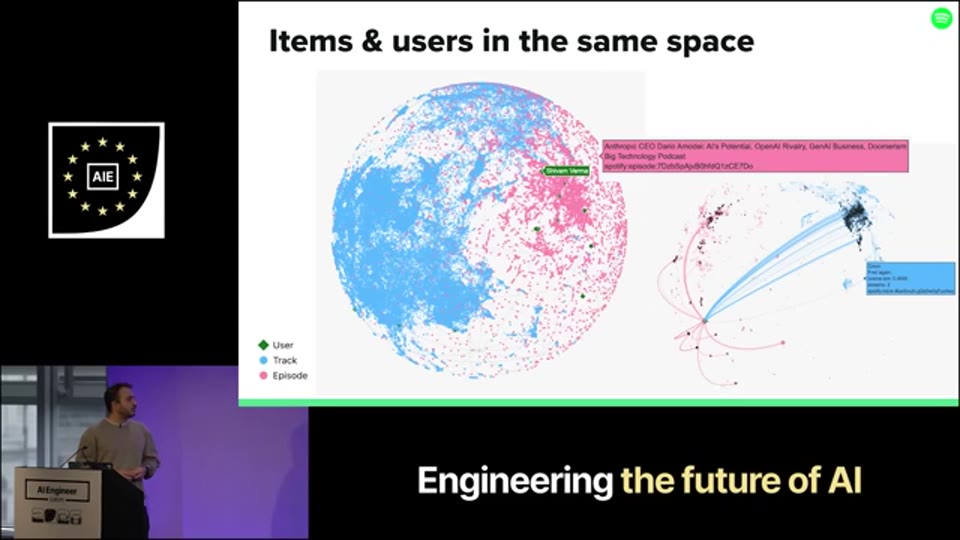
09:51 - Cross-content 임베딩 공간 시각화: 파란 점(트랙), 분홍 점(팟캐스트 에피소드), 초록 점(사용자)이 동일한 하이퍼스피어 위에 표현된 모습
이 시각화에서 파란 점은 트랙, 분홍 점은 팟캐스트 에피소드, 초록 점은 사용자를 나타낸다. 강연자 본인도 초록 점으로 표시되어 있으며, 그의 임베딩은 Big Tech 팟캐스트 관련 콘텐츠 군집과 매우 가까운 위치에 있다고 설명한다. 이는 모델이 사용자, 트랙, 에피소드를 동일한 임베딩 공간 안에 함께 표현하는 Cross-content Modeling을 수행한다는 것을 보여준다. 이 하이퍼스피어(hypersphere) 위에서 나와 가까운 콘텐츠가 무엇인지, 나의 음악 취향 이웃이 누구인지를 기하학적으로 탐색할 수 있게 되는 것이다.
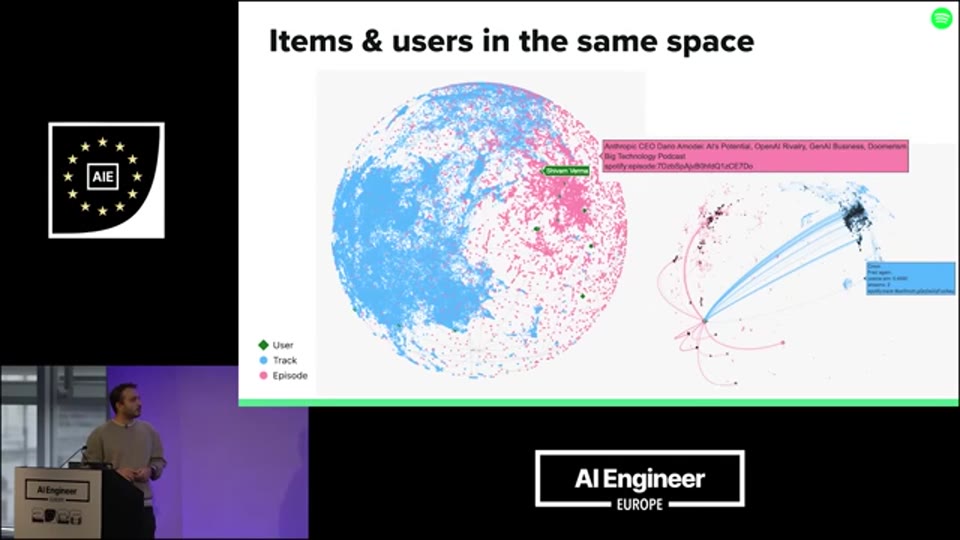
10:52 - 강연자 본인의 임베딩이 Big Tech 팟캐스트 군집 근처에 위치한 것을 가리키며 설명하는 시점
두 번째 퍼즐 조각: Semantic ID를 통한 카탈로그 이해
사용자를 이해하는 방법을 확보했다면, 다음 과제는 카탈로그를 이해하는 것이다. 콘텐츠를 표현하는 기본적인 방법은 사용자 쪽과 유사하다. 노래, 아티스트, 팟캐스트, 에피소드 등 각 아이템을 벡터로 표현한다. 그런데 이 벡터를 LLM과 함께 사용하기 위해서는 해결해야 할 기술적 간극이 있다. LLM은 기본적으로 토큰(token)의 시퀀스를 처리하도록 설계되어 있기 때문에, 연속적인 실수(real-valued) 벡터를 그대로 입력받아 처리하는 것이 자연스럽지 않다.
이 간극을 메우기 위해 Spotify가 도입한 개념이 바로 Semantic ID다. 강연자에 따르면 이 개념은 몇 년 전 구글이 YouTube 추천 문제에 적용한 논문에서 처음 소개되었으며, Spotify는 이를 자체 도메인에 맞게 발전시켰다. Semantic ID의 핵심 아이디어는 간단하다. 콘텐츠를 표현하는 고차원 벡터(예: 1,000차원)를 4~6개의 정수 토큰으로 압축하는 것이다. 이 압축된 토큰들이 바로 Semantic ID이며, LLM이 일반적으로 텍스트를 처리하는 것과 동일한 방식으로 콘텐츠를 처리할 수 있게 된다.
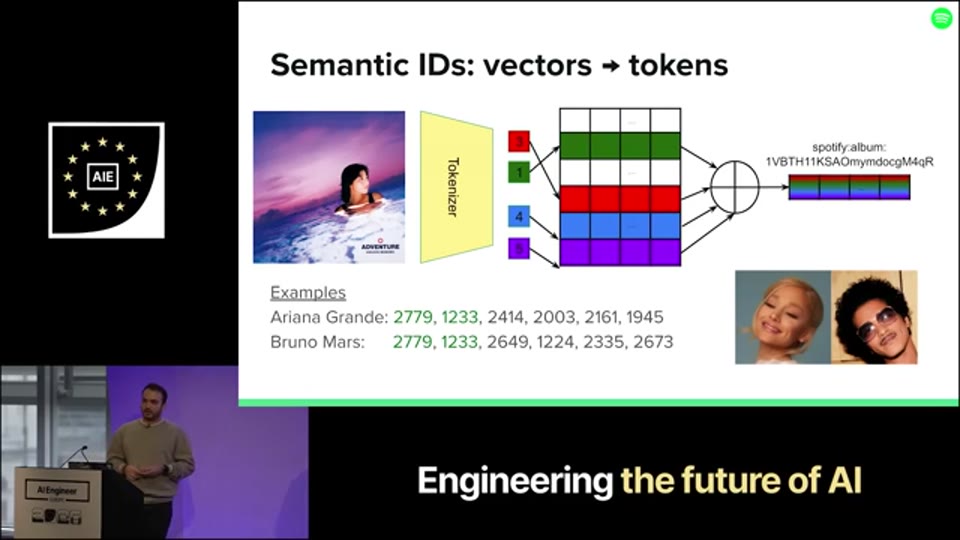
13:44 - Semantic ID 개념 설명: 콘텐츠 벡터를 4~6개의 정수 토큰으로 압축하는 방식 도식
강연자가 설명한 예시가 이 개념을 직관적으로 이해하게 해준다. Ariana Grande와 Bruno Mars를 각각 6개의 토큰으로 표현할 때, 앞의 두 토큰은 두 아티스트 사이에 공유된다. 두 아티스트 모두 팝(pop) 장르에 속하며 그 특성을 공유하기 때문이다. 나머지 네 토큰은 두 아티스트 사이에 서로 다른데, 이 토큰들은 보다 세부적인 장르적 특성이나 스타일의 차이를 인코딩한다. 결과적으로 Semantic ID는 카탈로그의 의미 구조를 반영하는 계층적(hierarchical) 표현 체계가 된다. 이 계층 구조 덕분에 LLM은 마치 다음 단어를 예측하듯, 다음에 사용자가 들을 곡이나 에피소드를 Semantic ID 토큰 시퀀스 형태로 자기회귀적(autoregressively)으로 생성할 수 있다.
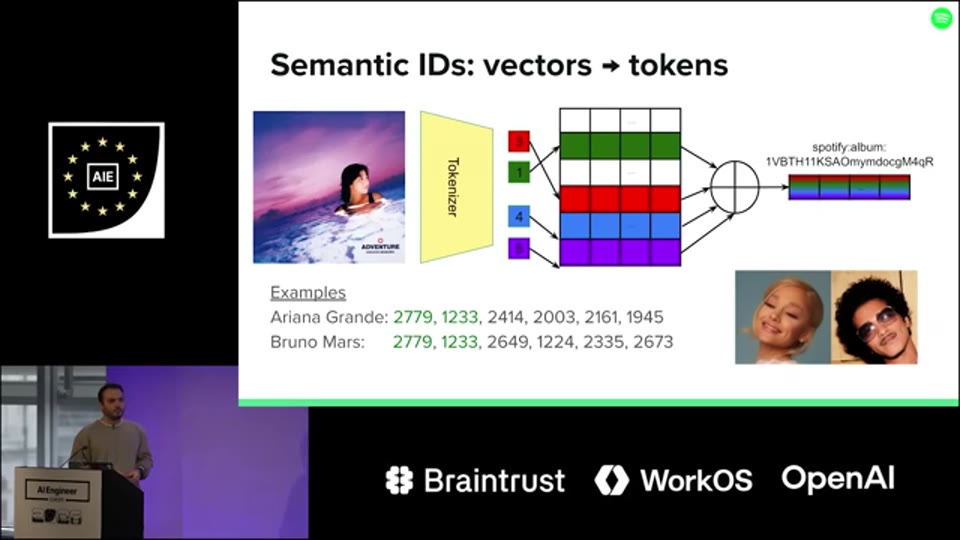
14:31 - Ariana Grande와 Bruno Mars의 Semantic ID 토큰 예시: 앞 두 토큰은 공유(팝 장르), 나머지 토큰은 개별 특성 인코딩
이 과정을 실현하기 위해 Spotify는 Llama나 Qwen 같은 오픈 웨이트(open-weight) LLM을 가져와 Continued Pre-Training(CPT)과 Supervised Fine-Tuning(SFT)을 수행한다. 이 학습 과정에서 모델은 Spotify의 도메인 데이터, 즉 사용자의 청취 이력을 Semantic ID 토큰으로 변환한 데이터로 훈련된다. 이를 통해 LLM은 Spotify의 카탈로그 지식을 내재화하게 되고, 월드 놀리지(world knowledge)와 플랫폼 특화 지식이 결합된 모델이 탄생한다. 강연자는 이 접근이 추천 품질 향상, 설명 가능성(explainability) 확보, 그리고 사용자와의 자연어 인터랙션 가능성이라는 세 가지 이점을 동시에 제공한다고 강조한다. Catastrophic Forgetting(파국적 망각) 문제가 트레이드오프로 존재하지만, 실험 결과 플랫폼 지식과 월드 놀리지를 결합하는 데 있어 전반적으로 긍정적인 결과를 보였다고 덧붙인다.
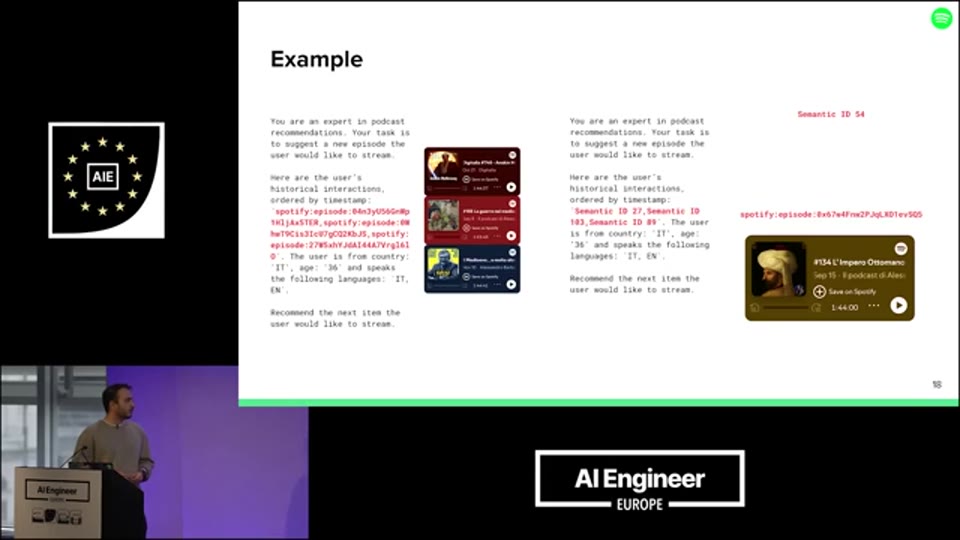
15:44 - 이탈리아어 팟캐스트를 듣는 사용자 예시: Spotify URI → Semantic ID 변환 후 LLM 프롬프트에 입력되는 실제 구조
이 예시에서 프롬프트는 사용자의 청취 이력(Spotify URI로 표현된 에피소드 목록을 Semantic ID로 변환한 것)을 포함하며, 모델은 이 컨텍스트를 바탕으로 다음에 이 사용자가 들을 에피소드를 예측한다.
세 번째 퍼즐 조각: Soft Token을 통한 개인화
사용자 임베딩과 Semantic ID라는 두 퍼즐 조각이 마련되었다면, 마지막 과제는 이 둘을 하나의 개인화된 시스템으로 통합하는 것이다. 문제의 핵심은 이것이다. LLM은 수억 명의 데이터로 훈련되어 일반적인 패턴을 학습하지만, 7억 5천만 명의 모든 사용자를 개별적으로 학습할 수는 없다. 따라서 모델이 협업 필터링(Collaborative Filtering)으로 일반화하는 것 이상으로, 특정 사용자의 고유한 취향을 반영하려면 별도의 메커니즘이 필요하다.
강연자가 소개하는 해법이 바로 Soft Token 기법이다. 원리는 다음과 같다. 학습된 사용자 임베딩 벡터를 LLM의 토큰 공간(token space)으로 선형 투영(projection)한다. 이렇게 투영된 결과가 Soft Token이며, 이것은 특정 사용자를 대표하는 하나의 특수 토큰으로서 LLM의 프롬프트 안에 삽입된다. 이 토큰은 사용자마다 다르기 때문에, 모델이 추천을 생성할 때 자연스럽게 현재 요청을 받는 사용자의 맥락을 반영하게 된다. 텍스트 기반 프롬프트로 표현하기 어려운 사용자의 취향 전체를 벡터 공간을 통해 모델 내부로 직접 주입하는 방식이라 할 수 있다.
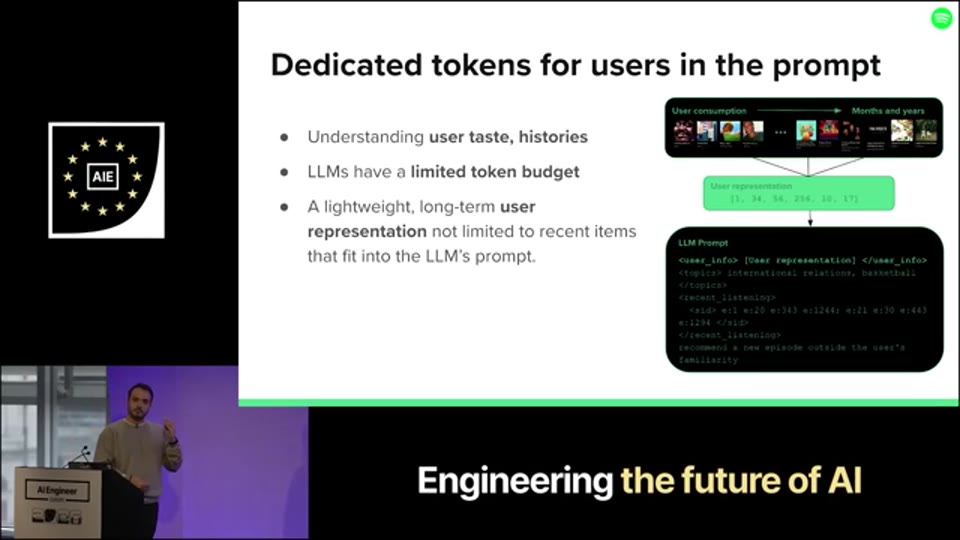
17:58 - Soft Token 구조 다이어그램: User Embedding 벡터가 LLM Token Space로 선형 투영되어 프롬프트에 삽입되는 방식
이 접근의 또 다른 강점은 Taste Profile 제품과의 결합이다. Taste Profile은 Spotify가 사용자에 대해 알고 있는 정보를 텍스트 형태로 사용자에게 공개하고, 사용자가 직접 수정하거나 특정 정보를 삭제할 수 있게 하는 기능이다. 강연자는 예를 들어 사용자가 “Justin Bieber를 더 많이 추천해 달라”거나 “이 팟캐스트는 추천하지 말라”는 식으로 피드백을 남기면, 그 편집 내용이 생성 모델에 다시 반영되어 추천 품질이 개선된다고 설명한다. 현재 이 기능은 일부 마켓에서만 제공되지만, 연내 확대 예정이다.
실제 성과 측면에서, 팟캐스트 ‘다음 에피소드’ 추천에 이 Soft Token 기반 개인화를 적용한 결과 내부 지표에서 긍정적인 성과를 확인했으며, 현재 프로덕션에 실제 배포되어 운용 중이라고 밝혔다. 즉, 현재 Spotify에서 팟캐스트를 청취할 때 받는 다음 에피소드 추천은 이 시스템에서 나오고 있다.
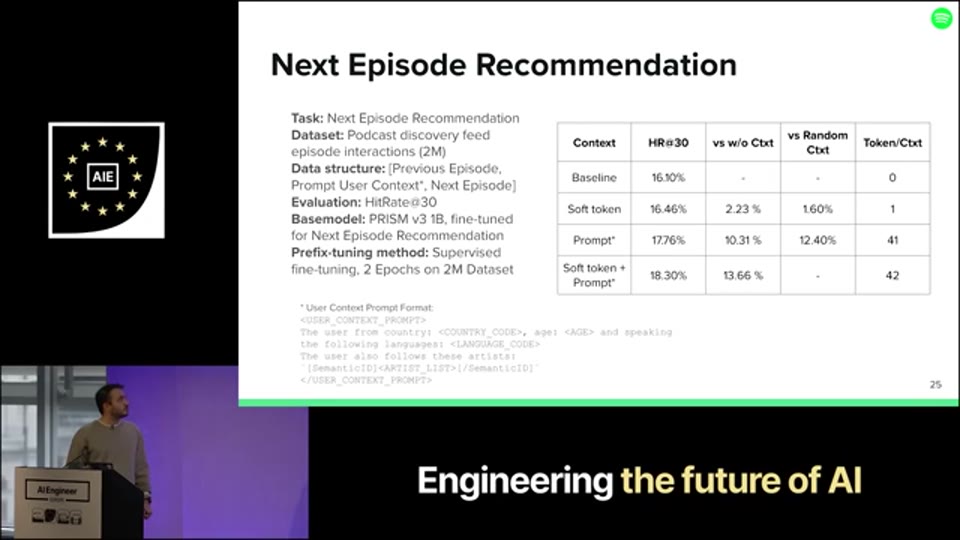
18:49 - 팟캐스트 다음 에피소드 추천에 적용한 결과 지표 및 프로덕션 배포 현황
시스템 전체 아키텍처 요약
세 가지 핵심 기술이 어떻게 하나의 시스템으로 결합되는지를 정리하면 다음과 같다.
| 구성 요소 | 역할 | 기술 |
|---|---|---|
| User Embedding | 사용자의 청취 이력 전체를 하나의 벡터로 표현 | Sequential Transformer 기반 User Model |
| Semantic ID | 콘텐츠 벡터를 LLM이 처리 가능한 토큰 시퀀스로 압축 | Vector Quantization 기반 토크나이제이션 |
| Soft Token | 사용자 벡터를 LLM 토큰 공간으로 투영하여 개인화 컨텍스트 제공 | Linear Projection + Prompt Integration |
전통적인 후보군 생성 → 랭킹 다단계 파이프라인이 각 제품별로 분산되어 있던 구조에서, 이 세 기술을 통해 단일 LLM 백본 위에서 사용자와 콘텐츠를 동일한 공간에서 이해하고, 사용자별로 개인화된 추천을 자기회귀적으로 생성하는 통합 시스템으로 전환하는 것이 강연의 핵심 메시지다. 강연자는 이 순차적 모델링(sequential modeling) 프레임워크가 Spotify의 모든 추천 시스템에 점진적으로 적용될 것이며, 팀 전체가 이 방향에 매우 흥미를 갖고 있다고 마무리한다.
마무리 / 핵심 정리
이 강연이 전달하는 가장 중요한 메시지는 추천 시스템과 LLM이 서로 분리된 영역이 아니라는 점이다. Spotify는 LLM을 단순히 챗봇이나 텍스트 생성 도구로 보는 것이 아니라, 추천 시스템의 핵심 백본으로 재정의하고 있다. 이 과정에서 등장하는 핵심 통찰은 다음과 같다. 첫째, 사용자 임베딩을 Soft Token으로 변환하면 연속 벡터 공간의 풍부한 정보를 LLM의 이산적(discrete) 토큰 시퀀스 처리 방식과 결합할 수 있다. 둘째, Semantic ID는 콘텐츠의 의미 구조를 계층적으로 인코딩함으로써 LLM이 카탈로그를 이해하고 다음 아이템을 자기회귀적으로 생성할 수 있게 한다. 셋째, 오픈 웨이트 LLM에 대한 도메인 적응(CPT + SFT)은 월드 놀리지와 플랫폼 특화 지식을 결합하여 설명 가능하고 자연어와 연동되는 추천 시스템을 구현하는 현실적인 경로를 제시한다.
유사한 대규모 개인화 문제를 다루는 엔지니어라면, 이 접근 방식은 단순히 “LLM을 추천에 쓴다”는 수준을 넘어서 사용자 표현, 콘텐츠 표현, 생성 모델 세 레이어를 어떻게 유기적으로 설계할지에 대한 구체적인 아키텍처 방향을 제시한다는 점에서 주목할 만하다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Personalization in the Era of LLMs - Shivam Verma, Spotify |
| 채널 | AI Engineer |
| 강연자 | Shivam Verma (Tech Lead, User Representations, Spotify AI Foundation) |
| 리포트 작성 | 2026-05-20 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.