RLM Recursive Language Models for Large Codebases - Shashi, Superagentic AI
📺 원본 영상: RLM: Recursive Language Models for Large Codebases - Shashi, Superagentic AI
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-13
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 코드, 슬라이드, 터미널 출력은 포함되지 않을 수 있습니다.
개요
이 강연은 Recursive Language Models(RLM)를 대규모 코드베이스 작업에 적용하는 방법을 설명한다. Shashi는 RLM을 단순한 논문 아이디어가 아니라, 코딩 에이전트가 거대한 저장소를 다룰 때 컨텍스트를 선별하고 재귀적으로 질의하며 최종 답변을 합성하는 실행 패턴으로 소개한다. 특히 모노레포처럼 파일, 테스트, 설정, 의존성이 얽힌 환경에서는 긴 컨텍스트를 모델에 그대로 밀어 넣는 방식이 한계에 부딪히기 때문에, 별도의 실행 환경과 REPL(Read-Eval-Print Loop)을 통해 필요한 근거만 추출하는 접근이 중요하다고 강조한다.
00:30 - RLM 논문과 강연의 목적을 설명하며 화면의 논문 자료를 참조하는 구간
왜 대규모 코드베이스에서 컨텍스트 문제가 커지는가
강연자는 작은 저장소나 제한된 범위의 코드 작업에서는 기존 코딩 에이전트가 매우 잘 동작한다고 설명한다. 문제는 모노레포처럼 컨텍스트가 빠르게 커지는 환경에서 발생한다. 모델의 컨텍스트 창에 많은 파일과 설명을 넣을수록 관련 없는 정보가 섞이고, 그 결과 모델의 성능은 오히려 떨어질 수 있다. 이때 단순히 더 긴 컨텍스트를 쓰는 것만으로는 충분하지 않으며, 무엇을 읽고 무엇을 버릴지 결정하는 별도의 컨텍스트 관리 전략이 필요해진다.
기존 코딩 에이전트 하네스들은 이 문제를 해결하기 위해 여러 방식을 사용해 왔다. 가장 흔한 방식은 grep 같은 도구로 파일 시스템을 검색해 필요한 파일을 찾는 것이고, 또 다른 방식은 semantic search(의미 기반 검색)나 local search(로컬 검색)를 통해 관련 코드 조각을 선별하는 것이다. 긴 대화를 요약해 압축된 컨텍스트를 다시 사용하는 방법도 있으며, 일부 제품은 에이전트의 장기 기억을 유지하기 위한 memory layer(메모리 계층)를 제공한다. 그러나 강연자가 보기에 RLM의 핵심은 이 모든 방식을 더 일반적인 실행 패턴으로 묶어, 모델이 직접 프로그래밍 가능한 환경에서 컨텍스트를 계산하게 만드는 데 있다.
RLM의 핵심 아이디어는 컨텍스트 관리를 외부화하는 것이다
강연자가 정리한 RLM의 핵심 명제는 컨텍스트 관리를 programmable execution environment(프로그래밍 가능한 실행 환경)로 외부화해야 한다는 것이다. 즉, 전체 저장소를 모델의 입력 창에 한꺼번에 넣는 대신, 저장소를 모델이 조작할 수 있는 데이터로 취급한다. 모델은 별도의 REPL이나 샌드박스 환경에서 코드를 작성해 파일을 탐색하고, 관련 코드 조각을 계산하고, 그렇게 얻은 제한된 관찰 결과만 메인 컨텍스트에 전달한다. 이 구조에서는 모델의 컨텍스트 창이 무한히 커질 필요가 없고, 대신 어떤 정보를 가져올지 결정하는 계산 절차가 중요해진다.
강연자는 이를 새 프로젝트에 배정된 리드 소프트웨어 엔지니어의 행동에 비유한다. 숙련된 엔지니어는 거대한 코드베이스를 처음부터 끝까지 한 줄씩 읽지 않는다. 먼저 디렉터리 구조를 보고, 의존성을 확인하고, 테스트와 설정 파일을 훑으며, 이해되지 않는 부분은 다른 전문가에게 물어본다. RLM도 같은 방식으로 저장소를 탐색하고, 중간 노트를 만들고, 필요한 경우 다른 모델 또는 하위 질의에 도움을 요청한 뒤, 마지막에는 정제된 합성 결과를 반환한다.
여기서 recursion(재귀성)은 모델이 단 한 번의 검색으로 끝나지 않고, 필요할 때 다른 LLM query(LLM 질의)를 호출해 추가 답변을 얻는 구조에서 나온다. 메인 루프는 저장소를 컨텍스트로 삼고, REPL 코드를 실행해 제한된 observation(관찰 결과)을 만들며, 부족한 부분은 하위 모델 질의로 보완한다. 이후 반환된 값을 다시 루프에 넣어 다음 결정을 내리고, 충분한 근거가 모이면 최종 결과를 만든다. 따라서 RLM은 단순한 검색 기법이라기보다, 코드베이스를 대상으로 한 반복적 연구와 합성의 절차에 가깝다.
코드베이스는 단순한 텍스트가 아니라 구조화된 데이터다
강연자가 RLM의 적용 대상으로 책이나 사전보다 코드베이스를 선택한 이유는 코드가 단순한 긴 텍스트가 아니기 때문이다. 코드베이스에는 디렉터리, 테스트, import, dependency(의존성), 설정 파일, 문서, 때로는 이미지와 빌드 산출물까지 포함된다. 이 요소들은 서로 관계를 맺고 있기 때문에, 모델은 단순히 문장을 읽는 것이 아니라 구조와 실행 흐름을 함께 추론해야 한다. 이런 점에서 대규모 저장소는 RLM의 장점이 잘 드러나는 실험 대상이 된다.
일반적인 긴 문서 처리에서는 중요한 단락을 찾고 요약하는 것이 핵심일 수 있다. 반면 코드베이스에서는 어떤 파일이 진입점인지, 어떤 테스트가 어떤 동작을 보장하는지, 특정 함수가 어디서 호출되는지, 설정이 런타임 동작에 어떤 영향을 주는지까지 추적해야 한다. 이 과정은 사람이 수동으로 수행하면 탐색과 검증을 반복하는 작업이 되며, RLM은 이를 모델이 코드 실행 환경 안에서 수행하도록 만든다. 강연자는 바로 이 지점에서 RLM이 대규모 코드 작업에 적합하다고 본다.
RLM Code는 개념 검증을 위한 오픈소스 하네스다
강연 중반부에서 Shashi는 Superagentic AI가 만든 RLM Code를 소개한다. 이 프로젝트는 RLM 자체를 새롭게 정의하려는 것이 아니라, RLM 논문과 기존 구현에서 제시된 개념을 코드베이스 분석에 적용해 볼 수 있는 reference implementation(참조 구현)에 가깝다. 강연자에 따르면 RLM은 특정 라이브러리 하나가 아니라 패턴이며, 각 팀은 자신의 워크플로우와 인프라에 맞춰 이를 구현할 수 있다. RLM Code는 그중 하나의 독립적인 하네스로, 로컬 모델과 클라우드 모델을 모두 연결할 수 있고 관측성 도구도 선택적으로 붙일 수 있게 설계되었다.
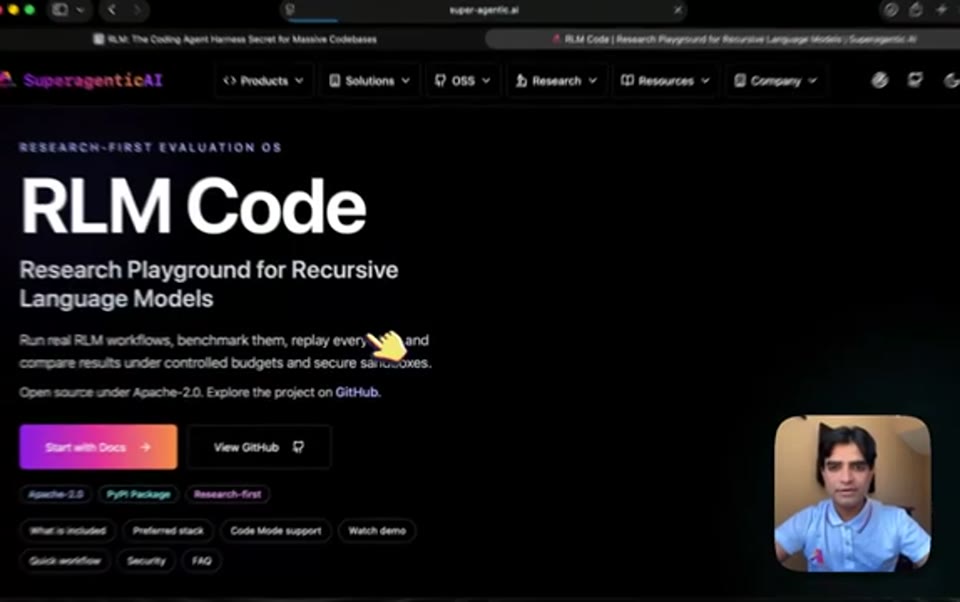
06:18 - RLM Code 랜딩 페이지와 문서, GitHub 저장소를 보여주며 프로젝트를 소개하는 구간
강연자는 MIT와 공동 연구자들이 발표한 RLM 논문, RLM 및 RLM minimal 구현, 그리고 DSPy 내부의 RLM 구현을 함께 언급한다. 다만 그는 이들을 동일한 제품으로 보지 말고, 같은 아이디어를 서로 다른 방식으로 구현한 사례로 이해해야 한다고 설명한다. RLM Code 역시 그런 구현 중 하나이며, 특히 라이브 데모에서 REPL 실행, recursive call(재귀 호출), LLM query, 최종 결과 합성의 흐름을 직접 보여주기 위해 만들어진 연구용 플레이그라운드다. 따라서 이 프로젝트의 가치는 완성된 상용 에이전트라기보다, RLM식 하네스를 직접 설계하려는 엔지니어에게 내부 동작을 드러내는 데 있다.
라이브 데모에서 드러난 RLM 루프의 실제 흐름
데모에서는 RLM Code 저장소를 대상으로 RLM 개념이 어떻게 동작하는지 보여준다. 강연자는 먼저 저장소를 열고, 데모 타깃과 README, 실행 지침을 확인한 뒤 Gemini 모델을 사용해 스크립트를 실행한다. Docker 컨테이너가 샌드박스로 시작되고, 모델은 첫 단계에서 REPL 코드를 작성해 저장소에서 필요한 정보를 추출한다. 이후 이 정보로 evidence(근거)를 만들고, 필요한 경우 LLM query를 호출해 추가 문맥을 받아온 뒤, 최종 답변을 생성한다.
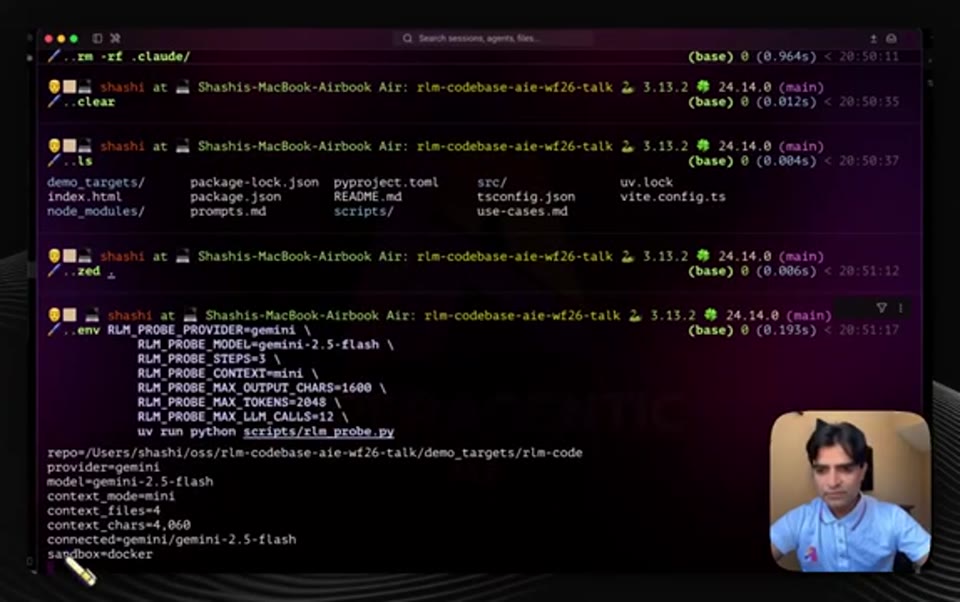
10:37 - Docker 샌드박스가 시작되고 RLM Code 데모 실행 환경을 보여주는 구간
이 데모에서 중요한 점은 모델의 답변만 보는 것이 아니라, 답변이 만들어지는 경로 전체를 관찰할 수 있다는 것이다. 강연자는 실행 결과에서 REPL 코드, evidence 생성 과정, LLM query 호출, 최종 출력, tool call 수, 토큰 사용량을 확인할 수 있다고 설명한다. 또한 실행 흔적은 저장소 내부의 run/session 형태로 남고, JSONL 형식의 trace(추적 로그)를 통해 외부 observability platform(관측성 플랫폼)으로 가져갈 수도 있다. 이는 RLM 하네스를 실제 업무에 적용할 때 디버깅과 비용 관리, 품질 평가에 중요한 기반이 된다.
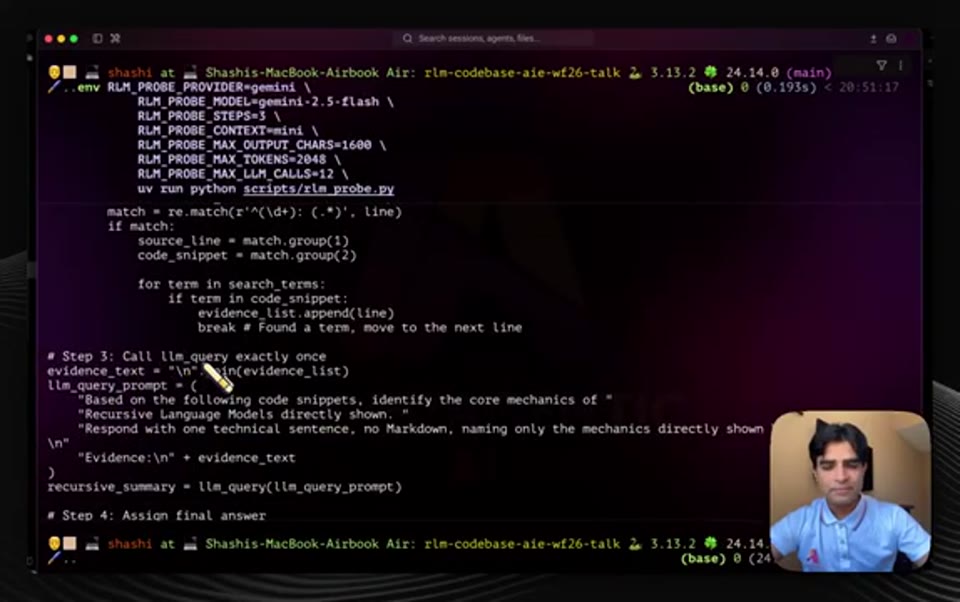
11:13 - REPL 코드, evidence 생성, LLM query 호출, 최종 답변 흐름을 터미널 출력으로 보여주는 구간
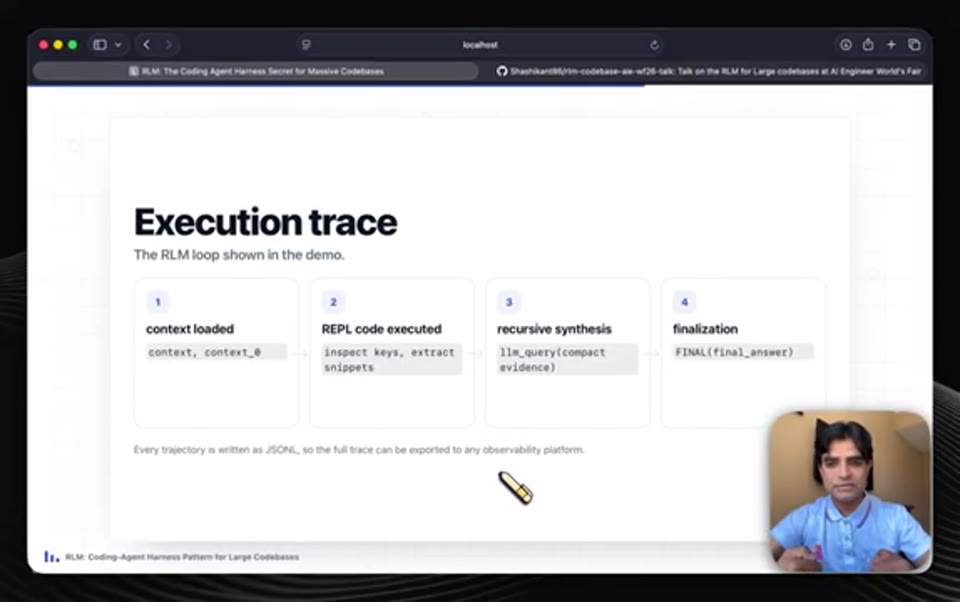
14:44 - JSONL trace와 observability platform 연동 가능성을 설명하는 구간
터미널 UI와 연구용 하네스가 제공하는 실험 공간
강연자는 CLI 실행뿐 아니라 coding agent style의 실험적 하네스도 소개한다. 이 환경에서는 connect 명령으로 provider와 model name을 지정해 Gemini 모델에 연결하고, doctor 명령으로 환경 상태를 점검할 수 있다. 일부 warning이 표시되지만, 강연자는 그것이 DeepAgent, ADK 등 다른 프레임워크와 관련된 것으로 이번 데모의 핵심과는 직접 관련이 없다고 설명한다. 이후 프롬프트와 예산을 지정해 실행하면, 최대 step 수와 recursion depth(재귀 깊이)에 따라 RLM 루프가 진행되고 결과가 반환된다.
흥미로운 부분은 이 실행 결과를 research lab 형태의 화면에서 다시 볼 수 있다는 점이다. 강연자는 spend(비용), rewards(보상), trajectory(궤적), event(이벤트)를 확인할 수 있다고 설명한다. 특히 trajectory는 REPL 실행, 코드, 최종 출력이 어떤 순서로 이어졌는지 보여주기 때문에, RLM 루프의 내부 상태를 이해하는 데 중요하다. 이처럼 RLM Code는 단순히 “답을 잘 내는 도구”라기보다, 에이전트가 코드베이스를 탐색하고 판단하는 과정을 연구하고 조정하는 실험실에 가깝다.
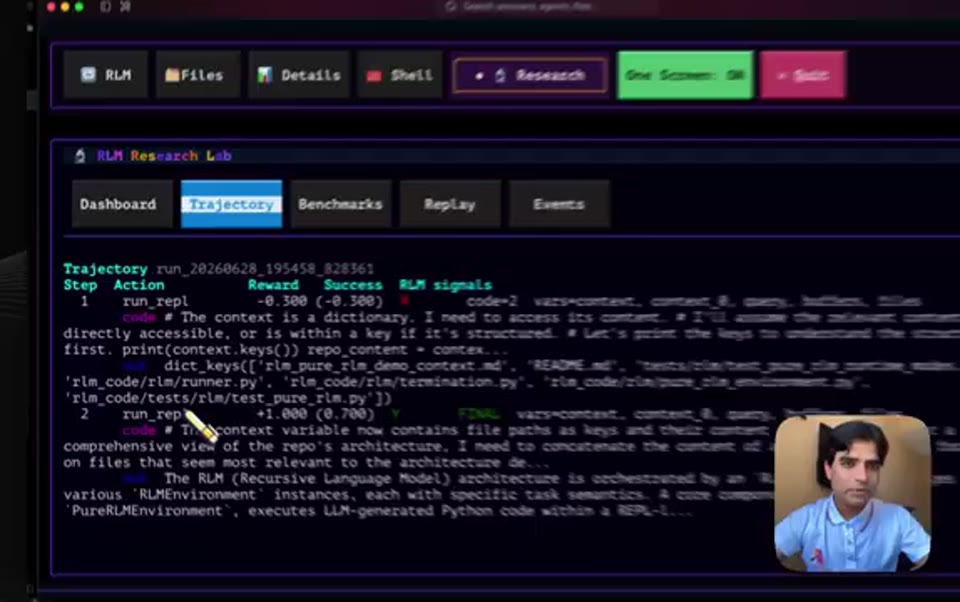
13:45 - research lab 화면에서 trajectory, REPL 실행, 코드, 최종 출력과 이벤트를 확인하는 구간
실제 AI 엔지니어링에서의 활용 가능성
강연자가 제안하는 실제 활용 사례는 대규모 코드베이스를 다루는 엔지니어링 업무와 밀접하게 연결되어 있다. 예를 들어 root cause analysis(근본 원인 분석)를 해야 하거나, 낯선 저장소에 온보딩해야 하거나, 복잡한 모노레포에서 특정 기능의 동작 경로를 파악해야 할 때 RLM식 접근이 유용할 수 있다. 이 경우 중요한 것은 일반 챗봇처럼 질문과 답변만 주고받는 것이 아니라, planning(계획), coding(코드 실행), observation(관찰), subcall(하위 호출), budget(예산), final output(최종 출력)을 모두 기록하는 하네스를 설계하는 것이다. 그래야 에이전트의 답변이 어떤 근거와 비용으로 만들어졌는지 추적할 수 있다.
강연자는 최근 여러 관리형 에이전트와 동적 워크플로우 제품에서도 RLM과 유사한 개념이 쓰이고 있다고 언급한다. 예를 들어 Codex 계열 하네스가 Python REPL에서 코드를 작성해 컨텍스트를 선별하는 모습을 보았고, Claude나 Gemini의 managed agent 역시 샌드박스와 하위 실행 환경을 활용한다는 점에서 RLM적 성격을 가진다고 설명한다. 또한 하나의 에이전트가 작업을 받아 여러 하위 에이전트를 생성하고, 각 하위 에이전트가 별도 샌드박스에서 작업한 뒤 결과를 합치는 dynamic workflow(동적 워크플로우)도 같은 방향의 아이디어로 볼 수 있다. 다만 강연자는 일부 proprietary system(독점 시스템)의 내부 구현은 확정적으로 알 수 없으므로, “RLM 개념이 사용되고 있을 가능성”으로 조심스럽게 표현한다.
RLM이 제시하는 코딩 에이전트 설계의 방향
이 강연의 핵심 메시지는 더 큰 모델이나 더 긴 컨텍스트만으로 대규모 코드 작업의 문제가 해결되지 않는다는 데 있다. 코드베이스가 커질수록 중요한 것은 정보를 많이 넣는 능력이 아니라, 필요한 정보를 찾아 계산하고 검증하며 압축하는 절차다. RLM은 이 절차를 모델 밖의 실행 환경으로 옮기고, 모델이 직접 코드를 작성해 관찰 결과를 만들어내게 한다. 이 방식은 사람 엔지니어가 큰 프로젝트를 이해하는 방식과 닮아 있기 때문에, 단순 요약형 AI보다 실제 엔지니어링 작업에 더 잘 맞을 수 있다.
물론 RLM이 만능 해결책은 아니다. 별도 샌드박스, 실행 권한, 예산 관리, trace 저장, 관측성 연동이 필요하고, 하위 모델 질의가 늘어날수록 비용과 지연 시간도 커질 수 있다. 그러나 대규모 저장소에서 정확한 근거를 찾아야 하는 상황이라면, 이러한 복잡성은 단순 프롬프트 기반 접근보다 더 나은 통제력을 제공한다. 강연자는 RLM Code를 통해 이런 구조를 직접 실험해 보고, 각자의 조직과 워크플로우에 맞는 에이전트 하네스를 설계해 보라고 제안한다.
마무리 / 핵심 정리
Shashi의 강연은 RLM을 논문 속 개념에서 실제 코딩 에이전트 하네스 설계 원칙으로 끌어온다. 대규모 코드베이스는 단순한 텍스트 더미가 아니라 구조화된 실행 대상이기 때문에, 모델이 저장소를 읽고 검색하고 코드를 실행하며 필요한 근거를 선별할 수 있어야 한다. RLM은 이 과정을 REPL, LLM query, recursive loop, trace로 구성해 컨텍스트 관리를 외부화한다. 그 결과 엔지니어는 답변뿐 아니라 답변이 만들어진 경로까지 관찰할 수 있고, 이는 대규모 저장소 분석, 온보딩, 근본 원인 분석, 에이전트 워크플로우 설계에 직접적인 의미를 가진다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | RLM: Recursive Language Models for Large Codebases - Shashi, Superagentic AI |
| 채널 | AI Engineer |
| 영상 길이 | 약 17분 23초 |
| 리포트 작성 | 2026-07-13 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.