Research to Reality - Benoit Schillings, Google DeepMind, VP Research (Thinking, Reasoning, Coding)
📺 원본 영상: Research to Reality - Benoit Schillings, Google DeepMind, VP Research (Thinking, Reasoning, Coding)
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-18
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Google DeepMind의 연구 부문 VP Benoit Schillings는 이 강연에서 AI가 코드 작성 방식을 어떻게 바꾸고 있는지, 그리고 그 변화가 단순한 생산성 향상을 넘어 소프트웨어 엔지니어링의 경제학과 역할 구조를 어떻게 재편하는지 설명한다. 그는 코드 생성 자체는 이미 인간을 넘어서는 단계에 가까워졌지만, 진짜 병목은 대규모 코드베이스의 이해, 시스템 설계, 보안, 평가, 그리고 장기적 아키텍처 판단으로 이동하고 있다고 본다.
강연의 핵심은 “AI가 코드를 잘 쓰는가”라는 질문에서 “AI가 복잡한 문제를 올바르게 분해하고, 검증하고, 안전하게 설계할 수 있는가”라는 질문으로 초점이 이동해야 한다는 데 있다. Schillings는 DeepMind가 AlphaZero에서 보여준 Self-play(자기 대국·자기학습)의 사고방식을 코드 영역에도 적용할 수 있다고 설명하며, 향후 AI 코딩 모델의 발전은 인간이 만든 데이터를 더 많이 긁어모으는 방식이 아니라 모델이 스스로 문제를 만들고 검증하는 방향으로 전개될 가능성이 크다고 주장한다.
Google X에서 DeepMind로: “1개월에서 1년 뒤 Gemini”를 준비하는 팀
Benoit Schillings는 자신을 머신러닝 분야에서는 비교적 신입이라고 소개하지만, 그의 경력은 오히려 이 강연의 관점을 더 흥미롭게 만든다. 그는 약 1년 반 전까지 Google X에서 일했으며, Google X는 Waymo와 Google Glass 같은 프로젝트로 잘 알려진 조직이다. 그는 이 경험을 통해 장기 연구와 현실 제품 사이의 간극을 다루는 법을 배웠고, 그 관점이 DeepMind에서 연구팀을 운영하는 방식에도 영향을 주었다고 설명한다.
그가 맡은 팀의 목표는 Gemini를 “1개월에서 1년 사이의 미래”에 더 강력하게 만들 기술을 개발하는 것이다. 여기서 1개월이라는 시간은 당장 다음 주에 필요한 기능을 고치는 단기 엔지니어링과 구분되는 연구의 시간축이며, 1년이라는 시간은 오늘날 AI 분야에서 누구도 자신 있게 예측하기 어려운 먼 미래에 해당한다. 이 범위 안에서 그의 팀은 코드 생성뿐 아니라 reasoning(추론), 새로운 neural network architecture(신경망 아키텍처), reinforcement learning(강화학습)의 기초 과학까지 다룬다.
01:37 - DeepMind 팀이 Gemini의 1개월에서 1년 뒤 기술을 준비한다는 연구 범위 설명 화면
이 배경은 강연 전체의 문제의식을 이해하는 데 중요하다. Schillings가 말하는 AI 코딩은 단순히 IDE 안에서 자동완성 기능이 좋아지는 이야기가 아니라, Gemini 같은 프런티어 모델이 앞으로 어떤 지적 능력을 갖춰야 하는지에 대한 연구 의제다. 따라서 그는 코드 작성 능력을 모델의 언어 능력, 추론 능력, 계획 능력, 검증 능력, 그리고 궁극적으로 과학적 발견 능력과 연결해 설명한다.
Pitchfork에서 시작된 질문: 왜 머신러닝으로 코드를 써야 하는가
Schillings는 2018년 Google X에서 Pitchfork라는 프로젝트를 시작했다고 회상한다. 이 프로젝트의 목표는 머신러닝이 코드 작성 과정을 어떻게 개선할 수 있는지 탐구하는 것이었다. 당시 Google 내부에서 이 아이디어는 큰 관심을 얻지 못했는데, 많은 사람들은 “왜 굳이 머신러닝이 코드를 써야 하는가”라는 반응을 보였다고 한다. 지금의 분위기와 비교하면 놀라운 일이지만, 당시에는 프로그래밍 언어가 이미 사람이 의도를 정확히 표현하기 위한 도구라고 여겨졌기 때문에 자연어로 코드를 작성한다는 발상은 진지하게 받아들여지기 어려웠다.
Pitchfork의 초기 목표는 오늘날 말하는 Vibe Coding(자연어 기반 코딩)과는 조금 달랐다. Schillings는 작은 코드 변경 하나가 리뷰를 거쳐 반영되기까지 며칠씩 걸리는 병목을 줄이고 싶었다고 설명한다. 즉, 처음부터 영어로 대규모 시스템을 작성하겠다는 야심보다는, 소프트웨어 개발 속도를 늦추는 작고 반복적인 변경 주기를 압축하려는 시도에 가까웠다.
흥미로운 점은 Schillings 자신도 당시에는 “영어는 프로그래밍 언어가 아니다”라고 생각했다는 것이다. 그러나 그는 지금 자신이 그 판단에서 틀렸다고 인정한다. 이 고백은 강연의 중요한 정서적 축을 만든다. 그는 새로운 기술에 대한 저항이 단지 외부의 보수성 때문만이 아니라, 오랜 기간 특정 방식으로 사고하고 일해온 숙련자 내부에서도 자연스럽게 생긴다는 점을 자신의 경험으로 설명한다.
소프트웨어의 세 시대: 기계의 한계, 인간 두뇌의 한계, 그리고 AI 프런티어
Schillings는 소프트웨어 역사를 크게 세 단계로 바라본다. 첫 번째 시대는 기계가 가장 큰 병목이던 시기다. 그는 Apple II와 Commodore 64용 비디오게임을 만들며 assembly language(어셈블리 언어)를 작성하던 시절을 언급한다. 이때의 프로그래밍은 제한된 하드웨어에서 마지막 성능까지 끌어내는 일이었고, 프로그래머는 기계에 극도로 가까운 수준에서 사고해야 했다.
두 번째 시대는 클라우드와 고수준 언어의 시대다. 컴퓨팅 비용이 낮아지면서 모든 문제에서 최후의 성능을 짜내는 일이 가장 중요한 목표는 아니게 되었다. 대신 핵심 병목은 인간이 복잡한 시스템을 이해하고, 모듈화하고, 장기적으로 유지할 수 있는 구조를 만드는 능력으로 이동했다. Schillings는 이 시기의 소프트웨어 문화를 “한 번만 쓰는 것이 아니라 오래 관리할 수 있도록 라이브러리, 함수, 모듈로 나누는 방식”으로 설명한다.
그는 이 시대의 소프트웨어 프로세스가 인간 두뇌의 한계에 맞춰 설계되었다고 본다. 인간은 제한된 맥락만 한 번에 유지할 수 있기 때문에, 코드는 작은 단위로 나뉘고, 리뷰되고, 문서화되고, 계층화되어야 했다. 반면 현대 머신러닝 모델은 점점 더 긴 context window(컨텍스트 윈도우)를 갖게 되고 있으며, Schillings는 가까운 미래에는 사실상 무한한 맥락을 다룰 수 있는 방향으로 갈 것이라고 본다.
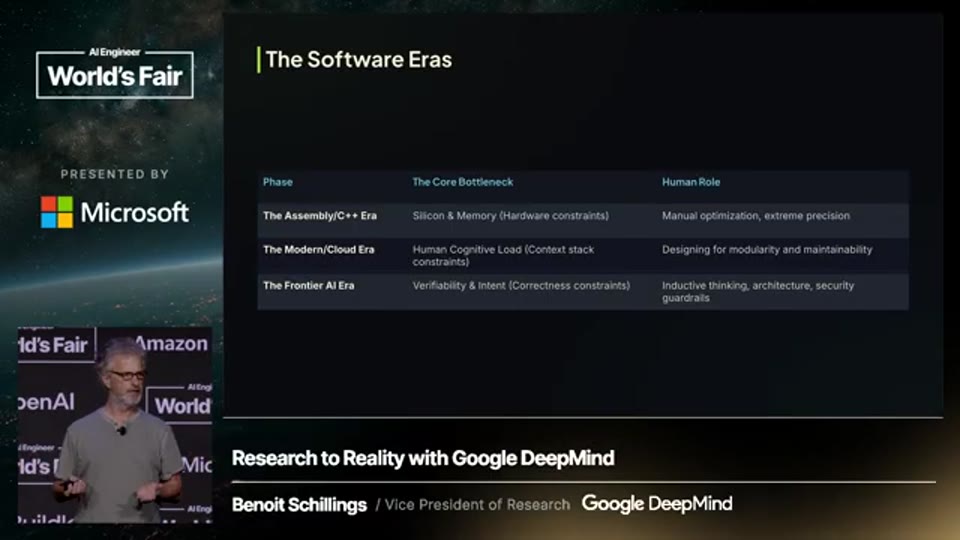
05:56 - 소프트웨어 발전의 병목이 기계 성능에서 인간 두뇌의 맥락 처리 한계로 이동했다는 설명 화면
이 변화가 세 번째 시대, 즉 AI frontier(인공지능 프런티어)를 연다. 이 시대에는 코드를 “작성하는 행위” 자체가 더 이상 가장 어려운 일이 아니며, 오히려 중요한 질문은 모델이 만든 코드가 정말 우리가 원한 것인지, 그 코드가 시스템 전체에서 어떤 의미를 갖는지, 그리고 장기적으로 어떤 위험을 낳는지 판단하는 쪽으로 이동한다. Schillings는 인간의 역할이 적어도 가까운 미래에는 architecture(아키텍처), 의도 명세, 귀납적 판단, 넓은 맥락에서의 패턴 인식에 더 가까워질 것이라고 본다.
“코드 작성은 끝났다”는 말의 정확한 의미
강연에서 가장 강한 표현 중 하나는 “code is over”라는 주장이다. 그러나 Schillings가 말하는 “코드의 종말”은 소프트웨어 엔지니어링 전체가 끝났다는 의미가 아니다. 오히려 그는 syntax generation(문법적 코드 생성), 즉 함수나 로컬한 구현을 작성하는 능력에서는 프런티어 모델이 이미 인간을 넘어서는 단계에 도달했다고 본다. 그가 Gemini에게 함수를 작성하게 했을 때 “내가 더 잘할 수 있다”고 느끼는 순간은 거의 사라졌다는 설명이 이 관점을 잘 보여준다.
하지만 그는 곧바로 진짜 소프트웨어 엔지니어링은 코드 한 조각을 쓰는 일이 아니라고 강조한다. 소프트웨어 엔지니어링의 본질은 회사에 처음 합류했을 때 수천만 줄 규모의 레거시 코드베이스를 마주하고, 그 안에서 정확한 변경을 해야 하는 상황에서 드러난다. Schillings는 예시로 3,500만 줄의 PHP 코드베이스를 언급하며, 이때 필요한 것은 단순한 구문 생성 능력이 아니라 복잡성을 분해하고 맥락을 파악하며 시스템 전체의 결과를 예측하는 능력이라고 말한다.
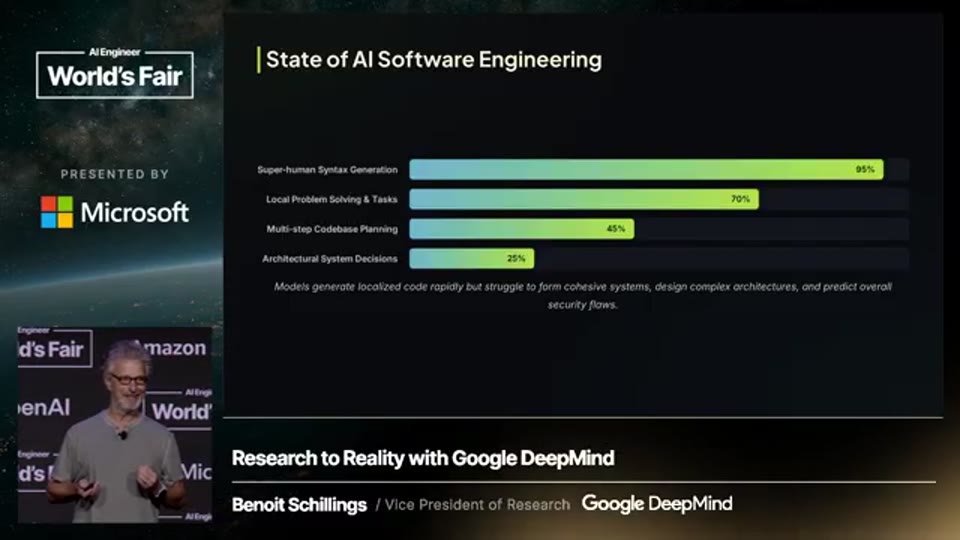
07:50 - 단순 코드 생성과 대규모 코드베이스 기반 소프트웨어 엔지니어링의 차이를 설명하는 화면
따라서 AI 코딩의 다음 프런티어는 multi-step codebase reasoning(다단계 코드베이스 추론)과 architecture-level thinking(아키텍처 수준 사고)에 있다. Google 규모의 시스템을 생각해 보면, 하드웨어 최적화, 보안, 운영, 유지보수, 10년 뒤의 기술 부채까지 모두 연결되어 있다. Schillings는 Jeff Dean을 Google 아키텍처의 핵심 인물로 언급하면서, 이런 수준의 사고가 앞으로 모델이 도달해야 할 영역이라고 설명한다.
코드가 AI 연구에 특별히 적합했던 이유
Schillings는 코드가 AI 발전에 특별히 유리한 도메인이었다고 설명한다. 첫 번째 이유는 데이터의 양이다. GitHub 같은 공개 저장소에는 방대한 코드가 존재했고, 모델을 훈련하기 위한 재료가 다른 많은 전문 영역보다 훨씬 풍부했다. 이 점은 초기 코드 생성 모델이 빠르게 발전할 수 있었던 중요한 조건이었다.
두 번째 이유는 검증 가능성이다. 코드는 실행할 수 있고, 컴파일할 수 있으며, unit test(단위 테스트)를 통해 일정 수준의 정답 여부를 확인할 수 있다. 자연어 에세이나 철학적 논증과 달리, 많은 코드 문제는 출력이 맞는지 틀리는지 비교적 명확하게 판단할 수 있다. 이 때문에 코드 영역은 모델이 생성한 결과를 평가하고 개선하는 루프를 만들기에 적합했다.
그러나 Schillings는 이 방식에도 한계가 왔다고 본다. 그는 오늘날 GitHub에 새로 추가되는 코드의 상당 부분, 구체적으로는 약 80%가 기계 생성 코드라고 말한다. 이 수치는 강연자의 발언에 기반한 것이며, STT만으로는 별도 출처나 측정 기준을 확인할 수 없다. 다만 그의 논지는 분명하다. 인간이 새롭게 작성한 코드에서 지식을 채굴해 모델을 훈련하는 방식은 점점 수확 체감에 들어가고 있으며, 이제는 다른 성장 방식이 필요하다는 것이다.
Self-play: AI 코딩의 다음 성장 엔진
Schillings가 제시하는 다음 성장 엔진은 Self-play(자기 대국·자기학습)이다. DeepMind가 AlphaZero를 통해 보여준 것처럼, 모델은 인간의 지식 없이도 자기 자신과의 대국을 통해 체스와 바둑에서 초인간적 수준에 도달할 수 있었다. Schillings는 코드 영역에서도 이와 유사한 전환이 가능하다고 본다.
프런티어 코드 모델은 이제 스스로 문제를 만들고, 답의 유효성을 판단하고, 어느 정도는 아키텍처의 타당성까지 평가할 수 있는 단계로 이동하고 있다. 이는 모델이 단순히 인간이 쓴 코드를 모방하는 것을 넘어, 스스로 해결 가능한 과제를 생성하고 반복적으로 개선하는 훈련 루프를 만들 수 있음을 뜻한다. Schillings는 이를 수억 시간 규모의 코드 작성 Self-play로 표현하며, 이 과정이 “초인간적 코딩”의 다음 지평을 열 것이라고 설명한다.
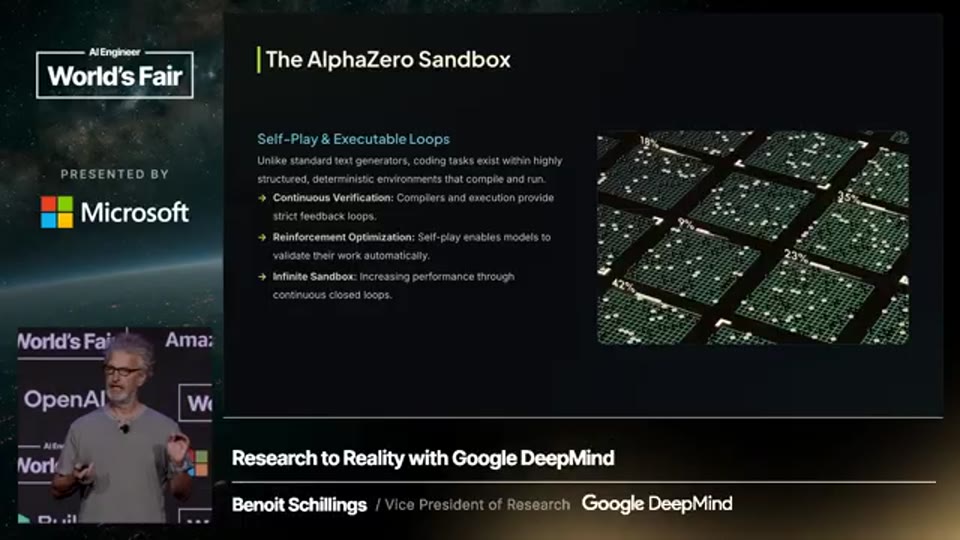
10:24 - AlphaZero식 Self-play를 코드 모델 훈련에 적용하는 아이디어를 설명하는 화면
그는 이를 인간 소프트웨어 엔지니어의 자기 훈련에 비유한다. 뛰어난 엔지니어를 2년 동안 방에 넣고 더 나은 엔지니어가 되라고 한다면, 그 사람은 스스로 과제를 만들고, 검증 가능한 문제를 풀고, 계속 코딩하며 실력을 키울 것이다. 모델도 같은 방식으로 훈련될 수 있다면, 핵심 제약은 인간 데이터의 양이 아니라 compute(연산 자원)와 Self-play 시간으로 바뀐다.
코드 작성 비용이 0에 가까워질 때 생기는 문제
Schillings는 AI가 바꾸는 것은 개발 생산성만이 아니라 코드의 경제학이라고 말한다. 기존의 소프트웨어 산업, 엔지니어링 문화, 리뷰 프로세스, 회사 구조는 모두 “코드 작성이 어렵고 비싼 일”이라는 가정 위에 세워져 있었다. 그런데 코드 작성 비용이 무료 또는 거의 무료에 가까워지면, 세상에 생성되는 코드의 양은 폭발적으로 증가한다.
이 변화는 단순히 더 많은 기능을 더 빠르게 만든다는 낙관적 이야기로 끝나지 않는다. 오히려 핵심 문제는 산더미처럼 생성되는 코드 앞에서 시스템 전체가 여전히 제대로 작동하고 신뢰할 수 있도록 유지하는 방법이다. Schillings는 앞으로 인간에게 중요한 일은 개별 코드 라인을 읽고 쓰는 것이 아니라, 거시적 수준에서 시스템의 설계 적합성, 안정성, 목적 부합성을 판단하는 일이 될 것이라고 본다.
그는 가까운 미래에는 모델이 생성한 코드를 사람이 거의 읽지 않는 시점이 올 것이라고 예측한다. 이는 오늘날 대부분의 개발자가 컴파일러가 만든 assembly output(어셈블리 출력)을 직접 확인하지 않는 것과 비슷하다. 한때는 어셈블리를 읽는 것이 실력의 일부였지만, 이제는 컴파일러를 신뢰하는 프로세스가 자리 잡았다. Schillings는 코드 생성 모델에 대해서도 비슷한 신뢰 구조가 필요해질 것이며, 그에 맞는 새로운 개발 프로세스가 요구된다고 본다.
보안의 이동: 취약점 탐지에서 처음부터 올바른 코드 생성으로
AI가 더 많은 코드를 생성할수록 보안 문제는 더 중요해진다. Schillings는 모델이 기존 코드에서 수많은 vulnerability(취약점)를 찾아내고, 그 취약점을 패치하는 흐름이 이미 나타나고 있다고 말한다. 그러나 그는 이것이 끝없는 과정이 될 가능성이 크다고 본다. 모델이 더 똑똑해질수록 더 깊고 미묘한 취약점을 찾아낼 것이고, 우리는 다시 그것을 고치는 루프에 들어갈 수 있기 때문이다.
그가 제시하는 더 근본적인 목표는 취약점을 나중에 탐지해 수정하는 것이 아니라, 모델이 처음부터 correct code(올바른 코드)를 작성하도록 가르치는 것이다. 이는 말처럼 쉽지 않다. 어떤 코드가 올바른지는 문맥에 따라 달라지고, 보안 요구사항은 제품의 목적, 실행 환경, 데이터 민감도, 사용자 권한 구조와 연결되어 있기 때문이다.
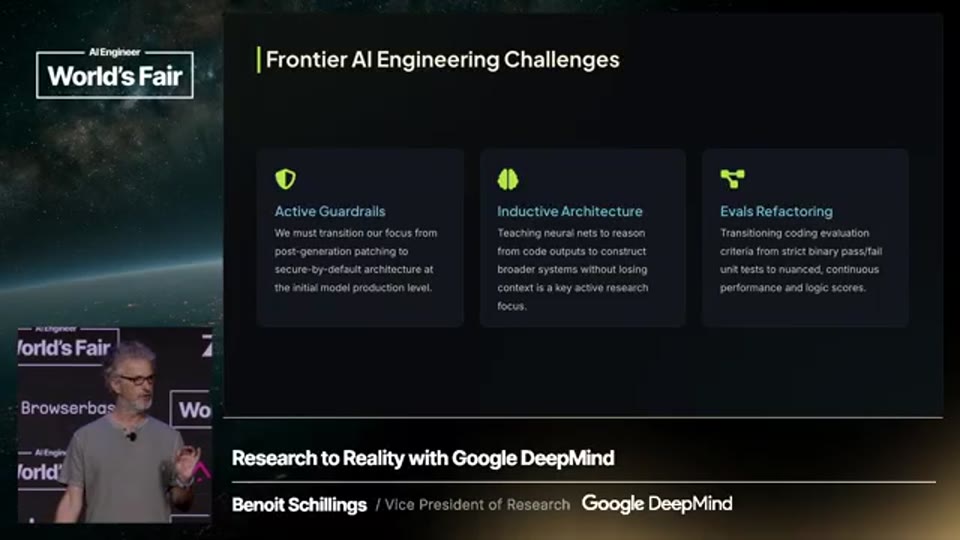
13:32 - 취약점 탐지와 패치를 넘어 처음부터 올바른 코드를 생성하도록 모델을 훈련해야 한다는 설명 화면
이 대목에서 Schillings의 관점은 단순한 자동화 낙관론과 구분된다. 그는 모델이 코드를 많이 쓰게 되는 미래일수록, 코드 작성 자체보다 코드의 의미와 영향, 안전성에 더 많은 관심을 기울여야 한다고 본다. AI 코딩 시대의 핵심 역량은 “빨리 생성하기”가 아니라 “처음부터 요구사항과 제약을 만족하는 시스템을 만들도록 유도하기”에 가까워진다.
Inductive Architecture: 모델에게 문제 분해와 계획을 가르쳐야 한다
Schillings는 향후 모델에게 필요한 능력 중 하나로 inductive architecture(귀납적 아키텍처)를 언급한다. 그의 설명에 따르면 현재 모델은 한 도메인의 지식을 다른 도메인에 옮겨 적용하거나, 서로 다른 두 개념의 교차점에서 새로운 구조를 찾아내는 능력이 아직 충분하지 않다. 이는 복잡한 소프트웨어 시스템을 설계하는 데 치명적인 한계가 될 수 있다.
복잡한 문제를 올바르게 풀려면 먼저 문제를 어떻게 나눌지 결정해야 한다. 어떤 경계로 모듈을 나눌 것인지, 어떤 추상화를 만들 것인지, 무엇을 공통화하고 무엇을 분리할 것인지에 따라 시스템의 명확성, 정확성, 유지보수성이 크게 달라진다. Schillings는 모델이 이런 planning(계획) 능력을 갖춰야 한다고 강조한다.
이는 코드 생성 모델 평가 방식에도 직접 연결된다. 단순히 주어진 입력에 대해 정답 출력을 내는지 확인하는 방식은 소프트웨어 엔지니어링의 작은 일부만 측정한다. 진짜 중요한 것은 모호하고 열린 문제를 만나도 좋은 구조를 만들고, 장기적 결과를 고려하며, 새로운 알고리즘적 접근을 탐색할 수 있는지다.
벤치마크의 한계: “돌아가는 코드”만으로는 부족하다
Schillings는 현재의 코드 벤치마크가 소프트웨어 엔지니어링의 본질을 충분히 평가하지 못한다고 비판한다. STT에서 “three bench”처럼 인식된 표현은 문맥상 SWE-bench를 가리키는 것으로 보인다. 그는 이런 벤치마크가 코드가 실행되고 올바른 출력을 내는지만 확인하는 경향이 있다고 설명하는데, 이는 소프트웨어 엔지니어링 전체에서 매우 작은 부분에 불과하다.
그가 흥미로운 예로 든 것은 text compression(텍스트 압축) 문제다. 모델에게 10MB 정도의 텍스트 또는 코드를 주고, lossless compression(무손실 압축)을 수행하는 최고의 compressor(압축기)를 작성하게 한다. 이때 손실 함수는 압축된 파일의 크기와 소스 코드의 크기를 합한 값이 될 수 있다. 이 문제는 단순히 정답을 맞히는 문제가 아니라, 더 나은 알고리즘을 계속 발명할 수 있는 열린 문제다.
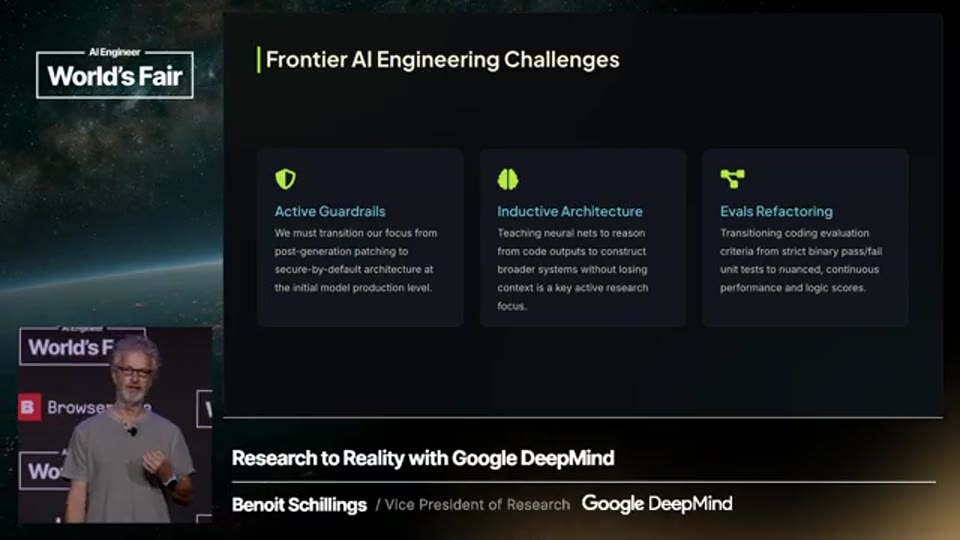
15:21 - 텍스트 압축 문제를 예로 들어 개방형 코드 평가 벤치마크를 설명하는 화면
Schillings는 이런 open-ended problem(개방형 문제)이 모델을 더 높은 수준으로 밀어 올릴 수 있다고 본다. 단순한 함수 구현 과제는 이미 모델이 잘하는 영역에 가깝지만, 텍스트 압축처럼 개선의 끝이 없는 문제는 모델이 새로운 알고리즘과 표현 방식을 탐색하도록 만든다. 결국 AI 코딩 평가도 “정답을 냈는가”에서 “새로운 접근을 만들어낼 수 있는가”로 이동해야 한다.
Chain of Thought를 넘어: 코딩은 시각적이고 다중양식적인 사고다
Schillings는 코드 작성이 단순한 chain of tokens(토큰의 연쇄)가 아니라고 말한다. 오늘날 많은 reasoning model(추론 모델)은 chain of thought(사고의 연쇄)를 통해 성능을 높였지만, 인간이 문제를 푸는 방식은 그보다 훨씬 복잡하다. 특히 코딩은 그에게 매우 시각적인 활동이다. 개발자는 블록 다이어그램, 데이터 흐름, 시스템 구성도, 상태 전이 같은 형태로 문제를 이해하는 경우가 많다.
이 관점에서 Gemini가 처음부터 multimodal model(다중양식 모델)로 설계되었다는 점은 중요하다. Schillings는 텍스트가 Gemini가 다루는 여러 modality(양식) 중 하나일 뿐이라고 설명한다. 모델이 공간적 표현이나 동적 표현을 통해 문제를 풀기 시작한다면, 코드 생성 역시 단순히 텍스트를 이어 쓰는 방식에서 벗어날 수 있다.
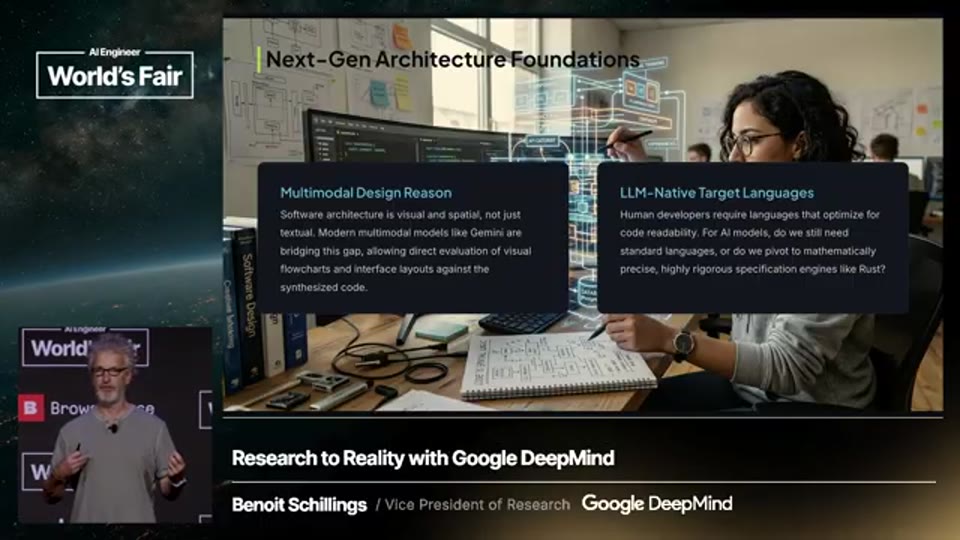
16:40 - Gemini의 다중양식 설계와 공간적·동적 표현 기반 추론을 설명하는 화면
이는 AI 코딩의 미래가 IDE 안의 텍스트 자동완성을 넘어설 수 있음을 시사한다. 모델은 시스템의 구조를 시각적으로 이해하고, 데이터 흐름을 추론하며, 실행 중인 동작을 동적으로 모델링해야 할 수 있다. Schillings는 이런 능력이 앞으로 필수 조건이 될 것이라고 본다.
인간을 위한 언어가 아니라 모델을 위한 언어가 필요할까
강연 후반부에서 Schillings는 도발적인 질문을 던진다. 이제 코드를 사람이 직접 작성하는 고통이 사라진다면, 굳이 인간이 쓰기 쉬운 언어를 계속 중심에 둘 필요가 있을까. Python을 비롯한 많은 프로그래밍 언어는 인간을 위해 발명되었고, 읽고 쓰기 편하다는 장점이 있지만, 안전하고 신뢰할 수 있는 코드를 작성하는 데 최적이라고 보기는 어렵다.
그는 모델이 코드를 쓰는 시대에는 오히려 작성하기 훨씬 어렵지만 안전성과 정확성을 강하게 요구하는 언어가 더 적합할 수 있다고 말한다. 예컨대 매우 강한 type system(타입 시스템)을 갖춘 언어나 Lean에서 영감을 받은 formal proof(형식 증명) 방식이 모델에게 correctness(정확성)의 부담을 더 많이 지울 수 있다. 물론 프로그램 증명에는 한계가 있지만, 최소한 모델이 처음부터 더 엄격한 제약 안에서 코드를 생성하도록 만들 수 있다.
더 나아가 그는 그런 언어가 반드시 인간이 읽기 쉬울 필요도 없다고 말한다. 이 대목은 AI 코딩 시대의 근본적 전환을 보여준다. 지금까지 프로그래밍 언어는 인간과 기계 사이의 타협물이었다면, 앞으로는 모델과 검증 시스템 사이의 계약 언어가 될 수도 있다.
코드를 넘어 과학으로: 실험 비용이 낮아질 때 열리는 영역
Schillings는 코드가 문제 해결을 위한 보편 언어라고 본다. 코드 작성과 실험의 비용이 낮아지면, 그 영향은 소프트웨어 산업 안에만 머물지 않는다. 그는 code writing과 atoms 또는 science의 교차점, 즉 코드 기반 실험이 물리적 세계와 과학 연구에 영향을 미치는 영역이 큰 전선이 될 것이라고 설명한다.
특히 그는 chemistry(화학)를 흥미로운 분야로 꼽는다. 인간은 화학을 이해한다고 말하지만, 실제로는 매우 작은 조각만 이해하고 있을 뿐이며, 분자가 20개 이상의 원자로 구성되기 시작하면 그 행동을 정확히 예측하기 어려워진다. Schillings는 10,000개의 원자를 조합할 수 있는 세계를 상상하며, 그 규모가 생명과 닮아가기 시작한다고 말한다. 이 발언은 AI가 분자 설계, 신소재, 생명과학 영역에서 인간이 직관적으로 탐색하기 어려운 공간을 열 수 있다는 기대와 연결된다.
Biology(생물학)에 대해서도 그는 비슷한 관점을 제시한다. 자연은 놀라운 엔지니어링 결과물을 만들었지만, 문서화는 형편없었다는 표현을 사용한다. 생명 시스템은 작동하지만, 인간은 그 설계 의도와 내부 관계를 완전히 이해하지 못한다. 모델은 인간에게 보이지 않는 관계를 찾아내며, 그 문서화되지 않은 자연의 엔지니어링을 해독하는 도구가 될 수 있다.
우리가 보지 못하는 금: 인간 편향을 넘어선 발견
강연의 마지막에서 Schillings는 “gold we cannot see”, 즉 우리가 보지 못하는 금을 이야기한다. 인간은 자신이 옳다고 느끼는 해법에 강하게 편향되어 있다. 우리의 사고는 정글에서 생존하도록 진화한 결과이지, 양자컴퓨팅이나 복잡한 분자 설계를 위해 최적화된 결과가 아니다.
이 말은 인간 지능의 한계를 낮춰보는 것이 아니라, 인간이 뛰어난 영역과 보지 못하는 영역을 구분하자는 제안에 가깝다. 인간은 창의적이고 혁신적일 수 있지만, 여전히 진화적 배경과 감각적 직관, 기존 학문 구조의 제약 안에서 문제를 본다. 반면 머신러닝 모델은 완전히 다른 방식으로 탐색 공간을 바라볼 수 있고, 그 때문에 인간이 너무 당연하게 지나친 해법을 찾아낼 가능성이 있다.
Schillings는 미래의 AI 발전에서 가장 흥미로운 순간이 “이게 계속 우리 앞에 있었는데 왜 보지 못했을까”라고 깨닫는 순간일 것이라고 말한다. 이 관점에서 AI 코딩은 단지 개발자 도구의 발전이 아니라, 인간이 문제를 정의하고 탐색하는 방식 자체를 확장하는 출발점이다.
마무리 / 핵심 정리
Benoit Schillings의 강연은 AI 코딩의 미래를 단순한 생산성 향상으로 축소하지 않는다. 그는 코드 작성 능력은 이미 빠르게 상품화되고 있으며, 앞으로의 핵심은 대규모 시스템 이해, 정확한 문제 분해, 보안, 검증, 아키텍처, 다중양식 추론으로 이동한다고 본다. 이 변화 속에서 인간은 더 이상 모든 코드를 직접 읽고 쓰는 존재가 아니라, 의도와 제약을 설계하고 모델이 만든 결과의 거시적 의미를 판단하는 역할로 이동할 가능성이 크다.
강연에서 가장 중요한 전환점은 데이터 중심 학습에서 Self-play 중심 학습으로의 이동이다. GitHub의 인간 작성 코드가 더 이상 무한한 학습 자원이 될 수 없다면, 모델은 스스로 문제를 만들고 검증하며 성장해야 한다. 이 방식은 AlphaZero가 게임에서 보여준 초인간적 성능의 논리를 코드와 소프트웨어 엔지니어링으로 확장하는 시도다.
결국 Schillings가 제시하는 미래는 “AI가 코드를 대신 써준다”는 수준을 넘어선다. AI는 더 엄격한 언어로 더 안전한 코드를 만들고, 시각적·공간적 표현을 통해 시스템을 이해하며, 화학과 생물학 같은 과학 영역에서 인간이 보지 못한 해법을 찾는 도구가 될 수 있다. 이 미래에서 중요한 질문은 개발자가 사라지는가가 아니라, 인간이 어떤 수준의 문제를 정의하고 어떤 기준으로 모델의 사고를 이끌 것인가이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Research to Reality - Benoit Schillings, Google DeepMind, VP Research (Thinking, Reasoning, Coding) |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-18 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.