Scaling beman.exemplar - Eddie Nolan - C++Now 2026
📺 원본 영상: Scaling beman.exemplar - Eddie Nolan - C++Now 2026
🎙️ 채널: CppNow
📅 정리 일자: 2026-08-10
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Eddie Nolan의 이 강연은 Beman Exemplar라는 단일 프로젝트 템플릿을 소개하는 데서 출발하지만, 실제 핵심은 Beman 프로젝트 전체의 C++ 라이브러리 인프라를 어떻게 확장 가능한 형태로 만들었는가에 있다. Beman은 C++ 표준 라이브러리 제안의 reference implementation(참조 구현)을 담기 위한 생태계이며, Exemplar는 그 라이브러리들이 공통으로 가져야 할 CMake, 패키징, CI, 모듈 지원, 릴리스 구조의 원형 역할을 한다.
강연의 흐름은 프로젝트 구조에서 시작해, CMake와 패키지 관리의 경계, vcpkg 기반 배포, C++ Modules의 현실적 제약, GitHub Actions 기반 CI 매트릭스 설계, 그리고 마지막으로 템플릿 변경 사항을 여러 저장소에 전파하는 template drift 문제로 이어진다. 단순한 “좋은 템플릿 만들기”가 아니라, 표준화 후보 라이브러리들이 빠르게 변하는 컴파일러와 표준 초안 위에서도 지속적으로 검증될 수 있도록 만드는 운영 체계가 강연의 중심이다.
Beman 프로젝트가 해결하려는 문제
강연자는 Beman 프로젝트의 출발점을 C++ 표준 라이브러리 제안자들이 겪던 현실적인 불편에서 찾는다. 과거에는 새 표준 라이브러리 제안을 구현할 때 Boost에 먼저 올리는 방식이 흔했지만, Boost 라이브러리로 받아들여진 뒤에는 API 안정성에 대한 기대가 생긴다. 문제는 표준화 과정에서는 위원회의 피드백에 따라 API가 바뀔 가능성이 크다는 점이다. 이미 안정화된 Boost API를 유지해야 하는 상황에서는, 표준화 직전의 변경 사항을 실제 구현으로 충분히 검증하기가 어려워진다.
다른 선택지는 각 제안자가 직접 저장소와 빌드 시스템을 꾸리는 것이다. 그러나 이는 CMake, 테스트, 설치, CI, 패키징 같은 주변 인프라를 매번 새로 고민해야 한다는 뜻이며, 표준 라이브러리 설계라는 본질적인 작업에서 에너지를 빼앗는다. 더 간단한 방법으로 Compiler Explorer 링크를 논문에 넣는 경우도 있지만, 강연자는 이것이 discoverability(발견 가능성), 지속적 테스트, 장기 유지보수 측면에서 충분하지 않다고 본다. Beman은 바로 이 간극을 메우기 위해, 표준화 제안 구현체를 위한 공통 저장소 구조와 품질 기준을 제공한다.
Beman의 maturity model(성숙도 모델)도 일반 라이브러리와 다르다. 라이브러리는 처음에는 under development 상태로 시작하고, Boost review와 유사한 검토 과정을 거치면 production-ready로 이동한다. 그러나 이 단계에서도 API 안정성이 보장되지는 않는다. ISO C++ 표준에 실제로 반영된 뒤에야 API stable로 볼 수 있으며, 이후 약 6년 동안 적극적으로 유지보수한 뒤에는 사용자가 표준 라이브러리 구현으로 이동하도록 유도한다. 만약 제안이 표준화되지 않거나 중단되면, 해당 라이브러리는 early retirement 또는 archived 상태로 이동한다.
Exemplar의 프로젝트 구조와 vendoring 현실
Beman Exemplar는 새 Beman 라이브러리를 만들기 위한 template repository 역할을 한다. 강연에서 소개된 새 프로젝트 구조에는 CMakeLists.txt, CMakePresets.json, README, CONTRIBUTING, 라이선스 파일, vcpkg 관련 템플릿, lockfile.json, 실제 C++ 헤더와 테스트 코드, 그리고 infra 디렉터리가 포함된다. 이 구조는 단순히 파일을 예쁘게 배치한 것이 아니라, 새 표준 라이브러리 구현체가 곧바로 빌드, 테스트, 설치, 패키징, 문서화 흐름에 올라탈 수 있도록 설계되어 있다.
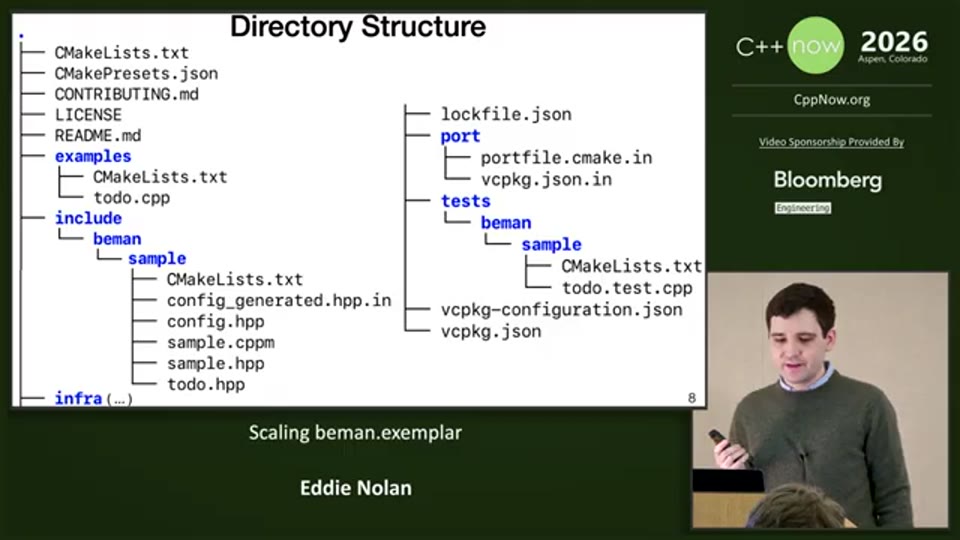
05:21 - 새 Beman 라이브러리를 생성했을 때의 Exemplar 기반 프로젝트 디렉터리 트리 설명
Exemplar는 Cookiecutter를 사용해 새 라이브러리를 찍어낸다. Cookiecutter는 Python 기반 템플릿 도구로, Jinja 템플릿 안에 라이브러리 이름, 네임스페이스, 빌드 옵션 같은 값을 채워 넣어 새 프로젝트를 생성한다. 과거에는 header-only 라이브러리와 static library 중 선택할 수 있었지만, 강연 시점에는 C++ Modules 지원을 추가하는 과정에서 해당 옵션이 잠시 제거되었다고 설명한다. 다만 강연자는 이것이 근본적인 제약은 아니며, 다시 지원할 계획이라고 말한다.
특히 흥미로운 부분은 config.hpp와 config-generated.hpp의 분리다. C++ 라이브러리에서는 feature test macro나 컴파일러 플래그에 따라 ABI가 달라질 수 있고, 서로 다른 설정으로 빌드된 라이브러리를 링크하면 ODR(One Definition Rule) 문제와 undefined behavior(정의되지 않은 동작)가 발생할 수 있다. Beman은 이를 완화하기 위해 CMake가 생성하는 config-generated.hpp에 빌드 환경에 의존하는 값을 넣고, 일반 config.hpp는 이 생성 파일이 없을 때 fallback define을 제공하도록 구성한다. 이는 CMake를 통해 정식으로 가져오는 사용자뿐 아니라, include 디렉터리만 복사해 사용하는 vendoring 사용자까지 어느 정도 지원하려는 절충이다.
10:29 - config.hpp와 config-generated.hpp를 통해 ABI와 ODR 문제를 완화하는 구조 설명
infra 디렉터리와 공통 CMake 로직의 분리
Exemplar 안의 infra 디렉터리는 Beman project infra 저장소의 vendored copy에 가깝다. 강연자는 이 디렉터리를 통해 각 라이브러리에 흩어져 있던 CMake 로직을 최대한 deduplicate(중복 제거)하려 했다고 설명한다. 특히 toolchain file은 CMake presets에서 직접 참조되기 때문에, 사용자에게 일관된 빌드 환경을 제공하는 데 중요한 역할을 한다.
또 하나의 핵심 파일은 beman-install-library.cmake다. 과거에는 각 라이브러리가 자신만의 설치 로직을 가지고 있었지만, 이는 라이브러리마다 조금씩 다른 실수를 만들기 쉬운 구조였다. Beman은 이를 공통 함수 호출로 추상화해, 개별 라이브러리가 bespoke installation logic(맞춤형 설치 로직)을 반복 작성하지 않도록 했다. 이 접근은 나중에 C++ Modules 설치 지원과도 연결되며, 인프라를 한곳에서 개선하면 여러 라이브러리가 동시에 이익을 얻는 구조를 만든다.
강연자는 최근 추가된 build telemetry(빌드 텔레메트리)도 언급한다. CMake 4.3 같은 최신 버전을 사용할 경우, 빌드 과정의 각 compile 작업이 얼마나 걸리는지 분석할 수 있는 파일을 생성하고, 이를 웹 GUI에 넣어 빌드 성능을 살펴볼 수 있다. Windows에서도 Git Bash와 jq가 있으면 동작하도록 테스트했으며, 환경이 갖춰져 있지 않으면 빌드를 실패시키지 않고 telemetry를 건너뛰는 방식으로 설계했다. 이처럼 Exemplar의 인프라는 엄격한 검증과 사용자 경험 사이에서 현실적인 균형을 잡고 있다.
FetchContent에서 find_package로: CMake는 패키지 매니저가 아니다
강연의 패키징 파트는 CMake의 역할에 대한 중요한 구분에서 시작한다. 초기 Beman Exemplar는 GoogleTest 같은 의존성을 CMake FetchContent로 가져오는 단순한 방식을 사용했다. FetchContent는 편리하지만, 의존성을 현재 CMake 프로젝트의 하위 프로젝트처럼 추가하기 때문에 설치 단계에서 문제가 생긴다. 예를 들어 foo가 bar에 의존하고 bar를 FetchContent로 가져오면, CMake는 bar를 외부 패키지가 아니라 같은 프로젝트의 target으로 인식하고, foo를 install export set에 넣을 때 bar도 같은 export set에 있어야 한다고 요구할 수 있다.
강연자는 이 문제가 단순한 에러 메시지의 문제가 아니라, CMake와 package management(패키지 관리)의 책임 경계에서 비롯된다고 본다. Cargo나 uv와 달리 CMake는 본질적으로 빌드 구성 도구이지 패키지 매니저가 아니다. 따라서 더 올바른 구조는 라이브러리 CMakeLists.txt 내부에서 raw FetchContent 호출을 직접 수행하는 것이 아니라, find_package를 사용하고, 실제 의존성 획득은 외부 패키지 매니저나 별도 provider가 맡게 하는 것이다.
Beman은 이 방향으로 전환하면서도 FetchContent의 편리함을 완전히 버리지는 않았다. CMake의 dependency provider mechanism을 사용해 find_package 호출을 가로채고, 사용자가 opt-in한 경우 내부적으로 FetchContent를 통해 의존성을 내려받도록 했다. 이 방식은 FetchContent의 구조적 문제를 완전히 없애지는 않지만, 적어도 라이브러리 본문이 find_package 기반의 올바른 인터페이스를 유지하게 만든다. 다시 말해, 사용자는 편의상 FetchContent를 선택할 수 있지만, 프로젝트는 더 정석적인 패키징 경로를 닫아버리지 않는다.
vcpkg 레지스트리와 Beman 패키징 모델
Beman은 FetchContent provider를 넘어 vcpkg 기반의 더 정식적인 패키징 흐름도 구축했다. vcpkg는 manifest mode와 classic mode를 모두 지원하는데, Beman은 각 라이브러리 저장소에 vcpkg.json.in과 portfile.cmake.in 같은 템플릿 파일을 두고, 릴리스 시점에 이를 실제 vcpkg registry에 찍어내는 방식을 사용한다. 템플릿에는 버전뿐 아니라 릴리스 tarball의 SHA-512 hash 같은 값이 들어가야 하므로, 릴리스 워크플로가 이를 채워 넣는다.
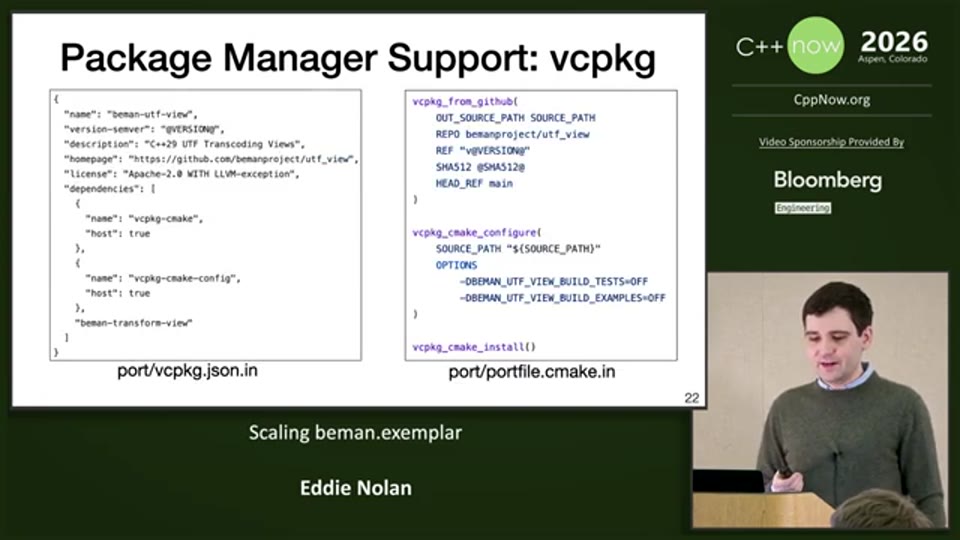
24:22 - vcpkg.json과 portfile.cmake 템플릿 및 SHA-512 기반 릴리스 패키징 설명
강연에서 반복적으로 등장하는 예시는 beman.utf_view와 beman.transform_view다. UTF view는 transform view에 의존하므로, Beman vcpkg registry는 Microsoft의 upstream vcpkg registry와 별도로 Beman 라이브러리들을 찾을 수 있는 fallback registry 역할을 한다. 이를 통해 모든 Beman 라이브러리를 곧바로 upstream vcpkg에 올리지 않아도, Beman 생태계 내부에서는 서로를 패키지로 참조할 수 있다.
vcpkg registry의 버전 관리 방식도 흥미롭다. registry에는 ports 디렉터리 아래 최신 portfile과 vcpkg.json이 있고, versions 디렉터리 아래 baseline.json과 각 패키지별 JSON이 있다. 오래된 버전은 파일을 계속 복사해 두는 방식이 아니라, Git object의 tree hash를 기록해 두고 필요할 때 Git history에서 해당 시점의 portfile을 꺼내는 방식으로 지원된다. 이 구조 덕분에 registry는 최신 파일 중심으로 단순하게 유지되면서도 과거 릴리스 설치를 지원할 수 있다.
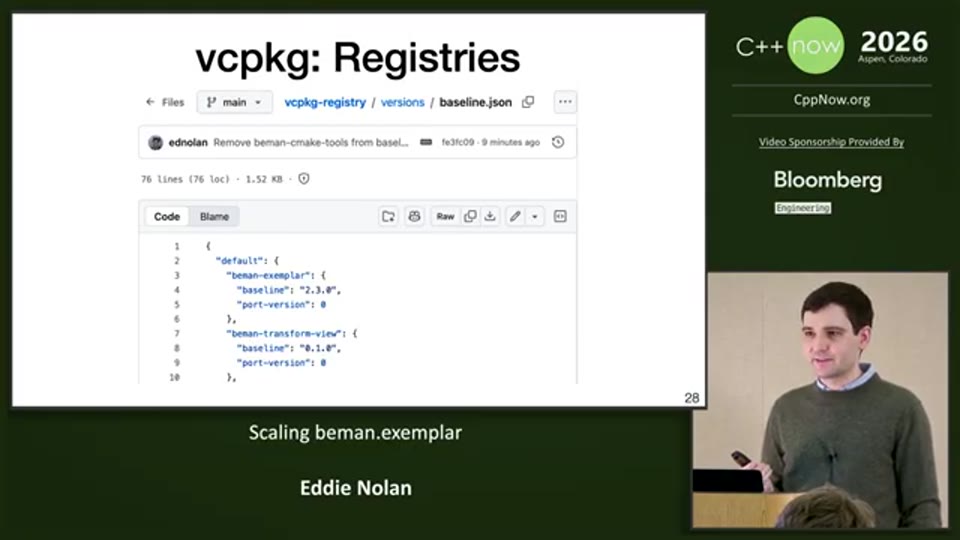
30:51 - Beman vcpkg registry의 baseline.json, versions 디렉터리, Git tree hash 기반 버전 관리 설명
왜 infra는 패키지로만 해결되지 않는가
패키징 체계가 갖춰졌다면 infra 디렉터리도 패키지로 가져오면 될 것처럼 보인다. 그러나 강연자는 toolchain file 때문에 이 문제가 단순하지 않다고 설명한다. CMakePresets.json은 configure 단계에서 toolchain file을 참조하는데, 그 toolchain file을 가져오기 위해서는 이미 CMake가 실행되어야 한다. 즉, toolchain file을 fetch하려면 toolchain file이 필요한 chicken-and-egg problem(닭과 달걀 문제)이 생긴다.
Git submodule도 검토되었지만, 사용자 경험과 GitHub release tarball 문제가 발목을 잡았다. 사용자가 git submodule update를 실행하지 않으면 CMake는 toolchain file을 찾지 못하고, 이 시점에는 프로젝트의 CMake 코드가 실행되기 전이므로 친절한 에러 메시지를 제공하기 어렵다. 또한 GitHub가 자동 생성하는 source tarball은 submodule 내용을 채우지 않으며, 이 자동 tarball을 끌 수 없기 때문에 릴리스 산출물에서도 문제가 생긴다.
Beman은 결국 자체적인 beman-submodule 도구를 만들었다. 이 도구는 infra 디렉터리 안의 설정 파일에 기록된 remote와 commit hash를 기준으로, 실제 infra 내용이 upstream과 일치하는지 확인하고 업데이트한다. 이름은 submodule이지만 Git submodule을 직접 쓰지 않고, 필요한 검증과 사용자 경험을 Beman 쪽에서 통제하는 방식이다. 강연자는 이 도구가 PyPI에도 올라가 있어 원한다면 외부에서도 쓸 수 있다고 언급한다.
C++ Modules 지원의 현실: import std는 아직 까다롭다
C++ Modules 파트에서 강연자는 먼저 compiler support의 현재 상태를 짚는다. 단순한 module hello 예제에서 module 내부는 include
이 문제는 단순히 “include 순서를 조심하자”로 끝나지 않는다. 표준의 취지상 사용자는 include와 import를 임의의 순서로 섞을 수 있어야 하지만, 실제 toolchain은 아직 그 수준에 도달하지 못했다. MSVC는 강연자의 테스트에서 module 문제가 거의 없었고, Clang trunk는 특정 예제를 처리했지만, Clang 22는 여전히 실패했다고 한다. GCC도 GCC 16에서
이 때문에 Beman은 현실적인 사용 규칙을 둔다. Beman module을 import한 뒤에는 표준 라이브러리 include를 두지 말고, 가장 쉬운 방법은 import std를 일관되게 사용하는 것이다. 이는 이상적인 C++ Modules 사용 모델이라기보다는, 현재 compiler와 standard library 구현의 제약 안에서 Beman 라이브러리가 modules를 제공하기 위한 운영 규칙에 가깝다.
Header와 Module을 동시에 지원하는 세 가지 모드
Beman의 module 구현 방식은 Boost 쪽에서 Ruben Perez가 제안한 접근을 받아들인 것이다. 기본 아이디어는 기존 header-only 구현을 유지하면서, 별도의 .cppm module interface file에서 export module을 선언하고 import std를 수행한 뒤, 기존 .hpp 구현을 export block 안에 include하는 방식이다. 이렇게 하면 같은 구현을 header 방식과 module 방식에서 공유할 수 있다.
문제는 이 구조에서 header가 세 가지 모드로 동작해야 한다는 점이다. 첫 번째는 module을 쓰지 않는 일반 header include 모드이며, 이때는 표준 라이브러리 헤더 include와 구현이 모두 들어간다. 두 번째는 module interface unit 안에서 include되는 모드로, 이 경우 import std가 이미 처리되었으므로 표준 라이브러리 include를 피하고 구현만 노출해야 한다. 세 번째는 사용자가 module-enabled build에서 기존처럼 header를 include하는 compatibility mode이며, 이때 header include는 실제 구현 대신 적절한 import statement로 바뀐다.
이를 위해 Beman은 use_modules와 included_from_interface_unit 같은 macro를 사용한다. 이 방식은 boilerplate가 header 안으로 들어가는 intrusive change(침투적인 변경)이기 때문에 완전히 깔끔하지는 않지만, 현재로서는 구현과 호환성을 동시에 잡기 위한 실용적인 절충이다. 또한 detail header처럼 외부 API로 노출하면 안 되는 파일은 export block 밖에서 include함으로써, 파일 단위로 module visibility를 관리할 수 있다고 설명한다.
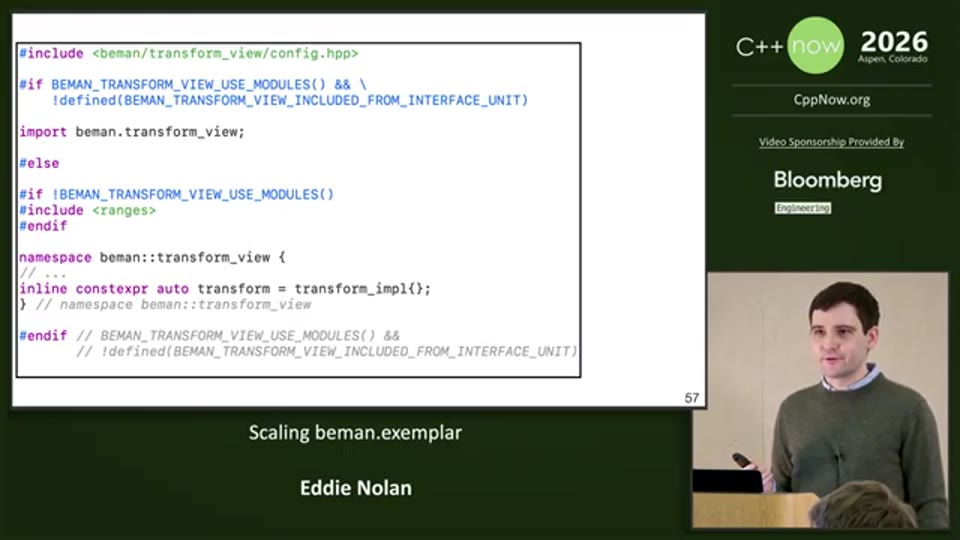
47:12 - transform_view.hpp에서 macro를 사용해 header mode, module interface mode, import compatibility mode를 나누는 구조 설명
CI는 단순 빌드가 아니라 품질 모델이다
강연의 가장 큰 비중은 GitHub Actions 기반 CI에 있다. Beman 라이브러리는 표준화 후보 구현체라는 특성상 여러 compiler, 여러 C++ standard version, sanitizer, standard library 조합에서 지속적으로 검증되어야 한다. 강연자는 먼저 Coveralls를 통한 code coverage를 소개하며, percentage 자체보다 source browser에서 녹색으로 표시되지 않은 줄을 보는 경험이 더 유용하다고 강조한다. 실제로 UTF view 구현에서 coverage가 비어 있는 영역을 확인하다가 여러 버그를 찾았다고 한다.
다만 coverage에도 한계가 있다. template code가 instantiate되지 않으면 coverage denominator에도 들어가지 않을 수 있고, constexpr code는 compile-time에 실행되더라도 일반적인 runtime coverage 도구에는 보이지 않는다. 강연자는 이 문제를 완화하기 위해 constexpr 테스트 함수를 static_assert로 compile-time 검증하고, 동시에 runtime에서도 실행해 coverage를 얻는 방식을 사용한다고 설명한다. 이는 C++ 라이브러리 테스트에서 compile-time correctness와 runtime coverage가 서로 다른 축이라는 점을 잘 보여준다.
또한 Beman은 pre-commit을 통해 formatting과 linting을 관리한다. trailing whitespace 같은 단순 문제는 git hook으로 커밋 전에 자동 수정할 수 있고, clang-format 같은 항목은 maintainer가 선택적으로 켤 수 있다. 이 안에는 beman-tidy도 포함되며, Beman standard 중 machine-checkable한 규칙을 검사한다. 예를 들어 모든 Beman 라이브러리는 examples를 제공해야 하므로, 예제가 없는 저장소는 CI에서 실패하도록 만들 수 있다.
전통적인 CI matrix의 한계와 JSON tree configuration
기존 GitHub Actions matrix는 platform, C++ version, CMake arguments 같은 축을 곱해서 job을 만든다. 이 방식은 이해하기 쉽지만, 축이 늘어날수록 조합 폭발이 발생한다. sanitizer build를 모든 C++ version과 모든 compiler에 대해 돌리면 CI 자원이 낭비되고, debug와 release를 병렬화하려 하면 job 수가 급격히 늘어난다. Clang에서 libstdc++와 libc++를 모두 시험하고, compiler version까지 늘리면 단순 matrix로는 원하는 조합만 정교하게 선택하기 어렵다.
Beman은 이를 해결하기 위해 자체 JSON configuration language를 만들었다. 이 구조는 모든 축을 전부 곱하는 matrix가 아니라 tree 형태로 구성되어, 특정 compiler version과 C++ standard 조합 안에서만 필요한 test 목록을 확장할 수 있다. 예를 들어 최신 Clang과 C++26 조합에서는 sanitizer와 warn-error job을 돌리되, 오래된 Clang에서는 지원되지 않는 최신 standard 조합을 제외할 수 있다. 이는 “모든 조합을 다 돌리는” 방식이 아니라, 의미 있는 위험 영역을 선별해 검증하는 방식이다.
강연 시점의 Exemplar는 C++ build and test에 대해 82개의 job을 구성한다고 설명한다. 하지만 Exemplar 자체가 매우 작은 라이브러리라 전체 CI가 약 5분 안에 끝날 수 있고, 더 무거운 beman.execution도 33개 job을 약 8분대에 돌린다고 한다. 이 수치는 CI가 충분히 넓은 조합을 다루면서도, contributor가 기다릴 수 있는 피드백 루프 안에 머물도록 설계되었음을 보여준다.
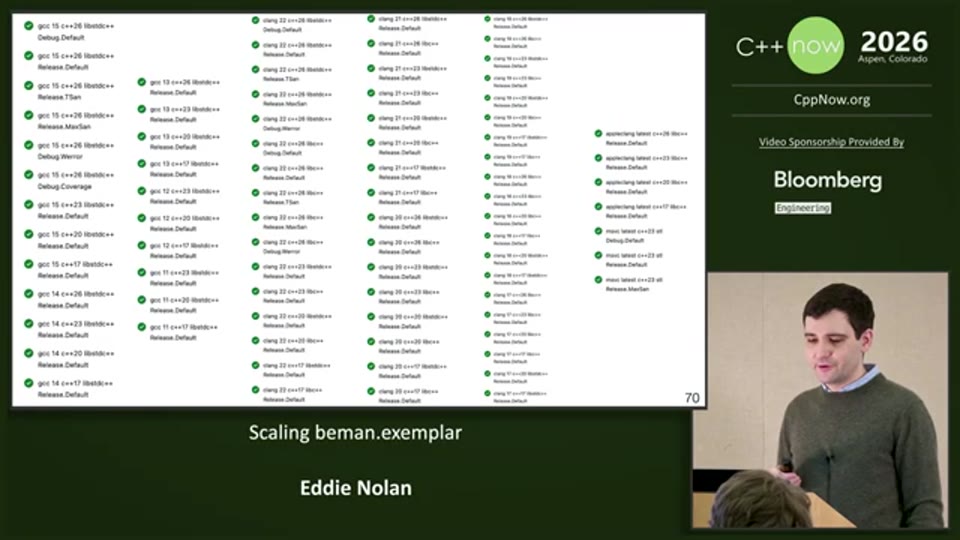
57:42 - 새 CI configuration에서 compiler, standard library, sanitizer, warn-error job을 정교하게 구성한 전체 job 목록 설명
Gentoo 기반 Docker 이미지와 최신 컴파일러 추적
Beman CI는 compiler와 도구를 미리 설치한 자체 Docker image를 사용한다. 과거에는 CI job 안에서 apt로 필요한 compiler version을 설치하기도 했지만, 이는 매번 불필요한 overhead를 만든다. Beman은 최신 C++ standard를 대상으로 하기 때문에 새 compiler release를 빠르게 반영해야 하고, 동시에 trunk build와 일부 compiler fork도 시험할 수 있어야 했다.
Ubuntu는 안정적이지만 공식 compiler release나 trunk build를 빠르게 가져오는 데 한계가 있었고, NixOS와 Arch는 강연자가 시도했으나 막혔다고 설명한다. 반면 Gentoo는 binary package cache와 source build를 함께 지원하고, LLVM trunk의 date-stamped build를 제공해 Beman의 요구에 잘 맞았다. Gentoo는 오래된 compiler도 어느 정도 제공하는데, 강연자는 Clang 16 정도면 표준화 관점에서는 이미 충분히 과거 버전이며, 실제 이미지는 Clang 17 정도부터 만든다고 언급한다.
이 Docker image build 역시 GitHub Actions로 자동화되어 있다. binary cache에 있는 compiler는 약 20분이면 image를 만들 수 있지만, source build가 필요한 경우 Clang build에 몇 시간이 걸릴 수 있다. 그래도 이 구조 덕분에 Beman은 GCC 16 같은 새 compiler release를 매우 빠르게 CI matrix에 반영할 수 있었다. 강연자는 GCC trunk에서 std::non-type 제거가 반영된 것을 scheduled CI가 다음 날 감지했고, 덕분에 GCC 16 release 전에 UTF view 구현을 std::constant_wrapper 기반으로 고칠 수 있었다고 소개한다.
Local CI와 AI가 만든 전용 도구
GitHub Actions를 로컬에서 돌리는 업계 표준 도구로는 act가 있지만, 강연자는 thread sanitizer 권한 설정 등에서 원하는 사용자 경험을 얻지 못했다고 말한다. 그래서 그는 AI에게 전용 도구를 만들도록 프롬프트를 작성했고, 그 결과 Beman local CI라는 도구가 만들어졌다. 이 도구는 내부적으로 Docker container를 띄워 Beman CI configuration 중 원하는 부분만 필터링해 실행한다.
이 접근은 단순한 편의 기능 이상의 의미가 있다. contributor가 GitHub에 push한 뒤 Actions 결과를 기다리는 대신, 로컬에서 GCC C++26 job 같은 특정 조합을 먼저 검증할 수 있기 때문이다. MSVC는 Docker에서 직접 처리하기 어렵지만, GCC와 Clang 기반 job에 대해서는 실제 CI와 상당히 가까운 환경을 로컬에서 재현할 수 있다.
강연자는 README의 compiler matrix와 CI configuration이 일치하는지 검사하는 Beman readme platforms라는 도구도 소개한다. 이 역시 AI를 활용해 만든 도구이며 PyPI에 배포되어 있다. 여기서 AI는 단지 코드 생성 장난감이 아니라, 반복적인 인프라 작업을 자동화하고 저장소 간 일관성을 유지하는 도구로 쓰인다.
Template Drift: Exemplar가 좋아질수록 생기는 문제
Exemplar가 계속 개선되면, 과거 버전의 Exemplar에서 생성된 라이브러리들은 자연스럽게 뒤처진다. 강연자는 이를 template drift라고 부른다. 새 Exemplar에는 infra 디렉터리 구조, find_package 전환, beman-install-library, refactored CI, header-only interface library model, telemetry, vcpkg packaging 같은 변화가 들어가지만, 이미 생성된 라이브러리에는 자동으로 반영되지 않는다.
infra 디렉터리에 있는 내용은 beman-submodule 메커니즘으로 비교적 쉽게 업데이트할 수 있다. 그러나 모든 변화가 infra로 분리될 수 있는 것은 아니다. C++ header 안의 modules boilerplate, CMakeLists.txt의 project-specific 설정, README의 compiler matrix처럼 라이브러리마다 달라지는 부분은 단순 복사로 해결하기 어렵다. maintainer가 기존 구현을 수정해 둔 경우에는 새 템플릿을 덮어쓰는 순간 충돌이 생긴다.
처음에는 강연자가 AI를 사용해 각 저장소의 상태를 조사하고, 어떤 refactor가 적용되어 있는지 Google Sheets에 정리했다고 한다. 이후 비교적 쉬운 라이브러리부터 최신 Exemplar를 다시 stamp out하고, 기존 라이브러리의 실제 구현 코드를 새 scaffolding 위로 옮기는 방식으로 업데이트했다. 이 방식은 꽤 많은 저장소에 적용될 만큼 효과적이었지만, 매번 전체 템플릿을 다시 찍어내는 것은 무겁고 일회성에 가깝다.
.exemplar-version과 commit 단위 전파
더 지속 가능한 방식으로 Beman은 각 라이브러리에 .exemplar-version 파일을 두기 시작했다. 이 파일은 해당 라이브러리가 마지막으로 동기화된 Exemplar commit hash를 기록한다. 이를 통해 현재 Exemplar에는 있지만 해당 라이브러리에는 아직 반영되지 않은 commit 목록을 알 수 있다.
흥미로운 점은 이 commit들을 raw patch로 기계적으로 적용하지 않는다는 것이다. 강연자는 각 Exemplar commit을 별도의 AI agent에게 넘기고, 해당 라이브러리의 맥락에 맞게 qualitatively(의미 기반으로) 적용하도록 한다고 설명한다. 예를 들어 Exemplar의 packaging commit은 GoogleTest 의존성을 기준으로 작성되어 있을 수 있지만, beman.monadics는 Catch2를 쓰고, beman.any_view는 benchmark 관련 의존성이 있으며, beman.utf_view는 transform_view에 의존한다. AI는 byte-level patch가 아니라 “이 변경의 의도”를 적용하기 때문에, 라이브러리별 차이를 반영할 수 있었다고 한다.
이 방식은 token을 많이 쓰지만, 강연자는 사람이 수작업으로 해야 할 일을 줄이는 데 효과적이라고 평가한다. GCC 16 rollout도 같은 흐름으로 처리했다. 먼저 Beman local CI로 관련 라이브러리들이 GCC 16을 지원하는지 확인했고, 모두 별도 수정 없이 통과하자 Exemplar CI matrix에 GCC 16을 추가했다. 이후 각 라이브러리의 서로 다른 CI matrix와 README를 고려해 변경을 전파했고, 새 compiler release 다음 날 여러 라이브러리에 반영할 수 있었다.
💡 [영상 참조] 강연자는 template drift를 설명하는 다이어그램, Google Sheets 기반 상태 표, 그리고 여러 AI agent가 Exemplar commit을 각 라이브러리에 적용하는 과정을 보여줍니다.
📺 원본 영상에서 확인하세요.
이 강연이 C++ 프로젝트 운영에 주는 함의
이 강연의 실질적인 메시지는 “좋은 C++ 라이브러리는 코드만으로 완성되지 않는다”는 것이다. 특히 표준화 후보 라이브러리는 API 실험, compiler 변화, 패키징, 테스트, 문서화, module support, 릴리스 배포가 한꺼번에 움직이는 환경에 놓인다. Beman Exemplar는 이 복잡성을 개별 제안자에게 떠넘기지 않고, 공통 인프라로 흡수하려는 시도다.
물론 이 정도의 인프라가 모든 개인 C++ 프로젝트에 필요한 것은 아니다. 강연 후반 Q&A에서도 “vendoring, vcpkg, FetchContent, module, CI 등 너무 많은 사용 방식을 지원하는 것이 과한가”라는 질문이 나온다. 강연자는 개인 프로젝트라면 vendoring 지원까지 굳이 하지 않을 수도 있고, vcpkg 대신 FetchContent만 지원할 수도 있다고 답한다. 다만 Beman의 경우 한 번 구축한 인프라가 여러 표준화 후보 라이브러리에 공유되고, CI가 깨진 부분을 알려주기 때문에 그 비용이 정당화된다.
또 다른 중요한 함의는 AI의 사용 방식이다. 이 강연에서 AI는 추상적인 설계 결정을 대신하지 않는다. 대신 상태 조사, 템플릿 재적용, commit 의도 전파, 로컬 CI 도구 생성처럼 반복적이고 맥락이 많은 작업을 처리하는 데 사용된다. 이는 C++ 인프라처럼 작은 예외와 저장소별 차이가 많은 영역에서, AI가 단순 자동화 스크립트보다 유연하게 작동할 수 있음을 보여준다.
마무리 / 핵심 정리
Eddie Nolan의 발표는 Beman Exemplar를 하나의 템플릿 저장소가 아니라, C++ 표준화 생태계를 위한 운영 플랫폼으로 보여준다. 프로젝트 구조, CMake preset, generated config, infra vendoring, vcpkg registry, C++ Modules compatibility, GitHub Actions CI matrix, Docker image, local CI, template drift 대응까지 이어지는 구성은 모두 같은 목적을 향한다. 표준 라이브러리 제안 구현체가 단발성 예제가 아니라, 여러 compiler와 package workflow 위에서 지속적으로 검증되는 라이브러리로 남도록 만드는 것이다.
강연에서 가장 인상적인 지점은 기술적 완벽함보다 현실적 균형에 있다. CMake는 패키지 매니저가 아니지만 FetchContent의 편리함은 dependency provider로 보존하고, C++ Modules는 아직 불안정하지만 제한된 사용 규칙과 header compatibility mode로 실험 가능하게 만든다. Git submodule은 문제가 많지만 toolchain file의 chicken-and-egg problem은 자체 beman-submodule로 풀고, template drift는 .exemplar-version과 AI 기반 의미 적용으로 관리한다.
결국 Beman Exemplar의 확장은 “템플릿을 잘 만든다”는 수준을 넘어선다. 이는 C++ 표준화 후보 라이브러리들이 빠르게 변하는 언어와 도구 체인 속에서도, 품질과 재현성을 유지하며 진화할 수 있게 하는 인프라 설계 사례다. C++ 프로젝트를 진지하게 운영하려는 개발자에게 이 강연은 CMake, 패키징, CI, modules, 릴리스 자동화가 서로 분리된 주제가 아니라 하나의 시스템으로 설계되어야 한다는 점을 분명하게 보여준다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Scaling beman.exemplar - Eddie Nolan - C++Now 2026 |
| 채널 | CppNow |
| 리포트 작성 | 2026-08-10 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.