State of Data - Sean Cai Independent / State of Data
📺 원본 영상: State of Data — Sean Cai, Independent / State of Data
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-27
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
Sean Cai는 이 강연에서 AI 데이터 시장을 단순한 라벨링 산업이 아니라, 차세대 화이트칼라 자동화의 핵심 공급망으로 해석한다. 그의 핵심 주장은 이제 모델 성능의 병목이 단순한 Compute(연산 자원)나 Talent(인재)에만 있지 않고, 실제 전문 업무를 모델이 학습할 수 있는 형태로 바꾸는 Data(데이터) 쪽으로 이동하고 있다는 것이다.
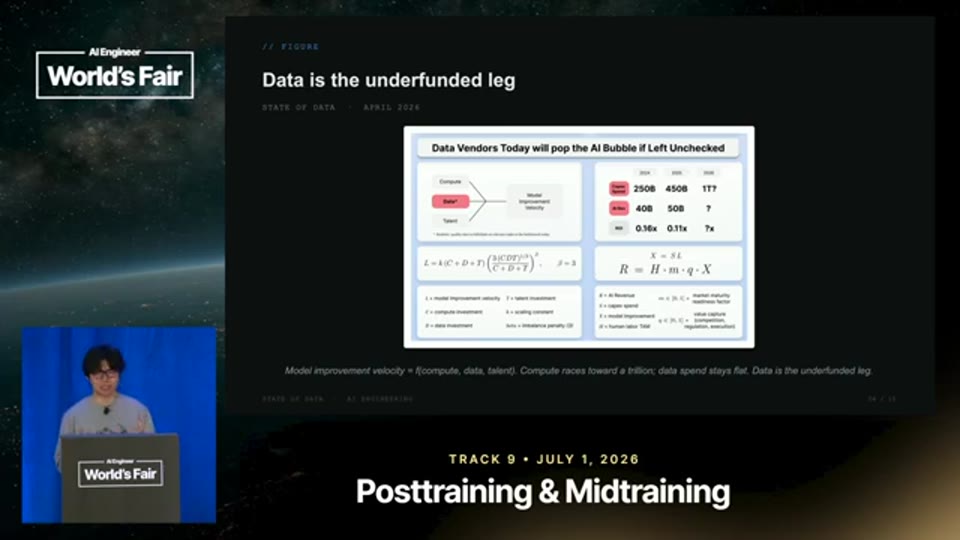
03:28 - Compute, data, talent의 불균형과 모델 성능 개선 관계를 설명하는 차트 또는 수식이 언급되는 구간
강연은 데이터 시장의 산업적 분화, Type 1 데이터와 Type 2 데이터의 차이, Benchmark(벤치마크)의 왜곡, Verifiability(검증 가능성)가 AI 애플리케이션 성숙 순서를 결정하는 방식, 그리고 데이터 회사가 결국 엔터프라이즈 AI 인프라 회사로 변해가는 흐름을 하나의 구조로 묶어 설명한다. 특히 그는 데이터 회사의 지속 가능한 가치는 데이터셋 자체가 아니라, 실제 업무 현장으로 이어지는 파이프라인과 그 위에서 반복적으로 모델을 재학습시키는 인프라에 있다고 본다.
데이터 시장은 라벨링 산업이 아니라 산업 공급망이 되고 있다
Sean Cai는 사람들이 “데이터 시장”이라는 말을 들을 때 여전히 2019년식 이미지 라벨링 공장을 떠올린다고 지적한다. 방 안에 모인 Annotator(주석 작업자)들이 이미지에 박스를 치고 태그를 붙이는 장면은 실제로 존재하며, 대형 AI Lab(연구소) 기준으로 연간 100억에서 150억 달러 규모의 지출이 발생할 수 있는 큰 시장이다. 그러나 그가 보기에 이 영역은 이제 가장 덜 흥미로운 부분이다. 모델이 이미 일반적 역량을 갖추기 시작했기 때문에, 앞으로 희소하고 가격이 잘못 매겨진 자원은 모델을 “괜찮은 Generalist(범용 모델)”에서 “실제 전문가”로 밀어 올리는 데이터다.
그는 이 변화를 산업혁명의 원자재에 비유한다. 빅토리아 시대의 석탄과 철이 산업 생산의 기반이었듯, 화이트칼라 혁명에서는 데이터가 업무 자동화의 원자재가 된다. 여기서 중요한 점은 데이터가 단순한 파일이나 테이블이 아니라, 사람이 문제를 인식하고 판단하며 결과물을 완성하는 과정 전체를 담아야 한다는 것이다. 따라서 데이터 시장은 더 이상 하나의 수직 통합 기업이 모든 과정을 처리하는 구조로 머물기 어렵고, 사람을 소싱하고, 환경을 만들고, 보상 구조를 설계하고, 평가를 수행하는 여러 기능으로 분해되고 있다.
Sean Cai는 Scale AI, Surge, Mercor, Handshake 같은 대형 데이터 기업들이 과거에는 수직 통합 방식으로 전체 체인을 담당할 수밖에 없었다고 설명한다. 초기 시장에서는 단위 경제성이 그렇게 해야만 맞았기 때문이다. 그러나 지금은 AI Lab들이 품질이 양에 비례하지 않는다는 점을 체감하면서, 20~30개 수준의 Vendor(공급업체)를 동시에 쓰는 Vendor Diversification(공급업체 다변화)을 요구하는 경우가 늘고 있다. 이는 일시적 과도기가 아니라, 데이터 공급망이 영구적으로 분화되는 방향에 가깝다는 것이 강연자의 판단이다.
Type 1 데이터와 Type 2 데이터 - 진짜 업무 흐름과 만들어낸 예제의 차이
강연의 중심 개념 중 하나는 Type 1 데이터와 Type 2 데이터의 구분이다. Sean Cai에 따르면 Type 1 데이터는 실제 업무 과정에서 자연스럽게 포착된 데이터다. 예컨대 GitHub Commit(깃허브 커밋), Session Replay(세션 재생), 업무 도구의 상태 변화와 의사결정 로그처럼, 전문가가 실제로 일을 수행하면서 남긴 흔적이 여기에 해당한다. 반면 Type 2 데이터는 전문가를 고용해 임의의 환경에 앉혀 놓고 예제를 만들게 하는 방식으로 생산된 Contrived Data(인위적으로 구성된 데이터)다.
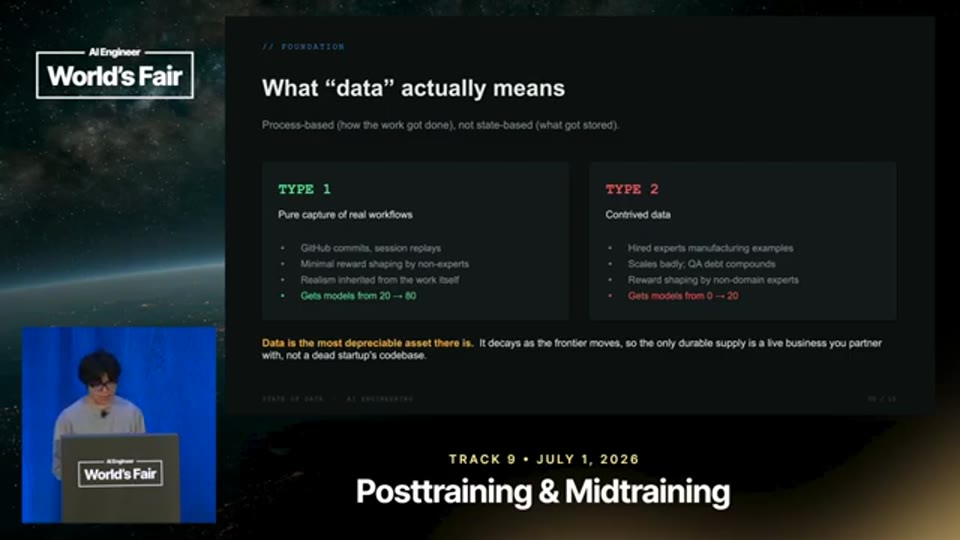
05:04 - Type 1 데이터와 Type 2 데이터를 구분하며 실제 워크플로 데이터와 인위적 데이터의 차이를 설명하는 구간
그는 Type 2 데이터가 완전히 무용하다고 말하지 않는다. 모델이 아직 초등학교 1학년 수준으로 읽는 단계라면, 비교적 단순하고 인위적인 교육 데이터도 충분히 도움이 될 수 있다. 하지만 모델을 20% 수준에서 80% 수준의 실무 역량으로 끌어올리려면 이야기가 달라진다. 그 단계에서는 데이터가 실제 업무의 구조, 맥락, 제약, 실패 복구 과정을 포함해야 하며, 이 현실성은 별도로 꾸며내기보다 실제 업무 자체에서 상속되어야 한다.
이 지점에서 그는 업계의 “더러운 비밀”을 언급한다. 많은 회사가 실제로는 Type 2 데이터를 판매하면서도 그것을 Type 1 데이터처럼 포장한다는 것이다. 문제는 Frontier Model(최전선 모델)이 발전할수록 데이터셋의 가치가 빠르게 감가상각된다는 데 있다. 죽은 스타트업의 코드베이스를 사들이는 방식은 순간적으로 데이터처럼 보일 수 있지만, 진짜 지속 가능한 공급원은 계속해서 새로운 고품질 업무 흔적을 만들어내는 살아 있는 비즈니스와의 파트너십이다.
검증 가능성이 AI 애플리케이션의 성숙 순서를 결정한다
Sean Cai는 어떤 AI 애플리케이션 시장이 먼저 성숙하는지를 이해하려면 Verifiability(검증 가능성)를 봐야 한다고 말한다. 그는 Jason Wei의 “Verifier’s Law”를 인용하며, 모델이 어떤 작업을 잘하도록 훈련되기 쉬운 정도는 그 작업이 얼마나 쉽게 검증되는지에 비례한다고 설명한다. 이 관점에서 Coding(코딩)이 가장 먼저 성숙한 AI 애플리케이션 계층이 된 것은 우연이 아니다. Web 2.0 시대의 GitHub가 이미 검증 가능한 데이터 인프라를 만들어두었기 때문이다.
그는 검증 가능성을 세 축으로 나눈다. 첫째는 작업을 확인 가능한 단계로 분해하기 쉬운지에 관한 Asymmetry of Verification(검증 비대칭성)이다. 둘째는 무엇이 정답인지에 대한 합의가 얼마나 강한지를 뜻하는 Veracity of Verification(검증의 진실성 또는 정답 합의성)이다. 셋째는 현실 세계가 검증된 새 사례를 얼마나 자주 제공하는지를 뜻하는 Proliferation of Verification(검증 사례의 확산성)이다. 코딩은 Unit Test(단위 테스트), 작동하는 코드에 대한 커뮤니티 합의, 무수한 공개 커밋 기록을 통해 이 세 축에서 모두 높은 점수를 받는다.
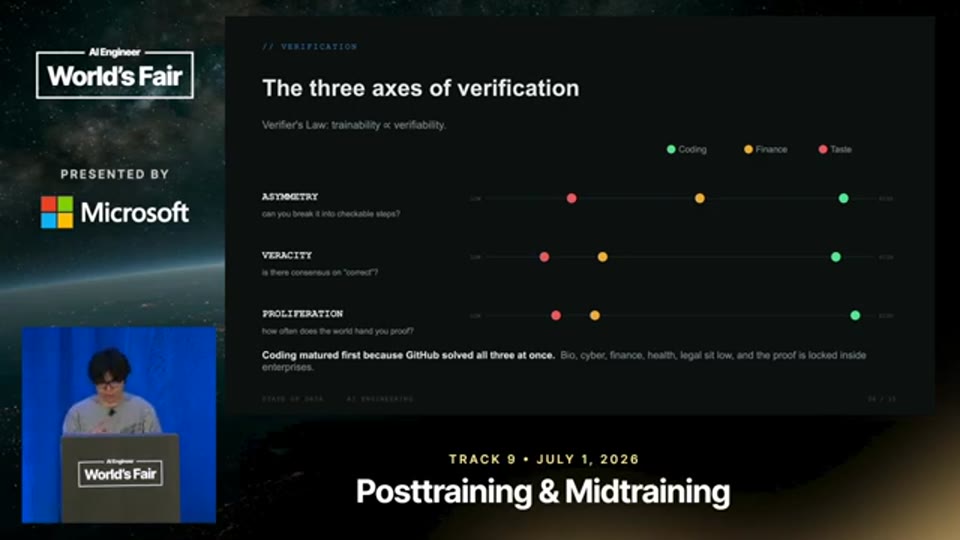
06:34 - 검증 가능성을 세 축으로 나누고 코딩 시장이 먼저 성숙한 이유를 설명하는 구간
반면 Biology(생물학), Security(보안), Taste(취향), Finance(금융), Healthcare(의료), Law(법률)는 훨씬 더 어렵다. 이 영역들은 무엇이 올바른지에 대한 합의가 약하거나, 검증 사례가 기업 내부 Workflow(업무 흐름)에 잠겨 있거나, 결과가 장기적으로만 드러나는 경우가 많다. 그래서 Sean Cai는 최근 데이터 회사들이 Slack 로그, Jira 로그, 기업 내부 작업 기록 같은 자료에 관심을 갖는 현상을 단순한 데이터 수집이 아니라, 검증 가능한 전문 업무 흔적을 확보하려는 경쟁으로 해석한다. 결국 어떤 직업군의 작업을 이 세 축 위에 배치해보면, 어느 시장이 먼저 AI 제품화될지 어느 정도 예측할 수 있다는 것이다.
Benchmark Psychosis - 숫자 하나가 모델의 진짜 능력을 말해주지 못하는 이유
강연자는 현재 AI 업계의 Benchmark(벤치마크) 문화에 상당히 비판적이다. 그의 표현에 따르면 많은 벤치마크는 “조용히 가짜”이며, 특히 Type 2 데이터로 만들어진 Benchmark는 측정 대상과 훈련 대상이 뒤섞이는 구조적 문제를 갖는다. 흔한 방식은 Domain Expert(도메인 전문가)를 고용해 Chat 모델로 그럴듯한 문제를 만들고, 전문가가 답을 작성하게 한 뒤, 모델이 틀린 항목만 골라 어려운 Benchmark로 포장하는 것이다. 더 큰 문제는 그 Benchmark 점수를 올릴 수 있는 데이터까지 같은 공급자가 판매한다는 데 있다.
그는 이 구조를 Goodhart’s Law(굿하트의 법칙)의 전형적인 사례로 본다. 측정 지표가 목표가 되는 순간, 특히 그 목표를 진짜 도메인 전문가가 아닌 사람들이 설계할 때, 지표는 현실을 측정하는 기능을 잃는다. Lab, Vendor, Enterprise가 모두 어떤 데이터가 실제로 모델을 개선하는지 명확히 보지 못한 채 안개 속에서 움직이는 셈이다. 그래서 그는 단일 Benchmark 점수는 측정되지 않은 분포에서 나온 하나의 샘플에 불과하다고 강조한다.
특히 장기적이고 상호 의존적인 업무에서는 단일 문제 풀이형 Benchmark가 거의 충분하지 않다. 인위적으로 만든 Benchmark는 보통 고립된 In-distribution Question(분포 내 단일 질문)을 테스트할 뿐, 모델이 긴 Episode(작업 구간) 동안 올바른 추론을 유지하고, 이전 상태가 이후 선택을 제약하는 상황을 견디는지는 보기 어렵다. 그는 Cross-harness Differencing(평가 하네스 간 차이)과 Cross-infrastructure Differencing(인프라 간 차이)이 Benchmark 성능 차이의 주요 원인이 될 수 있다고 언급하면서, 겉으로 보이는 평균 점수 뒤에 높은 False Positive(거짓 양성)와 False Negative(거짓 음성)가 숨어 있을 수 있다고 설명한다.
금융 평가 사례가 보여주는 모델별 실패 방식의 차이
Sean Cai는 자신이 내부적으로 구축한 Vals AI와 유사한 사설 Benchmark 환경을 예로 든다. 그는 세 개의 실제 Vendor 기반 금융 테스트를 언급하는데, ARR Waterfall Reconciliation(연간 반복 매출 워터폴 조정), LBO Valuation Memo(차입매수 가치평가 메모), Hedge Fund Trading(헤지펀드 트레이딩)을 위한 Long-short Pair Trade(롱숏 페어 트레이드)가 그것이다. 이들은 모두 Long-horizon(장기 흐름), Non-verifiable(직접 검증이 어려운), Finance Task(금융 업무)에 속하며, 단순한 객관식 문제보다 실제 업무에 가까운 평가로 볼 수 있다. 다만 화면에 표시된 세부 Rubric(평가 기준)이나 수치표는 STT에 포함되어 있지 않으므로, 여기서는 강연자가 음성으로 설명한 범위만 정리한다.
그의 관찰에 따르면 Claude Opus 계열 모델들은 일부 Rubric에서 버전이 올라갔는데도 더 낮은 성능을 보였고, 업데이트 과정에서 Over-engineered Self-reflection(과도하게 설계된 자기 성찰) 같은 특성이 나타났다. 또 GPT 계열 모델과 Claude Opus 계열 모델은 같은 작업에서 근접한 총점을 냈지만, 실패하는 방향은 정반대였다고 한다. GPT는 산술 계산을 더 잘 맞히는 반면, Opus는 방법론을 더 잘 잡지만 산술에서 손실을 냈다는 설명이다. 이는 모델의 총점 하나만 보면 놓치기 쉬운 차이를 Rubric별 분석을 통해 드러낼 수 있음을 보여준다.
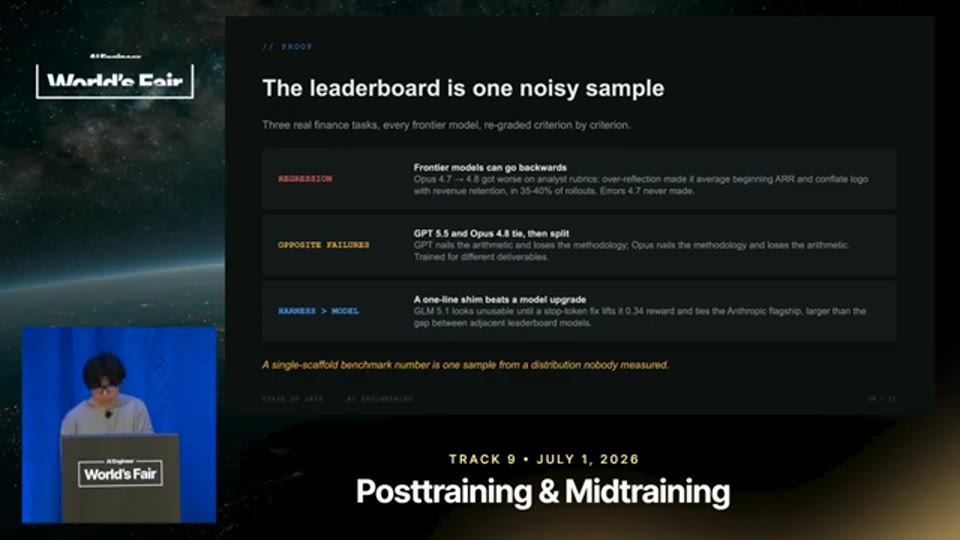
10:46 - 금융 업무 벤치마크에서 모델별 Rubric 차이와 실패 양상이 설명되는 구간
이 사례의 함의는 단순하다. “어떤 모델이 더 좋다”는 질문은 실제 업무 환경에서는 거의 항상 불완전한 질문이다. 어떤 모델은 계산에 강하고, 어떤 모델은 방법론적 구조화에 강하며, 어떤 모델은 장기 작업 중 실패 복구에 약할 수 있다. 따라서 강연자는 좋은 Benchmark가 모델의 순위를 매기는 도구가 아니라, 각 연구팀의 Post-training(후훈련) 방향과 데이터 선택이 어떤 능력을 강화하거나 약화했는지 읽어내는 진단 장치가 되어야 한다고 본다.
데이터 시장은 다음 AI 애플리케이션을 예고하는 선행지표다
Sean Cai는 데이터 시장을 관찰하면 다음에 어떤 AI 제품이 나올지 예측할 수 있다고 말한다. 그의 설명에 따르면 2026년 1월 Anthropic은 Cybersecurity(사이버보안) 데이터에 상당한 지출을 했고, 3~4월에는 Biology(생물학) 데이터 Vendor에 많은 돈을 썼다. 그로부터 2~3개월 뒤 Cyber 관련 제품과 Claude Bio 또는 Life Sciences(생명과학) 방향의 움직임이 나타났다는 것이 그의 해석이다. 여기서 중요한 것은 데이터 구매가 단순한 비용 집행이 아니라, Lab이 다음 모델 역량을 어디로 확장하려 하는지 보여주는 상류 지표라는 점이다.
그는 다음 시장을 읽기 위한 기준으로 검증 가능성뿐 아니라 작업의 길이와 구조를 함께 본다. 실제 Lab이 원하는 Long-horizon 데이터는 단순히 시간이 긴 데이터가 아니다. Step Length(단계 길이)가 충분히 있고, 서로 대체 불가능한 Heterogeneous Tool Call(이질적 도구 호출)이 포함되며, State Transition(상태 전이)이 미래의 행동을 실제로 제약하고, Mandatory Failure Recovery(필수 실패 복구)가 요구되는 작업이어야 한다. 이런 조건이 없다면 긴 영상이나 긴 로그가 있다고 해서 곧바로 장기 추론 데이터가 되는 것은 아니다.
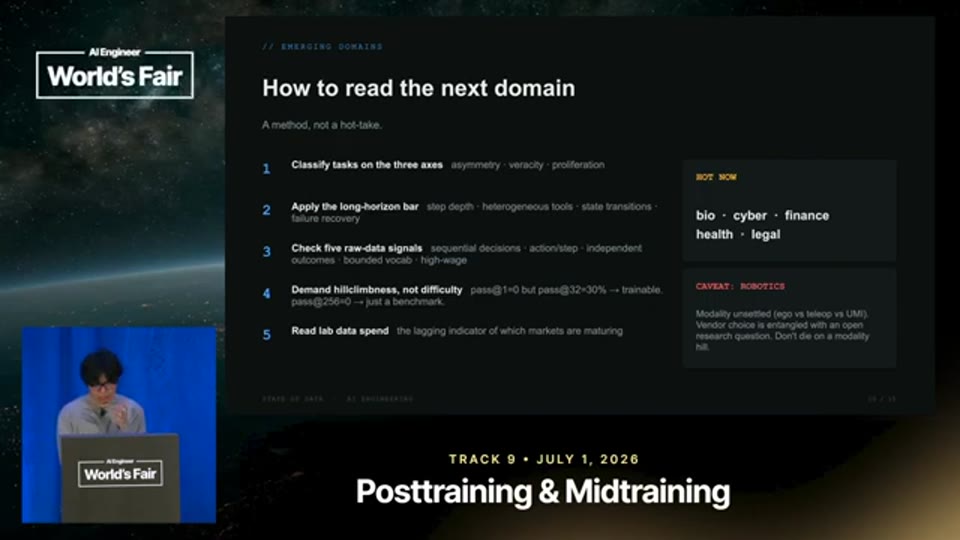
12:49 - 다음 AI 애플리케이션 시장을 읽기 위한 Long-horizon 작업 기준과 데이터 신호를 설명하는 구간
또한 그는 원천 데이터에서 다섯 가지 신호를 보아야 한다고 말한다. 하나의 Entity(대상)를 둘러싼 순차적 의사결정, 각 단계에서 추론 가능한 전문가 행동, 독립된 주체가 기록한 결과, 그리고 경제적으로 접근 가능한 고임금 업무가 중요한 단서가 된다. 다만 이 항목들은 강연자가 빠르게 언급한 체크리스트에 가까우며, 화면에 더 상세한 표가 있었을 가능성이 있다. 따라서 구체적인 분류표나 사례별 점수는 원본 영상을 직접 확인해야 한다.
그는 이어 화이트칼라 업무 비중과 Task Horizon(작업 기간 또는 작업 길이)을 축으로 여러 산업을 배치하는 시장 지도를 제시한다. 이 지도는 단순히 “어느 산업이 AI에 적합한가”를 묻는 것이 아니라, 고임금 지식노동이 많고 장기 작업 데이터가 축적되는 영역이 어디인지 비교하기 위한 프레임으로 볼 수 있다.
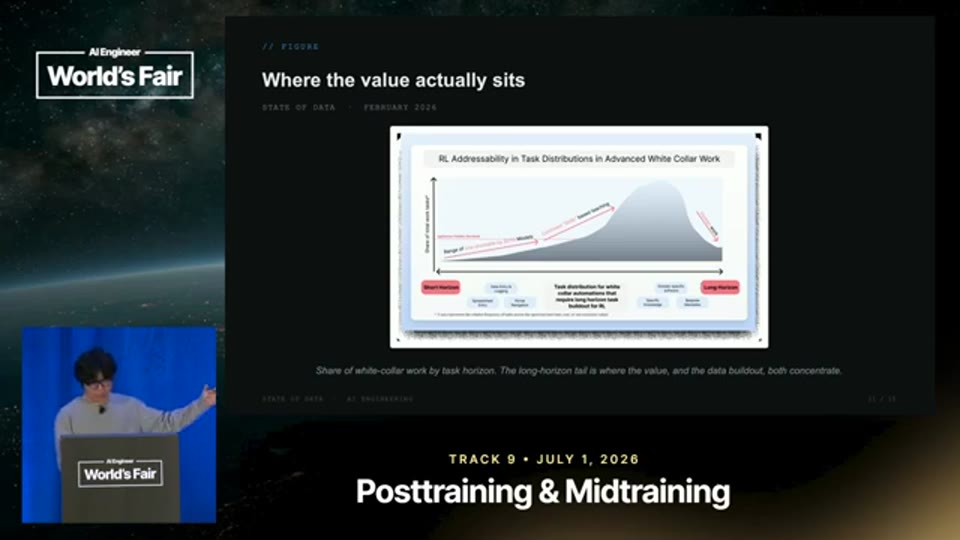
14:26 - 화이트칼라 업무 비중과 Task horizon을 축으로 한 시장 지도를 설명하는 구간
Robotics 사례 - 데이터보다 먼저 풀어야 할 연구 문제가 있다
강연자는 Robotics(로보틱스)를 반례로 제시하며, 모든 데이터 시장이 같은 방식으로 성숙하지는 않는다고 말한다. 로보틱스에서는 Ego Data(1인칭 관점 데이터), Teleoperation(원격 조작), UMI로 들리는 방식 등 Modality(데이터 양식)가 아직 정착되지 않았고, 어떤 데이터가 실제 학습에 가장 유효한지 자체가 연구 문제로 남아 있다. 이 때문에 Vendor가 어떤 데이터를 팔 것인지 결정하는 문제가 곧 미해결 연구 질문과 얽히게 된다. 단순히 “인도에서 촬영한 iPhone 영상 10만 시간” 같은 식의 자료가 있다고 해서 그것이 곧 유효한 로봇 학습 데이터가 되는 것은 아니라는 비판이다.
이 사례는 데이터 회사가 어디까지 확장할 수 있는지에 대한 경계도 보여준다. Sean Cai는 성공적인 Environment Company(환경 회사)가 단순 데이터 판매자가 아니라 Research Accelerator(연구 가속기)에 가까워진다고 본다. 그러나 그것이 Venture-scalable(벤처 규모로 확장 가능)한 사업이 되려면, 특정 데이터 양식에 목숨을 거는 대신 기업 애플리케이션 계층이 활용할 수 있는 범용 인프라를 구축해야 한다. 그는 이를 두고 특정 Modality Hill(데이터 양식의 언덕)에서 죽지 말라고 표현한다.
모델 계층의 변화와 엔터프라이즈 AI의 재부상
강연 후반부에서 Sean Cai는 모델 계층의 권력 구조가 데이터 시장의 방향을 바꾸고 있다고 설명한다. 그는 역사적으로 어떤 인프라 기술의 선구자도 장기적으로 시장의 10% 이상을 안정적으로 장악하지 못했다는 일반화를 제시한다. 철도 회사는 Company Town(회사 도시)을 만들고 과도한 Rent(지대)를 부과했지만, 자동차가 등장하고 국가 개입이 커지면서 지배력을 잃었다. AWS와 Google 역시 인프라 계층을 강하게 장악했지만, 애플리케이션 계층 전체를 소유하지는 못했다는 점을 예로 든다.
그는 OpenAI와 Anthropic이 현재 강한 Fiefdom(영지)을 만들고 있지만, Anti-distillation(반증류), Export Control(수출 통제), Enterprise Exclusivity(기업 독점 계약) 같은 압력은 오래 지속되는 Lock-in(종속)을 보장하지 못한다고 본다. 강연자는 GLM 계열 모델이 여러 실제 업무 Rubric에서 GPT 계열 모델을 넘어서는 사례를 언급하며, 애플리케이션 계층 회사들이 Foundation Model Lab(기반 모델 연구소)으로부터 분리될 수 있다는 증거로 해석한다. 모델은 비용, 지연시간, 성능, Modality 측면에서 서로 다르기 때문에 전기처럼 완전히 대체 가능한 상품은 아니지만, 그렇다고 영구적인 독점으로 향하는 것도 아니라는 것이다.
이 변화는 데이터 회사의 사업 모델을 엔터프라이즈 쪽으로 밀어낸다. Sean Cai는 성공적인 데이터 회사들이 이미 Enterprise(기업)로 Pivot(전환)하고 있다고 말한다. 기업이 Lab의 지능을 빌려 쓰는 단계에서 벗어나 자신만의 지능을 소유하려 한다면, 단순 데이터 납품보다 더 넓은 추상화 계층이 필요하다. 그 계층은 작은 모델을 비용, 지연시간, 성능 프로파일에 따라 Serve and Route(서빙 및 라우팅)하고, RL Dataset(강화학습 데이터셋)을 관리하며, 새로운 Open-source Base Model(오픈소스 기반 모델)로 이동할 때 Post-training을 자동으로 다시 수행하는 역할을 맡게 된다.
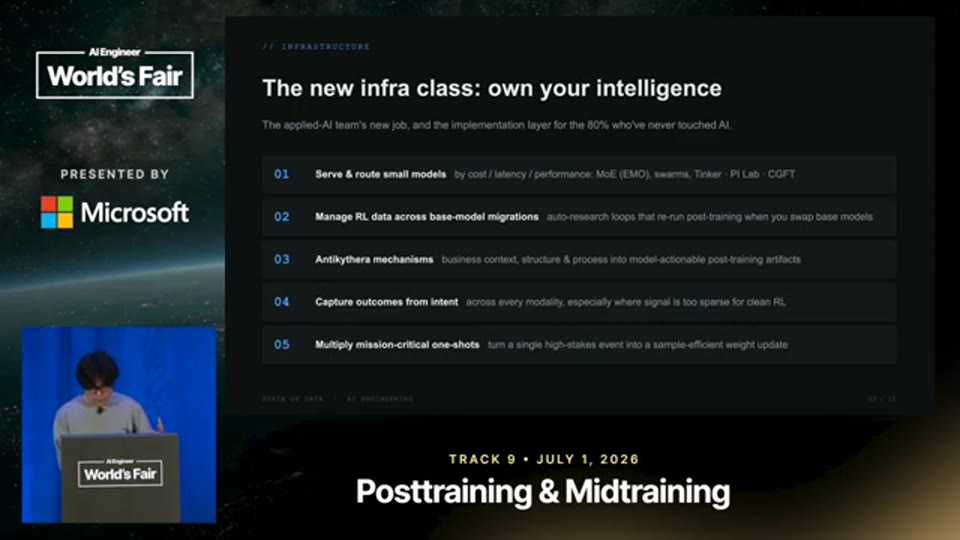
16:43 - 엔터프라이즈 AI 인프라와 RL 데이터셋 관리, 모델 마이그레이션 후 재훈련 구조를 설명하는 구간
Antikythera Mechanisms - 지저분한 업무 맥락을 평가 가능한 시스템으로 바꾸는 장치
강연 전반에 반복적으로 등장하는 표현이 Antikythera Mechanisms(안티키테라 메커니즘)이다. 원래 안티키테라 장치는 고대 그리스의 복잡한 천문 계산 장치로 알려져 있는데, Sean Cai는 이를 현대 AI 데이터 인프라의 은유로 사용한다. 그가 말하는 Antikythera Mechanisms는 지저분한 Business Context(비즈니스 맥락)를 Eval(평가), Reward(보상), Training Signal(훈련 신호)로 변환하는 맞춤형 시스템이다. 즉, 기업 내부의 복잡한 업무를 모델이 학습하고 개선될 수 있는 구조로 번역하는 기계라고 볼 수 있다.
이 개념은 데이터 회사가 왜 단순 데이터 판매자로 남을 수 없는지를 설명한다. 실제 업무 데이터는 정리된 CSV 파일이나 단일 문답쌍 형태로 존재하지 않는다. 업무는 Slack 대화, Jira 티켓, 문서 변경, 승인 흐름, 고객 결과, 실패 복구, 전문가 판단이 뒤섞인 상태로 발생한다. 따라서 지속 가능한 AI 인프라는 이 복잡성을 줄여 없애는 것이 아니라, 그것을 모델 훈련과 평가에 사용할 수 있는 형태로 보존하며 변환해야 한다.
Sean Cai는 마지막에 자신이 실제 기업들과 함께 데이터 자산을 수익화하고, RL as a Service(서비스형 강화학습)를 구현하는 일을 하고 있다고 공개한다. 이는 강연의 논지를 개인 프로젝트로 연결하는 결론이기도 하다. 그의 관점에서 앞으로의 데이터 회사는 Lab의 외주 공급업체가 아니라, 기업이 자체 지능을 구축하도록 돕는 Neo-lab(신형 연구소)에 가까워진다. 데이터셋 하나를 파는 회사보다, 실제 업무와 학습 인프라를 계속 연결하는 회사가 더 오래 살아남는다는 주장이다.
마무리 / 핵심 정리
이 강연의 가장 중요한 메시지는 AI 데이터 시장의 중심이 “더 많은 데이터”에서 “더 현실적인 업무 흐름”으로 이동하고 있다는 점이다. 과거에는 모델이 아직 약했기 때문에 인위적으로 만든 Type 2 데이터도 충분한 개선을 만들 수 있었지만, Frontier Model이 성숙할수록 실제 전문가가 실제 제약 속에서 일하는 Type 1 데이터의 가치가 커진다. 동시에 단일 Benchmark 점수는 모델의 진짜 능력을 설명하기 어렵고, 장기 업무와 복잡한 도구 사용, 실패 복구, 상태 전이를 평가하는 더 정교한 환경이 필요해진다.
Sean Cai의 분석은 데이터 산업을 AI 공급망의 하부 산업이 아니라, 다음 애플리케이션 계층을 예고하고 형성하는 핵심 인프라로 바라보게 만든다. 어떤 분야가 먼저 성숙할지는 화려한 데모보다 검증 가능성, 실제 업무 로그의 접근성, 고임금 전문 업무의 경제성에 의해 결정된다. 결국 AI 시대의 데이터 회사가 지켜야 할 Moat(방어력)는 데이터 자체가 아니라, 실제 업무 현장으로 이어지는 파이프라인과 그 위에서 모델을 계속 재훈련할 수 있는 시스템이다. 이 점에서 “State of Data”는 데이터 시장 리포트이면서 동시에 엔터프라이즈 AI 인프라의 미래에 대한 투자 논문처럼 읽힌다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | State of Data — Sean Cai, Independent / State of Data |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-27 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Recursive Model Improvement — Lee Robinson, Cursor, SpaceXAI
- Evals Are Broken, Use Them Anyway — Ara Khan, Cline
- Data and Environment Curation for Post-Training LLMs — Mahesh Sathiamoorthy, Bespoke Labs
- Learning on the Job - The Future of Post-Training — Raymond Feng, Applied Compute
- Stop Making Models Bigger, Make Them Behave - Kobie Crawford, Snorkel