Stop Evaluating Models Like It’s the 50s - Alejandro Vidal, Mindmakers
📺 원본 영상: Stop Evaluating Models Like It’s the 50s - Alejandro Vidal, Mindmakers
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-14
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Alejandro Vidal은 현재 LLM 평가가 지나치게 단순한 정답 개수 세기에 머물러 있다고 지적한다. 그는 심리측정학(Psychometrics), 특히 Item Response Theory(문항반응이론, IRT)를 빌려오면 모델의 능력뿐 아니라 벤치마크 문항 자체의 품질까지 함께 평가할 수 있다고 설명한다.
이 강연의 핵심은 “모든 문제를 같은 무게로 더하는 방식”에서 벗어나야 한다는 주장이다. 어떤 문항은 너무 쉽고, 어떤 문항은 너무 어렵고, 어떤 문항은 오히려 좋은 모델을 틀리게 만드는 잘못된 문항일 수 있다. IRT는 이러한 차이를 난이도, 변별력, 잔차라는 형태로 수치화함으로써 LLM 평가를 더 정교한 측정 문제로 바꾸는 방법을 제안한다.
정답 수 세기의 한계와 Classical Test Theory
강연자는 현재 업계의 일반적인 LLM 평가 방식이 “맞힌 문제 수를 세는 것”이라고 말한다. 이 방식은 심리측정학에서 Classical Test Theory(고전검사이론)에 해당하며, 이해하기 쉽고 구현도 간단하지만 매우 강한 가정을 전제로 한다. 그 가정은 벤치마크의 모든 문항이 동일한 정보량과 동일한 중요도를 가진다는 것이다.
문제는 이 가정이 실제 벤치마크 환경에서는 거의 성립하지 않는다는 데 있다. 어떤 문제는 대부분의 모델이 맞히는 쉬운 문항이고, 어떤 문제는 강한 모델만 맞힐 수 있는 어려운 문항이다. 또한 일부 문항은 정답 라벨이 잘못되어 있거나, 질문 자체가 모호하거나, 모델의 실제 능력과 반대로 상관되는 경우도 있다. 그럼에도 단순 정확도는 이 모든 문항을 같은 1점으로 처리하기 때문에, 모델 간 차이를 제대로 드러내지 못할 수 있다.
Vidal은 이 문제를 설명하기 위해 Epoch AI의 실제 데이터와 실제 벤치마크를 사용했다고 언급한다. 화면에는 여러 모델의 정확도 막대와 각 문항별 정답 여부 행렬이 제시된 것으로 보이며, 그는 여기서 문항 하나하나를 독립적인 측정 단위로 다루어야 한다고 주장한다. 즉, 평가 대상은 모델만이 아니라 벤치마크 문항 자체이기도 하다.
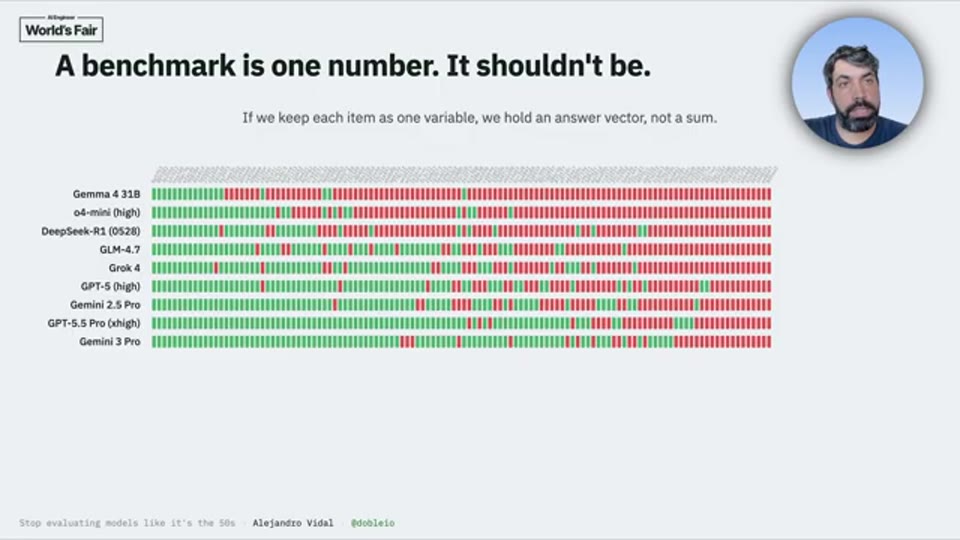
01:53 - 문항별 정답 여부 행렬을 보여주며 각 문항을 독립 변수로 다루는 IRT 접근을 설명하는 구간
Item Response Theory가 바꾸는 평가의 관점
Item Response Theory(IRT)는 각 문항이 모델의 능력과 어떤 관계를 갖는지 함수로 표현한다. 강연자는 문항의 난이도를 b 파라미터로, 모델의 능력 수준을 theta(θ)로 설명한다. 특정 문항의 곡선은 모델의 θ가 높아질수록 그 문항을 맞힐 확률이 어떻게 증가하는지를 보여주며, b는 그 문항을 맞힐 확률이 50%가 되는 지점으로 해석된다.
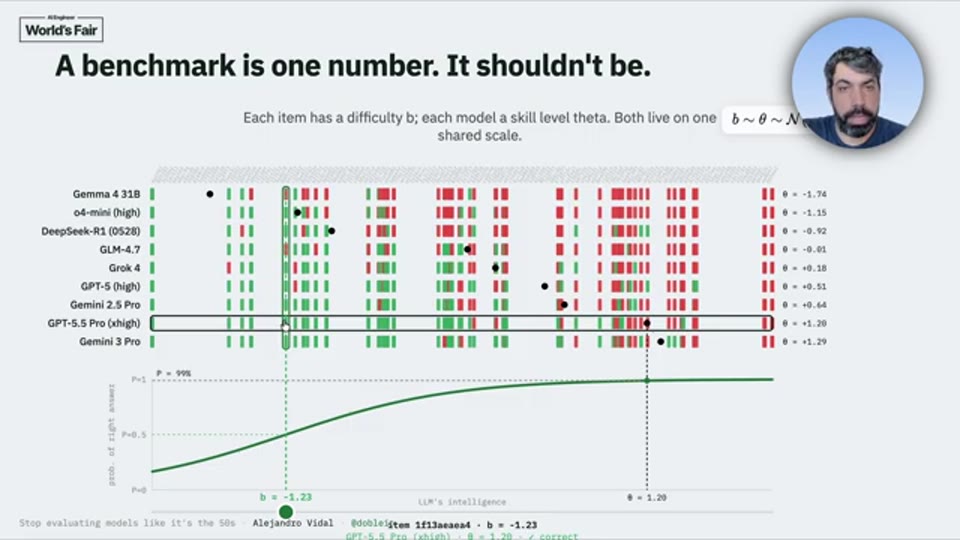
03:42 - Theta와 B 파라미터를 사용해 특정 모델이 특정 문항을 맞힐 확률을 설명하는 구간
이 구조가 중요한 이유는 문항과 모델을 같은 척도 위에 올려놓을 수 있기 때문이다. 예를 들어 b가 0인 문항은 데이터셋 내 모델들의 평균적인 능력 수준에 해당하는 문항으로 볼 수 있다. 절반가량의 모델이 해당 문항을 맞힐 수 있다면, 그 문항은 평가에서 기준점 역할을 할 수 있다. 단순 정확도는 이런 기준점을 제공하지 못하지만, IRT는 문항 난이도 분포와 모델 능력 분포를 함께 추정함으로써 해석 가능한 평가 체계를 만든다.
강연자는 여기에 a 파라미터, 즉 문항의 discrimination(변별력)을 추가한다. 변별력이 높은 문항은 능력이 낮은 모델과 높은 모델을 잘 구분하며, 곡선이 가파르게 나타난다. 반대로 변별력이 낮은 문항은 모델 능력과 거의 관련이 없거나 노이즈에 가깝고, 더 심한 경우에는 능력이 높은 모델일수록 오히려 틀리는 음의 상관을 보일 수도 있다. 이 지점에서 IRT는 단순히 모델 순위를 매기는 도구를 넘어, 벤치마크를 진단하는 도구가 된다.
왜 두 문제 차이가 한 표준편차 차이일 수 있는가
강연에서 특히 인상적인 예시는 Claude Opus 4.1과 Gemini 3 Pro의 비교다. Vidal에 따르면 한 실제 벤치마크에서 Claude Opus 4.1은 245개를 맞혔고, Gemini 3 Pro는 247개를 맞혔다. 전체 337문항 중 2문항 차이에 불과하기 때문에 단순 정확도 관점에서는 두 모델이 거의 비슷해 보인다.
하지만 IRT로 분석하면 두 모델의 차이는 거의 1 표준편차에 달한다고 설명한다. 이는 Gemini 3 Pro가 단지 문제를 두 개 더 맞힌 것이 아니라, 더 어려운 문항을 맞혔기 때문에 훨씬 높은 θ를 갖는다는 뜻이다. 반대로 어떤 모델이 쉬운 문항을 많이 맞혔더라도 어려운 문항에서 계속 실패한다면, 단순 정답 수는 높아 보여도 실제 추정 능력은 낮게 나올 수 있다.
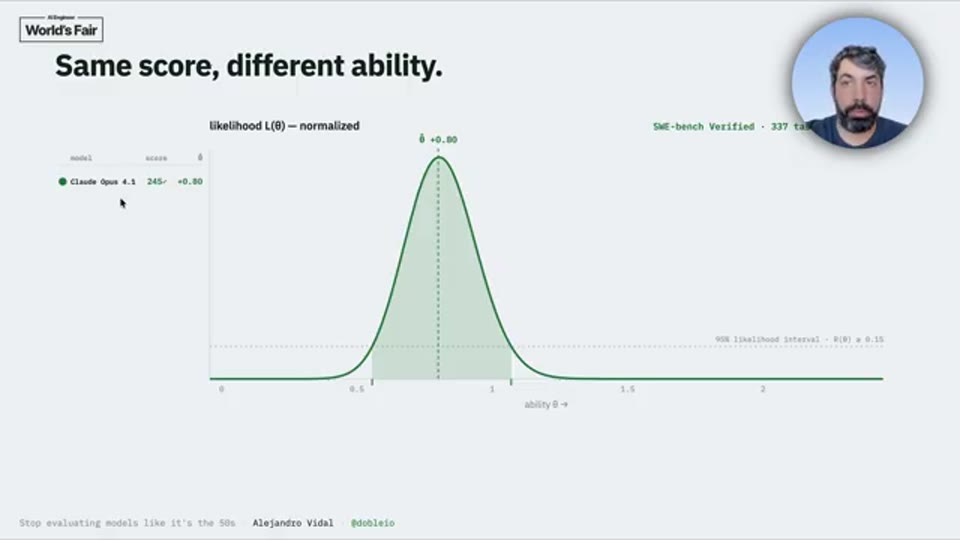
06:45 - Claude Opus 4.1과 Gemini 3 Pro의 정답 수 차이와 IRT 기반 능력 차이를 비교하는 구간
이 사례는 벤치마크 평가에서 “무엇을 맞혔는가”가 “몇 개를 맞혔는가”만큼 중요하다는 점을 보여준다. 특히 최신 LLM처럼 성능 차이가 점점 미세해지는 환경에서는 단순 정확도 몇 퍼센트 차이가 실제 능력 차이를 과소평가하거나 과대평가할 가능성이 크다. IRT는 각 문항의 정보량을 반영하기 때문에, 모델 간 차이를 더 민감하고 해석 가능하게 드러낼 수 있다.
| 비교 항목 | Claude Opus 4.1 | Gemini 3 Pro |
|---|---|---|
| 맞힌 문항 수 | 245 | 247 |
| 전체 문항 수 | 337 | 337 |
| 단순 정답 수 차이 | 기준 | +2 |
| IRT 기반 해석 | 낮은 θ | 약 1 표준편차 높은 θ |
이 표는 강연자가 음성으로 언급한 수치만 바탕으로 재구성한 것이다. 핵심은 Gemini 3 Pro가 단순히 두 문제를 더 맞혔다는 사실이 아니라, 두 모델이 맞힌 문항의 난이도 구조가 다르다는 데 있다. 따라서 평가 리포트에서 정확도만 제시하는 방식은 모델 능력의 실질적 차이를 가릴 수 있다.
벤치마크 감사: 나쁜 문항을 찾아내는 방법
IRT의 첫 번째 실용적 응용은 벤치마크 감사(Benchmark Audit)다. 강연자는 각 문항마다 난이도 b와 변별력 a를 추정할 수 있기 때문에, 어떤 문항이 유용하고 어떤 문항이 문제가 있는지 찾아낼 수 있다고 설명한다. 변별력이 높은 문항은 좋은 문항이고, 0에 가까운 문항은 신호가 약한 문항이며, 음수 변별력을 가진 문항은 특히 의심해야 한다.
음수 변별력 문항은 좋은 모델일수록 틀리고 약한 모델일수록 맞히는 이상한 패턴을 보인다. 이런 문항은 정답 라벨이 잘못되었거나, 질문이 모호하거나, 벤치마크 설계 의도와 다르게 작동할 가능성이 있다. 강연자는 이런 문항을 플래그한 뒤 다른 LLM으로 검토할 수 있다고 말한다. 실제로 그는 한 예시에서 벤치마크의 gold answer가 잘못된 것으로 보이는 사례를 확인했다고 설명한다.
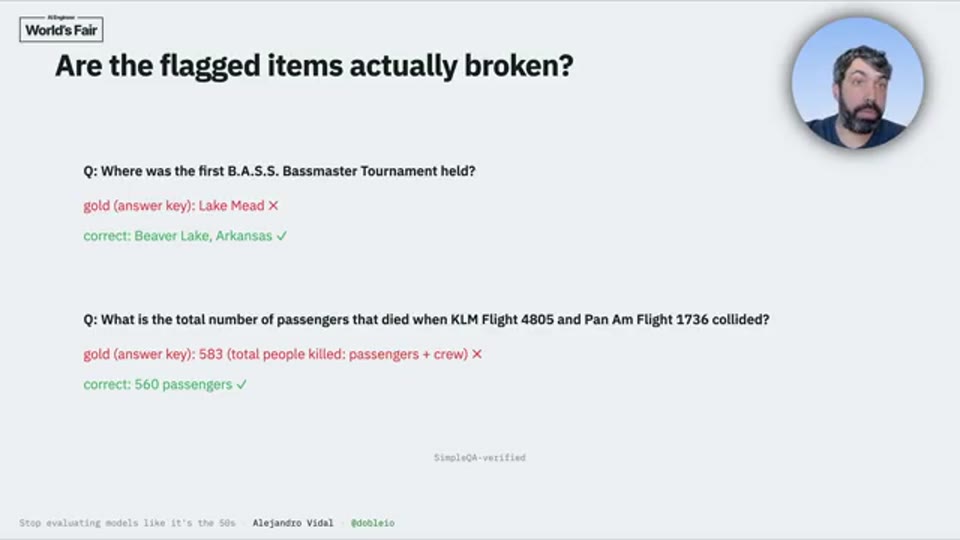
09:32 - 음수 변별력을 가진 문항과 잘못된 gold answer 사례를 보여주며 벤치마크 감사를 설명하는 구간
또 다른 사례는 더 미묘하다. 질문은 “총 승객 수”를 묻고 있었지만, 벤치마크의 gold answer는 승객과 승무원을 합친 전체 인원 583명을 답으로 삼고 있었다. 이 경우 답이 얼핏 맞아 보일 수 있지만, 질문이 승객만을 요구했다면 정답 라벨은 잘못된 것이다. Vidal은 이런 사례가 사람이 놓치기 쉬운 벤치마크 오류이며, IRT 기반 문항 분석이 적은 노력으로 이를 찾아낼 수 있다고 강조한다.
벤치마크 축소: 더 적은 문항으로 같은 순위를 얻기
두 번째 응용은 벤치마크 크기 최적화다. 많은 조직은 내부 목적에 맞는 자체 벤치마크를 운영하지만, 대규모 벤치마크는 실행 비용이 크고 토큰 사용량도 많다. 특히 여러 오픈소스 모델과 상용 모델을 반복적으로 비교해야 하는 조직에서는 평가 비용이 곧 운영 비용으로 이어진다.
강연자는 IRT를 사용하면 문항별 정보량을 기준으로 더 작은 벤치마크를 만들 수 있다고 설명한다. 단순화하면 변별력 a가 높은 문항부터 선택해도 원래 벤치마크 순위와 매우 높은 상관을 유지할 수 있다. 강연에서 제시된 실제 데이터 예시에 따르면, 원래 484개 문항이 있는 벤치마크에서 약 97개 문항만으로도 원래 랭킹과 0.99 수준의 상관을 목표로 할 수 있었다고 한다. 이는 거의 5배의 효율 개선을 의미한다.
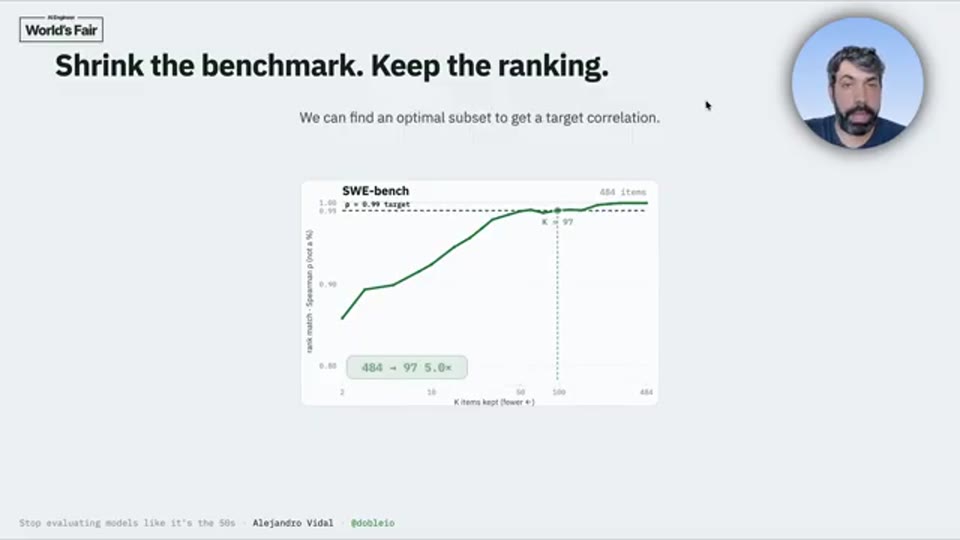
11:39 - 높은 변별력 문항만 선택해 벤치마크를 484개에서 약 97개로 줄이는 사례를 설명하는 구간
이 결과가 중요한 이유는 “문항이 많을수록 항상 좋은 평가”라는 직관을 흔들기 때문이다. 두 문항이 거의 같은 정보를 제공한다면 둘 다 물어보는 것은 평가 효율 측면에서 낭비일 수 있다. 반대로 정보량이 낮거나 실제 능력과 상관이 약한 문항은 전체 평가 시간을 늘리지만 추정 품질에는 거의 기여하지 않는다. 다만 Vidal은 이 현상이 모든 벤치마크에서 동일하게 나타나는 것은 아니며, GPQA처럼 잘 설계된 벤치마크에서는 무작위로 문항을 뽑아도 비교적 안정적인 결과가 나올 수 있다고 덧붙인다.
잔차 분석: 모델의 이상 행동을 읽는 새로운 창
IRT는 각 모델이 각 문항을 맞힐 확률을 추정하므로, 실제 결과와 예측 결과 사이의 차이도 계산할 수 있다. 이 차이가 residual(잔차)이다. 잔차는 단순한 오차가 아니라, 모델이 예상보다 훨씬 잘하거나 훨씬 못한 지점을 보여주는 신호가 된다.
강연자는 Gemini 3 Pro가 어떤 문항을 맞힐 확률이 86%로 예측되었지만 실제로는 틀린 사례를 언급한다. 반대로 DeepSeek R1이 예상보다 어려운 문항을 맞힌 사례도 소개한다. 이런 이상값이 곧바로 오버피팅이나 데이터 누출을 의미하는 것은 아니지만, 반복적으로 관찰된다면 벤치마크 오염, 특정 유형 문항에 대한 편향, 추론 플랫폼 문제 등을 의심해볼 수 있다.
특히 그는 o4-mini가 가장 일관성이 낮은 모델로 보였다고 설명한다. 중간 난이도의 문항에서 예측과 다른 정답 패턴이 많이 나타났기 때문이다. 이러한 패턴은 실제 모델 능력의 특성일 수도 있지만, 추론 플랫폼이 잘못된 모델을 실행했거나 quantization(양자화)이 잘못 적용된 경우에도 나타날 수 있다. 따라서 잔차 분석은 모델 성능 평가뿐 아니라 평가 파이프라인의 품질 점검에도 활용될 수 있다.
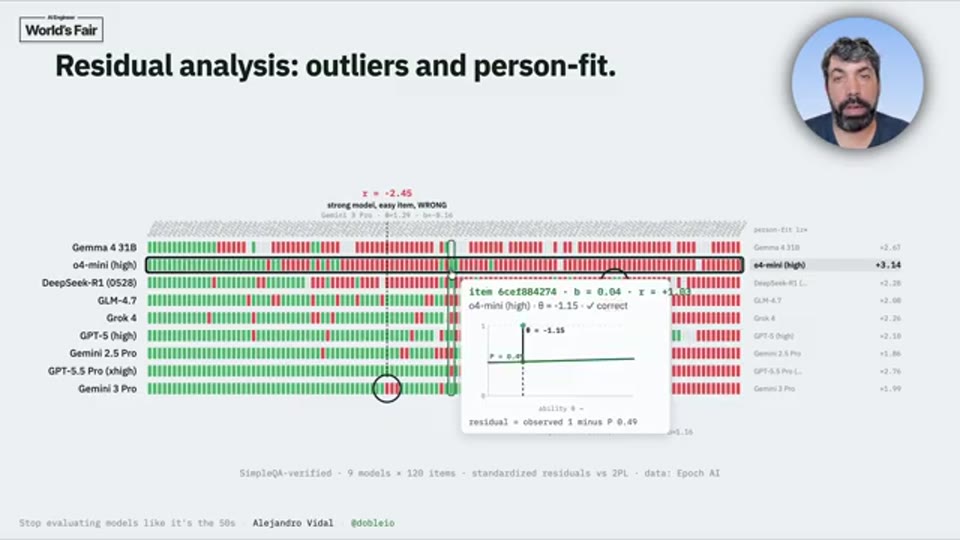
15:36 - 잔차와 일관성 분석을 통해 O4-mini의 이상한 응답 패턴을 설명하는 구간
Adaptive Testing과 벤치마크 보호
강연자는 벤치마크가 매우 비싸고 가치 있는 자산일수록 유출과 학습 오염을 막는 것이 중요하다고 말한다. 이를 위해 그는 adaptive testing(적응형 검사) 아이디어를 소개한다. 핵심은 전체 벤치마크를 모든 조직에 동일하게 공개하지 않고, 공통 기준이 되는 anchor set과 조직별 fingerprint set을 나누어 사용하는 것이다.
Anchor set은 전체 벤치마크를 대표하는 공통 문항 집합이다. 모든 모델과 조직에 이 문항을 사용함으로써 기본적인 비교 가능성을 유지한다. 반면 fingerprint set은 특정 조직에만 제공되는 개별 문항 집합이며, Vidal은 이 문항들이 특히 어려운 문항이어야 한다고 설명한다. 시간이 지난 뒤 해당 조직의 새 모델이 유독 그 fingerprint set에서 비정상적으로 좋은 잔차를 보인다면, 그 문항들이 학습에 사용되었을 가능성을 의심할 수 있다.
물론 그는 이 방법이 완벽한 증명 도구는 아니라고 선을 긋는다. 하지만 벤치마크 보호 관점에서는 매우 강력한 탐지 신호가 될 수 있다. 특히 고가의 비공개 평가셋을 운영하는 조직이라면, 문항을 단순히 숨기는 것보다 잔차 기반의 추적 구조를 함께 설계하는 편이 장기적으로 더 효과적일 수 있다.
문항 편향 분석과 모델 그룹 비교
심리측정학에서는 특정 문항이 특정 집단에 불리하게 작동하는지 확인하는 것이 중요하다. Vidal은 같은 기법을 LLM에도 적용할 수 있다고 설명한다. 예를 들어 모델을 open weights 모델과 closed weights 모델로 나누고, 각 문항에 대해 두 그룹의 반응 곡선을 따로 추정할 수 있다.
편향이 없는 문항이라면 두 곡선은 대체로 겹쳐야 한다. 그러나 어떤 문항에서 두 곡선 사이의 간격이 크다면, 그 문항은 특정 그룹에 더 유리하거나 불리하게 작동하는 것이다. 강연자는 실제 벤치마크에 이 기법을 적용하면 closed weights 모델에 유리한 문항과 open weights 모델에 유리한 문항을 찾을 수 있다고 말한다.
그는 실제 문항을 공개하지는 않았다. 벤치마크 유출을 피하기 위한 선택이다. 다만 특정 질문군이 공통된 특징을 보이며 특정 모델 그룹에 유리하게 작동한다는 패턴은 관찰할 수 있었다고 설명한다. 이는 모델이 어떤 데이터와 학습 방식의 영향을 받았는지 추론하는 데에도 도움이 될 수 있다.
모델 fingerprint: 잔차로 모델의 계보를 추적하기
마지막 응용은 가장 연구적인 성격이 강하다. Vidal은 각 모델의 잔차 패턴을 일종의 DNA 또는 fingerprint로 볼 수 있다고 말한다. 모델이 같은 계열에서 발전했거나 같은 base model을 공유한다면, 비슷한 문항에서 비슷한 방식으로 실수할 가능성이 높기 때문이다.
그는 잔차 기반 correlation matrix(상관 행렬)와 간단한 projection(투영)을 통해 모델 사이의 관계를 시각화할 수 있다고 설명한다. 같은 연구소의 모델, 같은 모델의 다른 버전, distillation(증류) 모델들은 서로 가까운 위치에 나타나는 경향이 있다고 한다. 예를 들어 같은 base를 공유하는 두 모델은 높은 상관을 보일 수 있으며, 강연에서는 한 사례에서 0.38의 상관이 언급된다.
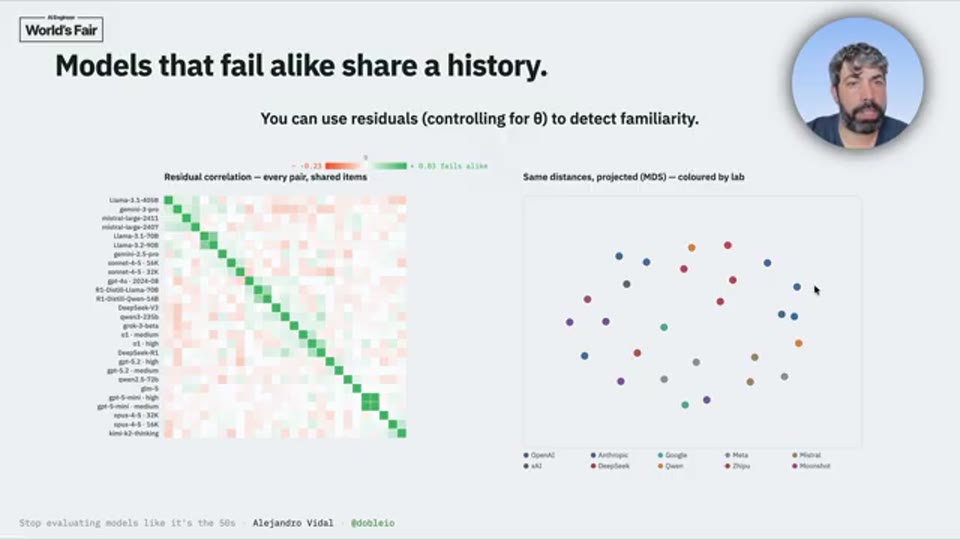
20:30 - 잔차 기반 correlation matrix와 projection으로 모델 fingerprint와 계보를 분석하는 구간
이 접근은 일상적인 모델 선택에는 벤치마크 축소나 문항 감사만큼 직접적이지 않을 수 있다. 그러나 무단 distillation을 탐지하거나, 모델 계열 간 관계를 분석하거나, 같은 모델의 다른 effort level과 버전을 구분하는 연구에는 의미가 있다. LLM 생태계가 복잡해질수록 단순한 성능 점수보다 “어떤 방식으로 맞히고 틀리는가”가 더 중요한 메타데이터가 될 수 있다.
앞으로의 연구 방향: 다차원 능력, 메타벤치마크, 정렬 측정
강연의 결론에서 Vidal은 자신의 목표가 LLM 평가에 심리측정학 연구의 문을 여는 것이라고 말한다. 그는 IRT가 매우 기본적인 수학만으로도 현재의 LLM 벤치마크 방식을 크게 개선할 수 있다고 본다. 하지만 동시에 이 강연에서 다룬 내용은 시작점일 뿐이며, 더 많은 확장 가능성이 남아 있다고 강조한다.
그가 언급한 첫 번째 확장 방향은 multidimensionality(다차원성)와 hierarchical models(계층 모델)이다. 현재의 단일 θ는 모델의 능력을 하나의 축으로 표현하지만, 실제 LLM 능력은 수학, 코딩, 추론, 지식, 언어 이해처럼 여러 차원으로 나뉠 가능성이 크다. 다차원 IRT를 적용하면 모델이 어떤 유형의 작업에 강하고 약한지 더 세밀하게 측정할 수 있다.
두 번째 방향은 여러 벤치마크를 결합해 추정 품질을 높이는 것이다. 강연자는 MetaBenchmark라는 연구를 추천하며, IRT 관점에서는 서로 다른 벤치마크를 하나의 측정 체계로 연결하는 일이 자연스럽다고 설명한다. 또한 latency(지연 시간), token 사용량 같은 추가 신호를 함께 넣거나, alignment(정렬)와 interpretability(해석 가능성)를 심리측정 모델로 측정하는 방향도 유망하다고 말한다. 이 지점에서 IRT는 단순한 평가 기법을 넘어, LLM을 과학적으로 측정하는 프레임워크가 된다.
마무리 / 핵심 정리
이 강연의 핵심 메시지는 LLM 평가가 더 이상 “몇 문제를 맞혔는가”에 머물러서는 안 된다는 것이다. 정답 수 기반 평가는 모든 문항을 동일하게 취급하지만, 실제로 문항은 난이도와 변별력, 품질, 편향, 오염 가능성에서 서로 크게 다르다. IRT는 이 차이를 모델링함으로써 모델 능력과 문항 특성을 동시에 추정한다.
Vidal이 제안하는 접근은 실용성과 연구성을 모두 갖고 있다. 실무적으로는 잘못된 문항을 찾고, 벤치마크 비용을 줄이고, 추론 플랫폼의 이상 동작을 감지하며, 벤치마크 유출 가능성을 추적하는 데 도움이 된다. 연구적으로는 모델 계보, 증류 탐지, 다차원 능력 측정, alignment 평가 같은 더 깊은 문제로 이어진다.
결국 이 강연은 LLM 벤치마크를 “점수표”가 아니라 “측정 도구”로 보자는 제안이다. 좋은 측정 도구는 대상뿐 아니라 도구 자체의 신뢰성도 함께 검증해야 한다. IRT는 바로 그 검증을 가능하게 하며, 모델 평가를 1950년대식 정답 수 세기에서 더 정교한 심리측정학적 분석으로 옮겨가는 출발점이 될 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Stop Evaluating Models Like It’s the 50s - Alejandro Vidal, Mindmakers |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-14 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.