Stop Renting Your Cognitive Infrastructure - Thiyagarajan Maruthavanan, Kalmantic Labs
📺 원본 영상: Stop Renting Your Cognitive Infrastructure - Thiyagarajan Maruthavanan, Kalmantic Labs
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-19
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
Thiyagarajan Maruthavanan은 이 강연에서 AI 애플리케이션의 추론 비용이 단순한 클라우드 사용료 문제가 아니라, 기업의 핵심 인지 인프라를 외부에 임대하는 구조적 문제라고 주장한다. 초기 실험 단계에서는 Anthropic, OpenAI, neocloud, inference endpoint provider 같은 외부 플랫폼을 쓰는 것이 합리적일 수 있지만, 제품 시장 적합성(Product-Market Fit)을 지나거나 엔터프라이즈 업무에 들어서는 순간 비용, 통제, 감사, 재현성 문제가 동시에 터진다는 것이다.
강연의 핵심 문장은 “rent to learn, own to earn”이다. 배울 때는 빌려도 되지만, 그 위에서 돈을 벌려면 소유해야 한다는 메시지다. 이는 단순히 GPU를 사야 한다는 주장이라기보다, 모델 실행, 토큰 관리, 컨텍스트 압축, 보안, 감사 가능성, 워크로드 형상에 대한 이해까지 포함하는 넓은 의미의 inference infrastructure(추론 인프라) 전략을 말한다.
rented intelligence가 싸 보이는 이유와 실제로 비싸지는 이유
강연자는 먼저 외부 AI 추론 플랫폼을 “rented intelligence”라고 부른다. 이 표현은 매우 의도적이다. 사용자는 API를 호출할 때마다 지능을 빌려 쓰고 있으며, 겉으로는 토큰 단가가 낮아 보이기 때문에 처음에는 비용 부담을 과소평가하기 쉽다. 그러나 실제 운영에서는 이 비용이 휴대폰 요금처럼 한 달에 한 번 명확하게 청구되는 고정비가 아니라, 선불 크레딧을 계속 충전하면서 소진 속도를 뒤늦게 깨닫는 구조에 가깝다.
그는 이를 카지노 칩에 비유한다. 사용자는 처음에는 적은 크레딧을 넣고 실험하지만, 앱이 재미있게 작동하고 사용자 반응이 생기면 더 많은 요청을 보내게 된다. 특히 AI 제품은 사용자가 늘어날수록 단순한 서버 비용뿐 아니라 모델 추론 호출이 곱절로 증가하기 때문에, 기존 SaaS 인프라보다 비용 곡선이 훨씬 빠르게 가팔라질 수 있다. 강연자는 대형 유통 기업이 Anthropic 추론에 약 2억 달러 가까이 지출한 뒤 자체 인프라 구축으로 방향을 틀었다는 사례와, Uber CTO가 연간 토큰 예산을 잡았지만 4개월 만에 소진했다는 사례를 언급하며 이 문제가 이미 대규모 기업 환경에서 현실이 되었다고 설명한다.
그의 개인 경험도 같은 방향을 가리킨다. 그는 Suno.com처럼 텍스트 프롬프트로 음악을 생성하는 서비스와 반대로, 특정 노래가 어떤 프롬프트에서 생성되었을지를 추론하는 Ulta Suno라는 애플리케이션을 만들었다고 설명한다. 이 앱은 친구들에게 공유된 뒤 빠르게 퍼졌고 많은 사용자가 유입되었지만, 그 결과 예상보다 훨씬 큰 추론 비용이 발생했다. 제품이 성공할수록 비용도 함께 폭증하는 역설이 여기서 드러난다.
01:32 - 개인 앱 Ulta Suno의 사용자 확산 이후 추론 비용이 예상보다 크게 증가한 사례
비용 폭증의 진짜 원인 - 토큰보다 워크로드를 봐야 한다
강연자는 추론 비용이 커지는 이유를 단순히 “모델이 비싸서”라고 설명하지 않는다. 문제의 핵심은 inference endpoint가 실제 워크로드의 형태를 이해하지 못한다는 데 있다. 많은 애플리케이션은 입력 토큰 압축, 컨텍스트 관리, agent loop 최적화를 제대로 하지 않은 채 외부 모델을 반복 호출한다. 그 결과 사용자가 보는 기능은 하나의 요청처럼 보이지만, 내부에서는 불필요한 모델 호출이 연쇄적으로 발생한다.
특히 agent system에서는 이 문제가 더 커진다. 에이전트는 계획을 세우고, 도구를 호출하고, 중간 결과를 다시 모델에 넣고, 필요하면 반복하는 구조를 갖는다. 이 과정에서 컨텍스트가 계속 길어지고, 이전 정보가 압축되지 않으며, 같은 목적의 호출이 중복되면 비용은 사용량보다 훨씬 빠르게 증가한다. 따라서 추론 비용 최적화는 단순히 더 싼 모델을 찾는 일이 아니라, 애플리케이션이 어떤 형태의 인지 작업을 수행하는지 이해하고 그 흐름을 인프라 수준에서 제어하는 문제로 바뀐다.
보안 문제도 같은 맥락에서 비용 문제로 이어진다. 강연자는 3주 전 자신의 API key가 탈취되어 중국의 누군가가 endpoint를 사용했고, 비용이 7,000달러에서 7,500달러, 8,000달러로 계속 올라가는 상황을 겪었다고 말한다. 공동창업자의 대응 덕분에 10,000달러 선에서 막았지만, 그렇지 않았다면 100,000달러까지 갈 수 있었다고 설명한다. 이 사례는 rented intelligence 구조에서 비용 통제와 보안 통제가 분리될 수 없다는 점을 보여준다.
02:16 - API key 탈취로 추론 endpoint 비용이 빠르게 상승한 보안 및 비용 통제 사례
Token Factory라는 중간 해법과 그 한계
외부 API 비용이 부담스러워지면 많은 팀은 Token Factory로 이동한다. 강연자가 말하는 Token Factory는 Anthropic이나 OpenAI 같은 API에 직접 비용을 지불하는 대신, 오픈소스 모델을 cloud provider, neocloud, inference endpoint provider 위에 배포하고 tokens per second 단위로 소비하는 구조를 뜻한다. 이는 모델 선택권을 넓히고 단가를 낮출 수 있기 때문에, rented intelligence의 첫 번째 대안처럼 보인다.
더 나아가 일부 AI Twitter 인플루언서들은 로컬 Token Factory를 주장한다고 강연자는 말한다. GPU 카드를 사서 차고나 지하실에 설치하고, 직접 inference cluster를 구성하면 외부 API 비용에서 벗어날 수 있다는 논리다. 강연자 역시 이 아이디어에 일부 영향을 받아 NVIDIA DGX Spark로 추정되는 로컬 장비를 구입했고, 자신의 앱을 Anthropic에서 해당 로컬 인프라로 옮겼다고 설명한다. STT상 “dgx parks”로 인식되었지만 문맥상 NVIDIA의 DGX Spark 또는 유사한 DGX 계열 장비를 가리키는 것으로 보인다.
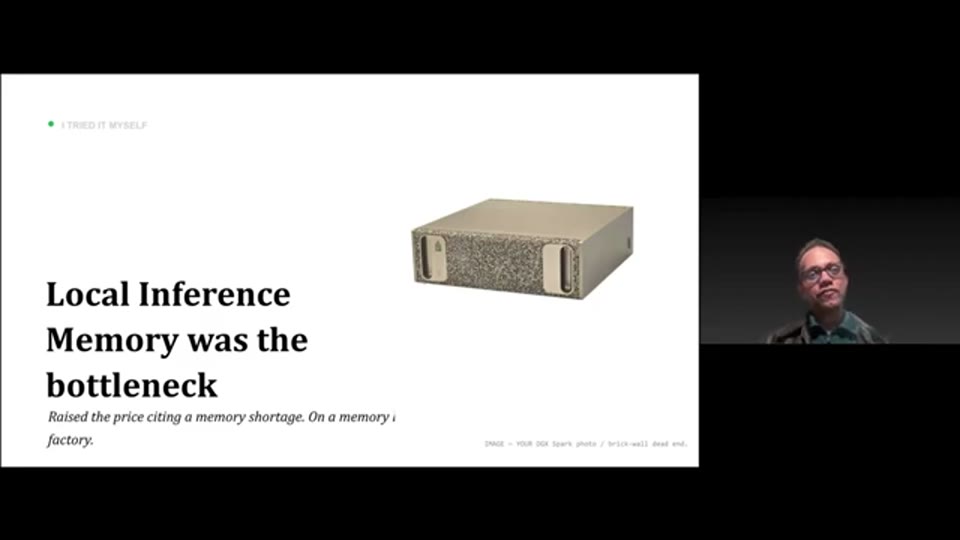
03:11 - Anthropic 기반 앱을 로컬 DGX 계열 인프라로 옮기고 Token Factory를 실험한 과정
초기 결과는 나쁘지 않았다. 그는 메모리가 병목이 되는 문제를 겪었지만, 앱을 옮기고 연구소 운영에 필요한 에이전트를 2개, 6개, 8개, 12개씩 늘려가며 어느 정도 작동하는 환경을 만들었다. 그러나 이 경험은 동시에 로컬 Token Factory가 곧바로 엔터프라이즈급 인프라가 되는 것은 아니라는 점도 보여주었다. 개인이나 소규모 연구 환경에서는 “작동한다”가 충분할 수 있지만, 기업 환경에서는 안정성, 감사, 통제, 재현성이 별도의 요구사항으로 등장하기 때문이다.
엔터프라이즈가 rented intelligence를 견디기 어려운 세 가지 이유
강연자는 세 개의 기업 사례를 통해 기업이 외부 추론 인프라에 부딪히는 벽을 설명한다. 첫 번째는 투자 펀드다. 이 펀드는 NVIDIA NIM 계열 아키텍처로 추정되는 환경에서 investment analyst agent를 운영하고 있었는데, 문제는 외부 제공자가 rate limit을 결정한다는 점이었다. 투자 분석처럼 시간 민감성과 처리량이 중요한 업무에서, 어느 시점에 얼마나 많은 추론을 사용할 수 있는지를 외부 사업자가 정한다면 그것은 단순한 비용 문제가 아니라 운영 통제권의 문제가 된다.
두 번째는 병원 사례다. 병원은 특정 AI use case를 성공적으로 검증했지만, 이후 감사 과정에서 third-party vendor dependency가 redline 처리되면서 더 이상 진행할 수 없었다. 의료 분야에서는 환자 데이터, 규제 준수, 감사 가능성, 책임 소재가 매우 중요하기 때문에, 외부 추론 제공자에 의존하는 구조가 실제 도입의 병목이 될 수 있다. 기술적으로 잘 작동한 데모가 조직의 운영 체계 안으로 들어오지 못하는 전형적인 장면이다.
세 번째는 세무 법인 사례다. 세무 업무에서는 AI가 생성한 recommendation을 나중에 다시 재현할 수 있어야 한다. 그런데 모델 내부, 버전, 실행 조건, 추론 설정에 충분히 접근할 수 없다면 과거의 판단을 같은 방식으로 재현하기 어렵다. 세금, 회계, 법률처럼 결과의 설명 가능성과 재현성이 중요한 영역에서는 단지 “좋은 답변을 냈다”는 사실만으로 충분하지 않으며, 어떤 조건에서 왜 그런 답변이 나왔는지를 추적할 수 있어야 한다.
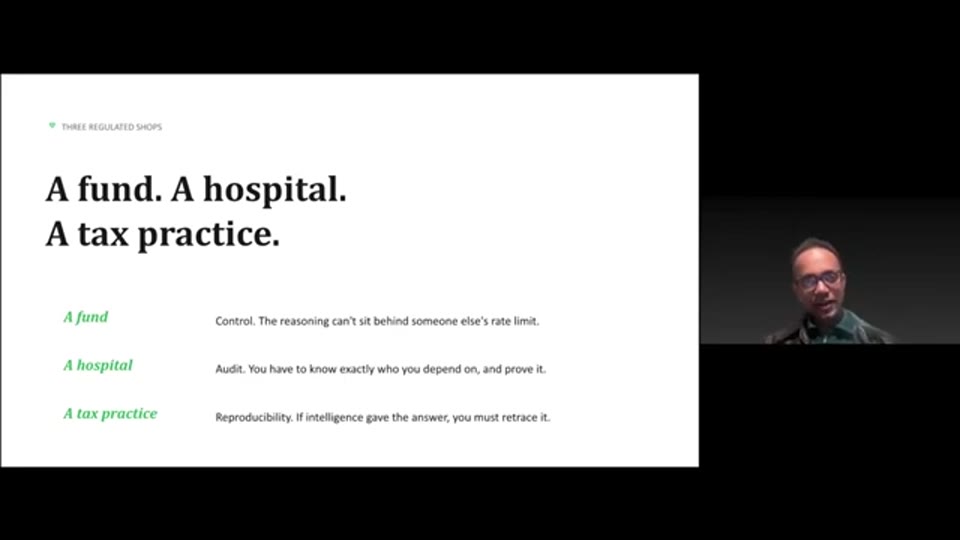
04:08 - 투자 펀드, 병원, 세무 법인이 각각 외부 AI 인프라 사용에서 부딪힌 엔터프라이즈 문제
언제 빌리고, 언제 소유해야 하는가
강연의 중심 질문은 “언제 rented infrastructure를 멈춰야 하는가”이다. 강연자에 따르면 스타트업이 아직 pre-product-market-fit 단계라면 빌려 쓰는 것이 맞다. 이 시기에는 고객이 실제로 원하는 문제가 무엇인지, 어떤 use case에 수요가 있는지, 어떤 모델 조합이 쓸 만한지를 빠르게 검증해야 하기 때문에 외부 API의 속도와 유연성이 큰 장점이 된다.
그러나 post-product-market-fit 단계로 넘어가면 상황은 달라진다. 제품이 이미 수요를 입증했고 사용량 증가가 매출 또는 핵심 업무와 연결된다면, 추론 인프라를 계속 임대하는 것은 비용 구조와 운영 통제권을 동시에 외부에 맡기는 일이 된다. 엔터프라이즈의 경우에는 특정 프로젝트에 예산을 배정했다는 사실 자체가 이미 내부적으로 product-market fit을 가정했다는 뜻이므로, 자체 inference infrastructure 구축을 검토하지 않는 것은 위험하다고 강연자는 주장한다.
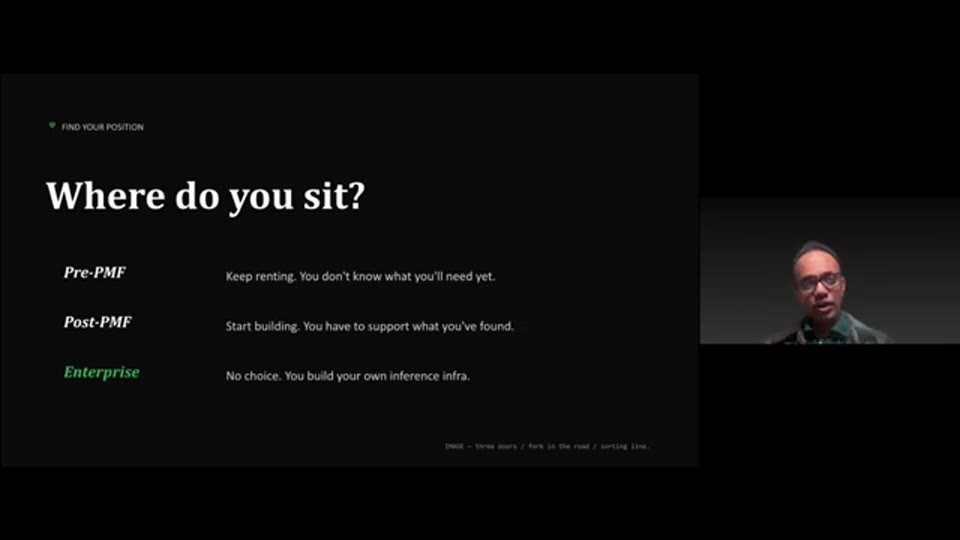
05:16 - pre-product-market-fit과 post-product-market-fit을 기준으로 인프라 임대와 소유의 전환점
그는 이를 주거에 비유한다. 새로운 도시에 처음 가면 집을 사기보다 임대하거나 Airbnb를 쓰면서 환경과 동네를 경험하는 것이 합리적이다. 하지만 장기적으로 가족을 꾸리고 생활 기반을 만들려면 Airbnb에서 계속 살 수는 없다. AI 인프라도 마찬가지로, 탐색 단계에서는 빌려 쓰되 핵심 사업 기반이 되는 순간에는 소유 구조로 전환해야 한다는 것이 그의 결론이다.
추론 인프라 최적화는 여러 계층에서 일어난다
강연자는 “소유”를 단순히 하드웨어 구매로 축소하지 않는다. 그는 inference infrastructure를 구축하는 과정에서 여러 계층의 최적화가 필요하다고 말한다. rented intelligence나 leased Token Factory 단계에서도 입력 비용, 토큰 관리, 컨텍스트 관리, agent loop 최적화는 여전히 중요하다. 즉, 자체 인프라 구축 여부와 무관하게 비용을 이해하고 줄이는 능력은 AI 애플리케이션 운영의 기본 역량이 된다.
그는 최근 몇 달간의 경험을 바탕으로 JustTokenMax라는 오픈소스 프로젝트를 만들었다고 소개한다. STT상 “just token max”로 인식되었으며, 강연자는 이를 Netflix의 Headroom과 비교 가능한 대안이라고 설명한다. 구체적인 벤치마크 수치나 화면 자료는 음성에 포함되어 있지 않으므로 여기서 확정적으로 재구성할 수는 없지만, 강연자의 설명에 따르면 여러 파라미터에서 JustTokenMax가 더 우수한 결과를 보였다고 한다.
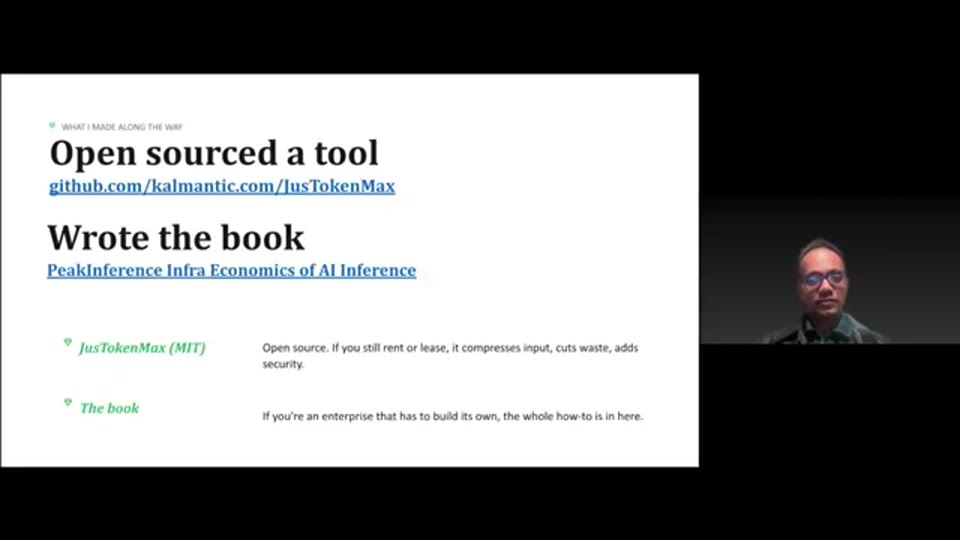
06:14 - JustTokenMax 오픈소스 프로젝트와 Netflix Headroom 비교
또한 그는 “Peak Inference Infra - Economics of AI Inference”라는 책을 썼다고 언급한다. 이 책은 자체 inference infrastructure를 언제, 어떻게 고민해야 하는지 다루는 것으로 보인다. 강연 맥락상 이 프로젝트와 책은 같은 문제의식에서 나온다. AI 애플리케이션의 비용 구조를 이해하지 못한 채 제품을 성장시키면, 제품 성공이 곧 손실 확대로 이어질 수 있기 때문이다.
AI 인프라 시장의 소음과 판단 기준
강연자는 AI 시장이 기존 기술 시장과 다르다고 말한다. 규칙이 3개월에서 6개월마다 바뀌기 때문에, 시장 참여자마다 서로 다른 미래를 주장하고 그 결과 의사결정자가 혼란에 빠지기 쉽다는 것이다. Jensen Huang은 Token Factory가 미래라고 말할 수 있고, Satya Nadella는 unmetered intelligence와 local intelligence가 미래라고 말할 수 있으며, neocloud와 inference endpoint provider들은 자신들이 가치의 중심을 가져갈 것이라고 주장할 수 있다.
이러한 주장들은 모두 각자의 이해관계와 시장 위치를 반영한다. GPU 공급자는 GPU 기반 토큰 생산 구조를 강조할 것이고, 클라우드 및 플랫폼 기업은 대규모 unmetered intelligence 또는 managed endpoint의 장점을 말할 것이다. 그러나 강연자는 특정 진영의 메시지를 그대로 받아들이기보다, 자신의 애플리케이션이 어느 단계에 있고 어떤 위험을 감당해야 하는지를 기준으로 판단해야 한다고 강조한다.
그가 앱에서 에이전트로, 다시 확장과 자체 인프라 구축으로 이동하면서 얻은 결론은 간단하다. 학습과 탐색에는 임대가 적합하지만, 수익과 운영의 기반이 되는 순간에는 소유가 필요하다. 이 문장은 비용 절감 구호처럼 들릴 수 있지만, 실제로는 AI 제품의 책임 소재, 통제권, 재현성, 감사 가능성을 모두 포함하는 전략적 기준이다.
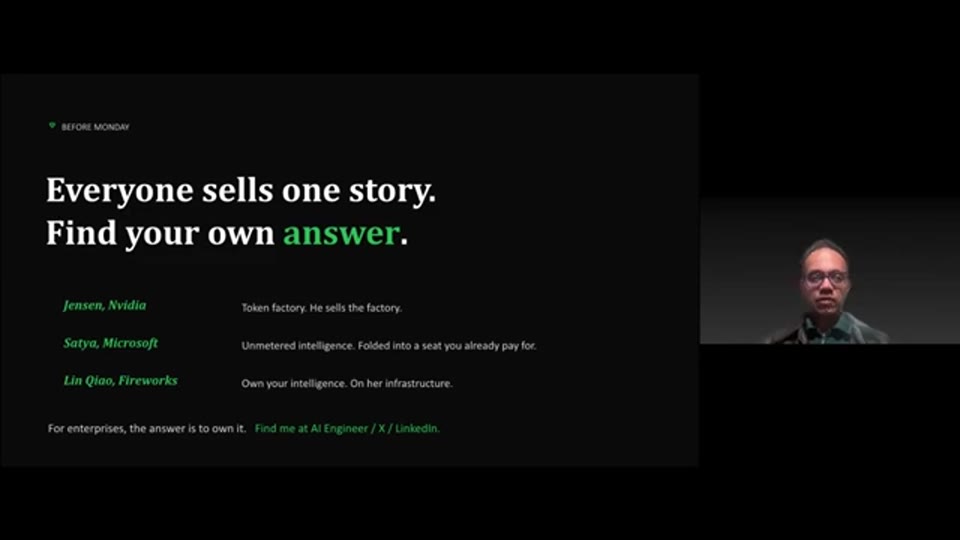
07:16 - 강연의 핵심 메시지인 rent to learn, own to earn
마무리 / 핵심 정리
이 강연의 핵심은 AI 추론 비용을 단순한 청구서 문제가 아니라 기업의 인지 인프라 소유권 문제로 보아야 한다는 점이다. 외부 API와 Token Factory는 빠른 실험과 초기 제품 검증에는 매우 강력하지만, 사용량이 증가하고 업무가 핵심 프로세스에 연결될수록 비용 예측, rate limit, 보안, 감사, 재현성의 문제가 커진다. 특히 엔터프라이즈 환경에서는 “모델이 잘 답한다”는 것만으로 충분하지 않고, 그 답을 어떤 조건에서 다시 만들 수 있는지와 누가 인프라를 통제하는지가 중요해진다.
강연자가 제시한 “rent to learn, own to earn”은 이 전환점을 압축한 문장이다. 초기에는 빌려서 배우고, 시장과 사용 사례를 확인한 뒤, 수익과 운영이 걸린 단계에서는 직접 소유하거나 최소한 통제 가능한 인프라 구조를 만들어야 한다. AI 애플리케이션이 점점 더 많은 의사결정과 업무 흐름을 담당하게 될수록, inference infrastructure는 부가적인 백엔드 자원이 아니라 제품의 경제성과 신뢰성을 결정하는 핵심 기반이 된다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Stop Renting Your Cognitive Infrastructure - Thiyagarajan Maruthavanan, Kalmantic Labs |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-19 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.