Taking Reinforcement Learning Cross Datacenter — Nan Jiang, Modal
📺 원본 영상: Taking Reinforcement Learning Cross Datacenter — Nan Jiang, Modal
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-08-11
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
Nan Jiang은 Modal이 GPU capacity를 바라보는 관점에서 RL post-training(강화학습 기반 후처리 학습)의 병목을 다시 해석한다. 오늘날 RLHF나 agentic post-training 논의는 PPO, GRPO, sandbox, tool call, low-precision training, deterministic kernel 같은 알고리즘과 환경 설계에 집중되지만, 실제 scale에서 문제는 훨씬 물리적인 형태로 나타난다. 핵심 질문은 단순하다. 필요한 GPU가 같은 region에 있고, 빠른 RDMA fabric으로 묶여 있으며, 지금 당장 사용할 수 있는가.
강연의 주장은 RL loop 전체를 하나의 거대한 cluster 안에 밀어 넣는 기본 설계가 지나치게 제한적이라는 데서 출발한다. Trainer는 여전히 tightly coupled cluster를 필요로 하지만, rollout worker는 본질적으로 serving job의 fleet에 가깝기 때문에 더 느슨하게 분산될 수 있다. 이 차이를 이용하면 trainer cluster는 안정적으로 유지하면서도, rollout capacity는 여러 region과 provider에 흩어진 GPU를 elastic하게 활용하는 구조로 확장할 수 있다.
RL Post-Training의 병목은 알고리즘보다 물리적이다
강연자는 먼저 표준 RL post-training loop를 trainer, rollout worker, environment의 상호작용으로 설명한다. Trainer는 policy를 업데이트하고, rollout worker 또는 sampler는 해당 policy로 trajectory를 생성하며, environment는 reward와 observation을 반환한다. 이후 생성된 trajectory는 다시 trainer로 돌아가 다음 update에 사용된다. 이 구조 자체는 익숙하지만, scale이 커질수록 trainer와 rollout worker가 같은 cluster 안에 묶여 있다는 사실이 capacity 확장의 가장 큰 제약으로 드러난다.
기본 설정에서는 trainer와 rollout fleet이 같은 cluster 안에 있고, weight synchronization은 RDMA를 통해 매우 빠르게 처리된다. 문제는 이 빠른 동기화가 rollout fleet을 trainer cluster의 물리적 크기와 availability에 결박한다는 점이다. Rollout이 더 많은 node를 필요로 하더라도 trainer cluster가 이미 고정된 크기라면, 실행 중간에 capacity를 유연하게 늘리는 것은 어렵다. 결국 RL loop 전체가 하나의 RDMA island 안에 있어야 한다는 전제가 rollout까지 trainer의 가장 어려운 제약을 상속하게 만든다.
Nan Jiang은 이를 “cathedral”과 “sprawl”의 대비로 설명한다. Cathedral은 하나의 region, 빠른 interconnect, 촘촘히 연결된 GPU로 이루어진 trainer에 적합한 형태다. 반면 sprawl은 서로 다른 provider, region, 가격, availability를 가진 분산된 compute pool이며, 실제로 많은 usable GPU capacity가 존재하는 곳이다. RL이 충분한 GPU, 같은 region, 빠른 fabric, 즉시 availability라는 네 조건을 동시에 요구할 때 문제가 어려워지는 이유는 바로 이 mismatch에 있다.
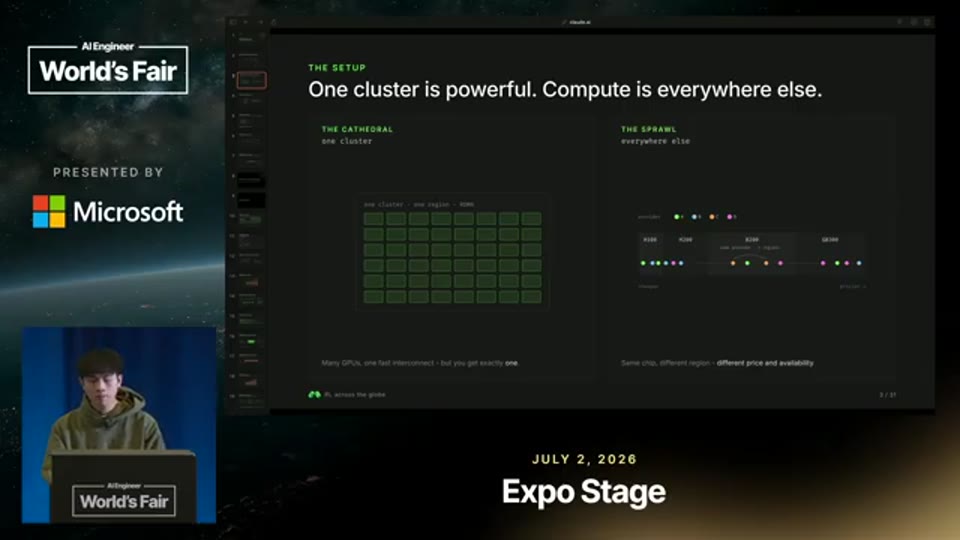
02:27 - cathedral과 sprawl의 대비를 통해 RDMA cluster와 분산 GPU capacity의 mismatch를 설명하는 장면
Trainer는 cluster 안에, Rollout은 밖으로 나갈 수 있다
강연의 첫 번째 핵심 분리는 training과 rollout의 통신 패턴 차이다. Training은 매 step마다 collective communication, all-reduce, model parallel communication을 수행하므로 하나의 빠른 RDMA fabric 안에 있어야 한다. Backpropagation은 특히 latency와 bandwidth에 민감하기 때문에, 이를 여러 region이나 provider로 흩뜨리는 것은 현실적인 설계가 아니다.
하지만 rollout은 다르다. Rollout worker는 trajectory를 생성하고, environment 또는 tool을 호출하며, 결과 data와 metadata를 trainer로 보내는 serving job의 fleet에 더 가깝다. Rollout job들 사이에는 global all-reduce가 필요하지 않으며, 각 rollout island는 특정 policy version을 serve하는 독립적인 endpoint 또는 local endpoint group으로 볼 수 있다. 따라서 이동 가능한 단위는 backpropagation이 아니라 rollout serving island다.
이렇게 단위를 다시 정의하면 architecture는 자연스럽게 단순해진다. Trainer는 RDMA cluster 안에 남아서 optimizer step과 collective를 처리하고, rollout side는 여러 region과 provider에 퍼진 serving island로 확장된다. Global interface는 trainer가 policy weight version을 내보내고, rollout island가 trajectory와 metadata를 되돌려주는 형태로 정리된다. 이 구조가 성립하려면 마지막으로 하나의 문제가 해결되어야 하는데, 그것이 바로 weight update를 어떻게 빠르고 정확하게 전달할 것인가다.
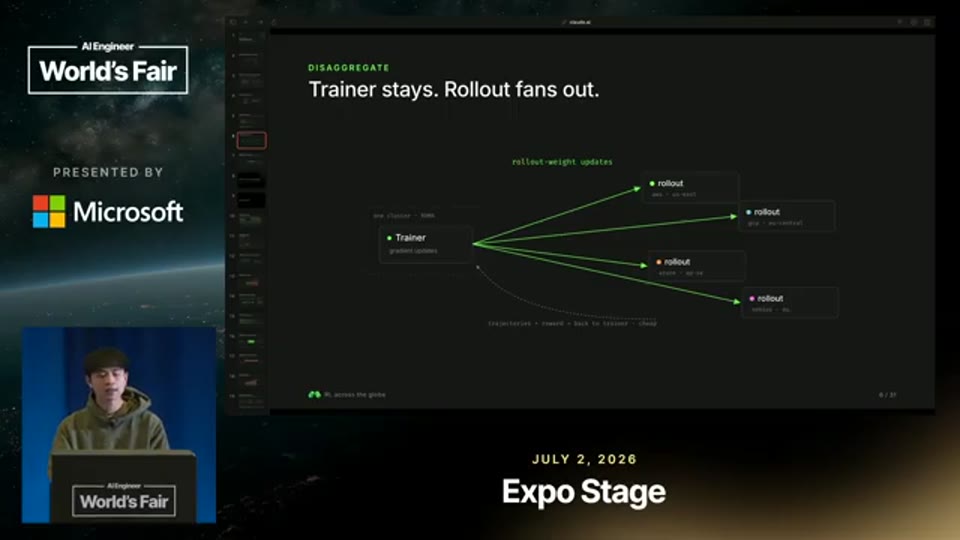
04:48 - trainer cluster와 여러 rollout island 사이의 version 및 trajectory 흐름을 설명하는 architecture 장면
Full Checkpoint는 잘못된 Synchronization 단위다
Rollout을 cluster 밖으로 빼내려 할 때 가장 먼저 부딪히는 장벽은 checkpoint size다. Full parameter checkpoint를 매번 disk나 network를 통해 전달한다면 architecture는 곧바로 무너진다. 강연자는 Kimi scale의 대형 모델 checkpoint가 약 500GB 수준일 수 있으며, 이를 전송하는 데 수분에서 길게는 수시간이 걸릴 수 있다고 설명한다. Commodity network link를 통해 이런 크기의 checkpoint를 자주 전달하는 것은 RL loop의 update latency 요구와 맞지 않는다.
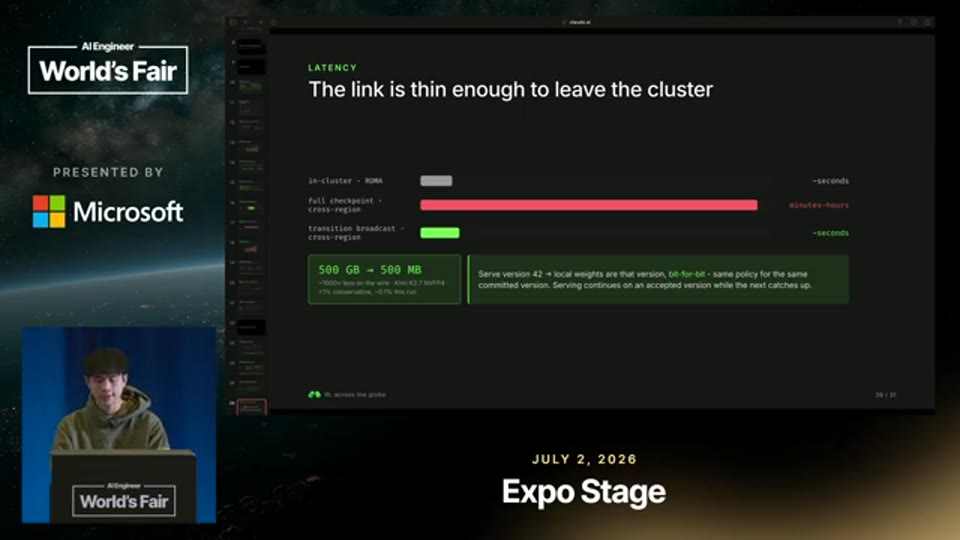
17:34 - full checkpoint 500GB 전송과 sparse patch 500MB 전송의 latency 차이를 비교하는 장면
중요한 점은 rollout이 cluster 밖으로 나갈 수 있느냐가 아니라, full checkpoint를 synchronization 단위로 삼는 것이 애초에 잘못되었다는 것이다. Fully async training을 사용하더라도 rollout engine이 새로운 policy version을 받아 serve하기까지의 latency는 가능하면 seconds 단위로 낮아야 한다. 따라서 질문은 “전체 parameter를 보낼 수 있는가”가 아니라 “동일한 served version을 재구성하면서 훨씬 작은 object만 보낼 수 있는가”로 바뀐다.
강연자는 여기서 rollout-visible weights라는 개념을 도입한다. 이는 optimizer가 보유한 FP32 master weights나 Adam moment가 아니라, 실제 rollout engine이 inference serving에 사용하는 BF16, FP8, 또는 더 낮은 precision의 weight view를 의미한다. 만약 한 version에서 다음 version으로 넘어갈 때 rollout-visible weights 중 1% 미만만 바뀐다면, network로 보내야 하는 것은 full checkpoint가 아니라 sparse patch가 된다.
왜 Served Weights는 거의 변하지 않는가
Nan Jiang은 served weights가 sparse하게 바뀌는 이유를 “small Adam step meets finite precision”으로 설명한다. Optimizer는 high precision master weights를 유지할 수 있지만, rollout engine의 forward path가 읽는 것은 BF16 같은 finite precision view다. BF16은 표현 가능한 값 사이에 간격이 있고, weight magnitude가 theta일 때 spacing은 대략 theta/128 수준이다. 실제 값이 다른 representable BF16 value로 바뀌려면 rounding boundary를 넘어야 하므로, 필요한 변화량은 대략 theta/256 수준이 된다.
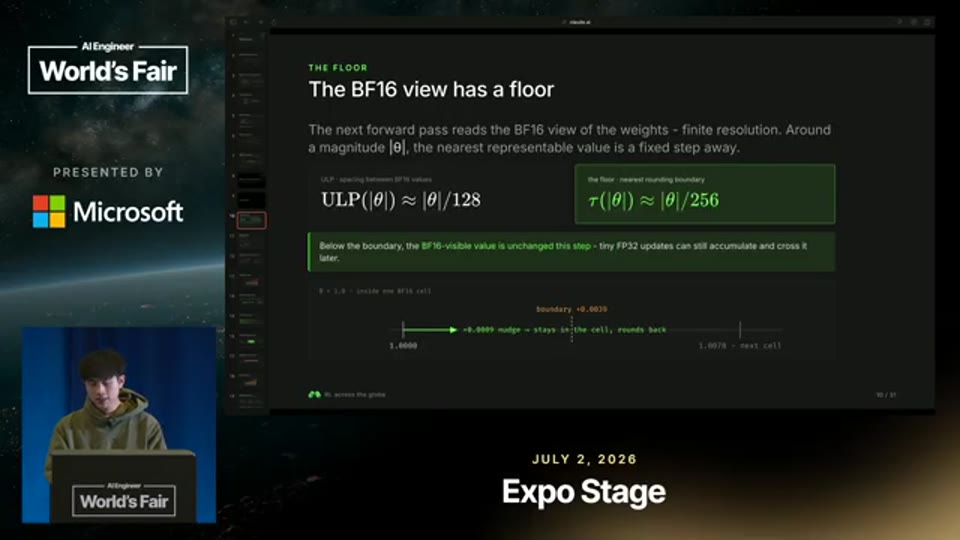
07:58 - BF16 ULP와 rounding boundary를 통해 served weight가 왜 잘 바뀌지 않는지 설명하는 장면
예를 들어 weight magnitude가 1 근처라면 BF16의 ULP(Unit in the Last Place)는 약 0.0078이고, 가장 가까운 rounding boundary는 약 0.0039다. 그런데 post-training에서 Adam 또는 AdamW의 per-parameter update는 learning rate와 normalized direction의 곱으로 매우 작고 통제된 크기를 갖는다. 강연자는 typical Adam step이 약 3e-6 수준이라고 설명하는데, 이는 BF16 rounding boundary보다 1,000배 이상 작다. 따라서 FP32 master weight는 dense하게 업데이트되더라도, rollout engine이 보는 BF16 값은 그대로 round back되어 바뀌지 않을 수 있다.
이 논리는 model이 멈춰 있다는 뜻이 아니다. Master weights는 계속 업데이트되고 있으며, optimizer state도 dense하게 움직인다. 다만 특정 step에서 rollout engine이 serve하는 quantized 또는 low-precision view가 바뀌지 않는 parameter가 대부분이라는 뜻이다. 이 현상을 강연자는 Adam absorption으로 설명하며, 결국 dense gradient와 dense master update가 sparse served update로 관측되는 이유가 여기에 있다고 말한다.
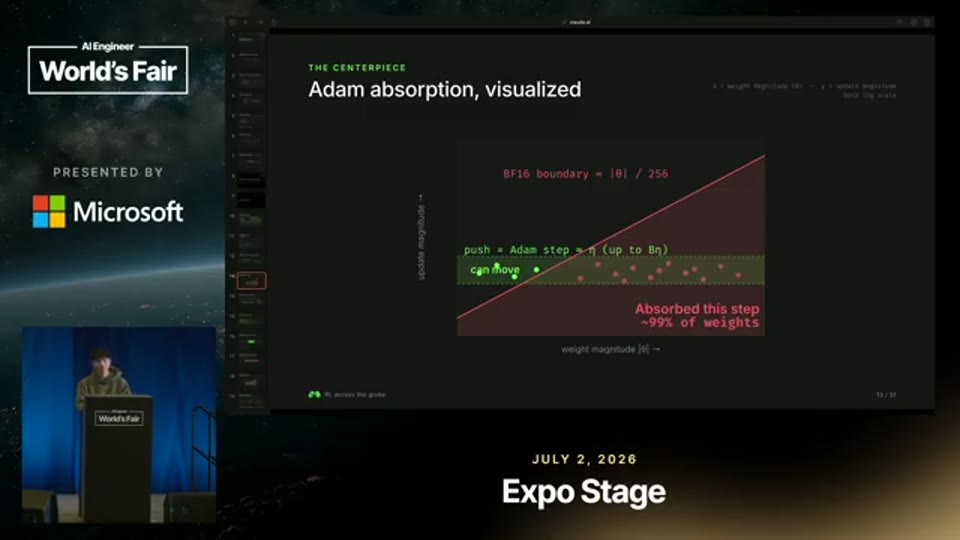
10:16 - weight magnitude와 Adam push의 관계를 그래프로 보여주며 Adam absorption을 설명하는 장면
Sparse Patch의 핵심은 Approximation이 아니라 Bitwise Reconstruction이다
이 설계에서 전송되는 object는 floating-point delta가 아니라 rollout view에서의 bit-level patch다. 먼저 weight를 rollout engine이 실제 serving에 사용할 dtype으로 project한 뒤, version T-1과 version T를 비교한다. 이후 바뀐 position, replacement bits, metadata를 patch로 구성한다. 구현 방식은 selective overwrite가 될 수도 있고 XOR encoding이 될 수도 있지만, 핵심은 patch를 적용했을 때 rollout engine이 정확히 동일한 served version을 bitwise로 재구성해야 한다는 점이다.
이 점은 시스템 안정성 측면에서 중요하다. Floating-point addition 방식의 delta를 누적하면 drift가 생길 수 있고, region마다 backend나 hardware가 다를 때 미세한 불일치가 커질 수 있다. 반면 replacement bits 기반의 patch는 올바르게 적용되기만 하면 full checkpoint를 load했을 때와 동일한 served weight version을 만든다. 따라서 cross-datacenter rollout은 approximate serving이 아니라 exact versioned serving으로 정의된다.
강연자는 full parameter RL과 LoRA(Low-Rank Adaptation)를 구분해 설명한다. Full parameter RL에서는 optimizer가 전체 model을 업데이트하지만, rollout view patch는 finite precision absorption 때문에 sparse해진다. 반면 LoRA는 base model이 frozen이고 adapter 자체가 작기 때문에 update object가 작다. 즉 full parameter delta는 absorption 때문에 작고, LoRA update는 구조적으로 작다는 차이가 있다.
Measurement는 Gradient Sparsity가 아니라 Served Weight Stillness다
강연에서 강조하는 또 하나의 오해는 sparse patch가 gradient sparsity 때문에 가능한 것이 아니라는 점이다. 논문 또는 실험에서 측정한 대상은 gradient가 얼마나 sparse한지가 아니며, optimizer state가 sparse한지도 아니다. 측정은 consecutive version의 weights를 BF16 등 serving dtype으로 cast한 뒤 bitwise로 비교하여, 얼마나 많은 value가 변하지 않았는지 확인하는 방식으로 이루어진다.
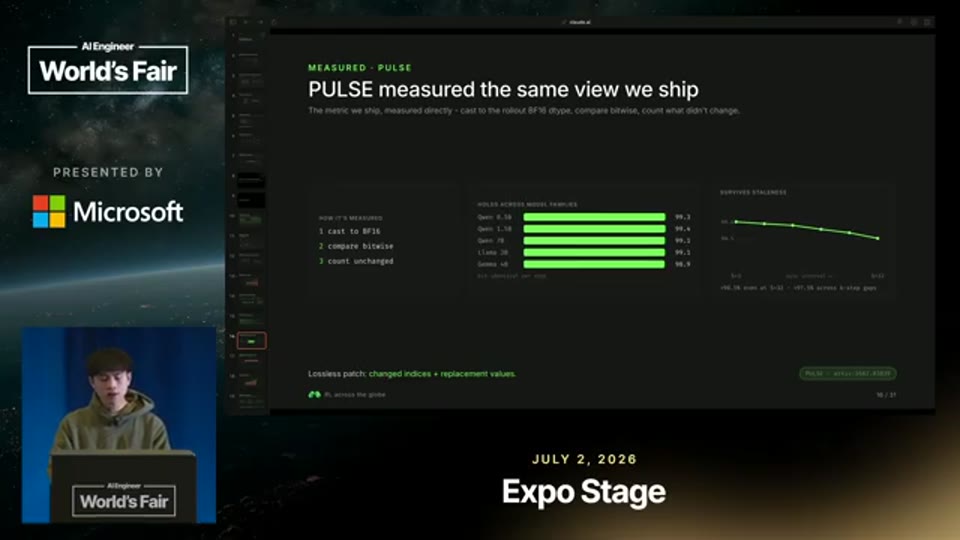
12:25 - consecutive BF16 served weight version을 bitwise 비교해 약 99% stillness를 설명하는 장면
강연자에 따르면 여러 model family에서 per-step 기준 약 99%의 served weights가 bit-identical하게 유지되는 결과가 관찰되었다. 또한 rollout이 trainer보다 뒤처지는 staleness 상황에서도 change size는 여전히 작게 유지된다고 설명한다. 이는 gradient가 sparse하다는 주장과 다르다. 실제로 gradient는 dense하며, 약 99%의 parameter가 non-zero gradient를 갖는다고 언급된다. 다만 FP32 master update가 매우 작기 때문에, low-precision served view에서는 대부분의 값이 그대로 남는다.
이 distinction은 engineering decision에 직접적인 영향을 준다. 만약 sparse patch를 gradient sparsity에 기대고 설계했다면 workload나 task가 바뀔 때 쉽게 깨질 수 있다. 하지만 finite precision boundary와 optimizer step size의 관계에 기대고 있다면, post-training learning rate regime과 serving dtype을 기준으로 더 일반화 가능한 판단을 할 수 있다. 강연의 시스템 설계는 바로 이 관찰을 전제로 full checkpoint transfer를 patch transfer로 대체한다.
Lower Precision Serving은 Patch를 더 작게 만들 수 있다
강연은 BF16에서 출발하지만, 실제 rollout serving은 FP8이나 MXFP4 같은 더 낮은 precision을 사용할 수 있다고 설명한다. Training precision은 일반적으로 BF16일 수 있고, 경우에 따라 QAT(Quantization-Aware Training)를 활용할 수 있지만, rollout serving path는 더 낮은 precision으로 동작하는 경우가 늘고 있다. Float-style fixed format에서는 visibility floor가 mantissa bit 수에 의해 결정되므로, precision이 낮아질수록 rounding boundary는 커지고 visible change는 더 줄어드는 경향이 있다.
Group scale을 사용하는 INT4나 MXFP4 계열은 element별 rounding boundary만 보면 되는 단순한 float format과는 다르다. 이런 format에서는 weight가 shared group scale에 대해 quantized되거나 hierarchical scale을 사용하기 때문에, scale 자체의 변화가 patch 구조에 영향을 줄 수 있다. 그럼에도 강연자는 유사한 현상이 관찰된다고 설명하며, low-precision serving system이 이런 방향으로 이동하고 있다는 점을 강조한다.
내부 run 사례로는 FP8 serving에서 초기 step의 weight change가 약 0.15% 수준이고, Adam이 안정화된 뒤에는 step당 약 0.05% 수준으로 내려간다고 언급된다. STT상 모델명은 “GRM 4.7”처럼 들리지만 정확한 표기는 불확실하므로 여기서는 특정 모델명 확정을 피한다. 중요한 것은 정확한 모델명이 아니라, high learning rate 초기 구간에서도 rollout-visible weight change가 극히 낮고, 학습이 안정화될수록 patch size가 더 작아진다는 패턴이다.
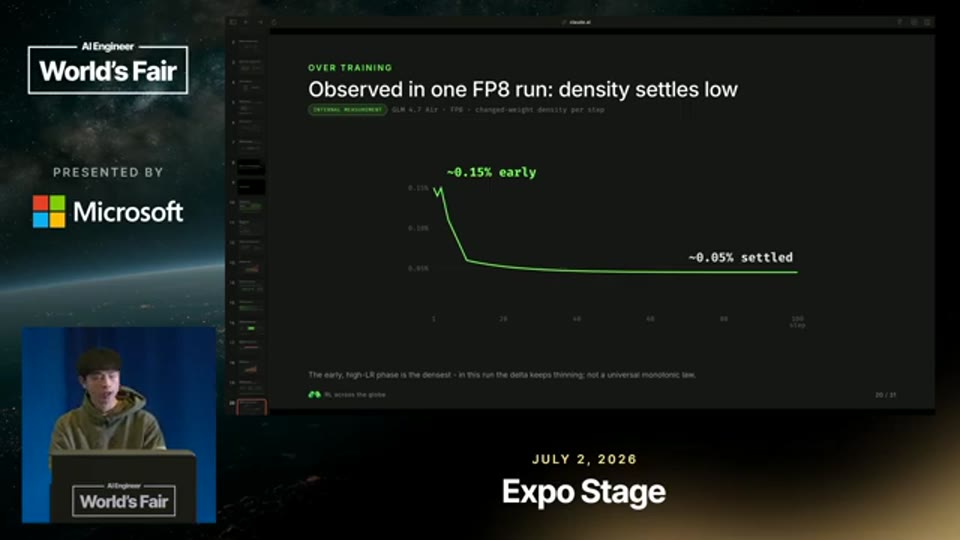
14:38 - FP8 serving 내부 run에서 step당 weight change가 0.05% 수준으로 안정화되는 curve를 설명하는 장면
Cross-Globe RL을 위한 Version-Aware Rollout Architecture
Sparse patch가 가능해지면 architecture는 trainer cluster와 global rollout fleet으로 분리된다. Trainer는 RDMA cluster 안에서 optimizer step을 수행한 뒤, immutable rollout weight version을 shared bulletin board에 publish한다. Rollout engine은 training cluster 밖의 다른 region이나 provider에서 실행될 수 있으며, 필요한 version을 pull해 local checkpoint layout으로 materialize한 뒤 serving을 수행한다.
이 구조에서 request는 단순히 completion을 요청하지 않는다. Request는 어떤 policy version으로 요청을 보내는지, 어떤 version까지 accept할 수 있는지를 함께 명시한다. Response 역시 version과 함께 token, logprob, router replay information, 기타 metadata를 반환한다. 따라서 trainer 입장에서는 rollout engine이 같은 cluster 안에 있든 다른 region에 있든, versioned trajectory와 metadata라는 동일한 contract로 결과를 받을 수 있다.
Sidecar는 일반적인 rollout engine을 version-aware하게 만드는 핵심 구성요소로 제시된다. Engine이 이미 acceptable committed version에 있다면 sidecar는 request를 proxy한다. Engine이 뒤처져 있지만 patch를 적용해 따라잡을 수 있다면 missing transition을 적용한다. 반대로 따라잡을 수 없다면 not ready를 반환한다. 이 단순한 상태 전이는 elastic rollout fleet에서 straggler나 stale worker를 다루는 기반이 된다.
Stitch는 이 Protocol의 Concrete Implementation이다
강연 후반부에서 Nan Jiang은 Modal이 구현한 Stitch를 소개한다. Stitch는 앞서 설명한 일반 protocol을 구체화한 implementation으로, trainer side에서는 rollout weight version을 정의하는 artifact를 publish하고, rollout side에서는 최신 weight를 pull해 여러 region과 provider에서 weight sync를 수행한다. Transcript상 “bullet board”로 들리는 구성요소는 shared bulletin board 또는 version registry에 가까운 역할로 이해할 수 있다.
04:48 - trainer side, contract side, rollout side가 version artifact와 trajectory를 주고받는 구조를 설명하는 장면
Stitch의 중요한 특징은 trainer, engine, transport에 대해 framework-agnostic하다는 점이다. Hugging Face safetensors format처럼 널리 받아들여지는 checkpoint layout을 활용하면, SGLang, vLLM 등 다양한 rollout engine backend와 compatibility를 맞추기 쉬워진다. Attention backend, MoE backend, tensor parallelism 또는 pipeline parallelism, serving dtype, GPU type이 달라도 artifact가 version을 정의하고 engine은 그것을 어떻게 load하고 shard할지만 결정한다.
이 architecture의 결과는 scattered inference capacity가 하나의 elastic rollout fleet으로 바뀐다는 것이다. 기존에는 rollout capacity가 trainer cluster의 크기와 availability에 묶였지만, 이제는 전 세계에 흩어진 inference GPU를 RL rollout capacity로 흡수할 수 있다. 강연자는 이를 통해 inference capacity가 곧 RL capacity가 될 수 있다고 정리한다. 이는 GPU 공급이 점점 더 fragmented되고 region별 availability가 달라지는 현실에서 매우 실용적인 시스템 방향이다.
남아 있는 질문들: Muon, Fully Async RL, Pretraining
강연은 이 접근이 완성된 정답이라기보다 열려 있는 research agenda를 포함한다고 마무리된다. 첫 번째 질문은 Adam이 아닌 optimizer에서도 sparsity가 유지되는가이다. 강연자는 Moonshot, DeepSeek 계열 모델 provider들이 post-training에서 Muon optimizer를 채택하고 있다고 언급하며, 앞선 push-versus-floor 논리가 Adam에 초점을 맞추고 있기 때문에 Muon에서도 같은 served weight stillness가 나타나는지 검증해야 한다고 말한다.
두 번째 질문은 fully async RL의 scale이다. Rollout을 전 세계 GPU로 확장할 수 있게 되면, 이제 문제는 capacity 자체보다 staleness와 async policy update가 학습 안정성에 미치는 영향으로 이동한다. Version-aware request와 response contract는 이 문제를 다룰 수 있는 시스템 기반을 제공하지만, 얼마나 오래된 rollout을 허용할 수 있는지, 어떤 staleness policy가 reward learning에 안전한지, throughput과 convergence 사이의 균형을 어떻게 잡을지는 여전히 열려 있다.
세 번째 질문은 이 paradigm이 RL post-training을 넘어 pretraining, mid-training, SFT(Supervised Fine-Tuning)에도 일반화될 수 있는가이다. Pretraining은 communication pattern과 data parallel synchronization 요구가 다르기 때문에 rollout처럼 쉽게 분리되지는 않을 수 있다. 그럼에도 “어떤 compute는 cathedral에 남아야 하고, 어떤 compute는 sprawl로 나갈 수 있는가”라는 질문은 대규모 AI infrastructure 설계 전반에 적용될 수 있다.
마무리 / 핵심 정리
이 강연의 가장 중요한 통찰은 RL post-training을 하나의 monolithic cluster job으로 보지 말고, tightly coupled training과 loosely coupled rollout serving으로 분리해 보자는 것이다. Trainer는 RDMA cluster 안에 남아 collective와 backpropagation을 수행해야 하지만, rollout은 policy version을 받아 trajectory와 metadata를 반환하는 serving island로 재정의될 수 있다. 이 재정의가 가능해지는 결정적 이유는 full checkpoint를 매번 보내지 않아도, rollout-visible weights의 sparse patch만으로 exact served version을 bitwise reconstruction할 수 있다는 관찰이다.
결국 bottleneck은 GPU가 부족하다는 일반론이 아니라, “같은 region에 있고, 빠른 fabric으로 연결되어 있으며, 지금 당장 사용 가능한 GPU”를 동시에 요구하는 compute shape에 있다. Sparse version patch와 version-aware sidecar를 이용하면 trainer cluster의 hard constraint를 rollout fleet 전체에 강제하지 않아도 된다. 이 관점에서 Stitch는 단순한 weight sync tool이 아니라, fragmented inference capacity를 RL post-training capacity로 바꾸는 infrastructure layer로 볼 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Taking Reinforcement Learning Cross Datacenter — Nan Jiang, Modal |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-08-11 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.