Task Fidelity Scaling Laws — 태스크 품질이 AI 학습을 결정한다
📺 원본 영상: Task Fidelity Scaling Laws — Kobie Crawford, Snorkel 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-03 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 Snorkel AI의 Developer Advocate인 Kobie Crawford가 에이전틱(Agentic) AI 학습 환경에서 태스크 품질(Task Quality)이 강화학습(Reinforcement Learning, RL) 훈련 성과에 미치는 영향을 실증적으로 분석한 연구를 발표한 자리다. 핵심 메시지는 단순하지만 강력하다. 데이터 품질이 높아야 모델 성능이 높아진다는 오랜 직관을 단순한 신념이 아니라 측정 가능한 수치로 증명했다는 점에서 이 연구는 눈여겨볼 가치가 있다. 특히 고품질 태스크로 훈련했을 때 저품질 대비 5배 높은 성능 향상을 기록했다는 실험 결과는, 에이전틱 AI 시대에 데이터 큐레이션이 단순한 부가 작업이 아닌 핵심 경쟁력임을 시사한다.
Snorkel AI — 데이터로부터 시작된 회사
Snorkel AI는 스탠퍼드 대학교(Stanford University) AI 연구실에 그 뿌리를 두고 있다. 현 CEO의 박사 학위 논문에서 출발한 프로젝트가 오픈소스 라이브러리로 공개되었고, 이를 기반으로 2019년에 정식 회사로 설립되었다. Crawford에 따르면, Snorkel이 처음 설립된 이래로 일관되게 유지해온 핵심 가치는 데이터 품질(Data Quality)이 AI 성능의 근본이라는 명제다. 모델 아키텍처나 학습 방법론이 얼마나 발전하더라도, 그 기저에는 항상 고품질 데이터가 있어야 한다는 것이 Snorkel의 오랜 신념이자 회사의 존재 이유다.
회사의 자체 소개로는 “프런티어 AI 데이터 랩(Frontier AI Data Lab)“이며, 파운데이션 모델(Foundation Model) 학습에 사용될 데이터셋을 생산하는 것이 주요 사업 영역이다. 연구팀이 실제 프로덕션 작업과 긴밀하게 통합되어 있다는 점도 특징적이다. 이는 연구가 현장과 동떨어진 추상적 실험으로 끝나지 않고, 실제 고객에게 전달되는 데이터셋의 품질 개선으로 이어진다는 것을 의미한다.
왜 지금 태스크 품질인가 — 에이전틱 AI로의 전환
AI의 활용 방식이 단순 응답 생성을 넘어 에이전틱(Agentic) 작업, 즉 여러 단계로 구성된 복잡한 문제를 자율적으로 해결하는 방향으로 진화하면서, 학습 데이터의 성격도 근본적으로 달라졌다. 에이전틱 작업에서는 모델이 외부 도구를 호출하고, 환경과 상호작용하며, 여러 단계에 걸쳐 추론을 이어가야 하기 때문에, 학습에 사용되는 태스크 그 자체의 설계 품질이 곧 데이터 품질을 결정한다.
Crawford는 이 연구가 다루는 범위를 명확히 한정한다. 이 연구에서 다루는 것은 컨테이너화된 환경(Containerized Environment)에서 실행되는 에이전틱 터미널 벤치(TerminalBench) 스타일의 태스크다. 모델이 실제로 코드를 실행하고, 파일 시스템과 상호작용하며, 명령어를 통해 목표를 달성하는 형태의 평가 및 훈련 환경을 전제로 한다. 이러한 환경에서 태스크의 품질이 낮다면 — 즉 태스크 정의가 모호하거나, 평가 로직에 결함이 있거나, 환경 자체가 불안정하다면 — 모델이 아무리 잘 학습하려고 해도 의미 있는 신호를 얻을 수 없다는 것이 연구의 출발점이다.
태스크 품질의 네 가지 기준
Snorkel의 연구팀은 에이전틱 태스크의 품질을 정의하는 네 가지 핵심 기준을 제시한다. 각 기준은 독립적이지 않으며, 하나라도 충족되지 않으면 전체 태스크의 가치가 훼손된다.
첫 번째는 **달성 가능성(Achievability)**이다. 태스크가 원칙적으로 해결 가능해야 한다는 뜻으로, 어떤 모델도 이론적으로 완료할 수 없는 태스크는 학습에 의미 있는 신호를 제공하지 못한다. 두 번째는 **비자명성(Non-triviality)**이다. 태스크가 너무 쉬워서 모델이 아무 추론 없이 통과할 수 있다면, 그 태스크는 모델 개선에 기여하지 않는다. 세 번째는 **기능적 정확성(Functional Correctness)**이다. 태스크의 평가 로직, 즉 정답을 판별하는 테스트 코드가 실제로 의도한 대로 동작해야 한다는 기준이다. 마지막 네 번째는 **환경 신뢰성(Environment Reliability)**이다. 태스크가 실행되는 컨테이너 환경이 안정적이고 재현 가능해야 하며, 환경 불안정으로 인해 무작위적인 실패가 발생해서는 안 된다.
Snorkel의 연구 팀은 이 네 가지 기준을 검증하는 테스트를 구축하고, 모든 기준을 통과한 태스크는 “승인(Accepted)” 버킷에, 그렇지 못한 태스크는 “거부(Rejected)” 버킷에 분류한다. 이 두 버킷이 이후 실험에서 “고품질 태스크”와 “저품질 태스크”를 구분하는 기준이 된다.
품질 기준이 실제로 의미 있는가 — 1차 검증 실험
네 가지 기준을 통해 태스크를 분류하는 것이 단순히 팀 내부적인 규칙에 불과한지, 아니면 실제 모델 거동에서도 의미 있는 차이를 만들어내는지를 먼저 검증해야 했다. 이를 위해 연구팀은 Claude Sonnet(Sonnet 4.5 계열)과 OpenAI Codex([GPT 계열 모델 세부 버전 불명확, 원본 영상 참조])를 사용해 승인된 태스크와 거부된 태스크에 대한 완료 거동을 비교 분석했다.
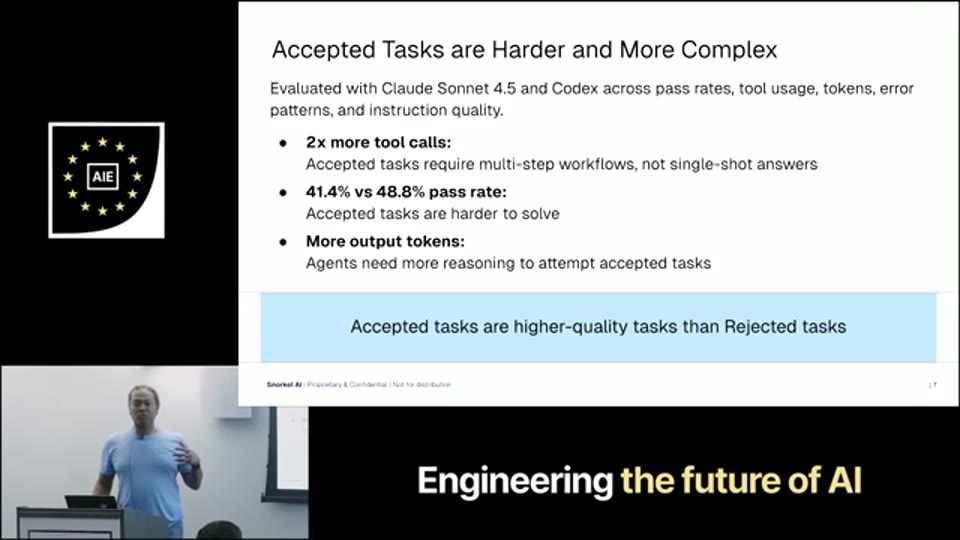
05:17 - 승인된 태스크와 거부된 태스크 간의 성능 비교 지표(도구 호출 수, 통과율, 출력 토큰 수) 슬라이드
결과는 직관과 일치했다. 승인된 태스크는 거부된 태스크에 비해 평균적으로 **두 배 더 많은 도구 호출(Tool Call)**을 발생시켰다. 이는 승인된 태스크가 더 많은 단계와 외부 도구 활용을 필요로 한다는 것, 즉 본질적으로 더 어렵고 더 풍부한 추론을 요구한다는 것을 의미한다. 더불어 모델의 응답 토큰 수도 더 많았는데, 이는 모델이 더 깊은 추론 과정을 거쳤음을 시사한다. 반면 통과율(Pass Rate)은 더 낮았다. 언뜻 보면 부정적인 신호처럼 보이지만, 이는 사실 학습 데이터로서의 가치를 높이는 속성이다. 너무 쉬운 태스크는 모델이 이미 할 수 있는 것을 확인할 뿐, 새로운 능력을 키우지 못한다. 적절한 난이도의 태스크야말로 모델이 “힐 클라이밍(Hill Climbing)“할 여지를 제공한다.
실패 유형 분석 — 어떻게 실패하느냐가 품질을 결정한다
낮은 통과율 자체보다 더 중요한 것은 “왜 실패하는가”다. 모든 실패가 동등하게 의미 있는 것은 아니기 때문이다. 연구팀은 실패를 유형별로 분류하여 승인된 태스크와 거부된 태스크에서 각 실패 유형의 비율이 어떻게 다른지 비교했다.
Crawford가 특히 강조하는 것은 **로직 오류(Logic Error)**와 태스크 미완료(Incomplete Task) 유형이다. 이 두 범주에서 승인된 태스크와 거부된 태스크 간의 비율이 역전되는 현상이 나타났다. 승인된 태스크에서는 로직 오류와 미완료가 더 높은 비중을 차지하는 반면, 거부된 태스크에서는 “환경 문제(Environmental Issue)” — 어떤 모델도 완료할 수 없는 환경적 결함에서 비롯된 실패 — 의 비중이 더 높았다.
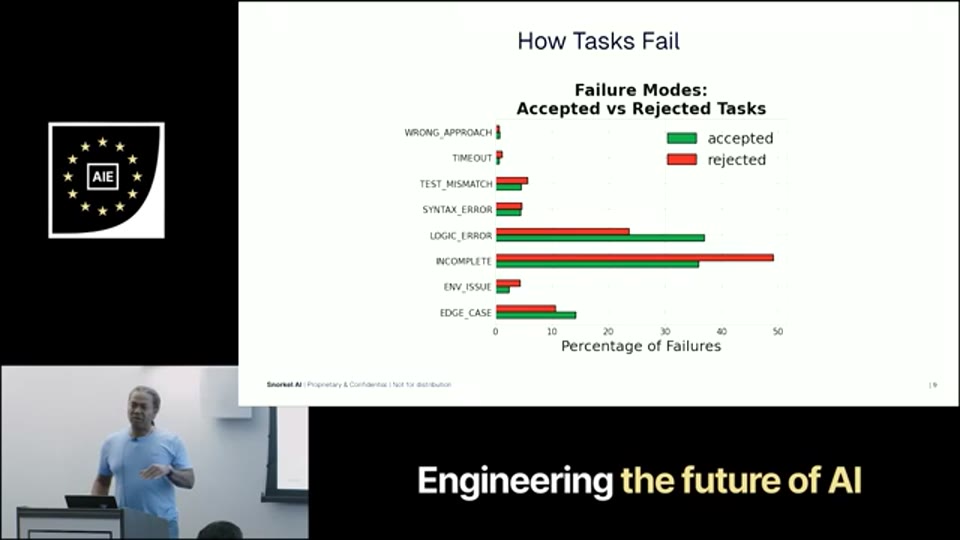
07:17 - 실패 유형별(로직 오류, 태스크 미완료, 환경 문제 등) 비율을 승인/거부 태스크 간 비교한 바 차트
이 구분이 중요한 이유는 명확하다. 로직 오류나 태스크 미완료는 모델 능력의 한계를 드러내는 실패다. 즉 모델이 아직 할 수 없는 것을 보여주기 때문에, 바로 그 지점에서 학습을 통해 개선될 여지가 있다. 반면 환경 문제로 인한 실패는 태스크 정의 자체의 결함에서 비롯되므로, 어떤 모델이 주어지더라도 해결할 수 없다. 이런 실패 데이터로 훈련하는 것은 의미 없는 신호로 모델을 혼란시키는 것에 가깝다. Crawford는 이 차이를 “승인된 태스크는 더 깨끗한 실패(Cleaner Failures)를 생산한다”는 표현으로 요약한다.
RL 학습 실험 — 5배의 성능 차이
태스크 품질 기준이 유효하다는 1차 분석을 마친 뒤, 연구팀은 한 걸음 더 나아가 동일한 조건에서 고품질 태스크와 저품질 태스크로 각각 RL 훈련을 수행하고 그 결과를 비교했다. 비교의 공정성을 위해 사용한 모델, 컴퓨팅 예산(Compute Budget), 태스크 수를 모두 동일하게 통제했다. 바뀐 단 하나의 변수는 태스크의 품질이었다.
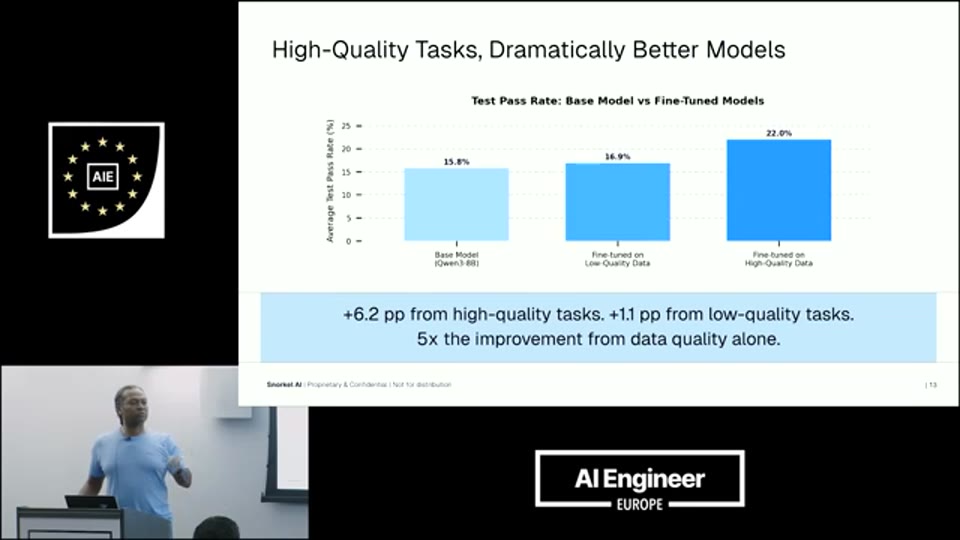
09:49 - 고품질 태스크(~6% 향상) vs 저품질 태스크(~1% 향상)의 RL 훈련 결과 성능 비교 그래프
결과는 놀라웠다. 저품질(거부된) 태스크로 훈련된 모델은 베이스라인 대비 약 1% 성능 향상에 그쳤다. 같은 컴퓨팅 자원을 투입했음에도 의미 있는 개선이 거의 일어나지 않은 것이다. 반면 고품질(승인된) 태스크로 훈련된 모델은 약 6% 성능 향상을 달성했다. 결과적으로 태스크 품질 차이만으로 5배(5x)의 성능 향상 격차가 발생했다. Crawford는 이 수치가 “데이터 품질이 높아야 한다는 직관을 확실히 못 박아주는(Cements the intuition)” 결과라고 강조했다.
이 결과의 함의는 모델 학습 방법론을 고민하는 모든 팀에게 중요하다. 더 많은 컴퓨팅 자원을 투입하거나, 더 큰 모델을 사용하기 이전에, 학습 데이터가 되는 태스크 자체의 품질을 점검하는 것이 선행되어야 한다는 것이다. 잘못 정의된 태스크 1,000개는 잘 정의된 태스크 200개보다 훈련 효율 측면에서 열등할 수 있다.
Snorkel의 데이터 생성 철학 — 전문가와 LLM의 협업
이처럼 고품질 태스크를 안정적으로 공급하기 위해 Snorkel은 전문가 인루프(Expert-in-the-Loop) 방식을 채택하고 있다. 단순히 LLM이 자동으로 데이터를 생성하거나 주석을 다는 방식에서 멈추지 않고, 도메인 전문가가 직접 개입하여 데이터의 품질을 검증하고 보정하는 과정을 설계에 포함시킨다.
이때 Snorkel의 플랫폼은 전문가의 작업 효율을 높이는 도구로 기능한다. LLM 저지(LLM-as-Judge)를 활용해 전문가의 판단을 보조하거나 확장하되, 최종적인 품질 기준은 인간 전문가의 판단에 의해 정립된다. 구체적으로는 루브릭(Rubric) 기반의 평가 체계를 구축하는데, 단순한 이진(Pass/Fail) 판단보다 더 세밀한 기준 목록을 만들어 인간 주석자와 LLM 저지 양측이 동일한 기준으로 평가할 수 있도록 한다. 이 과정에서 주석자 간 동의율(Inter-Annotator Agreement, IAA)을 주기적으로 측정하여, 인간끼리의 합의 수준뿐만 아니라 LLM 저지와 인간 간의 합의 수준도 지속적으로 추적하고 관리한다.
Q&A — 현장의 날카로운 질문들
강연 이후의 질의응답 시간은 연구의 빈틈을 메우는 유용한 맥락을 제공한다.
거부된 태스크가 훈련 세트에 포함될 경우 그 영향은? 한 청중은 거부된 태스크를 아예 포함하지 않는 것과 승인/거부 태스크를 함께 사용하는 경우를 비교해봤는지 물었다. Crawford는 이번 연구에서 그 실험을 직접 수행하지는 않았다고 솔직히 인정하면서, SWE-bench([STT 원본에서는 “sweep bench”로 기록됨])와 TerminalBench 등 공개 벤치마크를 분석한 경험을 공유했다. 품질이 낮은 태스크가 훈련 세트에 혼재할 경우, 특정 태스크들은 어떤 모델도 완료하지 못하는 “결코 해결되지 않는 태스크”로 남게 되고, 이것이 모델 성능 측정의 노이즈(Noise) 원인이 된다는 것이다. 즉, 모델이 실제로 개선되었는지를 파악하는 것 자체가 저품질 태스크의 존재로 인해 흐려진다.
미명세(Underspecified) 태스크의 문제. 또 다른 질문은 거부된 태스크들의 일반적인 특성에 관한 것이었다. Crawford에 따르면, 거부되는 태스크의 가장 흔한 유형은 태스크 정의와 평가 로직 간의 불일치다. 예를 들어 태스크 정의에서는 특정 동작을 명시적으로 요청하지 않았는데, 백엔드의 테스트 코드는 그 동작이 수행되었는지를 확인하는 경우다. 모델은 요청받지 않은 것을 수행할 이유가 없으므로 테스트에 실패하지만, 이것은 모델의 능력 한계가 아니라 태스크 설계의 결함이다. 암묵적인 의존성(Implicit Dependency)이 태스크 정의에는 기술되지 않고 테스트 코드에만 숨어 있는 경우도 마찬가지다.
검증 가능성을 넘어선 미래 과제. 코딩이나 수학 문제처럼 정답이 명확히 검증 가능한 영역을 벗어나, 더 불명확하고 장기적인 작업으로 연구를 확장할 계획이 있는지에 대한 질문도 있었다. Crawford는 Snorkel이 이미 그러한 방향을 탐색 중이라고 밝혔다. 오픈 벤치마크 그랜트 프로그램(Open Benchmark Grants Program)을 통해 검증이 어려운 영역의 평가 방법을 연구하는 파트너 조직들을 지원하고 있으며, 그 중에는 감정적 반응이나 인간 중심적 사고를 평가하는 벤치마크를 개발하는 팀도 있다고 언급했다. 이 경우에는 단순한 이진 정답 판별이 아니라, 다양한 정답이 스펙트럼 위에 놓이고 각각에 서로 다른 점수가 부여되는 방식을 탐색 중이라고 했다.
마무리 — 데이터 품질이 최우선이다
이 연구는 AI 개발 커뮤니티에서 오랫동안 당연한 것으로 여겨졌지만 정작 수치로 증명되지 않았던 명제 하나를 검증한다. 태스크(데이터)의 품질이 높을수록 모델 훈련의 결과가 좋아진다는 것이다. 특히 에이전틱 AI의 부상과 함께 RL 훈련 환경이 복잡해지고, 태스크 정의 자체가 데이터의 성격을 결정하는 지금의 맥락에서, 이 연구가 제시하는 네 가지 품질 기준 — 달성 가능성, 비자명성, 기능적 정확성, 환경 신뢰성 — 은 에이전틱 학습 환경을 설계하는 모든 팀이 체크리스트로 삼을 만한 기준이다.
5배의 성능 차이라는 결과가 주는 메시지는 명확하다. 컴퓨팅 예산을 늘리거나, 더 큰 모델을 구하거나, 더 정교한 학습 알고리즘을 도입하기에 앞서, 지금 사용하는 훈련 태스크가 과연 고품질 기준을 충족하는지를 먼저 점검하는 것이 더 높은 투자 대비 효용(ROI)을 가져올 수 있다. Snorkel이 강조하는 “품질 우선(Quality First)” 원칙은, 에이전틱 AI 시대에도 변하지 않는 데이터 중심 AI(Data-Centric AI)의 본질을 다시 한번 상기시킨다.
11:22 - Snorkel 연구 페이지 및 에이전틱 코딩 리더보드 링크가 표시된 마무리 슬라이드
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Task Fidelity Scaling Laws — Kobie Crawford, Snorkel |
| 채널 | AI Engineer |
| 강연자 | Kobie Crawford (Developer Advocate, Snorkel AI) |
| 리포트 작성 | 2026-06-03 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
수정 내역 요약:
- STT 오인식 교정:
"힘 클라이밍(Hill Climbing)"→"힐 클라이밍(Hill Climbing)"— ‘힘(力)‘이 아닌 ‘힐(hill)‘의 음역 오인식 - 스크린샷 삽입 3건: 기존
💡 [영상 참조]플레이스홀더를 실제 이미지+타임스탬프 링크로 교체- [05:17] (317s) — 성능 비교 지표 슬라이드 → “1차 검증 실험” 단락 직후
- [07:17] (437s) — 실패 유형 바 차트 → “실패 유형 분석” 단락 직후
- [09:49] (589s) — RL 훈련 결과 비교 그래프 → “RL 학습 실험” 단락 직후
- 스크린샷 삽입 1건: [11:22] (682s) — 마무리 슬라이드 → “마무리” 섹션 말미에 신규 삽입