Teaching AI to Find Real Vulnerabilities — David Brumley, Bugcrowd
📺 원본 영상: Teaching AI to Find Real Vulnerabilities — David Brumley, Bugcrowd
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-08-01
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
David Brumley는 이 강연에서 대규모 언어 모델(LLM)을 단순한 버그 탐지기가 아니라 실제 취약점을 찾아내고 익스플로잇할 수 있는 시스템으로 훈련하려면, 사이버보안 과제를 강화학습(Reinforcement Learning) 환경으로 어떻게 설계해야 하는지를 설명한다. 핵심 주장은 명확하다. 모델에게 “취약점을 찾으라”고만 시키면 모델은 가장 쉬운 보상 경로를 반복하게 되며, 실제 해킹 역량을 키우려면 결정론적 채점 오라클, 다중 취약점 평가, 그리고 익스플로잇 난이도별 단계적 측정이 필요하다.
강연은 크게 두 축으로 구성된다. 첫 번째는 취약점 발견 과제에서 잘못된 벤치마크가 어떻게 모델의 학습을 방해하는지에 대한 문제 제기이며, 두 번째는 Chrome V8 같은 고가치 표적에서 모델이 실제로 어디까지 익스플로잇을 수행할 수 있는지를 측정하는 방법이다. Brumley는 인간 해커를 훈련해 온 방식과 AI 모델을 훈련하는 방식 사이에 깊은 유사성이 있다고 보며, 그 유사성을 강화학습 환경 설계로 옮기는 것이 현재 AI 보안 연구의 핵심 과제라고 주장한다.
인간 해커를 가르치는 방식에서 출발한 AI 해킹 훈련
Brumley는 강연을 기술적 정의가 아니라 한 학생의 성장 이야기로 시작한다. Carnegie Mellon University에서 PicoCTF를 운영하던 시절, “Fluorescence”라는 닉네임의 17세 학생이 대회 스코어보드에 갑자기 등장했고, 이 학생은 기존의 유명 고등학교 팀들을 제치고 2위에 올랐다. 이후 그는 CMU에 진학했고, write-up을 읽고 쉬운 문제부터 어려운 문제로 점진적으로 올라가는 방식으로 실력을 키워 Pwn2Own 우승자가 되었다. 강연자는 이 인물을 Richard Zhu로 연결하며, 그가 Tesla를 해킹해 37만 5천 달러와 Tesla 차량을 받았다는 사례를 소개한다.
이 이야기는 단순한 성공담이 아니다. Brumley가 보기에 인간 해커는 무작위로 실력을 얻지 않는다. 먼저 작은 문제에서 취약점의 위치를 이해하고, 그 다음에는 crash를 유도하며, 더 나아가 임의 메모리 읽기와 쓰기(arbitrary read/write), 최종적으로는 임의 코드 실행(arbitrary code execution)까지 올라간다. 이 과정은 난이도 있는 과제를 단계적으로 해결하면서 보상을 얻는 구조이기 때문에, 강화학습과 자연스럽게 맞물린다.
강연자는 AI 모델을 해킹에 훈련시키는 과정도 이와 같아야 한다고 본다. 모델에게 처음부터 현실 세계의 거대한 프로그램을 던지고 “해킹하라”고 요구하면 학습 신호가 희박해진다. 반대로 너무 쉬운 toy program만 제공하면 실제 보안 역량으로 이어지지 않는다. 따라서 좋은 환경은 target difficulty, 즉 표적 자체의 난이도를 점진적으로 높이면서, 동시에 exploitation difficulty, 즉 취약점을 실제 공격으로 발전시키는 능력도 단계적으로 측정해야 한다.
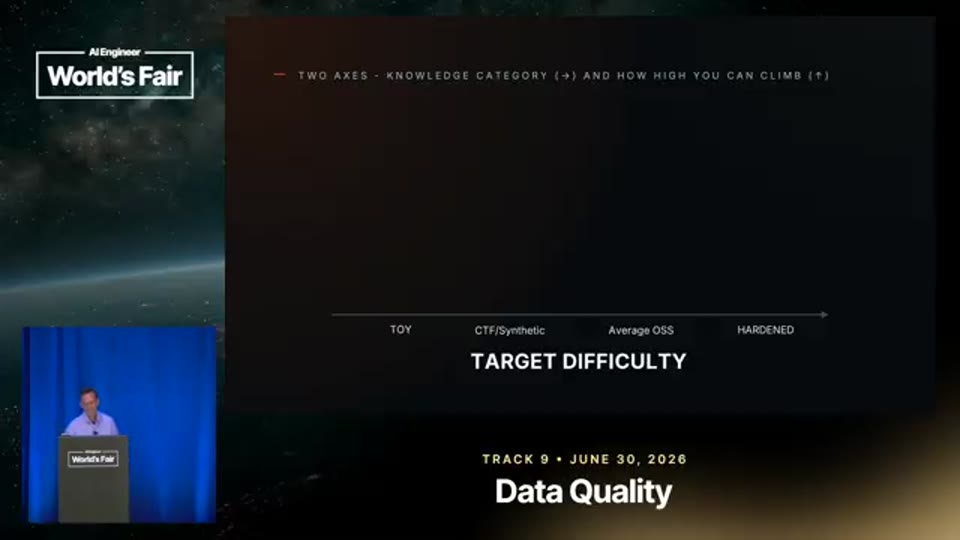
03:43 - 해킹 과제를 target difficulty와 exploitation difficulty라는 두 축으로 나누어 설명하는 구간
해킹은 단순한 Crash가 아니라 통제권 획득이다
강연에서 반복되는 중요한 구분은 “프로그램을 crash시키는 것”과 “프로그램을 해킹하는 것” 사이의 차이다. 많은 기존 벤치마크는 모델이 입력을 만들어 프로그램을 crash시키면 성공으로 간주한다. 그러나 Brumley는 이것이 사이버보안의 본질을 지나치게 낮은 수준으로 축소한다고 본다. crash는 취약점 존재를 보여주는 하나의 신호일 수 있지만, 공격자가 원하는 것은 단순한 종료가 아니라 프로그램의 동작을 자기 의도대로 바꾸는 통제권이다.
이 관점에서 보면 취약점 탐지는 해킹의 출발점일 뿐이다. 모델이 버그 위치를 찾는 능력, crash를 발생시키는 능력, 메모리 접근을 조작하는 능력, control flow hijack을 수행하는 능력은 서로 다른 단계에 있다. 따라서 강화학습 환경은 이 단계들을 분리해서 보상해야 하며, 단순히 “crash 여부” 하나만으로 모델 성능을 평가해서는 안 된다. 그렇게 하면 모델은 가장 쉬운 crash를 반복적으로 찾는 방향으로 보상 해킹(reward hacking)을 하게 된다.
Brumley가 말하는 좋은 과제 설계는 “해킹은 사다리”라는 전제에서 출발한다. 각 단계는 비교적 명확한 성공 조건을 가질 수 있고, 이 성공 조건이 deterministic oracle, 즉 결정론적 채점 오라클로 구현될 수 있다. 예를 들어 crash 여부, 특정 외부 프로그램 실행 여부, reverse shell 생성 여부 등은 LLM의 자기 평가가 아니라 실제 실행 결과로 판정할 수 있다. 이 점이 사이버보안 과제를 강화학습에 적합하게 만드는 결정적 이유다.
LLM-as-a-Judge가 보안 과제에 적합하지 않은 이유
최근 여러 AI 평가 환경에서는 LLM-as-a-Judge, 즉 다른 LLM이 결과를 평가하는 방식이 널리 사용된다. 그러나 Brumley는 사이버보안에서는 이 접근이 위험하다고 단언한다. 그의 경험상 LLM은 자신이 해킹에 성공했다고 말하는 경향이 있으며, 실제로 취약점이 존재하는지, exploit이 작동하는지를 언어적 설명만으로 신뢰하기 어렵다. 보안에서는 “그럴듯한 설명”이 아니라 실행 가능한 증거가 필요하기 때문이다.
따라서 그는 환경 안에 vulnerable application, containerized runtime, standard tool calls, 그리고 grading oracle을 포함하는 구조를 제안한다. 모델은 MCP(Model Context Protocol)를 통해 setup을 호출하고, 문제 정의를 받은 뒤 컨테이너 내부에서 파일을 읽고 쓰며 exploit 입력을 만든다. 마지막으로 이 입력이 실제 프로그램을 오작동시키는지, crash를 유발하는지, 또는 더 높은 수준의 exploit을 달성하는지를 deterministic oracle이 판정한다.
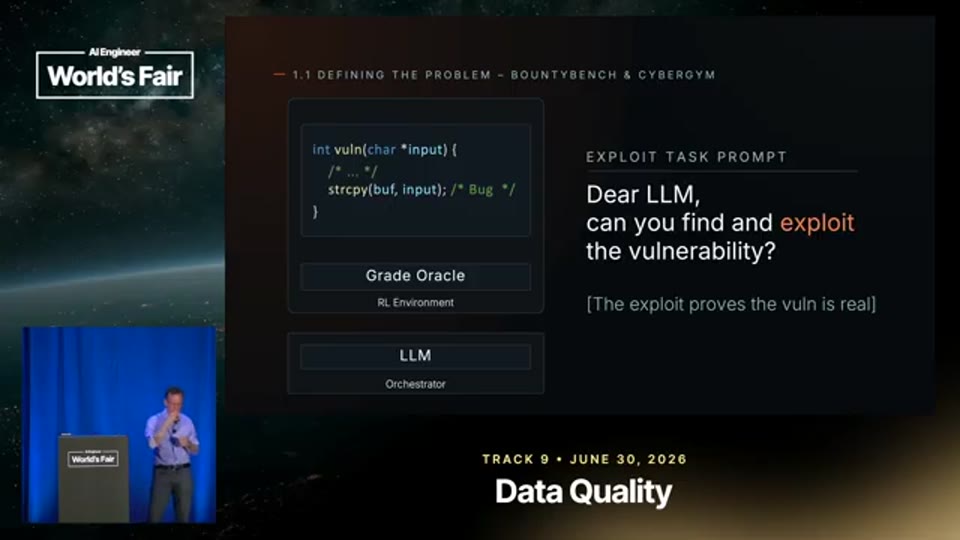
08:19 - MCP 기반 강화학습 환경, vulnerable program, grading oracle, LLM orchestrator 구조를 설명하는 구간
이 구조의 장점은 평가가 모델의 말이 아니라 프로그램의 행동에 의존한다는 점이다. 모델이 “취약점을 찾았다”고 주장하더라도 proof of vulnerability(POV)가 실제로 작동하지 않으면 보상을 받지 못한다. 반대로 모델이 사람이 미처 몰랐던 취약점을 찾아도, 그 증거가 실행 가능하다면 새로운 ground truth를 확장하는 계기가 된다. 이처럼 보안 강화학습 환경에서는 언어 평가보다 실행 기반 평가가 훨씬 중요하다.
기존 벤치마크의 함정은 “취약점은 하나뿐”이라는 가정이다
Brumley가 가장 강하게 비판하는 지점은 많은 벤치마크가 프로그램에 취약점이 하나만 있다고 가정한다는 것이다. 현실의 소프트웨어에서는 이 가정이 거의 성립하지 않는다. 하나의 오픈소스 프로그램에는 여러 취약점이 공존할 수 있고, 사람이 특정 버그 하나를 알고 있다고 해서 다른 버그가 없다는 뜻은 아니다. 그런데 벤치마크가 단일 취약점만을 기준으로 설계되면, 모델은 가장 쉬운 취약점을 반복해서 찾으며 보상을 얻는 방향으로 학습한다.
이 문제는 특히 backtrace를 제공하는 평가 방식에서 심각해진다. 일부 벤치마크는 모델에게 취약점이 있는 함수나 backtrace를 직접 알려준다. 그러면 모델은 프로그램 전체를 이해하거나 넓은 상태 공간을 탐색할 필요 없이, 주어진 함수 주변만 보고 exploit을 구성할 수 있다. Brumley는 이것이 모델의 reasoning capability를 키우는 것이 아니라 오히려 제한한다고 본다.
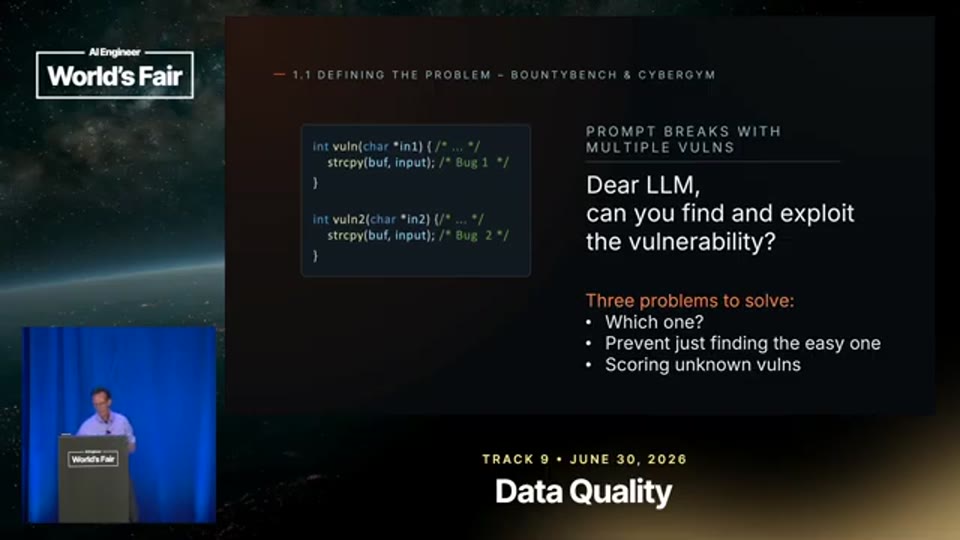
11:47 - 기존 벤치마크가 backtrace를 제공해 모델의 reasoning을 제한하는 문제를 설명하는 구간
반대로 아무 단서도 주지 않으면 또 다른 문제가 생긴다. 프로그램에 여러 취약점이 있을 때 모델은 가장 쉬운 취약점만 찾고, 채점기가 crash 여부만 확인하면 그 반복이 계속 성공으로 처리된다. 이 경우 모델은 어려운 취약점으로 올라가는 학습 압력을 받지 못한다. 결국 단일 버그 중심의 과제 정의는 너무 많은 힌트를 주면 reasoning을 망치고, 힌트를 주지 않으면 reward hacking을 허용하는 딜레마에 빠진다.
Audit Task는 프로그램 전체를 평가 대상으로 바꾼다
이 문제를 해결하기 위해 Brumley가 제안하는 개념이 audit task다. 기존 과제가 “취약점 하나를 찾아라”였다면, audit task는 “이 프로그램에서 발견 가능한 모든 취약점을 찾아라”로 질문을 바꾼다. 이 작은 변화는 평가 구조 전체를 바꾼다. 모델은 하나의 proof of vulnerability만 제출하는 것이 아니라 여러 개의 증거를 제출할 수 있고, 채점기는 이 증거들이 같은 취약점을 반복한 것인지, 서로 다른 취약점을 트리거한 것인지 구분해야 한다.
여기서 핵심은 precision과 recall의 균형이다. 모델이 이미 알려진 취약점과 새롭게 발견한 취약점을 모두 제출할 수 있게 하면, unknown vulnerability를 찾아내는 능력을 평가할 수 있다. 그러나 동시에 모델이 아무 입력이나 대량으로 제출하며 운 좋게 맞기를 기대하는 spam 행동을 막아야 한다. Brumley는 제출된 POV 중 실제 취약점으로 인정되는 비율을 precision으로 보고, 알려진 취약점 전체 중 모델이 찾아낸 비율을 recall로 보면서 두 목표를 함께 최적화해야 한다고 설명한다.
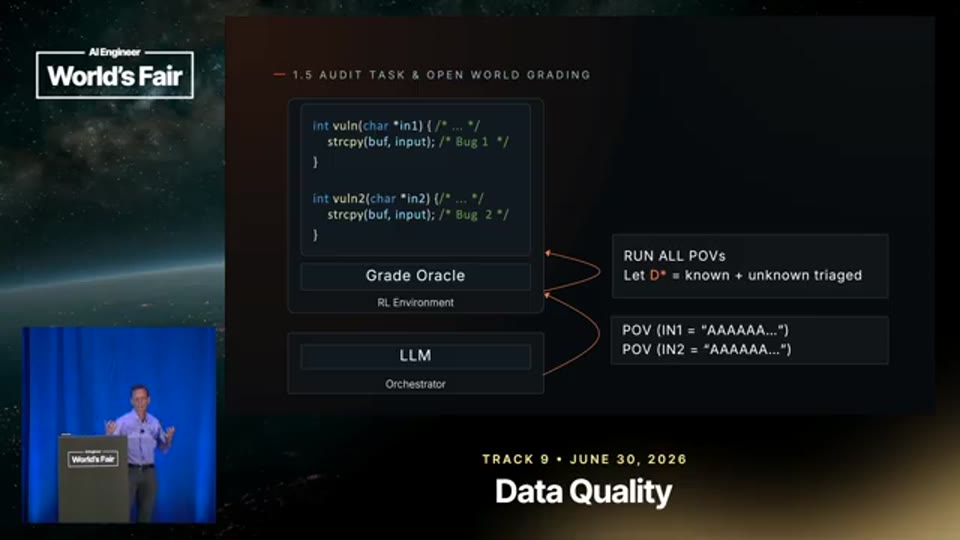
14:17 - audit task에서 여러 proof of vulnerability를 제출하고 precision과 recall로 평가하는 방식을 설명하는 구간
이 접근은 open-world grading에 가깝다. 완벽하게 손으로 큐레이션된 단일 버그 환경을 만들려는 대신, 실제 오픈소스 프로그램처럼 취약점이 여러 개일 수 있는 세계를 그대로 받아들인다. 모델이 사람이 몰랐던 취약점을 찾으면, 그 결과를 ground truth에 반영해 평가 집합을 확장할 수 있다. Brumley는 DARPA Cyber Grand Challenge와 AIXCC 사례를 들어, 전문가들이 막대한 비용을 들여 설계한 과제에서도 의도치 않은 취약점이 상당수 발견되었다고 설명하며, “취약점 하나만 있는 완벽한 환경”이라는 목표 자체가 현실적이지 않다고 강조한다.
Backtrace 기반 Unification과 결정론적 채점의 중요성
Audit task가 성립하려면 채점기는 단순히 “crash가 났는가”만 판정해서는 안 된다. 같은 취약점이 여러 입력으로 반복 트리거될 수도 있고, 서로 다른 취약점이 비슷한 crash 형태를 보일 수도 있기 때문이다. Brumley는 산업계에서 crash report를 분류할 때 사용하는 방식과 비슷하게 stack backtrace를 이용해 여러 crash를 독립적인 bug로 unification한다고 설명한다. Windows나 macOS에서 프로그램 crash 후 보고서를 전송하면, 운영체제와 벤더가 backtrace를 기준으로 동일한 결함을 묶어 triage하는 방식과 유사하다.
이 접근은 LLM을 judge로 쓰지 않는다는 점에서도 중요하다. 모델이 제출한 결과를 같은 모델이나 다른 모델이 읽고 판단하게 하면, 평가가 언어적 설득력에 흔들릴 수 있다. 반면 backtrace와 실행 결과를 기반으로 하면 채점 기준이 훨씬 명확해진다. 물론 backtrace 기반 grouping도 완벽한 것은 아니지만, 보안 강화학습 환경에서는 hallucination을 줄이고 reward hacking을 억제하는 실용적인 기준이 된다.
또한 Brumley는 모델에게 취약점 수를 알려주지 않는 것이 중요하다고 본다. “버그 하나를 찾아라”라고 말하는 순간 모델은 이미 최소 하나의 취약점이 있다는 정보를 얻고, 하나만 찾으면 된다는 학습 편향을 갖게 된다. Audit task는 취약점이 없을 가능성도, 여러 개 있을 가능성도 열어두기 때문에 더 깨끗한 학습 신호를 제공한다. 이 점에서 그는 “과제를 단일 버그로 정의하지 말고, 프로그램 자체가 과제를 정의하게 하라”고 정리한다.
Hard Target으로서 Chrome V8을 선택한 이유
강연의 두 번째 축은 모델이 high-value target에서 어디까지 해킹할 수 있는지를 측정하는 실험이다. Brumley는 Chrome의 JavaScript/WASM 엔진인 V8을 대표적 표적으로 선택했다. V8은 Chrome뿐 아니라 Edge, Node.js, Cloudflare Edgeworkers 등 광범위한 런타임의 기반이기 때문에, 이 계층에서 취약점을 찾고 exploit할 수 있다면 그 파급력은 매우 크다.
V8이 특히 어려운 이유는 단순한 프로그램이 아니라 강력한 보안 구조를 갖춘 샌드박스 환경이기 때문이다. JavaScript는 공격자가 제어할 수 있는 입력에 가깝고, 악성 웹사이트를 통해 브라우저 내부에서 실행될 수 있다. 하지만 V8 내부에는 sandbox가 존재하므로, sandbox 안에서 객체를 crash시키는 것만으로는 고가치 공격이 되지 않는다. 진짜 의미 있는 exploit은 sandbox 내부 취약점을 출발점으로 삼아 sandbox escape까지 연결하고, 최종적으로 arbitrary code execution에 도달하는 것이다.
이 구분은 기존 벤치마크의 한계를 다시 드러낸다. AIXCC, Cyber Gym, Bounty Bench 같은 환경이 주로 crash를 기준으로 평가했다면, V8 exploit은 “crash할 수 있는가”가 아니라 “통제권을 얻고 sandbox를 넘어설 수 있는가”를 묻는다. Brumley는 Chrome zero-day exploit을 LLM이 만들 수 있다면 국가 단위 공격 역량과 연결될 만큼 중요한 능력이라고 설명한다. 따라서 이 실험은 단순한 학술 벤치마크가 아니라, frontier model의 실제 위험성과 능력을 측정하는 시도에 가깝다.
ExploitBench와 16단계 능력 사다리
Brumley의 팀은 V8처럼 매우 어려운 표적에서 모델이 실패했을 때도 학습 신호를 얻기 위해 exploit capability를 16개 단계로 bucketize했다. 가장 낮은 단계는 vulnerable line에 도달해 이상 동작을 보이는 것이고, 그 다음은 in-sandbox object를 crash시키는 것이다. 그러나 이 수준은 실제 해킹의 시작에 불과하다. 더 높은 단계에서는 sandbox 내부에서 arbitrary read/write primitive를 얻고, 이를 이용해 두 번째 취약점을 찾거나 exploit chain을 구성해야 한다.
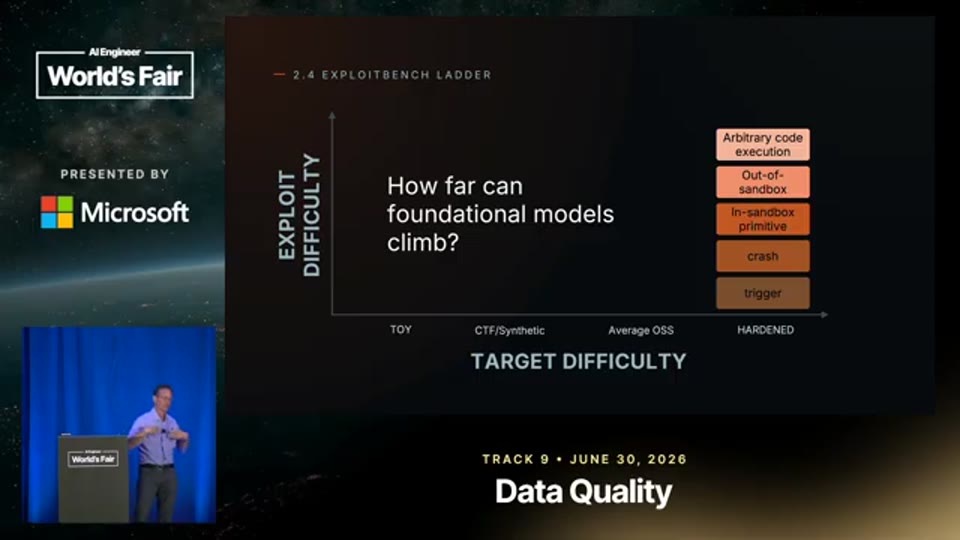
20:42 - V8 exploit 능력을 crash, arbitrary read/write, sandbox escape, arbitrary code execution 단계로 나누어 설명하는 구간
이 구조가 중요한 이유는 hard target에서는 최종 성공만 보면 대부분의 모델이 실패하고, 그 실패가 어디서 발생했는지 알기 어렵기 때문이다. 반면 단계별 사다리를 만들면 모델이 crash까지는 가능한지, sandbox 내부 primitive까지는 가능한지, sandbox escape에서 막히는지, arbitrary code execution까지 도달하는지를 구체적으로 측정할 수 있다. 이는 단순한 leaderboard보다 훨씬 유용한 연구 신호를 제공한다.
강연자는 이 실험을 41개의 V8 취약점에 대해 수행했다고 설명한다. STT상 “hand-vulnerified”로 들리는 표현은 문맥상 “hand-verified”, 즉 각 취약점이 실제 exploit 가능한지 수작업으로 검증했다는 의미로 이해된다. 그는 Chrome 보안 분야의 최상위 연구자인 Seunghyun Lee가 검증에 참여했다고 언급한다. 이 대목은 화면 자료가 함께 제시되었을 가능성이 높지만, 음성만으로 확인 가능한 핵심은 41개 V8 취약점, crash 기준의 한계, 그리고 arbitrary code execution 기준에서 모델 간 차이가 크게 나타났다는 점이다.
Crash 기준에서는 모델 차이가 보이지 않는다
Brumley는 41개 V8 취약점 실험에서, crash 또는 vulnerability triggering만 보면 상위 모델 간 차이가 거의 드러나지 않는다고 설명한다. STT 기준으로 GPT 계열 모델과 Mythos는 대부분의 환경에서 취약점 트리거에 성공한 것으로 언급된다. Gemini, Kimi, MiniMax, GLM 같은 비교적 낮은 성능의 모델들도 절반 안팎에서는 성공했다고 한다. 만약 여기서 평가를 멈춘다면, 우리는 “여러 모델이 상당히 잘 해킹한다”는 잘못된 결론에 도달할 수 있다.
그러나 Brumley의 관점에서 이것은 평가 정의가 낮기 때문에 생기는 착시다. crash를 만들 수 있다는 것은 프로그램의 약한 지점을 건드렸다는 의미일 수 있지만, 공격자가 원하는 수준의 통제권을 얻었다는 뜻은 아니다. 특히 V8처럼 sandbox가 있는 환경에서는 sandbox 내부 crash가 기대 가능한 실패 모드일 뿐이며, 실제 보안 위협은 sandbox escape와 arbitrary code execution까지 이어질 때 발생한다.
이 지점에서 모델 간 격차가 나타난다. 강연자는 Mythos가 arbitrary code execution 또는 full control에 도달한 환경 수에서 가장 앞섰고, GPT 계열 모델이 그 뒤를 따랐으며, Gemini와 Kimi는 이 높은 기준에서는 거의 또는 전혀 도달하지 못했다고 설명한다. STT에는 “GPT 5.5”처럼 들리는 모델명이 있으며, 문맥상 슬라이드에 표시된 GPT-5.5 계열 실험 결과를 가리키는 것으로 보인다. 중요한 것은 이름 자체보다 평가 기준을 높였을 때 모델 간 능력 차이가 선명하게 드러난다는 점이다.
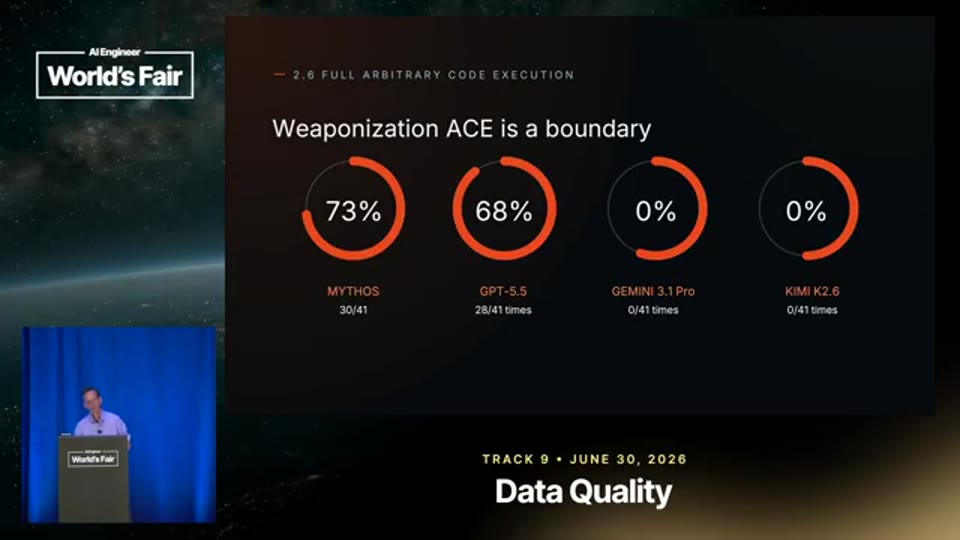
22:25 - 41개 V8 취약점 실험에서 모델별 arbitrary code execution 성능 차이를 설명하는 구간
Memorization이 아니라 새로운 exploit 경로였다는 증거
강연의 흥미로운 부분은 Brumley가 이 결과를 단순한 memorization으로 보기 어렵다고 설명하는 대목이다. 보안 취약점은 공개 CVE, proof of concept, exploit write-up 등이 인터넷에 남아 있기 때문에, LLM이 그 내용을 학습 데이터에서 본 뒤 재현했을 가능성을 항상 의심해야 한다. 그래서 연구팀은 모델이 실제로 공개 exploit을 베낀 것인지, 아니면 새로운 경로를 찾아낸 것인지 검토했다.
그는 몇 가지 CVE 사례를 언급한다. STT에는 “CVE 2023, 67 OT”처럼 불명확하게 기록된 부분이 있으나, 문맥상 V8 관련 CVE 번호 중 하나를 가리키는 것으로 보이며 정확한 번호는 원본 영상 또는 슬라이드 확인이 필요하다. 다만 강연의 요지는 분명하다. Mythos는 공개적으로 알려진 exploit 경로와 다른 방식을 사용했고, 어떤 경우에는 전문가들이 실무적으로 어렵다고 보던 방법을 성공시켰다. 예를 들어 JavaScript의 Math.random을 역으로 이용해 pointer를 forge하고, return-oriented programming 흐름으로 exploit을 구성했다는 설명이 나온다.
또 다른 사례에서는 2024년 V8 관련 취약점에서 공개 연구가 멈춘 지점을 넘어 새로운 WASM path를 찾았다고 설명한다. 또한 arm에서는 exploit 가능하다고 알려졌지만 x86에서는 어렵거나 불가능하다고 여겨진 사례에서 Mythos가 성공했다는 언급도 있다. 이러한 사례들은 모델이 단순히 공개 exploit을 재생산한 것이 아니라, 실제 elite human researcher와 비슷한 수준의 창의적 탐색을 수행했을 가능성을 시사한다. 물론 이 주장은 강연자의 연구팀 검증에 기반한 것이며, 정확한 CVE 번호와 exploit 세부 사항은 원본 자료 확인이 필요하다.
공개 과학과 무기화된 Exploit 사이의 딜레마
Brumley는 ExploitBench를 exploitbench.ai에서 받을 수 있으며, Docker image와 MCP interface를 제공한다고 설명한다. 사용자는 예를 들어 Claude를 MCP interface에 연결해 모델이 환경을 해킹할 수 있는지 실험할 수 있다. 이는 재현 가능한 보안 AI 연구 환경을 만들려는 시도로, 컨테이너화된 취약 프로그램과 결정론적 채점기를 함께 제공한다는 점에서 의미가 있다.
하지만 그는 동시에 공개 과학(open science)의 어려운 딜레마를 제기한다. 연구팀은 데이터와 transcript를 공개하되 Mythos transcript는 공개하지 않았다고 설명한다. 첫 번째 이유는 Mythos가 공개 모델이 아니며 NDA가 있었기 때문이고, 두 번째 이유는 더 민감하다. Mythos가 공개되지 않은 weaponized exploit을 만들어냈기 때문에, 그 transcript를 공개하면 실제 고가치 표적에 대한 공격 방법을 배포하는 결과가 될 수 있었다.
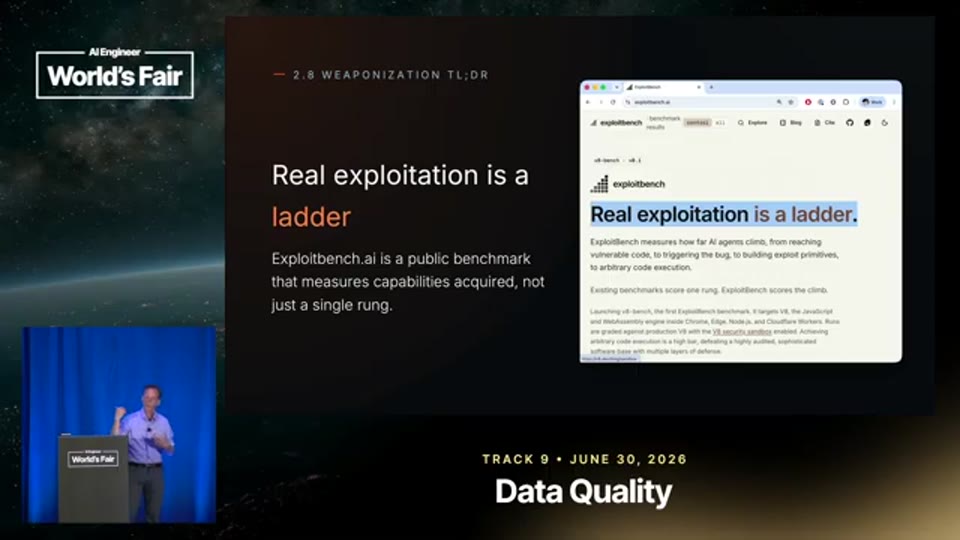
24:42 - ExploitBench 공개 환경과 Mythos transcript 비공개 이유, 공개 과학과 weaponized exploit의 딜레마를 설명하는 구간
이 문제는 AI 보안 연구가 앞으로 반복해서 마주할 갈등이다. 벤치마크를 공개해야 연구가 검증되고 발전하지만, 모델이 실제 exploit을 만들어낼 만큼 강력해질수록 공개 자체가 공격 능력 확산으로 이어질 수 있다. Brumley는 이 질문에 대해 명확한 답을 내리지는 않는다. 오히려 “우리는 아직 답이 없다”는 식으로 열어두며, AI가 실제 취약점과 exploit을 생산하는 시대에는 연구 공개의 원칙도 새롭게 설계해야 한다는 문제를 던진다.
Zero-day 기반 강화학습 환경을 만드는 이유
강연 후반부에서 Brumley는 Bugcrowd와 연구팀이 실제로 어떤 방향으로 작업하고 있는지 설명한다. 그들은 frontier model이 어디서 멈추는지를 벤치마크로 측정한 뒤, 그 지점을 넘어서도록 강화학습 환경을 구축한다. 이를 위해 오픈소스 소프트웨어를 대상으로 대규모 vulnerability mining machine을 운영하고, DARPA 관련 연구 경험을 바탕으로 새로운 proof of vulnerability를 찾아낸다고 한다.
여기서 zero-day를 찾는 목적은 공격적 과시가 아니라 학습 데이터 오염을 줄이는 데 있다. 이미 공개된 취약점이라면 모델이 훈련 과정에서 관련 정보를 보았을 가능성이 있다. 반면 연구팀이 새로 발견한 취약점은 적어도 공개 자료 memorization만으로 해결하기 어렵다. 따라서 모델이 이러한 환경에서 성공한다면, 단순 암기가 아니라 실제 reasoning과 exploit construction 능력을 일부 측정할 수 있다.
Brumley는 일부 협력사에 월 최대 1만 개의 강화학습 환경을 제공한다고 언급한다. 이 숫자는 AI 보안 학습이 더 이상 작은 수작업 벤치마크 수준에 머물지 않고, 대규모 데이터 파이프라인과 환경 생성 인프라의 문제로 이동하고 있음을 보여준다. 좋은 모델을 만들기 위해서는 단순히 더 큰 모델을 훈련하는 것만으로는 부족하고, 어떤 과제를 어떤 오라클로 어떤 난이도 곡선에 따라 제공할지 설계하는 전문성이 필요하다.
참고할 만한 배경 지식
이 강연을 이해하려면 CTF(Capture the Flag), Pwn2Own, sandbox escape, arbitrary code execution 같은 보안 용어의 맥락을 알아두는 것이 좋다. CTF는 학습자가 제한된 환경에서 취약점을 찾아 flag를 획득하는 교육형 보안 대회이며, deterministic autograder와 잘 맞는다. Pwn2Own은 실제 제품을 대상으로 exploit을 시연하는 고난도 대회로, 단순 crash보다 훨씬 높은 수준의 공격 능력을 요구한다.
V8은 Chrome의 JavaScript 및 WebAssembly 실행 엔진이며, 웹 브라우저 보안에서 매우 중요한 공격 표면이다. 브라우저는 외부 웹사이트의 코드를 실행해야 하므로 공격자가 입력을 제어하기 쉽고, 이 때문에 sandbox를 통해 피해 범위를 제한한다. 따라서 V8 exploit의 핵심은 보통 sandbox 내부에서 첫 취약점을 얻은 뒤, 추가 취약점이나 primitive를 연결해 sandbox 밖으로 나가는 것이다.
강연에서 언급된 reinforcement learning environment는 일반적인 자연어 질의응답 평가와 다르다. 모델은 텍스트 답변을 생성하는 것이 아니라, 실제 파일을 읽고 코드를 분석하고 입력을 만들며 실행 결과로 평가받는다. 이 점에서 보안 AI 연구는 agentic AI, MCP 기반 tool use, containerized evaluation, deterministic oracle 설계가 만나는 영역이라고 볼 수 있다. 이러한 배경을 함께 보면 Brumley의 핵심 주장이 더 분명해진다. AI 해킹 능력은 모델 크기만으로 결정되는 것이 아니라, 학습 환경과 채점 방식의 품질에 의해 크게 좌우된다.
마무리 / 핵심 정리
David Brumley의 강연은 “AI에게 해킹을 가르친다”는 자극적인 주제를 다루지만, 실제 메시지는 매우 공학적이다. 모델을 강하게 만들려면 먼저 과제를 정확히 정의해야 하고, 보상 함수가 잘못되면 모델은 우리가 원하는 역량이 아니라 가장 쉬운 보상 경로를 학습한다. 사이버보안에서는 이 문제가 특히 치명적인데, crash를 exploit으로 착각하거나 단일 취약점만 있는 환경을 가정하면 모델의 실제 능력을 과대평가하거나 학습을 잘못된 방향으로 유도할 수 있기 때문이다.
강연자가 제안하는 방향은 세 가지로 요약할 수 있다. 첫째, LLM-as-a-Judge 대신 실행 기반 deterministic oracle을 사용해야 한다. 둘째, 단일 버그 과제가 아니라 프로그램 전체를 대상으로 하는 audit task를 통해 precision과 recall을 함께 평가해야 한다. 셋째, crash를 넘어 arbitrary read/write, sandbox escape, arbitrary code execution까지 이어지는 exploit capability ladder를 만들어야 한다. 이 세 가지가 결합될 때 비로소 모델이 실제 취약점을 찾고 무기화할 수 있는지, 또는 단지 그럴듯한 설명과 쉬운 crash를 반복하는지 구분할 수 있다.
가장 중요한 함의는 AI 보안 연구가 이제 단순한 벤치마크 점수 경쟁을 넘어섰다는 점이다. 모델이 실제 high-value target에서 공개되지 않은 exploit 경로를 찾을 가능성이 보이기 시작하면, 연구자는 성능 향상뿐 아니라 공개 범위, 재현성, 오용 가능성까지 함께 설계해야 한다. Brumley의 강연은 이 전환점을 잘 보여준다. 해킹을 배우는 인간에게 단계적 문제와 정확한 채점이 필요했듯, AI에게도 같은 원칙이 필요하며, 그 원칙을 제대로 세우는 일이 앞으로의 AI 보안 역량을 결정하게 될 것이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Teaching AI to Find Real Vulnerabilities — David Brumley, Bugcrowd |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-08-01 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.