Text Diffusion — Google DeepMind의 Brendan Dillon
📺 원본 영상: Text Diffusion — Brendon Dillon, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-05 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Google DeepMind의 연구과학자 Brendan Dillon은 이 강연에서 텍스트 디퓨전(Text Diffusion)을 소개한다. 이미지·영상 분야에서 이미 주류 기술로 자리잡은 디퓨전 방식을 텍스트 생성에 적용하면 어떤 이점이 생기는지, 그리고 왜 아직 대규모 서비스 모델에 전면 채택되지 않았는지를 명쾌하게 정리한다. 강연은 Gemini Diffusion이라는 실제 연구 데모를 중심으로 저지연(Low Latency), 양방향 추론(Bidirectional Reasoning), 적응적 연산(Adaptive Computation), 인플레이스 편집(In-place Editing)이라는 네 가지 핵심 특성을 다룬다.
텍스트 디퓨전이란 무엇인가
텍스트 디퓨전의 원리는 이미지 디퓨전과 본질적으로 같다. 이미지 디퓨전에서는 원본 이미지에 노이즈를 점진적으로 추가한 뒤 신경망이 그 노이즈를 단계적으로 제거하도록 학습하고, 추론 시에는 순수한 노이즈에서 출발해 이미지를 복원한다. 텍스트 디퓨전도 마찬가지다. 학습 단계에서는 깨끗한 토큰 시퀀스에 노이즈를 추가하는데, 연속적(continuous) 방식과 이산적(discrete) 방식이 있으며 후자가 더 일반적이다. 이산적 방식에서는 임의의 토큰을 삽입하거나 기존 토큰을 다른 무작위 토큰으로 대체하는 방식으로 시퀀스를 오염시키고, 신경망은 이 오염된 시퀀스를 보고 잘못된 부분을 교정하는 방법을 학습한다.
추론 시에는 어휘(vocabulary)에서 무작위로 뽑은 순수 노이즈 토큰들로 시퀀스를 초기화한 뒤, 신경망이 원하는 순서에 따라 정보를 채워 나가면서 깨끗한 문장으로 수렴시킨다. 강연자에 따르면 이 과정은 이미지 디퓨전 GIF와 시각적으로도 유사하게 보인다. 처음에는 완전히 노이즈 상태이다가 점점 텍스트가 채워지며, 최종적으로 깨끗한 출력이 나타난다.
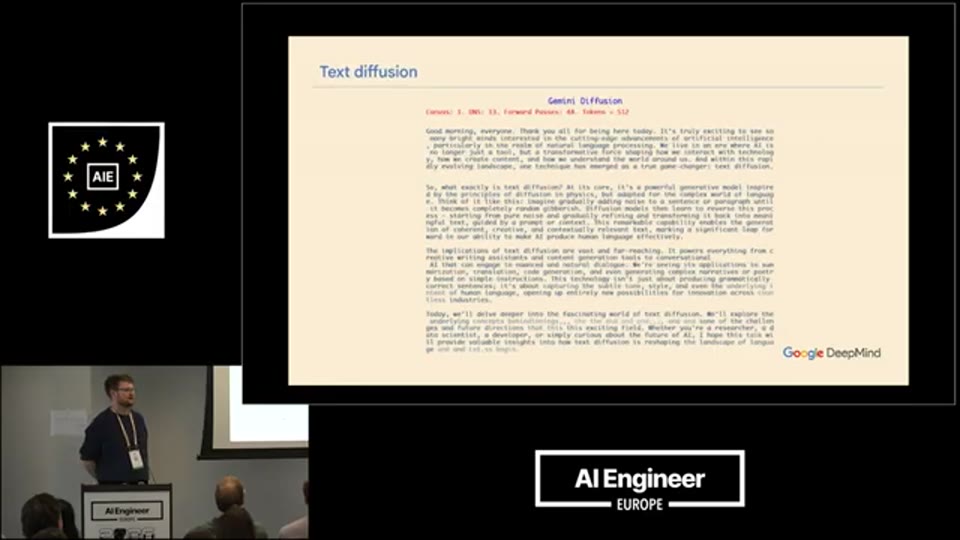
01:54 - 텍스트 디퓨전 과정을 보여주는 GIF 애니메이션 — 노이즈 상태에서 깨끗한 텍스트로 수렴하는 과정
Gemini Diffusion: 연구 미리보기
강연자가 속한 팀은 약 1년 전(강연 기준) Gemini Diffusion이라는 연구 데모를 공개했다. 이는 Gemini 모델의 변형으로, 기존의 자기회귀적(autoregressive) 다음 토큰 예측 방식 대신 텍스트 디퓨전을 적용한 것이다. 약 10만 명에게 조기 접근이 허용된 연구 미리보기 형태로 공개되었으며, 비교 기준 모델은 당시 베이스 아키텍처였던 Gemini 2.0 Flash Lite였다. 품질 면에서는 전반적으로 유사하며, 코드 생성에서 약간의 우위를, 일부 영역에서는 약간의 열세를 보였다. 그러나 강연자는 이 수치가 1년 전 것이며 이 분야에서 1년은 “선사 시대”와 다름없다고 직접 언급하며, 수치보다는 기술의 방향성에 집중할 것을 당부했다.
자기회귀 생성 vs. 텍스트 디퓨전
자기회귀 방식(Gemini, GPT 계열 등)은 문맥(context)을 받아 한 번에 한 토큰씩 생성한다. 첫 번째 토큰을 생성한 뒤 그것을 조건으로 두 번째 토큰을 생성하는 식으로 순차적으로 이어지는 구조다. 반면 텍스트 디퓨전은 수백에서 수천 토큰에 달하는 “캔버스(canvas)“를 무작위 노이즈로 초기화한 뒤, 몇 번의 디노이징 스텝(denoising step)에 걸쳐 전체 블록을 동시에 정제한다. 즉, 토큰 하나하나가 아니라 전체 덩어리를 여러 번의 패스(pass)를 통해 완성하는 구조다.
이러한 구조적 차이에서 두 방식의 가장 근본적인 차이가 나온다. 자기회귀 트랜스포머는 현재 토큰 이전의 과거만 볼 수 있는 인과적 어텐션(causal attention)을 사용한다. 반면 텍스트 디퓨전 모델은 아직 확정되지 않은 미래 토큰까지 참조할 수 있는 양방향 어텐션(bidirectional attention)을 활용할 수 있다. 이것이 이후에 설명할 자기 교정 능력의 구조적 근거다.
강연자는 텍스트 디퓨전의 주요 이점을 네 가지로 요약했다. 가장 두드러진 것은 저지연(low latency), 즉 더 빠른 토큰 생성 속도이고, 이어서 양방향 어텐션을 통한 자기 교정 능력, 문제 난이도에 따라 연산량을 조절하는 적응적 연산(adaptive computation), 그리고 기존 텍스트를 문맥에 맞게 최소한으로 수정하는 인플레이스 편집(in-place editing)이 있다. 반면 주요 단점도 명확하다. 대규모 배치(batch) 처리 시 처리량(throughput)이 자기회귀 방식보다 낮다는 점이다. 자기회귀 모델은 수많은 쿼리를 동시에 배치로 처리해 GPU 활용률을 높임으로써 낮은 단가로 대량 서빙이 가능하지만, 텍스트 디퓨전은 동일한 데이터에 여러 번 포워드 패스(forward pass)를 수행해야 하므로 연산 한계에 더 일찍 도달하고 전체 처리량이 떨어진다. 강연자는 이것이 현재 텍스트 디퓨전이 Claude를 포함한 대형 상용 모델에 채택되지 못하는 가장 큰 이유라고 명시했다.
하드웨어가 설명하는 속도 우위
텍스트 디퓨전이 더 낮은 지연을 달성할 수 있는 이유는 GPU·TPU의 하드웨어 특성에서 출발한다. 현대 GPU와 TPU에는 대규모 행렬 곱셈을 담당하는 텐서 코어(tensor core)와, 가중치(weights)·활성값(activations)·KV 캐시(KV cache)를 저장하는 고대역 메모리(HBM, High Bandwidth Memory)가 있다. 문제는 이 메모리에서 텐서 코어로 데이터를 전송하는 대역폭(bandwidth)이 매우 제한적이라는 점이다. 칩 제조 관점에서 연산 플롭(FLOP)을 늘리기는 상대적으로 쉽지만 대역폭을 늘리는 것은 비용이 크기 때문에, GPU·TPU는 모두 플롭은 풍부하고 대역폭은 빠듯한 구조를 갖는다. 결국 이 칩들은 실질적으로 메모리 대역폭에 의해 병목이 생기는 상황(memory-bound)이다.
자기회귀 방식으로 배치 크기 1로 서빙할 때, 한 토큰을 생성하기 위해 전체 신경망과 KV 캐시를 메모리에서 불러와야 하며 다음 토큰을 위해 이 과정을 반복한다. 반면 텍스트 디퓨전은 한 번의 메모리 스트리밍으로 수백 토큰을 처리하는 방식을 취한다. 예를 들어 256개 토큰을 생성하는 데 24번의 패스만 수행한다면, 자기회귀 방식보다 약 10배 적은 메모리 전송으로 동일한 결과를 얻을 수 있다. 진정으로 메모리 대역폭이 병목이라면, 이는 약 10배의 속도 향상으로 이어진다. Gemini Diffusion은 이를 통해 쿼리 길이에 따라 다르지만 일관되게 초당 약 2,000 토큰을 달성했다. 강연자는 이것이 프리필(prefill)을 포함한 실제 수치임을 강조했다.
양방향 추론과 자기 교정
텍스트 디퓨전의 두 번째 주요 특성은 양방향 추론과 자기 교정 능력이다. 강연자는 Google I/O에서 시연된 수학 문제 풀이 데모를 예시로 들었다. 문제는 “√81 × (2/3)² + …”와 같은 형식으로, 정답은 39다. 많은 모델들이 이 비교적 단순해 보이는 문제에서 실수를 범한다.
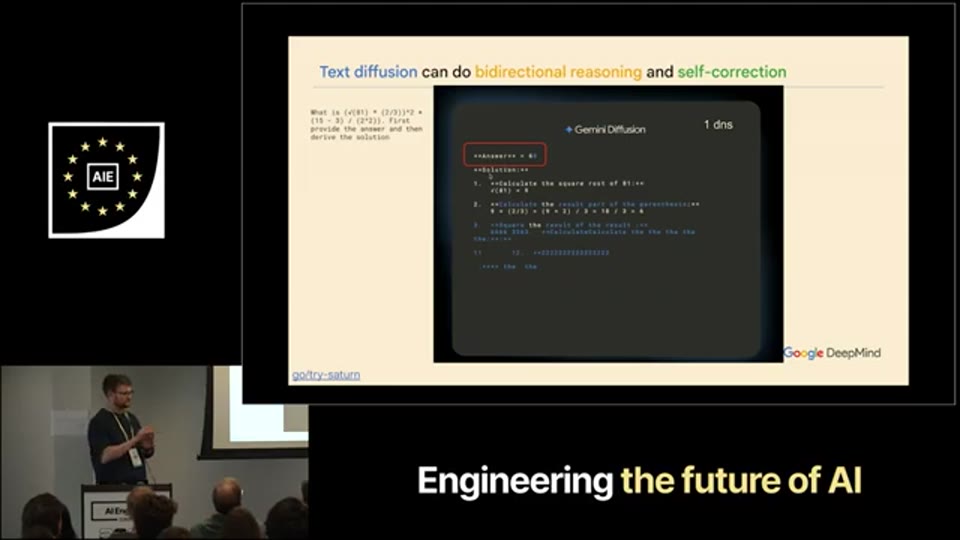
09:33 - Gemini Diffusion 수학 문제 풀이 데모 — 첫 번째 포워드 패스 이후 토큰 상태 (answer=60 오답 표시)
Gemini Diffusion에 이 문제를 입력했을 때의 과정은 자기회귀 방식으로는 불가능한 것이다. 첫 번째 포워드 패스 이후 모델은 “answer = 60”이라는 잘못된 추측을 내놓으면서도 이어서 추론 과정을 시작한다. 두 번째 포워드 패스에서는 답이 49로 수정되고 추론이 더 진행된다. 세 번째 포워드 패스에서 모델은 전체 추론을 완료하고 “36 + 3 = 39”를 확인한 뒤, 처음에 잘못 내놓았던 답을 소급하여 39로 수정한다.
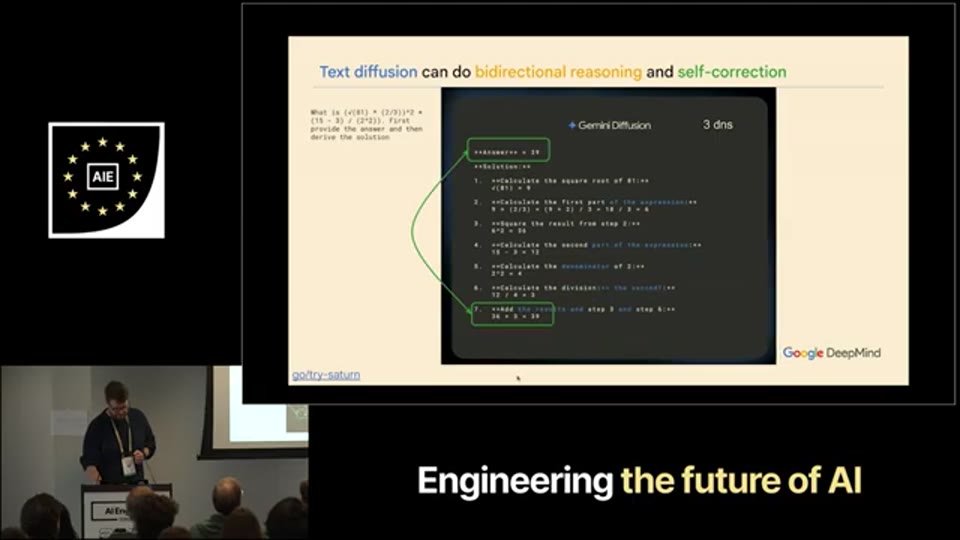
10:07 - 수학 문제 풀이 세 번째 포워드 패스 — 추론 완료 후 answer=39로 소급 수정된 화면
강연자에 따르면 이는 미래에 생성될 토큰을 참조할 수 있는 양방향 어텐션 덕분에 가능하다. 이미 발화한 과거 토큰만 볼 수 있는 자기회귀 모델은 구조적으로 이런 소급 수정을 할 수 없다.
더욱 인상적인 것은, 당시 Gemini Diffusion보다 훨씬 큰 규모의 모델들도 같은 문제에서 실수를 범했다는 점이다. GPT-4o는 40이라고 답했다가 스스로 39로 수정했고, Gemini 2.5 Flash는 42라고 답한 뒤 이 오류를 끝내 수정하지 못하고 “36 + 3 = 42”라는 잘못된 논리를 그대로 유지했다. 강연자는 이것이 개별 모델의 문제가 아니라 자기회귀 구조 자체의 근본적인 한계라고 지적했다. 현대의 추론 모델(reasoning model)이 이 문제를 우회하는 방법을 찾아냈지만, 그것은 문제를 다른 방식으로 미룬 것일 뿐이라고 덧붙였다.
동적·적응적 연산
텍스트 디퓨전의 세 번째 특성은 문제 난이도에 따라 연산량을 동적으로 조절하는 능력이다. 디노이징 스텝 수를 늘릴수록 출력 품질이 올라가는 경향이 있는데, 이는 완전히 단조적(monotonic)이지는 않지만 전반적으로 각 평가 지표에서 품질이 계속 향상되는 패턴을 보인다. 이미 거의 완성된 출력이라도 추가 패스를 거치면 미세한 오류를 발견하고 수정할 기회를 얻기 때문이다.
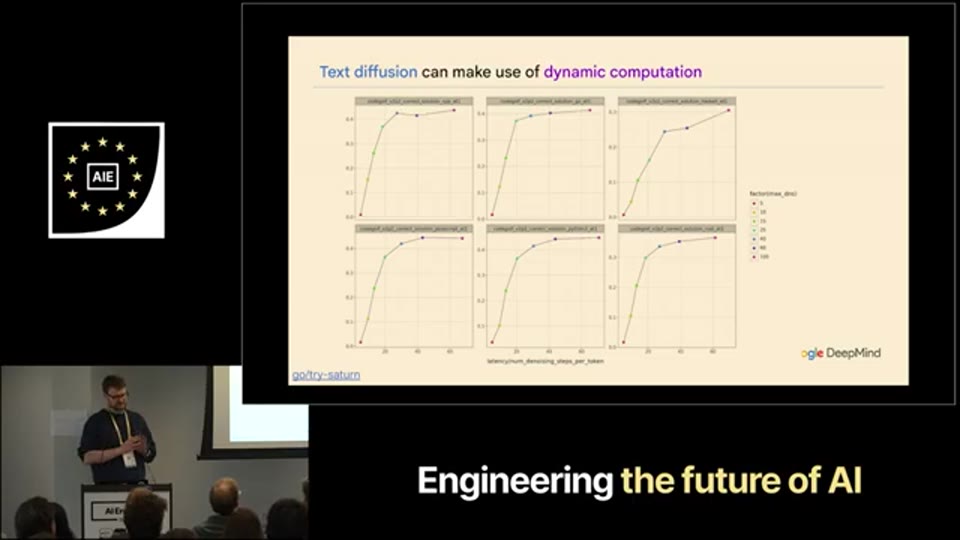
12:15 - 디노이징 스텝 수 증가에 따른 품질 향상 곡선 — 6개 코딩 평가 지표 차트
여기서 한 단계 더 나아간 개념이 적응적 연산(adaptive computation)이다. 모델을 특별한 방식으로 학습시키면 스스로 작업 완료 시점을 판단하게 할 수 있다. 강연자는 Gemini Diffusion의 세 가지 예시를 제시했다.
- “원주율의 앞 100자리를 알려달라” → 단 4번의 스텝 소요. 100개 토큰 분량의 답변이지만 암기된 정보를 곧바로 출력할 수 있어 매우 빠르다. 같은 시간 동안 자기회귀 모델은 4개 토큰밖에 생성하지 못했을 것이다.
- FizzBuzz 코드 작성 → 18번의 포워드 패스 소요.
- 한 문단으로 양자역학 설명 → 31번의 디노이징 스텝 소요.
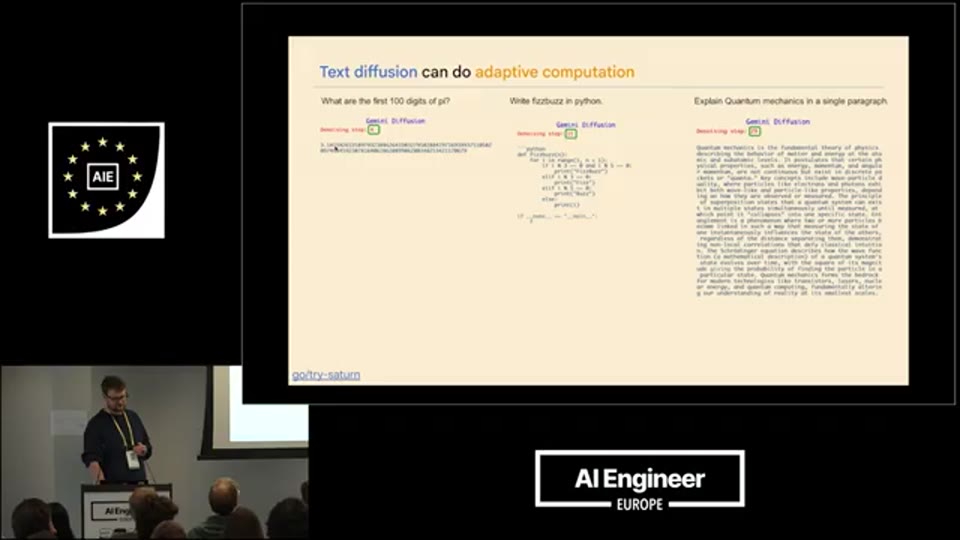
13:00 - 적응적 연산 예시 — 원주율(4스텝), FizzBuzz(18스텝), 양자역학(31스텝) 비교 슬라이드
이 외에도 더 어려운 평가 지표일수록 더 많은 스텝이 소요되는 경향이 뚜렷하게 나타났다. 강연 당시 기준으로 가장 어려운 평가 지표였던 GPQA Diamond(대학원 수준 과학 문제)는 매우 많은 스텝을, 기본적인 파이썬 프로그래밍 평가인 MBPP(Mostly Basic Python Problems)는 아주 적은 스텝을 사용했다. 이 모든 것이 외부에서 설정한 규칙이 아니라 모델 스스로의 판단으로 이루어진다는 점이 이 기능의 핵심이다.
인플레이스 편집
네 번째 특성은 인플레이스 편집(in-place editing)으로, 이미지 디퓨전의 인페인팅(inpainting)과 유사한 개념이다. 이미지에서 일부를 지우고 채워 넣는 작업이 가능한 이유는, 디퓨전 모델이 수정하지 않은 부분 전체를 맥락으로 활용해 빈 공간을 채울 수 있기 때문이다. 좌에서 우, 위에서 아래로 픽셀을 순차 생성하는 자기회귀 이미지 생성기와 달리, 디퓨전 모델은 전체 이미지를 보면서 디노이징을 시작하므로 각 픽셀이 다른 모든 픽셀을 참조할 수 있다.
텍스트에서도 동일한 원리가 적용된다. 강연자가 보여준 데모에서는 코드에 버그가 있다는 프롬프트를 입력하자, 모델이 전체 코드를 처음부터 다시 생성하는 것이 아니라 문제가 있는 인덱스 부분만 최소한으로 수정했다. 문서화 추가, 이야기 중간에 새 문단 삽입 같은 작업도 동일한 원리로 가능하다. 앞 문단과 뒷 문단을 모두 참조해 그 사이에 자연스럽게 이어지는 내용을 생성할 수 있기 때문이다.
💡 [영상 참조] 강연자는 이 시점에서 코드 버그 수정 및 문서화 추가 인플레이스 편집 데모 화면을 보여줍니다. 📺 원본 영상에서 확인하세요.
저지연이 여는 새로운 가능성
강연의 후반부는 저지연 모델이 단순히 “같은 것을 더 빠르게” 제공하는 것이 아니라 완전히 새로운 응용 분야를 열 수 있음을 보여주는 데 할애되었다. 강연자 팀은 내부에서 개발한 세 가지 데모를 공개했다.
첫 번째는 실시간으로 생성되는 위키피디아다. 실제 위키피디아처럼 보이지만 HTML과 텍스트 모두 Gemini Diffusion이 클릭 즉시 생성하는 방식이다. 지연 시간이 충분히 낮기 때문에 실제 웹페이지를 탐색하는 것과 구분하기 어려운 경험을 제공한다.
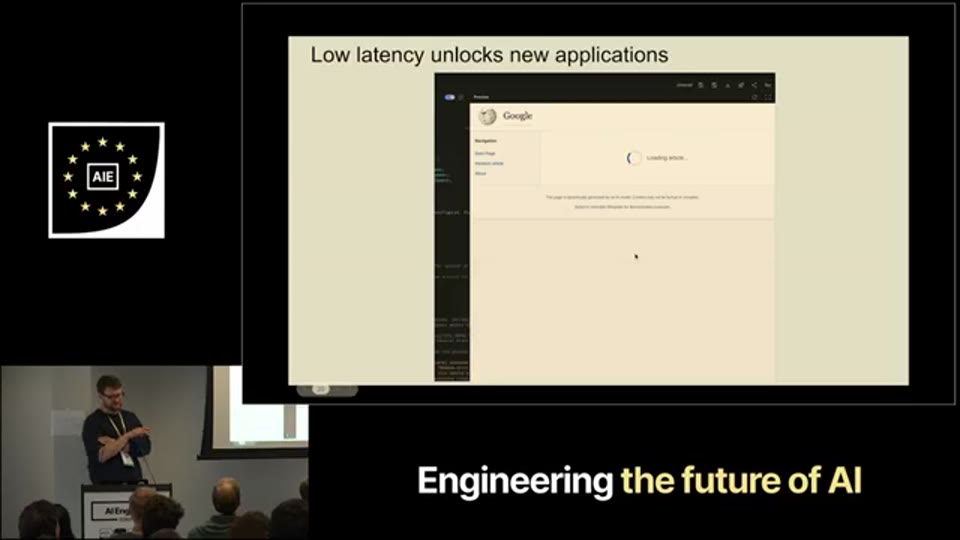
16:48 - Gemini Diffusion이 실시간으로 생성하는 Wikipedia 데모 화면
두 번째는 Reddit 시뮬레이션으로, 어떤 주제의 서브레딧이든 즉석에서 생성하고 게시글과 댓글을 모두 실시간으로 만들어 낸다. 이 데모에서 Gemini Diffusion은 텍스트와 HTML을 담당하고, 이미지 생성은 당시 팀 내 최신 이미지 생성 모델(내부 코드명 Juneau로 언급됨)이 협력 처리했다. 텍스트는 거의 즉각 생성되고 이미지는 이후에 따라오는 방식이다. 세 번째는 운영체제 시뮬레이션으로, 매 클릭마다 모델이 다음 화면 전체를 실시간으로 생성해 실제 OS처럼 작동하는 경험을 만들어낸다. 파일 열기, 리드미 확인, 바탕화면 복귀 등 모든 인터랙션이 즉석 생성이다.
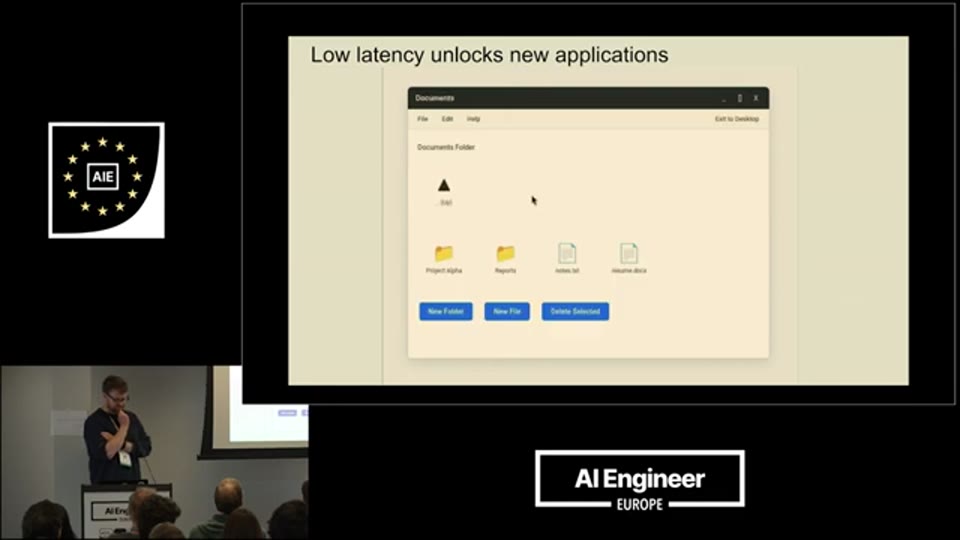
18:19 - 모든 클릭에 즉석 생성되는 운영체제 시뮬레이션 데모 화면
강연자가 가장 인상적으로 소개한 사례는 외부 개발자가 Gemini Diffusion 웹 인터페이스를 사용해 음성으로 바이브 코딩(vibe coding by voice)을 진행한 트위터 데모였다. 음성 명령만으로 할 일 앱(To-do app)을 생성하고, 항목 추가, 완료 상태 처리, 이름·상태별 정렬, 다크 모드 전환을 약 15초 만에 완성하는 모습은 저지연 모델이 개발 워크플로우 자체를 어떻게 바꿀 수 있는지를 보여주는 구체적인 사례였다. 강연자는 이 같은 사례들이 앞으로 AI 엔지니어들이 저지연 디퓨전 모델로 무엇을 만들 수 있는지를 탐색할 계기가 되길 바란다고 밝혔다.
질의응답에서 나온 추가 내용
강연 후 질의응답에서는 몇 가지 기술적 세부 사항이 추가로 논의되었다. 학습 데이터에 관해 강연자는 기존 언어 모델과 동일한 데이터를 사용하며 알고리즘만 달라진다고 답했고, 지식 증류(knowledge distillation)도 가능하다고 언급했다. 생성 길이 처리 방식에 대해서는 고정 윈도우 크기를 설정하고 블록 단위 자기회귀(blockwise autoregressive) 방식으로 처리하는 것이 가장 일반적이며, 원하는 경우 응답 길이를 예측하는 전용 헤드를 두는 방법도 있다고 설명했다.
모델 규모와 스텝 수의 관계에서는 흥미로운 경향이 확인되었다. 더 큰 모델일수록 동일한 품질을 내기 위해 필요한 스텝 수가 적어지는 경향이 있어, 모델이 커질수록 포워드 패스당 연산량이 늘어나더라도 필요한 패스 수가 줄어 서빙 비용 증가폭이 완화된다는 것이다. 또한 텍스트 디퓨전은 이미 알파벳(Alphabet) 생태계 내 일부 온디바이스(on-device) 애플리케이션, 특히 로보틱스(robotics) 분야에 적용되어 있다고 밝혔다. 대규모 서비스 환경에서 문제가 되는 처리량 이슈는 수천 명과 배치를 공유하지 않는 온디바이스 환경에서는 걸림돌이 되지 않기 때문이다.
마무리
텍스트 디퓨전은 자기회귀 방식이 구조적으로 해결할 수 없는 몇 가지 문제들, 즉 미래 토큰을 참조할 수 없는 단방향성, 처음 잘못된 추론을 소급하여 수정할 수 없는 한계, 문제 난이도와 무관하게 고정된 연산량이라는 문제들을 하드웨어 친화적인 방식으로 해결하는 접근법이다. Gemini Diffusion이 보여준 초당 2,000 토큰이라는 성능은 저지연이 단순한 속도 개선을 넘어 완전히 새로운 사용자 경험과 제품을 가능하게 한다는 것을 증명했다. 현재는 대용량 배치 서빙 비용이라는 현실적 장벽으로 인해 상용 대형 모델에는 아직 채택되지 않았지만, 강연자는 조만간 새로운 세대의 텍스트 디퓨전 모델이 등장할 것임을 시사했다. 온디바이스 환경부터 실시간 인터랙티브 서비스까지, 이 기술이 열어갈 응용 가능성은 이제 막 탐색이 시작된 단계다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Text Diffusion — Brendon Dillon, Google DeepMind |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-06-05 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.