The Desktop Frontier — Ahmad Osman, Osmantic
📺 원본 영상: The Desktop Frontier — Ahmad Osman, Osmantic
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-22
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
Ahmad Osman의 강연은 로컬 AI와 오픈소스 모델의 발전을 단순한 성능 경쟁이 아니라 “하드웨어 단위당 지능의 밀도”가 빠르게 높아지는 현상으로 해석한다. 그는 거대 모델이 계속 커지는 흐름과 별개로, 새로운 아키텍처와 학습 효율, 후처리 학습, 양자화 기술이 결합되면서 과거에는 서버급 장비가 필요했던 성능이 점점 개인용 데스크톱 GPU로 내려오고 있다고 주장한다.
이 강연의 핵심은 “작은 모델이 큰 모델을 이긴다”는 단순한 구호가 아니다. 강연자는 더 정확히는 “새롭고 효율적인 모델이 오래되고 비효율적인 모델을 이긴다”고 설명하며, 같은 수준의 지능을 실행하는 데 필요한 파라미터 수와 하드웨어 풋프린트가 지속적으로 줄어드는 흐름을 강조한다. 이 관점에서 데스크톱은 더 이상 클라우드 AI의 보조 수단이 아니라, 개인과 기업이 자체적으로 지능형 시스템을 소유하고 최적화할 수 있는 새로운 프런티어로 제시된다.
데스크톱 프런티어라는 문제의식
강연의 제목인 “Desktop Frontier”는 STT 원문에서 “Disk Top Frontier”처럼 인식되었지만, 문맥상 데스크톱 환경에서 실행되는 로컬 AI의 가능성을 가리킨다. Osman은 발표 초반부터 약 18개월 안에 GLM 5.2급 지능을 단일 RTX 5090급 GPU와 32GB VRAM에서 실행할 수 있을 것이라는 예측을 제시한다. 이 예측은 2027년 말 무렵을 겨냥한 것이며, 그는 이를 오히려 보수적인 전망이라고 표현한다.
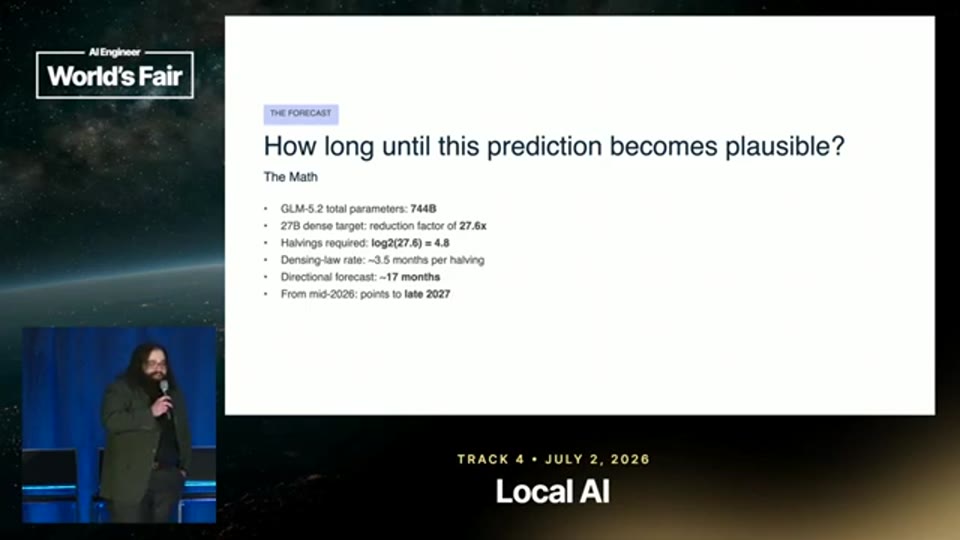
15:12 - GLM 5.2급 모델을 단일 RTX 5090급 GPU에서 실행할 수 있다는 예측의 시간 계산을 설명하는 구간이다.
이 주장은 단순히 “GPU가 빨라질 것”이라는 하드웨어 낙관론이 아니다. 강연자가 주목하는 변화는 모델 자체의 효율이 빠르게 좋아지고 있다는 점이다. 과거 AI 담론은 더 큰 모델, 더 많은 파라미터, 더 큰 데이터센터를 중심으로 전개되었지만, 실제 사용 관점에서는 같은 품질의 응답을 더 작은 모델과 더 적은 VRAM으로 실행할 수 있는지가 중요하다. 따라서 데스크톱 프런티어의 핵심 질문은 “가장 큰 모델은 무엇인가”가 아니라 “동일한 지능을 얼마만큼 작은 하드웨어에서 실행할 수 있는가”로 바뀐다.
강연자는 클라우드 최첨단 모델과 오픈소스 모델 사이의 격차가 완전히 사라지지는 않을 것이라고 인정한다. 그러나 그는 그 격차가 점차 줄어들고 있으며, 특히 모델 효율이 누적적으로 개선되면서 개인용 하드웨어가 감당할 수 있는 지능의 수준이 빠르게 올라가고 있다고 본다. 이때 중요한 개념으로 제시되는 것이 “파라미터당 임팩트(impact per parameter)”다.
파라미터당 임팩트라는 렌즈
Osman이 제안하는 “impact per parameter”는 모델의 총 파라미터 수만으로 성능을 판단하는 관성을 깨기 위한 개념이다. 같은 70B 모델이라도 어느 시점의 아키텍처인지, 어떤 학습 방식과 후처리 학습을 거쳤는지, 실제 실행 시 활성화되는 파라미터가 얼마나 되는지에 따라 사용자가 체감하는 능력은 크게 달라진다. 따라서 그는 “이 모델이 무엇을 할 수 있는가”와 “그 능력을 위해 어떤 하드웨어 풋프린트가 필요한가”를 함께 보아야 한다고 강조한다.
강연자는 Llama 2 70B가 과거에는 여러 장의 RTX 3090급 GPU를 필요로 했던 사례를 언급한다. 그러나 이후 Qwen 계열의 27B급 모델이 등장하면서, 훨씬 작은 모델이 과거의 400B급 모델과 비교될 정도의 능력을 보이게 되었다고 설명한다. STT 원문에는 “Queen 3.5, 3.6”처럼 기록되어 있지만, 문맥상 Qwen3.5 및 Qwen3.6 계열을 가리키는 것으로 보인다.
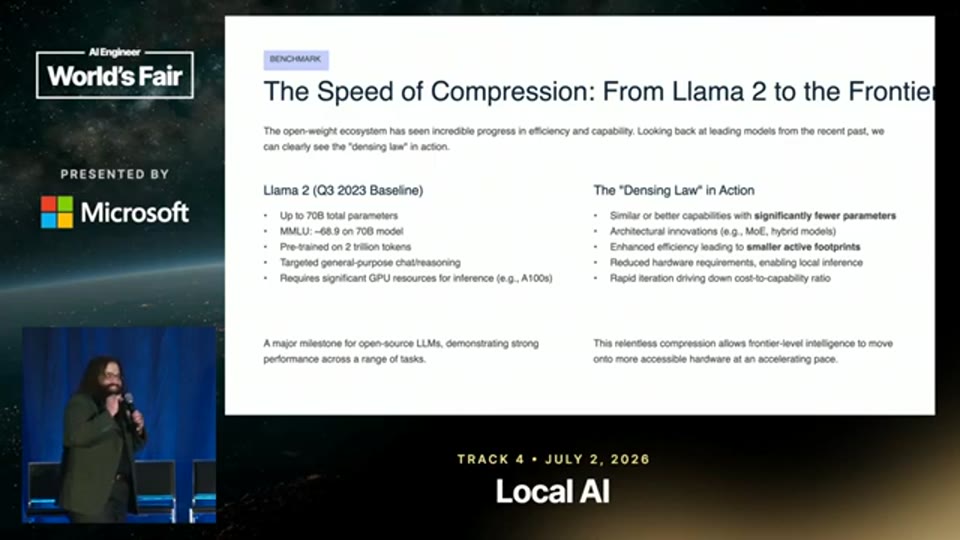
06:45 - Llama 2 70B 실행에 필요했던 과거 하드웨어와 현재 Qwen 계열 모델로 가능한 병렬 에이전트 실행을 비교하는 구간이다.
이 흐름은 벤치마크 점수만의 문제가 아니다. 강연자는 1년 전만 해도 로컬 모델이 Claude Code와 같은 코딩 에이전트 환경에서 안정적으로 실행되기 어려웠다고 말한다. 그러나 이후 GLM 4.5, GLM 4.5 Air, Qwen 계열 모델이 등장하면서 로컬 실행 환경에서도 실제 에이전트 워크플로우가 가능해졌고, 필요한 GPU 수도 줄어들었다는 것이 그의 판단이다. 즉 모델 효율의 진전은 논문이나 리더보드의 숫자에 머무르지 않고, 개발자가 자기 책상 밑 장비에서 어떤 작업을 수행할 수 있는지로 연결된다.
큰 모델 대 작은 모델이 아니라, 오래된 모델 대 새로운 모델
강연에서 가장 중요한 문장은 “작은 모델이 큰 모델을 이기는 것이 아니라, 더 새롭고 효율적인 모델이 더 오래되고 비효율적인 모델을 이기는 것”이라는 설명이다. 이는 오픈소스 AI 생태계를 해석할 때 중요한 균형점을 제공한다. 단순히 작은 모델이 언제나 우월하다는 뜻이 아니라, 아키텍처 개선과 학습 기법의 누적 효과가 모델 크기라는 단일 지표를 압도하기 시작했다는 뜻이기 때문이다.
강연자는 이 흐름을 “capability density”, 즉 능력 밀도의 상승으로 설명한다. STT 원문의 “Natural machine intelligence calls this pattern dense and glow”라는 문장은 부정확하게 인식된 것으로 보이며, 문맥상 특정 문헌이나 슬라이드에서 제시한 능력 밀도 증가 추세를 가리키는 대목으로 해석하는 것이 자연스럽다. 강연자의 취지는 분명하다. 그는 일정 기간마다 동일한 능력을 구현하는 데 필요한 파라미터 수가 줄어들고 있으며, 특히 dense 모델과 Mixture-of-Experts(MoE) 모델 모두에서 활성 파라미터 기준의 효율성이 개선되고 있다고 본다.
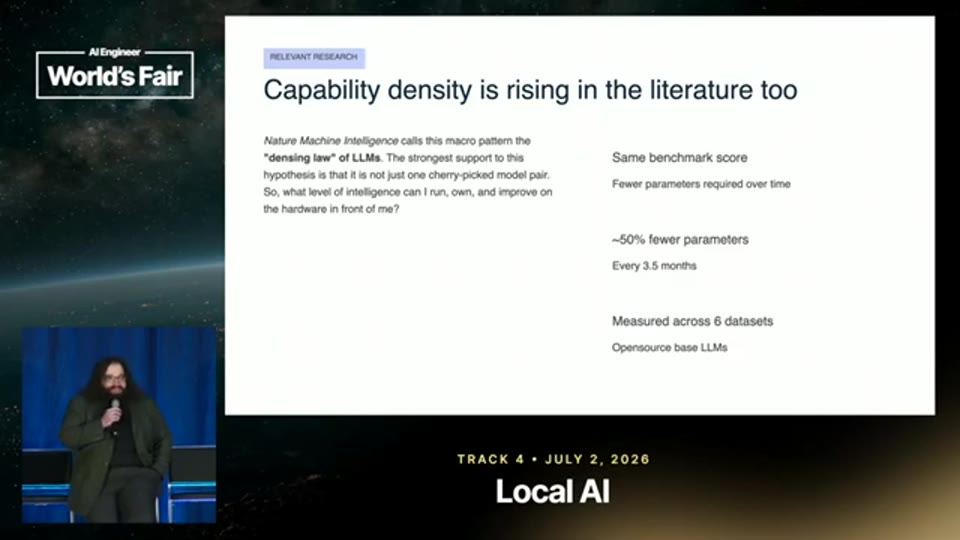
04:48 - 능력 밀도와 파라미터 감소 추세를 설명하는 구간으로, 강연자가 관련 문헌 또는 추세 슬라이드를 참조하는 것으로 보인다.
이 관점은 하드웨어 구매와 인프라 전략에도 영향을 준다. 만약 같은 GPU가 시간이 갈수록 더 강력한 모델을 실행할 수 있게 된다면, GPU는 시간이 지나면 구식이 되는 소비재가 아니라 모델 효율 개선의 수혜를 받는 자산처럼 작동할 수 있다. 물론 강연자는 이것이 투자 조언이 아니라고 분명히 선을 긋지만, 로컬 AI 인프라를 단기 성능만이 아니라 미래 모델 효율까지 포함해 평가해야 한다는 문제의식은 강하게 드러난다.
GLM 5.2와 NVFP4가 보여주는 로컬 프런티어
강연자는 현재의 대표적 사례로 GLM 5.2를 언급한다. 그의 설명에 따르면 GLM 5.2는 총 744B 파라미터 규모이며, 실제 활성화되는 파라미터는 약 40B 수준이다. 또한 최대 100만 토큰 컨텍스트를 지원하고, NVFP4로 실행할 경우 DGX Station이나 8장의 RTX PRO 6000급 GPU를 장착한 서버에서 구동할 수 있다고 설명한다.
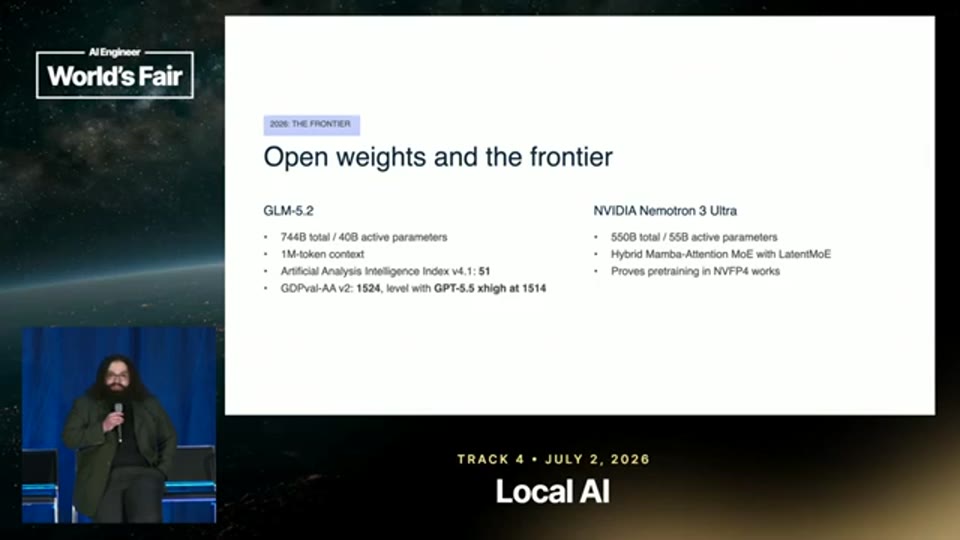
05:22 - GLM 5.2의 총 파라미터, 활성 파라미터, 100만 토큰 컨텍스트, 실행 하드웨어 구성을 설명하는 구간이다.
이 대목에서 중요한 것은 “최첨단 지능이 클라우드 데이터센터에만 있어야 한다”는 전제가 흔들리고 있다는 점이다. DGX Station은 일반 소비자용 장비라고 보기는 어렵지만, 강연자는 그것이 물리적으로 책상 밑에 둘 수 있는 형태의 장비라는 점을 강조한다. 즉 로컬 AI의 범위가 단순한 장난감 모델이나 개인 실험을 넘어, 프런티어 모델에 근접한 지능을 자체 장비에서 운영하는 방향으로 확장되고 있다는 것이다.
강연자는 Nemotron 3 Ultra도 함께 언급한다. STT 원문에서는 “Nematron”으로 기록되었지만, 문맥상 NVIDIA의 Nemotron 계열 모델을 가리키는 것으로 보는 것이 자연스럽다. 그는 이 모델이 NVFP4 기반의 더 효율적인 학습과 미세조정 가능성을 보여주었다고 설명하며, 이는 기업이 특정 업무에 맞춘 소형 전문 모델을 더 저렴하게 만들 수 있다는 경제적 의미로 이어진다고 본다.
오픈소스 모델 진화의 계보
Osman은 오픈소스 모델의 발전을 Mistral 7B 이후의 흐름으로 되짚는다. Mistral 7B는 작은 모델이 기대 이상의 성능을 보일 수 있다는 인식을 넓힌 중요한 사례였고, 이후 Mixtral 8x7B는 MoE 구조가 실용적인 오픈 모델에서도 강력할 수 있음을 보여주었다. 이 시점부터 오픈소스 모델은 단지 폐쇄형 모델의 축소판이 아니라, 제한된 하드웨어에서 최대한의 성능을 뽑아내는 실험장이 되기 시작했다.
그다음 전환점으로 강연자는 Llama 3를 꼽는다. 특히 Llama 3 8B는 그가 개인적으로 선호했던 모델이며, 70B 모델은 당시 그가 8장의 RTX 3090급 GPU에서 실행하던 대표 모델이었다고 설명한다. 그러나 Llama 3 405B처럼 400B를 넘는 대형 모델은 여전히 상당한 하드웨어를 요구했고, 시간이 지나면서 더 작은 Qwen3.5 및 Qwen3.6 계열 모델과 비교될 수 있는 상황이 되었다고 말한다.
Qwen 2.5는 강연자에게 오픈소스와 프런티어 모델 사이의 격차가 실제로 줄어들고 있음을 체감하게 만든 모델로 제시된다. 그는 이 모델을 중심으로 많은 미세조정과 실험, 논문이 나왔고, 커뮤니티가 큰 도움을 받았다고 평가한다. 이어 DeepSeek R1은 reasoning, 즉 추론 능력을 집에서도 실행할 수 있는 수준으로 끌어내린 전환점으로 설명된다. 다만 DeepSeek R1은 약 671B 파라미터 규모의 거대한 MoE 모델이었기 때문에, 실제 구동에는 매우 강력한 서버가 필요했다는 점도 함께 언급된다.
GPT OSS와 에이전트 성능의 의미
강연자는 GPT OSS 120B를 또 하나의 중요한 단계로 언급한다. STT 원문에서는 “GBT OSS”로 기록되었지만, 문맥상 GPT OSS를 가리키는 것으로 보인다. Osman은 이 모델이 도구 호출(tool calling)을 성공적으로 수행할 수 있었던 초기 오픈소스 모델 중 하나였으며, 로컬 하드웨어에서 더 많은 에이전트적 작업을 수행할 수 있음을 보여준 사례라고 설명한다.
여기서 “에이전트적 성능”은 단순 질의응답 능력과 다르다. 도구 호출을 수행하는 모델은 외부 명령, 코드 실행, 검색, 파일 처리, 워크플로우 제어와 연결될 수 있기 때문에 실제 업무 자동화의 기반이 된다. 따라서 120B급 모델이 671B급 DeepSeek R1보다 훨씬 작은 풋프린트로 유사하거나 더 나은 에이전트 성능을 보였다는 강연자의 평가는, 오픈소스 AI의 실용성이 모델 크기보다 실행 비용과 워크플로우 적합성에 의해 좌우된다는 메시지를 강화한다.
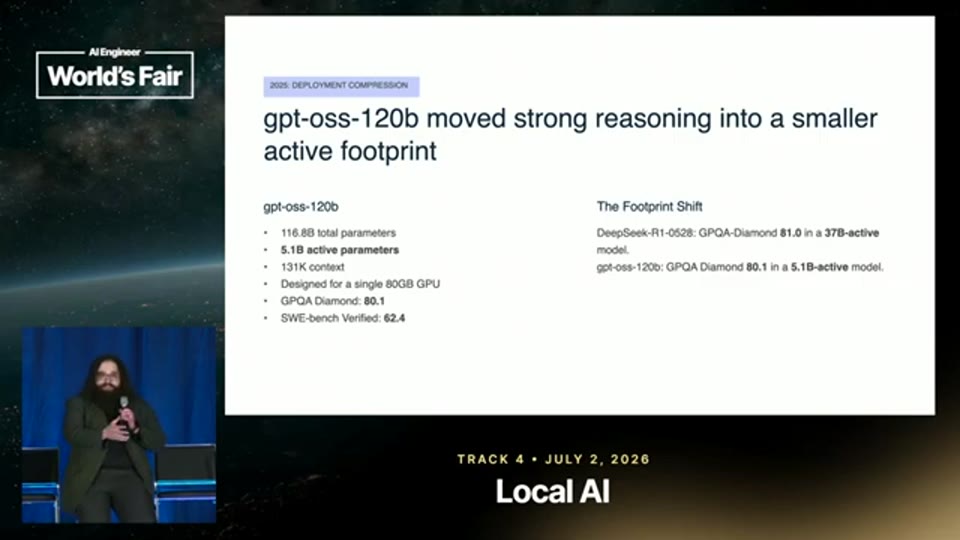
12:30 - DeepSeek R1과 GPT OSS 120B의 모델 크기 및 에이전트 성능을 비교하며 풋프린트 변화를 설명하는 구간이다.
이 흐름은 Qwen3.5와 Qwen3.6 비교에서 더 극적으로 제시된다. 강연자에 따르면 Qwen3.5-397B-A17B는 약 397B 파라미터 규모의 큰 MoE 모델이지만, Qwen3.6의 27B dense 모델은 훨씬 작은 총 파라미터 수에도 불구하고 특정 벤치마크에서 이를 앞선다. 그는 활성 파라미터 기준으로 보면 차이가 단순한 15배가 아니라 처리 비용과 능력의 균형 문제로 읽혀야 한다고 설명하며, 짧은 기간 안에 이 정도의 풋프린트 변화가 일어났다는 사실을 강조한다.
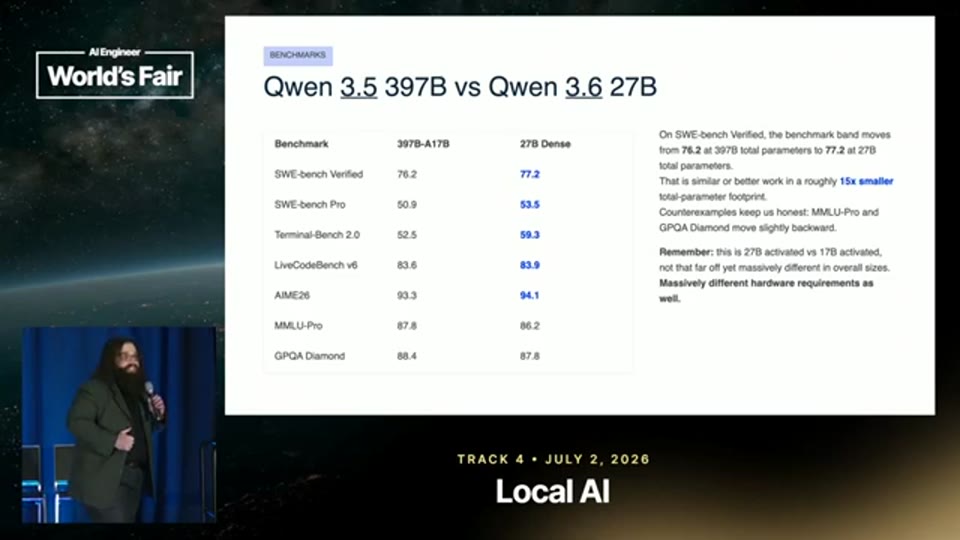
14:23 - 27B dense 모델과 훨씬 큰 MoE 모델의 벤치마크 및 활성 파라미터 차이를 비교하는 구간이다.
데스크톱 AI와 소버린 AI의 경제학
강연 후반부에서 Osman은 기술적 진보를 소버린 AI(sovereign AI)의 문제로 확장한다. 그는 소비자, 소규모 기업, 중견기업, 엔터프라이즈가 왜 자기 모델과 하드웨어를 직접 소유해야 하는지 질문한다. 클라우드 모델은 편리하지만, 사용자는 가격 정책, 사용 제한, 모델 변경, 접근권 회수, 데이터 통제 문제에 노출될 수 있다. 반면 로컬 모델은 초기 하드웨어 비용이 들더라도 장기적으로 특정 사용 사례에 맞춘 최적화와 비용 통제가 가능해진다.
이 논리는 개인 사용자에게만 해당하지 않는다. 강연자는 오픈소스 AI 생태계가 지속되려면 기업의 참여가 필요하다고 강조한다. 현재 많은 기업이 클라우드 제공자의 데이터센터 구축을 간접적으로 지원하는 방식으로 비용을 지불하고 있는데, 그 수요 일부가 자체 하드웨어와 오픈소스 스택으로 이동해야 오픈 모델 개발자와 제공자에게도 지속 가능한 인센티브가 생긴다는 것이다.
결국 강연자가 말하는 소버린 AI는 단순한 기술 취향이 아니라 인프라 소유권의 문제다. 모델을 직접 실행할 수 있다는 것은 데이터와 워크플로우, 비용 구조, 최적화 방향을 직접 통제할 수 있다는 뜻이다. 특히 모델 효율이 계속 높아진다면 오늘 산 하드웨어가 내일 더 강력한 모델을 실행할 수 있게 되므로, 로컬 AI 인프라는 시간이 지날수록 더 많은 선택지를 제공할 가능성이 있다.
GPU를 사야 하는가라는 마지막 질문
강연의 결론은 도발적인 질문으로 모인다. Osman은 RTX 3090급 GPU가 출시 이후 시간이 지났음에도 여전히 다양한 AI 작업에 활용되고 있으며, 일부 시장에서는 MSRP보다 높은 가치로 거래되는 상황을 언급한다. 그는 자신이 보유한 RTX 3090급 하드웨어를 팔지 않는 이유도 지금 당장의 현금 가치보다 1~2년 뒤 그 장비로 무엇을 할 수 있을지가 더 흥미롭기 때문이라고 말한다.
이 주장은 “GPU는 무조건 사야 한다”는 단순한 구매 권유로 읽어서는 안 된다. 강연자 본인도 이것이 금융 조언이 아니라고 명확히 말한다. 더 정확히는, 모델 효율 향상이 계속된다면 하드웨어의 가치는 고정된 것이 아니라 실행 가능한 모델의 범위와 함께 재평가될 수 있다는 관점이다. 오늘의 DGX Station이 GLM 5.2를 실행할 수 있다면, 6개월 뒤, 18개월 뒤, 2년 뒤에는 어떤 모델을 실행할 수 있을지 질문해야 한다는 것이다.
마지막에 그는 청중에게 “GPU를 사야 하는가?”라고 묻는다. 이 질문은 강연 전체의 기술적 논리를 압축한다. 클라우드 구독이 계속 보조금이 붙은 저렴한 토큰 가격으로 유지될지, 사용자가 원하는 방식으로 모델을 계속 쓸 수 있을지, 기업이 자기 데이터와 워크플로우를 얼마나 통제할 수 있을지 불확실하다면, 로컬 하드웨어는 단순한 장비가 아니라 선택권을 보존하는 인프라가 된다.
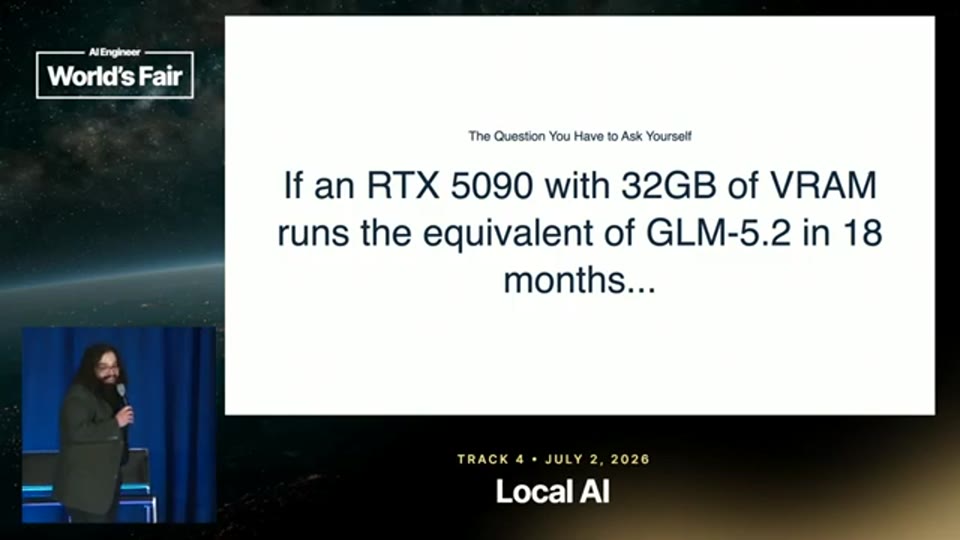
17:23 - 강연자가 최종 질문인 GPU 구매 여부를 제시하며 청중에게 화면을 보라고 요청하는 결론 구간이다.
마무리 / 핵심 정리
이 강연은 로컬 AI의 미래를 “작은 모델 대 큰 모델”의 경쟁으로 단순화하지 않는다. 대신 모델 효율, 활성 파라미터, 하드웨어 풋프린트, 컨텍스트 길이, 도구 호출, 에이전트 워크플로우를 함께 보아야 한다고 주장한다. 그 결과 데스크톱 GPU는 과거보다 훨씬 더 강력한 AI 실행 환경이 되었고, 앞으로 모델 효율이 계속 개선된다면 개인과 기업이 클라우드에 의존하지 않고도 고성능 AI를 운영할 수 있는 범위는 더욱 넓어질 수 있다.
강연자의 핵심 메시지는 소유권과 통제권으로 귀결된다. 모델을 직접 실행할 수 있다는 것은 비용을 직접 통제하고, 데이터와 워크플로우를 내부에 유지하며, 특정 사용 사례에 맞춰 모델을 최적화할 수 있다는 뜻이다. 따라서 데스크톱 프런티어는 단순히 더 빠른 GPU나 더 작은 모델의 이야기가 아니라, AI 인프라의 권력이 클라우드에서 사용자 쪽으로 일부 이동할 수 있는 가능성에 관한 이야기다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | The Desktop Frontier — Ahmad Osman, Osmantic |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-22 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
| 검증 참고 | GLM-5.2 개요, Qwen3.5 발표, Qwen3.6-27B 참고 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- 유료 AI를 위협하는 오픈소스 AI 전쟁, 지금 무슨 일이 벌어지나
- Local Models - Trust, Control, Optimization - Carter Abdallah, NVIDIA
- Running LLMs locally - Practical LLM Performance on DGX Spark
- 맥북에서 초거대 4000억 AI 돌려봤습니다… 속도도 빠르다? 한국 저자들이 개발한 Flash-MoE 분석 || 메모리는 더욱 중요해질겁니다
- Local AI models explained - How to run a fleet of Mac Studios and GPUs at home