C++이 이미 가진 패턴 매칭
📺 원본 영상: The Pattern Matching We Already Have - Braden Ganetsky - CppCon 2025 🎙️ 채널: CppCon 📅 정리 일자: 2026-03-19 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 코드 슬라이드는 포함되지 않을 수 있으며, 강연자의 설명을 바탕으로 재구성한 코드 예시는 “[재구성 코드]“로 명시합니다.
개요
C++ 커뮤니티에서 패턴 매칭(Pattern Matching)은 오랫동안 갈망해온 기능이다. Herb Sutter의 P2392나 Michael Park의 P2688 같은 제안서들이 존재하지만, C++26 표준에는 포함되지 못했다. 그러나 이 강연의 화자인 Braden Ganetsky는 역설적인 주장을 펼친다. C++은 C++98 시절부터 이미 패턴 매칭을 갖추고 있었다는 것이다. 함수 오버로드 해소(Function Overload Resolution), 템플릿 특수화(Template Specializations), 템플릿 인수 추론(Template Argument Deduction), 그리고 클래스 템플릿 인수 추론(Class Template Argument Deduction, CTAD) - 이 네 가지 메커니즘의 동작 원리를 규격(Standard) 수준에서 파헤치는 것이 이 강연의 핵심이다. Ganetsky는 캐나다 출신의 licensed professional engineer이자 C++ 표준 위원회 멤버(2023년~)로, 위니펙 C++ 개발자 밋업을 운영하고 있다.
패턴 매칭 제안서들과 C++의 현재 - 없는 게 아니라 다른 이름으로 있다
강연은 최신 패턴 매칭 제안서들에 대한 간략한 소개로 시작된다. P2392는 inspect 키워드를 접두어 방식으로 사용하며, P2688은 match를 중위 키워드로 도입한다. 두 제안서 모두 가상 소멸자를 가진 shape 기본 클래스와 이를 상속받는 circle, rectangle로 이루어진 다형성 계층 구조를 예시로 사용하는데, 각 도형의 면적을 계산하기 위해 타입에 따라 분기하는 코드를 훨씬 간결하게 표현한다.
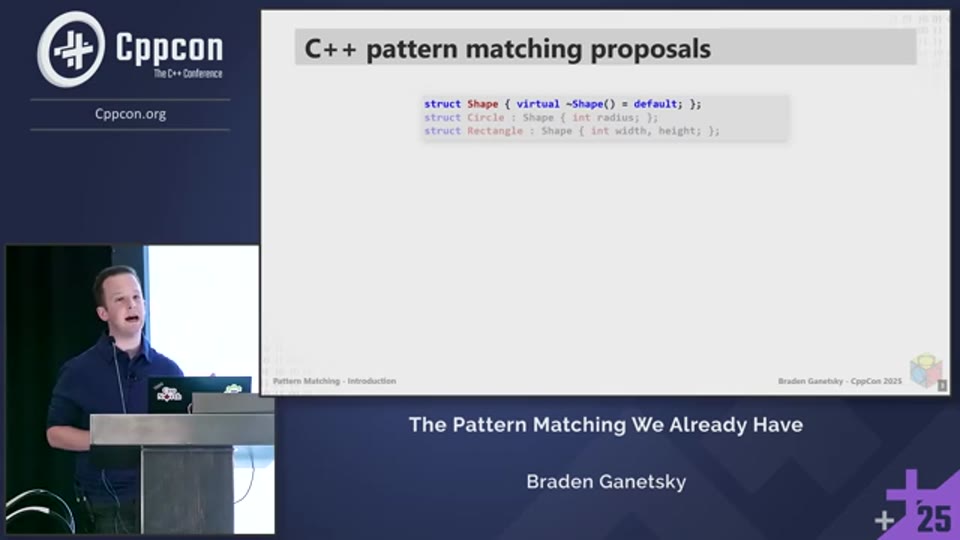
00:55 - P2392의 inspect 키워드를 사용한 shape/circle/rectangle 다형성 패턴 매칭 코드 예시 슬라이드
그러나 강연자는 명확히 선을 긋는다. “저는 crystal ball이 없습니다.” C++26 표준의 배는 이미 출항했고, 이 제안서들은 탑승하지 못했다. 따라서 현재 C++ 언어 자체에 패턴 매칭은 없는 것처럼 보인다. 하지만 정말 그럴까?
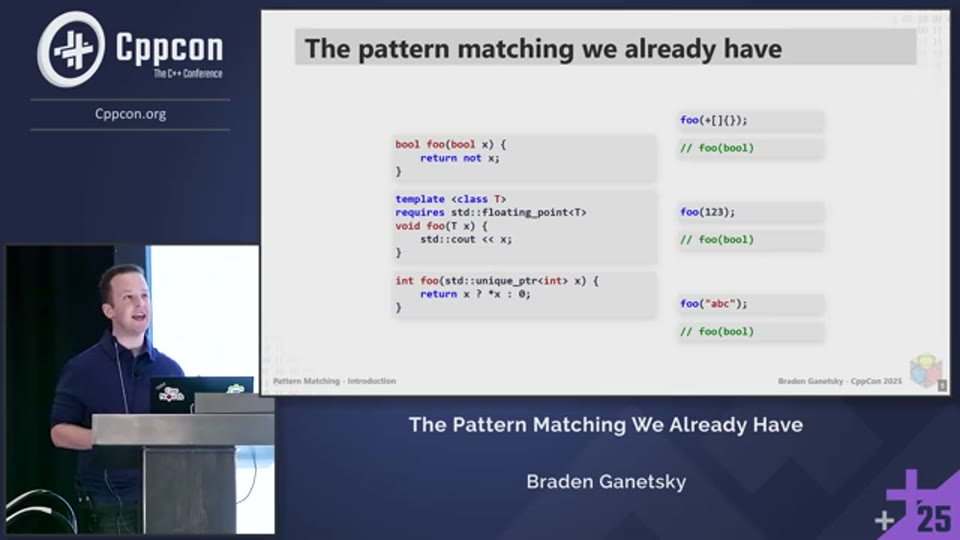
강연자는 세 개의 foo 함수를 제시하며 청중을 시험한다. 하나는 bool을 받고, 하나는 부동소수점 타입(floating point)만 받는 함수 템플릿, 하나는 unique_ptr을 받는다. 여기서 퇴화된 람다(decayed lambda), 정수 리터럴 123, 문자열 리터럴 "abc" - 이 세 가지를 각각 인자로 전달하면 어떻게 될까? 이 타입들 중 어느 것도 오버로드 집합에 직접 매칭되지 않는데도, 코드는 정상적으로 컴파일된다. 세 호출 모두 foo(bool)을 호출한다. “왜”냐는 질문이 이 강연의 출발점이다.
1장: 함수 오버로드 해소 (Function Overload Resolution)
C++ 대 C - 왜 오버로딩이 하나의 혁명이었나
함수 오버로딩은 C++98 표준부터 존재해 온 C++의 핵심 기능이다. 이 기능이 얼마나 강력한지는 같은 일을 C 언어로 구현하려 했을 때 더욱 명확해진다. 강연자에 따르면, C에서 두 개의 init 오버로드와 유사한 기능을 구현하려면 매크로 마법을 동원해야 하고, 결과물은 가독성이 극히 떨어지는 코드가 된다. 게다가 더 복잡한 경우로 확장하려 하면 C에서는 아예 불가능할 수도 있다. C++에서는 같은 이름의 함수 두 개를 선언하는 것으로 모든 것이 해결된다. 강연자는 소멸자(destructor)와 함께 이것이 C++을 C와 가장 근본적으로 차별화하는 기능 중 하나라고 강조한다.
오버로드인가, 재선언인가, 오류인가 - 직관을 깨는 규칙들
강연에서 가장 인상적인 부분 중 하나는 청중과의 인터랙티브 퀴즈다. 강연자는 다양한 함수 선언 쌍을 제시하며 이것이 재선언(re-declaration)인지, 별개의 오버로드인지, 아니면 컴파일 오류(ill-formed)인지를 묻는다. 여기서 드러나는 C++ 규칙들은 꽤 직관에 어긋나는 경우가 많다.
우선 타입 별칭(alias) 문제다. C++에서 별칭은 단순히 같은 타입에 다른 이름을 붙인 것일 뿐이다. 따라서 f(int)와 f(Int)(Int가 int의 별칭인 경우)는 두 개의 재선언이다. 반면, int와 enum E : int는 별개의 타입으로 취급되어 두 개의 오버로드가 된다. 열거형(enum)은 그 기저 타입(underlying type)과 구별되는 독립적인 타입이며, 이는 C++98 표준 자체에 명시되어 있다.
최상위 const(top-level const) 규칙도 까다롭다. 함수 매개변수에서는 최상위 const가 제거된다. 따라서 f(int)와 f(const int)는 사실 동일한 함수의 재선언이다. 언뜻 보면 다른 함수처럼 보이지만 그렇지 않다. 하지만 f(int*)와 f(const int*)는 다른 이야기다. 두 번째 경우의 const는 최상위 const가 아니라 포인터가 가리키는 대상에 대한 const이기 때문에 제거되지 않으며, 이 둘은 별개의 오버로드가 된다.
배열의 포인터 변환(array-to-pointer decay) 규칙도 있다. f(char*), f(char[]), f(char[7])은 모두 동일한 재선언이다. 함수 매개변수에서 배열은 포인터로 변환되기 때문이다. 이것이 바로 int main의 두 번째 인자가 char** argv, char* argv[], char *argv[] 등 다양한 형태로 쓰일 수 있는 이유다. 실제 함수 시그니처는 모두 이중 포인터로 동일하기 때문이다.
멤버 함수의 const 한정자와 관련해서도 흥미로운 규칙이 있다. void g()와 void g() const는 별개의 오버로드가 가능하다. 이를 통해 const 객체와 비-const 객체에 대해 다른 동작을 정의할 수 있으며, 이는 C++에서 흔히 볼 수 있는 패턴이다. 하지만 void g()와 void g() &는 ill-formed이다. L-value 참조 한정자가 있는 버전이 없는 버전을 가려버리기(shadow) 때문에, 같은 클래스 안에 두 번 선언된 셈이 되어 오류가 발생한다.
마지막으로 강연자는 잠깐 멈추고 기본 인수(default argument)와 오버로드의 조합에 대해 설명한다. 하나의 함수에 대해 여러 선언에 걸쳐 기본 인수를 단계적으로 추가하는 것은 합법적이지만, 같은 매개변수에 기본 인수를 두 번 선언하는 것은 불가능하다. 또한, 동일한 이름에 실제 인수가 없는 오버로드와 기본 인수로 모든 매개변수가 채워질 수 있는 오버로드가 동시에 존재하면, 인수 없이 호출했을 때 모호성 오류가 발생한다.
오버로드 해소의 메커니즘 - 후보를 좁혀가는 3단계
강연자는 오버로드 해소가 어떻게 작동하는지 단계별로 설명한다. 먼저 **7가지 문맥(context)**이 있는데, 강연자는 개발자 관점에서 5가지로 단순화한다. 일반 함수 호출, 객체에 대한 operator() 호출, 연산자 오버로딩, 생성자 호출, 그리고 변환 함수 관련 문맥이다. 어떤 문맥인지에 따라 후보 함수 집합(candidate set)을 모으는 방식이 달라진다.
후보 집합을 모은 뒤에는 실행 가능 후보(viable candidates) 목록으로 좁혀나간다. 인자 수가 맞지 않는 후보, 불만족된 제약(constraints, Concepts 등)을 가진 후보, 그리고 호환되지 않는 인자 타입을 가진 후보를 순서대로 제거한다. 이 단계를 거치고 나면 실행 가능한 후보들만 남는다.
마지막으로 실행 가능 후보들 중에서 **최적 후보(best candidate)**를 선택한다. 이 단계에서 **암묵적 변환 시퀀스(implicit conversion sequence)**의 개념이 등장한다. 암묵적 변환 시퀀스는 인자에서 매개변수 타입으로 변환하는 데 필요한 단계들의 순서로, 세 가지 등급이 있다. **표준 변환 시퀀스(Standard Conversion Sequence)**가 가장 높은 순위를 가지고, **사용자 정의 변환 시퀀스(User-Defined Conversion Sequence)**가 그 다음, 타원(Ellipsis) 변환 시퀀스가 가장 낮다. 이것이 처음에 제시했던 foo 예시에서 세 가지 호출이 모두 foo(bool)로 귀결되는 이유다. bool로의 변환이 표준 변환 시퀀스에 해당하고, 이것이 가변 인자(...) 버전의 타원 변환 시퀀스보다 높은 순위를 가지기 때문이다. 강연자는 “모르겠을 때 bool 오버로드가 호출되는 경우가 많다”며 이를 기억할 만한 포인트로 짚어준다.
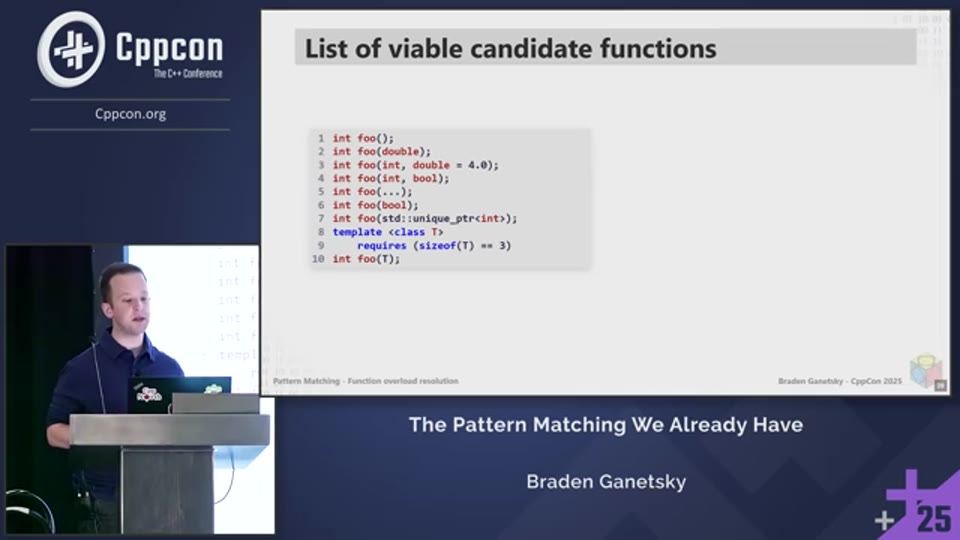
15:52 - 8개의 foo 오버로드 후보(variadic, double, int, bool, template 등)에서 nullptr_t 인자로 최적 후보를 좁혀가는 과정
2장: 템플릿 특수화 (Template Specializations)
C++ 표준 스스로가 인정한 “패턴 매칭”
C++ 표준 자체가 이미 답을 제공하고 있다. C++98 표준의 해당 섹션 제목은 “Matching of Class Template Partial Specializations(클래스 템플릿 부분 특수화의 매칭)“이다. 강연자에게 이것은 일종의 공식적인 인정이었다. 자신이 패턴 매칭을 본다고 생각한 것이 단순한 착각이 아니었던 것이다. 미래 C++ 버전의 패턴 매칭 제안에서 match 키워드로 표현할 수 있는 것을 C++ 템플릿은 기본 템플릿(primary template)과 부분 특수화(partial specialization)의 조합으로 이미 구현하고 있다. 그 대표적인 예가 C++11에서 도입된 타입 트레이트(type traits)들이다. std::is_same, std::remove_const 등은 모두 이 메커니즘 위에 구축되어 있다.
03:08 - isSame 구조체 템플릿 - 부분 특수화가 패턴 매칭임을 보여주는 핵심 예시 코드
세 가지 핵심 개념 - 해부학적 분석
세 가지 개념을 구분하는 것이 이후 내용 이해의 전제조건이다. **기본 템플릿(primary template)**은 template<typename T, typename U> 형태의 템플릿 헤드를 갖고, 클래스 이름 뒤에 <...> 없이 선언된다. **부분 특수화(partial specialization)**는 역시 template<...> 형태의 헤드를 갖지만, 클래스 이름 뒤에 템플릿 인수 목록을 명시한다. 강연자의 직관적인 설명에 따르면, 부분 특수화는 “지금 막 작성한 템플릿 매개변수들을 기본 템플릿에 다시 전달하는 것”으로 상상하면 이해하기 쉽다. 예컨대 기본 템플릿이 MyTrait<T>라면, 부분 특수화 template<typename T> MyTrait<T*>는 “T가 어떤 타입의 포인터일 때”라는 매칭 조건을 표현한다. **명시적 특수화(explicit specialization)**는 template<>라는 빈 헤드를 가지며, 완전히 구체적인 타입을 명시하는 특수화다.
이 세 가지의 특이한 점 중 하나는 각각의 본문이 서로 아무런 관련이 없어도 된다는 것이다. 기본 템플릿, 부분 특수화, 명시적 특수화는 전혀 다른 멤버를 가질 수 있으며, 컴파일러는 이를 전혀 문제 삼지 않는다. 물론 실제 코드 유지보수성을 위해서는 권장되지 않지만, 이것이 가능하다는 사실 자체가 템플릿 특수화의 유연성을 보여준다. 강연자는 C++98 표준에 담겨 있는 유명한 limerick을 언급하며 경고한다. 특수화를 올바른 순서로 정의하지 않으면 코드가 예상대로 작동하지 않을 수 있으며, 명시적 특수화와 명시적 인스턴스화(explicit instantiation)는 자주 혼동되는 완전히 다른 개념이라는 점도 덧붙인다.
부분 특수화 매칭의 알고리즘 - 가상 함수로의 재작성
부분 특수화들 사이에서 어떤 것을 선택할지 결정하는 과정은 그 자체로 아름다운 알고리즘이다. C++ 표준은 이것을 함수 템플릿 인수 추론(template argument deduction)으로 명세한다. 구체적으로는, 각각의 부분 특수화를 마치 함수 템플릿인 것처럼 재작성한 “가상 함수(imaginary function)“들을 만들고, 이 함수들에 대해 오버로드 해소와 템플릿 인수 추론을 수행하여 최적의 특수화를 결정한다.
강연자는 struct A<T1, T2>에 두 개의 부분 특수화를 예시로 사용한다. 하나는 첫 번째 인수가 포인터 타입(T1*)일 때 매칭되고, 다른 하나는 두 번째 인수가 포인터 타입(T2*)일 때 매칭된다. A<int, int>는 어느 조건도 만족하지 않으므로 기본 템플릿이 사용되고, A<int*, int>는 첫 번째 부분 특수화, A<int, int*>는 두 번째 부분 특수화가 사용된다. 여기까지는 직관적이다. 그런데 A<int*, int*>처럼 두 조건을 모두 만족하는 경우에는 어떻게 될까? 두 부분 특수화 모두 매칭되지만, 어느 쪽이 더 나은지 결정할 수 없어 모호성(ambiguity) 컴파일 오류가 발생한다.
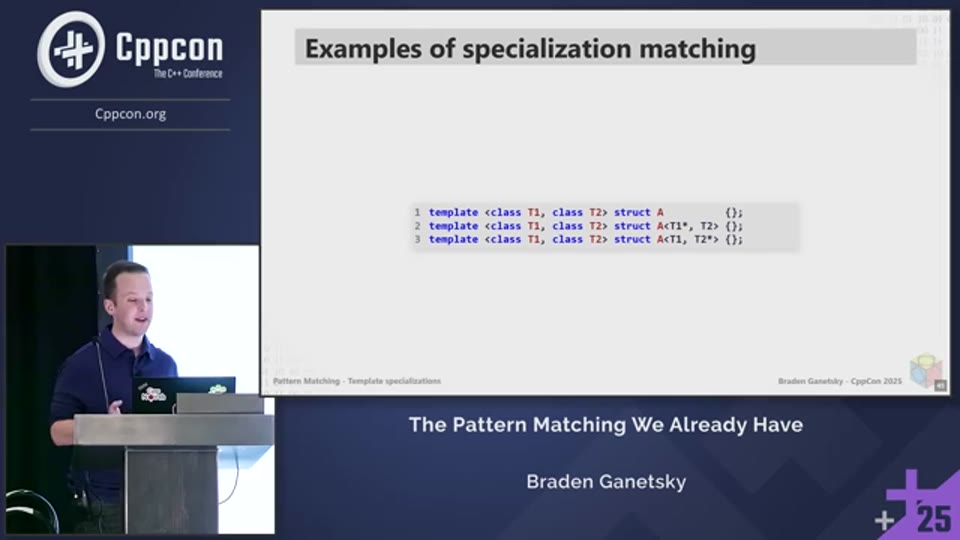
25:13 - struct A의 두 부분 특수화 - 포인터 타입 매칭 예시와 A<int, int*>의 모호성 발생 케이스*
이를 해결하려면 세 번째 부분 특수화를 추가하면 된다. 두 인수 모두 포인터 타입인 경우(T1*, T2*)를 명시적으로 처리하는 것이다. 이 새로운 특수화는 기존 두 가지보다 더 특수화되어 있으므로, 오버로드 해소에서 “더 나은 매칭”으로 선택된다.
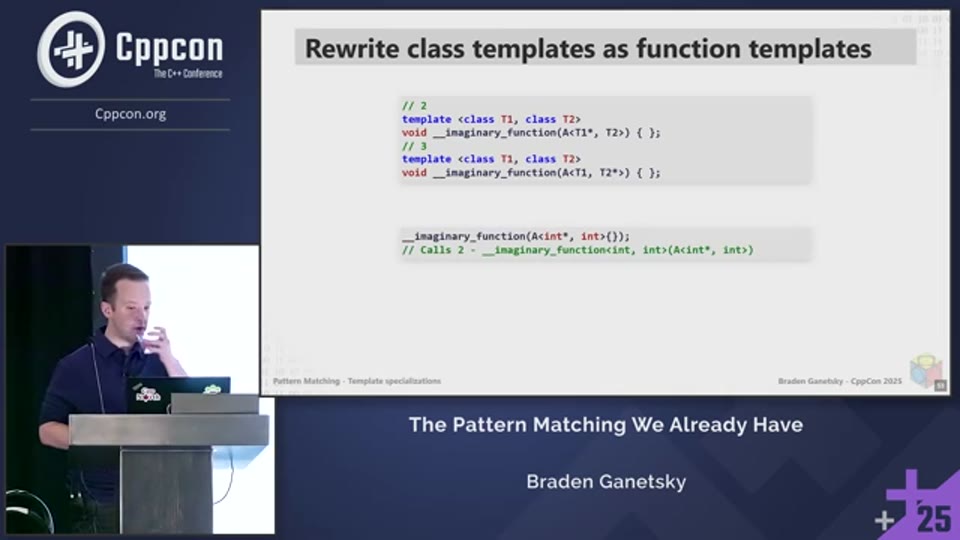
29:05 - 부분 특수화를 가상 함수로 재작성(imaginary functions)하여 매칭을 수행하는 과정 슬라이드
3장: 템플릿 인수 추론 (Template Argument Deduction)
“<int>를 쓰지 않아도 되는 이유” - 너무나 당연해서 잊은 마법
std::vector<int>를 받는 함수 템플릿을 작성해본 사람이라면 누구나 이런 코드를 써봤을 것이다. 함수 템플릿 foo에 vec을 전달할 때, foo<int>(vec)이 아닌 그냥 foo(vec)이라고 쓸 수 있다. 너무나 당연하게 느껴지지만, 강연자는 여기서 멈추고 “왜 그럴 수 있는가?”라는 질문을 던진다. 그 답이 바로 템플릿 인수 추론(Template Argument Deduction)이다. C++98 표준부터 존재해 온 이 기능은 컴파일러가 함수 인자의 타입을 보고 템플릿 매개변수가 무엇인지 자동으로 추론하게 해준다. 이 덕분에 복잡하게 중첩된 템플릿 컨텍스트에서도 <> 안에 타입을 일일이 명시할 필요가 없어졌고, C++11에서 추가된 포워딩(forwarding) 시맨틱스도 이를 기반으로 구축되어 있다.
손으로 직접 하는 템플릿 인수 추론 - 재귀적 패턴 매칭
강연의 백미 중 하나는 템플릿 인수 추론을 단계별로 손으로 직접 해보는 부분이다. 추론의 핵심은 특수 형태(special forms) 목록이다. 매개변수와 인수를 이 특수 형태들에 대입하여 재귀적으로 패턴을 매칭해나가는 것이 추론의 본질이다. 특수 형태의 종류로는 선택적 const/volatile을 가진 T, T*(포인터), T&(L-value 참조), T&&(R-value 참조), T[N](배열), 함수 타입, 포인터-to-멤버, 그리고 Template<T...> 형태의 템플릿 템플릿 등이 있다.
강연자는 세 가지 수준의 예시를 통해 이 과정을 보여준다. 첫 번째로, T*를 매개변수로 받는 foo에 std::vector<int>*를 전달하면, 매개변수와 인수 모두 T* 형태이므로 *를 제거하면 T = std::vector<int>가 된다. 두 번째로, std::vector<T>*를 매개변수로 받는 경우, 먼저 포인터를 제거하여 std::vector<T> = std::vector<int>를 얻고, 그 다음 템플릿 템플릿 형태를 매칭하여 T = int를 얻는다. 세 번째로, 매개변수가 템플릿 템플릿 매개변수 Vec<T...>을 사용하는 경우, Vec = std::vector이고 T = int라는 두 가지 추론 결과를 동시에 얻는다. 강연자는 “오늘 여기서 손으로 직접 템플릿 인수 추론을 해봤습니다”라고 말하며, 이것이 생각보다 직관적임을 강조한다.
이 예시에서 흥미로운 사이드 토픽이 하나 등장한다. std::vector는 사실 두 개의 템플릿 매개변수(타입과 allocator)를 갖는다. 따라서 템플릿 템플릿 매개변수에서 ... 가변 인수를 사용하는 것이 중요한데, 청중의 지적에 의해 C++20 이전에는 이것이 필수였지만 C++20부터는 기본 allocator가 완전히 기본화되어 상황이 달라졌다는 흥미로운 논의가 이루어진다.
추론 실패의 함정 - max(1, 2.0)이 왜 안 되는가
같은 템플릿 매개변수 T가 여러 매개변수-인수 쌍에서 서로 다른 타입으로 추론될 경우 컴파일이 실패한다는 점이 중요하다. 강연자는 max(T a, T b) 예시로 이를 설명한다. 이 함수에 max(1, 2.0)처럼 int와 double 혼합 인자를 전달하면, 첫 번째 쌍에서 T = int, 두 번째 쌍에서 T = double이라는 모순이 발생하여 컴파일러는 어떤 인스턴스화를 해야 할지 결정할 수 없다. 강연자는 청중 대다수가 고개를 끄덕이는 것을 보며 “공감의 고개 끄덕임”이라고 표현한다. 이 상황에서 max<int>(1, 2.0)처럼 템플릿 인수를 명시적으로 지정하면 컴파일이 된다.
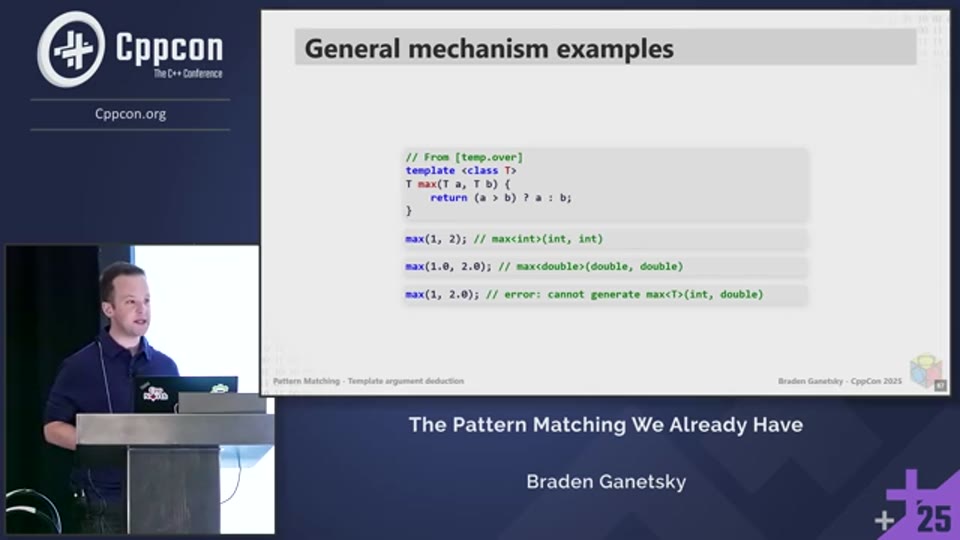
44:06 - max(1, 2.0) 호출 시 T가 int와 double로 동시에 추론되어 실패하는 템플릿 인수 추론 오류 예시
비추론 문맥 (Non-Deduced Contexts) - 의도적인 추론 비활성화
때로는 특정 매개변수 위치에서 템플릿 인수를 추론하지 않는 것이 의도적으로 필요하다. 이를 **비추론 문맥(Non-Deduced Context)**이라 한다. 표준에는 10가지 경우가 있지만, 강연자는 실용적으로 중요한 세 가지를 소개한다.
첫 번째는 **중첩 이름 한정자(nested name specifier)**를 포함하는 경우다. typename S<T>::type처럼 가장 오른쪽 범위 연산자(::)의 왼쪽에 있는 모든 것은 비추론 문맥이다. S<T>에는 다른 특수화가 존재할 수 있고, 그 특수화가 type을 다른 타입으로 정의할 수 있으므로 컴파일러는 T를 역으로 추론할 수 없다. 이것이 std::type_identity_t<T> 같은 _t 접미사 별칭들이 실제로는 std::type_identity<T>::type의 별칭임을 이해하는 데 중요한 이유다.
두 번째는 std::type_identity를 통한 의도적 비추론 문맥 활용이다. max 문제로 돌아가서, 두 번째 매개변수를 std::type_identity_t<T>로 감싸면, 두 번째 매개변수-인수 쌍은 추론에 참여하지 않는다. 첫 번째 매개변수에서만 T가 추론되고, 두 번째 인수는 그 추론된 T로 암묵적 변환된다. 이렇게 하면 max(1, 2.0)도 컴파일되며, T = int로 추론된다. 물론 이것은 함수 정의를 수정할 수 있는 경우에만 가능하다.
세 번째는 **중괄호 초기화 목록(braced-init-list)**을 인자로 전달하는 경우다. std::vector<T>를 받는 함수에 {1, 2, 3}을 전달하면 T를 추론할 수 없다. 매개변수가 std::initializer_list가 아닌 상태에서 인자가 중괄호 초기화 목록이면 비추론 문맥이 된다는 규칙이 표준에 명시되어 있다. 강연자는 이것이 많은 C++ 개발자가 한 번쯤은 겪어봤을 상황이라고 말한다. 규칙이 복잡해서가 아니라, 너무나 자연스럽게 이렇게 작성했다가 컴파일 오류를 만난 경험이 있을 것이라는 뜻이다.
포워딩 참조와 참조 축약 - 완전 포워딩의 비밀
강연자에 따르면, 이 강연을 쓰게 된 직접적인 계기가 바로 포워딩 참조(Forwarding Reference)의 동작 방식이었다. T&& 형태(함수 자체의 템플릿 매개변수에 대한 R-value 참조)는 표준에서 “Heisen reference”라고도 불리며, L-value 인자를 받으면 T가 L-value 참조로 추론되는 특수한 규칙이 적용된다.
int i = 0; f(i);처럼 L-value를 전달하면 어떻게 될까? 매개변수 T&&와 인자 int&를 매칭할 때, int&는 사실상 int& &&와 동일하다(L-value 참조에 임의의 R-value 참조를 추가해도 동일하다). 따라서 형태 T&&에 매칭하면 T = int&가 된다. 그러면 매개변수 타입은 int& &&인데, 참조 축약(reference collapsing) 규칙에 의해 이것은 int&로 축약된다. 규칙은 간단하다. 참조 체인에 L-value 참조가 하나라도 있으면 최종 결과는 L-value 참조가 되고, R-value 참조끼리만 연결된 경우에만 R-value 참조가 된다.
반면 R-value를 전달하면(f(0)), 매개변수 T&&와 인자 int&&를 직접 매칭하여 T = int가 추론된다. 이것이 더 단순하다. 강연자는 “L-value 케이스가 더 단순할 것이라고 생각했는데 오히려 더 복잡했고, R-value 케이스가 더 간단했다는 것에 놀랐다”고 고백하며, 이 과정을 직접 단계별로 추적해서야 비로소 완전히 이해했다고 말한다. 이것이 완전 포워딩(Perfect Forwarding) 원리의 핵심이며, std::forward가 동작하는 기반이 된다.
4장: 클래스 템플릿 인수 추론 (CTAD, Class Template Argument Deduction)
C++17의 선물 - 타입을 명시하지 않아도 되는 시대
C++17에 도입된 CTAD는 클래스 템플릿을 인스턴스화할 때 생성자 인자로부터 템플릿 인수를 자동으로 추론할 수 있게 해준다. std::pair p(1, 2.0);이라고 쓰면 컴파일러는 p의 타입이 std::pair<int, double>임을 알아낸다. 마찬가지로, int를 반환하는 함수의 결과를 받을 때 std::vector v = foo();라고 쓰면 v의 타입이 std::vector<int>로 추론된다. 여기서 std::pair나 std::vector는 강연자의 표현에 따르면 “타입에 대한 placeholder”다. 구체적인 타입이 아니라, 추론을 통해 구체적인 타입으로 채워질 자리를 의미한다.
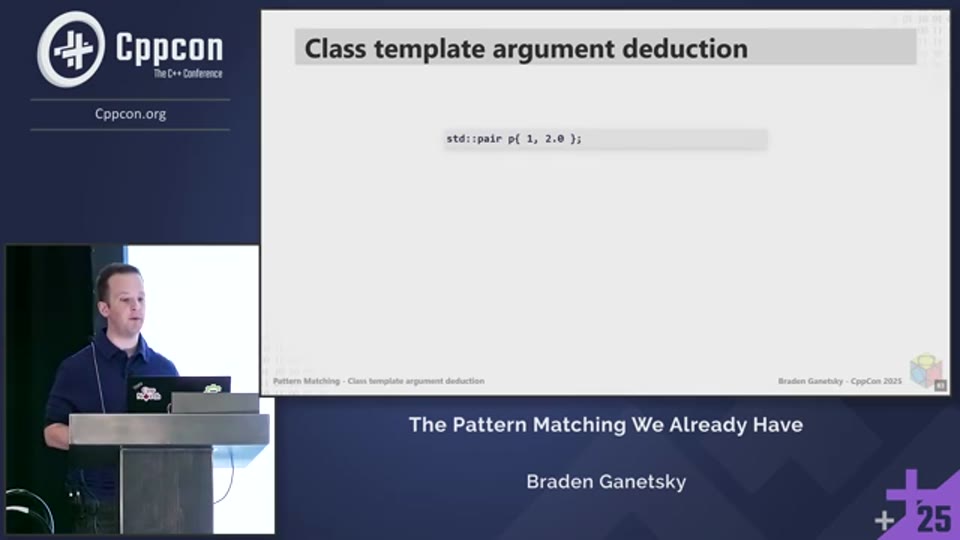
55:51 - CTAD 예시 - std::pair p(1, 2.0)에서 std::pair<int, double>로 타입이 추론되는 과정
생성자 기반 가상 함수 집합 - CTAD의 내부 메커니즘
CTAD의 동작 원리는 앞서 살펴본 “부분 특수화를 가상 함수로 재작성”하는 방식과 유사하다. 각 생성자마다 대응되는 가상 함수(guide)를 생성하는데, 이 가상 함수는 생성자와 같은 매개변수를 받고, 반환 타입은 해당 클래스 템플릿의 인스턴스 타입이다. 그런 다음 이 가상 함수들에 대해 오버로드 해소와 템플릿 인수 추론을 수행하고, 최종 선택된 가상 함수의 반환 타입이 실제로 추론된 클래스 타입이 된다.
강연자는 두 개의 생성자를 가진 MyStruct 예시를 통해 이 과정을 보여준다. 하나는 std::vector<T>와 double을 받는 비-템플릿 생성자이고, 다른 하나는 T와 std::pair<U, char>를 받는 템플릿 생성자다. 특정 인자 조합에서는 두 가지 가상 함수 모두 매칭되어 모호성 오류가 발생할 수 있다. 이때, 비-템플릿 생성자(구조체는 템플릿이지만 생성자 자체는 템플릿이 아닌 경우)가 더 구체적이므로 우선 선택되는 경우도 있지만, 조건에 따라서는 진짜 모호성이 발생한다.
추론 가이드(Deduction Guide) - 모호성을 내 뜻대로 해소하는 도구
모호성이 발생할 때, 혹은 기본 추론 동작을 커스터마이즈하고 싶을 때 사용하는 도구가 **추론 가이드(Deduction Guide)**다. 클래스 템플릿 정의 이후에 선언하며, “이러한 인자 조합에 대해 이 타입으로 추론하라”는 명시적 규칙을 제공한다. 내부적으로는 추론 가이드도 하나의 가상 함수를 가상 함수 집합에 추가하는 방식으로 작동하며, 이를 통해 원하는 특수화가 선택되도록 유도할 수 있다.
그러나 추론 가이드를 사용할 때 중요한 주의점이 있다. 추론 가이드의 반환 타입은 반드시 실제로 존재하는 생성자에 대응해야 한다. 만약 가이드의 반환 타입으로 추론된 MyStruct<T, U>와 일치하는 생성자가 없다면, CTAD 자체는 성공했더라도 이후 “이 타입의 객체를 만들 수 있는 생성자를 찾는” 단계에서 실패하게 된다. 추론 가이드는 단순히 타입 추론을 가이드하는 것이지, 생성자를 대체하지 않는다는 점을 명심해야 한다.
마무리 - C++은 이미 패턴 매칭을 갖고 있다
강연의 결론은 명확하다. 새로운 inspect나 match 키워드가 없어도, C++은 이미 강력한 패턴 매칭 메커니즘을 갖추고 있다. 함수 오버로드 해소, 템플릿 특수화, 템플릿 인수 추론, 그리고 CTAD는 서로 다른 이름을 가지고 있지만 본질적으로 “이 패턴에 맞는 것을 골라라”는 패턴 매칭의 원리를 구현하고 있다. 강연자는 “내가 규격을 읽었으니 여러분은 읽지 않아도 됩니다”라는 말과 함께, 이 메커니즘들의 일반적인 규칙은 우아하지만 엣지 케이스는 매우 복잡하다는 점을 솔직하게 인정한다.
가장 중요한 메시지는 **아날로그 추론(analog reasoning)**의 가치다. 우리가 코드를 볼 때 컴파일러가 어떤 선택을 내릴지 직관적으로 이해하고 예측할 수 있는 능력은 하나의 근육이다. C++을 단순히 문법 규칙의 집합으로 외우는 것이 아니라, 그 규칙들이 왜 그렇게 생겼는지를 이해하는 논리적 추론 능력을 길러야 한다. 청중의 마지막 질문에서 “더 배우려면 어디를 보면 되냐”는 물음에 강연자는 Jason Turner의 방법, 즉 Compiler Explorer(godbolt.org)를 열고 직접 시도해보는 것을 추천했다. 이론과 실험을 병행하는 것이 C++ 규격의 깊은 부분을 이해하는 가장 효과적인 방법이기 때문이다.
📚 참고 - 추가 학습 자료
⚠️ 강연 내용과 별개로, 이 강연에서 다루는 주제들을 더 깊이 공부하고 싶다면 다음 자료들이 도움이 될 수 있습니다.
- cppreference.com: 함수 오버로드 해소, 템플릿 인수 추론, CTAD에 관한 규격 수준의 상세 설명과 예제를 제공합니다. 강연자가 직접 참고한 자료이기도 합니다.
- Compiler Explorer (godbolt.org): 강연자가 직접 추천한 학습 방법입니다. 코드를 작성하고 다양한 컴파일러의 반응을 실시간으로 확인할 수 있습니다.
- ISO C++ 표준 문서: 강연자는
over.load,temp.deduct,over.match등 구체적인 표준 섹션들을 언급했습니다. 초안 버전은 공개적으로 접근 가능합니다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | The Pattern Matching We Already Have - Braden Ganetsky - CppCon 2025 |
| 채널 | CppCon |
| 리포트 작성 | 2026-03-19 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.