Durable Agent를 만드는 두 가지 길: Replay vs. Snapshot
📺 원본 영상: Two Roads to Durable Agents: Replay vs. Snapshot — Eric Allam, Trigger.dev 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-11 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 Trigger.dev의 공동 창업자 Eric Allam이 AI 에이전트를 프로덕션 환경에 배포할 때 마주치는 핵심 난제인 “내구성(Durability)“을 주제로 다룬다. 강연자는 1993년 CGI부터 현재의 LLM 에이전트까지 백엔드 인프라의 역사를 짚어가며, 기존의 Replay 기반 내구성 실행 모델이 에이전트 시대에 왜 한계를 드러내는지 설명한다. 그리고 이에 대한 대안으로 Context 로그와 Execution 스냅샷(Snapshot)을 결합한 새로운 접근법을 제시하며, Trigger.dev가 Firecracker microVM을 통해 이를 실제 구현한 경험을 공유한다.
30년의 유산: Stateless Compute와 Shared Nothing 아키텍처
백엔드 인프라의 역사는 사실 “상태(State)를 어디에 둘 것인가”에 대한 오랜 질문의 역사다. 1993년 등장한 CGI(Common Gateway Interface)는 가장 원초적인 형태의 동적 웹 백엔드였다. HTTP 요청이 들어오면 서버는 새 프로세스를 fork하고, 해당 프로세스가 작업을 처리한 뒤 표준 출력으로 응답을 쓰고 사라지는 구조였다. 완전히 무상태(Stateless)한 모델이었다.
이후 PHP가 등장하고 LAMP 스택이 자리잡으면서 프로세스 재사용이 가능해졌지만, 핵심 원칙은 달라지지 않았다. “요청(Request) + 데이터베이스(DB) = 응답(Response)“이라는 공식이 그것이다. 컴퓨팅 레이어에는 의미 있는 상태가 없고, 모든 상태는 데이터베이스에 있다는 이 개념은 Shared Nothing 아키텍처라는 이름으로 정착되었다. Eric Allam이 강조하듯, Ruby on Rails, Node.js, 서버리스(Serverless)에 이르기까지 이후 30년간 등장한 모든 백엔드 패러다임은 이 원칙을 계승했다.
비동기 작업과 Replay 모델의 등장
웹 애플리케이션이 점차 복잡해지면서 요청-응답 사이클 밖에서 처리해야 하는 부수 효과(Side Effect)들이 생겨나기 시작했다. 이메일 발송, 결제 처리, 이미지 리사이징처럼 단순한 것들로 시작했지만, 이내 여러 단계가 연쇄되는 복잡한 비동기 작업으로 발전했다. 강연자가 예로 드는 “주문 처리(Process Order)” 워크플로우가 대표적이다. 결제 → 영수증 발송 → 배송 알림 같은 흐름에서 중간 단계가 실패했을 때 전체를 다시 실행하면 결제가 두 번 청구되는 것처럼 심각한 부작용이 발생할 수 있었다.
이 문제를 해결하기 위해 약 10~15년 전부터 워크플로우 엔진(Workflow Engine) 또는 **내구성 실행 엔진(Durable Execution Engine)**이 채택되기 시작했다. 핵심 아이디어는 모든 부수 효과를 “스텝(Step)“으로 감싸는 것이다. 각 스텝은 실행되는 즉시 캐싱되어 리플레이 저널(Replay Journal)에 기록된다. 덕분에 워크플로우가 중간에 실패하더라도 재실행 시 이미 완료된 스텝은 건너뛰고 실패한 지점부터 이어갈 수 있게 된다. 강연자는 이 패러다임을 Replay 모델이라고 부른다. 기존의 Stateless 컴퓨트 아키텍처 위에서 내구성 실행을 구현하고, 덤으로 실행 히스토리와 감사 로그(Audit Trail)까지 얻을 수 있다는 점에서 큰 인기를 끌었다.
LLM의 등장과 Replay 모델의 균열
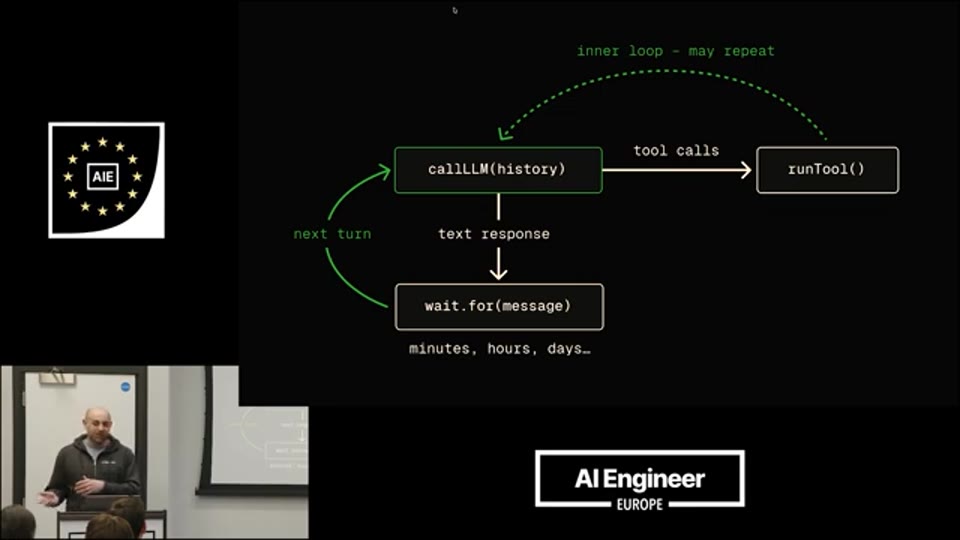
2023년 LLM이 주류로 떠올랐을 때, 처음에는 기존 패러다임에 자연스럽게 흡수되는 듯 보였다. LLM 호출은 그저 워크플로우의 한 스텝이 되었고, 텍스트 분류처럼 단순한 작업에는 충분히 잘 맞았다. 그러나 Tool Calling 기능이 성숙해지면서 **에이전트 루프(Agent Loop)**라는 개념이 등장하자 상황이 근본적으로 달라졌다. 이전까지는 코드가 LLM을 오케스트레이션했다면, 이제는 LLM이 코드를 오케스트레이션하게 된 것이다.
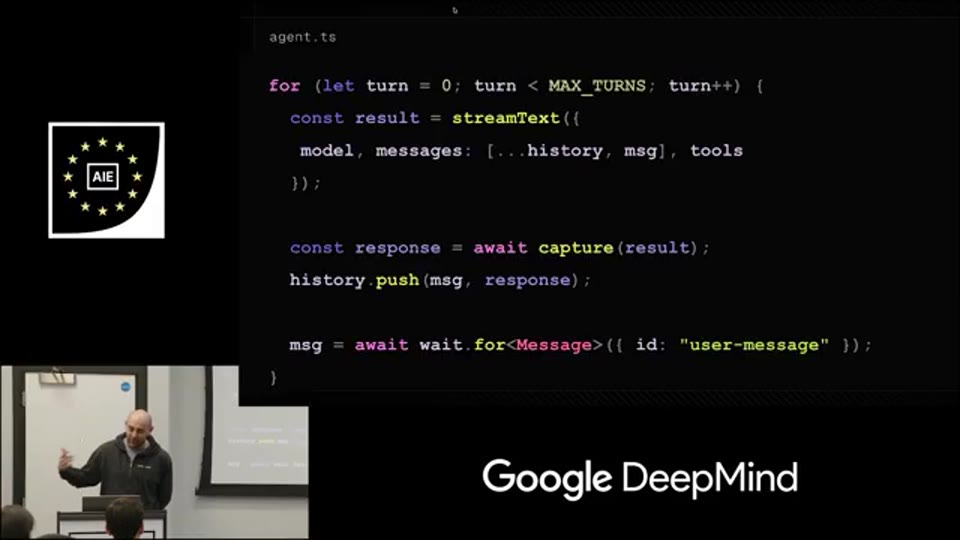
00:27 - 에이전트 루프(턴 루프 + LLM 루프) 구조 다이어그램
이 에이전트 루프에 Replay 모델을 적용하면 어떻게 될까. LLM 호출 하나하나, 툴 호출 하나하나가 모두 리플레이 저널의 엔트리가 된다.
05:54 - 단일 LLM 턴 후 리플레이 저널(Replay Journal) 상태
에이전트가 한 턴을 마칠 때마다 로그가 불어나고, 상호작용이 계속될수록 로그는 기하급수적으로 커진다.
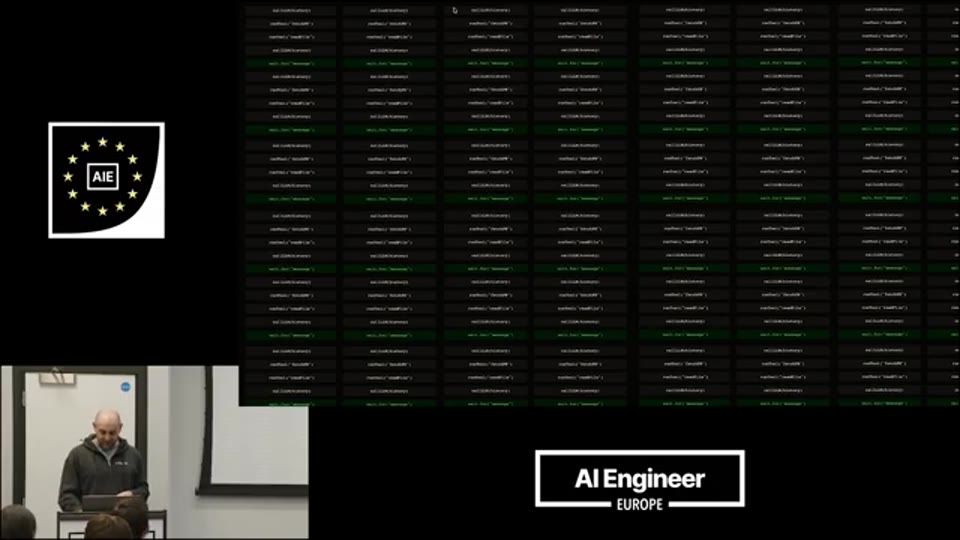
06:16 - 에이전트 상호작용이 쌓임에 따라 리플레이 로그가 계속 증가하는 모습
결국 리플레이 시스템의 근본적인 한계, 즉 엔트리 수의 상한이나 엔트리 크기의 제한에 부딪히게 된다. 강연자는 에이전트가 의미 있는 작업을 수행할 수 있는 시간이 4~7개월마다 두 배씩 늘어나고 있으며, 현재 “수 시간” 수준에서 머지않아 “며칠” 수준으로 증가할 것이라고 전망한다. Replay 모델이 감당하기에는 너무 긴 세션이다.
강연자는 이 차이를 명확하게 표현한다. “Replay는 우리에게 내구성 있는 트랜잭션(Transaction)을 줬다. 그러나 에이전트는 트랜잭션이 아니라 세션(Session)이다.” 멀티스텝 워크플로우는 시작과 끝이 있지만, 에이전트 세션은 사용자가 원하는 한 계속 이어진다. 이 근본적인 성격 차이가 Replay 모델로는 에이전트를 온전히 지원할 수 없음을 보여준다.
에이전트 내구성의 두 축: Context와 Execution
에이전트를 처음 원칙(First Principles)에서 다시 설계한다면 내구성을 어떻게 확보할 수 있을까. Eric Allam은 에이전트를 두 개의 반쪽으로 구분한다.
첫 번째 반쪽은 **컨텍스트(Context)**다. 시스템 메시지, 사용자 메시지, 툴 호출과 결과, 어시스턴트 응답, 즉 LLM에 들어가고 나온 모든 것이 여기에 해당한다. 이 컨텍스트는 본질적으로 **추가만 가능한 로그(Append-Only Log)**다. 데이터베이스, 오브젝트 스토리지, 분산 파일 시스템 등 이미 존재하는 수많은 기술로 쉽게 내구성을 부여할 수 있다. 컨텍스트 로그가 안전하게 저장되면 코드 버전이 바뀌어도 같은 컨텍스트를 이어받아 에이전트를 계속 실행할 수 있고, 머신이 다운되더라도 마지막 지점부터 재개할 수 있게 된다. Append-Only 로그는 확장성(Scalability) 측면에서도 유리하다.
두 번째 반쪽은 **실행 레이어(Execution Layer)**다. 고도화된 에이전트는 단순히 LLM을 호출하는 것에 그치지 않는다. GitHub 저장소를 클론하고, 패키지를 설치하고, 데이터셋을 메모리에 올리고, 개발 서버를 돌리는 등 컴퓨팅 레이어에 방대한 상태를 축적한다. 이 실행 레이어의 상태는 로그로는 표현할 수 없다. 재현하려면 동일한 과정을 전부 다시 수행해야 한다.
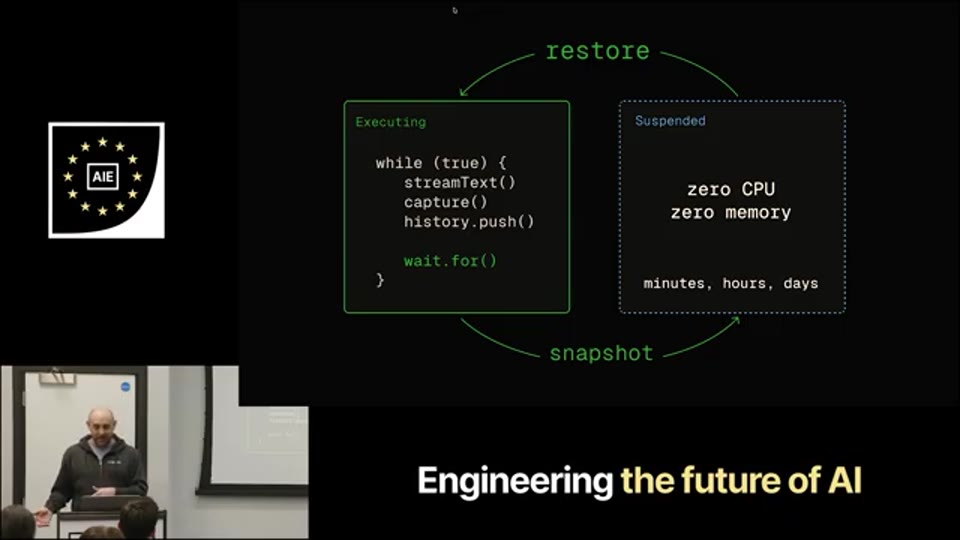
09:38 - 스냅샷 & 복원(Snapshot & Restore) 흐름 다이어그램 - 컨텍스트 로그와 실행 레이어의 분리
스냅샷 복원(Snapshot & Restore): 오래된 아이디어의 귀환
실행 레이어의 내구성을 확보하는 해법으로 강연자가 제시하는 것이 바로 **스냅샷 & 복원(Snapshot & Restore)**이다. 사용자의 다음 메시지를 기다리는 동안 머신을 계속 켜두는 것은 비용이 너무 크다. 그 대신 에이전트가 대기 상태에 들어갈 때 머신의 상태 전체를 스냅샷으로 찍어 디스크에 저장하고 종료한다. 사용자 메시지가 오면 스냅샷을 복원해 정확히 중단된 지점부터 이어서 실행하는 것이다. 이로써 에이전트는 턴과 턴 사이에 내구성을 확보하고, 에이전트가 수행하던 모든 것을 보존하며, 상시 가동보다 훨씬 저렴하게 운영할 수 있게 된다.
흥미롭게도 이 아이디어는 새로운 것이 아니다. 강연자는 1966년 IBM 메인프레임까지 거슬러 올라간다. 수 시간이 걸리는 고비용 작업을 실행하다 오류가 발생하면 처음부터 다시 돌릴 수 없었기 때문에, 체크포인트(Checkpoint)를 코드에 삽입하는 방식을 이미 사용하고 있었다. 기본 개념은 60년 전에 이미 있었던 것이다.
CRIU에서 Firecracker까지: Trigger.dev의 실전 구현
CRIU: 프로세스 단위 스냅샷의 시대
보다 현대적인 맥락에서 스냅샷 복원 기술의 출발점은 2011년에 개발된 **CRIU(Checkpoint/Restore In Userspace)**다. CRIU는 사용자 공간(User Space)에서 프로세스를 일시 중단하고 복원하는 기능을 제공한다. 프로세스에 일종의 “기생자(Parasite)“를 주입해 모든 메모리 상태를 덤프한 뒤 흔적을 제거하는 방식으로 작동하며, 컨테이너 런타임과 호환된다는 장점이 있다. Trigger.dev는 2024년에 이를 실제 배포에 적용하여 수백만 건의 스냅샷 복원을 수행했다. 프로세스 입장에서는 스냅샷이 진행되는 것을 인지하지 못한다는 점에서 완전히 투명하게 작동한다.
그러나 CRIU에는 구조적인 한계가 있다. 스냅샷 대상이 단일 프로세스에 한정되기 때문에 FFmpeg나 Chrome처럼 외부 프로세스를 함께 사용하는 경우 제대로 동작하지 않는다. 또한 스냅샷 시점에 열려 있는 파일만 캡처하므로 파일 시스템 상태를 완전히 보존하기 어렵다. 컨테이너 레지스트리를 통해 스냅샷을 push/pull해야 하는 구조적 오버헤드도 속도를 크게 저하시킨다.
Firecracker microVM: 머신 전체를 스냅샷하다
이 한계를 돌파하기 위해 Trigger.dev는 작년에 Firecracker microVM으로 전환했다. Firecracker는 AWS에서 개발한 경량 가상 머신 기술로, VM 전체를 스냅샷할 수 있다. 프로세스 하나가 아니라 VM에서 실행 중인 모든 것, 즉 파일 시스템, 열린 네트워크 연결, 메모리 전체가 스냅샷에 포함되며 복원 시 중단된 지점부터 그대로 이어진다.
단순하게 구현하면 메모리 용량만큼의 스냅샷이 생성된다는 문제가 있다. 기본 머신 사이즈 512MB를 기준으로 스냅샷 하나가 512MB가 되는 것이다. 네트워크 전송 비용과 스토리지 비용 모두 부담스럽고, 실제로 사용 중인 메모리보다 훨씬 많은 데이터를 저장하게 된다.
Trigger.dev는 이를 **시크 가능한 압축(Seekable Compression)**으로 해결했다. 복원 시 스냅샷의 메모리 페이지 전체를 한꺼번에 불러오지 않고, 필요한 순간에 필요한 페이지만 선택적으로 압축 해제하는 방식이다. 스냅샷 레이어링(Layering) 기법도 함께 적용하여, 최종적으로 스냅샷 크기를 약 14MB 수준으로 줄이는 데 성공했다. 압축 비율은 성능과의 트레이드오프를 고려해 조정 가능한 파라미터로 노출되어 있다.
13:03 - Firecracker microVM 기반 스냅샷 아키텍처 및 압축 기법 설명
이러한 최적화의 결과로 Firecracker 기반 스냅샷은 1초 미만, 복원은 수백 밀리초 수준의 성능을 달성했다.
fcrun: 오픈소스 Docker 대체 CLI
Trigger.dev는 이 Firecracker 기반 스냅샷 인프라 전체를 **fcrun(또는 FC Run)**이라는 도구로 패키징하여 곧 오픈소스로 공개할 예정이다. fcrun은 Docker 커맨드의 드롭인 대체제(Drop-in Replacement)로 설계된 CLI 도구로, Firecracker microVM 위에서 컨테이너를 실행하고 스냅샷을 찍고 복원하는 작업을 Docker에 익숙한 인터페이스로 수행할 수 있게 해준다.
강연자가 소개한 성능 수치는 인상적이다. Alpine 이미지 실행, VM 스냅샷, VM 포크(Fork) 모두 매우 빠른 속도를 보인다. TTI(Time-to-Interactive), 즉 VM이 네트워크 통신 가능 상태가 되기까지 걸리는 시간을 기준으로 한 벤치마크에서는 분당 15,000개의 VM 시작이 가능함을 확인했다. 이는 초당 약 250개, FPS로 환산하면 약 30FPS에 해당하는 속도다.
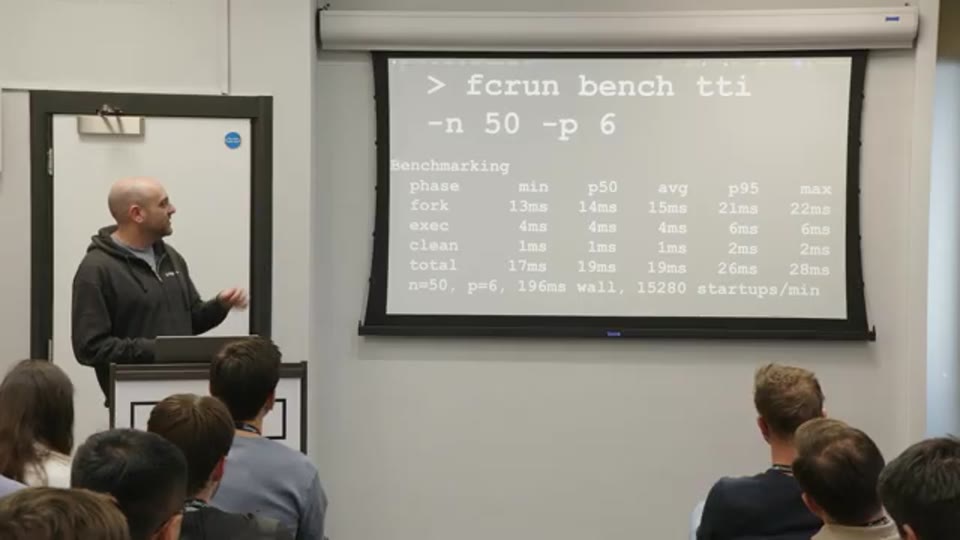
15:16 - TTI 벤치마크 - 분당 15,000 VM 시작 성능 비교 그래프
오류 복구: 내구성이 가져다주는 실질적 가치
Context 로그와 Execution 스냅샷을 결합했을 때 얻는 또 다른 핵심 이점은 **오류 복구(Error Recovery)**다. 무엇이 잘못되었느냐에 따라 복구 전략이 달라진다. LLM 서비스 자체에 장애가 생겨 15분 후 재시도가 필요한 경우라면, 메모리에서 대기하는 대신 스냅샷을 찍고 재시도 가능 시점에 복원하면 된다. 반면 버그 배포나 머신 크래시처럼 실행 환경 자체에 문제가 생긴 경우에는 Context 로그가 안전하게 저장되어 있기 때문에 해당 로그를 기반으로 에이전트를 재구성할 수 있다.
마무리: Stateless에서 Stateful로, 백엔드의 근본적 전환
강연자는 결론을 간결하게 정리한다. 30년간 백엔드 인프라의 핵심은 Stateless 컴퓨트였다. 그러나 AI 에이전트는 이 패러다임을 근본적으로 흔들고 있으며, 그 중심에는 Stateful 컴퓨트로의 전환이 있다. 그리고 이 전환을 가능하게 하는 핵심 기술이 바로 스냅샷 & 복원이다.
에이전트 내구성의 두 축, 즉 컨텍스트 로그의 내구성과 실행 레이어의 내구성을 모두 확보할 때 비로소 버전 업그레이드를 넘어서고, 긴 대화 턴을 이어가며, 예상치 못한 장애에서도 회복하는 진정한 의미의 프로덕션 에이전트를 만들 수 있다. Replay 모델이 트랜잭션 워크플로우의 세계에서 충분히 작동했다면, 에이전트 세션의 세계에서는 Snapshot 모델이 그 역할을 이어받아야 한다는 것이 Eric Allam의 핵심 주장이다.
15:55 - 에이전트 루프에 컨텍스트 로그 + 실행 스냅샷이 결합된 최종 내구성 아키텍처 다이어그램
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Two Roads to Durable Agents: Replay vs. Snapshot |
| 채널 | AI Engineer |
| 발표자 | Eric Allam (Trigger.dev 공동 창업자) |
| 리포트 작성 | 2026-05-11 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.