Vibe Engineering: Effect 앱을 AI 에이전트로 만드는 법
📺 원본 영상: Vibe Engineering Effect Apps — Michael Arnaldi, Effectful 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-08 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 코드, 터미널 출력 등은 포함되지 않을 수 있으며, 해당 부분은 원본 영상을 참조하세요.
개요
이 워크숍은 Effect 라이브러리의 저자이자 Effectful의 창립자인 Michael Arnaldi가 진행하는 실시간 라이브 코딩 세션이다. 그는 아무것도 준비하지 않은 채 완전히 빈 저장소에서 출발해, AI 에이전트(OpenCode + GPT-4.5)만을 활용하여 Effect 기반 TypeScript HTTP API를 구축하는 과정을 보여준다. 이 세션의 핵심 주제는 단순한 “vibe coding”을 넘어, AI 에이전트가 낯선 라이브러리를 효과적으로 활용할 수 있도록 저장소 환경 자체를 설계하는 방법론이다. 강연자가 스스로 붙인 원제는 “그냥 레포 클론하세요(Just clone the fucking repo)“였다.
AI 에이전트의 근본적 한계: 왜 레포를 클론해야 하는가
이 워크숍의 출발점은 LLM(Large Language Model)의 구조적 한계에 대한 냉철한 이해에서 시작한다. 인간의 뇌는 매일 새로운 경험을 흡수하고, 수면 중에 불필요한 정보를 정리하며 장기 기억을 형성하는 연속적인 학습 과정을 거친다. 그러나 LLM은 이와 근본적으로 다르다. 사전 학습(Pre-training) 단계에서 인터넷의 방대한 지식을 학습하고, 이후 강화학습(Reinforcement Learning) 기반의 사후 학습(Post-training)을 통해 코드 작업에 특화되지만, 일단 배포가 완료되면 지식은 그 시점에 고정된다.
코딩 에이전트가 특화된 사후 학습의 실체는 더욱 구체적이다. 모델에게 수많은 코드베이스를 탐색하게 하고, 변경 후 코드가 컴파일되는지 여부를 평가 지표로 삼아 반복 학습을 진행한다. 즉, 코딩 에이전트는 “코드를 소비하고 생성하는 것”에 최적화되어 있지, 인간이 작성한 문서(Documentation)를 읽거나 처음 보는 MCP(Model Context Protocol) 서버를 활용하는 것에는 특화되어 있지 않다. 강연자는 이 점을 8개월간의 경험을 통해 체득했으며, 이것이 “레포 클론” 전략의 이론적 근거가 된다.
또한 컨텍스트 윈도우(Context Window)의 한계도 중요하다. 100만 토큰의 컨텍스트 윈도우가 존재하더라도, 더 많은 정보를 밀어넣는다고 반드시 좋은 결과가 나오지는 않는다. 모델은 컨텍스트 윈도우에 담긴 모든 정보를 뉴럴 네트워크에 통째로 입력해 다음 토큰을 예측하기 때문에, 관련 없는 정보가 혼재할수록 모델의 집중력이 분산된다. 컨텍스트는 크게 유지하는 것이 아니라, 필요한 정보만 정밀하게 담는 것이 핵심이라는 것이 강연자의 결론이다.
핵심 전략: 라이브러리 저장소를 내 코드베이스로 위장하라
강연자가 8개월 전 도달한 핵심 통찰은 단순하다. 모델에게 라이브러리의 문서를 읽게 하는 대신, 라이브러리의 소스 코드 저장소 자체를 마치 내 프로젝트의 일부인 것처럼 접근하게 만들면 된다. 코딩 에이전트는 “내 코드베이스”를 탐색하도록 훈련받았기 때문에, 라이브러리 코드가 node_modules에 있으면 무시하고, .gitignore에 포함된 디렉토리도 인덱싱하지 않는다. 예를 들어 Cursor는 .gitignore에 포함된 파일을 인덱싱하지 않는다.
이 문제를 해결하는 가장 효과적인 방법이 git subtree다. git subtree를 이용해 Effect 저장소를 프로젝트 내 .repos/effect 디렉토리에 이력 없이(squash) 추가하면, 모델의 관점에서 이 코드는 내 프로젝트의 일부가 된다. 모델은 이를 탐색하고, 패턴을 학습하며, 내 코드에 동일한 패턴을 적용할 수 있게 된다. 이 전략은 TypeScript뿐 아니라 Rust에서도 동일하게 효과적이었다고 강연자는 밝혔다. 모델이 어떤 언어를 쓰든, 어떤 라이브러리를 쓰든 상관없이 효과적인 방법은 결국 레포를 클론하는 것이었다는 결론이다.
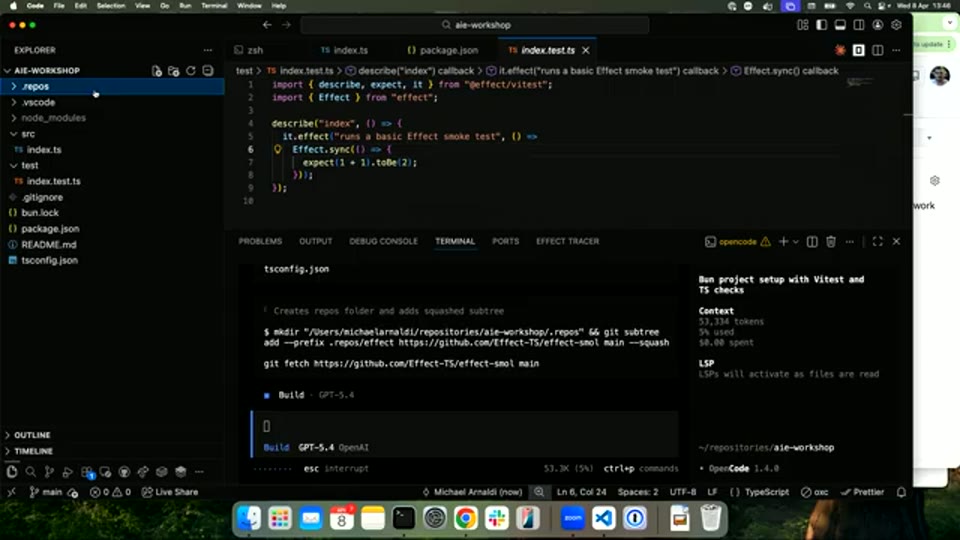
36:04 - git subtree를 이용해 Effect 저장소를 .repos/effect 디렉토리에 추가한 후 git log를 통해 커밋 확인 화면
프로젝트 셋업: Bun, VTest, TypeScript, tsgo
워크숍의 첫 실습 단계는 프로젝트 환경 구성이다. 강연자는 AI 에이전트에게 Bun 기반 프로젝트를 생성하고, VTest(Vitest)로 테스트 환경을 구성하며, TypeScript 타입 체크 스크립트를 추가하도록 지시했다. 이 과정에서 흥미로운 실험이 이루어졌는데, 바로 Microsoft의 TypeScript Go 컴파일러 프리뷰(tsgo)를 타입 체크 도구로 설정한 것이다. tsgo는 TypeScript 컴파일러를 Go 언어로 재작성한 프리뷰 버전으로, typescript-go npm 패키지의 이진 파일인 tsgo를 제공한다.
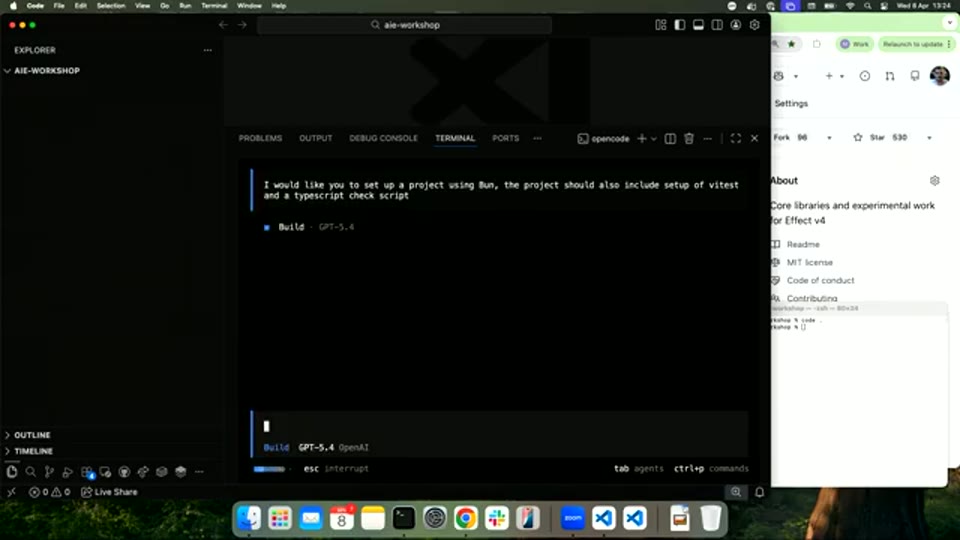
14:52 - OpenCode 터미널에서 Bun 프로젝트 초기 설정(TypeScript, VTest 포함)이 완료된 파일 구조 화면
💡 [영상 참조] 강연자는
tsgo설치 및 VSCode LSP 설정 과정에서 여러 오류와 씨름하는 과정을 실시간으로 보여줍니다. 📺 원본 영상에서 확인하세요.
환경 구성의 또 다른 핵심은 VSCode의 모든 진단(Diagnostics)을 오류 수준으로 격상하는 설정이다. 경고(Warning)나 제안(Suggestion)을 허용하면 AI 에이전트가 오류처럼 보이지 않는 문제를 그냥 통과시킬 가능성이 있기 때문이다. 강연자는 이 프로젝트가 AI를 집중적으로 사용할 것임을 명시하고, 모든 진단 항목을 에러로 설정함으로써 에이전트가 어떤 형태의 경고도 허용하지 않는 엄격한 환경을 구축했다. format on save도 함께 활성화하여 코드 스타일 일관성을 유지했다.
agents.md와 컨텍스트 관리 철학
프로젝트 환경이 구성된 후 강연자가 가장 먼저 한 일은 agents.md 파일을 생성하는 것이다. 이 파일은 AI 에이전트에게 프로젝트의 규칙과 사용 가능한 명령어, 접근 가능한 참조 자료를 알려주는 “에이전트용 README”에 해당한다. 여기에는 bun run type-check와 bun run test 같은 사용 가능한 명령어, Effect 저장소의 위치(.repos/effect), 그리고 결정적으로 중요한 규칙이 포함된다. 바로 워치 모드(watch mode)나 개발 서버(dev server)를 절대로 실행하지 말라는 것이다. 이 규칙을 추가한 이유는 단순하다. 에이전트가 처음으로 하는 일 중 하나가 개발 서버를 실행하는 것인데, 이 경우 에이전트는 프로세스가 완료되기를 기다리다 무한히 멈춰버리기 때문이다.
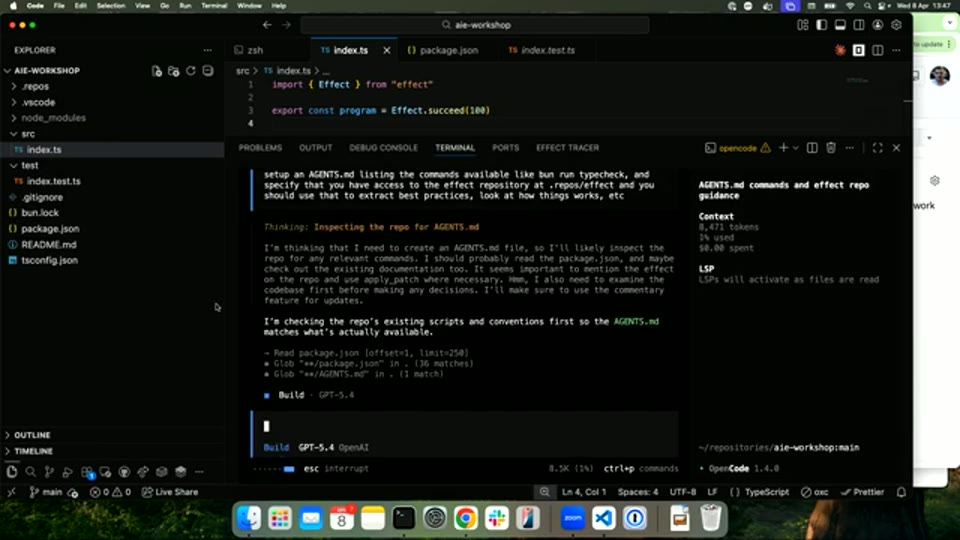
37:50 - agents.md 초안이 생성된 화면 - 사용 가능한 명령어, Effect 저장소 위치, 워치 모드 금지 규칙 포함
강연자는 컨텍스트 관리에 대해 중요한 통찰을 공유했다. 하나의 긴 대화(컨텍스트 윈도우)에서 여러 작업을 계속하면, 초기 정보가 후기 작업에 혼선을 준다. 따라서 그는 “Run Loop(강연에서는 ‘Ralph Loop’라고 불렀으나 문맥상 실행 루프를 의미)“를 운영한다. 이는 매우 단순한 Bash 스크립트로, 에이전트에게 작은 작업 하나를 선택하고, 구현하고, 종료하도록 지시한 뒤, 이를 반복 실행하는 방식이다. AI를 다룰 때 많은 경우 “적을수록 풍요롭다(less is more)“는 원칙이 적용되며, 복잡한 컨텍스트 관리 아키텍처보다 이처럼 단순한 루프가 오히려 더 좋은 결과를 낸다고 강연자는 강조했다.
강연자의 개발 방식은 “스펙 주도 개발(Spec-Driven Development)“에 가깝다. 먼저 모델과 함께 명세(Spec)를 논의해 마크다운 파일로 저장한 뒤, 이후 새로운 세션(새 컨텍스트)에서 해당 명세를 구현하도록 지시한다. 이 과정 자체가 계획 단계와 구현 단계를 물리적으로 분리하는 컨텍스트 관리 전략이기도 하다.
패턴 파일 생성: 에이전트에게 Effect를 가르치는 방법
Effect 저장소를 클론했다고 해서 에이전트가 모든 Effect의 기능을 즉시 잘 활용하는 것은 아니다. 강연자의 해결책은 “패턴 파일(Pattern File)“이다. 에이전트에게 Effect 저장소를 탐색하게 한 뒤, 특정 기능(예: HTTP API, SQL)에 관한 모범 사례를 마크다운 파일로 추출하게 하는 것이다.
이 방식의 장점은 선택적 적용(Self-selection)에 있다. Effect는 매우 광범위한 라이브러리이기 때문에, 전체 패턴을 기본값으로 주입하면 에이전트가 사용하지 않을 기능까지 모두 활용하려 들 수 있다. 반면 패턴 파일을 직접 생성하면 현재 프로젝트에서 실제로 필요한 기능의 패턴만 선택할 수 있다. 이는 기존 레거시(Brownfield) 프로젝트에서 특히 중요한데, 전체 코드베이스를 한꺼번에 Effect 방식으로 리팩토링하고 싶지 않을 때 원하는 부분만 점진적으로 도입할 수 있기 때문이다.
이 워크숍에서 생성된 패턴 파일은 세 가지다. patterns/http-api.md에는 Effect HTTP API 정의와 OpenAPI 문서 자동 생성 패턴이, patterns/sql.md에는 Effect SQL과 SQLite를 이용한 데이터 영속성 패턴이, patterns/testing.md에는 Effect VTest를 이용한 테스트 패턴이 담겼다. 마지막으로 agents.md가 이 모든 패턴 파일을 참조하도록 업데이트되어, 에이전트가 항상 이 파일들의 존재를 인지할 수 있게 했다.
HTTP API 구현: Effect의 방식으로
패턴 파일이 준비된 뒤, 강연자는 에이전트에게 투두(To-do) 관리 HTTP API를 구현하도록 지시했다. API는 투두 생성(title, description 포함), 수정, 완료 플래그 토글, 목록 조회의 네 가지 기능을 제공하며, OpenAPI 문서를 기본으로 포함해야 했다. 에이전트는 HTTP API 패턴 파일과 Effect 저장소를 참조해 구현을 진행했다.
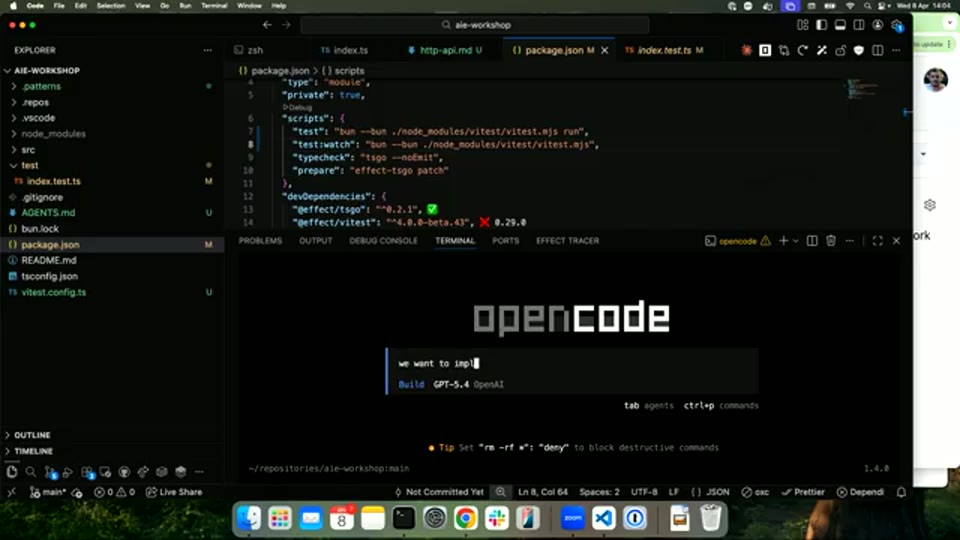
53:56 - 에이전트가 .repos/effect 내 idocs를 탐색하며 HTTP API 패턴을 조사하는 터미널 화면
구현 결과에 대한 강연자의 피드백은 실용적이었다. 식별자(Identifier)가 Plain String으로 처리된 점은 향후 Branded Type으로 개선할 여지가 있었고, TodoNotFound 에러에 404 상태코드를 매핑하는 Schema annotation은 올바르게 구현되었다. Schema.Struct 대신 클래스를 선호하는 개인적 취향도 언급되었다. 하지만 전체적으로 Effect의 방식을 따른 합리적인 구현이었으며, 테스트까지 자동으로 생성되어 실제로 모두 통과했다.
영속성 레이어는 Effect SQL과 SQLite로 구현되었다. 에이전트는 마이그레이션을 인라인으로 정의했고, SQL 레이어를 마이그레이션 레이어에 올바르게 제공(Provide)했다. 서버를 실행했을 때 OpenAPI 문서 엔드포인트가 정상 작동하는 것이 확인되었다.
💡 [영상 참조] 강연자가
bun run start로 서버를 실행한 뒤 OpenAPI 문서 엔드포인트를 브라우저에서 확인하는 화면이 표시됩니다. 📺 원본 영상에서 확인하세요.
ESLint와 린트 규칙: AI 코드 품질 관리의 핵심
강연자는 자신의 공개 저장소 accountability를 소개하며, AI 에이전트의 “나쁜 습관”을 방지하는 커스텀 ESLint 규칙들을 설명했다. 이 규칙들은 처음부터 설계된 것이 아니라, 에이전트가 반복적으로 만들어내는 나쁜 패턴을 발견할 때마다 하나씩 추가된 것들이다. 강연자는 이를 법률 조항에 비유했다. 법률 조항은 항상 누군가가 실제로 그 짓을 했기 때문에 만들어진다. ESLint 규칙도 마찬가지로, 에이전트가 그 패턴을 실제로 반복했기 때문에 존재한다.
주요 규칙의 예시를 살펴보면, any 타입 사용 금지, unknown 타입 사용 금지, as 키워드를 이용한 타입 단언(Type Assertion) 금지가 포함된다. 이 규칙들은 서로 맞물려 있는데, any를 금지하면 에이전트가 unknown으로 우회하고, unknown을 금지하면 as never as X 패턴을 쓰며, 이를 막기 위해 결국 as 자체를 금지하는 방향으로 진화했다. SQL 관련 규칙도 있는데, sql<T> 형태로 SQL 쿼리 결과에 제네릭 타입을 지정하는 것을 금지하고, 반드시 sql.schema를 통한 런타임 검증을 요구한다.
Branded Type(명목 타입) 강제도 중요한 패턴이다. userId를 단순 string으로 처리하면 orderId와 userId를 혼용해도 타입 오류가 발생하지 않는다. 이를 방지하기 위해 모든 식별자를 Branded Type으로 강제하고, 타입 단언 대신 생성자 함수(UserId.make(value)) 사용을 요구한다. 나아가 핸들러 내부에서 생성자를 호출하는 것도 금지한다. 검증은 반드시 API 진입점의 Schema에서 이루어져야 하기 때문이다.
이 접근 방식의 핵심은 에이전트를 “나이프를 들고 부엌을 뛰어다니는 주니어 개발자”처럼 다루는 것이다. 직접 감시할 수 없으니, 나이프를 들고 할 수 있는 짓을 린트 규칙으로 미리 막아두는 전략이다.
도구 수 제한의 역설: 적을수록 강력하다
강연자는 에이전트에게 접근 가능한 도구(Tool)의 수를 줄이면 성능이 오히려 향상된다는 자체 연구 결과를 공유했다. Effectful에서 실험 중인 코딩 에이전트는 execute라는 단 하나의 도구만을 가지고 있으며, 이 도구는 임의의 TypeScript 코드를 실행할 수 있고, 그 TypeScript 코드 내에서 Bash를 호출하는 방식으로 모든 작업을 수행한다.
이 설계의 흥미로운 부작용은 에이전트가 파일을 직접 수정하는 patch 도구가 없기 때문에, TypeScript로 TypeScript Transformer(AST 기반 변환)를 작성해 코드를 수정해야 한다는 것이다. 즉, 에이전트가 코드를 변경하려면 TypeScript AST 변환 코드를 스스로 작성해야 한다. 이 제약이 오히려 더 신중하고 체계적인 코드 변경으로 이어진다는 것이 강연자의 관찰이다.
모델 비교: Claude vs GPT, 언제 무엇을 쓸 것인가
강연자는 Claude(Opus, Sonnet 계열)와 GPT(OpenAI) 모델에 대한 실용적 관점을 공유했다. 최근 GPT-4.5를 주로 사용하는 이유는 기술적 우월성보다 Anthropic의 사용 정책 제한 때문이라고 솔직하게 밝혔다. OpenCode나 자체 TypeScript 파일로 AI SDK를 직접 호출하는 방식을 선호하는데, Anthropic이 이런 사용 방식에 제약을 두면서 OpenAI 모델로 전환했다는 것이다.
모델별 특성 차이도 언급되었다. GPT 모델은 복잡한 작업에서 중간중간 사용자에게 확인을 요청하는 경향이 있어, 자동화된 루프에서 불편함이 있다. 반면 Opus는 확인 없이 작업을 진행하지만, 한 번 “나쁜 패턴”이 허용되면 이후 코드베이스 전체에 동일 패턴을 반복하는 경향이 있다. UI 관련 작업에서는 Opus가 GPT보다 확연히 좋은 결과를 낸다는 경험도 공유했다. 어떤 특정 버그를 GPT가 반나절 동안 풀지 못했는데 Opus가 단번에 해결한 경우도 있었고, 반대의 경우도 있었다. 결국 어느 모델이 절대적으로 우월하다고 단정할 수 없다는 것이 결론이다.
오픈 웨이트(Open-Weight) 모델에 대해서도 흥미로운 전망을 제시했다. 현재 오픈 웨이트 모델은 최전선(Frontier) 모델 대비 약 3~6개월 뒤처져 있는데, 강연자가 Sonnet 4로 라이브러리 수준의 코딩을 성공적으로 수행했음을 감안하면, 그 수준에 도달한 오픈 모델들이 이미 존재한다는 의미가 된다. 이는 가까운 미래에 오픈 모델을 일상적인 개발에 활용할 수 있게 될 것임을 시사한다.
Effect Cluster와 Workflow: AI 시대의 신뢰성 인프라
워크숍의 마지막은 Effect Cluster와 Workflow에 대한 개념 설명으로 마무리되었다. 투두 API처럼 단순한 서비스도 실제 서비스에서는 회원가입 시 이메일 발송 같은 두 가지 독립적 연산을 조합해야 하는 경우가 빈번하다. 데이터베이스 쓰기와 이메일 발송 사이에는 트랜잭션이 없기 때문에, 서버가 중간에 다운되면 이메일이 발송되지 않을 수 있다. “이메일이 30분 내 도착하지 않으면 재시도하세요”라는 문구는 이런 설계 결함의 증상이다.
이 문제를 해결하는 것이 Workflow 시스템이다. Temporal, Inngest 같은 외부 솔루션이 있고, Effect는 Effect Cluster 위에 구축된 자체 Workflow 구현을 제공한다. 이 시스템은 여러 노드로 클러스터를 구성하고, 한 프로세스가 시작되면 서버가 다운되더라도 다른 노드로 이전되어 반드시 완료를 보장한다.
강연자는 특히 AI 통합 관점에서 Workflow의 중요성이 커졌다고 강조했다. 평균 응답 시간이 10밀리초인 API에서는 서버 장애가 그 짧은 시간 내에 발생할 확률이 매우 낮다. 하지만 LLM 호출이 포함되면 응답 시간이 수 분으로 늘어나고, 사용자가 10명에 불과해도 장애 확률이 크게 높아진다. AI를 제품에 통합하는 모든 회사에서 Workflow의 필요성이 급격히 증가한 이유가 여기 있다. Effect Cluster가 Temporal처럼 주목받기 시작한 것도 이런 맥락에서다.
평가(Eval)와 Fine-tuning: 풀리지 않는 숙제
워크숍 중 청중과의 토론에서 평가(Evaluation) 방법론에 대한 깊은 논의가 이루어졌다. Effectful은 Effect 라이브러리 자체의 변경이나 문서 추가가 에이전트의 코드 품질에 미치는 영향을 측정하기 위해 하루 한 번 Eval을 실행하고 보고서를 생성하는 파이프라인을 구축 중이다. 현재 방식은 인간이 작성한 모범 코드와 에이전트가 생성한 코드를 LLM으로 비교해 유사도 점수를 매기는 것이다.
그러나 강연자는 이 접근법의 근본적 한계를 인정했다. Anthropic이 코드 품질 평가에 관한 블로그 포스트에서 언급했듯이, “코드가 좋은지 나쁜지를 객관적으로 정의하기 어렵다.” 타입 체크를 통과하는 코드가 통과하지 못하는 코드보다 낫다는 것은 확실하지만, 파일 구조나 스타일에 관해서는 100명에게 물으면 80대 20으로 의견이 갈린다. Effectful의 Eval은 결국 강연자 팀의 주관적 견해가 반영된 것이며, 절대적 진리가 아니다.
Fine-tuning도 고려 중이다. Effect 패턴을 기본으로 사용하는 오픈소스 모델을 강화학습으로 파인튜닝하는 방향이다. 이를 위해서는 좋은 Eval이 필수적이며, 이것이 현재 Effectful이 연구 중인 핵심 과제다.
마무리 / 핵심 정리
Michael Arnaldi가 이 워크숍을 통해 전달하려는 메시지는 하나다. 코딩 에이전트를 효과적으로 사용하는 것은 모델을 잘 프롬프팅하는 기술이 아니라, 저장소를 에이전트가 잘 작동할 수 있는 환경으로 설계하는 아키텍처 기술이라는 것이다.
핵심 방법론을 요약하면, 사용하는 라이브러리의 저장소를 git subtree로 프로젝트 내에 포함시키고, agents.md로 에이전트에게 컨텍스트를 제공하며, 특정 기능에 대한 패턴 파일을 선택적으로 생성하고, ESLint 규칙으로 반복되는 나쁜 패턴을 예방하고, 컨텍스트 오염을 막기 위해 작은 작업 단위로 에이전트 세션을 자주 초기화하는 것이다.
강연자는 코드를 손으로 직접 작성하지 않은 지 6~8개월이 되었으며, 이것이 TypeScript와 Rust 모두에서 가능했다고 강조했다. 앞으로 프로그래머의 역할은 코드를 직접 작성하는 것에서, 에이전트가 올바른 방향으로 작동할 수 있는 코드베이스 환경을 설계하는 것으로 전환되고 있다. 빈 저장소에서 시작해 약 90분 만에 Effect 기반의 테스트가 통과하는 HTTP API를 완성한 이 세션이 그 증거다.
📚 참고: Effect 생태계 주요 개념
아래 내용은 강연 내용을 바탕으로 한 배경 설명으로, 강연 내용과 별개입니다.
| 도구/라이브러리 | 역할 |
|---|---|
| Effect | TypeScript를 위한 함수형 프로그래밍 라이브러리. 에러 처리, 비동기, 의존성 주입 등을 타입 안전하게 다룬다. |
@effect/platform | HTTP 서버/클라이언트, OpenAPI 등 플랫폼 통합 기능을 제공한다. |
@effect/sql | Effect 방식의 SQL 클라이언트로, SQLite, PostgreSQL 등을 지원한다. |
@effect/vitest | Vitest 위에서 Effect를 테스트하기 위한 유틸리티. it.layer()로 레이어를 주입할 수 있다. |
| Effect Cluster | 분산 클러스터와 Workflow를 구현하기 위한 Effect 확장. Temporal과 유사한 기능을 제공한다. |
| effect.solutions | Keith Langton이 제작한 AI 프로젝트에서 Effect를 빠르게 시작하기 위한 사이트. |
| accountability (GitHub) | 강연자 Michael Arnaldi의 저장소로, AI 에이전트용 커스텀 ESLint 규칙 모음을 포함한다. |
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Vibe Engineering Effect Apps — Michael Arnaldi, Effectful |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-05-08 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.