VoiceOps — 혼잡한 오디오 스트림에서 초저지연 인텔리전스를 추출하는 방법
📺 원본 영상: VoiceOps-fying Low-Latency Intelligence Extraction from Messy Audio Streams — Deepu Kumar Singh 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-08 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Fujitsu North America에서 신흥 데이터 기술 및 AI 아키텍처 이니셔티브를 총괄하는 Deepu Kumar Singh는 이 강연에서 실제 컨택 센터 환경에 배포한 VoiceOps 파이프라인의 설계 원리와 구현 결과를 공유한다. 핵심 메시지는 단순하지만 강렬하다. 생성형 AI(Generative AI)를 다룰 때 우리는 대부분 깨끗하게 정제된 텍스트 입력을 전제로 논의하지만, 실제 세계, 특히 컨택 센터에서는 데이터가 처음부터 텍스트로 존재하지 않는다는 점이다. 감정이 실린 목소리, 겹치는 발화, 다채널 오디오 스트림이 뒤엉킨 혼잡한 음성 데이터를 어떻게 초저지연으로 처리하고, 구조화된 비즈니스 인텔리전스로 변환하는가가 이 강연의 핵심 주제다.
왜 컨택 센터인가 — 구조적 위기의 실체
컨택 센터는 고객 경험의 최전선이지만, 동시에 구조적으로 극심한 압박 아래 놓여 있다. 강연자에 따르면 업계 데이터를 보면 컨택 센터의 50% 이상이 채용, 교육, 생산성을 가장 심각한 장벽으로 꼽고 있으며, 그 근본 원인은 업무 자체의 복잡성과 높은 스트레스 수준에 있다. 상담원들은 복잡한 고객 감정을 다루면서 동시에 여러 CRM(Customer Relationship Management) 시스템을 탐색하고, 모든 것을 완벽하게 문서화해야 하는 세 가지 과제를 동시에 처리해야 한다.
이 구조는 필연적으로 악순환을 만들어 낸다. 인력 부족은 남은 상담원들의 스트레스를 높이고, 높아진 스트레스는 이직률을 상승시키며, 높은 이직률은 다시 인력 부족으로 이어진다. 강연자는 이 사이클을 끊기 위해 단순히 더 많은 사람을 고용하는 것으로는 부족하며, 워크플로우에서 스트레스를 근본적으로 엔지니어링해내는 것이 필요하다고 강조한다.
문제의 핵심 — ACW(After Call Work)라는 비효율의 덩어리
이 구조적 비효율의 가장 두드러진 지점이 바로 ACW(After Call Work), 즉 통화 후 처리 작업이다. 강연자가 공유한 기준 데이터에 따르면, 컨택 센터의 평균 통화 시간은 약 6.5분인 반면, 상담원이 통화 후 노트를 작성하고 콜 요약과 처리 코드(disposition code)를 입력하는 사후 처리 시간은 평균 6.3분에 달한다. 이는 거의 1대 1의 비율로, 상담원이 실제 고객과 대화하는 시간만큼을 행정적 데이터 입력에 소비하고 있다는 의미다.
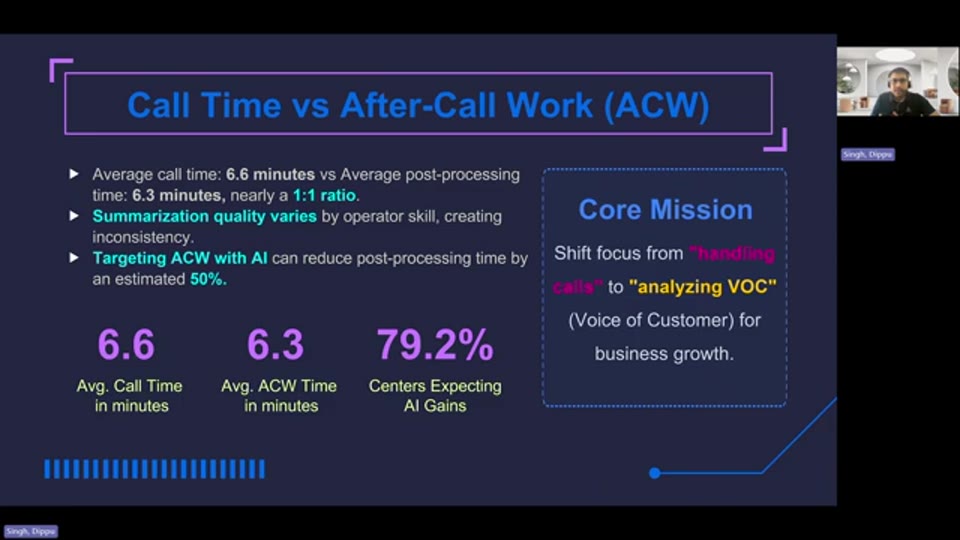
05:15 - ACW 시간 비교 슬라이드 — 평균 통화 시간(6.5분) vs 사후 처리 시간(6.3분)의 1:1 비율을 시각화한 자료
더 심각한 것은 품질의 문제다. 이 요약 작업이 개별 상담원의 기억력과 문장력에 전적으로 의존하기 때문에, 생성되는 데이터의 품질은 상담원마다, 심지어 같은 상담원이라도 컨디션에 따라 크게 달라진다. 강연자는 여기에서 명확한 엔지니어링 미션을 도출한다. AI로 ACW를 자동화한다면 이론적으로 사후 처리 시간을 50% 이상 단축할 수 있으며, 이는 단순한 효율 개선을 넘어 기업이 고객의 목소리(Voice of Customer) 데이터를 체계적으로 분석하고 비즈니스 성장에 활용할 수 있는 토대가 된다.
4단계 파이프라인 아키텍처 — 음성에서 구조화된 JSON으로
강연자가 설계한 솔루션은 원시 오디오를 최소한의 인간 개입으로 구조화된 비즈니스 인텔리전스로 변환하는 4단계 저지연 파이프라인이다. 각 단계는 이전 단계의 품질에 전적으로 의존하기 때문에, 파이프라인의 첫 단계부터 엄격한 품질 관리가 이루어진다.
Stage 1. 음성 캡처(Voice Capture) — 쓰레기 입력은 쓰레기 출력을 만든다
AI 시스템에서 흔히 통용되는 원칙인 “Garbage In, Garbage Out”은 이 파이프라인의 첫 번째 단계에서 가장 중요하게 적용된다. 강연자에 따르면 오디오 입력이 불량하면 LLM은 이후 단계에서 반드시 환각(hallucination)을 일으키기 때문에, 실시간 오디오 인테이크 단계에서 세 가지 핵심 처리가 이루어진다.
첫째로 노이즈 필터링이다. 사무실 배경 소음이나 잡음을 제거하고 오디오 레벨을 정규화(normalize)하는 작업이 필수적이다. 둘째는 채널 매핑(channel mapping)인데, 이것이 아키텍처 전체에서 가장 중요한 결정 중 하나다. 스테레오 오디오를 반드시 분리하여 상담원의 음성은 왼쪽 채널에, 고객의 음성은 오른쪽 채널에 격리해야 한다. 만약 이 둘을 단일 모노 트랙으로 혼합한다면 AI는 누가 무엇을 말했는지 파악하지 못하고, 이는 이후 모든 요약 작업을 망가뜨리게 된다. 셋째는 PII(Personally Identifiable Information, 개인식별정보) 마스킹이다. 오디오 스트림에는 신용카드 번호나 비밀번호 같은 민감한 정보가 포함될 수 있기 때문에, 버퍼 관리와 초기 단계 PII 마스킹 기법을 통해 이 데이터가 절대 LLM의 메모리에 도달하지 않도록 처리한다.
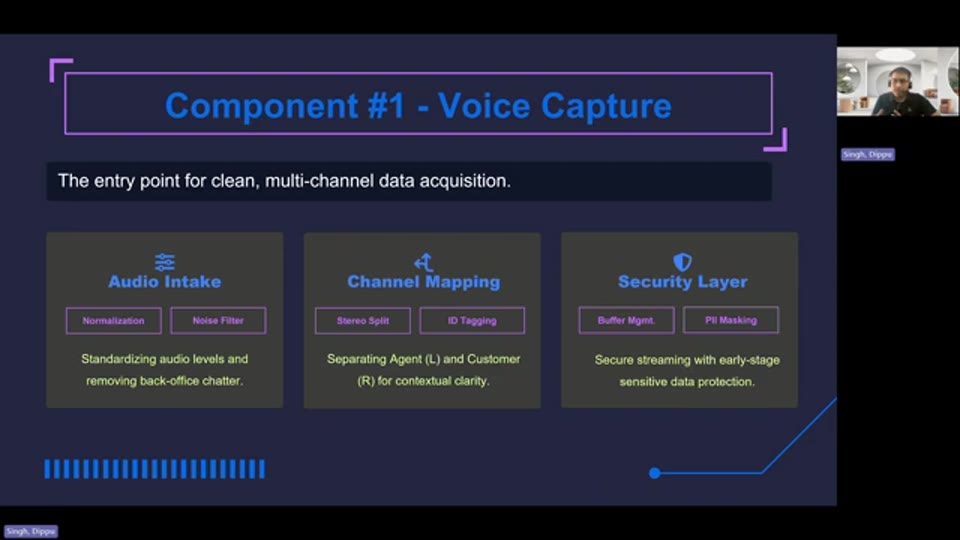
08:27 - 음성 캡처 컴포넌트 아키텍처 — 노이즈 필터링, 스테레오 채널 분리(좌: 상담원 / 우: 고객), PII 마스킹 레이어 구조
Stage 2. STT(Speech-to-Text) 엔진 — 90% 정확도가 마지노선
오디오가 STT 엔진을 통과하는 이 단계는 파이프라인 전체의 품질을 결정짓는 병목이다. 강연자는 생성형 AI가 효과적으로 요약하기 위해서는 STT 정확도가 반드시 90% 이상이어야 한다고 단언한다. 이를 달성하기 위해 세 가지 접근법이 병행된다.
우선 고급 음향 모델링(advanced acoustic modeling)을 통해 음소(phoneme)를 매핑하고 지역 방언을 필터링한다. 그다음은 도메인 특화 사전(domain-specific dictionary)의 활용이다. 여기서 강연자는 인상적인 사례를 든다. 보험 상담 환경에서 STT 엔진은 “term life(정기 생명보험)“와 단순한 “term(기간)“의 차이를 반드시 구별할 수 있어야 한다. 발음이 유사하더라도 비즈니스 맥락에서의 의미는 완전히 다르기 때문이다. 마지막으로 역 텍스트 정규화(inverse text normalization)와 자동 구두점(auto punctuation) 같은 후처리(post-processing) 과정이 중요하다. 예를 들어 고객이 “five thousand dollars”라고 말하면 STT 출력은 문자 그대로가 아닌 “$5,000”이라는 수치 형식으로 나와야 하며, 이 수치 포맷팅은 이후 LLM이 엔터티(entity)를 추출하는 능력을 크게 향상시킨다.
Stage 3. 생성형 AI 코어(Generative AI Core) — 오케스트레이션이 핵심이다
이 단계가 파이프라인의 두뇌에 해당한다. 강연자는 단순히 원시 트랜스크립트를 LLM에 던지고 요약을 요청하는 방식의 한계를 명확히 지적한다. 그렇게 하면 LLM은 지저분한 서술형 단락(messy narrative paragraph)을 출력할 뿐이다. 대신 팀은 세 개의 레이어로 구성된 고도로 오케스트레이션된 접근법을 사용한다.
첫 번째는 오케스트레이션 레이어로, 퓨샷(few-shot) 라이브러리를 활용해 LLM이 고객의 문의 내용과 상담원의 조치 사항을 각각 별도의 불릿 포인트 리스트로 분리하여 출력하도록 지시한다. 두 번째는 추론 레이어(reasoning layer)로, LLM에게 미리 정의된 콜 이유 목록(취소, 신규 신청, 청구 상태 확인 등)을 제공하고, 트랜스크립트를 분류하게 하면서 동시에 왜 그 분류를 선택했는지 이유도 함께 출력하도록 지시한다. 분류 결과만이 아니라 추론 과정까지 요구함으로써 결과의 신뢰성을 높이는 것이다. 세 번째는 신뢰 레이어(trust layer)로, 토큰 최적화를 통해 지연 시간을 낮추고 자동화된 환각 검증(hallucination check)을 실행하여 생성된 요약이 트랜스크립트에 기반한 내용으로만 구성되었는지 확인한다.
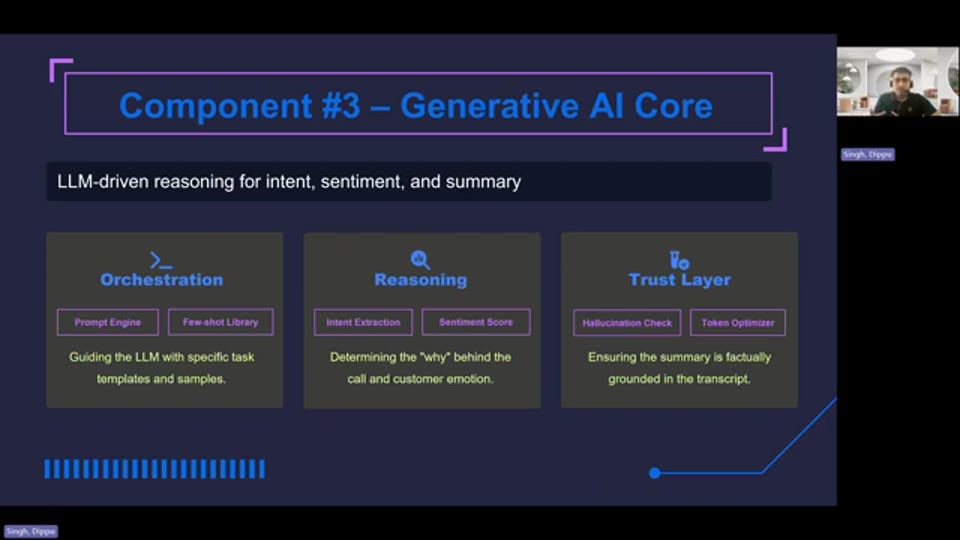
11:37 - 생성형 AI 코어의 오케스트레이션 레이어 — 퓨샷 프롬프트 템플릿 구조 및 고객 문의/상담원 조치 분리 출력 형식
Stage 4. 고객 데이터 동기화(Customer Data Sync) — 인간의 검증을 남기다
파이프라인의 마지막 단계는 이 아름다운 구조화 데이터를 실제 비즈니스 시스템에 다시 통합하는 것이다. API 게이트웨이가 스키마 매퍼(schema mapper) 역할을 수행하며, LLM이 출력한 JSON에서 고객 인텐트(customer intent)나 해결 상태(resolution status) 같은 필드를 회사의 CRM 시스템이나 고객 데이터 플랫폼의 해당 필드에 REST API를 통해 자동으로 매핑한다.
강연자가 강조하는 중요한 설계 결정은 인간을 완전히 제거하지 않았다는 점이다. 상담원은 AI가 생성하고 자동으로 화면에 채워진 요약본을 확인하고 간단한 수정을 거쳐 확인 버튼을 클릭한다. 이 검증 단계는 AI 오류를 방지하는 안전망이면서 동시에 상담원의 부담을 최소화하는 UX 설계이기도 하다. 동시에 이 구조화된 데이터는 경영진을 위한 비즈니스 인텔리전스 대시보드로도 흘러가며, 새로운 FAQ 항목 후보를 자동으로 플래그하는 데도 활용된다.
데이터 파이프라인의 선형 흐름
💡 [영상 참조] 강연자는 이 시점에서 전체 파이프라인의 데이터 흐름을 시각화한 다이어그램을 화면에 표시하며 설명합니다. 📺 상세 내용은 원본 영상에서 확인하세요.
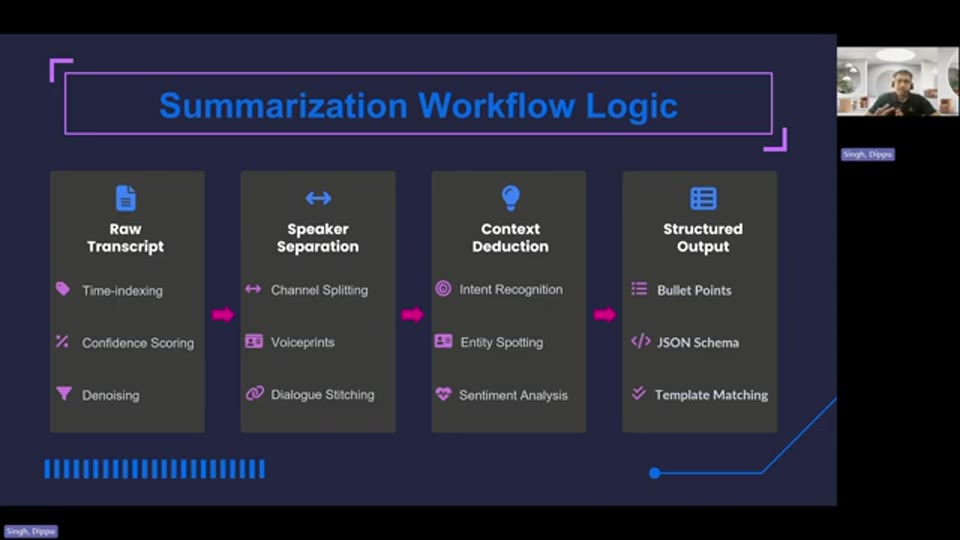
14:17 - 전체 데이터 파이프라인 선형 흐름도 — 원시 트랜스크립트 → 화자 분리 → 컨텍스트 추출 → 구조화된 JSON 출력까지의 단계
파이프라인의 전체 흐름을 논리적으로 정리하면, 시간 인덱싱과 신뢰도 점수, 노이즈 제거가 포함된 원시 트랜스크립트에서 출발한다. 이것이 화자 분리(speaker separation) 단계를 거치는데, 1단계에서 스테레오 채널을 분리했기 때문에 여기서는 그것을 논리적으로 재결합하여 “고객이 X를 말했고, 상담원이 Y로 응답했다”는 구조의 대화체로 재편성할 수 있다. 이어서 컨텍스트 추출(context deduction) 단계에서 LLM이 계좌 번호, 상품명, 고객 이름 같은 엔터티를 식별하고 감정 분석(sentiment analysis)을 실행하며 인텐트를 인식한다. 최종 출력은 텍스트 덩어리가 아닌 미리 정의된 CRM 템플릿에 맞춘 깔끔한 JSON 스키마로, 이것이 비정형 대화를 데이터베이스에 바로 저장할 수 있는 자산으로 전환하는 결정적 단계다.
실제 배포 결과 — 측정 가능한 ROI
아키텍처를 실제 컨택 센터 환경에 배포한 결과는 즉각적이고 측정 가능했다. 수작업 기준 평균 6.3분이었던 ACW 시간이 AI 워크플로우 도입 후 3.1분으로 줄었다. 거의 정확히 50%의 감소다.
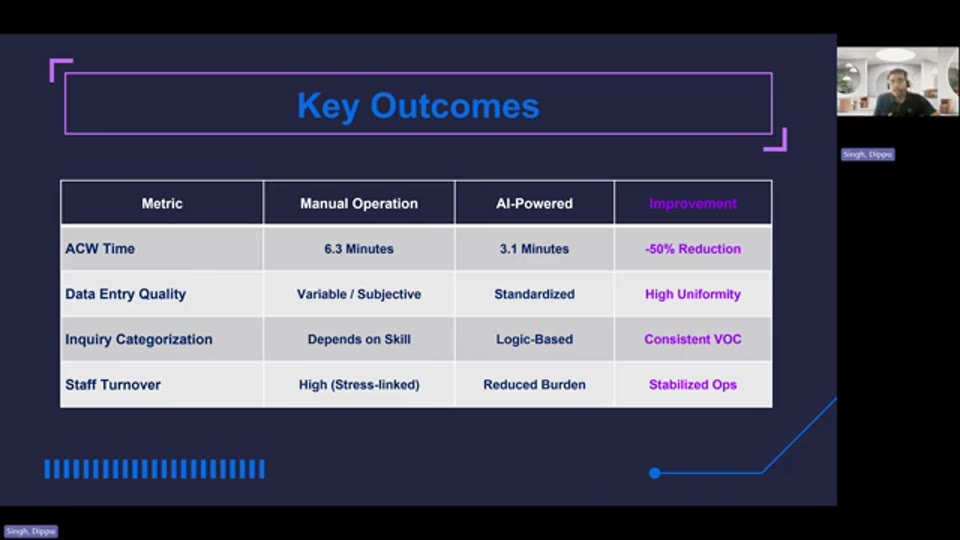
16:05 - 배포 결과 수치 — ACW 시간이 6.3분에서 3.1분으로 약 50% 감소한 성과 지표
500석 규모의 컨택 센터에서 하루에 수천 건의 통화를 처리한다고 가정하면, 이는 순수히 효율성 관점에서 수십 명의 풀타임 인력을 되찾는 것에 상응하는 운영적 절감 효과다.
데이터 품질의 변화도 마찬가지로 중요하다. 통화 이유 분류(call reason tagging)가 개별 상담원의 기억이나 그날의 컨디션에 의존하던 방식에서, 엄격한 논리 기반 분류 방식으로 전환되었다. 이는 경영진이 의존하는 고객 목소리 데이터셋의 일관성을 근본적으로 향상시킨다. 더 나아가 반복적인 행정 업무인 노트 타이핑의 부담을 제거함으로써 상담원의 인지적 부하가 줄어들었고, 이는 강연 초반에 식별했던 스트레스 연관 이직률 문제를 직접적으로 해소하는 효과를 가져왔다.
현재의 엔지니어링 제약과 솔직한 한계
강연자는 결과가 훌륭하더라도 엔지니어링 작업은 결코 완성되지 않는다고 강조하며, 현재 직면한 세 가지 주요 제약을 투명하게 공유한다.
첫째는 STT 정확도의 지속적 도전이다. 전체 생성형 AI 요약이 트랜스크립트에 의존하기 때문에, STT 엔진이 강한 억양이나 불량한 오디오 품질을 제대로 처리하지 못하면 LLM은 아무것도 할 수 없게 된다. STT 최적화는 팀에게 끊임없는 전투라고 강연자는 표현한다. 둘째는 초기 구축 비용이다. 장기 ROI는 크지만, 특히 20분짜리 긴 트랜스크립트에 복잡한 LLM 추론을 실행할 때 소모되는 API 토큰 비용은 특히 초기 스케일링 단계에서 부담이 된다. 팀은 이 비용을 낮추기 위한 토큰 최적화 기법을 지속적으로 연구하고 있다. 셋째는 보안과 규정 준수다. 오디오 스트림 내의 PII를 처리하는 것은 매우 복잡하며, 클라우드 엔드포인트에 데이터가 도달하기 전에 강력한 마스킹을 보장하는 것이 필수 요건이다. 이를 위해 추가된 레이어들은 지연 시간을 증가시키고 아키텍처 오버헤드를 유발하며, 이 레이어들을 줄이면서도 견고함을 유지하는 방법을 팀은 여전히 모색 중이다.
로드맵 — 다음 세 단계
현재의 제약을 해결하고 기술의 경계를 확장하기 위해 팀의 로드맵은 세 단계로 구성된다.
Phase 1: 설명 가능한 AI(Explainable AI) 기반 상담원 코칭
단순히 통화를 요약하는 것을 넘어 상담원을 코칭하는 단계다. 강연자의 설명에 따르면, 통화 후 오디오를 분석하여 상담원에게 소프트 스킬, 공감 수준, 정보 전달 정확도에 대한 즉각적인 개인 피드백을 제공하는 시스템을 엔지니어링하고 있다. 이 피드백은 개인에게만 전달되는 방식으로 설계될 예정이다.
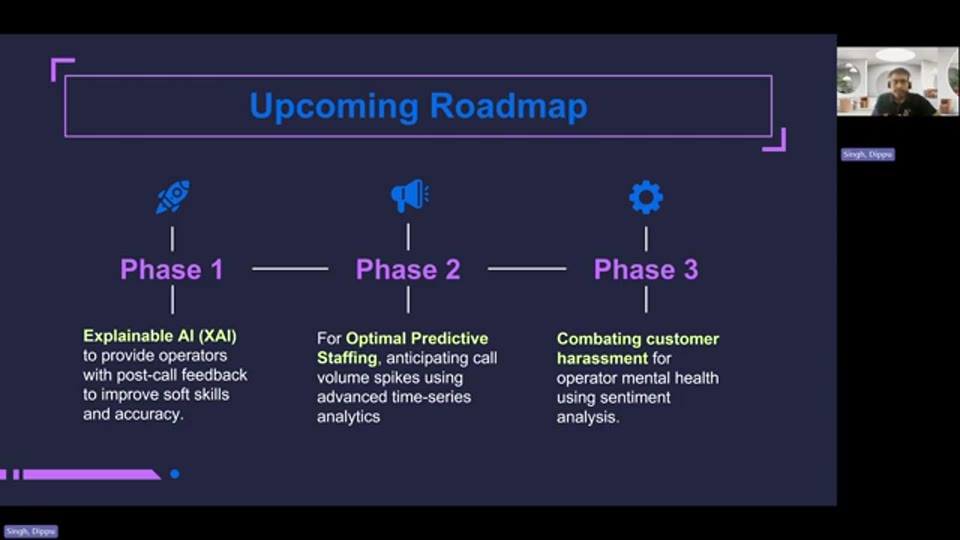
19:47 - 로드맵 Phase 1 — 설명 가능한 AI 기반 상담원 코칭 시스템 설계 개요
Phase 2: 예측적 인력 운영(Predictive Staffing)
현재 방대하게 축적되고 있는 분류된 인텐트 데이터를 활용한다. 이 인텐트 데이터를 시계열 분석(time series analytics)에 투입하면, 특정 주제별 통화량 급증을 사전에 예측하고 이를 기반으로 교대 일정을 최적화하는 것이 가능해진다.
Phase 3: 고객 언어 폭력 탐지 및 상담원 보호
강연자가 가장 중요한 단계라고 표현한 것으로, 컨택 센터 상담원들이 점점 더 많이 직면하는 언어적 폭력에 대응하기 위한 것이다. 저지연 감정 및 음향 분석을 통해 고객이 공격적으로 변하는 순간을 실시간으로 탐지하고, 이를 통해 감독자에게 즉각적인 알림을 발송하거나 AI 음성 에이전트로 통화를 원활하게 전환하여 인간 상담원의 정신 건강을 보호하는 시스템을 개발 중이다.
21:10 - 로드맵 Phase 3 — 저지연 감정/음향 분석 기반 언어 폭력 탐지 및 상담원 보호 시스템 구조
마무리 — 비용 센터에서 인텔리전스 엔진으로
이 강연의 핵심 주장은 기술적인 것이지만, 그 함의는 인문적이다. 강연자는 혼잡한 오디오 데이터에 엄격한 엔지니어링 기법을 적용함으로써 컨택 센터를 단순한 고스트레스 비용 센터에서 인력을 보호하는 고효율 인텔리전스 수집 엔진으로 전환할 수 있다고 결론짓는다. VoiceOps 파이프라인은 기술적 성과인 동시에 사람을 위한 설계이기도 하다. 50%의 ACW 시간 단축이 의미하는 것은 단순히 생산성 수치가 아니라, 상담원들이 자신의 역할에서 실제로 의미 있는 부분에 집중할 수 있는 여지를 되돌려 주는 것이기 때문이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | VoiceOps-fying Low-Latency Intelligence Extraction from Messy Audio Streams |
| 채널 | AI Engineer |
| 강연자 | Deepu Kumar Singh (Fujitsu North America) |
| 리포트 작성 | 2026-04-08 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.