Voice AI: ‘Her’ 모먼트는 언제 올까?
📺 원본 영상: Voice AI: when is the “Her” moment? — Neil Zeghidour, Gradium AI 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-10 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Gradium AI의 공동창업자이자 연구자인 Neil Zeghidour가 AI Engineer 컨퍼런스에서 발표한 이 강연은, 현재 Voice AI 기술이 어디까지 왔는지를 솔직하게 짚고, 2013년 영화 *허(Her)*에서 묘사된 수준의 자연스러운 AI 음성 대화를 실현하기 위해 무엇이 남아 있는지를 구조적으로 분석한다. 강연자는 현재 가장 앞선 데모들조차 여전히 근본적인 한계를 안고 있다고 솔직하게 인정하면서, 레이턴시·풀-듀플렉스 대화·확장성·비용이라는 네 가지 기술적 병목을 순서대로 해체하여 설명한다.
Gradium AI: 음성 AI의 빌딩 블록을 만드는 곳
Neil Zeghidour가 이끄는 Gradium AI는 Voice AI를 위한 핵심 모델 인프라를 개발하는 회사다. Speech-to-Text(STT), Text-to-Speech(TTS), Speech-to-Speech 변환, 음성 번역, 대화형 음성 모델 등 다양한 음성 AI 모델을 훈련하는 것이 주요 사업이며, 특정 수직 시장이나 오케스트레이션 레이어에 집중하는 대신, 음성 에이전트와 음성 솔루션을 구축하려는 개발자와 기업들이 사용할 수 있는 기초 모델(building block)을 제공하는 역할에 집중한다. 회사는 Eric Schmidt, Rodolphe Saadé, Xavier Niel 등의 지원을 받아 2년 전 설립된 비영리 연구소에서 스핀오프(spinoff)한 영리 법인으로, 오픈 리서치를 지향하던 연구소의 성과를 실제 프로덕션에서 사용 가능한 제품으로 발전시키기 위해 분리되었다.
이 연구소에서 개발한 대표 성과물이 바로 Moshi다. Moshi는 대화를 위한 최초의 Full-Duplex Speech-to-Speech 모델로, 이후 음성 AI 연구의 중요한 기준점이 되었다. 또한 강연 중 가장 최근 개발 성과로 언급된 모델이 스마트폰 CPU에서 직접 구동 가능한 경량 TTS 모델인 Gradium Phonon으로, 비용과 프라이버시 문제를 동시에 해결하기 위한 Gradium의 전략적 제품이다.
영화 ‘Her’의 약속, 그리고 현실의 간극
영화 *허(Her)*는 2013년 작품임에도 불구하고, 사람과 AI 음성이 나누는 대화의 미래를 놀랍도록 정확하게 예견했다고 강연자는 평가한다. 영화 속 AI Samantha가 처음 등장하는 장면에서, 그녀는 자신의 이름을 스스로 지었다고 말하고 소리가 마음에 들었기 때문이라고 설명한다. 이 짧은 교환이 담고 있는 자연스러움, 즉각적인 반응성, 그리고 감정적 뉘앙스의 이해는 오늘날 최고 수준의 Voice AI 데모와 비교해도 여전히 뚜렷한 격차를 드러낸다. 강연자는 Her 모먼트라는 표현이 업계에서 남용되고 있음을 자조적으로 지적하면서도, 그 개념이 아직도 유효한 벤치마크라는 점은 분명히 인정한다.
그가 예시로 든 현재의 데모들—Eleven Labs의 정부 AI 헬퍼 데모와 Gradium의 스트리밍 음성 모델을 탑재한 소형 로봇 디바이스 데모—은 분명 과거보다 훨씬 자연스러워졌다. 그러나 레이턴시는 여전히 높고, 사용자와 시스템이 동시에 말하는 상황을 처리하는 능력은 아직 부족하다. 강연자는 이를 솔직하게 인정하며 “아직 거기까지 도달하지 못했다(we are still not there)“고 말한다. 인텔리전스 측면에서는 눈에 띄게 발전했고, 그것이 현재 음성 에이전트에 대한 관심이 급증하는 이유이기도 하지만, 현재의 음성 에이전트는 근본적으로 “목소리가 달린 텍스트 모델(glorified text model with a voice around it)“에 불과하다는 것이 그의 핵심 비판이다.
캐스케이드 시스템의 구조와 레이턴시의 벽
현재 대부분의 상용 음성 AI 시스템은 캐스케이드(Cascaded) 아키텍처를 사용한다. 이는 STT → LLM → TTS라는 세 개의 독립적인 블록이 순차적으로 연결된 구조로, Gradium의 구현 방식도 이와 유사하게 스트리밍 STT, 음성 클로닝이 포함된 스트리밍 TTS, 그리고 의미론적 VAD(Semantic Voice Activity Detection)를 조합한 방식을 따른다. 강연자는 Gradium의 TTS 레이턴시가 경쟁 모델들보다 빠르다고 언급하지만, 그럼에도 TTS 단계만으로 이미 200밀리초 이상이 소요된다는 점을 강조한다.
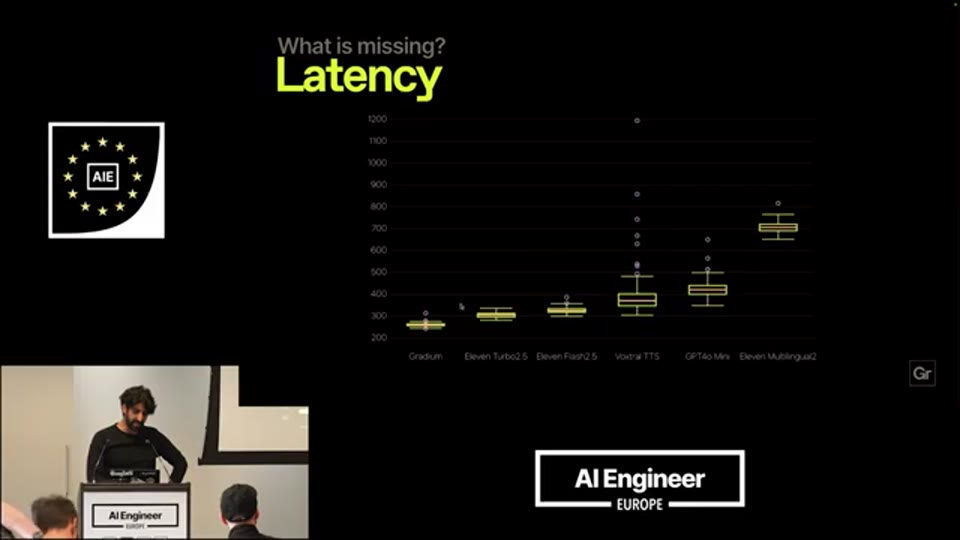
06:10 - Gradium TTS와 경쟁 모델들의 레이턴시 비교 차트 - 수치 비교 데이터 확인 가능
이것이 결정적인 문제가 되는 이유는, 인간 간의 자연스러운 대화에서는 상대방의 말을 이해하고, 답변을 생성하고, 발화하는 전체 과정이 약 200밀리초 안에 완결되기 때문이다. 즉, TTS 단계 하나만으로도 인간의 전체 반응 사이클을 초과해버린다. 더구나 이 계산에는 툴 콜(tool call)이나 실제 작업 수행에 필요한 시간이 전혀 포함되지 않았다. 따라서 현재의 캐스케이드 시스템은 구조적으로 인간 수준의 대화 속도를 달성할 수 없다는 한계를 안고 있다.
새로운 병목: 툴 콜 레이턴시와 필러(Filler) 전략
TTS 레이턴시를 10~30밀리초 단위로 줄이기 위해 치열하게 최적화하면서, 실제로는 그보다 훨씬 큰 지연이 다른 곳에서 발생하고 있다는 것이 강연자의 중요한 통찰이다. 바로 **툴 콜(tool call)**이다. 외부 서비스를 통한 툴 콜은 500밀리초에서 최대 4초까지 레이턴시가 발생하며, 이는 TTS 최적화 노력을 사실상 무색하게 만드는 수준이다. 강연자는 “우리가 더 이상 가장 중요한 것을 위해 싸우고 있는 게 아닌 것 같다는 느낌이 든다”고 표현하며, 지금의 주된 병목은 TTS가 아니라 툴 콜이 되었고, 복잡한 툴 콜에도 견고하게 작동하는 모델이 필요하다고 진단한다.
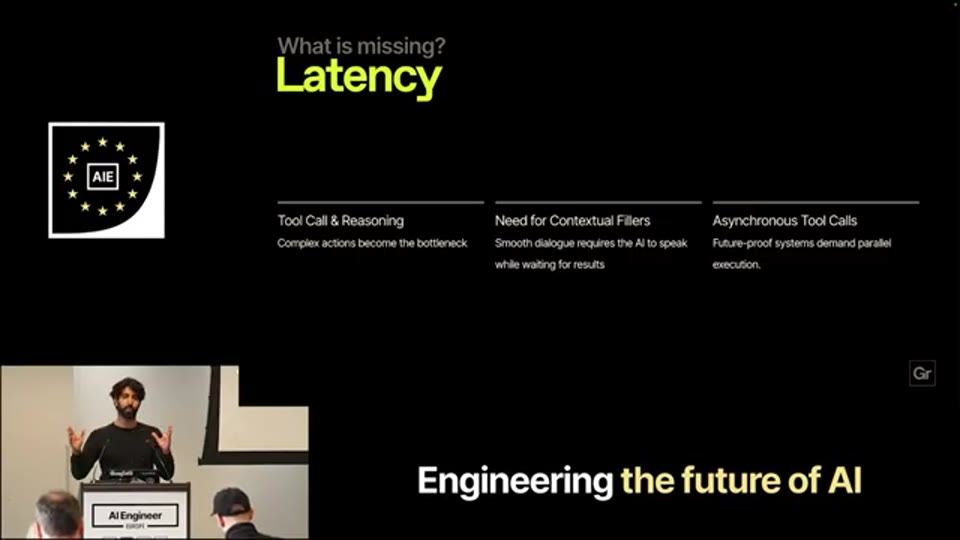
07:07 - 캐스케이드 시스템의 툴 콜 레이턴시 문제 - 500ms~4초 지연 관련 슬라이드
이 문제에 대한 Gradium의 접근법이 필러(Filler) 전략이다. LLM이 툴 콜을 보내고 결과를 기다리는 동안, 대화를 자연스럽게 이어갈 수 있는 임시 발화를 생성하는 방식이다. 강연자가 라이브로 시연한 여행 에이전트 데모에서, AI는 도쿄 호텔 정보를 가져오는 동안 “도쿄는 정말 멋진 선택이에요. 초현대적인 고층 빌딩과 고즈넉한 신사들이 공존하는 곳이죠…”처럼 목적지에 대한 자연스러운 발화를 이어갔다. 결과가 도착하면 이 흐름에 매끄럽게 실제 데이터를 끼워 넣는 방식으로, 불확실한 툴 콜 레이턴시를 사용자 경험 측면에서 감추는 전략이다. 강연자는 이 방식이 완벽하지는 않지만, 복잡한 태스크가 포함된 상황에서도 더 예측 가능하고 안정적인 대화 경험을 제공할 수 있다고 설명한다.
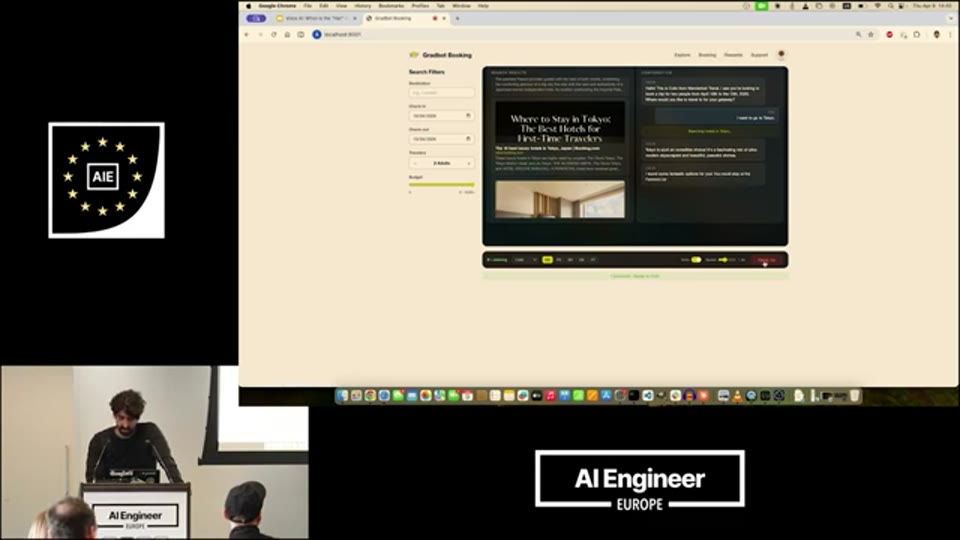
08:37 - 필러 전략 라이브 데모: 도쿄 여행 에이전트가 툴 콜 대기 중 자연스럽게 발화하는 장면
Speech-to-Speech 모델과 Full-Duplex의 핵심
캐스케이드 시스템의 레이턴시가 구조적으로 높을 수밖에 없다는 인식 하에, 많은 사람들이 Speech-to-Speech 모델에 주목한다. 이 방식은 STT, LLM, TTS라는 세 블록 대신, 음성 입력을 직접 받아 음성 출력을 생성하는 단일 모델을 사용한다. 레이턴시를 크게 줄일 수 있다는 점에서 매력적이지만, 강연자는 여기서 자주 간과되는 핵심적인 구분을 지적한다. 바로 Full-Duplex와 Half-Duplex의 차이다.
Moshi를 제외한 현존하는 모든 Speech-to-Speech 모델은 Half-Duplex 방식이다. 강연자가 세계 최고 수준이라고 언급한 OpenAI의 Advanced Voice Mode나 SESAME 음성 모델조차 마찬가지다. Half-Duplex란 모델이 ‘듣거나’ ‘말하거나’ 둘 중 하나만 할 수 있음을 의미한다. 그러나 실제 인간 대화는 이보다 훨씬 복잡하다. 사람들은 서로의 말에 겹쳐 말하고, 기침을 하고, 상대의 말에 동의를 표하는 짧은 반응—이른바 백채널링(back-channeling)—을 수시로 주고받는다. 예를 들어 일본어 대화에서는 이런 반응이 전체 대화 시간의 최대 20%를 차지하기도 한다는 점을 강연자는 언급한다. Half-Duplex 모델은 이런 상황에서 완전히 무너진다.
강연자는 이를 입증하기 위해 호텔 방에서 직접 Half-Duplex 모델과 대화를 나누는 영상을 촬영하여 보여주었다. 자신이 백채널링을 반복하자 모델이 계속 말을 끊거나 오작동하는 모습이 고스란히 담겼다. 이 영상은 단순한 기술 결함 시연이 아니라, 현재 Voice AI가 실제 인간 대화의 본질적인 특성—동시 발화, 불확실성, 겹침—에 얼마나 취약한지를 직접적으로 드러내는 사례다.
Moshi: Full-Duplex의 선구자, 그리고 솔직한 자기 평가
이런 배경에서 Gradium AI가 개발한 Moshi는 업계 최초의 Full-Duplex Speech-to-Speech 모델이라는 점에서 역사적 의의가 있다. Moshi는 사용자와 AI가 동시에 말하는 상황, 즉 발화가 겹쳐도 대화가 자연스럽게 흘러가도록 설계되었다. 데모 영상에서 강연자의 공동창업자 Alex와 Moshi가 서로 말을 겹치면서도 대화가 이어지는 모습을 볼 수 있으며, 모델이 상대방의 발화를 예측하여 일찍 답변을 시작하더라도 실제 내용이 달라지면 그것을 반영하는 유연성도 갖추고 있다. 강연자는 이 자연스러운 대화 흐름의 강인성(robustness)은 2년이 지난 지금도 여전히 따라오기 어려운 수준이라고 평가한다. 최근 NVIDIA가 Moshi를 기반으로 한 Personaplex 모델을 공개하기도 했다.
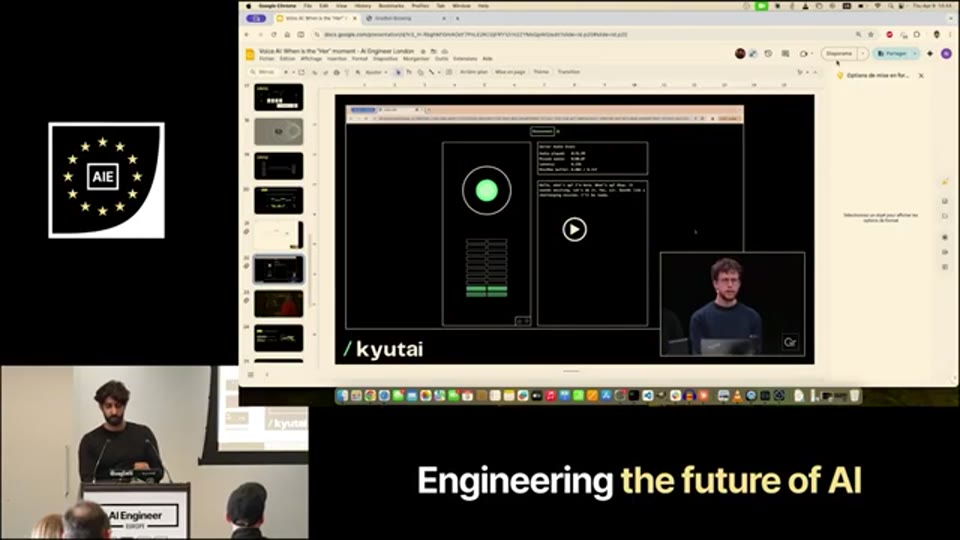
11:57 - Moshi Full-Duplex 시스템 소개 슬라이드 - 기술 구조 및 특징 요약
그러나 강연자는 Moshi의 한계도 솔직하게 인정한다. 대화 흐름의 자연스러움과는 별개로, 모델 자체가 “매우 멍청했다(very stupid)“는 것이 핵심 문제였다. 툴 콜 기능이 없어 실제 작업을 수행할 수 없었고, 프로덕션에서 필수적인 관찰 가능성(observability)도 없었으며, 부적절한 발언을 감지하는 안전 메커니즘도 갖추지 못했다. 또한 진정한 의미의 파라언어적 이해(paralinguistic understanding)—말투, 억양, 감정적 뉘앙스를 이해하여 반응에 반영하는 능력—도 구현되지 않았다. 강연자는 이 점이 기술적으로는 흥미로운 문제라고 설명한다. Speech-to-Speech 모델은 구조적으로 이런 파라언어적 정보를 처리 과정에서 잃지 않는다. 그러나 사실 기반의 질의응답 데이터셋으로만 훈련하면, 모델은 그 정보를 실제 반응에 활용하도록 학습되지 않는다. 즉, 기술적 가능성과 실제 학습 사이의 간극이 문제인 것이다.
13:14 - 영화 ‘Her’에서 AI Samantha가 주인공의 감정적 불편함을 감지하는 장면 - 파라언어적 이해 예시
Full-Duplex의 미래: 지능과 자연스러움의 융합이 관건
강연자의 핵심 주장은 다음과 같이 정리된다. Full-Duplex 모델이 인간과 유사한 자연스러운 상호작용을 가능하게 한다는 것은 이미 Moshi를 통해 증명되었다. 문제는 현재 캐스케이드 시스템이 제공하는 신뢰성, 지능, 개인화 수준에 도달하지 않는 한, Full-Duplex 모델이 캐스케이드 시스템을 대체하는 경로는 보이지 않는다는 것이다. 강연자는 “나는 한때 캐스케이드 시스템에 강하게 반대했지만(I used to be really at war against cascaded systems)“이라고 고백하며, 현실적으로 캐스케이드 시스템은 너무 실용적이고 편리하기 때문에, 진정한 과제는 Full-Duplex 모델에 동일한 수준의 역량을 부여하는 것이라고 강조한다.
자연스럽게 들리는 대화 모델을 만드는 것 자체는 이미 해결된 문제에 가깝다고 그는 말한다. 더 좋은 데이터로 Moshi 구조를 훈련시키면 인간과 구별하기 어려운 수준의 대화 흐름을 만들 수 있다. 따라서 앞으로의 모든 도전은 그 위에 지능, 신뢰성, 개인화를 쌓는 일에 집중될 것이라는 것이 그의 전망이다.
확장성, 비용, 프라이버시: 상업화의 세 가지 벽
기술적 도전 외에도, 강연자는 Voice AI가 실제 대규모 소비자 제품으로 성공하려면 넘어야 할 상업적 장벽을 명확하게 짚는다. 첫 번째는 비용이다. 현재 대부분의 하이퍼스케일러(hyperscaler)들이 제공하는 음성 모드는 적자를 감수하고 운영되고 있다. 거대한 멀티모달 모델을 구동하는 비용이 매우 높기 때문에, 마케팅 차원의 의미는 있지만 실제 수익 모델로는 지속 불가능하다. 소비자 앱을 개발하는 스타트업들의 경우, LLM 비용은 이미 사실상 무시할 수 있는 수준이 되었지만 TTS 비용이 전체 API 청구액의 대부분을 차지한다고 강연자는 강조한다. 일부 스타트업들은 사용자 기반을 충분히 성장시키기도 전에 TTS 비용으로 투자금을 모두 소진한 사례도 있다는 것이다.
두 번째는 프라이버시다. 사람들이 점점 더 많은 개인 정보를 음성 AI와 공유하게 될수록, 그 데이터가 클라우드 서버로 전송되고 저장되는 것에 대한 불안감도 커진다. 데이터베이스 해킹에 대한 우려가 높아지는 현시점에서, 개인 데이터가 기기 밖으로 나가지 않는 로컬 처리 방식이 훨씬 매력적인 대안이 된다. 세 번째는 확장성의 문제다. Her 영화 수준으로 Voice AI를 활용한다면, 하루에 수 시간씩 혹은 컴퓨터 앞에 앉아 있는 내내 AI와 비동기적으로 상호작용하게 된다. 이런 대규모 사용 패턴에서도 수익을 낼 수 있는 구조가 전제되어야 한다.
Gradium Phonon: 온디바이스 TTS로 세 가지 문제를 동시에 해결
세 가지 상업적 장벽에 대한 Gradium의 첫 번째 실질적 해답이 바로 Gradium Phonon이다. 이는 스마트폰 CPU에서 직접 구동 가능한 온디바이스 TTS 모델로, 1억 개 미만의 파라미터를 가진 매우 경량화된 모델이다. 강연자가 “온디바이스”를 정의하는 방식이 인상적이다. 일부 회사들이 “온디바이스”를 게이머용 고성능 GPU에서 실행되는 수준으로 정의하는 것과 달리, Gradium은 진정한 의미의 온디바이스—즉, 일반 스마트폰 CPU에서의 실행—를 기준으로 삼는다.
그 작은 크기에도 불구하고 강연자에 따르면 성능 측면에서 기존의 온디바이스 모델들을 능가하며, 음성 클로닝 기능까지 지원한다. 비교 대상으로 언급된 Kokoro는 성능이 좋은 온디바이스 TTS 모델이지만 음성 클로닝을 지원하지 않는다는 점에서 차별화된다. Gradium Phonon이 스마트폰에서 직접 실행되면 API 호출 비용이 전혀 발생하지 않아 비용 문제를 근본적으로 해결하고, 데이터가 기기 밖으로 나가지 않아 프라이버시 문제도 동시에 해소된다. 강연자는 이 모델의 프라이빗 베타를 열었으며, 개발자들이 API 비용 부담 없이 스케일링 가능한 음성 소비자 앱을 만들 수 있도록 지원하는 것이 목표라고 밝혔다.
17:38 - Gradium Phonon 온디바이스 TTS 라이브 데모 - Rick and Morty 테마 음성 출력 시연
마무리 / 핵심 정리
강연의 결론에서 Neil Zeghidour는 경쟁사들이 “음성은 이제 상품화되었다(voice is a commodity)“고 주장하는 것에 강하게 반대한다. 오히려 음성 AI는 여전히 극도로 어렵고, 마지막에 남은 문제들이 가장 해결하기 어려운 것들이며, 결국 순수한 과학과 엔지니어링의 힘이 Her 영화가 묘사한 수준으로 우리를 이끌 것이라고 확신한다.
이 강연에서 제시된 Voice AI의 과제는 세 가지 층위로 정리된다. 첫째, 대화의 자연스러움 문제로, Full-Duplex 모델과 파라언어적 이해가 필수적이다. 둘째, 지능과 신뢰성 문제로, 자연스러운 대화 모델에 캐스케이드 시스템 수준의 에이전트 역량을 부여하는 것이다. 셋째, 확장성과 비용 문제로, 온디바이스 AI처럼 API 비용 없이 대규모 사용을 가능하게 하는 것이다. 강연자의 논지는 이 세 가지를 동시에 해결하는 날이 진정한 Her 모먼트가 도래하는 날이라는 것이며, Gradium AI는 그 각각의 문제를 정면으로 공략하고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Voice AI: when is the “Her” moment? — Neil Zeghidour, Gradium AI |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-05-10 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- [Reachy Mini - the 300 open source robot you can actually hack - Andres Marafioti, Hugging Face](Reachy_Mini_the_300_open_source_robot_you_can_actually_hack_—_Andres_Marafioti_Hugging_Face)